Research
Mô hình Sparse: Nguồn gốc, Tại sao Nó Quan Trọng, và Tương Lai của LLM
Product
Career
Đây là bản dịch tự động từ bản gốc tiếng Nhật
Overview
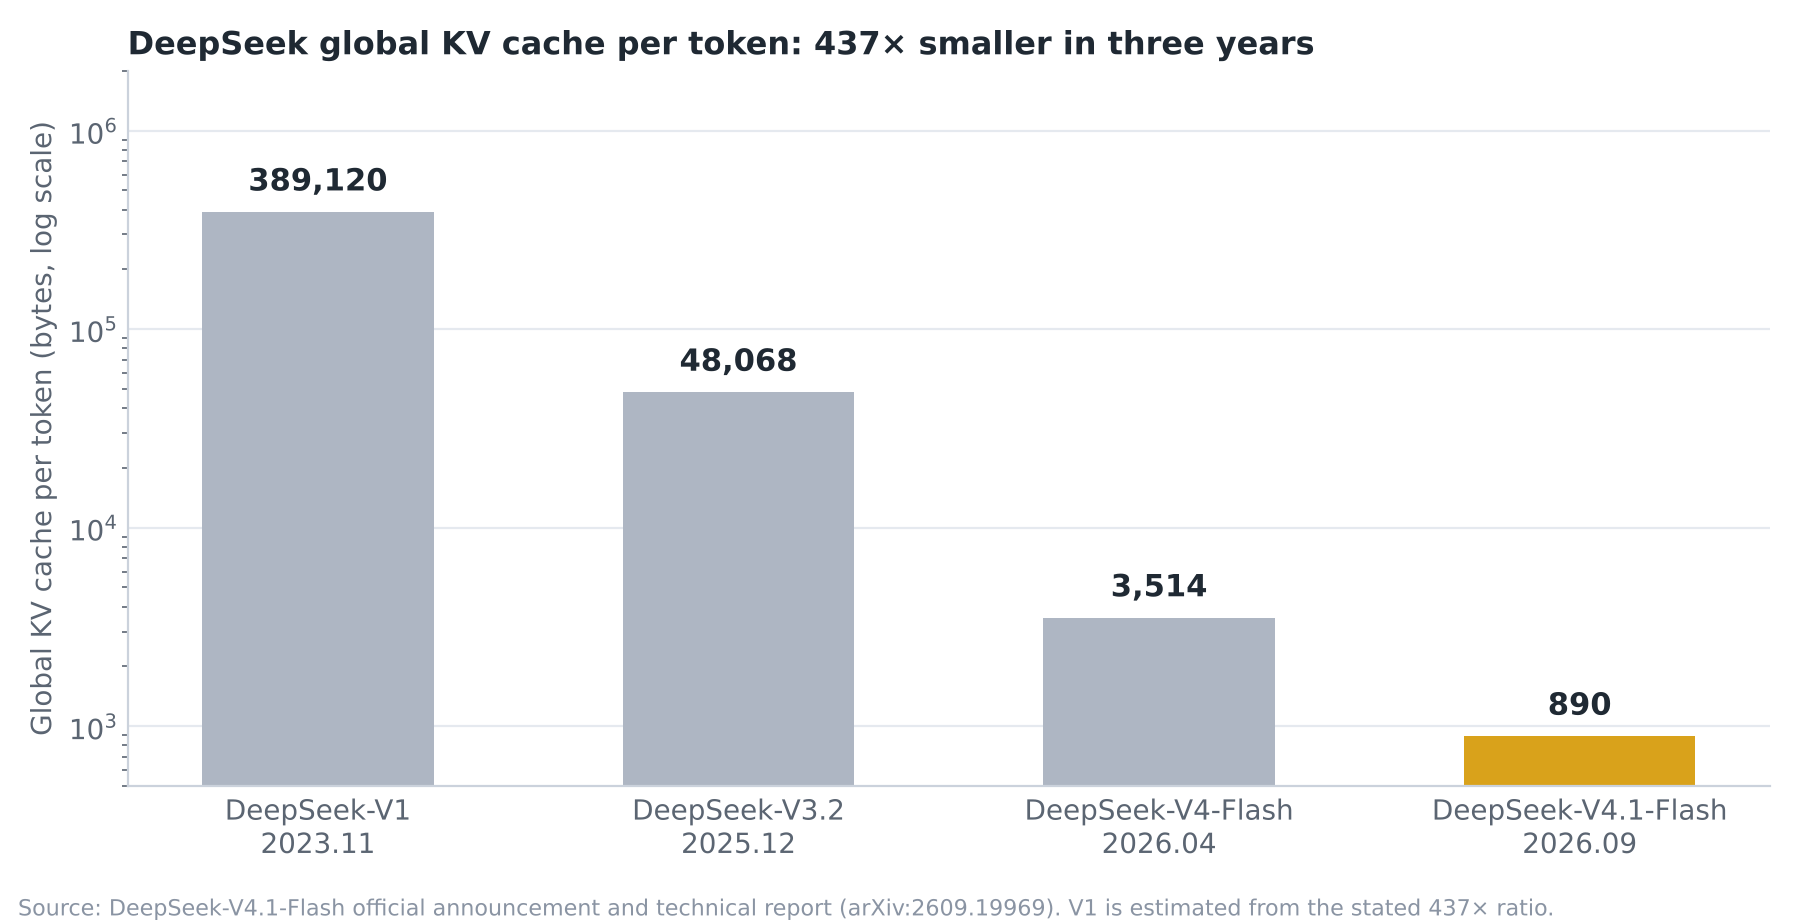
Tính đến năm 2026, thưa thớt (sparsity) không còn là một "kỹ thuật tối ưu hóa tùy chọn". Nó là một ràng buộc kiến trúc mặc định trong các mô hình quy mô lớn ở tầm cao nhất, quyết định cả chi phí vận hành của các mô hình lớn và độ chính xác đọc hiểu của các tác nhân xử lý tài liệu dài. Bằng chứng trực tiếp nhất là DeepSeek-V4.1-Flash được công bố vào ngày 10 tháng 9 năm 2026. Mặc dù xương sống có 552B tham số, chỉ 8B được kích hoạt trong giai đoạn prefill và 16B trong giai đoạn decode cho mỗi token, bộ nhớ cache KV toàn cục thường trú trên GPU chỉ 890 byte cho mỗi token, được nén xuống còn 1/437 so với DeepSeek-V1 (thông báo chính thức DeepSeek, báo cáo kỹ thuật arXiv:2609.19969).
3 điểm chính
Hệ tộc của tính thưa thớt là liên tục. Từ "mã hóa thưa thớt não bộ" của Barlow hay Olshausen–Field, qua "tính thưa thớt có thể tính toán" như wavelet, LASSO, nén cảm nhận, đến "tính thưa thớt như một kiến trúc" như MoE, atténtion thưa thớt, bộ nhớ điều kiện. Dưới nền tảng luôn có cùng một tiên nghiệm: "chỉ có rất ít thành phần thực sự quan trọng". Điểm chung của ba hệ tộc thành công là mô hình thưa thớt phù hợp với phần cứng. Cắt tỉa trọng số phi cấu trúc thất bại không phải vì lý thuyết mà vì phần cứng.
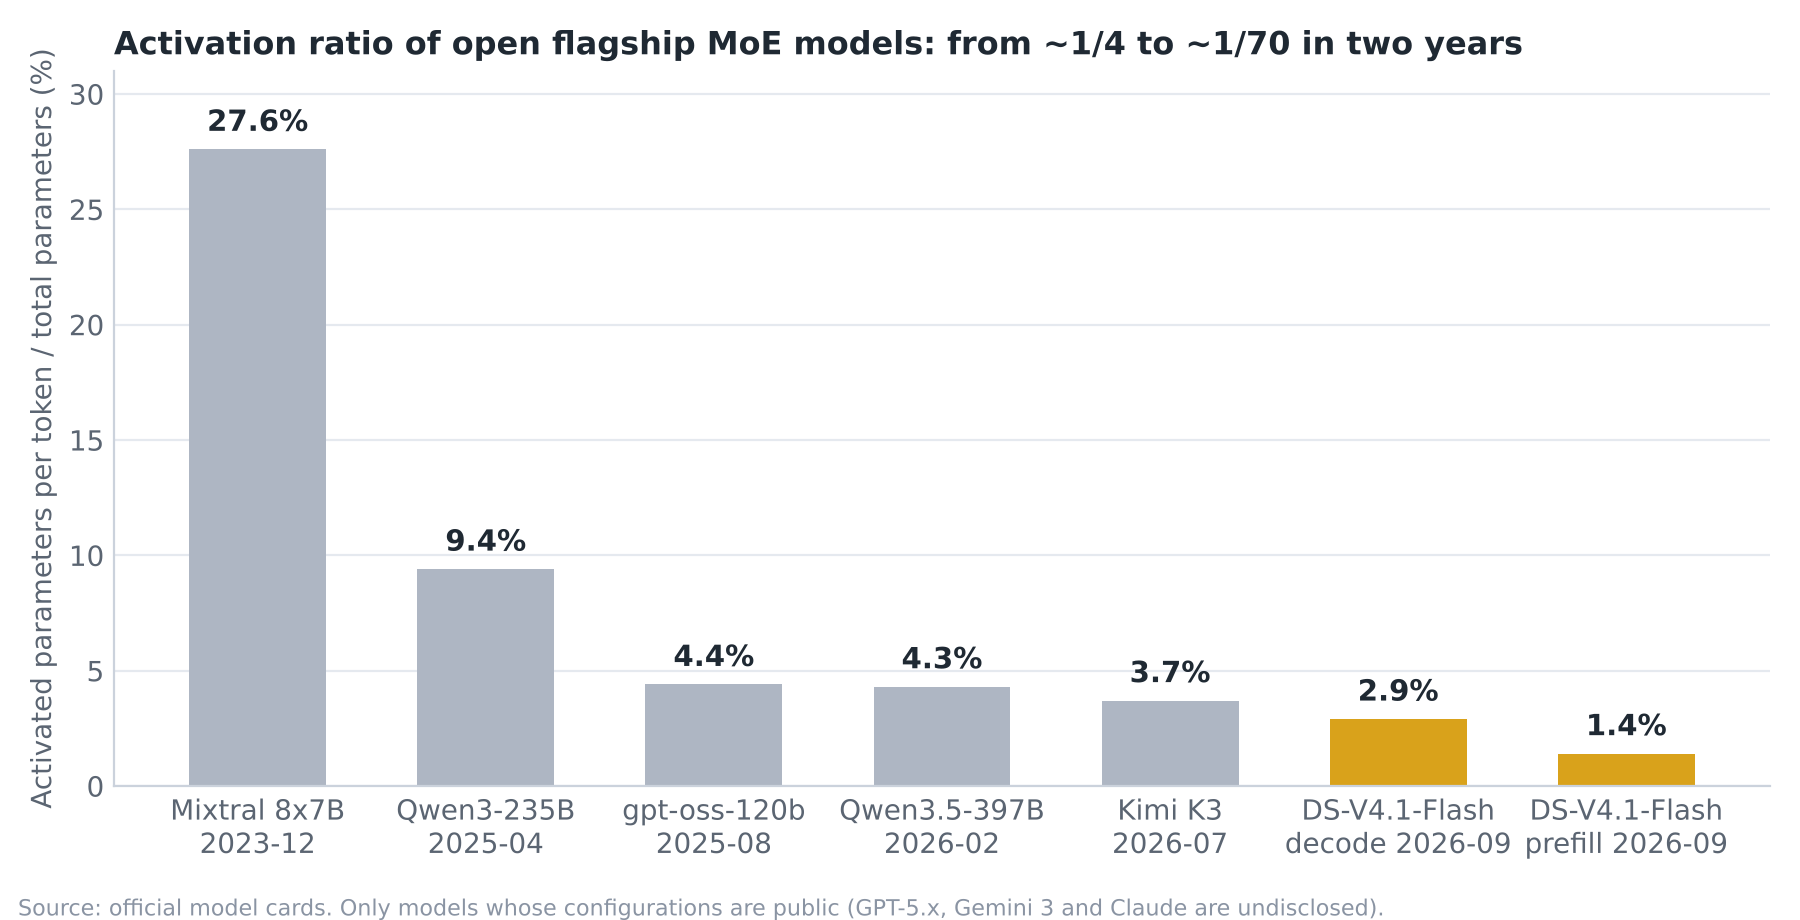
Tại sao là bây giờ. Mở rộng quy mô đã chạm vào bức tường chi phí suy luận và bộ nhớ, và các tác nhân xử lý bối cảnh dài đã làm cho bộ nhớ cache KV và prefill trở thành chi phí thống trị. Kết quả là, vai trò của tính thưa thớt đã mở rộng từ "tiết kiệm tính toán" thành "tiết kiệm bộ nhớ, băng thông và lưu trữ". Các MoE chủ yếu năm 2024 kích hoạt khoảng 25% tham số cho mỗi token (Mixtral), nhưng đến năm 2026 tỷ lệ đó đã giảm xuống 1.5%–4.5% (DeepSeek-V4.1, Kimi K3, Qwen3.5).
Tính thưa thớt không phải là thuốc chữa bách bệnh. Đánh giá quy mô lớn nhất từ trước đến nay về atténtion thưa thớt (Nawrot et al., Findings of ACL 2026) cho thấy hầu như tất cả các cấu hình thưa thớt đều gây ra sự suy giảm hiệu suất đáng kể trong ít nhất một tác vụ. Trong lĩnh vực khả năng diễn giải, các bộ mã hóa tự động thưa thớt (SAE) đã đối mặt với các kết quả tiêu cực có hệ thống năm 2025. Lựa chọn mô hình phải dựa trên điểm số cho các tác vụ khó nhất đối với doanh nghiệp của bạn, chứ không phải điểm số trung bình.
Hai trục xuyên suốt bài viết này
5 loại tính thưa thớt: tính thưa thớt kích hoạt, tính thưa thớt trọng số, tính thưa thớt có cấu trúc, tính toán điều kiện (MoE), và tính thưa thớt atténtion. Cuộc tranh luận "liệu tính thưa thớt có hữu ích không" không thể bắt đầu trừ khi xác định được loại nào đang được nói đến.
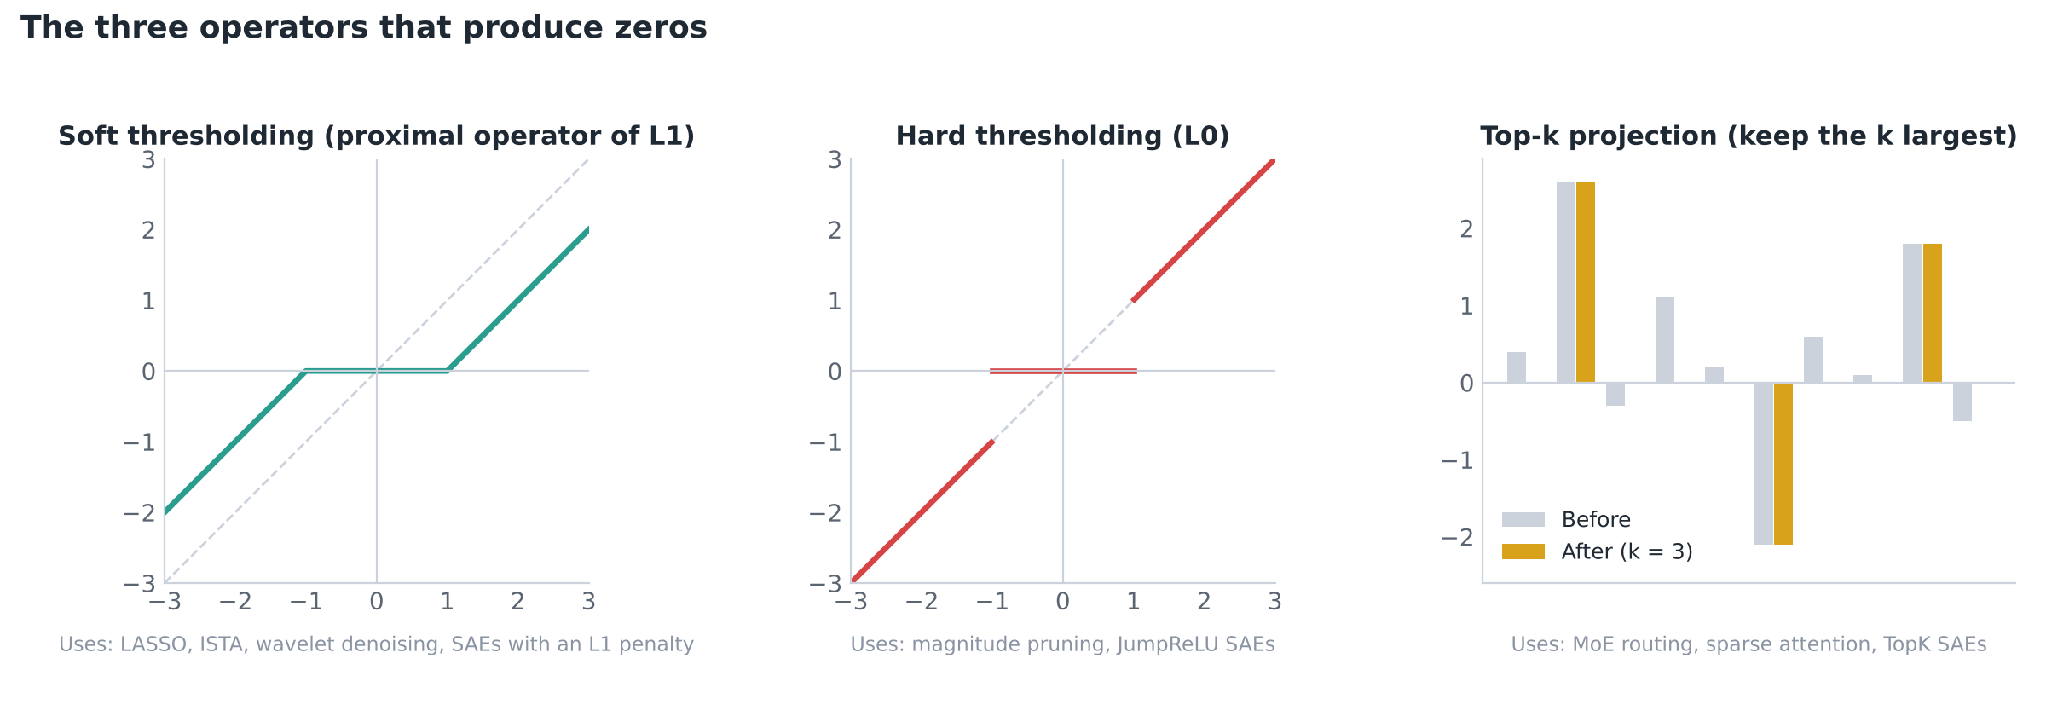
3 toán tử: ngưỡng mềm (proximal operator của L1), ngưỡng cứng (L0), và hình chiếu top-k (hình chiếu lên quả cầu L0). Từ khử nhiễu wavelet năm 1994 đến định tuyến MoE năm 2026, bước "tạo ra các số không" chỉ là áp dụng một trong ba toán tử này cho các đối tượng khác nhau. Hầu như tất cả các mô hình lớn hiện đại đều sử dụng bước thứ ba. Vì nó có thể cố định chính xác lượng tính toán cho mỗi token và phù hợp với mạt độ song song của phần cứng.
5 thuật ngữ xuất hiện lặp đi lặp lại trong toàn bộ bài viết
| Thuật ngữ | Nói một cách vắn tắt |
|---|---|
| Token | Đơn vị nhỏ nhất của văn bản mà mô hình xử lý. Một từ hoặc một phần của nó. "Bao nhiêu tham số được kích hoạt cho mỗi token" có nghĩa là bạn sử dụng bao nhiêu tính toán mỗi khi xuất ra một chút văn bản |
| Tham số và tham số kích hoạt | Tham số là tổng thể các giá trị mà mô hình giữ (nó biết bao nhiêu). Tham số kích hoạt là phần thực tế được sử dụng để tính toán khi xử lý một token (nó chi phí bao nhiêu để chạy). Tính thưa thớt hóa là tách rời hai điều này |
| Cơ sở và tọa độ | Một tập hợp "khối xây dựng". Dữ liệu có thể được viết dưới dạng tổng trọng số của chúng, với trọng số là tọa độ. Nếu bạn thay đổi khối, bạn cũng thay đổi hệ tọa độ. Mặc dù dữ liệu giống nhau, các giá trị mà bạn đọc được sẽ khác nhau |
| Chuẩn | L2 là độ dài, L1 là tổng giá trị tuyệt đối của các thành phần, L0 là số lượng các thành phần khác không. Thưa thớt có nghĩa là L0 nhỏ |
| FLOPs và băng thông bộ nhớ | Thông lượng tính toán là số lượng phép toán tích tích lũy trên giây, băng thông là số byte có thể được chuyển ra từ bộ nhớ GPU trên giây. Ở giai đoạn giải mã của các mô hình lớn hiện đại, nút thắt thường ở vị trí thứ hai |
Lưu ý về thuật ngữ: Trong bài viết này, "thưa thớt" được sử dụng một cách chặt chẽ để có nghĩa là "phần lớn các phần tử bằng không". "Hạng thấp" có nghĩa là "không phải tất cả các phần tử đều bằng không, nhưng bậc tự do ít hơn" (như MLA hay LoRA, v.v.). Hai điều này thường bị nhầm lẫn, nhưng bài viết này luôn phân biệt rõ ràng giữa chúng.
Cách đọc bài viết này
Bài viết này tiến hành theo trình tự thời gian và trả lời bốn câu hỏi giống nhau cho mỗi giai đoạn. Bối cảnh và nút thắt lúc đó là gì. Tính thưa thớt xuất hiện bằng cách nào. Nó giải quyết cái gì và hy sinh cái gì. Nó kết nối như thế nào với các mô hình lớn ngày hôm nay. Trong chương "Tiền sử", chúng tôi hỏi tại sao thế giới lại thưa thớt. "Thời kỳ cổ điển" cho thấy toán học biến nó thành công cụ như thế nào, "Thời kỳ mạng nơron" giải thích tại sao cắt tỉa lại thất bại khi tính thưa thớt được đưa vào mạng nơron. Chương "Hiện tại" ở trung tâm thảo luận về lý do tại sao các mô hình lớn đã chuyển hướng hoàn toàn sang tính thưa thớt hóa trong 2023–2026 và so sánh một cách có hệ thống cách tiếp cận của các tổ chức nghiên cứu khác nhau. "Nơi tính thưa thớt và học tập sâu gặp nhau" xử lý sự hội tụ của tính thưa thớt và học tập sâu trong xử lý hình ảnh và tín hiệu, và các chương "Ứng dụng", "Lợi ích và Chi phí", "Tương lai", "Điều gì có nghĩa là với chúng ta", xử lý ứng dụng, chi phí, tương lai và tất cả những điều này có ý nghĩa gì với chúng ta. Phần phụ lục chứa năm biểu, dữ liệu, ghi chú và tài liệu tham khảo.
Tiền sử: Tại sao bản thân thế giới lại thưa thớt
Tính thưa thớt không chỉ là tính chất của dữ liệu mà là tính chất của cặp "dữ liệu và cách mô tả nó". Thế giới trở nên thưa thớt dưới một cơ sở thích hợp. Và lịch sử khoa học cũng là lịch sử tìm kiếm cơ sở đó. Chương này trình bày ba loại bằng chứng thực nghiệm và một nguồn tư tưởng, sau đó làm rõ những hạn chế.
Triết học và lý thuyết thông tin: Trực giác và khung công tác chứ không phải nguồn gốc kỹ thuật
Dao cạo Occam là một nguyên tắc triết học ưa thích sự đơn giản chứ không phải điểm khởi đầu kỹ thuật của các mô hình thưa thớt. Shannon (1948) đã định lượng hóa "dư thừa". Phần của độ dài mã vượt quá entropy của nguồn thông tin là dư thừa có thể nén được, và biểu diễn thưa thớt về cơ bản là cơ sở làm cho dư thừa đó trở nên rõ ràng. Độ phức tạp Kolmogorov (những năm 1960) trình bày lý tưởng của "mô tả ngắn nhất" nhưng nó không thể tính toán được. MDL của Rissanen (độ dài mô tả tối thiểu, 1978) biến nó thành một tiêu chí thực tế cho lựa chọn mô hình. Các mô hình thưa thớt có thể được đọc là một trường hợp đặc biệt của MDL. Độ dài mô tả ≈ số lượng thành phần khác không × chi phí mã hóa cho mỗi hệ số, như vậy. Những tư tưởng này nên được viết như "tiền sử trí tuệ" chứ không phải "những người phát minh mô hình thưa thớt".
Ba bằng chứng từ tự nhiên
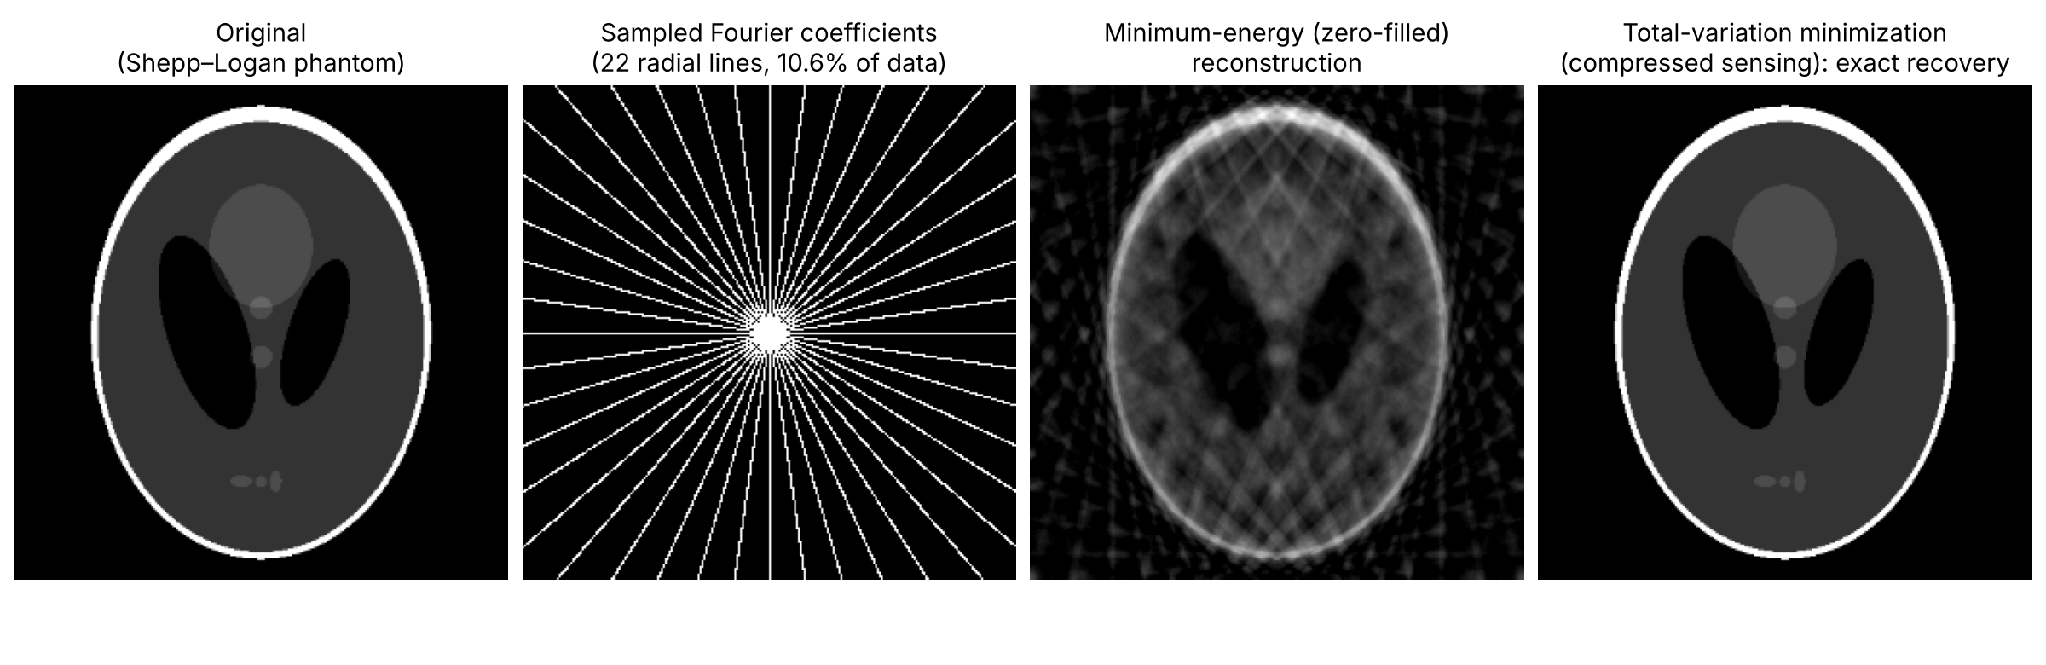
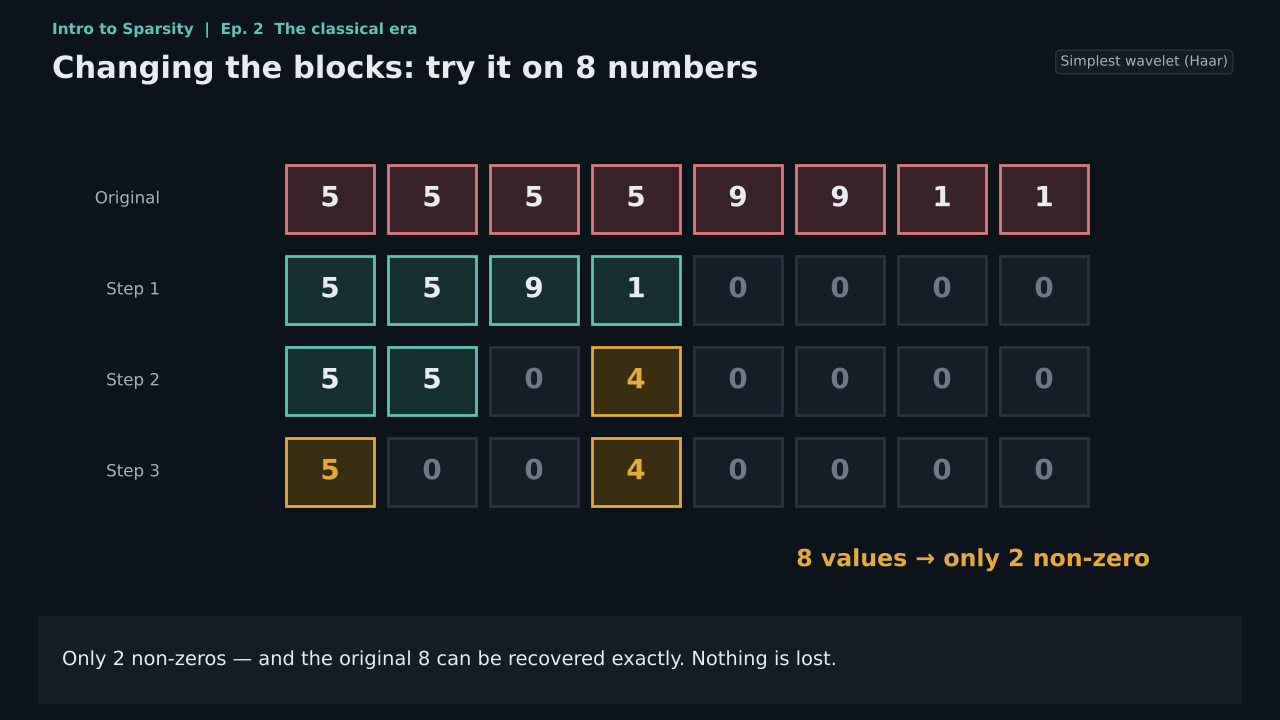
Hình ảnh tự nhiên. Phổ công suất của hình ảnh tự nhiên tuân theo luật lũy thừa 1/f² và thể hiện tính bất biến quy mô gần đúng (Field 1987; Ruderman & Bialek 1994; đánh giá trong Simoncelli & Olshausen 2001). Trong các cơ sở địa phương, dải thông-thông như wavelet, các hệ số của hình ảnh tự nhiên có đuôi nặng. Phần lớn gần bằng không, chỉ có rất ít ở các phần cạnh là lớn. Lý thuyết xấp xỉ phi tuyến (DeVore 1998; Donoho 1993) chứng minh rằng đối với tín hiệu từng phần trơn, sai số xấp xỉ n-hạng tốt nhất trong cơ sở wavelet giảm nhanh hơn bất kỳ cơ sở tuyến tính cố định nào. Đây là cơ sở lý thuyết cho cả JPEG2000 và nén cảm nhận, và ví dụ Haar trong Hình 3 là minh chứng tối thiểu.
Ngôn ngữ. Tần suất từ tuân theo định luật Zipf. Một nhóm nhỏ các từ chiếm phần lớn các lần xuất hiện, với đuôi cực kỳ dài. Do đó, các biểu diễn túi từ hay TF-IDF cực kỳ thưa thớt. Cùng một thống kê giải thích lý do tại sao tải trên các chuyên gia MoE về cơ bản là thiên vị, và lý do tại sao DeepSeek sử dụng bảng tra cứu N-gram như bộ nhớ điều kiện (Engram).
Não bộ. Barlow (1961) đề xuất giả thuyết giảm thiểu dư thừa. Mục đích của hệ thống cảm giác là loại bỏ dư thừa và xây dựng biểu diễn độc lập về mặt thống kê, giả thuyết này là nguồn gốc thần kinh học của mã hóa thưa thớt. Attwell & Laughlin (2001) tính toán cân bằng năng lượng của chất xám, từ đó Lennie (2003, Current Biology 13:493–497) ước tính rằng vì chi phí của mỗi spike rất cao, "số lượng nơron có thể hoạt động đáng kể cùng một lúc có thể bị giới hạn nghiêm ngặt dưới 1%".
Ở đây có một điều cần phải sửa chữa. Khẳng định "não chỉ sử dụng 1–4% nơron" được lưu hành rộng rãi là trích dẫn gián tiếp. Khi Glorot, Bordes, Bengio (2011) trích dẫn Lennie, họ viết "1–4%", và kể từ đó con số đó liên tục được tái đăng. Văn bản gốc của Lennie là "có thể dưới 1%", và hơn nữa đó là một ước tính về ranh giới trên dẫn xuất từ các ràng buộc năng lượng chứ không phải giá trị đo đạc. Tính thưa thớt có nghĩa là "tỷ lệ bắt lửa mạnh mẽ trong bất kỳ lúc nào là thấp", không phải là "phần lớn não đang nhàn rỗi".
Hạn chế và phản ví dụ
Thưa thớt không phải hạng thấp. Thưa thớt là ít hệ số khác không dưới một cơ sở hoặc từ điển nào đó (đo bằng L0/L1). Hạng thấp là ít giá trị kỳ dị của ma trận (đo bằng hạng hoặc chuẩn hạt nhân). LoRA và MLA có hạng thấp, trong khi MoE, atténtion top-k, và SAE có tính thưa thớt. SVD bị cắt cụt cung cấp một ma trận hạng thấp, và sự thưa thớt tại đó chỉ nằm trong phổ của các giá trị kỳ dị.
Thế giới không phải lúc nào cũng thưa.Robust PCA (Candès, Li, Ma & Wright 2011) phân tích dữ liệu thành "thấp xếp + thưa", cho thấy dữ liệu thực tế thường có cả hai đặc tính. Trong video, nền là thấp xếp, nền trước là thưa. Các tín hiệu bị chi phối bởi kết cấu hoặc nhiễu không thưa trong cơ sở thường dùng. Sự chồng chập (superposition) của các đặc trưng trong dòng phần dư của LLM có nghĩa là biểu diễn ở mức từng nơ-ron là dày đặc, và chỉ trở nên thưa dưới một từ điển quá đầy đủ. Đây là điểm khởi hành của cuộc thảo luận SAE trong chương "hiện tại" (phần "Tính thưa trong khả năng giải thích").
Tóm tắt chương này.Tính thưa là một tiên nghiệm có thể bác bỏ được, không phải một sự thật phổ quát. Vì nó đã được xác nhận lặp đi lặp lại trong hình ảnh tự nhiên, ngôn ngữ và hoạt động thần kinh nên nó đáng để "cược". Nhưng trước khi cược, bạn phải đặt ra một câu hỏi duy nhất. Câu hỏi đó là: dưới cơ sở nào thì nó thưa?
Chi tiết ba bằng chứng: tại sao những quy luật thống kê này?
Phổ 1/f của hình ảnh tự nhiên đến từ đâu?Có hai giải thích bổ sung. Giải thích thứ nhất là bất biến theo tỷ lệ. Kích thước của các vật thể trong cảnh tự nhiên trải rộng nhiều bậc, và thống kê hình ảnh không thay đổi cho dù bạn phóng to hay thu nhỏ. Về mặt toán học, điều này buộc phổ công suất phải tuân theo quy luật lũy thừa. Giải thích thứ hai là mô hình che khuất (occlusion). Cảnh được tạo thành bởi các vật thể chồng lên nhau về phía trước và phía sau, các cạnh tạo ra sự không liên tục, và trong miền tần số, sự không liên tục xuất hiện dưới dạng đuôi tần số cao suy giảm chậm. Cả hai giải thích đều dẫn đến cùng một kết luận. Hình ảnh tự nhiên không phải là "nhiễu ngẫu nhiên" cũng không phải "mịn ở khắp mọi nơi", mà là "vùng rộng và bằng phẳng + một số cạnh ít ỏi". Đây chính xác là cấu trúc mà cơ sở sóng nhỏ giỏi nhất. Field (1987) thậm chí còn đi xa hơn, chỉ ra rằng nếu băng thông trường tiếp nhận của các tế bào đơn giản trong vùng thị giác phù hợp với thống kê này, thì phản ứng của mỗi tế bào đối với hình ảnh tự nhiên sẽ có đuôi nặng, tức là hầu hết thời gian chúng hầu như không phản ứng, nhưng đôi khi phát bạo. Đây là ý nghĩa ban đầu của thuật ngữ "mã hóa thưa" trong khoa học thần kinh.
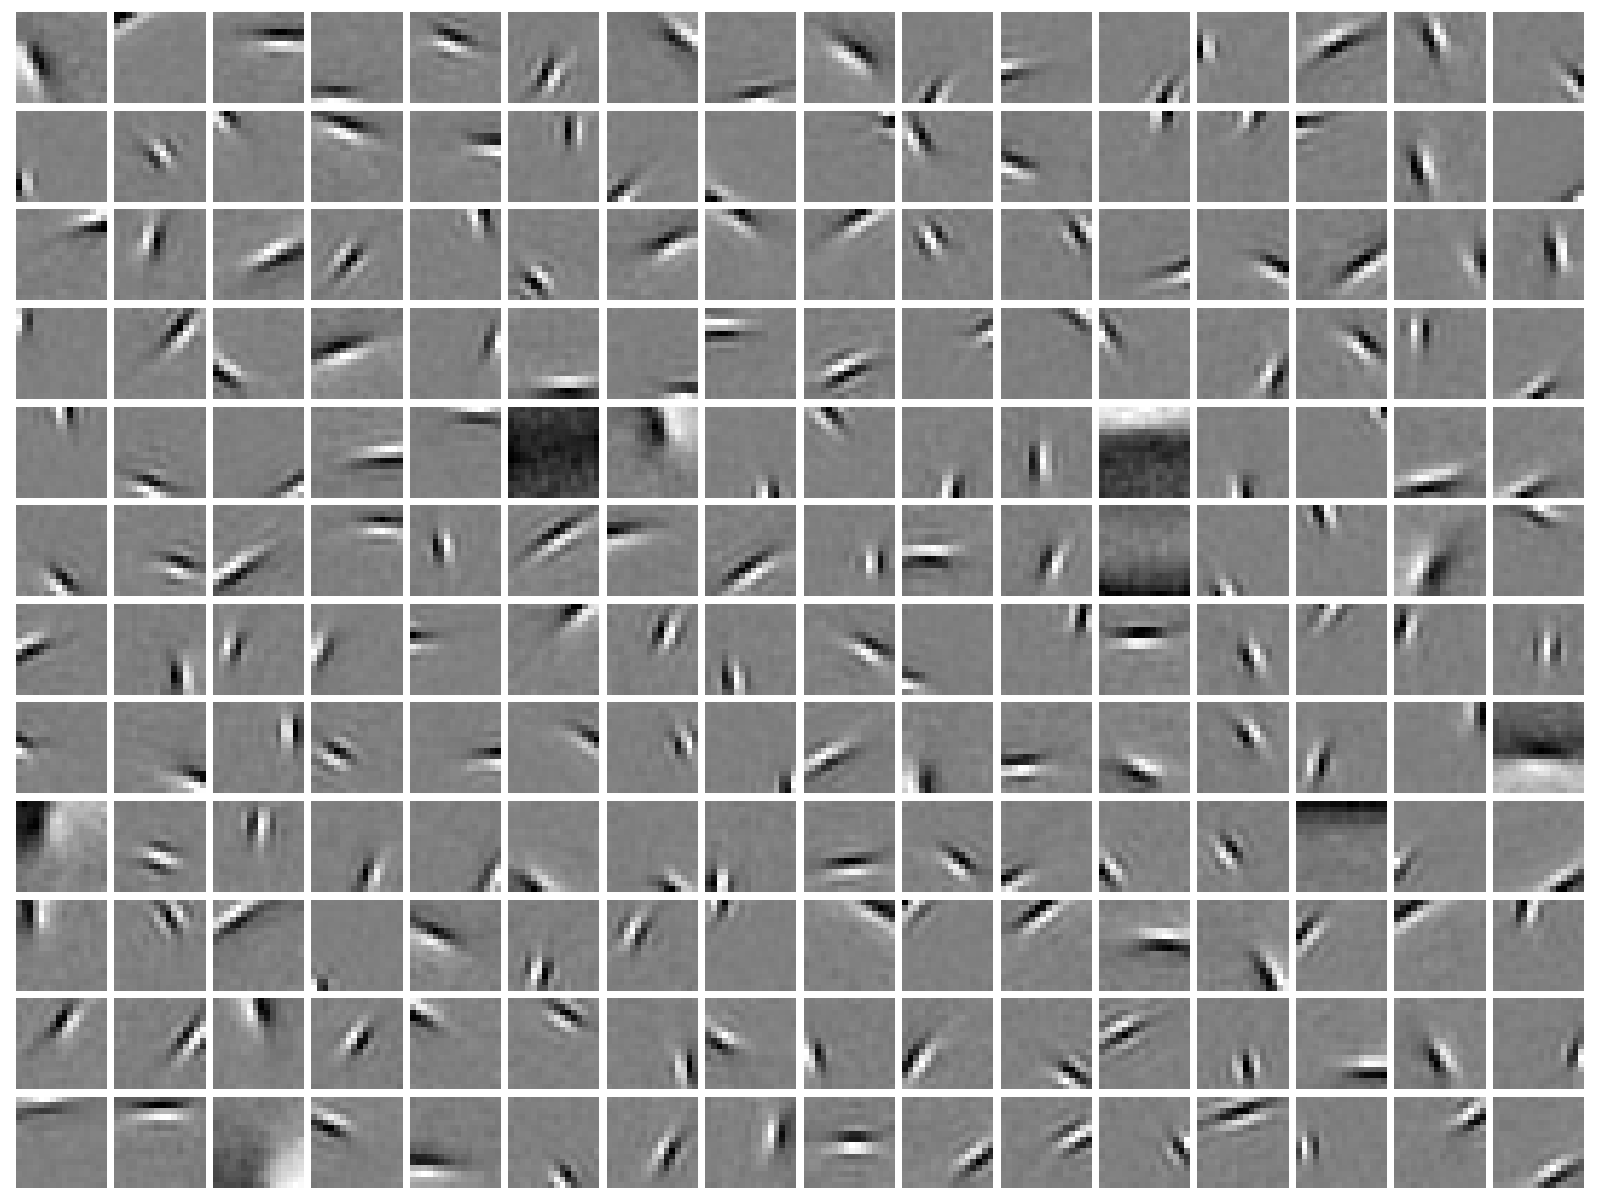
Tại sao thí nghiệm của Olshausen và Field lại có sức thuyết phục cao như vậy?Thí nghiệm năm 1996 chỉ áp đặt hai ràng buộc cho thuật toán. Tái tạo các bản vá hình ảnh tự nhiên bằng một tập hợp các hàm cơ sở tuyến tính, và làm cho các hệ số càng thưa càng tốt. Không có kiến thức tiền nghiệm nào về não. Tuy nhiên, các hàm cơ sở học được lại trở nên cục bộ, chọn lọc hướng và thông dải, rất giống với các trường tiếp nhận của các tế bào đơn giản V1 ở mèo và khỉ. Sức mạnh của kết quả này nằm ở hướng của nó. Không phải "chúng tôi tạo ra thuật toán được lấy cảm hứng từ não", mà "nguyên tắc tính thưa độc lập dự đoán cấu trúc não". Sau đó, Hromádka, DeWeese, Zador (2008) ghi lại các mẫu phát bạo vô cùng thưa trong vùng thính giác của chuột thức, và Quian Quiroga et al. (2005) khám phá ra "tế bào khái niệm" trong hồi hải mã của con người có thể phản ứng chọn lọc với những người hoặc mốc địa chỉ cụ thể. Cả hai đều được coi là bằng chứng của giả thuyết mã hóa thưa. Có những ý kiến khác nhau. Các tác giả như Spanne và Jörntell (2015) lập luận rằng mã hóa thưa nghiêm ngặt không phải là phổ quát trên toàn bộ皮层, mà mức độ thưa phụ thuộc vào khu vực não và nhiệm vụ. Do đó, điều này nên được viết dưới dạng "một giả thuyết được hỗ trợ rộng rãi" chứ không phải là một học thuyết được xác định.
Tại sao năng lượng buộc phải có tính thưa?Não người chiếm khoảng 2% trọng lượng cơ thể nhưng tiêu thụ khoảng 20% trao đổi chất khi yên tĩnh, khoảng 20 watt. Attwell và Laughlin (2001) ước tính rằng phần lớn năng lượng của chất xám được sử dụng cho truyền synap và điện thế hoạt động. Lennie (2003) sau đó lập luận ngược lại. Nếu mỗi lần phát bạo tốn kém như vậy, thì vỏ não không có đủ khả năng để phát bạo một tỷ lệ lớn các nơ-ron đồng thời với tần số cao. Lập luận này là "giới hạn trên dưới ràng buộc ngân sách", vì vậy kết quả là một ước tính "có lẽ dưới 1%" chứ không phải một số đo được. Ý nghĩa nằm ở logic chứ không phải ở con số cụ thể. Trong các hệ thống có năng lượng hoặc băng thông hạn chế, tính thưa không phải là một lựa chọn mà là một yêu cầu.Cùng một logic được phát lại trong chương "kỷ nguyên mạng lưới thần kinh" dưới dạng "bức tường bộ nhớ" trên GPU.
Quy luật Zipf trong ngôn ngữ và đuôi dài.Zipf (1935) quan sát thấy rằng tần suất của các từ gần như tỷ lệ nghịch với thứ hạng của chúng. Từ phổ biến thứ hai xuất hiện khoảng một nửa tần suất của từ thứ nhất, từ thứ mười xuất hiện khoảng 1/10 tần suất. Sau đó Mandelbrot đưa ra hình thức hiệu chỉnh. Hậu quả trực tiếp là bất kỳ văn bản nào cũng chỉ sử dụng một phần rất nhỏ của vốn từ vựng, và hầu hết các từ chỉ xuất hiện 1 hoặc 2 lần. Trong kỷ nguyên của mô hình ngôn ngữ thống kê, điều này xuất hiện dưới dạng ma trận tần suất n-gram cực kỳ thưa và vấn đề làm mịn "xác suất không" (Good–Turing, Kneser–Ney). Trong kỷ nguyên của các mô hình quy mô lớn, nó quay trở lại theo hai hình thức. Một là tải định tuyến MoE về cơ bản bị sai lệch; vì các chuyên gia phổ biến chịu phần lớn các mã thông báo, nên các cơ chế cân bằng tải phải can thiệp. Cái thứ hai là Engram của DeepSeek. Nó khôi phục bảng tra cứu N-gram vào kiến trúc biên giới, chuyển các mẫu thường gặp đến các đường tra cứu rẻ tiền, và chỉ giữ lại những gì thực sự cần suy luận cho các lớp Transformer đắt tiền.
Tính thưa trong vật lý và kỹ thuật
Lịch sử tính thưa lâu hơn trong kỹ thuật so với học máy. Trong tính toán khoa học, ma trận hệ số trong phương pháp phần tử hữu hạn và phương trình dòng chảy điện lực về cơ bản là thưa. Mỗi nút chỉ kết nối với các nút lân cận. Tinney và Walker (1967) đã đề xuất thứ tự tối ưu để giảm "điền vào" trong quá trình loại bỏ Gauss khi giải các hệ thống điện. Đây là điểm khởi hành của phương pháp trực tiếp thưa. Sau đó Rose (1972) mô tả quá trình loại bỏ theo ngôn ngữ lý thuyết đồ thị, Gilbert và những người khác phát triển phân rã LU thưa, và đại số tuyến tính thưa trở thành một lĩnh vực. Trong thăm dò địa chấn, dãy độ phản xạ dưới đất được mô hình hóa dưới dạng một dãy spike thưa, và vấn đề deconvolution có thể được giải bằng quy chuẩn L1. Điều này xảy ra trước 20 năm so với cảm biến nén. Trong xử lý tín hiệu mảng radar, các mục tiêu được phân bố thưa trong không gian góc, khoảng cách và vận tốc, và phục hồi thưa được sử dụng cho ước tính siêu độ phân giải.
Điểm chung của các lĩnh vực này là các mẫu thưa có nguồn gốc từ cấu trúc vật lý (quan hệ láng giềng, phản xạ, số lượng mục tiêu) nên có thể dự đoán và khai thác. Điều này liên tục với sóng nhỏ "kỷ nguyên cổ điển" (nguồn gốc của cấu trúc là tính mịn từng đoạn) hoặc MoE "hiện tại" (nguồn gốc của cấu trúc là các khối chuyên gia), và cũng giải thích tại sao tính thưa trọng số phi cấu trúc lại thất bại trong "kỷ nguyên mạng lưới thần kinh". Các số không đó không có cấu trúc vật lý, và phần cứng không thể khai thác được.
Gương phản ánh các hiện tượng xã hội và giới hạn của cách suy nghĩ này
Quy luật Pareto 80-20, Đuôi dài của Anderson, và truyền thống phân tích nhân tố rằng "một số ít các biến quan trọng giải thích hầu hết sự biến thiên" đều là gương phản ánh tính thưa tiên nghiệm ánh sáng lên khoa học xã hội. Những gì họ cho thấy là tính thưa là một giả định về cấu trúc của thế giới, không phải một định lý. Các nhà thống kê như Gelman đã đặt câu hỏi về "cược vào tính thưa". Họ lập luận rằng trong nhiều vấn đề của khoa học xã hội, các hiệu ứng thực sự là dày đặc và nhỏ, và các phương pháp thưa sẽ hệ thống loại bỏ chúng. Cùng một phê bình áp dụng cho học máy. Các đặc trưng trong dòng phần dư của LLM được lưu trữ dày đặc thông qua chồng chập, và tính thưa chỉ xuất hiện sau khi chuyển sang một từ điển quá đầy đủ. Do đó,立場 của bài viết này như sau. Tính thưa xứng đáng là một tiên nghiệm ban đầu để cược vì nó đã được xác nhận lặp đi lặp lại trên một lượng lớn dữ liệu tự nhiên. Nhưng mỗi khi cược, hãy trả lời "dưới cơ sở nào thì nó thưa?" và chuẩn bị sẵn sàng để từ bỏ nếu bằng chứng không hỗ trợ.
Kỷ nguyên cổ điển (những năm 1960 đến 2014): Làm thế nào tính thưa trở thành một công cụ có thể tính toán được
Các phương pháp thưa thành công trong kỷ nguyên cổ điển có một điểm chung. Các mẫu thưa được cấu trúc hóa và có thể dự đoán được, nên chúng mới có thể được tích hợp vào phần cứng và tiêu chuẩn ngành.Đây cũng là hình ảnh ẩn của "thất bại" được thảo luận trong "kỷ nguyên mạng lưới thần kinh". Bảng dưới đây sắp xếp các mốc theo ba câu hỏi: tại sao phương pháp lại xuất hiện vào thời kỳ đó, điểm thắt cổ chai lúc bấy giờ là gì, và nó giải quyết vấn đề gì.
| Mốc | Tại sao nó xuất hiện vào thời kỳ đó | Điểm thắt cổ chai lúc bấy giờ | Vấn đề nó giải quyết |
|---|---|---|---|
| Phương pháp trực tiếp ma trận thưa (Tinney & Walker 1967) | Lưới điện phát triển lớn, bộ nhớ ở thang đo KB | Phương pháp loại bỏ dày đặc là O(n³) và không vừa vào bộ nhớ | Chỉ lưu trữ các phần tử khác không và giảm điền vào bằng thứ tự tối ưu |
| Sóng nhỏ (Daubechies 1988; Mallat 1989) | Cơ sở Fourier không thưa đối với các cạnh | Năng lượng cạnh tán xạ trên toàn bộ miền tần số | Tín hiệu mịn từng đoạn trở nên thưa trong miền sóng nhỏ |
| Matching Pursuit (Mallat & Zhang 1993) | Sự xuất hiện của từ điển quá đầy đủ | Biểu diễn không duy nhất | Lựa chọn atom bằng phương pháp tham lam |
| Khử nhiễu ngưỡng sóng nhỏ (Donoho & Johnstone 1994) | Các hệ số thưa, nhiễu đồng đều | Bộ lọc tuyến tính làm mờ cả các cạnh | Xử lý ngưỡng mềm = Toán tử gần L1. Gần như tối ưu minimax |
| Garrote của Breiman 1995 → LASSO (Tibshirani 1996) | Dữ liệu chiều cao p ≫ n | Bình phương nhỏ nhất là bất định, lựa chọn tập hợp con không ổn định | Thực hiện đồng thời ước tính co cụm và lựa chọn biến |
| Basis Pursuit (Chen, Donoho & Saunders 1998) | Tối ưu hóa lồi trưởng thành | L0 là NP-khó | Thư giãn lồi bằng L1 |
| Xấp xỉ phi tuyến (DeVore 1998) | Cần có giải thích cho tính tối ưu của "giữ lại k cái lớn nhất" | Xấp xỉ tuyến tính hội tụ chậm | Lý thuyết xấp xỉ n-hạng tốt nhất |
| JPEG (1992) / JPEG2000 (2000) | Sự phổ biến của hình ảnh kỹ thuật số | Băng thông và lưu trữ | Biến đổi thưa + lượng tử hóa + mã hóa entropy |
| LARS (Efron et al. 2004); Elastic Net (Zou & Hastie 2005) | LASSO cần thuật toán đường dẫn hiệu quả | Giải chậm, không ổn định với các biến tương quan | Tính toán hàng loạt toàn bộ đường dẫn chính quy. L1 + L2 |
| Cảm biến nén (Candès–Romberg–Tao 2006; Donoho 2006) | Lý thuyết thưa gặp lý thuyết ma trận ngẫu nhiên | Lấy mẫu bị ràng buộc bởi tần số Nyquist | Dưới điều kiện RIP, phục hồi từ m ≳ k·log(n/k) lần đo |
| K-SVD (Aharon, Elad & Bruckstein 2006) | Cần một từ điển có thể học được | Sóng nhỏ cố định không phù hợp với dữ liệu cụ thể | Tối ưu hóa luân phiên của mã hóa thưa và cập nhật từ điển |
| Chuyển pha Donoho–Tanner (2009) | Cần phải đặc trưng hóa các điều kiện để L1 thành công | Các giới hạn lý thuyết quá lỏng lẻo | Chuyển pha sắc nét trong mặt phẳng (m/n, k/m) |
| Mã hóa thưa (Olshausen & Field 1996), thuật toán nhanh (Lee, Battle, Raina & Ng 2007) | Phản ứng với giả thuyết Barlow | Tại sao các trường tiếp nhận V1 lại có dạng Gabor | Từ điển thưa tái tạo lại các trường tiếp nhận V1 |
| Nơron khuôn mặt mèo (Le et al. 2012) | Sự xuất hiện của học phân tán | Các đặc trưng bậc cao có xuất hiện mà không cần giáo viên không | Sẽ được thảo luận sau |
| Ngưỡng cứng giá trị kỳ dị tối ưu (Gavish & Donoho 2014) | Khử nhiễu hạng thấp cần một ngưỡng nguyên tắc | Hạng bị cắt ngắn được chọn theo quy tắc kinh nghiệm | Đối với ma trận vuông với σ đã biết là (4/√3)√n·σ, nếu chưa biết thì 2,858 lần của trung vị |
Nguyên tắc "đặt cược vào tính thưa" trong thống kê
Hastie, Tibshirani, Friedman đã phát biểu nguyên tắc "bet on sparsity (đặt cược vào tính thưa)" trong The Elements of Statistical Learning. Nếu mô hình thực sự là thưa, L1 có thể tìm thấy nó. Nếu không thưa, không có phương pháp nào hoạt động tốt. Vì vậy hãy đặt cược vào tính thưa. Thống kê chiều cao đã định lượng chính xác cái giá của nó. Để khôi phục một vectơ k-thưa trong p chiều thì n ≳ k·log p mẫu là đủ (Wainwright 2009). Kết quả tương ứng trong cảm biến nén là m ≳ C·k·log(n/k) phép đo ngẫu nhiên và nếu hằng số RIP thỏa mãn δ₂ₖ < √2−1 ≈ 0,414 thì L1 có thể khôi phục chính xác (Candès 2008).
Ba ví dụ thế giới thực (các con số đã được xác minh)
CS-MRI. Lustig, Donoho, Pauly (2007) đã xây dựng nền tảng cho MRI cảm biến nén. Các con số lâm sàng phải được trích dẫn chính xác. Sartoretti et al. (2019, PLoS ONE 14(4): e0214887) báo cáo rằng trong thực hành lâm sàng hàng ngày, thời gian quét trung bình giảm 20,2%, thời gian kiểm tra giảm 16%, thời gian chụp của các chuỗi được áp dụng giảm 23%–43%, và số lượng kiểm tra trong cùng kỳ tăng 27% (nguồn ban đầu). Vranic et al. (2019, AJNR 40(1):92–98) báo cáo giảm 25% và 35% cho các chuỗi FLAIR và GRE não lần lượt. Tuyên bố được trích dẫn nhiều về "tăng tốc độ 30%–60%" không có hỗ trợ từ các nguồn ban đầu.
Hình ảnh lỗ đen (EHT). SMILI, một trong ba đường ống hình ảnh hỗ trợ hình ảnh M87* đầu tiên năm 2019, thuộc dòng mô hình hóa thưa (chính quy hóa L1+TV) của Honma et al. (2014) và Akiyama et al. (2017). Một đường ống khác, CHIRP (Bouman et al. 2016), không phải là cảm biến nén thuần túy mà sử dụng phân bố trước của bản vá, vì vậy báo cáo "một nhà nghiên cứu chụp ảnh lỗ đen bằng cảm biến nén" là một sự đơn giản hóa.
Nơron khuôn mặt mèo. Le et al. (2012, ICML, arXiv:1112.6209) đã huấn luyện một bộ mã hóa tự động thưa có kết nối cục bộ 9 lớp với khoảng một tỷ kết nối, được huấn luyện trên 10 triệu khung từ YouTube "trên 1.000 máy (16.000 lõi) trong 3 ngày". Không cần giáo viên, các nơron riêng lẻ xuất hiện có phản ứng chọn lọc với khuôn mặt người và khuôn mặt mèo, và đạt độ chính xác 15,8% trên ImageNet hạ lưu, cải thiện tương đối 70% so với kết quả tốt nhất trước đó. Dòng "mã hóa thưa → đặc trưng không giáo viên" này suy giảm sau năm 2012 khi bị CNN có giáo viên lấn át, nhưng quay trở lại vào năm 2023 dưới dạng SAE của Anthropic.
Dòng song song: hạng thấp
SVD cắt ngắn (định lý Eckart–Young–Mirsky) là xấp xỉ tốt nhất giữa tất cả các ma trận có hạng ≤ k, và Gavish & Donoho (2014, IEEE T-IT 60(8):5040–5053) đã cung cấp ngưỡng cứng tối ưu để khử nhiễu. Điều này có cấu trúc đẳng cấu với khử nhiễu ngưỡng wavelet. Cả hai đều tuân theo "đổi cơ sở → xử lý ngưỡng → chuyển đổi ngược", sự khác biệt chỉ là cơ sở wavelet được cố định trong khi cơ sở SVD được tính toán từ dữ liệu. Trong trường hợp trước, tín hiệu vẫn thưa sau khi xử lý ngưỡng, nhưng trong trường hợp sau, ma trận bị cắt ngắn có hạng thấp nhưng dày đặc. Dòng này quay trở lại các mô hình quy mô lớn dưới dạng MLA và LoRA trong chương "Hiện tại".
Từng bước: tại sao mỗi tiến bộ lại xảy ra vào thời kỳ đó
Từ Fourier đến Wavelet (những năm 1980). Cơ sở Fourier phân tích tín hiệu thành sóng sin toàn cục. Nó hiệu quả cho tín hiệu dừng, nhưng vô cùng lãng phí cho các cạnh và hiện tượng quá độ. Để biểu diễn chỉ một bước cần vô số thành phần tần số, năng lượng lan tỏa khắp miền tần số. Kỹ thuật đã có các cách tránh như biến đổi Gabor hoặc biến đổi Fourier thời gian ngắn, nhưng không có một khung toán học thống nhất. Khi Mallat (1989) hình thức hóa phân tích đa độ phân giải và Daubechies (1988) xây dựng các wavelet trực giao có giá compact, ba tính chất tính địa phương, cấu trúc đa tỷ lệ và tính trực giao có thể được thỏa mãn đồng thời. Mỗi hàm cơ sở wavelet chỉ khác không trên một phạm vi hữu hạn, lặp lại ở tất cả các tỷ lệ. Do đó, một tín hiệu từng phần mịn sẽ sản sinh các hệ số lớn chỉ ở vị trí của các cạnh và một vài tỷ lệ, nơi khác gần như bằng không. DeVore (1998) và Donoho (1993) đã chứng minh rằng đây không phải là sự trùng hợp ngẫu nhiên. Đối với lớp các hàm từng phần mịn, bất kỳ cơ sở tuyến tính cố định nào cũng không thể so sánh được với tỷ lệ giảm lỗi của xấp xỉ phi tuyến n-hạng tốt nhất trong cơ sở wavelet. JPEG2000 (2000) đã biến lý thuyết này thành một tiêu chuẩn, thay thế DCT của JPEG bằng wavelet, giảm đáng kể nhiễu khối ở cùng một tỷ lệ bit.
Từ bình phương tối thiểu đến LASSO (những năm 1990). Thống kê phải đối mặt với một loại tính thưa khác. Không phải các hệ số có thưa dưới một cơ sở nào đó, mà "biến giải thích nào thực sự quan trọng". Cách tiếp cận cổ điển là lựa chọn tập con (hồi quy từng bước, AIC/BIC), nhưng đó là tìm kiếm kết hợp, cực kỳ không ổn định với những nhiễu loạn nhỏ của dữ liệu. Breiman (1995) đề xuất garotte không âm, định khung lại lựa chọn biến như một vấn đề co rút liên tục. Được truyền cảm hứng từ đó, Tibshirani (1996) đề xuất LASSO, tức là bình phương tối thiểu với phạt L1. Hành vi của L1 được xác định bởi hình học của nó. Vùng ràng buộc là một hình thoi có góc, giải pháp tối ưu dễ nằm ở các góc, mỗi góc tương ứng với một điểm mà một số hệ số chính xác bằng không. Đây là cơ chế "co rút và lựa chọn xảy ra đồng thời". Điểm tắc nghẽn thuật toán của LASSO được loại bỏ bởi LARS (Efron, Hastie, Johnstone, Tibshirani) năm 2004, cho phép tính toàn bộ đường dẫn chính quy cùng một lúc. Năm 2005, Elastic Net của Zou và Hastie với L1+L2 có thể xử lý các nhóm biến tương quan mạnh. Thống kê chiều cao cung cấp bảo đảm lý thuyết. Wainwright (2009) chứng minh rằng n ≳ k·log p mẫu đủ để khôi phục k hệ số khác không trong p chiều, Bickel, Ritov, Tsybakov (2009) thiết lập bất đẳng thức Oracle cho LASSO và bộ chọn Dantzig.
Phát hiện độc lập trong xử lý tín hiệu (1993–1998). Vào khoảng thời gian tương tự, xử lý tín hiệu bắt đầu từ "từ điển quá hoàn chỉnh" và đi đến cùng một L1. Matching Pursuit (Mallat và Zhang 1993) tham lam chọn nguyên tử tương quan nhất với phần dư, và Basis Pursuit (Chen, Donoho, và Saunders 1998) nới lỏng vấn đề NP-khó L0 tìm "biểu diễn thưa nhất" thành lập trình tuyến tính L1. LASSO và Basis Pursuit về mặt toán học là hai tham số hóa của cùng một vấn đề, nhưng xuất phát từ hai cộng đồng gần như không tương tác. Suy nghĩ về tính thưa là trường hợp đầu tiên "hội tụ từ nhiều nguồn".
Khử nhiễu: khoảnh khắc tính thưa lần đầu tiên mang lại giá trị trực tiếp (1994). Khử nhiễu ngưỡng wavelet của Donoho và Johnstone biến lý thuyết trên thành một quy trình ba bước. Chuyển sang miền wavelet với phép biến đổi trực giao. Áp dụng xử lý ngưỡng mềm S_λ(w)=sign(w)·max(|w|−λ,0) với ngưỡng λ=σ√(2 log n) cho các hệ số. Chuyển trở lại miền tín hiệu bằng phép biến đổi ngược. Chìa khóa để nó hoạt động là phép biến đổi trực giao bảo toàn các tính chất thống kê của nhiễu trắng. Trong miền wavelet, nhiễu vẫn là nhiễu Gauss độc lập có phương sai bằng nhau lan tỏa đều trên tất cả các hệ số, trong khi năng lượng tín hiệu tập trung vào một số ít hệ số lớn, vì vậy chỉ cần loại bỏ các hệ số nhỏ. Toán tử xử lý ngưỡng mềm chính là toán tử gần của phạt L1, đó là lý do tại sao khử nhiễu, LASSO, sau này ISTA/FISTA (Beck và Teboulle 2009), và LISTA (Gregor và LeCun 2010, điểm khởi đầu của triển khai thuật toán), tất cả đều chia sẻ cùng một phép toán cốt lõi.
Cảm biến nén: biến tính thưa thớt từ "đo ít, nhận nhiều" (2004–2009). Cho đến lúc này, tất cả các phương pháp đều tìm kiếm biểu diễn thưa thớt với giả định dữ liệu hoàn chỉnh đã có sẵn. Candès, Romberg, Tao (2006) và Donoho (2006) đặt ra câu hỏi ngược lại: nếu biết rằng tín hiệu là k-thưa thớt dưới một cơ sở nào đó, cần bao nhiêu phép đo để khôi phục chính xác? Câu trả lời là m ≳ C·k·log(n/k) phép đo tuyến tính ngẫu nhiên, thấp hơn tốc độ Nyquist rất nhiều. Điều kiện là ma trận đo thỏa mãn Tính chất Isometry Hạn chế (RIP), nghĩa là bảo tồn gần như độ dài của tất cả các vectơ 2k-thưa thớt. Candès (2008) cung cấp điều kiện đủ δ₂ₖ < √2−1 ≈ 0,414, và Donoho với Tanner (2009) sử dụng hình học tổ hợp để đặc trưng hóa sự chuyển pha sắc nét giữa thành công và thất bại của khôi phục L1. Ý nghĩa lịch sử của cảm biến nén là nó nâng tính thưa thớt từ "tính chất biểu diễn" lên thành "nguyên tắc lấy mẫu" và trực tiếp thay đổi thiết kế phần cứng hình ảnh. Lustig, Donoho, Pauly (2007) đưa nó vào MRI, rút ngắn thời gian quét bằng cách đổi lấy các quỹ đạo lấy mẫu dưới ngẫu nhiên. Duarte et al. (2008) chế tạo máy ảnh một điểm ảnh, và trong thiên văn học vô tuyến, đường ống SMILI sử dụng chính quy hóa L1 và biến đổi toàn phần để chụp ảnh lỗ đen trong Sự kiện Chân trời Sự kiện.
Học từ điển và mã hóa thưa thớt: từ cơ sở cố định đến cơ sở học (1996–2012). Sóng con là cơ sở cố định được thiết kế bởi con người và không nhất thiết tối ưu cho dữ liệu cụ thể. Olshausen và Field (1996) học từ điển từ dữ liệu và tái tạo lại các trường tiếp nhận V1. K-SVD (Aharon, Elad, và Bruckstein 2006) cung cấp một thuật toán thực tế thay thế giữa mã hóa thưa thớt và cập nhật SVD từng nguyên tử. Lee, Battle, Raina, Ng (2007) tăng tốc độ mã hóa thưa thớt L1 và thúc đẩy "học tự dạy". Le et al. (2012) xếp chồng bộ tự động mã hóa thưa thớt lên tới 9 lớp, 1 tỷ kết nối, và học các nơ-ron chọn lọc khuôn mặt mèo một cách không giám sát từ 10 triệu khung hình YouTube. Sau AlexNet năm 2012, dòng này bị che khuất bởi mạng tích chập có giám sát trong 10 năm, nhưng để lại hai điều: khung biểu diễn "từ điển quá hoàn chỉnh + hệ số thưa thớt" và niềm tin rằng "từ điển có thể học từ dữ liệu". Khi Anthropic vào năm 2023 giải mã các đặc trưng nội bộ của mô hình quy mô lớn bằng bộ tự động mã hóa thưa thớt, chính Olshausen và Field là những người họ trích dẫn, và Olshausen chính mình là đồng tác giả của các bài báo liên quan.
Hạng thấp: đặc tính kép của tính thưa thớt (1936–2014). Eckart và Young (1936) chứng minh rằng SVD cắt ngắn là xấp xỉ hạng thấp tốt nhất của ma trận. Hạng thấp và tính thưa thớt về cấu trúc là đẳng cấu. Cả hai đều "tập trung năng lượng vào một số thành phần ít ỏi và cắt bỏ phần đuôi", nhưng tác động tới những đối tượng khác nhau: tính thưa thớt cắt các tọa độ, trong khi hạng thấp cắt các hướng. Gavish và Donoho (2014) đưa ra ngưỡng cứng tối ưu để loại bỏ nhiễu hạng thấp, điều này vang vọng với ngưỡng phổ quát của loại bỏ nhiễu sóng con. PCA Mạnh (Candès et al. 2011) kết hợp cả hai: Dữ liệu = Hạng thấp + Thưa thớt. Sự phân biệt này trở nên cực kỳ quan trọng ở chương "Hiện tại". MLA của DeepSeek là nén hạng thấp, và DSA với CSA2 mới thực sự là chú ý thưa thớt. Hai loại này thường bị nhầm lẫn.
Tóm tắt: Ba di sản mà thời đại cổ điển để lại cho học sâu
Thứ nhất, tìm ra cơ sở đúng đắn quan trọng hơn xử lý dữ liệu. Cùng một hình ảnh sẽ dày đặc ở cơ sở điểm ảnh nhưng thưa thớt ở cơ sở sóng con. Toàn bộ sự khác biệt nằm ở cách mô tả. Thứ hai, chỉ có ba phép toán tạo ra các số không: ngưỡng mềm (L1), ngưỡng cứng (L0), và giữ lại k phần tử lớn nhất (chiếu lên quả cầu L0). Thứ ba, chỉ tính thưa thớt được cấu trúc hóa mới đạt tới phần cứng và tiêu chuẩn công nghiệp. Cấu trúc cây sóng con đi vào JPEG2000, lấy mẫu dưới ngẫu nhiên đi vào sản phẩm MRI. Ba di sản này đều tái xuất hiện trong "thời đại mạng nơ-ron" và "hiện tại" với hình dáng mới.
Thời đại Mạng nơ-ron (1990–2022): Sự thất bại và điểm quay của tính thưa thớt
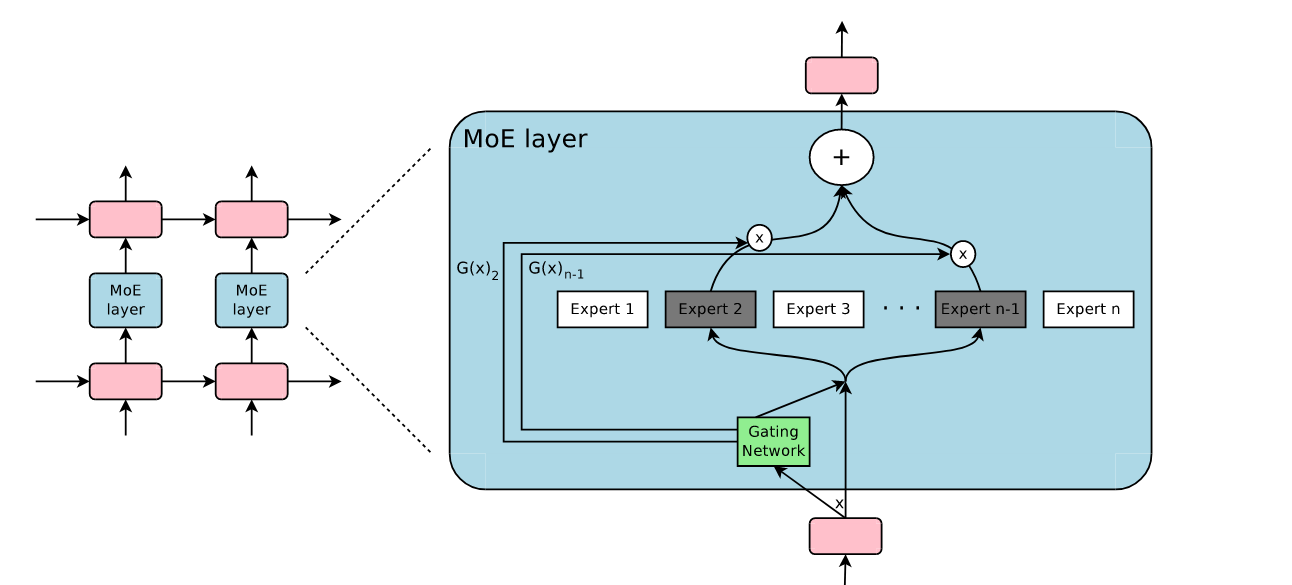
Tính thưa thớt không phải bị thất bại. Mà là tính thưa thớt không phù hợp với phần cứng đã thất bại. Cắt tỉa trọng số phi cấu trúc thành công trong lý thuyết nhưng thất bại trên GPU. MoE đã đơn vị hóa phần thưa thớt thành các khối chuyên gia nguyên vẹn, giữ nguyên tích ma trận dày đặc bên trong từng chuyên gia, do đó nó trúng số may mắn phần cứng. Chương này giải thích tại sao.
Hệ tư tưởng cắt tỉa và "tường thưa thớt"
OBD (LeCun, Denker & Solla 1990) ước tính tầm quan trọng của từng trọng số từ thông tin bậc hai, OBS (Hassibi & Stork 1993) tinh chỉnh điều này bằng ma trận Hessian đầy đủ. Deep Compression (Han, Mao & Dally 2016) kết hợp cắt tỉa, lượng tử hóa, và mã hóa Huffman, nén AlexNet từ 240 MB xuống 6,9 MB. Giả thuyết Xổ số (Frankle & Carbin 2019) cho thấy rằng bên trong một mạng dày đặc tồn tại một mạng con thưa thớt mà ngay cả khi học riêng lẻ cũng đạt được độ chính xác tương tự. SparseGPT (Frantar & Alistarh 2023) và Wanda (Sun et al. 2023) chứng minh rằng các mô hình lớp GPT có thể được cắt tỉa một lần với 50% thưa thớt mà hầu như không mất độ chính xác.
Tuy nhiên, khi thời đại LLM đến, dòng này gặp một bức tường. Bài báo ELSA tháng 10 năm 2025 (arXiv:2510.01650) gọi đó là "tường thưa thớt". Các phương pháp hiện tại "dường như không thể vượt qua 50–60% thưa thớt mà không làm giảm đáng kể độ chính xác". ELSA tuyên bố rằng sử dụng ADMM có thể cắt tỉa LLaMA-2-7B tới gần 90%, nhưng tuyên bố này vẫn còn trong thảo luận.
Tính thưa thớt kích hoạt: Những con số thực tế của ReLU
Glorot, Bordes, Bengio (2011, AISTATS) là tài liệu chính về tính thưa thớt kích hoạt, và những con số đó đáng được trích dẫn một cách chính xác. Ngay sau khi khởi tạo đều, khoảng 50% các đơn vị ẩn xuất các số không chính xác. Sau huấn luyện, tỷ lệ thưa thớt chính xác trung bình là 83,4% trên MNIST, 72,0% trên CIFAR10, 68,0% trên NISTP, 73,8% trên NORB. Kết luận là "tỷ lệ thưa thớt của các mô hình khái quát tốt nhất nằm trong khoảng 50% đến 80%", và có thể ép buộc thưa thớt tới khoảng 85% mà không mất hiệu suất. Tuyên bố "ReLU là 90% thưa thớt" không có bằng chứng từ tài liệu gốc.
Nhân tiện, hãy làm rõ một sự phân biệt. Dropout là chính quy hóa ngẫu nhiên được áp dụng trong quá trình huấn luyện, còn trong suy luận, mạng lưới trở nên dày đặc. Cắt tỉa xóa vĩnh viễn các trọng số. Cả hai đều có thể được viết dưới dạng "áp dụng mặt nạ", nhưng tính ngẫu nhiên của mặt nạ, giai đoạn tác động, và mục đích hoàn toàn khác nhau.
Tại sao tính thưa thớt trọng số phi cấu trúc lại thất bại ở thời đại GPU
Xổ số phần cứng. Theo định nghĩa của Hooker (The Hardware Lottery, 2020/2021), một ý tưởng nghiên cứu chiến thắng không phải vì nó là ý tưởng xuất sắc, mà vì nó phù hợp với phần mềm và phần cứng sẵn có. GPU và TPU được thiết kế cho tích ma trận dày đặc và liên tục. Tính thưa thớt phi cấu trúc đưa vào các phép gather/scatter, phá vỡ luồng dữ liệu tiled của GEMM, giảm tái sử dụng bộ nhớ cache trên chip, và thường không thể sử dụng tensor core. Theo kinh nghiệm, các thư viện như cuSPARSE chỉ cho thấy gia tốc đáng kể khi tỷ lệ thưa thớt vượt quá khoảng 90%, và ở tỷ lệ 50% thưa thớt phi cấu trúc, hầu như không tồn tại hạt nhân được tạo sẵn nào có thể vượt trội GEMM dày đặc trên GPU.
Tính thưa thớt có cấu trúc 2:4. GPU từ Ampere trở đi hỗ trợ mẫu trong đó chính xác 2 trong 4 trọng số là không, và nếu mẫu được thỏa mãn, thông lượng lý thuyết sẽ tăng gấp đôi. Tuy nhiên, tỷ lệ thưa thớt đạt tối đa 50% và khôi phục độ chính xác yêu cầu huấn luyện lại hoặc tinh chỉnh, do đó gia tốc từ đầu đến cuối hiếm khi tiến gần tới 2x, nên nó không được phổ biến như lượng tử hóa trong triển khai LLM.
Tại sao lượng tử hóa thắng thế. Lượng tử hóa giảm số bit trên mỗi tham số nhưng không động chạm tới tính chất đều đặn của ma trận, do đó mọi GPU đều được hưởng lợi một cách tự nhiên. Sau GPTQ (2022) và AWQ (2023), MXFP4 trở thành định dạng gốc cho 2025–2026. gpt-oss lưu trữ trọng số MoE (hơn 90% tổng tham số) ở MXFP4 (khoảng 4,25 bit trên mỗi tham số), điều này cho phép nó nạp một mô hình 120b trên một GPU 80 GB duy nhất. Kimi K3 thực hiện học nhạy cảm lượng tử hóa (QAT) với trọng số MXFP4 và kích hoạt MXFP8, trong khi tham số chuyên gia của DeepSeek-V4 sử dụng FP4.
Tường bộ nhớ. Từ V100 đến B200, sự tăng trưởng hiệu suất tính toán đỉnh vượt xa sự tăng trưởng băng thông bộ nhớ (những con số cỡ độ dựa trên thông số kỹ thuật công bố của mỗi nhà cung cấp).
| GPU | Hiệu suất tính toán BF16/FP16 dày đặc | Băng thông HBM | Phép toán trên mỗi byte (xấp xỉ) |
|---|---|---|---|
| V100 (2017) | Khoảng 125 TFLOPS | 0.9 TB/s | 140 |
| A100 (2020) | Khoảng 312 TFLOPS | 1.6–2.0 TB/s | 155–195 |
| H100 SXM (2022) | Khoảng 989 TFLOPS | 3.35 TB/s | 295 |
| B200 (2024) | Khoảng 2,2 PFLOPS (với FP4 là khoảng 9 PFLOPS) | Khoảng 8 TB/s | 280 (với FP4 là khoảng 1.100) |
Trong quá trình giải mã, mỗi lần tạo một token, bạn phải đưa các trọng số tham gia tính toán từ GPU memory. Khi kích thước batch nhỏ, các đơn vị tính toán hầu như không hoạt động, và nút thắt cổ chai chính là băng thông. Đó là lý do tại sao "giảm FLOPs" ít giá trị hơn "giảm tham số và KV cần đọc". MoE giảm số byte trọng số đọc trên mỗi token, và sparse attention cùng KV compression giảm số byte cache. Cả hai đều cắt giảm chính xác khoản chi phí lớn nhất.
Dòng lịch sử của tính toán có điều kiện (các bước ngoặt)
1991 Adaptive Mixtures of Local Experts của Jacobs, Jordan, Nowlan và Hinton. Đây là việc huấn luyện nhiều mạng chuyên gia cùng với mạng gating, với động lực ban đầu là giảm sự can thiệp giữa các nhiệm vụ. Vào năm 1994, Jordan & Jacobs mở rộng thành MoE phân cấp.
2013 Bengio và cộng sự đề xuất tính toán có điều kiện và ước lượng gradient thông qua nơ-ron ngẫu nhiên (STE). Eigen, Ranzato và Sutskever đã thử sớm MoE trong mạng sâu.
2017 Outrageously Large Neural Networks của Shazeer và cộng sự (với Hinton và Dean là đồng tác giả). Các lớp MoE gate thưa tối đa 137B tham số được chèn vào giữa các lớp LSTM, "cải thiện sức chứa mô hình hơn 1000x với chỉ mất nhỏ về hiệu quả tính toán". Lưu ý rằng "greater than 1000x" là từ nguyên bản, và 137B là số tham số của lớp MoE.
2020–2022 GShardmang MoE đến Transformer và mở rộng quy mô đến trên 600B, Switch Transformer (Fedus, Zoph & Shazeer 2021) đạt 1 triệu tỷ tham số với top-1 routing. GLaM và ST-MoE giải quyết vấn đề ổn định (router z-loss), và Expert Choice (2022) đảo ngược phương thức bằng cách cho các chuyên gia chọn token, tự nhiên cân bằng tải.
Nói gọn lại chương này: từ 1991 đến 2022, ý tưởng tính toán có điều kiện không thay đổi. Cái thay đổi là phần cứng, và cuối cùng thì quy mô phù hợp đã đến.
MoE từ bài báo đến sản phẩm: các vấn đề kỹ thuật được giải quyết từ 2017–2022
Shazeer et al. (2017) chỉ ra rằng có thể mở rộng sức chứa lên 1000 lần, nhưng để biến MoE thành sản phẩm đáng tin cậy cần thêm 5 năm và giải quyết 4 vấn đề cụ thể.
Làm thế nào để học routing. Gate xuất ra s = Softmax(W_g·h), k chuyên gia hàng đầu được chọn, và đầu ra của lớp là y = h + Σ_{i∈T} s_i·FFN_i(h). Vấn đề là top-k là lựa chọn rời rạc, nên gradient liên quan đến s gần như bằng không ở khắp mọi nơi. Gradient chỉ đến được trọng số gate của các chuyên gia được chọn, trong khi các chuyên gia không được chọn không bao giờ có cơ hội học. Giải pháp của Shazeer là Noisy Top-k gating, thêm Gaussian noise có thể học vào logit để đôi khi chuyên gia xếp hạng k+1 cũng được chọn. Giải pháp chung hơn là Straight-Through Estimator (STE) của Bengio et al. (2013) và sau đó là Gumbel-Softmax.
Làm thế nào để cân bằng tải. Router có xu hướng "kẻ giàu thêm giàu". Các chuyên gia được chọn nhiều được học tốt hơn, do đó được chọn thêm, cuối cùng dẫn đến expert collapse khi một vài chuyên gia chiếm tất cả lưu lượng và mô hình trở thành một mô hình nhỏ (mô hình thực chất bị suy thoái). GShardvà Switch Transformer đã giới thiệu auxiliary load balancing loss L_bal = α·N·Σ f_i·P_i, trong đó f_i là tỷ lệ token được gán cho chuyên gia i, P_i là xác suất gate trung bình của nó. ST-MoE (2022) thêm router z-loss để ngăn chặn sự bùng nổ của logit. Các auxiliary loss này hoạt động nhưng làm xáo trộn gradient của hàm mục tiêu language modeling ban đầu. Vào năm 2024, DeepSeek-V3 tránh được sự đánh đổi này bằng "bias ngoài gradient" (xem chương "Hiện tại").
Làm thế nào để đặt sức chứa. Trong học phân tán, bạn phải sửa kích thước buffer của mỗi chuyên gia trước, nơi đó xuất hiện capacity factor. Sức chứa trên mỗi chuyên gia = capacity_factor × (số token / N). Các token vượt quá sức chứa bị bỏ (token dropping) và chỉ đi qua residual connection. Capacity factor lớn làm lãng phí bộ nhớ, nhỏ làm giảm chất lượng. MegaBlocks (2023) xây dựng MoE "dropless" với multiply tích ma trận block-sparse, thoát khỏi tình thế này.
Làm thế nào để sống sót trong truyền thông. Các chuyên gia được đặt trên các GPU khác nhau (expert parallelism), mỗi lớp MoE yêu cầu hai lần all-to-all exchange phụ thuộc dữ liệu. Gửi token đến GPU nơi có chuyên gia, rồi thu thập kết quả. Đây là nút thắt cổ chai truyền thông chính trong huấn luyện MoE, cũng là lý do MoE thích hợp với triển khai quy mô lớn tập trung. Từ DeepSpeed-MoE và Tutel đến DeepEP của DeepSeek, tất cả các hệ thống này đều tối ưu hóa đường dẫn này.
Các cột mốc: GShard (2020) mang MoE đến Transformer với trên 600B. Switch Transformer (2021) đạt 1 triệu tỷ tham số với top-1 routing và tiền huấn luyện nhanh hơn T5-XXL 4 lần. GLaM (2021) có 1.2T tham số tổng cộng, ~97B activation, tiêu thụ năng lượng chỉ bằng khoảng 1/3 GPT-3. Expert Choice (2022) đảo chiều bằng cách cho các chuyên gia chọn token, cân bằng tải một cách tự nhiên.
Tại sao MoE trước năm 2022 chưa thành dòng chính
Dù có tất cả những giải pháp kỹ thuật này, MoE năm 2022 vẫn chỉ là "đồ chơi của các công ty lớn" bên trong Google. Có 3 lý do. Thứ nhất, áp lực chi phí chưa đủ mạnh. Ở thời đại GPT-3, các mô hình dense vẫn tiến bộ nhanh chóng, chi phí suy luận không phải là ràng buộc chính. Thứ hai, không có hệ sinh thái mở. Không tồn tại MoE trọng số mở chất lượng cao, cộng đồng không thể tái hiện hay cải thiện. Thứ ba, fine-tuning khó khăn. Trên các tập dữ liệu nhỏ, routing dễ sụp đổ, và thích ứng với các tác vụ hạ nguồn không mượt mà như mô hình dense.
3 điều kiện này đồng loạt thay đổi vào cuối năm 2023. Mixtral 8x7B (tháng 12 năm 2023) trở thành MoE mở chất lượng cao đầu tiên, lưu lượng ở quy mô ChatGPT biến chi phí suy luận thành vấn đề cấp bách nhất, và DeepSeekMoE (tháng 1 năm 2024) nâng hiệu quả chi phí của MoE lên mức mới với các chuyên gia hạt mịn và chuyên gia dùng chung. Từ đây "Hiện tại" bắt đầu.
Tóm tắt
3 dòng lịch sử trong chương này – pruning, sparse activation, tính toán có điều kiện – đã gặp những vận mệnh hoàn toàn khác nhau trước năm 2022. Pruning thành công trong lý thuyết nhưng thất bại trong phần cứng. Sparse activation (ReLU) được sử dụng ở khắp mọi nơi nhưng hầu như không được tận dụng ở đâu. Tính toán có điều kiện có tất cả mọi thứ, chỉ thiếu áp lực kinh tế. Hiểu được sự khác biệt này giúp bạn thấy tại sao người chiến thắng sau năm 2023 lại là MoE thay vì weight pruning. Liệu có thể đưa sparsity vào thực tế hay không phụ thuộc vào việc liệu các số không của nó có cấu trúc mà phần cứng có thể khai thác được hay không.
Hiện tại (2023–26 tháng 9): Tại sao LLM lại đặt toàn bộ cược vào sparsity
Đến năm 2026, tỷ lệ activation trên mỗi token của các mô hình mở tiên tiến sẽ giảm xuống 1,5%–4,5%, và sparsity sẽ lan rộng từ FFN sang attention, KV cache, và thậm chí chính việc lưu trữ kiến thức. Chương này trước hết trình bày 4 áp lực, sau đó liệt kê 5 loại sparsity, cuối cùng đi vào lý thuyết thống nhất và kinh tế.
Tại sao bây giờ: 4 áp lực
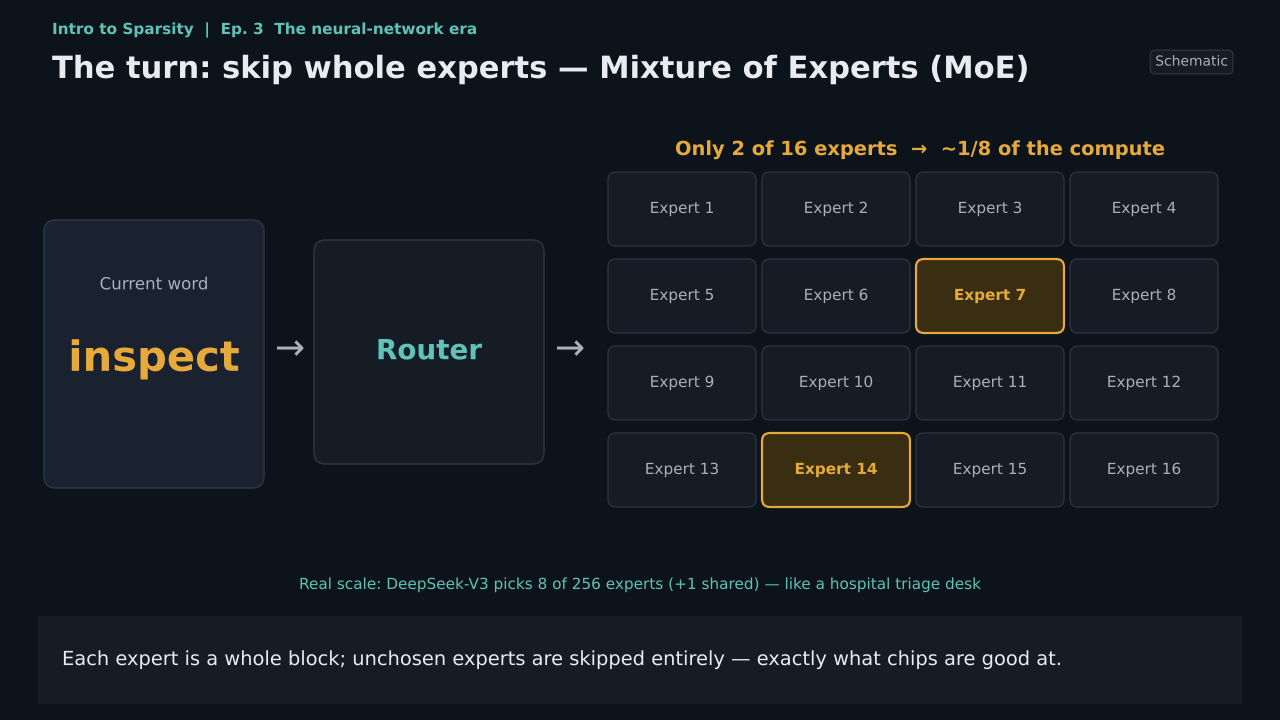
Scaling đã chạm vào tường chi phí. Tổng tham số đã đạt vùng 1–3T (DeepSeek-V4-Pro là 1,6T, Kimi K3 là 2,8T), học và suy luận với mô hình dense không còn khả thi về mặt kinh tế.
Chi phí suy luận đã vượt chi phí học. Trong tổng quan hệ thống suy luận ngày 1 tháng 3 năm 2025, DeepSeek tiết lộ rằng nó đang tăng kích thước batch bằng cách sử dụng expert parallelism quy mô lớn trên nhiều node và nâng hiệu quả GEMM. Điều này cho thấy kinh tế suy luận đã trở thành ràng buộc duy nhất và quan trọng nhất trong thiết kế kiến trúc.
Agent làm cho workload trở thành "input-centric". Technical report V4.1 khai vị bằng cách nói rằng với sự phổ biến của các agent chạy lâu dài, workload ngày càng bị chi phối bởi input, và KV cache khổng lồ liên tục gây áp lực lên dung lượng và băng thông truyền HBM và SSD.
Sáng tạo kỹ thuật dưới các hạn chế xuất khẩu. DeepSeek-V3 được huấn luyện với 2.048 H800, tổng cộng khoảng 2,788 triệu giờ GPU. H800 là cùng chip với H100 nhưng băng thông NVLink bị cắt từ 900 GB/s xuống 400 GB/s, điều này trực tiếp sinh ra những công việc tối ưu hóa truyền thông như DeepEP.
Tính toán có điều kiện: MoE trở thành kiến trúc mặc định
Tiến hóa của họ DeepSeek(tất cả từ báo cáo kỹ thuật chính thức, thẻ mô hình và thông báo API):
| Mô hình | Thời kỳ | Tổng tham số / Kích hoạt trên token | Cấu hình chuyên gia | Kỹ thuật thưa hóa chính |
|---|---|---|---|---|
| DeepSeekMoE | 2024-01 | — | Chuyên gia hạt mịn + chuyên gia chia sẻ | Chia nhỏ chuyên gia và tăng số kết hợp theo hàm mũ |
| V2 | 2024-05 | 236B / 21B | Chia sẻ 2 + Định tuyến 160 | MLA: Nén đồng thời hạng thấp của KV (hạng thấp, không phải thưa) |
| V3 | 2024-12 | 671B / 37B | Chia sẻ 1 + Định tuyến 256, 8 lựa chọn | Cân bằng tải không có tổn thất phụ trợ, dự đoán đa token, đào tạo FP8 |
| V3.2 | 2025-09/12 | 671B / 37B | Như trên | DSA: Lightning Indexer + Chú ý thưa top-k trên từng token (k=2048) |
| V4-Flash / V4-Pro | 2026-04-24 | 284B/13B、1.6T/49B | Chia sẻ 1 + Định tuyến 256, 6 lựa chọn / Định tuyến 384 | Xen kẽ Compressed Sparse Attention (CSA) và HCA, ngữ cảnh 1M, chuyên gia FP4 |
| V4.1-Flash | 2026-09-10 | Backbone 552B + Engram 196B, Prefill 8B / Decode 16B | Chia sẻ 1 + Định tuyến 384, 6 lựa chọn | CED、CSA2、Hierarchical Sparse Indexer、FP4 KV、Engram |
5 yếu tố thiết kế của V4.1-Flash(báo cáo kỹ thuật):
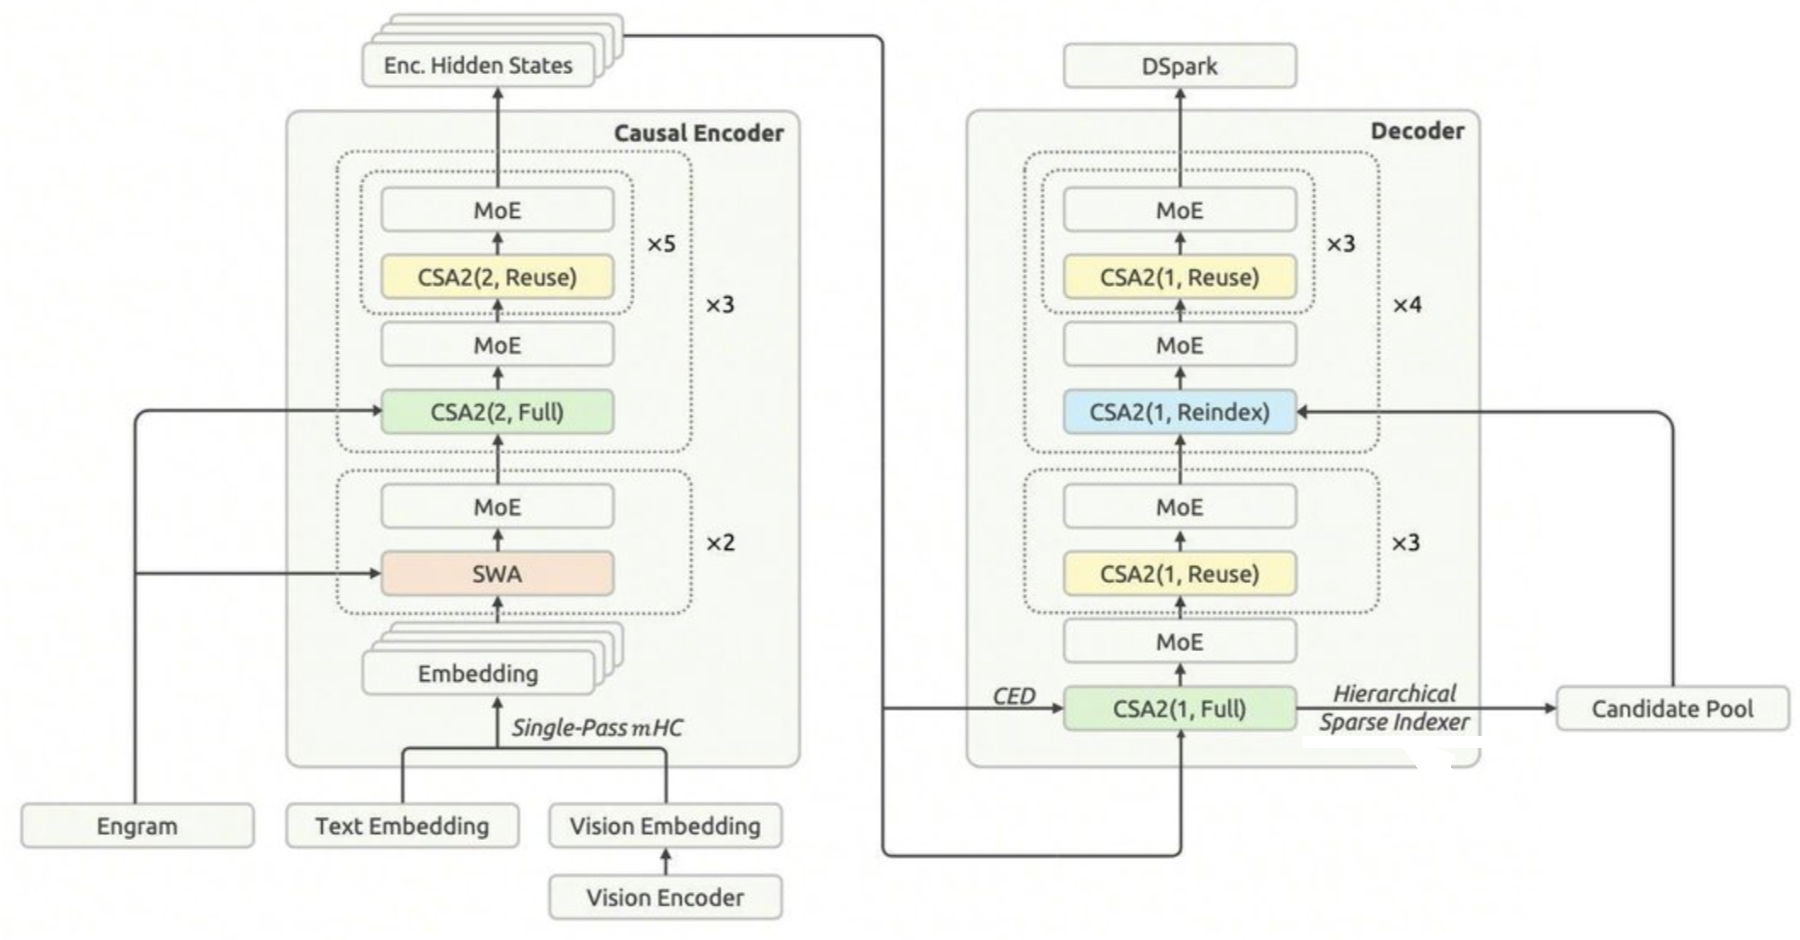
CED (Causal Encoder–Decoder). Chia 40 lớp thành 20 lớp bộ mã hóa và 20 lớp bộ giải mã, với KV toàn cầu của bộ giải mã được chiếu từ trạng thái ẩn cuối cùng của bộ mã hóa. Token đầu vào chỉ đi qua bộ mã hóa (kích hoạt 8B), token đầu ra đi qua bộ giải mã (16B). Đây là câu trả lời trực tiếp cho thực tế rằng "tác nhân đọc nhiều và viết ít".
3 chế độ của CSA2. Full tạo KV toàn cầu của riêng nó và xây dựng chỉ mục. Reindex tái sử dụng KV từ lớp trước nhưng tính toán lại top-k. Reuse tái sử dụng ngay cả chỉ mục top-k. Đa số các lớp sử dụng Reuse. Nói cách khác, đa số các lớp không chọn lại token.
Hierarchical Sparse Indexer. Lớp Full đầu tiên của bộ giải mã tạo ra nhóm ứng cử viên, và các lớp tiếp theo chỉ chọn từ nhóm đó. Chi phí tính toán chỉ mục ở các lớp sâu được tách rời khỏi độ dài ngữ cảnh.
Con số KV. KV toàn cầu là 890 byte trên mỗi token, khoảng 1/4 so với V4-Flash và 1/437 so với V1. KV được duy trì là khoảng 1/8 so với V4-Flash. Ngay cả khi mở rộng ngữ cảnh từ 4K đến 1M (256 lần), FLOP giải mã trên mỗi token chỉ tăng khoảng 1/4. Chú ý thưa được học từ đầu ở 64K, không có khởi động bằng chú ý dày đặc.
Engram conditional memory. Bảng băm n-gram khoảng 196B tham số, được truy cập thưa thông qua tra cứu trên mỗi token và có thể được đặt trên bộ nhớ máy chủ để tìm nạp trước. Nó không được kích hoạt trên tất cả các token.
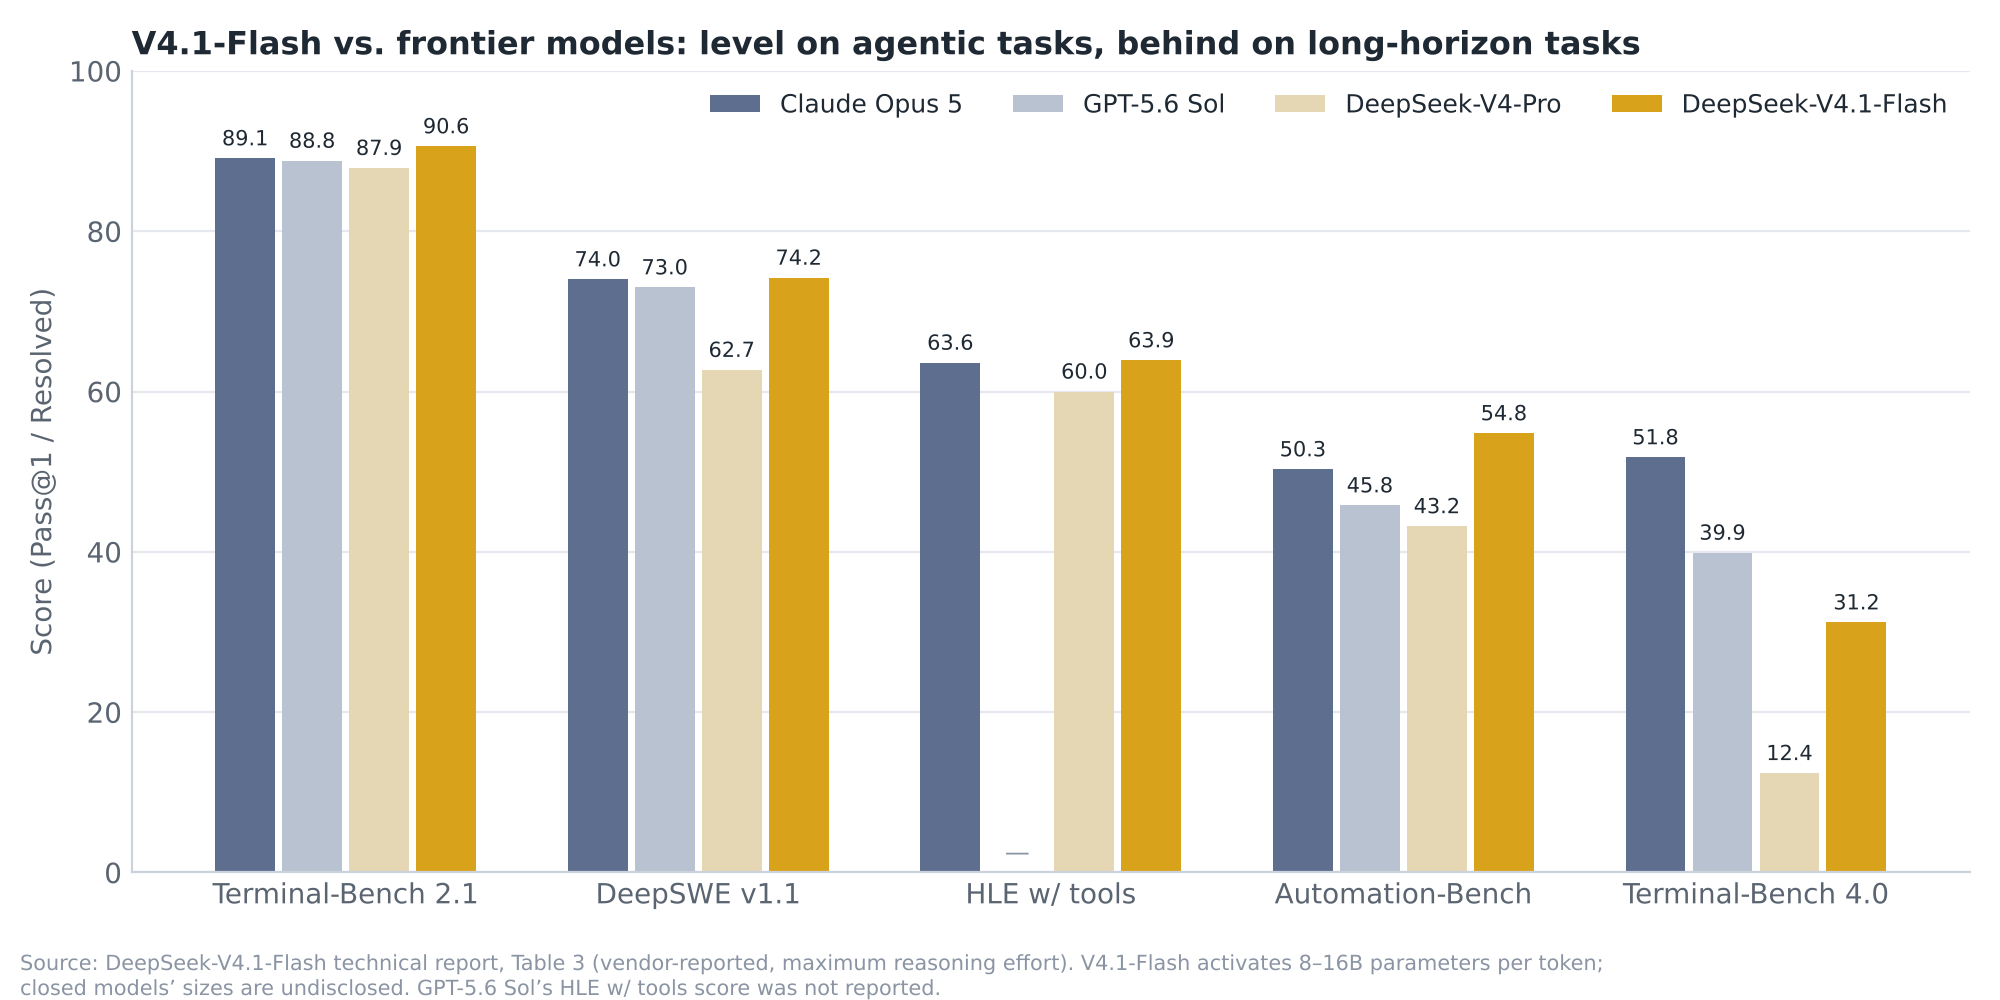
Về hiệu suất và giá cả. DeepSeek báo cáo rằng V4.1-Flash-Base đạt được mức độ của V4-Pro-Base với tổng tham số 1/3 và tham số kích hoạt 1/4. Giá cao nhất là $0,30/M cho đầu vào, $0,006/M cho đầu vào được lưu trữ trong bộ nhớ cache, và $1,20/M cho đầu ra, với giá ngoài giờ cao điểm là một nửa. Tuy nhiên, theo các chỉ số tổng hợp của bên thứ ba (40 điểm trên Artificial Analysis, Claude Opus 5 là 51 điểm), vẫn còn khoảng cách khoảng 10 điểm theo đánh giá độc lập. Phải viết riêng biệt các điểm chuẩn được nhà cung cấp chọn và đánh giá tổng hợp độc lập. Bản thân điều này là một bài học sống về cách "trung bình có thể gây hiểu lầm".
Các mô hình MoE chính khác trong giai đoạn 2025–2026(từ thẻ mô hình chính thức):
| Mô hình | Thời kỳ | Tổng cộng / Kích hoạt | Chuyên gia (lựa chọn / tổng số) | Tỷ lệ kích hoạt | Các tính năng thiết kế khác |
|---|---|---|---|---|---|
| Mixtral 8x7B | 2023-12 | 46.7B / 12.9B | 2/8 | Khoảng 28% | MoE mở nguồn chất lượng cao đầu tiên |
| gpt-oss-120b | 2025-08 | 116.8B / 5.1B | 4/128 | 4.4% | Trọng số MoE MXFP4, xen kẽ sliding window và toàn bộ chú ý, attention sink |
| Qwen3-235B-A22B | 2025-04 | 235B / 22B | 8/128 | 9.4% | — |
| Qwen3.5-397B-A17B | 2026-02 | 397B / 17B | 10+1 / 512 | 4.3% | Trộn Gated DeltaNet linear attention 3:1, giảm KV khoảng 1/4 |
| Kimi K2 / K2.5 | 2025-07 / 2026-01 | 1.04T / 32B | 8+1 / 384 | 3.1% | MuonClip, không có tăng mất với 15,5T token |
| Kimi K3 | 2026-07 | 2.8T / 104B | 16 / 896, chia sẻ 2 | 3.7% | KDA linear attention + Gated MLA, MXFP4 QAT |
| Llama 4 Maverick | 2025-04 | Khoảng 400B / 17B | 1 + chia sẻ 1 / 128 | 4.3% | Xen kẽ lớp dày đặc và lớp MoE |
| DeepSeek-V4.1-Flash | 2026-09 | 552B / 8–16B | 6+1 / 384 | 1.4%–2.9% | Như đã nói ở trên |
Xu hướng như thế này. Trong 2 năm, lĩnh vực này đã chuyển từ "8 chuyên gia, chọn 2, kích hoạt 25%" sang "hàng trăm đến gần 1.000 chuyên gia, chọn 6–16, kích hoạt 1,5%–4,5%", và mức độ thưa tăng khoảng 1 bậc mỗi 1–1,5 năm. Chuyên gia chia sẻ đã trở thành tiêu chuẩn, và định tuyến sử dụng bias không có tổn thất phụ trợ, định tuyến băm (3 lớp đầu tiên của V4) và định tuyến không gian tiềm ẩn (K3). Trong các mô hình đóng, Google đã thừa nhận chính thức rằng Gemini 1.5 và họ Gemini 2.5 là MoE thưa. "1,8T MoE" của GPT-4 chỉ là đồn đại từ năm 2023, và cấu hình của GPT-5.x và Claude là bí mật. Nếu viết, tối đa là "theo báo cáo".
Thưa hóa chú ý và KV cache
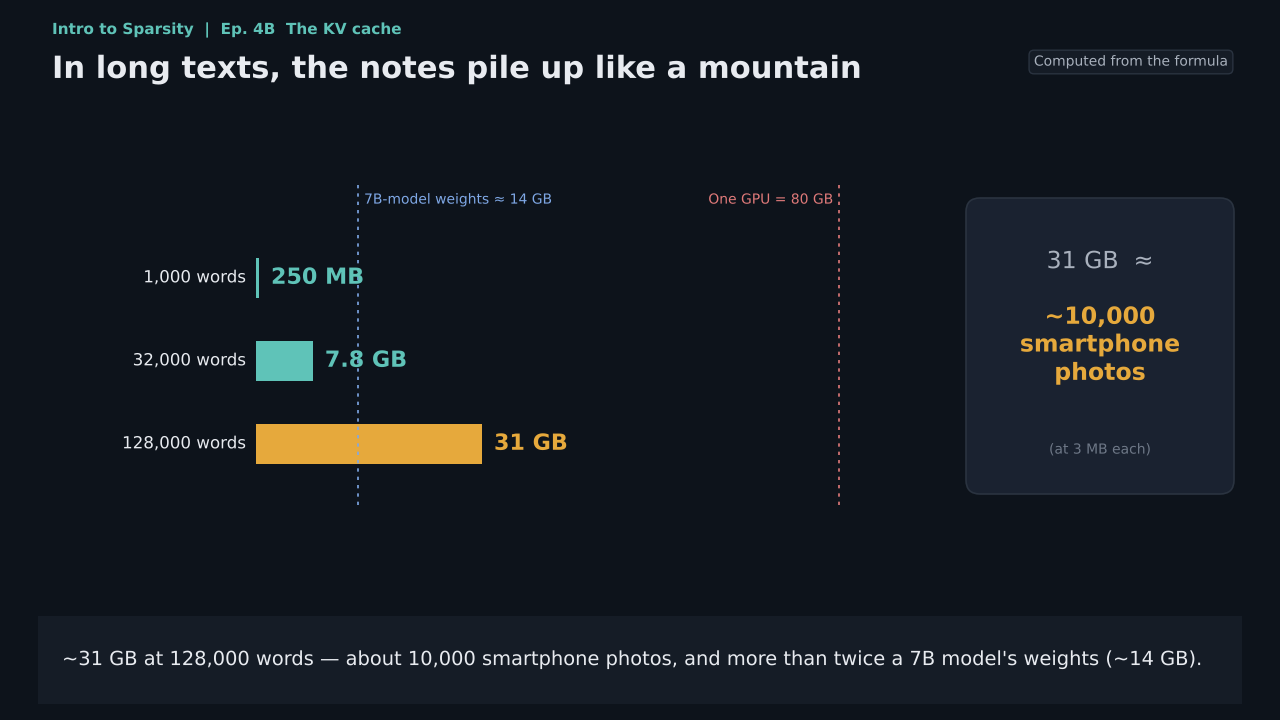
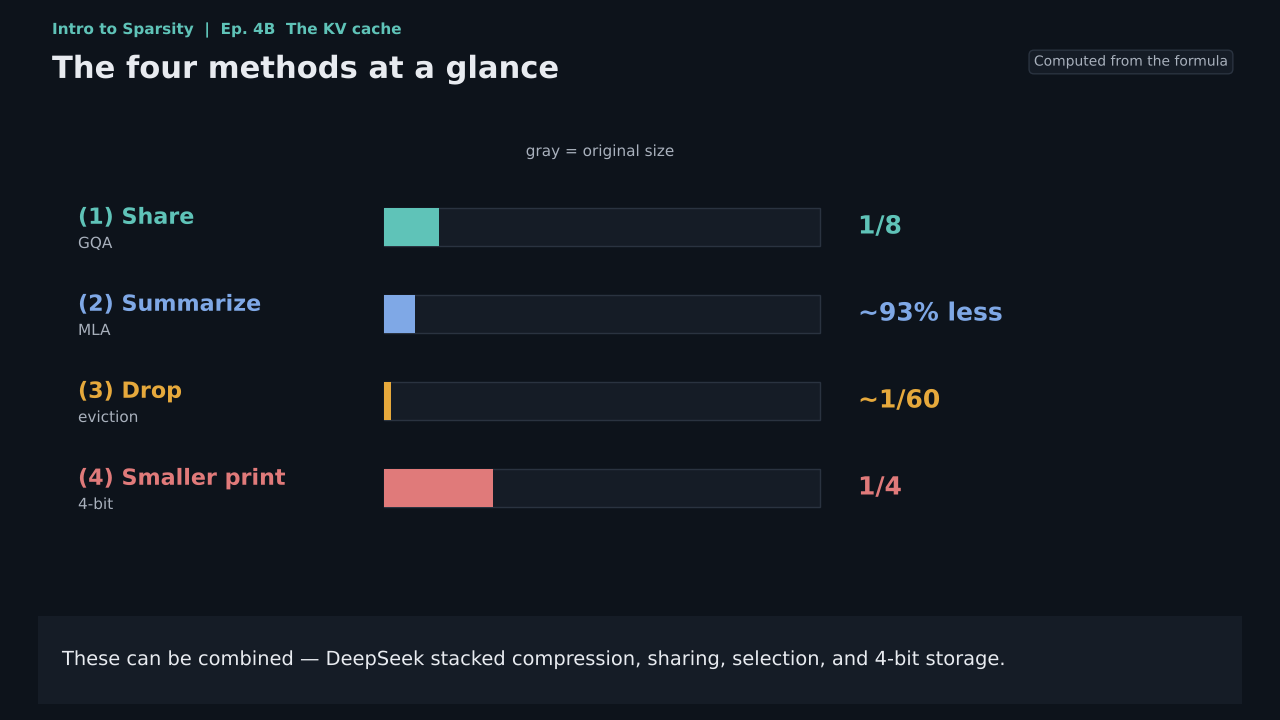
Kích thước KV cache = 2 × L × số lớp × số head KV × chiều head × byte mỗi phần tử. Thay 64 lớp, 8 head KV, chiều head 128, FP16, ngữ cảnh 128K, ta được khoảng 31 GiB. Lớn hơn trọng số của hầu hết các mô hình, và toàn bộ nó phải được đọc lại mỗi khi tạo 1 token. Có 3 cách đối phó. Giảm số head KV (GQA/MQA), nén hạng thấp (MLA), hoặc thưa hóa thay thế hoặc tính toán thưa.
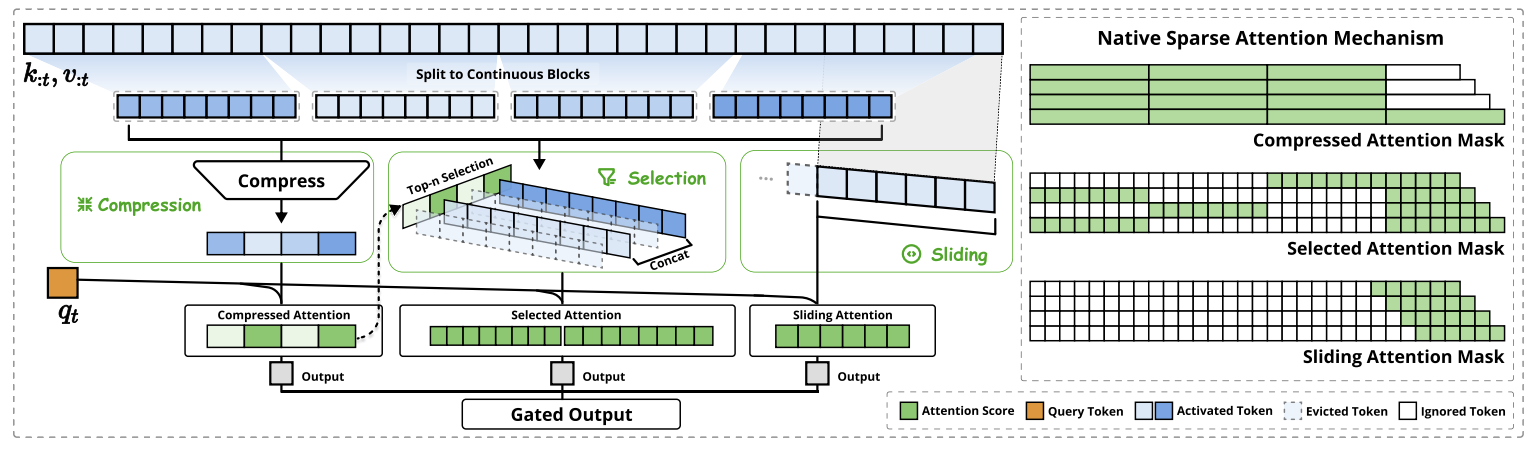
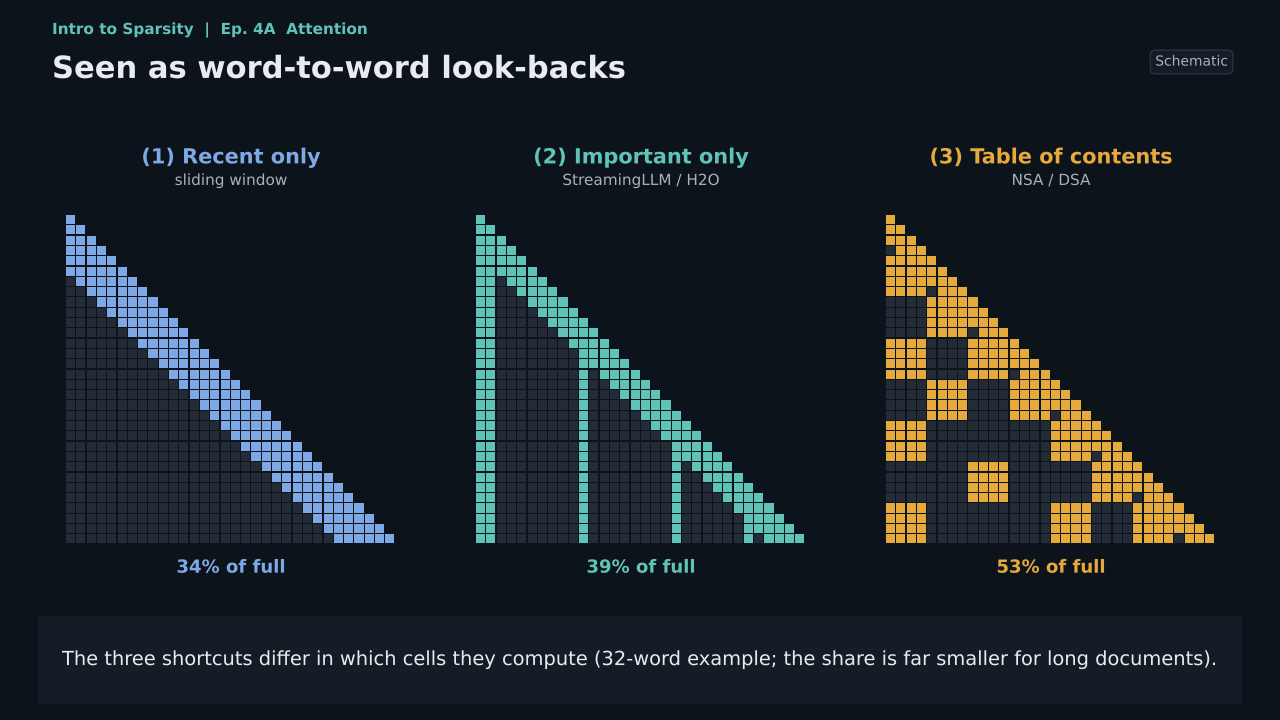
Chú ý thưa có 3 thế hệ và có thể được xếp chồng. Thế hệ 1 là mô hình cố định (Longformer, BigBird, sliding window của gpt-oss). Thế hệ 2 là thay thế động ở thời suy luận không cần huấn luyện lại (StreamingLLM, H2O, SnapKV, Quest). Thế hệ 3 học thưa hóa từ đầu một cách nguyên sinh (NSA, MoBA, DSA, CSA2). NSA (Yuan et al., DeepSeek × Đại học Bắc Kinh × Đại học Washington) đã giành Giải thưởng Best Paper Award của ACL 2025, đạt được tăng tốc độ toàn bộ chú ý ở độ dài 64K, decode 11,6 lần, forward pass 9,0 lần, backward pass 6,0 lần.
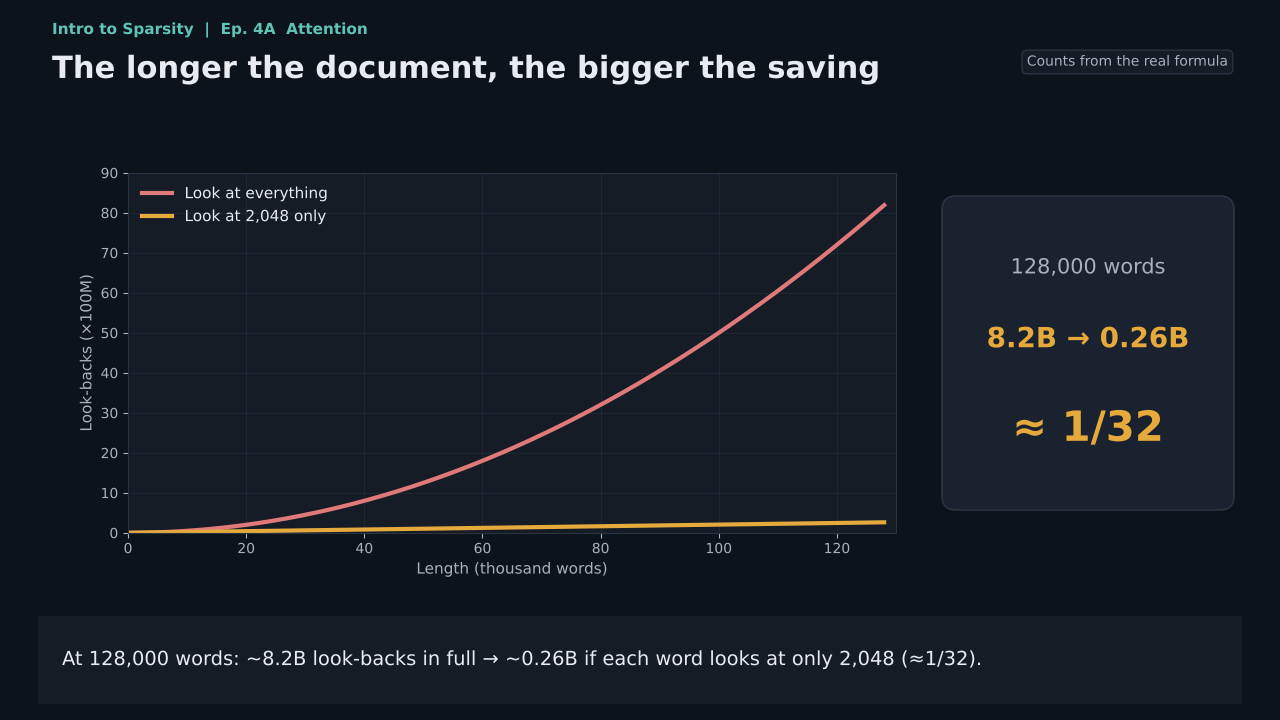
Nước lạnh từ các phép đo quy mô lớn. The Sparse Frontier của Nawrot et al. (arXiv:2504.17768, chính thức được công bố tại Findings of ACL 2026) đánh giá chú ý sparse không cần huấn luyện trên Qwen2.5 từ 7B đến 72B, 16K đến 128K, trên 9 tác vụ và đạt 4 kết luận. Với các chuỗi rất dài, "lớn và sparse" thắng "nhỏ và dày đặc", điểm giao cắt nằm gần 32–64K. Tỷ lệ sparse tối ưu cho prefill là 0.80–0.93 (theo ngân sách là 1/5 đến 1/15), còn decode có khả năng chịu đựng cao hơn. Hầu như mọi cấu hình đều chịu sự suy giảm hiệu suất lớn ở ít nhất một tác vụ. Chú ý sparse không phải là liều thuốc chữa được tất cả. Và không có một chiến lược duy nhất tốt nhất cho mọi tác vụ và giai đoạn. Kết quả này chính là động lực tạo ra thế hệ thứ ba "sparsity có thể huấn luyện native".
Sparsity trong kích hoạt
Q-Sparse (Wang, Ma, Wang & Wei, arXiv:2407.10969) áp dụng top-k trực tiếp vào kích hoạt của tất cả các lớp tuyến tính, lan ngược với STE, và chứng minh quy luật tỷ lệ sparsity. Tỷ lệ sparse tối ưu là khoảng 45.58% cho mô hình độ chính xác đầy đủ, 61.25% cho mô hình 1.58 bit, và ở tỷ lệ sparse khoảng 40% sẽ sánh được với mô hình dày đặc cùng kích thước. Khi huấn luyện thêm Mistral 7B với 40B token, Q-Sparse ghi được 63.7 với kích hoạt 3.8B, gần bằng 64.6 của đường cơ sở dày đặc (7.0B). Các phép loại bỏ cho thấy loại bỏ STE hoặc thay top-k bằng ReLU đều gây ra suy giảm hiệu suất rõ ràng. Hơn nữa, với ReLU, tỷ lệ sparse giảm khi huấn luyện tiến hành, trong khi với top-k nó được giữ ổn định. Điều này ủng hộ luận điểm "sparsity nên là ràng buộc kiến trúc chứ không phải điều khoản điều chỉnh". TEAL, ReLU Strikes Back, Deja Vu, PowerInfer là các hệ thống chính của phía cạnh.
Sparsity trong khả năng diễn giải: sự phát triển và nghi ngờ của SAE
Bước đi của Anthropic như sau. Towards Monosemanticity (2023) sử dụng sparse autoencoder để trích xuất các tính năng đơn ngữ từ mô hình một lớp. Scaling Monosemanticity (2024) đã huấn luyện SAE với tới 34 triệu tính năng trên Claude 3 Sonnet, chứng minh cách cài đặt tính năng trên Golden Gate Claude. Circuit Tracing và On the Biology of a Large Language Model (2025) xây dựng các đồ thị gán trách nhiệm với bộ mã hóa chéo lớp, truy vết suy luận đa bước của Claude 3.5 Haiku. Tại OpenAI, Gao et al. (2024) đã huấn luyện TopK SAE với 16 triệu tính năng trên GPT-4. Hệ thống này là con cháu trực tiếp của học từ điển Olshausen–Field.
Các nghi ngờ đổ về hàng loạt vào 2024–2025. Hấp thu tính năng (Chanin et al. 2024). Tính năng một chiều và phi tuyến (Engels et al. 2024). Không thắng được đường cơ sở hồi quy logistic trên 113 bộ dữ liệu thăm dò (Kantamneni et al. 2025). SAE khác nhau tìm thấy các tính năng khác nhau (Leask et al. 2025). Vào tháng 3 năm 2025, đội cơ học khả năng diễn giải của Google DeepMind công bố rằng lĩnh vực này đã quá đầu tư vào SAE và "sẽ hạ thấp mức độ ưu tiên nghiên cứu cơ bản SAE trong thời gian tới". Một sự đồng thuận tương đối ôn hòa là SAE phù hợp để phát hiện các khái niệm chưa biết nhưng không phù hợp như bộ phát hiện hoặc bộ điều khiển các khái niệm đã biết. Mặc dù các nghiên cứu mới như SharedSAE và WriteSAE vẫn tiếp tục xuất hiện vào năm 2026, chưa có sự đồng thuận thống nhất mới.
Lý thuyết thống nhất: 3 toán tử và học top-k
Dù là LASSO, pruning, SAE hay MoE routing, bước "tạo ra các số 0" đều là một trong 3 toán tử này.
Sλ(y) = sign(y) · max(|y| − λ, 0), Hτ(y) = y · 1[|y| > τ], Pk(y) = phép chiếu giữ lại chỉ k thành phần có giá trị tuyệt đối lớn nhất
Thresholding mềm là toán tử gần L1 (LASSO, ISTA, khử nhiễu wavelet, SAE có phạt L1). Thresholding cứng tương ứng với L0 (pruning theo độ lớn, JumpReLU SAE). Và top-k là phép chiếu lên tập hợp các vectơ k-sparse (MoE routing, sparse attention, TopK SAE, Q-Sparse). Chính ReLU là thresholding cứng một phía với τ=0. Hầu như tất cả các mô hình lớn hiện đại sử dụng loại thứ ba vì nó có thể cố định lượng tính toán trên mỗi token thành một hằng số chính xác, cho phép lập kế hoạch bộ nhớ tĩnh và các nhân chuyên biệt. Trong thời đại của các mô hình lớn, sparsity đã thay đổi từ "điều khoản điều chỉnh" thành "ràng buộc kiến trúc".
Top-k không khả vi. Vì ∂TopK/∂s gần như bằng không ở khắp nơi, nên gradient chỉ đến được các trọng số cổng của các chuyên gia được chọn, còn lại không thể học. Có 4 cách xử lý kỹ thuật. Lan ngược chỉ trên các chuyên gia được chọn và thêm hàm mất cân bằng phụ trợ (cách tiếp cận chính thống). Thêm nhiễu với Noisy Top-k để tạo khám phá (Shazeer 2017). Các phương pháp nới lỏng liên tục như STE, Gumbel-Softmax, Soft MoE. Và phương pháp bias không có hàm mất phụ trợ từ DeepSeek-V3 trở đi, tức là xếp hạng với s+b nhưng cân nặng với s, b được điều chỉnh bên ngoài gradient theo tải. Ở phía sparse attention, NSA lựa chọn ở cấp khối để gradient chảy, DSA trước tiên làm ấm lên với dense attention, căn chỉnh bộ chỉ mục với phân bố dense attention, rồi chuyển sang học sparse.
Về quy luật tỷ lệ, Clark et al. (2022) thống nhất tỷ lệ mô hình định tuyến và đề xuất 64–128 chuyên gia. Krajewski et al. (2024) chỉ ra rằng các chuyên gia chi tiết thắng mô hình dày đặc ở mọi ngân sách tính toán. Frantar et al. (2023) phát hiện rằng tỷ lệ sparse trọng số tối ưu tăng theo lượng dữ liệu. Bài báo Engram của DeepSeek (arXiv:2601.07372, tháng 1 năm 2026) đặt ra vấn đề "phân bổ ngân sách sparsity", tìm thấy quy luật hình chữ U. MoE thuần túy không tối ưu; kết quả tốt nhất đạt được khi phân bổ khoảng 20–25% ngân sách tham số sparse cho bộ nhớ có điều kiện. Chín tháng sau, phát hiện này được tích hợp vào sản phẩm V4.1.
Kinh tế và ngành công nghiệp
Cú sốc DeepSeek. Ngày 27 tháng 1 năm 2025, Nvidia giảm khoảng 17% lúc đóng cửa, mất đi vốn thị trường khoảng 589 tỷ đô la (Bloomberg) đến 593 tỷ đô la (Reuters). Đây là sự mất mát vốn thị trường tính trên một ngày lớn nhất trong lịch sử thị trường chứng khoán Mỹ.
Tỷ suất lợi nhuận lý thuyết 545%. Ngày 1 tháng 3 năm 2025, DeepSeek công bố rằng nếu tính H800 ở 2 đô la một giờ thì chi phí hàng ngày là 87.072 đô la, và nếu tính tất cả theo giá R1 thì doanh thu hàng ngày lý thuyết là 562.027 đô la. Công bố cũng nêu rõ rằng doanh thu thực tế thấp hơn nhiều, và không tính chi phí nghiên cứu phát triển hoặc chi phí huấn luyện. Khi trích dẫn con số này, hãy luôn thêm từ "lý thuyết".
Giá suy luận. Epoch AI (tháng 3 năm 2025) chỉ ra rằng giá suy luận ở cùng một mức độ năng lực đang giảm ở tốc độ từ 9 lần đến 900 lần mỗi năm, và tốc độ thay đổi tùy theo tác vụ. Tuy vậy, tổng chi trả của các doanh nghiệp vẫn tiếp tục tăng. Đó là vì các agent tăng số lần gọi trên mỗi tác vụ lên nhiều lần.
Kinh tế học suy luận MoE. Bộ nhớ được xác định bởi tổng số tham số, và chỉ khi có batch lớn và song song hóa chuyên gia thì mỗi chuyên gia mới nhận được đủ token. MoE về bản chất phù hợp với dịch vụ tập trung quy mô lớn, không phù hợp với self-hosting nhỏ. vLLM và SGLang đều hỗ trợ MLA, DSA, V4.1 từ ngày công bố.
So sánh có hệ thống cách tiếp cận của các cơ quan nghiên cứu
Khi xếp các cơ quan nghiên cứu theo cùng một tiêu chuẩn, có thể thấy rằng con đường hướng tới sparsification không chỉ có một, mà có nhiều chiến lược cạnh tranh song song.
| Cơ quan nghiên cứu | Công bố cấu hình | Loại sparsity chính | Chuyên gia (được chọn / tổng số) | Chiến lược chú ý | Chiến lược KV | Định dạng trọng số | Mô hình đại diện | Các tính năng nổi bật |
|---|---|---|---|---|---|---|---|---|
| DeepSeek | Công bố kèm báo cáo kỹ thuật | MoE + sparse attention + bộ nhớ có điều kiện | 6/384 + 1 được chia sẻ | Sparsity native (DSA→CSA2), huấn luyện sparse từ đầu | MLA hạng thấp + FP4 + tái sử dụng giữa các lớp, 890 B/token | Chuyên gia FP4/FP8 | V3, V3.2, V4, V4.1-Flash | Xếp chồng sparsity trên 3 trục. Phân công encoder-decoder cho agent |
| Moonshot (Kimi) | Công bố trọng số và báo cáo | MoE + hybrid attention tuyến tính | 16/896 + 2 được chia sẻ | Block sparse MoBA. K3 là KDA linear attention + Gated MLA | Lớp tuyến tính không có KV | MXFP4 QAT | K2, K2.5, K3 | Số lượng chuyên gia lớn nhất. Học ổn định bằng MuonClip |
| Alibaba (Qwen) | Công bố model card | MoE + hybrid attention tuyến tính | 10/512 + 1 được chia sẻ | Gated DeltaNet và Gated Attention theo tỷ lệ 3:1 | Giảm KV khoảng 1/4 | BF16/FP8 | Qwen3, Qwen3.5 | Loạt đầy đủ từ cạnh đến flagship |
| Meta | Công bố model card | MoE | 1/128 + 1 được chia sẻ (Maverick) | Xen kẽ lớp dày đặc và lớp MoE. iRoPE | GQA tiêu chuẩn | BF16 | Llama 4 | Ngữ cảnh 10M (Scout). Behemoth chưa phát hành |
| OpenAI | Chỉ công bố gpt-oss | MoE | 4/128 | Xen kẽ sliding window (128) và full attention. attention sink | GQA, 8 đầu | MXFP4 | gpt-oss-120b/20b | GPT-5.x không công khai. Nghiên cứu SAE (Gao 2024) |
| Gemini 1.5 và 2.5 được xác nhận chính thức là MoE. Chi tiết không công khai | MoE. Cấu trúc linh hoạt cho biên (edge) | Không công khai | Không công khai | Không công khai | Không công khai | Gemini 1.5/2.5, Gemma 3n | Mô hình con lồng của MatFormer, PLE | |
| Anthropic | Không công khai | Tính thưa thớt cho khả năng diễn giải (SAE, transcoders) | Không công khai | Không công khai | Không công khai | Không công khai | Dòng Claude | Sử dụng tính thưa thớt như một công cụ để "hiểu mô hình" |
| Mistral | Công bố trọng số | MoE | 2/8 | Tiêu chuẩn | GQA | BF16 | Mixtral 8x7B/8x22B | MoE mở chất lượng cao đầu tiên (tháng 12 năm 2023) |
| Microsoft Research | Công bố bài báo | Tính thưa thớt kích hoạt + 1,58 bit | — | Tiêu chuẩn | Tiêu chuẩn | 1,58 bit (BitNet) | Q-Sparse, BitNet b1.58 | Kết hợp tính thưa thớt và lượng tử hóa bit cực kỳ thấp |
| Meituan / Ant / Zhipu | Công bố model card | Biến thể MoE | Đa dạng | Đa dạng | Đa dạng | Đa dạng | LongCat-Flash, Ling, GLM-4.5/4.6 | Chuyên gia tính toán bằng không, MoE kết nối tắt |
Từ đây có thể rút ra ba quan sát. Thứ nhất, nguồn chính của đổi mới kiến trúc thưa thớt là lực lượng mô hình mở của Trung Quốc. Chuyên gia hạt mịn, chuyên gia dùng chung, cân bằng tải mà không có tổn thất phụ trợ, chú ý thưa thớt gốc, bộ nhớ có điều kiện, và lai hybrid chú ý tuyến tính hầu như tất cả đều được DeepSeek, Qwen và Kimi công bố lần đầu tiên. Thứ hai, thành phần của các tổ chức nghiên cứu đóng cửa lớn là hộp đen, chúng ta chỉ có thể suy đoán từ thông tin công khai như báo cáo gpt-oss hoặc Gemini. Việc trích dẫn "GPT-4 là MoE 1,8T" như một sự thật là một sai lầm phổ biến. Thứ ba, chú ý đã tách thành hai con đường. DeepSeek chọn "chú ý thưa thớt" (chỉ tính toán một phần của cặp token), trong khi Qwen và Kimi chọn "lai hybrid chú ý tuyến tính" (thay thế KV cache bằng trạng thái đệ quy). Cả hai đều nhắm vào cùng một vấn đề về bộ nhớ và băng thông KV cache, nhưng sử dụng các công cụ toán học khác nhau. Cái trước là thưa thớt, cái sau gần với đệ quy hạng thấp.
Ngăn xếp hệ thống: Kỹ thuật để chạy tính thưa thớt thực tế
Liệu lợi ích của kiến trúc thưa thớt có được thực hiện hay không, được quyết định bởi một lớp thường bị bỏ qua, đó là phần mềm hệ thống.
Tính song song chuyên gia và giao tiếp. DeepEP (DeepSeek công bố vào năm 2025) cung cấp hạt nhân all-to-all thông lượng cao, độ trễ thấp hỗ trợ FP8 và RDMA trên NVSHNEM, xếp chồng giao tiếp và tính toán. MegaBlocks (2023) viết lại phép tính MoE dưới dạng GEMM thưa thớt khối để thực hiện MoE không mất mát, đạt được tốc độ nhanh hơn 2,4 lần so với Megatron-LM dày đặc.
Hạt nhân chú ý. FlashMLA được tối ưu hóa cho MLA. DSA và CSA2 cần bộ lập chỉ mục và hạt nhân chú ý thưa thớt phối hợp, DeepSeek đã công bố với FlashMLA và DeepGEMM. Ba chế độ CSA2 của V4.1 có nghĩa là động cơ suy luận phải quản lý việc tái sử dụng giữa các lớp của KV và chỉ mục.
Khung suy luận. vLLM và SGLang đã hỗ trợ MLA, DSA, V4.1-Flash kể từ ngày công bố, bao gồm H100/H200/B200/GB200 và AMD MI355X. NVIDIA NeMo AutoModel cung cấp công thức tinh chỉnh cho V4.1, yêu cầu 64 GPU trong một miền NVLink duy nhất.
Lưu trữ phân cấp. Bảng Engram của V4.1 (khoảng 183 GiB) được thiết kế để được đặt trong bộ nhớ máy chủ và tìm nạp trước qua RDMA. Đã có bài báo lưu giữ Engram trong nhóm bộ nhớ CXL, di chuyển "kiến thức" từ HBM sang một tầng rẻ hơn. SWA Bounded Replay tránh lưu trữ vĩnh viễn SSD của KV cửa sổ trượt.
Định dạng lượng tử hóa. MXFP4 (một tỷ lệ chung 8 bit trên 32 phần tử, trung bình 4,25 bit) đã trở thành tiêu chuẩn thực tế cho trọng số chuyên gia MoE vào năm 2025-2026. Blackwell hỗ trợ natively các tensor core FP4.
Kết luận của phần này được cộng hưởng với "thời đại mạng nơ-ron". Chiến thắng của tính thưa thớt luôn đi kèm với hạt nhân và lập lịch tương xứng. Tính thưa thớt 2:4 không phổ biến vì ngay cả với tensor core, nó thiếu một ngăn xếp phần mềm hoàn chỉnh từ đầu đến cuối trưởng thành. MoE trở thành chủ đạo vì có DeepEP, MegaBlocks và vLLM.
Nơi tính thưa thớt và học sâu gặp nhau: Những tiến bộ gần đây trong xử lý hình ảnh và tín hiệu
Trong khi các mô hình quy mô lớn sử dụng tính thưa thớt để tiết kiệm tính toán, xử lý hình ảnh và tín hiệu đã đi con đường khác. Nó là con đường kết hợp các phân phối thưa thớt tiên nghiệm với các mạng sâu, khôi phục tín hiệu từ các phép đo không hoàn chỉnh và nhiễu. Các kết quả cũng chảy theo hướng ngược lại, thay đổi cách chúng ta hiểu các mô hình quy mô lớn và hình dạng thiết kế kiến trúc.
Tìm kiếm thuật toán: Biến máy giải thưa thớt lặp lại thành một mạng
Điểm khởi hành là LISTA của Gregor và LeCun (2010). Nó "mở ra (unroll)" các lần lặp cố định của ISTA thành một mạng có số lớp hữu hạn, và làm cho các tham số của nó có thể học được. Mỗi lớp vẫn là "biến đổi tuyến tính + xử lý ngưỡng mềm", nhưng ma trận và ngưỡng được học từ dữ liệu. Kết quả là hội tụ nhanh hơn 1-2 chữ số so với ISTA được điều chỉnh thủ công, và vẫn duy trì cấu trúc có thể diễn giải được. Điều này là bởi vì mỗi lớp tương ứng với một bước của phương pháp gradient gần. Tìm kiếm thuật toán sau này trở thành khung công việc chính trong hình ảnh tính toán. ADMM-Net và ISTA-Net được sử dụng để tái cấu trúc MRI cảm biến nén, và các mạng được mở ra vượt qua các kỹ thuật CS cổ điển trên dữ liệu dưới lấy mẫu lâm sàng. Ý nghĩa sâu hơn của việc mở ra là nó cho thấy rằng mạng nơ-ron sâu có thể được đọc dưới dạng phiên bản có thể học được của bộ giải thưa thớt. Hiểu biết sâu sắc này sau đó cung cấp trực giác cho việc giải mã mạng nơ-ron bằng từ điển thưa thớt.
Phân phối trước cắm vào và chính quy hóa bằng khử nhiễu
Chính quy hóa cổ điển (L1, biến thiên toàn phần) viết phân phối tiên nghiệm như một hạng mục hình phạt rõ ràng. Khung Plug-and-Play (PnP) xuất hiện sau năm 2013 phát hiện ra rằng bước "áp dụng toán tử gần" trong ADMM hoặc phương pháp gradient gần có thể được thay thế bằng một khử nhiễu tùy ý, tức là một mạng khử nhiễu sâu được huấn luyện trước. Phân phối tiên nghiệm trở thành từ "một công thức" thành "khử nhiễu hộp đen", và phân phối tiên nghiệm thưa thớt trở thành một trong những trường hợp đặc biệt của nó. Chính quy hóa bằng Khử nhiễu (RED) và phân phối mô hình khuếch tán sau này kế thừa hệ thống này. Trong cách nhìn này, khử nhiễu bằng xử lý ngưỡng mềm, BM3D, và khử nhiễu sâu là ba thế hệ của các phần có thể hoán đổi được được lắp vào cùng một vị trí.
Deep Image Prior: Cấu trúc của mạng lưới chính nó là một phân phối tiên nghiệm
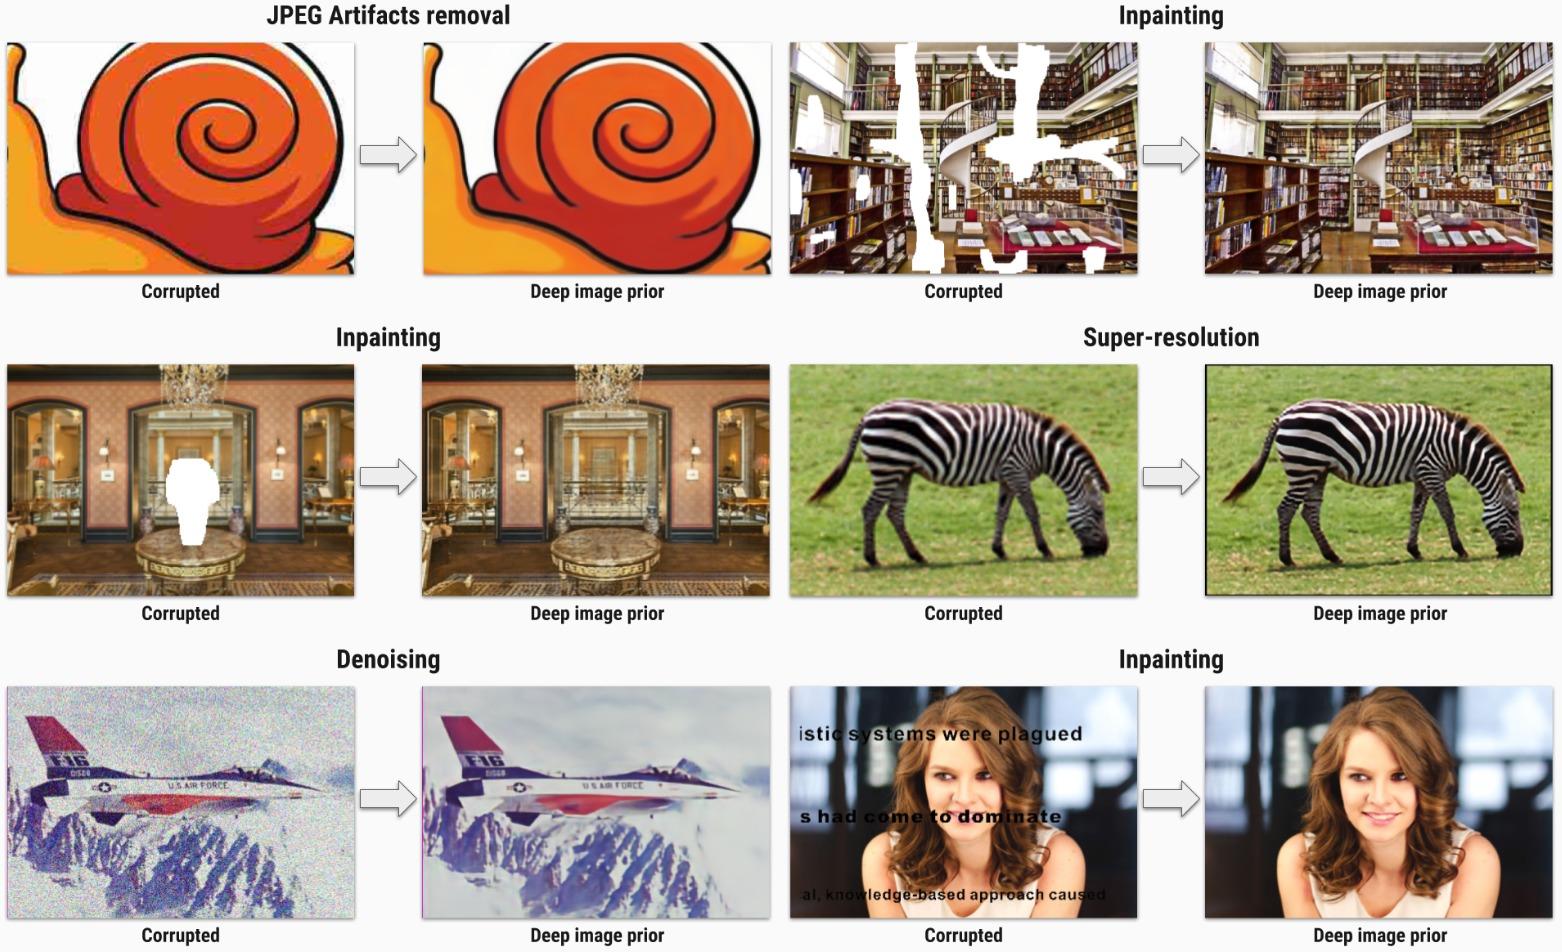
Deep Image Prior của Ulyanov, Vedaldi và Lempitsky (2018) mang lại kết quả phản trực giác. Chỉ bằng cách điều chỉnh mạng tích chập chưa được huấn luyện được khởi tạo ngẫu nhiên trên một hình ảnh bị giảm chất lượng, có thể thực hiện khử nhiễu, siêu phân giải và điền vào. Cấu trúc của mạng tích chập thích những thống kê tự tương tự tần số thấp của hình ảnh tự nhiên, và sự điều chỉnh để lắp vào nhiễu là chậm, vì vậy dừng sớm sẽ cung cấp hình ảnh sạch. Điều này được kết nối trực tiếp với thống kê hình ảnh tự nhiên được thảo luận trong "tiền sử". Cấu trúc của mạng lưới ngầm mã hóa phân phối tiên nghiệm "hình ảnh tự nhiên là thưa thớt dưới một cơ sở nào đó", khác biệt duy nhất là cơ sở đó không còn được viết ra rõ ràng nữa. Sau DIP, "cấu trúc chính nó là một phân phối tiên nghiệm" trở thành một thấu kính quan trọng để hiểu thiên lệch quy nạp của mạng nơ-ron, và trở thành một cầu nối với lý thuyết thưa thớt cổ điển. DIP có thể được xem như một phương pháp thực hiện điều tương tự một cách thích ứng thông qua một "khung hình" ngầm và có thể học được, tức là một phương pháp chỉ giữ lại các thành phần thực sự biểu diễn cấu trúc của tín hiệu.
Từ điển được học và khung hình có cấu trúc
Có một con đường ở giữa giữa wavelet cố định, từ điển phi cấu trúc mà K-SVD học, và phân phối tiên nghiệm ngầm mà mạng sâu học. Đó là con đường học các tham số của nó từ dữ liệu trong khi vẫn giữ cấu trúc toán học của các khung chặt hoặc phép biến đổi unitary (tái tạo hoàn hảo, bảo toàn năng lượng). NSOLT (không phân tách phép biến đổi đối xứng hướng chồng chéo) và LSUN (mạng unitary cấu trúc lưới) thuộc danh mục này. Bằng cách ràng buộc phép biến đổi với đa tạp khung chặt và tham số hóa nó bằng cấu trúc lưới, có thể thu được khả năng thích ứng với dữ liệu cụ thể trong khi vẫn duy trì tính giải thích được và khả năng đảo chiều của phép biến đổi cổ điển. Giá trị của con đường này được phát hiện lại trong thời đại của các mô hình quy mô lớn. SAE cần một từ điển quá đầy đủ, MLA cần một phép chiếu hạng thấp có thể đảo ngược. Cả hai đều đang tìm kiếm sự cân bằng giữa ràng buộc cấu trúc và tính thích ứng với dữ liệu, và đó chính xác là vấn đề thiết kế mà khung hình có cấu trúc luôn đối mặt.
Ba điểm tiếp xúc với các mô hình quy mô lớn
Thứ nhất, SAE chính là mã hóa thưa thớt. Bộ mã hóa tự động thưa thớt của Anthropic giống hệt về mặt toán học với học từ điển Olshausen–Field, chỉ có dữ liệu thay đổi. Từ bản vá hình ảnh đến hoạt động dòng phần dư. Thứ hai, tìm kiếm thuật toán đã dự đoán trước cách đọc "mạng = bộ giải". Transcoders của Anthropic và biểu đồ quy định về bản chất là tìm kiếm một biểu đồ tính toán thay thế thưa thớt, dễ đọc cho Transformer. Thứ ba, ý tưởng về phân phối tiên nghiệm có cấu trúc đã đi vào thiết kế kiến trúc. Các khối chuyên gia MoE, việc tái sử dụng giữa các lớp của CSA2 và bảng tra cứu Engram đều viết phân phối tiên nghiệm rằng "dữ liệu phải có cấu trúc này" vào chính hình dạng của mạng lưới, chứ không phải vào hàm mất. Đây là đối tác của kết luận của phần "lý thuyết thống nhất" trong thế giới xử lý hình ảnh. Tính thưa thớt đã chuyển từ hạng mục chính quy hóa thành ràng buộc kiến trúc.
Ứng dụng: Nơi tính thưa thớt thực sự tạo ra giá trị
Tính thưa thớt tạo ra giá trị tại những nơi có nhiều thứ để xử lý và rất ít thứ thực sự quan trọng. Kiểm tra tài liệu dài là một trong những ví dụ điển hình nhất.
Suy luận LLM trên đám mây. Hầu hết các API biên giới giá rẻ vào năm 2026 đều đến từ các mô hình MoE thưa cao độ. Đầu ra ngoài giờ cao điểm của DeepSeek-V4.1-Flash là $0,60/M, gpt-oss-120b trên OpenRouter có đầu vào khoảng $0,03/M và đầu ra khoảng $0,17/M.
Bối cảnh dài và các tác nhân. Khi công bố V4.1, DeepSeek cho biết hầu hết chi phí của tác nhân đều đến từ tính phí lượt bộ nhớ đệm, và nén bộ nhớ đệm có thể cắt giảm đáng kể phần này. Giá đầu vào được lưu vào bộ nhớ đệm ($0,006/M) chỉ bằng 1/50 giá bỏ lỡ bộ nhớ đệm ($0,30/M), đây là tay đòn trung tâm trong kinh tế học của các tác nhân.
Cạnh. LLM in a Flash (2023) của Apple tải các tham số được kích hoạt một cách thưa từ bộ nhớ flash theo yêu cầu. Gemma 3n sử dụng các mô hình con lồng nhau của MatFormer và nhúng từng lớp (PLE). Các mô hình MoE như Qwen3.5-35B-A3B với 3B kích hoạt đang trở thành ứng cử viên cho trình duyệt và cạnh.
Đa phương tiện. V4.1 cung cấp độ lệch định tuyến chuyên dụng cho các mã thông báo hình ảnh. Các mã thông báo hình ảnh rất nhiều và có độ dự phòng cao, làm cho chúng là mục tiêu lý tưởng cho chú ý thưa.
Khoa học và y tế. CS-MRI đã giảm thời gian quét trung bình trong thực hành lâm sàng hàng ngày khoảng 20%, và 23%-43% cho các chuỗi đơn. Đường ống SMILI hỗ trợ hình ảnh lỗ đen của Event Horizon Telescope được xây dựng dựa trên mô hình hóa thưa.
Xem xét tài liệu và bản vẽ dài cho doanh nghiệp (liên quan trực tiếp đến hoạt động kinh doanh của chúng tôi)
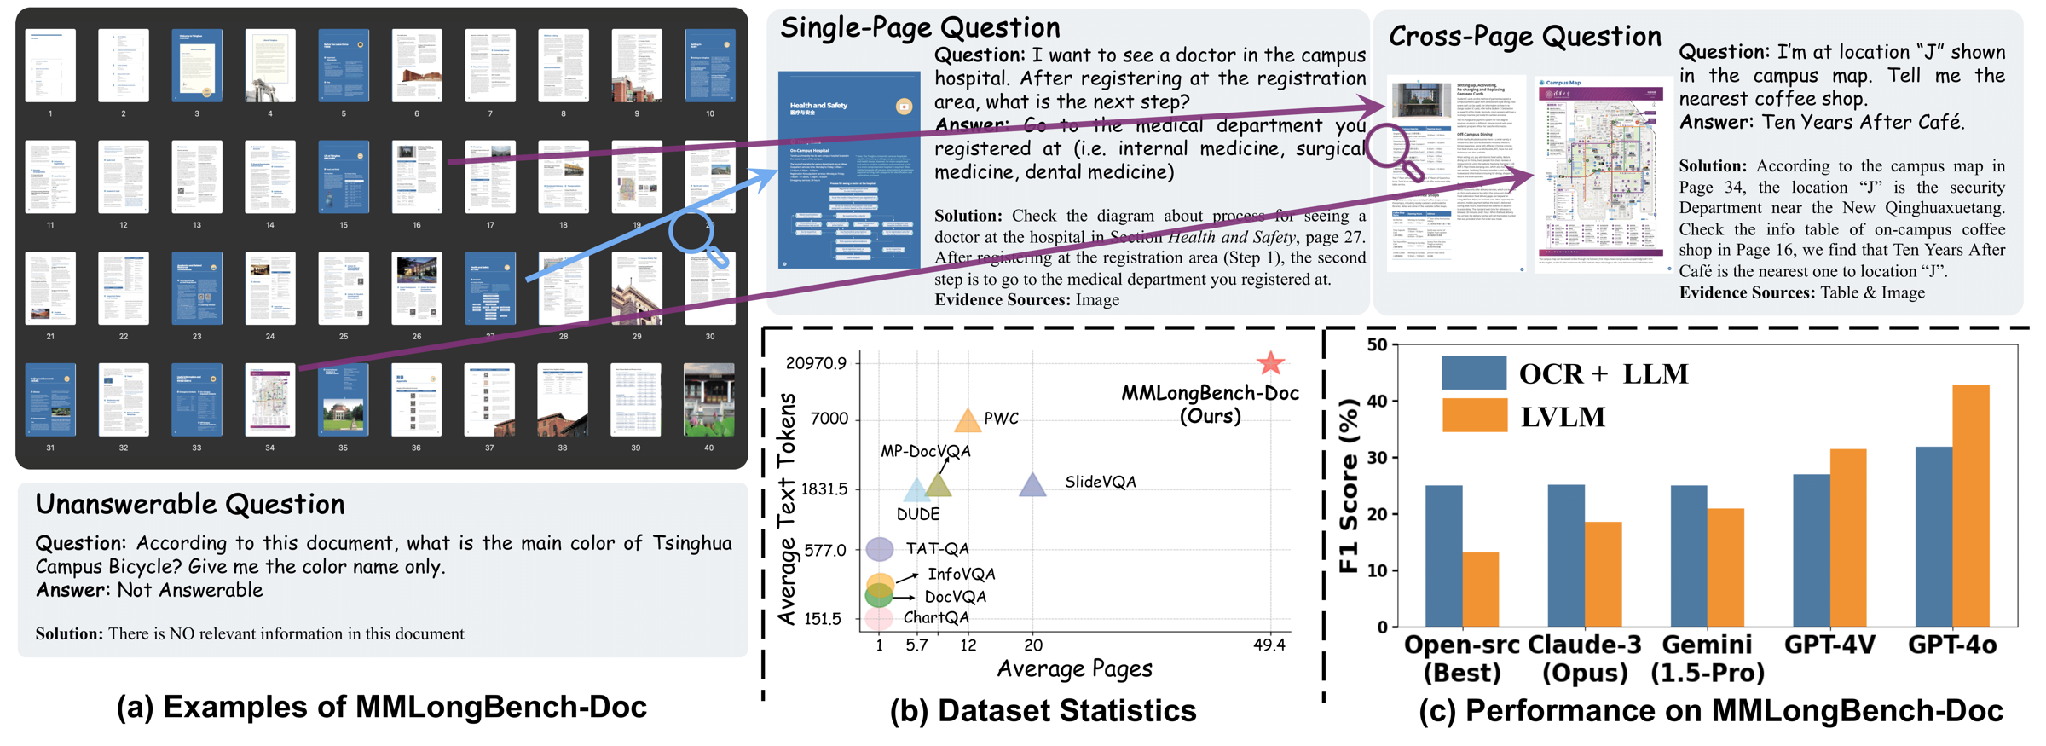
Tiêu chuẩn đánh giá độ khó. MMLongBench-Doc (NeurIPS 2024 D&B) tập hợp 135 tệp PDF với trung bình 47,5 trang, khoảng 21.000 mã thông báo văn bản, có 1.082 câu hỏi do chuyên gia viết. 33,2% yêu cầu bằng chứng xuyên trang và 22,8% được thiết kế để không trả lời để phát hiện ảo giác. F1 của người chú thích nhân loại là 66,0%, trong khi 12 trong 14 mô hình ngôn ngữ thị giác hoạt động kém hơn khi được cung cấp văn bản OCR cho các mô hình chỉ sử dụng văn bản tương ứng. 396 tài liệu trong LongDocURL có trung bình 86 trang, với 52,9% câu hỏi xuyên trang. Độ dài của các tài liệu này và tỷ lệ phần trăm các câu hỏi xuyên trang hoặc phần tử rất giống với đơn xin cấp phép xây dựng (bản vẽ từ nhiều chục đến quá 100 trang, tính toán kết cấu, các tài liệu đơn xin).
Nút cổ chai không chỉ là độ dài bối cảnh. Đó là chọn top-K chính xác từ các bằng chứng rải rác. Tìm kiếm (chọn các trang top-K) và chú ý thưa (chọn các khối mã thông báo top-K) là các toán tử toán học giống nhau. Sự khác biệt là liệu lựa chọn đó xảy ra bên ngoài mô hình (có thể kiểm toán, có thể trích dẫn các điều khoản) hay bên trong (end-to-end nhưng mờ đục).
Giới hạn. Sparse Frontier cho thấy rằng chú ý thưa có thể làm giảm hiệu suất của các tác vụ riêng lẻ ngay cả ở tỷ lệ thưa vừa phải. Trong công việc xem xét, "Điều X được nêu trên trang 37 mâu thuẫn với kích thước" chính xác là một tác vụ "nếu bỏ qua một điều thì toàn bộ câu trả lời là sai". Do đó, an toàn hơn là lai ghép tìm kiếm và xác minh lại trong bối cảnh dài, thay vì đặt cược cho một bên. Nhiều nghiên cứu về tài liệu nhiều trang vào năm 2025, bao gồm SimpleDoc, MDocAgent và LAD-RAG, cũng đi theo con đường này.
Lợi ích và chi phí
Về thưa của trọng số, "thưa được đánh giá quá cao" trong thời đại LLM phần lớn là đúng. Đối với tính toán có điều kiện và thưa của chú ý, ngược lại—cả hai đều là tiêu chuẩn biên giới. Phân chia hai cái này là chìa khóa để hiểu toàn bộ cuộc thảo luận.
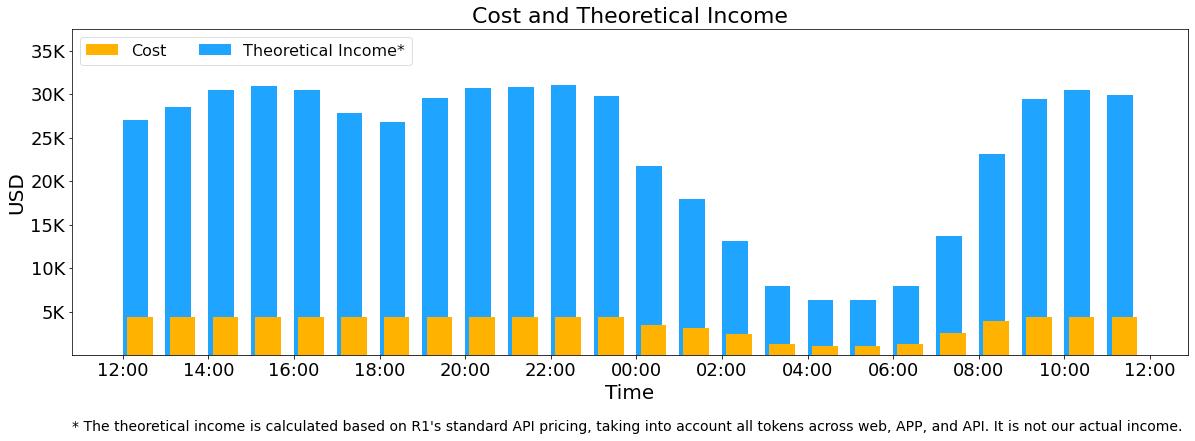
Lợi ích
Chi phí: Tỷ lệ kích hoạt giảm xuống 1,5%-4,5%, và đường cong giá đang giảm nhanh.
Tách biệt dung lượng và tính toán: Tổng tham số quyết định dung lượng kiến thức, các tham số được kích hoạt quyết định chi phí trên mỗi mã thông báo, và cả hai có thể mở rộng quy mô độc lập. Engram đi xa hơn nữa, di chuyển kiến thức tĩnh sang bộ nhớ lưu trữ host rẻ tiền.
Bối cảnh dài thực tế hóa: DecodeFLOPs của V4.1 chỉ tăng khoảng một phần tư giữa 4K và 1M.
Công cụ khả năng giải thích: SAE và transcoders được sử dụng để khám phá các khái niệm không xác định.
Chi phí và rủi ro
Bộ nhớ được xác định bởi tổng tham số: Chuyên gia định tuyến V4.1 (MXFP4) chiếm khoảng 259,5 GiB, bảng Engram chiếm khoảng 183 GiB. Thưa không tiết kiệm lưu trữ.
Overhead truyền thông: All-to-all của song song chuyên gia là nút cổ chai chính của học tập MoE, và Engram cần ưa tiên trước lấy dữ liệu qua RDMA hoặc CXL.
Bất ổn định học tập và sai lệch tải: Một loạt các bản vá là cần thiết, bao gồm z-loss, điều chỉnh thiên vị và định tuyến băm.
Ưa tiên tinh chỉnh khó khăn: Định tuyến có thể sụp đổ trên các tập dữ liệu nhỏ. Thủ tục ưa tiên tinh chỉnh chính thức của V4.1 yêu cầu 64 GPU trong một miền NVLink duy nhất.
Bẫy đánh giá: Phát hiện từ Sparse Frontier rằng "gần như mọi cấu hình đều mất hiệu suất ở ít nhất một tác vụ". V4.1 xếp hàng với biên giới trên các điểm chuẩn của nhà cung cấp, nhưng thua khoảng 10 điểm trên các chỉ số tổng hợp độc lập.
Giới hạn của SAE: Xem phần "Thưa trong khả năng giải thích".
Thưa của trọng số vẫn thua hiệu quả: Các phương pháp truyền thống bị kẹt dưới tường thưa 50%-60%.
Ý kiến tiêu biểu (được trích dẫn từ các nguồn)
| Vị trí | Nguồn | Ý kiến |
|---|---|---|
| Hỗ trợ: Người chiến thắng được xác định bởi phần cứng | Hooker 2021 | Các ý tưởng chiến thắng không phải vì "tốt hơn mà vì phù hợp với phần mềm và phần cứng sẵn có" |
| Hỗ trợ: Trục mới của thưa | DeepSeek, Engram 2026 | "Tôi tin rằng bộ nhớ có điều kiện sẽ trở thành một nguyên thủy lập mô hình thiết yếu cho các mô hình thưa thế hệ tiếp theo" |
| Thận trọng | Nawrot et al. 2026 | "Chú ý thưa không phải là viên đạn bạc" |
| Tiêu cực | Google DeepMind 2025 | "Tôi không tin rằng SAE sẽ trở thành người thay đổi trò chơi trong khả năng giải thích, và tôi nghi ngờ lĩnh vực này đã quá đầu tư vào SAE" |
| Ở giữa | arXiv:2506.23845 | SAE không tốt cho việc tác động đến các khái niệm đã biết nhưng là một công cụ mạnh mẽ để khám phá các khái niệm không xác định |
Phán quyết cho mỗi 5 loại thưa (tháng 9 năm 2026)
Không có câu trả lời duy nhất cho "Thưa được đánh giá quá cao?" Câu hỏi này cần được trả lời theo loại.
| Loại thưa | Tình hình năm 2026 | Phán quyết | Lý do chính |
|---|---|---|---|
| Thưa của trọng số (cắt tỉa không có cấu trúc) | Nghiên cứu sôi động, áp dụng công nghiệp tối thiểu | Được đánh giá quá cao trong thời đại LLM. Lượng tử hóa đã thắng | Tường thưa 50%-60%. Không có nhân GPU hiệu quả. MXFP4 là tiêu chuẩn thực tế |
| Thưa có cấu trúc (2:4, khối) | Hỗ trợ phần cứng hiện có nhưng tăng tốc end-to-end hạn chế | Một phần thực hiện. Khối thưa đã thắng dưới hình thức MoE | 2:4 hiếm khi đạt 2x trong lực. Block-sparse GEMM của MegaBlocks đã trở thành nền tảng của MoE |
| Thưa kích hoạt (ReLU, kích hoạt top-k) | Chú ý trên cạnh và nghiên cứu. Bị hấp thụ bởi MoE trên đám mây | Tiềm năng bị đánh giá thấp. Nhưng sân chơi chính là cạnh | Q-Sparse đạt tỷ lệ thưa khoảng 40%, phù hợp với mô hình dày đặc. TEAL và PowerInfer nhắm đến các thiết bị bị ràng buộc bộ nhớ |
| Tính toán có điều kiện (MoE) | Kiến trúc tiêu chuẩn biên giới | Như lời đồn. Tiếp tục sâu hơn | Tỷ lệ kích hoạt giảm từ 25% xuống 1,5%-4,5% trong 2 năm. Tất cả các mô hình nguồn mở hạng ngạo mộ năm 2025-2026 đều sử dụng nó |
| Thưa chú ý | Phiên bản có thể học được một cách tự nhiên trong sản phẩm | Được thành lập. Nhưng có rủi ro hiệu suất giảm từng tác vụ | NSA đã giành giải Best Paper từ ACL. V4.1 được đào tạo thưa từ đầu. "Giảm ít nhất một tác vụ" của Sparse Frontier |
| (Hệ thống lôgic song song) Thứ hạng thấp | MLA và LoRA được sử dụng rộng rãi | Được thành lập. Nhưng không được nhầm lẫn với thưa | Nén KV hạng thấp tối đa khoảng 93% (V2). LoRA là tiêu chuẩn cho ưa tiên tinh chỉnh |
| (Công cụ) Từ điển thưa / SAE | Cuộc thảo luận tiếp tục | Được thành lập như một công cụ khám phá. Được đánh giá quá cao như một bộ phát hiện và bộ điều khiển | Deepseek đã hạ mức độ ưu tiên. Nhỏ hơn sonde tuyến tính trên 113 tập dữ liệu. Anthropic đã chuyển sang transcoders và đồ thị thuộc tính |
Nói một lời: Thưa đã thắng trong "kích hoạt" và "chú ý", thua trong "trọng số". Điều đó thắng không phải vì lý thuyết tốt hơn mà vì phần cứng có thể tận dụng cấu trúc ở các vị trí bằng không.
Tương lai (2026-2030)
Trục tiếp theo của thưa không còn là "tham số nào để tính toán" mà là "kiến thức nào để lưu trữ và lịch sử nào để đọc". Dưới đây là biên giới nghiên cứu, xu hướng phần cứng và năm dự đoán có thể kiểm chứng được.
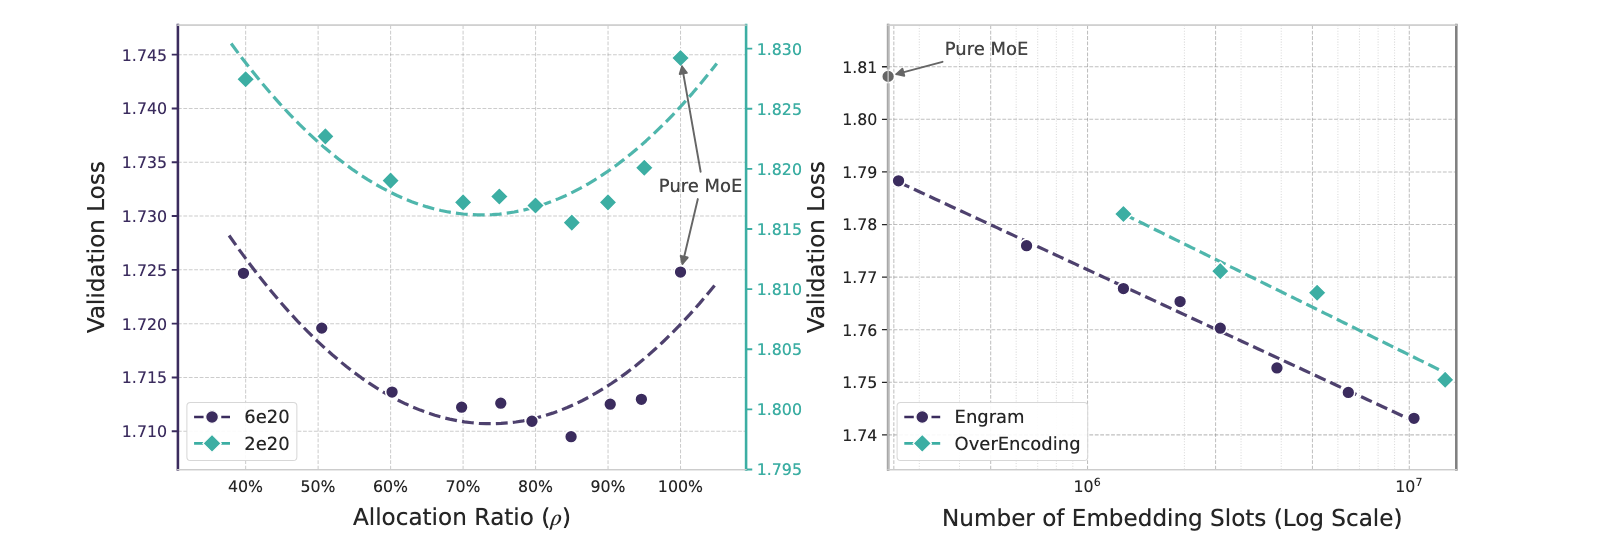
Biên giới Nghiên cứu
Sparsity Đa Trục và Phân bổ Ngân sách. Quy luật hình chữ U mà bài báo Engram tìm thấy cho thấy rằng pure MoE không phải là tối ưu, và ngân sách sparsity nên được chia giữa "các chuyên gia" và "bộ nhớ có điều kiện". Mô hình Engram 27B đã đạt được MMLU +3.4, BBH +5.0, HumanEval +3.0 so với baseline MoE có cùng số tham số và cùng FLOPs. Theo phân tích cơ chế, bộ nhớ có điều kiện giải phóng các lớp ban đầu khỏi việc tái lắp ráp kiến thức tĩnh.
Sparsity Có thể Học tập Gốc trở thành Mặc định. V4.1 học tập Sparse Attention ở 64K ngay từ đầu, không cần khởi động dày đặc. Điều này cho thấy rằng Sparse Attention đã trở thành công dân hạng nhất trong quá trình học tập, thay vì chỉ là xấp xỉ tại thời gian suy luận.
Sparsity × Tính toán Suy luận. Các mô hình reasoning tạo ra đầu ra dài, làm cho cả prefill lẫn decode đều nặng. MoE cung cấp khả năng chứa đựng kiến thức, còn chuỗi suy nghĩ dài cung cấp độ sâu suy luận. Kích hoạt bất đối xứng của CED là một sự cân bằng cho các khối lượng công việc có tỷ lệ đọc-ghi khác nhau.
Modularité và Học tập Liên tục. Các chuyên gia và bảng bộ nhớ có thể được chỉnh sửa cục bộ. Ví dụ, có những nghiên cứu viết dữ liệu người dùng như chỉnh sửa tham số cục bộ (User as Engram, arXiv:2606.19172).
Sự kết hợp của Sparsity và Quantization. Các chuyên gia MXFP4, KV FP4, Engram FP8 đã được sử dụng cùng nhau trong V4.1 và K3. Kết luận của Q-Sparse là: độ tích cực của quantization càng cao thì mức độ sparsity tối ưu càng cao.
Thiết kế Hợp tác với Phần cứng. Blackwell hỗ trợ FP4 natively, và lưu trữ KV theo lớp sử dụng các bộ nhớ CXL và SSD đang tiến bộ. Tính toán neuromorphic ở quy mô LLM vẫn còn là triển vọng xa xôi.
5 Dự đoán Có thể Bác bỏ (có cơ sở)
| Dự đoán | Hạn chót | Cơ sở |
|---|---|---|
| Ít nhất một trong các mô hình mở hàng đầu sẽ giảm KV global xuống dưới 500 byte mỗi token | Cuối năm 2027 | Từ V1 đến V4.1 là 437 lần, chỉ một thế hệ từ V4 đến V4.1 là 4 lần, FP4 đã đang được sử dụng |
| Ít nhất 3 trong 5 mô hình mở hàng đầu sẽ có tỷ lệ kích hoạt dưới 3% mỗi token | Cuối năm 2027 | Tính đến năm 2026 đã có V4.1 (2.9%), K3 (3.7%), Qwen3.5 (4.3%), và số chuyên gia tăng gấp đôi mỗi thế hệ |
| Ít nhất 2 tổ chức nghiên cứu chính ngoài DeepSeek sẽ triển khai bộ nhớ có điều kiện kiểu bảng tra cứu trong mô hình mở flagship của họ | Năm 2028 | Engram đã có các nghiên cứu dẫn xuất sử dụng CXL, SSD và không cần huấn luyện, đã được tải lên NeMo |
| SAE sẽ không trở thành kỹ thuật giám sát an toàn sản xuất chính được công bố chính thức tại bất kỳ tổ chức nghiên cứu biên giới nào | Năm 2028 | Hạ thấp ưu tiên của GDM. Kết quả âm tính trong các tác vụ hạ lưu |
| Giá API cùng mức độ khả năng sẽ tiếp tục giảm ở tốc độ trên 10 lần mỗi năm, nhưng chi phí của doanh nghiệp cho mỗi tác vụ sử dụng agent sẽ tăng | Đang diễn ra | Xu hướng giá của Epoch. Gấp đôi số lần gọi agent |
Điều này có nghĩa gì đối với chúng tôi
Audit về bản chất là một tác vụ chọn top-K từ vô số điều khoản và trang, và xu hướng sparsification đang ép giảm đơn giá chính xác cho loại tác vụ này. Có 4 hàm ý có thể hành động được đối với các công ty phát triển agent audit tài liệu dài và bản vẽ.
Đường cong Chi phí. Xem "Tỷ lệ cache hit" và "Phần trăm xử lý hàng loạt ngoài giờ cao điểm" là các chỉ số hạng nhất. Các tác vụ audit về bản chất có thể được batch hóa và thực hiện ngoại tuyến. Đặt các luật lệ và quy định ổn định ở phía trước của prompt để tối đa hóa cache hit prefix. Giá đầu vào được cache trong V4.1 là 1/50 của cache miss, và ngoài giờ cao điểm lại giảm một nửa nữa.
Lựa chọn Mô hình. Chọn mô hình trên tập đánh giá riêng của bạn cho "so khớp qua trang và trích dẫn điều khoản", và phán xét theo điểm của tác vụ con khó nhất, không phải trung bình. Sử dụng các MoE mở sparsity cao làm ngựa làm việc chính, và sử dụng các mô hình biên giới đóng cho kiểm tra kép trên các trường hợp khó.
Chiến lược Ngữ cảnh Dài. Áp dụng hybrid của "tìm kiếm top-K trang (có thể kiểm tra và trích dẫn) + kiểm tra lại ở 1M ngữ cảnh (để không bỏ lỡ mối quan hệ xuyên trang)". Kết luận của Sparse Frontier áp dụng trực tiếp tại đây. Cá cược chỉ vào Sparse Attention sẽ giảm hiệu suất ở một số tác vụ, và audit chính là tác vụ "nếu bỏ lỡ một cái thì toàn bộ câu trả lời sai".
Quyết định Tự lưu trữ. Bộ nhớ MoE được xác định bởi tổng số tham số. Các chuyên gia định tuyến và bảng Engram của V4.1 vượt quá 440 GiB tổng cộng, và thủ tục fine-tuning chính thức yêu cầu 64 GPU trong một miền NVLink duy nhất. Ở quy mô dưới hàng chục GPU, sẽ không tính toán được, nên chọn API.
Cơ hội Nghiên cứu. Các nghiên cứu hiện tại xem "trang nào cần xác nhận trong ngân sách" như một vấn đề tìm kiếm. Nhưng trong kiểm tra tính nhất quán xuyên trang, mục tiêu sparsity thực sự không phải là "trang" mà là "cặp trang". Với P trang có P(P−1)/2 cặp, chọn k cặp để kiểm tra chéo. Điều này tương ứng trực tiếp với đồ thị hợp tác sparsity của hệ thống đa agent, tính điểm tất cả cặp (query, key) bằng một indexer nhẹ rồi lấy top-k—tương tự như ý tưởng của DSA. Đây là hướng chúng tôi có thể tạo sự khác biệt.
Phụ lục
A. Niên biểu (1948–Tháng 9 năm 2026)
| Năm | Sự kiện | Độ tin cậy |
|---|---|---|
| 1948 | Shannon, A Mathematical Theory of Communication: Công thức hóa thừa và entropy | Bài báo chính |
| 1961 | Giả thuyết Giảm Dự phòng của Barlow | Bài báo chính |
| 1967 | Sắp xếp Bộ máy Sparse của Tinney & Walker (Tính toán Mạng lưới Điện) | Bài báo chính |
| 1978 | Độ dài Mô tả Tối thiểu (MDL) của Rissanen | Bài báo chính |
| 1987 | Field: Thống kê Ảnh Tự nhiên và Trường Tiếp nhận Vỏ não | Bài báo chính |
| 1988–89 | Wavelet Trực giao Hỗ trợ Compact của Daubechies. Phân tích Độ phân giải Đa của Mallat | Bài báo chính |
| 1990–93 | Cắt tỉa OBD / OBS. Matching Pursuit | Bài báo chính |
| 1991 | Hỗn hợp Chuyên gia Cục bộ của Jacobs–Jordan–Nowlan–Hinton | Bài báo chính |
| 1992 / 2000 | JPEG / JPEG2000 | Tiêu chuẩn |
| 1994–96 | Khử Nhiễu Wavelet Threshoding. Garrote của Breiman. LASSO. Mã hóa Sparse của Olshausen & Field | Bài báo chính |
| 1998 | Basis Pursuit. Xấp xỉ Phi tuyến của DeVore | Bài báo chính |
| 2001–03 | Cân bằng Năng lượng của Attwell & Laughlin. "Có lẽ dưới 1%" của Lennie | Bài báo chính (Đã xác minh) |
| 2004–05 | LARS。Elastic Net | Bài báo chính |
| 2006–07 | Cảm biến Nén. K-SVD. CS-MRI của Lustig | Bài báo chính |
| 2009 | Chuyển pha Donoho–Tanner | Bài báo chính |
| 2011 | ReLU của Glorot (50–85% Zero Chặt chẽ). Robust PCA | Bài báo chính (Đã xác minh) |
| 2012 | Neuron Mặt Mèo của Google | Bài báo chính (Đã xác minh) |
| 2013–14 | Tính toán Có điều kiện và STE của Bengio. Ngưỡng Cứng Tối ưu của Gavish–Donoho | Bài báo chính |
| 2016 | Deep Compression | Bài báo chính |
| 2017 | MoE Cổng Sparse của Shazeer (Lớp MoE 137B) | Bài báo chính (Đã xác minh) |
| 2019 | Giả thuyết Vé Số. EHT M87*. Nghiên cứu Lâm sàng CS-MRI của Sartorett | Bài báo chính |
| 2020 | GShard. Hardware Lottery của Hooker. 2:4 của Ampere | Bài báo chính |
| 2021–22 | Switch Transformer. GLaM. ST-MoE. Expert Choice. Scaling MoE của Clark | Bài báo chính |
| 2023 | Mixtral。SparseGPT / Wanda。StreamingLLM / H2O。Towards Monosemanticity | Bài báo chính |
| Tháng 1–2 năm 2024 | DeepSeekMoE. Gemini 1.5 chính thức xác nhận là MoE | Báo cáo kỹ thuật |
| Tháng 5 năm 2024 | DeepSeek-V2 (MLA)。Scaling Monosemanticity。Golden Gate Claude | Báo cáo kỹ thuật |
| Tháng 6–7 năm 2024 | TopK SAE của Gao. Q-Sparse | Bài báo chính (Đã xác minh) |
| Tháng 12 năm 2024 | DeepSeek-V3 (671B/37B) | Báo cáo kỹ thuật |
| 27 tháng 1 năm 2025 | Cú sốc DeepSeek: Vốn hóa thị trường Nvidia giảm khoảng 589 tỷ đô la trong một ngày | Báo cáo đáng tin cậy |
| Tháng 2–3 năm 2025 | NSA, MoBA. Tỷ suất lợi nhuận lý thuyết của Hệ thống Reasoning 545%. GDM hạ ưu tiên SAE | Bài báo chính / Chính thức |
| Tháng 4 năm 2025 | Qwen3 MoE. Preprint Sparse Frontier. Llama 4 | Chính thức / Bài báo chính |
| Tháng 7–8 năm 2025 | NSA Giải thưởng Best Paper ACL. Kimi K2. gpt-oss | Chính thức |
| Tháng 9–12 năm 2025 | DeepSeek-V3.2、DSA | Báo cáo kỹ thuật |
| Tháng 1 năm 2026 | Engram: Bộ nhớ Có điều kiện và Phân bổ Ngân sách Sparsity Hình chữ U | Bài báo chính |
| Tháng 2 năm 2026 | Qwen3.5-397B-A17B | Thẻ Mô hình Chính thức |
| 24 tháng 4 năm 2026 | DeepSeek-V4 (Pro 1.6T/49B、Flash 284B/13B) | Báo cáo kỹ thuật |
| Tháng 7 năm 2026 | Kimi K3 (2.8T/104B). Sparse Frontier được Công bố ở Findings of ACL 2026 | Chính thức |
| 10 tháng 9 năm 2026 | DeepSeek-V4.1-Flash (CED, CSA2, 890 B/token, Engram) | Chính thức + Báo cáo kỹ thuật (Đã xác minh) |
B. Chuỗi Dữ liệu Có thể Biểu đồ hóa
Bộ đệm KV Toàn cục DeepSeek (mỗi token): V1 ≈ 389 KB (ước tính) → V3.2 ≈ 48 KB → V4-Flash ≈ 3.5 KB → V4.1-Flash 890 B. Thang đo logarit.
Tỷ lệ Kích hoạt mỗi Token: Mixtral 28% → Qwen3 9.4% → gpt-oss 4.4% → Qwen3.5 4.3% → Kimi K3 3.7% → V4.1 giải mã 2.9% / prefill 1.4%.
Số chuyên gia (được chọn / tổng số): 2/8 → 4/128 → 8/256 → 6/384 → 10/512 → 16/896.
Giá API của DeepSeek ($/M, đầu vào / đầu ra): V4-Flash 0.14 / 0.28. V4-Pro 1.74 / 3.48 (đầu ra ở giờ cao điểm từ tháng 8 trở đi là 3.96). V4.1-Flash cao điểm 0.30 / 1.20, ngoài giờ cao điểm 0.15 / 0.60, bộ nhớ cache 0.006.
Sparse Frontier: Tỷ lệ sparse tối ưu cho prefill là 0.80–0.93. Decode ở 0.95 cũng vẫn đáp ứng được nhu cầu thực tiễn. Giao điểm nằm trong khoảng 32–64K.
Tỷ lệ sparse của Glorot 2011: MNIST 83.4%, CIFAR10 72.0%, NISTP 68.0%, NORB 73.8%.
Q-Sparse: Tỷ lệ sparse tối ưu 45.58% (độ chính xác đầy đủ) / 61.25% (1.58 bit). Khoảng 40% thì tương đương với mô hình dày đặc.
Sự khác biệt so với đường cơ sở MoE của Engram-27B: MMLU +3.4, CMMLU +4.0, BBH +5.0, ARC-C +3.7, HumanEval +3.0, MATH +2.4.
CS-MRI: Thời gian quét −20.2%, thời gian kiểm tra −16%, trình tự đơn −23% đến −43%, số lần kiểm tra +27%.
Hiệu năng tính toán và băng thông GPU: Xem bảng GPU trong "thời đại mạng nơ-ron".
C. Anecdotes và tài liệu câu chuyện
Làm thế nào "1% của Lennie" trở thành "1–4%": Có thể sử dụng làm phần giới thiệu để làm rõ sự hiểu lầm.
Neuron mặt mèo (2012): Câu chuyện về 1.000 máy tinh toán trong 3 ngày tự học "mèo" từ các khung hình YouTube.
Outrageously (2017): Câu chuyện về lớp MoE 137B trong thời đại LSTM đã báo hiệu bối cảnh năm 2026. Sáng tác chung của Hinton và Dean tượng trưng cho "ý tưởng cũ từ 1991 × tài nguyên tính toán của Google".
Cú sốc DeepSeek (27 tháng 1 năm 2025) và từ "lý thuyết" gắn liền với 545%.
Golden Gate Claude (2024) và phanh gấp của GDM (tháng 3 năm 2025).
CS-MRI: Câu chuyện về cách thời gian bệnh nhân nằm trên bàn máy quét giảm 20%, bệnh viện có thể thực hiện 27% nhiều bài kiểm tra hơn.
437 chia 1: Câu chuyện về "bộ nhớ" trên một token giảm từ khoảng 389 KB xuống còn 890 byte.
Sự trở lại của N-gram: Câu chuyện về mô hình ngôn ngữ thống kê đã bị chôn vùi trong quá khứ quay trở lại biên giới dưới dạng Engram.
D. Những hiểu lầm phổ biến và cách chỉnh sửa
| Cách diễn đạt phổ biến | Mô tả chính xác |
|---|---|
| Não chỉ sử dụng 1–4% nơ-ron | Mô tả thực tế của Lennie 2003 là "có lẽ dưới 1%", ước tính giới hạn trên dựa trên năng lượng. 1–4% là trích dẫn gián tiếp qua Glorot 2011. |
| Mạng ReLU có 90% sparse | Glorot 2011: Khoảng 50% khi khởi tạo, sau khi huấn luyện là 50%–85%. |
| GPT-4 là MoE 1.8T với 16 chuyên gia | Tin đồn năm 2023 mà OpenAI chưa bao giờ xác nhận. Cấu trúc của GPT-5.x và Claude cũng không công khai như vậy. |
| CS-MRI tăng tốc độ quét 30–60% | Sartoretti 2019: Thời gian quét trung bình −20.2%, trình tự đơn −23%–−43%. |
| Shazeer 2017: "lớn hơn 1000 lần" | Văn bản gốc là "greater than 1000x (hơn 1000 lần)". 137B là số lượng tham số của lớp MoE. |
| Sparse Frontier được trình bày tại ICML 2025 | Chính thức được đăng tải tại Findings of ACL 2026. |
| Tỷ lệ lợi nhuận của DeepSeek là 545% | Tỷ lệ lợi nhuận chi phí lý thuyết do chính công ty công bố. Thực tế thì thấp hơn nhiều, ngoại trừ chi phí nghiên cứu phát triển và chi phí huấn luyện. |
| MLA là chú ý sparse | MLA là nén độ dài thấp. Những gì thực sự sparse là DSA / CSA2. |
| Chú ý sparse có thể nén không giới hạn | Gần như tất cả các cấu hình đều mất hiệu suất đáng kể ở ít nhất một tác vụ. |
E. Tài liệu tham khảo
Nền tảng cổ điển: Shannon 1948; Barlow 1961; Tinney & Walker 1967; Rissanen 1978; Field 1987; Mallat 1989; LeCun, Denker & Solla 1990; Jacobs, Jordan, Nowlan & Hinton 1991; Mallat & Zhang 1993; Donoho & Johnstone 1994 (Biometrika); Breiman 1995; Tibshirani 1996 (JRSS-B); Olshausen & Field 1996 (Nature); Chen, Donoho & Saunders 1998; DeVore 1998; Attwell & Laughlin 2001; Lennie 2003 (Curr. Biol.); Efron et al. 2004; Zou & Hastie 2005; Candès, Romberg & Tao 2006; Donoho 2006; Aharon, Elad & Bruckstein 2006; Lustig, Donoho & Pauly 2007; Lee, Battle, Raina & Ng 2007; Donoho & Tanner 2009; Glorot, Bordes & Bengio 2011; Candès, Li, Ma & Wright 2011; Le et al. 2012; Bengio et al. 2013; Gavish & Donoho 2014; Han, Mao & Dally 2016; Shazeer et al. 2017; Frankle & Carbin 2019; Sartoretti et al. 2019; Vranic et al. 2019; Hooker 2021 (CACM); Fedus, Zoph & Shazeer 2021; Clark et al. 2022.
2023–2026: Frantar & Alistarh 2023 (SparseGPT); Sun et al. 2023 (Wanda); Xiao et al. 2023 (StreamingLLM); Bricken et al. 2023; Jiang et al. 2024 (Mixtral); Dai et al. 2024 (DeepSeekMoE); DeepSeek-AI 2024 (V2, V3); Templeton et al. 2024; Gao et al. 2024; Wang et al. 2024 (Q-Sparse); Krajewski et al. 2024; Yuan et al. 2025 (NSA); Nawrot et al. 2025/2026 (Sparse Frontier); Kantamneni et al. 2025; OpenAI 2025 (gpt-oss); Google DeepMind 2025 (Gemini 2.5 báo cáo kỹ thuật, arXiv:2507.06261); Moonshot 2025/2026 (Kimi K2, K3); Alibaba 2026 (Qwen3.5); Cheng et al. 2026 (Engram, arXiv:2601.07372); DeepSeek-AI 2026 (V4, arXiv:2606.19348); DeepSeek-AI 2026 (V4.1-Flash, arXiv:2609.19969); Ma et al. 2024 (MMLongBench-Doc).
Sách giáo khoa và khảo sát: Elad, Sparse and Redundant Representations (2010); Hastie, Tibshirani & Wainwright, Statistical Learning with Sparsity (2015); Mallat, A Wavelet Tour of Signal Processing (3rd ed.); Foucart & Rauhut, A Mathematical Introduction to Compressive Sensing (2013); Hoefler et al. 2021, Sparsity in Deep Learning; Cai et al. 2024, A Survey on Mixture of Experts.
Đã đọc
Đọc tiếp ↓