
Articles
スパースモデル:起源、なぜ重要なのか、そしてLLMの最前線と未来
Product
Career
Overview
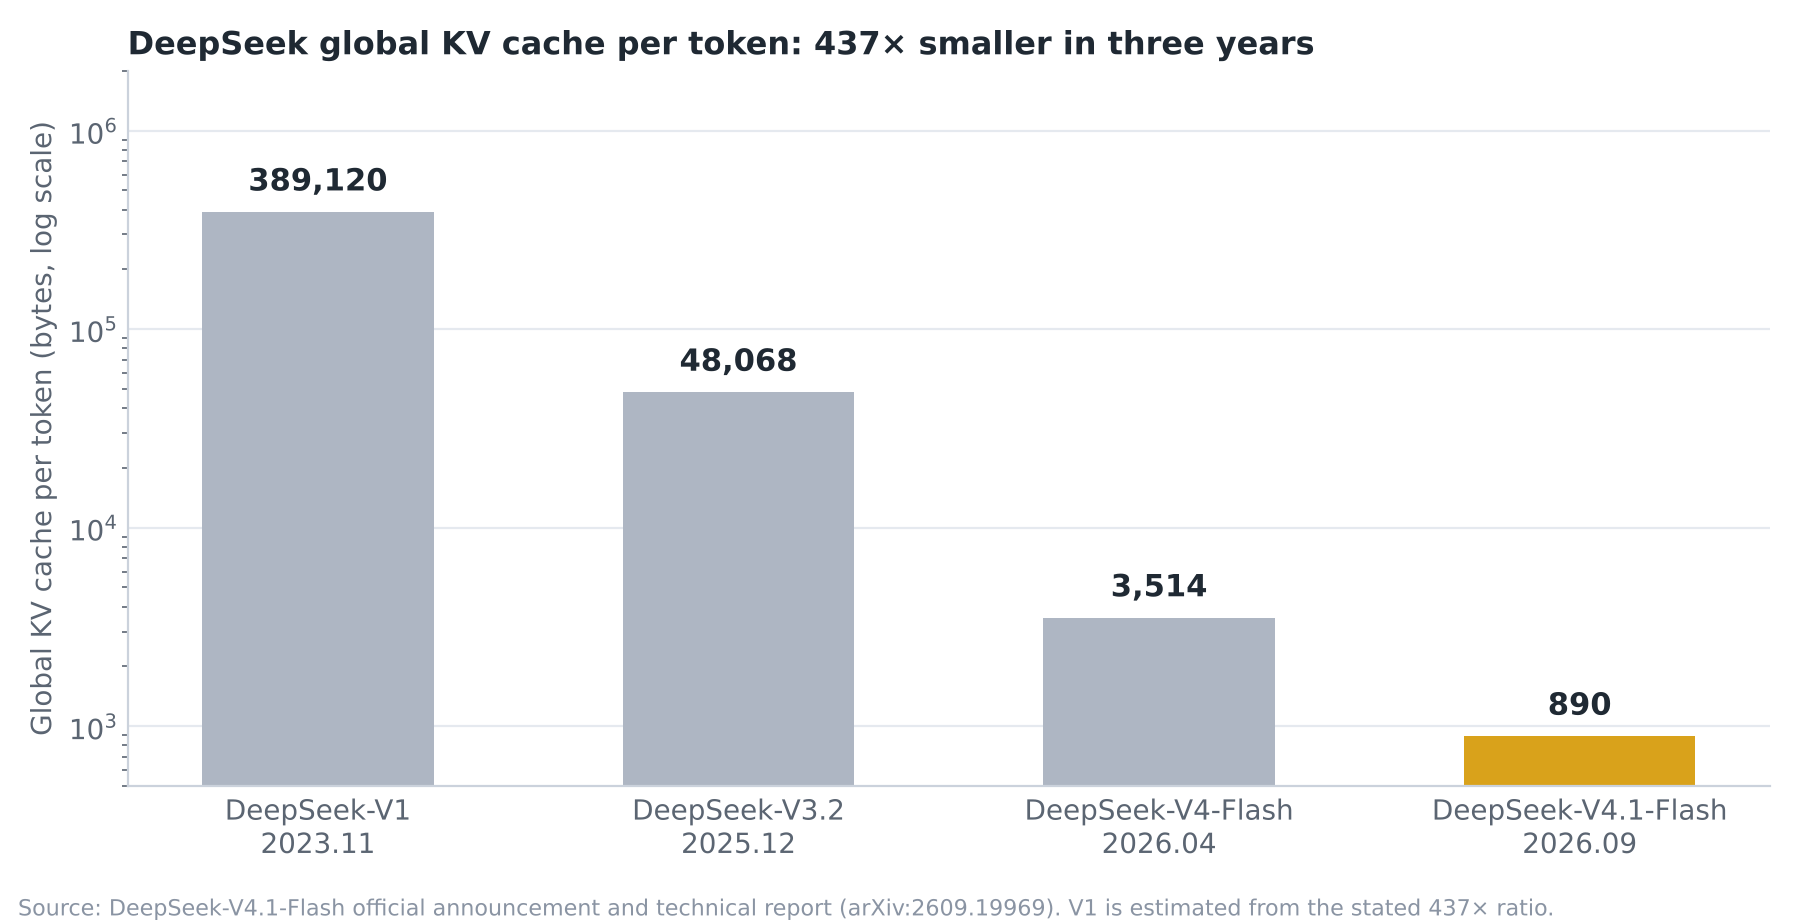
2026年現在、スパース性(sparsity)はもはや「あってもなくてもよい効率化のテクニック」ではありません。フロンティア級の大規模モデルにおける既定のアーキテクチャ制約であり、大規模モデルの運用コストと、長文書を扱うエージェントの読解精度の両方を決める要因になっています。最も直接的な証拠が、2026年9月10日に公開されたDeepSeek-V4.1-Flashです。バックボーンは552Bパラメータを持ちながら、1トークンあたりに活性化されるのはプリフィル時で8B、デコード時で16Bにすぎず、GPUメモリに常駐するグローバルKVキャッシュは1トークンあたり890バイト、DeepSeek-V1の1/437にまで圧縮されています(DeepSeek公式発表、技術レポート arXiv:2609.19969)。
3つの要点
スパース性の系譜は連続している。BarlowやOlshausen–Fieldの「脳のスパース符号化」から、ウェーブレット・LASSO・圧縮センシングという「計算可能なスパース性」を経て、MoE・スパースアテンション・条件付きメモリという「アーキテクチャとしてのスパース性」へ。その根底には常に同じ事前分布(prior)があります。すなわち「本当に重要な成分はごくわずかしかない」ということです。成功した3つの系譜に共通するのは、スパースのパターンがハードウェアに適合していたことです。非構造的な重みプルーニングが敗れたのは、理論のせいではなくハードウェアのせいでした。
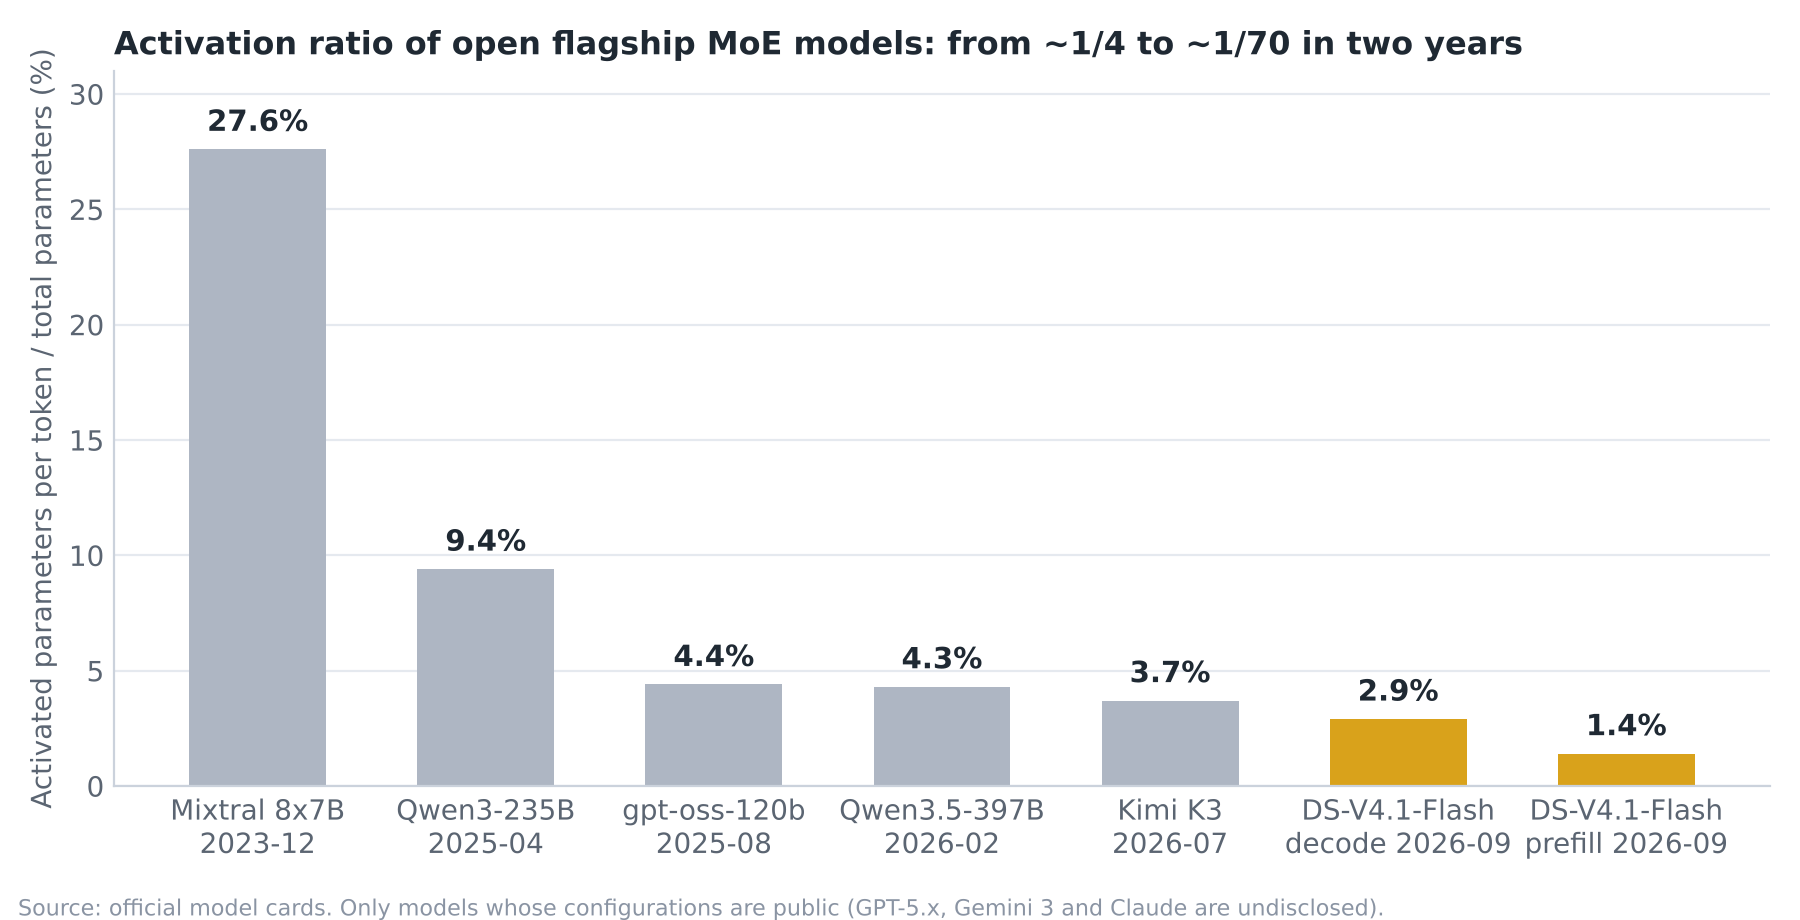
なぜ今なのか。スケーリングが推論コストとメモリの壁に突き当たり、長いコンテキストを扱うエージェントによってKVキャッシュとプリフィルが支配的なコストになったからです。その結果、スパース性の役割は「計算の節約」から「メモリ・帯域・ストレージの節約」へと広がりました。2024年の主流MoEは1トークンあたり約25%のパラメータを活性化していました(Mixtral)が、2026年にはその割合は1.5%〜4.5%にまで下がっています(DeepSeek-V4.1、Kimi K3、Qwen3.5)。
スパース性は万能薬ではない。スパースアテンションに関する過去最大規模の評価(Nawrot et al., Findings of ACL 2026)は、ほぼすべてのスパース構成が少なくとも1つのタスクで大きな性能低下を起こすことを示しました。解釈可能性の分野でも、スパースオートエンコーダ(SAE)は2025年に体系的なネガティブな結果に直面しています。モデル選定は、平均スコアではなく、自分たちの事業にとって最も難しいタスクのスコアで判断しなければなりません。
本稿を貫く2つの軸
5種類のスパース性:活性化のスパース性、重みのスパース性、構造化スパース性、条件付き計算(MoE)、そしてアテンションのスパース性です。「スパース性は役に立つのか」という議論は、どの種類の話なのかを特定しなければ始まりません。
3つの演算子:ソフトしきい値処理(L1の近接作用素)、ハードしきい値処理(L0)、そしてtop-k射影(L0球への射影)です。1994年のウェーブレットノイズ除去から2026年のMoEルーティングまで、「ゼロを作り出す」ステップは、この3つの演算子のいずれかを異なる対象に適用しているにすぎません。現代の大規模モデルのほぼすべては3つ目を使っています。1トークンあたりの計算量を正確に固定でき、ハードウェアの並列粒度と整合するからです。
全体で繰り返し登場する5つの用語
| 用語 | ひとことで言うと |
|---|---|
| トークン | モデルが処理するテキストの最小単位。単語、またはその一部。「1トークンあたり何パラメータが活性化されるか」とは、テキストを少し出力するたびにどれだけの計算を使うか、という意味 |
| パラメータと活性化パラメータ | パラメータはモデルが保持する数値の総体(どれだけ知っているか)。活性化パラメータは1トークンを処理するときに実際に計算へ使われる部分(動かすのにいくらかかるか)。スパース化とはこの2つを切り離すこと |
| 基底と座標 | 「組み立てブロック」の集合。データはその重み付き和として書け、重みが座標にあたる。ブロックを変えれば座標系も変わる。データは同じでも、読み取れる値は変わる |
| ノルム | L2は長さ、L1は成分の絶対値の和、L0は非ゼロ成分の個数。スパースとはL0が小さいこと |
| FLOPsとメモリ帯域 | 計算スループットは1秒あたりの積和演算の回数、帯域は1秒あたりにGPUメモリから運び出せるバイト数。現代の大規模モデルのデコード段階では、ボトルネックはたいてい後者 |
用語についての注記:本稿では「スパース」を厳密に「要素の大半がゼロであること」の意味で使います。「低ランク」は「どの要素もゼロではないが、自由度が少ないこと」を指します(MLAやLoRAなど)。両者はよく混同されますが、本稿では一貫して区別します。
本稿の読み方
本稿は時系列で進み、各時代について同じ4つの問いに答えます。当時の背景とボトルネックは何だったか。スパース性はどのような仕組みで現れたか。何を解決し、何を代償にしたか。今日の大規模モデルとどうつながるか。「前史」の章では、なぜ世界はスパースなのかを問います。「古典時代」では数学がそれをどのように道具へ変えたかを示し、「ニューラルネットワーク時代」ではスパース性がニューラルネットワークに持ち込まれたときになぜプルーニングが敗れたのかを説明します。中心となる「現在」の章では、2023〜2026年に大規模モデルがスパース化へ全面的に舵を切った理由を論じ、各研究機関のアプローチを体系的に比較します。「スパース性と深層学習が出会う場所」では画像・信号処理におけるスパース性と深層学習の融合を扱い、「応用」「恩恵とコスト」「未来」「私たちにとって何を意味するのか」の各章で、応用・コスト・将来、そしてこのすべてが私たちに何を意味するのかを取り上げます。付録には年表・データ・逸話・参考文献をまとめました。
前史:なぜ世界そのものがスパースなのか
スパース性はデータだけの性質ではなく、「データと、その記述の仕方」の組の性質です。世界は適切な基底のもとでスパースになります。そして科学の歴史は、その基底を探す歴史でもありました。この章では3種類の経験的証拠と1つの思想的源流を示し、そのうえで限界を明示します。
哲学と情報理論:直観と枠組みであって、技術的起源ではない
オッカムの剃刀は単純さを好む哲学的原理であって、スパースモデルの技術的な出発点ではありません。Shannon (1948)は「冗長性」を定量化しました。符号長のうち情報源のエントロピーを超える部分は圧縮可能な冗長性であり、スパース表現とは本質的に、その冗長性を表面化させる基底のことです。コルモゴロフ複雑性(1960年代)は「最短の記述」という理想を提示しましたが、計算不可能です。RissanenのMDL(最小記述長、1978)がそれをモデル選択の実用的な基準に変えました。スパースモデルはMDLの特別な場合として読めます。記述長 ≈ 非ゼロ成分の個数 × 係数1つあたりの符号化コスト、というわけです。これらの思想は「スパースモデルの発明者」ではなく「知的な前史」として書かれるべきものです。
自然界からの3つの証拠
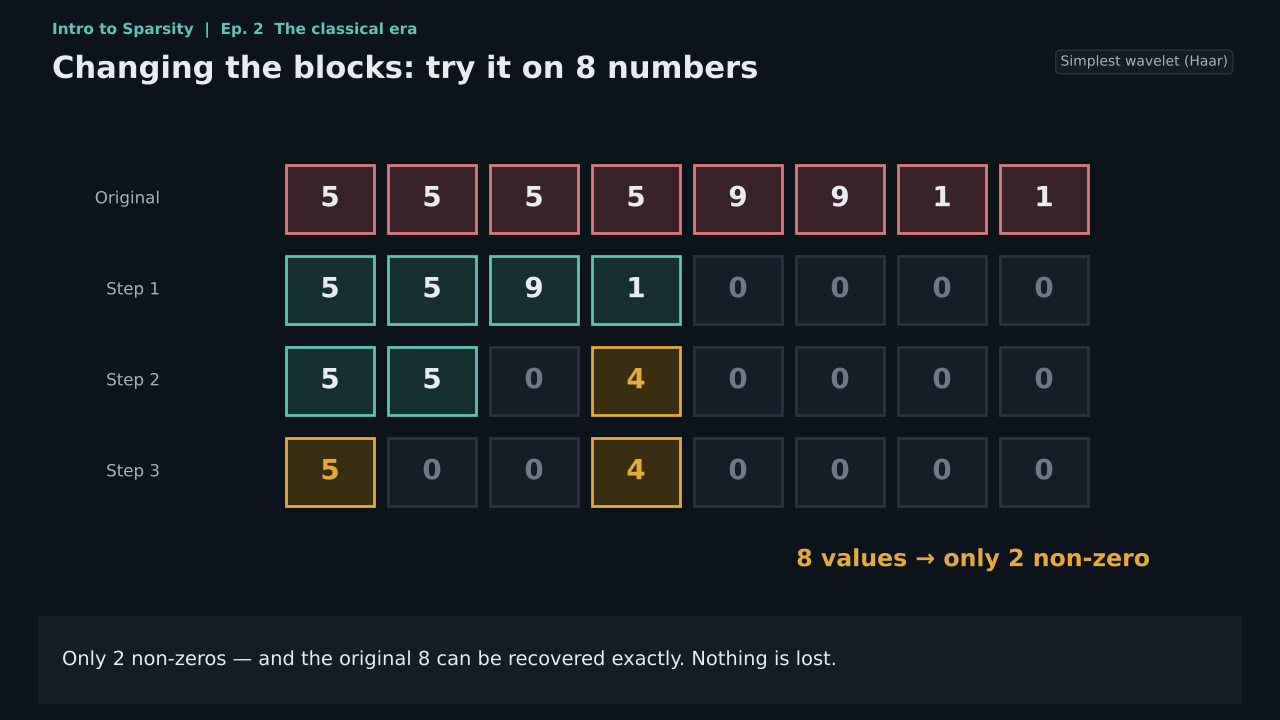
自然画像。自然画像のパワースペクトルはおおよそ1/f²のべき乗則に従い、近似的なスケール不変性を示します(Field 1987; Ruderman & Bialek 1994; レビューとしてSimoncelli & Olshausen 2001)。ウェーブレットのような局所的・バンドパス的な基底では、自然画像の係数はヘビーテイルになります。大半はゼロに近く、エッジ部分のごく少数だけが大きいのです。非線形近似理論(DeVore 1998; Donoho 1993)は、区分的に滑らかな信号については、ウェーブレット基底での最良n項近似の誤差が、どんな固定線形基底よりも速く減衰することを証明しました。これはJPEG2000と圧縮センシングの両方の理論的基盤であり、図3のHaarの例はその最小のデモンストレーションです。
言語。単語の頻度はZipfの法則に従います。ひと握りの単語が出現の大半を占め、裾は極端に長い。だからbag-of-wordsやTF-IDFの表現は極めてスパースになります。同じ統計が、MoEのエキスパートへの負荷が本質的に偏ること、そしてDeepSeekがNグラムのルックアップテーブルを条件付きメモリ(Engram)として使う理由も説明します。
脳。Barlow (1961)は冗長性削減仮説を提唱しました。感覚システムの目的は冗長性を取り除き、統計的に独立な表現を構築することだ、という仮説で、これがスパース符号化の神経科学的な源流です。Attwell & Laughlin (2001)は灰白質のエネルギー収支を計算し、そこからLennie (2003, Current Biology 13:493–497)は、スパイク1回のコストが非常に高いため「同時に実質的に活動できるニューロンの数は、おそらく1%未満に厳しく制限されている」と推定しました。
ここで1つ、どうしても訂正しておくべきことがあります。広く流布している「脳はニューロンの1〜4%しか使っていない」という主張は孫引きです。Glorot、Bordes、Bengio (2011)がLennieを引用した際に「1〜4%」と書き、以来その数字が転載され続けてきました。Lennieの原文は「おそらく1%未満」であり、しかもそれはエネルギー制約から導いた推定上の上限であって、測定値ではありません。スパース性が意味するのは「ある瞬間に強く発火している割合が低い」ことであって、「脳の大部分が遊んでいる」ことではないのです。
限界と反例
スパースは低ランクではない。スパースとは、ある基底や辞書のもとで非ゼロ係数が少ないこと(L0/L1で測る)。低ランクとは、行列の特異値が少ないこと(ランクや核ノルムで測る)。LoRAとMLAは低ランクで、MoE・top-kアテンション・SAEはスパースです。打ち切りSVDが与えるのは低ランク行列であり、そこでスパースなのは特異値のスペクトルだけです。
世界はいつもスパースとは限らない。Robust PCA(Candès, Li, Ma & Wright 2011)はデータを「低ランク+スパース」に分解し、実データがしばしば両方を併せ持つことを示しました。動画では背景が低ランク、前景がスパースです。テクスチャやノイズが支配する信号は、よく使われる基底ではスパースになりません。LLMの残差ストリームにおける特徴の重ね合わせ(superposition)は、個々のニューロンのレベルでは表現が密であり、過完備な辞書のもとで初めてスパースになることを意味します。これが「現在」の章のSAEの議論(「解釈可能性におけるスパース性」の節)の出発点です。
この章のまとめ。スパース性は反証可能な事前分布であって、普遍的な真理ではありません。自然画像・言語・神経活動で繰り返し確認されてきたからこそ「賭ける」価値があります。ただし賭ける前に、必ず1つの問いを立てなければなりません。どの基底のもとでスパースなのか?という問いです。
3つの証拠の詳細:なぜこれらの統計法則なのか
自然画像の1/fスペクトルはどこから来るのか?相補的な説明が2つあります。1つ目はスケール不変性です。自然のシーンに写る物体の大きさは何桁にもわたり、ズームインしてもズームアウトしても画像の統計は変わりません。数学的には、これはパワースペクトルがべき乗則になることを強制します。2つ目は遮蔽(オクルージョン)モデルです。シーンは前後に重なり合う物体で構成され、エッジは不連続を生み、不連続は周波数領域ではゆっくり減衰する高周波の裾として現れます。どちらの説明も同じ結論に行き着きます。自然画像は「ランダムノイズ」でも「どこも滑らか」でもなく、「広く平坦な領域+少数のエッジ」なのです。これこそウェーブレット基底が最も得意とする構造です。Field (1987)はさらに踏み込んで、視覚野の単純細胞の受容野の帯域幅がこの統計に適合しているなら、各細胞の自然画像への応答はヘビーテイルになる、つまりほとんどの時間はほぼ応答せず、ときどき強く発火する、と指摘しました。これが神経科学における「スパース符号化」という言葉の本来の意味です。
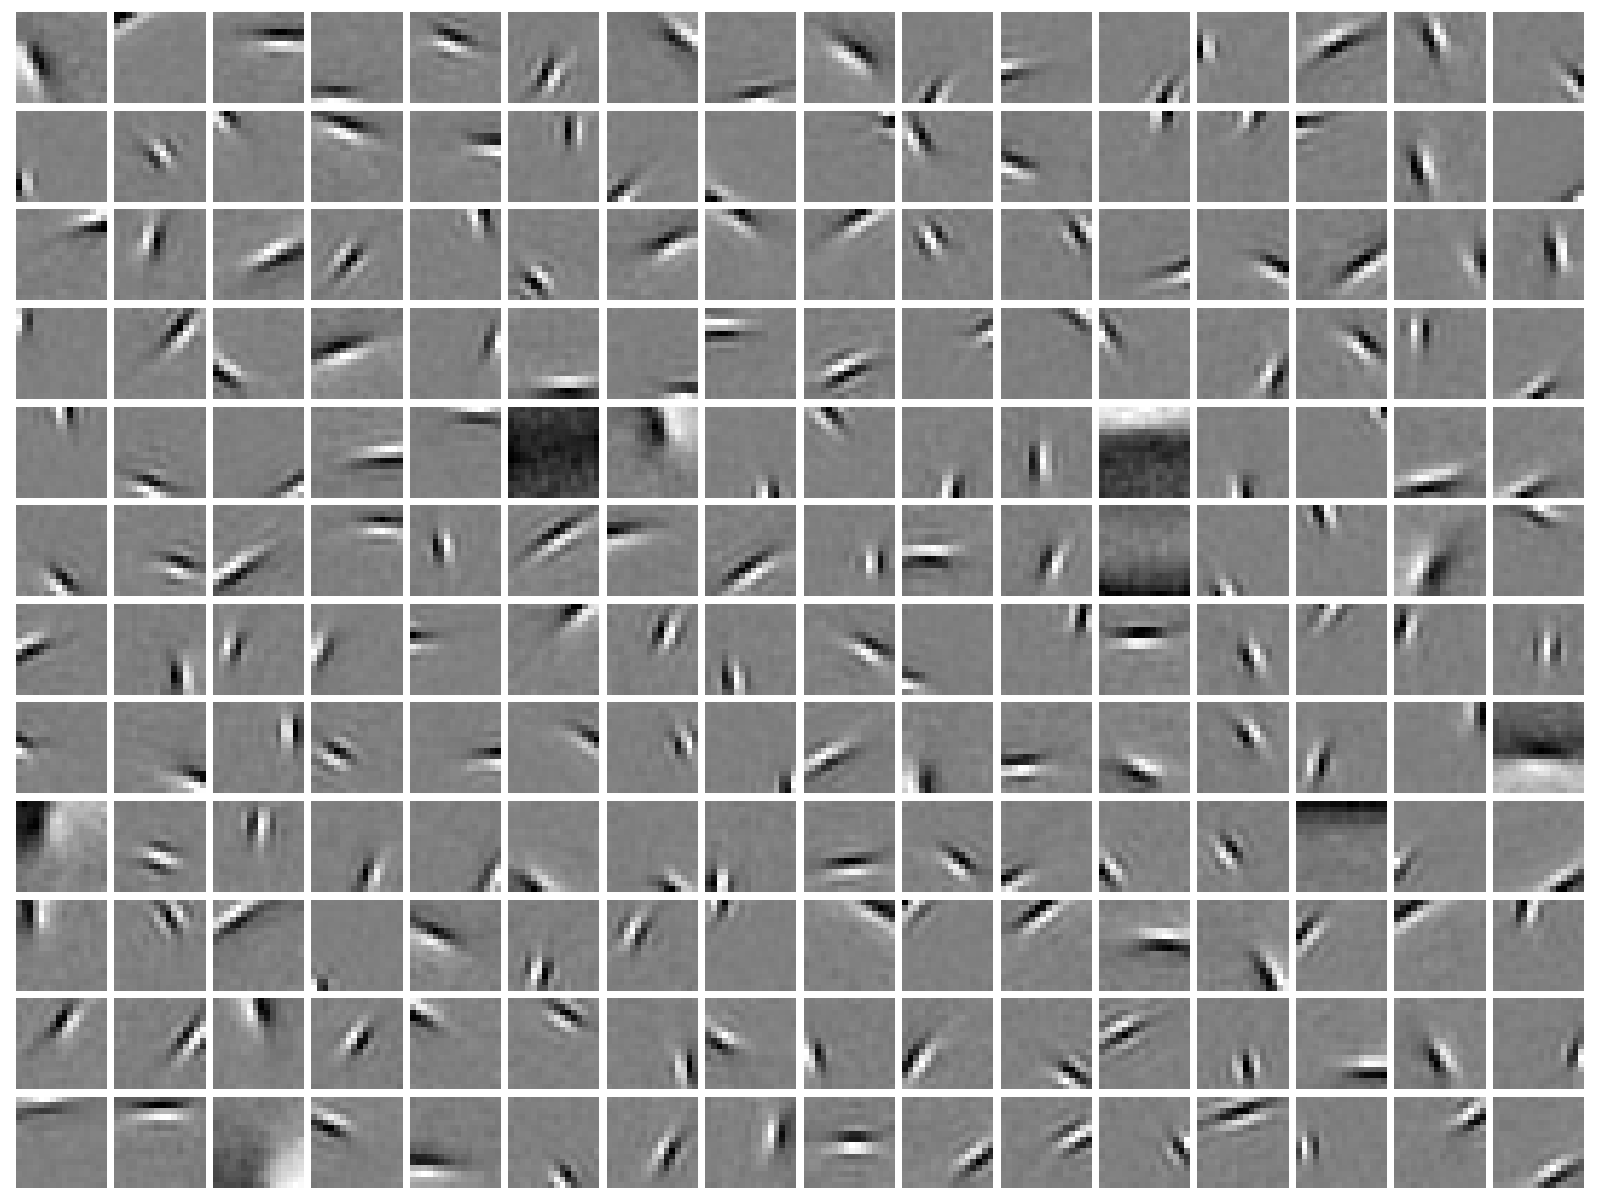
OlshausenとFieldの実験はなぜそれほど説得力があるのか?1996年の実験がアルゴリズムに課した制約は2つだけでした。自然画像のパッチを線形基底関数の組で再構成すること、そして係数をできるだけスパースにすることです。脳に関する事前知識は一切ありません。それでも学習された基底関数は局所的・方位選択的・バンドパス的になり、ネコやサルのV1単純細胞の受容野と酷似しました。この結果の力は方向性にあります。「脳にヒントを得てアルゴリズムを作った」のではなく、「スパース性の原理が脳の構造を独立に予言した」のです。のちにHromádka、DeWeese、Zador (2008)は覚醒ラットの聴覚野で高度にスパースな発火パターンを記録し、Quian Quiroga et al. (2005)はヒト海馬で特定の人物やランドマークに選択的に応答する「概念細胞」を発見しました。いずれもスパース符号化仮説の証拠とされています。異論もあります。Spanne and Jörntell (2015)などは、厳密なスパース符号化は皮質全体で普遍的ではなく、スパースの程度は脳領域やタスクに依存すると論じています。したがってこれは「広く支持されている仮説」として書くべきであり、確定した定説として書くべきではありません。
なぜエネルギーがスパース性を強制するのか?ヒトの脳は体重の約2%ながら、安静時代謝の約20%、およそ20ワットを消費します。Attwell and Laughlin (2001)は、灰白質のエネルギーの大半がシナプス伝達と活動電位に使われると見積もりました。Lennie (2003)はそこから逆算します。スパイク1回にこれだけのコストがかかるなら、皮質はニューロンの大きな割合を同時に高頻度で発火させる余裕はない、と。この議論は「予算制約下の上限」なので、得られるのは測定値ではなく「おそらく1%未満」という推定値です。意義は具体的な数字ではなく論理にあります。エネルギーや帯域が限られたシステムでは、スパース性は選択肢ではなく必然なのです。同じ論理が「ニューラルネットワーク時代」の章で、GPU上の「メモリの壁」として再演されます。
言語におけるZipfの法則とロングテール。Zipf (1935)は、単語の頻度がその順位にほぼ反比例することを観察しました。2番目に多い単語は1番目の約半分、10番目は約1/10の頻度で現れます。のちにMandelbrotが補正形を与えました。直接の帰結は、どんなテキストも語彙のごく一部しか使わず、大半の単語は1、2回しか現れないということです。統計的言語モデルの時代には、これは極端にスパースなnグラム頻度行列と、「ゼロ確率」の平滑化問題(Good–Turing、Kneser–Ney)として現れました。大規模モデルの時代には2つの形で戻ってきています。1つはMoEのルーティング負荷が本質的に偏ること。人気のエキスパートがトークンの大半を引き受けるため、負荷分散の仕組みが介入せざるを得ません。もう1つはDeepSeekのEngramです。Nグラムのルックアップテーブルをフロンティアのアーキテクチャに復活させ、頻出パターンは安価なルックアップ経路に流し、本当に推論が必要なものだけを高価なTransformer層に残すのです。
物理学と工学におけるスパース性
スパース性の歴史は、機械学習よりも工学のほうが長いのです。科学計算では、有限要素法や電力潮流方程式の係数行列は本質的にスパースです。各ノードは隣接ノードとしか結合しないからです。Tinney and Walker (1967)は電力系統を解く中で、ガウス消去の際の「フィルイン」を減らす最適順序付けを提案しました。これがスパース直接法の出発点です。続いてRose (1972)が消去過程をグラフ理論の言葉で記述し、Gilbertらがスパース LU分解を発展させ、スパース線形代数は一つの分野になりました。地震探査では、地下の反射率系列はスパースなスパイク列としてモデル化され、デコンボリューション問題はL1正則化で解けます。圧縮センシングの20年先取りです。レーダー・アレイ信号処理では、ターゲットは角度・距離・速度の空間にスパースに分布しており、超解像推定にスパース復元が使われています。
これらの分野に共通するのは、スパースのパターンが物理的構造(隣接関係、反射、ターゲットの数)に由来するため、予測可能で活用可能だということです。これは「古典時代」のウェーブレット(構造の出どころは区分的な滑らかさ)や「現在」のMoE(構造の出どころはエキスパートのブロック)と地続きであり、「ニューラルネットワーク時代」で非構造的な重みスパース性が敗れる理由も説明します。そのゼロには物理的構造がなく、ハードウェアが活用できないのです。
社会現象に映る鏡と、この考え方の限界
Paretoの80対20の法則、Andersonのロングテール、そして「少数の重要な変数が分散の大半を説明する」という因子分析の伝統は、いずれも社会科学に映ったスパース性事前分布の鏡です。これらが示すのは、スパース性が世界の構造に関する仮定であって、定理ではないということです。Gelmanらの統計学者は「スパース性に賭けよ」に疑問を呈してきました。社会科学の多くの問題では真の効果は密で小さく、スパースな手法はそれを系統的に見逃す、と論じています。同じ批判は機械学習にも当てはまります。LLMの残差ストリームの特徴は重ね合わせによって密に格納されており、スパース性は過完備な辞書に切り替えて初めて現れます。したがって本稿の立場は次のとおりです。スパース性は膨大な自然データで繰り返し確認されてきたのだから、最初に賭けるに値する事前分布である。ただし賭けるたびに「どの基底のもとでスパースなのか?」に答え、証拠が支持しないなら手放す用意をしておくこと。
古典時代(1960年代〜2014年):スパース性はいかにして計算可能な道具になったか
古典時代に成功したスパース手法にはひとつの共通点があります。スパースのパターンが構造化されていて予測可能だったからこそ、ハードウェアや業界標準に取り込まれ得たのです。これは「ニューラルネットワーク時代」で語られる「敗北」の伏線でもあります。下の表は、それぞれの手法がなぜその時期に現れたのか、当時のボトルネックは何だったのか、何を解決したのかという3つの問いでマイルストーンを整理したものです。
| マイルストーン | なぜその時期に現れたか | 当時のボトルネック | 何を解決したか |
|---|---|---|---|
| スパース行列の直接法(Tinney & Walker 1967) | 電力網が大規模化、メモリはKB単位の時代 | 密な消去法はO(n³)でメモリに収まらない | 非ゼロ要素だけを保存し、最適順序付けでフィルインを削減 |
| ウェーブレット(Daubechies 1988; Mallat 1989) | フーリエ基底はエッジに対してスパースでない | エッジのエネルギーが周波数領域全体に拡散する | 区分的に滑らかな信号がウェーブレット領域でスパースになる |
| Matching Pursuit (Mallat & Zhang 1993) | 過完備辞書の登場 | 表現が一意でない | 貪欲法によるアトム選択 |
| ウェーブレットしきい値ノイズ除去(Donoho & Johnstone 1994) | 係数はスパース、ノイズは一様 | 線形フィルタはエッジまでぼかす | ソフトしきい値処理=L1の近接作用素。ほぼミニマックス最適 |
| Breimanのgarrote 1995 → LASSO (Tibshirani 1996) | p ≫ nの高次元データ | 最小二乗は不良設定、部分集合選択は不安定 | 縮小推定と変数選択を同時に実現 |
| Basis Pursuit (Chen, Donoho & Saunders 1998) | 凸最適化が成熟 | L0はNP困難 | L1による凸緩和 |
| 非線形近似(DeVore 1998) | 「大きい方からk個残す」ことの最適性の説明が必要だった | 線形近似は収束が遅い | 最良n項近似の理論 |
| JPEG (1992) / JPEG2000 (2000) | デジタル画像の普及 | 帯域とストレージ | スパース変換+量子化+エントロピー符号化 |
| LARS (Efron et al. 2004); Elastic Net (Zou & Hastie 2005) | LASSOに効率的なパスアルゴリズムが必要だった | 解くのが遅い、相関のある変数で不安定 | 正則化パス全体を一括計算。L1+L2 |
| 圧縮センシング(Candès–Romberg–Tao 2006; Donoho 2006) | スパース理論がランダム行列理論と出会った | サンプリングはナイキスト周波数に縛られていた | RIP条件の下、m ≳ k·log(n/k)回の測定からの復元 |
| K-SVD (Aharon, Elad & Bruckstein 2006) | 学習可能な辞書が必要だった | 固定のウェーブレットは特定データに適合しない | スパース符号化と辞書更新の交互最適化 |
| Donoho–Tanner相転移(2009) | L1が成功する条件の特徴付けが必要だった | 理論上界が緩すぎた | (m/n, k/m)平面における鋭い相転移 |
| スパース符号化(Olshausen & Field 1996)、高速アルゴリズム(Lee, Battle, Raina & Ng 2007) | Barlow仮説への応答 | V1受容野はなぜGabor状なのか | スパース辞書がV1受容野を再現 |
| ネコ顔ニューロン(Le et al. 2012) | 分散学習の登場 | 高次の特徴は教師なしで出現するか | 後述 |
| 最適特異値ハードしきい値(Gavish & Donoho 2014) | 低ランクノイズ除去に原理的なしきい値が必要だった | 打ち切りランクは経験則で選ばれていた | 正方行列でσ既知なら(4/√3)√n·σ、未知なら中央値の2.858倍 |
統計学における「スパース性に賭けよ」の原則
Hastie、Tibshirani、FriedmanはThe Elements of Statistical Learningで「bet on sparsity(スパース性に賭けよ)」の原則を唱えました。真のモデルがスパースなら、L1はそれを見つけられる。スパースでないなら、どんな手法もうまくいかない。だからスパース性に賭けよ、というわけです。高次元統計学はその正確な代償を定量化しました。p次元のkスパースなベクトルを復元するにはn ≳ k·log pのサンプルで足ります(Wainwright 2009)。圧縮センシングでの対応する結果はm ≳ C·k·log(n/k)回のランダム測定で、RIP定数がδ₂ₖ < √2−1 ≈ 0.414を満たせばL1で厳密に復元できます(Candès 2008)。
実世界の3つの事例(数値は検証済み)
CS-MRI。Lustig、Donoho、Pauly (2007)が圧縮センシングMRIの基礎を築きました。臨床の数値は正確に引用する必要があります。Sartoretti et al. (2019, PLoS ONE 14(4): e0214887)は、日常臨床において平均スキャン時間が20.2%短縮、検査時間が16%短縮、適用シーケンスの撮像時間が23%〜43%短縮、同期間の検査件数が27%増加したと報告しています(一次資料)。Vranic et al. (2019, AJNR 40(1):92–98)は脳のFLAIRとGREのシーケンスでそれぞれ25%と35%の短縮を報告しています。よく引用される「30%〜60%の高速化」には一次資料の裏付けがありません。
ブラックホール撮像(EHT)。2019年のM87*の最初の画像を支えた3つの画像化パイプラインの1つであるSMILIは、Honma et al. (2014)とAkiyama et al. (2017)のスパースモデリング(L1+TV正則化)の系譜にあります。別のパイプラインであるCHIRP (Bouman et al. 2016)は純粋な圧縮センシングではなくパッチ事前分布を使っており、「一人の研究者が圧縮センシングでブラックホールを撮影した」という報道は単純化です。
ネコ顔ニューロン。Le et al. (2012, ICML, arXiv:1112.6209)は、約10億結合の9層・局所結合スパースオートエンコーダを、YouTubeの1,000万フレームで「1,000台のマシン(16,000コア)で3日間」学習させました。教師なしで、人の顔とネコの顔に選択的に応答する単一ニューロンが出現し、下流のImageNetでは15.8%の精度に到達、従来の最高値から相対70%の改善でした。この「スパース符号化 → 教師なし特徴」の系譜は2012年以降、教師ありCNNに押されて衰退しますが、2023年にAnthropicのSAEとして戻ってきます。
並行する系譜:低ランク
打ち切りSVD(Eckart–Young–Mirskyの定理)はランクk以下のすべての行列の中での最良近似であり、Gavish & Donoho (2014, IEEE T-IT 60(8):5040–5053)はノイズ除去のための最適なハードしきい値を与えました。これはウェーブレットしきい値ノイズ除去と構造的に同型です。どちらも「基底を変える → しきい値処理 → 逆変換」に従い、違いはウェーブレット基底が固定であるのに対しSVDの基底はデータから計算されることだけです。前者では信号はしきい値処理後もスパースのままですが、後者では打ち切られた行列は低ランクながら密です。この系譜は「現在」の章で、MLAとLoRAという形で大規模モデルに戻ってきます。
一歩ずつ:なぜそれぞれの進歩はその時期に起きたのか
フーリエからウェーブレットへ(1980年代)。フーリエ基底は信号を大域的な正弦波に分解します。定常信号には効率的ですが、エッジや過渡現象には極端に無駄が多い。たった1つのステップを表現するのに無限個の周波数成分が必要で、エネルギーが周波数領域全体に拡散してしまいます。工学にはGabor変換や短時間フーリエ変換といった回避策がすでにありましたが、統一的な数学的枠組みがありませんでした。Mallat (1989)が多重解像度解析を定式化し、Daubechies (1988)がコンパクトな台を持つ直交ウェーブレットを構成したことで、局所性・マルチスケール構造・直交性の3つを同時に満たせるようになりました。各ウェーブレット基底関数は有限の範囲でだけ非ゼロで、あらゆるスケールで繰り返されます。したがって区分的に滑らかな信号は、エッジの位置と少数のスケールでだけ大きな係数を生み、それ以外はほぼゼロになります。DeVore (1998)とDonoho (1993)は、これが経験的な偶然ではないことを証明しました。区分的に滑らかな関数のクラスでは、どんな固定線形基底も、ウェーブレット基底での最良n項非線形近似の誤差減衰率にかなわないのです。JPEG2000 (2000)はこの理論を標準規格に変え、JPEGのDCTをウェーブレットに置き換えて、同じビットレートでのブロックノイズを大幅に減らしました。
最小二乗からLASSOへ(1990年代)。統計学が直面したのは別の種類のスパース性でした。係数がある基底のもとでスパースかどうかではなく、「どの説明変数が本当に重要なのか」です。古典的なアプローチは部分集合選択(ステップワイズ回帰、AIC/BIC)でしたが、組合せ探索であり、データのわずかな摂動に対して極めて不安定です。Breiman (1995)は非負のgarroteを提案し、変数選択を連続的な縮小問題として捉え直しました。それに触発されたTibshirani (1996)がLASSO、すなわちL1ペナルティ付き最小二乗を提案します。L1の挙動はその幾何が決めています。制約領域は角を持つダイヤモンドで、最適解は角に乗りやすく、各角はいくつかの係数がちょうどゼロになる点に対応します。これが「縮小と選択が同時に起こる」メカニズムです。LASSOのアルゴリズム上のボトルネックは2004年のLARS(Efron、Hastie、Johnstone、Tibshirani)が取り除き、正則化パス全体を一度に計算できるようにしました。2005年にはZouとHastieのElastic NetがL1+L2で強く相関する変数群を扱えるようにしました。高次元統計学は理論保証を与えます。Wainwright (2009)はp次元でk個の非ゼロ係数を復元するにはn ≳ k·log pのサンプルで十分なことを証明し、Bickel、Ritov、Tsybakov (2009)はLASSOとDantzigセレクタのオラクル不等式を確立しました。
信号処理における独立した発見(1993〜1998年)。ほぼ同じ時期、信号処理は「過完備辞書」から出発して同じL1にたどり着きました。Matching Pursuit (Mallat and Zhang 1993)は残差と最も相関するアトムを貪欲に選び、Basis Pursuit (Chen, Donoho, and Saunders 1998)は「最もスパースな表現を見つける」というNP困難なL0問題をL1の線形計画に緩和しました。LASSOとBasis Pursuitは数学的には同じ問題の2つのパラメータ化ですが、ほとんど交流のない2つのコミュニティから生まれました。スパース性という考え方が「複数の源から収束する」最初の事例です。
ノイズ除去:スパース性が初めて直接価値を生んだ瞬間(1994年)。DonohoとJohnstoneのウェーブレットしきい値ノイズ除去は、上の理論を3ステップの手順に変えました。直交変換でウェーブレット領域に移る。係数にしきい値λ=σ√(2 log n)のソフトしきい値処理S_λ(w)=sign(w)·max(|w|−λ,0)を適用する。逆変換で信号領域に戻る。これがうまくいく鍵は、直交変換が白色雑音の統計的性質を保存することにあります。ウェーブレット領域でも、ノイズは等分散の独立なガウス雑音のまま全係数に均等に広がる一方、信号のエネルギーは少数の大きな係数に集中するので、小さい係数を捨てれば済むのです。ソフトしきい値処理の演算子はまさにL1ペナルティの近接作用素であり、だからこそノイズ除去、LASSO、のちのISTA/FISTA (Beck and Teboulle 2009)、そしてLISTA (Gregor and LeCun 2010、アルゴリズム展開の出発点)が、すべて同じ中核演算を共有しているのです。
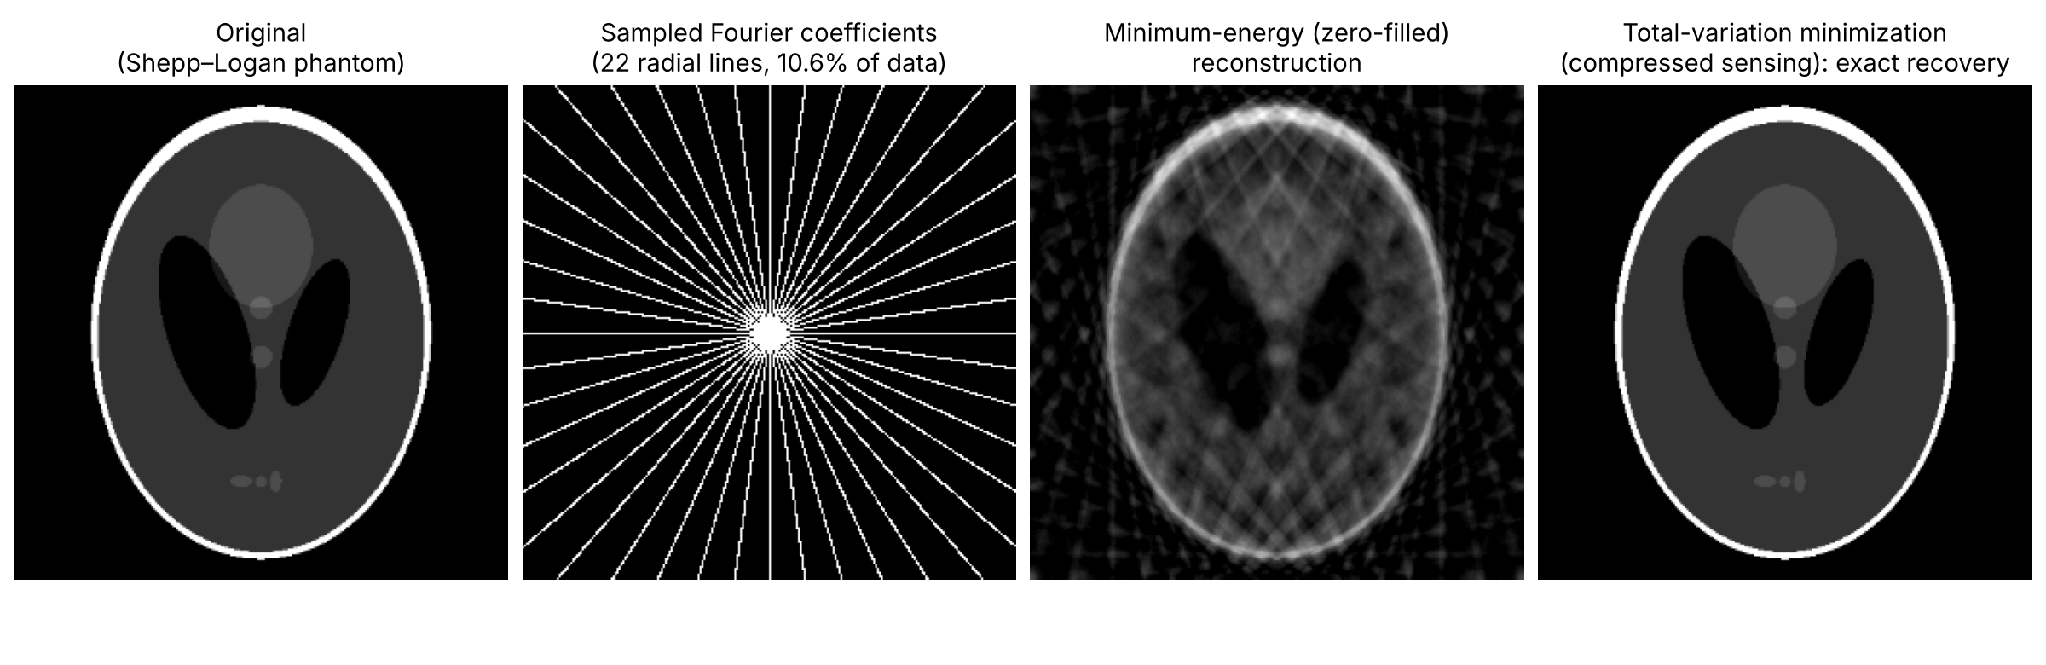
圧縮センシング:スパース性を「少なく測って多く得る」に変える(2004〜2009年)。ここまでのどの手法も、完全なデータが手元にある前提でスパース表現を探していました。Candès、Romberg、Tao (2006)とDonoho (2006)は逆の問いを立てます。信号がある基底のもとでkスパースだと分かっているなら、厳密な復元には何回の測定が必要か?答えはm ≳ C·k·log(n/k)回のランダム線形測定で、ナイキストレートをはるかに下回ります。条件は、測定行列が制限等長性(RIP)を満たすこと、つまりすべての2kスパースなベクトルの長さをほぼ保存することです。Candès (2008)は十分条件δ₂ₖ < √2−1 ≈ 0.414を与え、DonohoとTanner (2009)は組合せ幾何を使ってL1復元の成功と失敗の間の鋭い相転移を特徴付けました。圧縮センシングの歴史的意義は、スパース性を「表現の性質」から「サンプリングの原理」に昇格させ、撮像ハードウェアの設計を直接変えたことです。Lustig、Donoho、Pauly (2007)はこれをMRIに持ち込み、ランダムなアンダーサンプリング軌道と引き換えにスキャン時間を短縮しました。Duarte et al. (2008)はシングルピクセルカメラを作り、電波天文学ではSMILIパイプラインがEHTのブラックホール撮像にL1と全変動正則化を使いました。
辞書学習とスパース符号化:固定基底から学習基底へ(1996〜2012年)。ウェーブレットは人間が設計した固定基底であり、特定のデータに最適とは限りません。Olshausen and Field (1996)はデータから辞書を学習し、V1の受容野を再現しました。K-SVD (Aharon, Elad, and Bruckstein 2006)は、スパース符号化とアトムごとのSVD更新を交互に行う実用的なアルゴリズムを与えました。Lee、Battle、Raina、Ng (2007)はL1スパース符号化を高速化し、「self-taught learning」を前進させました。Le et al. (2012)はスパースオートエンコーダを9層・10億結合まで積み上げ、YouTubeの1,000万フレームから教師なしでネコ顔選択的なニューロンを学習しました。2012年のAlexNet以降、この系譜は教師あり畳み込みネットワークの陰に10年間隠れますが、2つのものを残しました。「過完備辞書+スパース係数」という表現の枠組みと、「辞書はデータから学習できる」という確信です。2023年にAnthropicがスパースオートエンコーダで大規模モデルの内部特徴を解読したとき、引用したのはまさにOlshausenとFieldであり、関連論文の共著者にはOlshausen本人がいました。
低ランク:スパース性の双子(1936〜2014年)。Eckart and Young (1936)は、打ち切りSVDが行列の最良低ランク近似であることを証明しました。低ランクとスパースは構造的に同型です。どちらも「エネルギーを少数の成分に集中させ、裾を切り捨てる」のですが、作用する対象が違います。スパースは座標を切り、低ランクは方向を切るのです。Gavish and Donoho (2014)は低ランクノイズ除去の最適ハードしきい値を与え、ウェーブレットノイズ除去の普遍しきい値と響き合いました。Robust PCA (Candès et al. 2011)は両者を組み合わせます。データ=低ランク+スパース、です。この区別は「現在」の章で決定的に重要になります。DeepSeekのMLAは低ランク圧縮であり、DSAとCSA2こそがスパースアテンションです。両者はしばしば混同されます。
まとめ:古典時代が深層学習に残した3つの遺産
第一に、データの処理よりも、正しい基底を見つけることのほうが重要だということ。同じ画像がピクセル基底では密で、ウェーブレット基底ではスパースになります。違いはすべて記述の仕方にあります。第二に、ゼロを作る演算は3つしかないこと。ソフトしきい値処理(L1)、ハードしきい値処理(L0)、そして大きい方からk個を残すこと(L0球への射影)です。第三に、構造化されたスパース性だけがハードウェアと標準規格に到達すること。ウェーブレットの木構造はJPEG2000に、ランダムアンダーサンプリングはMRI製品に入りました。3つの遺産はいずれも、「ニューラルネットワーク時代」と「現在」で装いを新たにして再登場します。
ニューラルネットワーク時代(1990〜2022年):スパース性の挫折と転機
スパース性が敗れたのではありません。ハードウェアに適合しないスパース性が敗れたのです。非構造的な重みプルーニングは理論では成功し、GPUの上で敗北しました。MoEはスパース化の単位をエキスパートブロック丸ごとにし、各エキスパートの内部は密な行列積のままだったので、ハードウェアの宝くじを引き当てました。この章ではその理由を説明します。
プルーニングの系譜と「スパース性の壁」
OBD (LeCun, Denker & Solla 1990)は二次の情報から各重みの重要度を推定し、OBS (Hassibi & Stork 1993)はそれを完全なヘッセ行列で精緻化しました。Deep Compression (Han, Mao & Dally 2016)はプルーニング・量子化・ハフマン符号化を組み合わせ、AlexNetを240 MBから6.9 MBに圧縮しました。宝くじ仮説(Frankle & Carbin 2019)は、密なネットワークの中に、単独で学習しても同じ精度に達するスパースな部分ネットワークが含まれることを示しました。SparseGPT (Frantar & Alistarh 2023)とWanda (Sun et al. 2023)は、GPTクラスのモデルを精度をほぼ落とさずワンショットで50%スパースにできることを示しました。
しかしLLMの時代が来ると、この系譜は壁に突き当たります。2025年10月のELSA論文(arXiv:2510.01650)はそれを「スパース性の壁」と呼びます。既存手法は「精度を大きく落とさずに50〜60%のスパース性を超えることはできないように見える」のです。ELSAはADMMを使えばLLaMA-2-7Bを90%近くまでプルーニングできると主張していますが、その主張はまだ議論の最中です。
活性化スパース性:ReLUの実際の数字
Glorot、Bordes、Bengio (2011, AISTATS)が活性化スパース性の一次資料であり、その数字は正確に引用する価値があります。一様初期化の直後、隠れユニットの約50%が厳密なゼロを出力します。学習後の平均の厳密スパース率はMNISTで83.4%、CIFAR10で72.0%、NISTPで68.0%、NORBで73.8%。結論は「最もよく汎化するモデルのスパース率は50%から80%の間」であり、性能を損なわずに約85%までスパース性を強制できる、というものです。「ReLUは90%スパース」という主張に原典の裏付けはありません。
ついでに1つ区別しておきましょう。Dropoutは学習時に適用されるランダムな正則化で、推論時にはネットワークは密に戻ります。プルーニングは重みを恒久的に削除します。どちらも「マスクの適用」と書けますが、マスクのランダム性、作用する段階、目的はまったく別物です。
なぜ非構造的な重みスパース性はGPU時代に敗れたのか
ハードウェアの宝くじ。Hookerの定義(The Hardware Lottery, 2020/2021)によれば、研究アイデアが勝つのは、それが優れたアイデアだからではなく、手に入るソフトウェアとハードウェアに適合しているからです。GPUとTPUは密で連続的な行列積のために設計されています。非構造的なスパース性はgather/scatterを持ち込み、GEMMのタイル化されたデータフローを壊し、オンチップキャッシュの再利用を減らし、たいていテンサーコアを使えません。経験的には、cuSPARSEのようなライブラリが明確な高速化を示すのはスパース率がおよそ90%を超えてからで、50%の非構造的スパース性では、GPU上で密なGEMMに勝てる既製カーネルはほぼ存在しません。
2:4構造化スパース性。Ampere以降のGPUは、4つの重みのうちちょうど2つがゼロというパターンをサポートし、パターンが満たされれば理論スループットは2倍になります。しかしスパース率は50%で頭打ちで、精度の回復には再学習かファインチューニングが必要で、エンドツーエンドの高速化が2倍に近づくことはまれなため、LLMのデプロイでは量子化ほど普及しませんでした。
なぜ量子化が勝ったのか。量子化はパラメータあたりのビット数を減らしますが、行列の規則性には手を付けないので、どのGPUも自然に恩恵を受けます。GPTQ (2022)とAWQ (2023)のあと、MXFP4は2025〜2026年のネイティブフォーマットになりました。gpt-ossはMoEの重み(全パラメータの90%以上)をMXFP4(1パラメータあたり4.25ビット)で保存しており、それが120bモデルを1枚の80 GB GPUに収めることを可能にしています。Kimi K3はMXFP4の重みとMXFP8の活性で量子化認識学習(QAT)を行い、DeepSeek-V4系のエキスパートパラメータはFP4を使っています。
メモリの壁。V100からB200まで、ピーク計算性能の伸びはメモリ帯域の伸びをはるかに上回りました(各ベンダーの公表仕様に基づく桁感の数字)。
| GPU | 密なBF16/FP16計算性能 | HBM帯域 | 1バイトあたりの演算数(概算) |
|---|---|---|---|
| V100 (2017) | 約125 TFLOPS | 0.9 TB/s | 140 |
| A100 (2020) | 約312 TFLOPS | 1.6–2.0 TB/s | 155–195 |
| H100 SXM (2022) | 約989 TFLOPS | 3.35 TB/s | 295 |
| B200 (2024) | 約2.2 PFLOPS (FP4では約9 PFLOPS) | 約8 TB/s | 280 (FP4では約1,100) |
デコード中は、トークンを1つ生成するたびに、計算に関与する重みをGPUメモリから運び出さなければなりません。バッチサイズが小さいと演算ユニットはほとんど遊んでいて、ボトルネックは帯域になります。だからこそ「FLOPsを減らす」よりも「読み出すべきパラメータとKVを減らす」ほうが価値があるのです。MoEはトークンあたりに読む重みのバイト数を減らし、スパースアテンションとKV圧縮はキャッシュのバイト数を減らします。どちらも、まさに最も高くつく費目を削っているのです。
条件付き計算の系譜(転機)
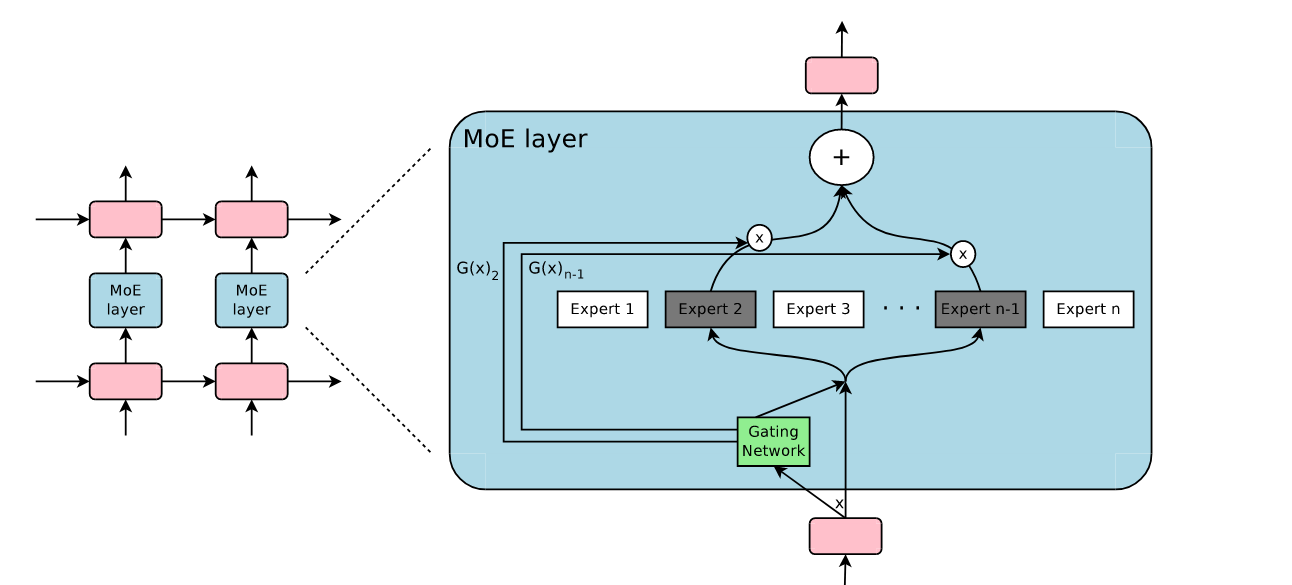
1991年 Jacobs、Jordan、Nowlan、HintonによるAdaptive Mixtures of Local Experts。複数のエキスパートネットワークをゲーティングネットワークと一緒に学習させるもので、当初の動機はタスク間の干渉を減らすことでした。1994年にはJordan & Jacobsが階層型MoEに拡張します。
2013年 Bengioらが条件付き計算と、確率的ニューロンを通じた勾配推定(STE)を提案。Eigen、Ranzato、Sutskeverが深層ネットワークでのMoEを早期に試みました。
2017年 ShazeerらによるOutrageously Large Neural Networks(共著者にHintonとDean)。最大137BパラメータのスパースゲートMoE層をLSTM層の間に挿入し、「計算効率のわずかな損失だけでモデル容量を1000倍超に改善」しました。原文は「greater than 1000x」であること、137BはMoE層のパラメータ数を指すことに注意してください。
2020〜2022年 GShardがMoEをTransformerに持ち込んで600B超にスケールさせ、Switch Transformer (Fedus, Zoph & Shazeer 2021)はtop-1ルーティングで1兆パラメータに到達。GLaMとST-MoEは安定性の問題(router z-loss)に取り組み、Expert Choice (2022)はエキスパートがトークンを選ぶ方式に反転させて、負荷を自然に均衡させました。
この節を一文で言えば:1991年から2022年まで、条件付き計算というアイデアは変わっていません。変わったのは、ハードウェアと、それに見合うスケールがようやく到来したことです。
MoEを論文から製品へ:2017〜2022年に解かれた工学的問題
Shazeer et al. (2017)は容量を1000倍に拡張できることを示しましたが、MoEを信頼できる製品にするにはさらに5年と、4つの具体的な問題の解決が必要でした。
ルーティングをどう学習するか。ゲートはs = Softmax(W_g·h)を出力し、上位k個のエキスパートが選ばれ、層の出力はy = h + Σ_{i∈T} s_i·FFN_i(h)になります。問題は、top-kが離散的な選択であるため、sに関する微分がほぼ至るところでゼロになることです。勾配は選ばれたエキスパートのゲート重みにしか届かず、選ばれないエキスパートは永遠に学習の機会を得られません。Shazeerの解決策はNoisy Top-kゲーティングで、ロジットに学習可能なガウスノイズを加え、k+1位になるはずだったエキスパートがときどき選ばれるようにしました。より一般的な解決策は、Bengio et al. (2013)のストレートスルー推定量(STE)と、のちのGumbel-Softmaxです。
負荷をどう均衡させるか。ルーターにはrich-get-richer(富める者はさらに富む)の傾向があります。人気のエキスパートほど選ばれ、選ばれるほどよく学習され、さらに選ばれやすくなり、ついには少数のエキスパートが全トラフィックを抱えてモデルが実質的に小さなモデルに退化します(エキスパート崩壊)。GShardとSwitch Transformerは補助の負荷分散損失 L_bal = α·N·Σ f_i·P_i を導入しました。f_iはエキスパートiに割り当てられたトークンの割合、P_iはその平均ゲート確率です。ST-MoE (2022)はさらにrouter z-lossでロジットの爆発を抑えました。これらの補助損失は機能しますが、本来の言語モデリング目的関数の勾配を乱します。2024年、DeepSeek-V3は「勾配の外にあるバイアス」でこのトレードオフを回避しました(「現在」の章を参照)。
容量をどう設定するか。分散学習では各エキスパートのバッファサイズを事前に固定する必要があり、そこで容量係数(capacity factor)が登場します。エキスパートあたりの容量 = capacity_factor × (トークン数 / N)です。容量を超えたトークンはドロップされ(token dropping)、残差接続だけを通過します。容量係数が大きいとメモリの無駄、小さいと品質の低下。MegaBlocks (2023)はブロックスパースな行列積で「ドロップレス」MoEを構築し、このジレンマから抜け出しました。
通信をどう生き延びるか。エキスパートは別々のGPUに置かれ(エキスパート並列)、各MoE層はデータ依存のall-to-all交換を2回要求します。トークンをエキスパートのいるGPUに送り、結果を回収するのです。これはMoE学習における主要な通信ボトルネックであり、MoEが大規模で集中型のデプロイに向く理由でもあります。DeepSpeed-MoEやTutelからDeepSeekのDeepEPまで、これらのシステムはすべてこの経路を最適化しています。
マイルストーン:GShard (2020)はMoEをTransformerに持ち込み600B超へ。Switch Transformer (2021)はtop-1ルーティングで1兆パラメータに到達し、T5-XXLの4倍の速さで事前学習しました。GLaM (2021)は総パラメータ1.2T・活性化約97Bで、GPT-3の約3分の1のエネルギー消費でした。Expert Choice (2022)は方向を逆転させ、エキスパートにトークンを選ばせて負荷を自然に均衡させました。
なぜ2022年以前のMoEはまだ主流でなかったのか
これらの工学的解決策が揃っても、2022年のMoEはまだGoogle社内の「大企業のおもちゃ」でした。理由は3つあります。第一に、コスト圧力がまだ十分に強くなかったこと。GPT-3の時代には密なモデルがまだ急速に進歩しており、推論コストは主要な制約ではありませんでした。第二に、オープンなエコシステムがなかったこと。高品質なオープンウェイトのMoEが存在せず、コミュニティは再現も改善もできませんでした。第三に、ファインチューニングが難しかったこと。小さなデータセットではルーティングが崩壊しやすく、下流タスクへの適応は密なモデルほどスムーズではありませんでした。
この3つの条件は2023年末に一度に変わりました。Mixtral 8x7B (2023年12月)が最初の高品質なオープンMoEになり、ChatGPT規模のトラフィックが推論コストを最も切実な問題にし、DeepSeekMoE (2024年1月)が細粒度エキスパートと共有エキスパートでMoEのコスト効率を新しい水準に押し上げたのです。ここから「現在」が始まります。
まとめ
この章の3つの系譜、すなわちプルーニング・活性化スパース性・条件付き計算は、2022年以前にまったく異なる運命をたどりました。プルーニングは理論で成功し、ハードウェアで敗れました。活性化スパース性(ReLU)はどこでも使われ、ほとんどどこでも活用されませんでした。条件付き計算はすべてが揃っていて、経済的な圧力だけが欠けていました。この運命の違いを理解すれば、2023年以降の勝者が重みプルーニングではなくMoEだった理由が分かります。スパース性を実用化できるかどうかは、そのゼロがハードウェアの活用できる構造を持つかどうかで決まるのです。
現在(2023年〜2026年9月):なぜLLMはスパース性に全面的に賭けたのか
2026年までに、最先端オープンモデルの1トークンあたり活性化率は1.5%〜4.5%にまで下がり、スパース性はFFNからアテンション、KVキャッシュ、そして知識の保存そのものにまで広がりました。この章ではまず4つの圧力を示し、次に5種類のスパース性を順に棚卸しし、最後に統一理論と経済の話に進みます。
なぜ今なのか:4つの圧力
スケーリングがコストの壁に突き当たった。総パラメータは1〜3Tの領域に達し(DeepSeek-V4-Proが1.6T、Kimi K3が2.8T)、密なモデルでの学習と推論は経済的に成り立たなくなりました。
推論コストが学習コストを追い越した。2025年3月1日の推論システム概要で、DeepSeekはノードをまたぐ大規模なエキスパート並列でバッチを大きくし、GEMMの効率を高めていることを明かしました。推論の経済性が、アーキテクチャ設計における単一で最重要の制約になったことを示しています。
エージェントがワークロードを「入力中心」にした。V4.1の技術レポートは冒頭で、長時間稼働するエージェントの普及に伴いワークロードはますます入力に支配され、巨大なKVキャッシュがHBMとSSDの容量・転送帯域を圧迫し続けていると述べています。
輸出規制下の工学的創意。DeepSeek-V3は2,048基のH800で、合計およそ278.8万GPU時間で学習されました。H800はH100と同じチップですが、NVLink帯域が900 GB/sから400 GB/sに削られており、これがDeepEPのような通信最適化を直接生み出しました。
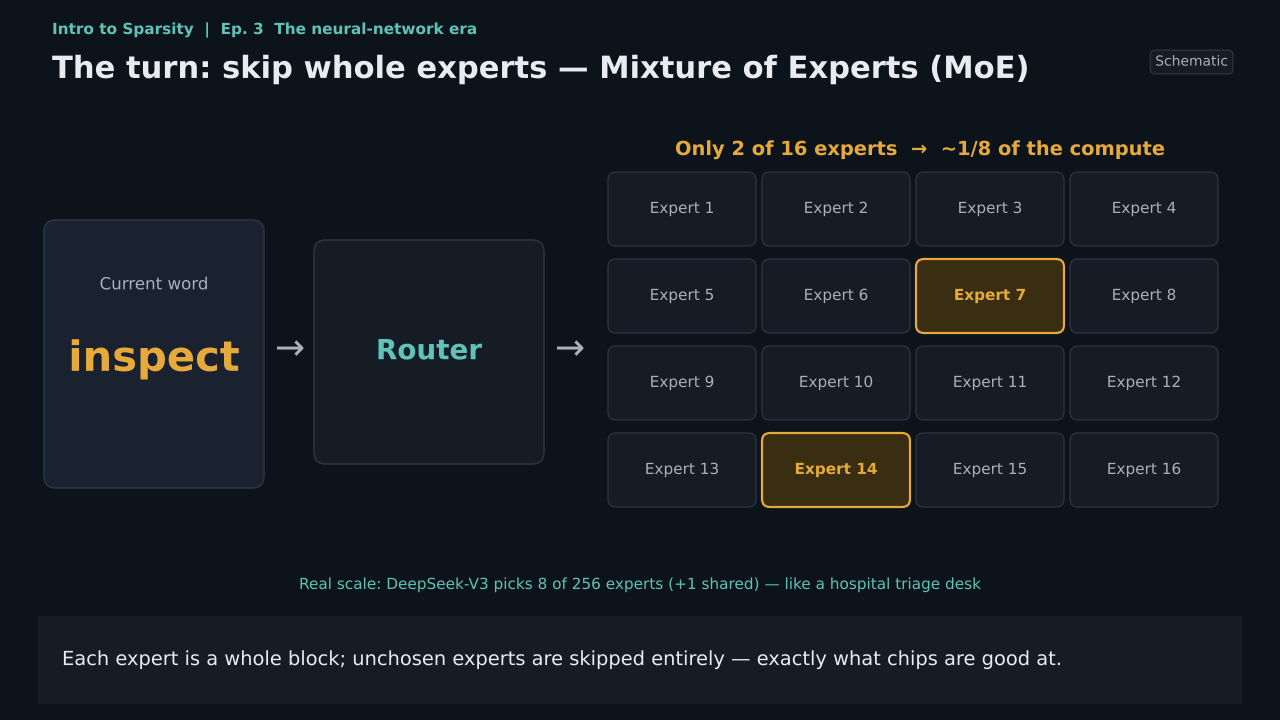
条件付き計算:MoEが既定のアーキテクチャになる
DeepSeekファミリーの進化(すべて公式の技術レポート・モデルカード・API発表より):
| モデル | 時期 | 総パラメータ / トークンあたり活性化 | エキスパート構成 | 主なスパース化技術 |
|---|---|---|---|---|
| DeepSeekMoE | 2024-01 | — | 細粒度エキスパート+共有エキスパート | エキスパートを細かく分割し、組み合わせ数を指数的に増やす |
| V2 | 2024-05 | 236B / 21B | 共有2+ルーティング160 | MLA:KVの低ランク同時圧縮(低ランクであってスパースではない) |
| V3 | 2024-12 | 671B / 37B | 共有1+ルーティング256、8選択 | 補助損失なしの負荷分散、マルチトークン予測、FP8学習 |
| V3.2 | 2025-09/12 | 671B / 37B | 同上 | DSA:Lightning Indexer+トークン単位top-k(k=2048)のスパースアテンション |
| V4-Flash / V4-Pro | 2026-04-24 | 284B/13B、1.6T/49B | 共有1+ルーティング256、6選択/ルーティング384 | Compressed Sparse Attention (CSA)とHCAの交互配置、1Mコンテキスト、FP4エキスパート |
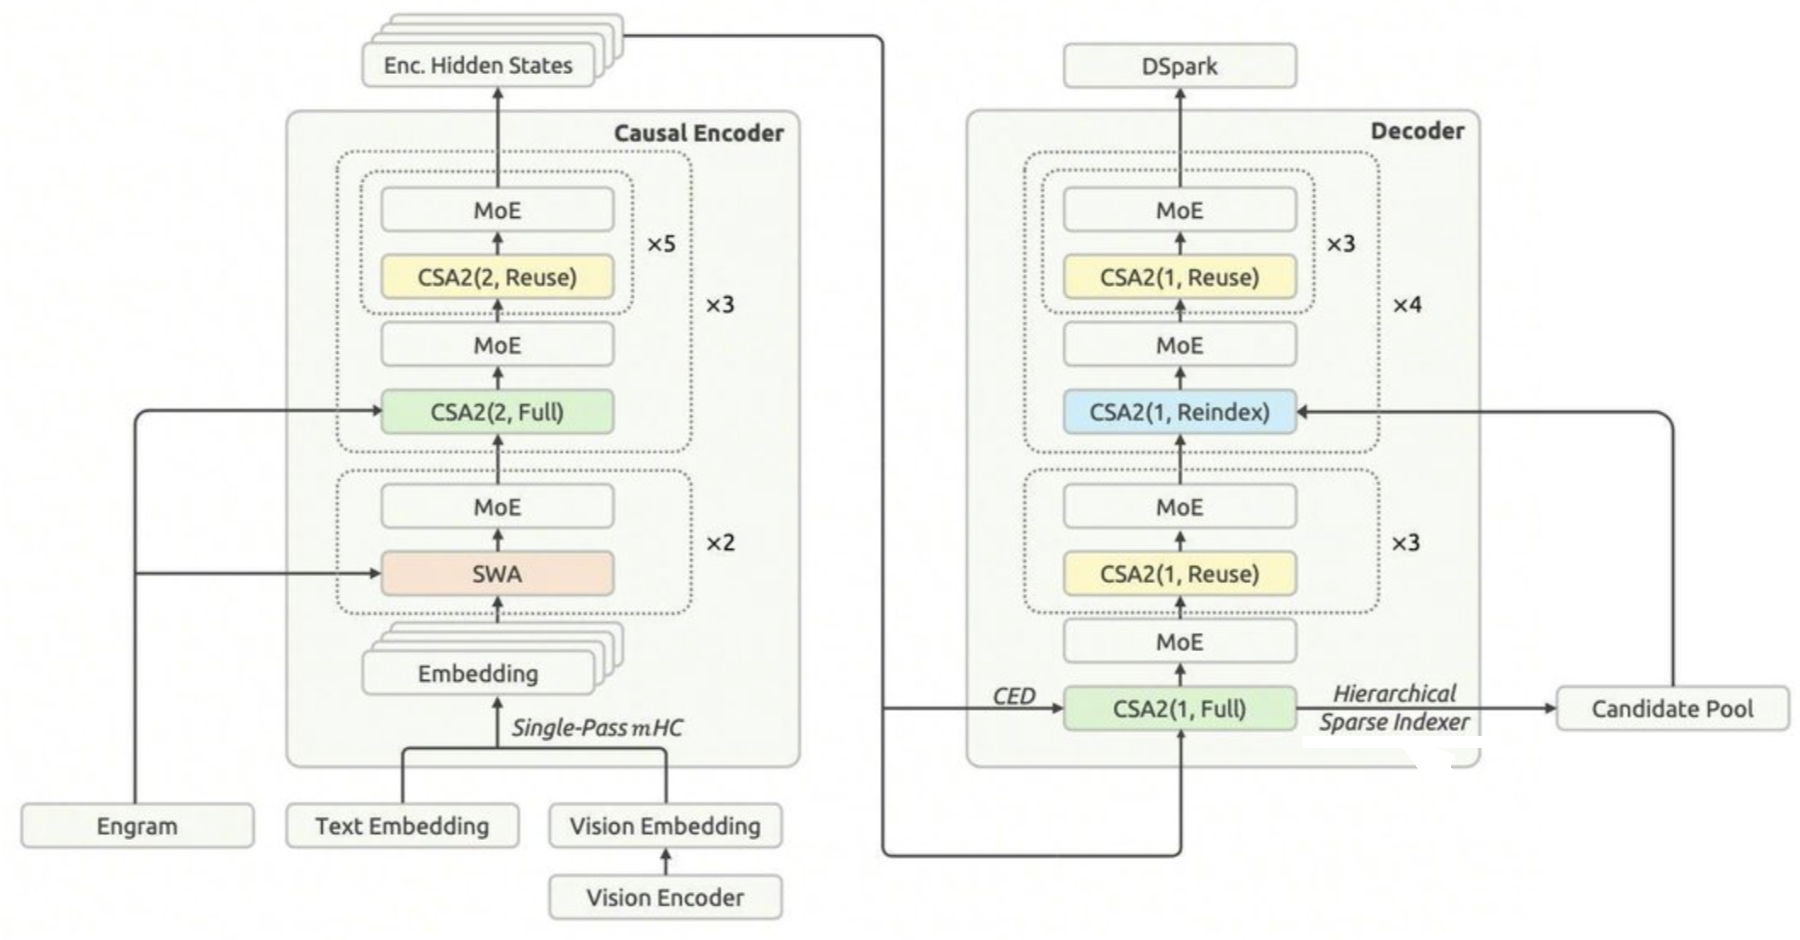
| V4.1-Flash | 2026-09-10 | バックボーン552B+Engram 196B、プリフィル8B / デコード16B | 共有1+ルーティング384、6選択 | CED、CSA2、Hierarchical Sparse Indexer、FP4 KV、Engram |
V4.1-Flashの5つの設計要素(技術レポート):
CED (Causal Encoder–Decoder)。40層を20層のエンコーダと20層のデコーダに分割し、デコーダのグローバルKVはエンコーダの最終隠れ状態から射影します。入力トークンはエンコーダのみを通り(活性化8B)、出力トークンはデコーダを通ります(16B)。「エージェントはたくさん読み、少しだけ書く」という事実への直接の回答です。
CSA2の3つのモード。Fullは自前のグローバルKVを生成してインデックスを構築します。Reindexは前の層のKVを再利用しつつtop-kを再計算します。Reuseはtop-kのインデックスまでそのまま再利用します。大多数の層はReuseです。つまり大多数の層は「トークンを選び直さない」のです。
Hierarchical Sparse Indexer。デコーダの最初のFull層が候補プールを作り、以降の層はその中からだけ選びます。深い層でのインデックス計算コストがコンテキスト長から切り離されます。
KVの数字。グローバルKVは1トークンあたり890バイトで、V4-Flashの約1/4、V1の1/437。永続化されるKVはV4-Flashの約1/8。コンテキストを4Kから1Mへ(256倍)広げても、トークンあたりのデコードFLOPsは約1/4しか増えません。スパースアテンションは最初から64Kで学習され、密なアテンションでのウォームアップはありません。
Engram条件付きメモリ。約196Bパラメータの Nグラムハッシュテーブルで、トークンごとのルックアップを通じてスパースにアクセスされ、ホストメモリに置いてプリフェッチできます。すべてのトークンで活性化されるわけではありません。
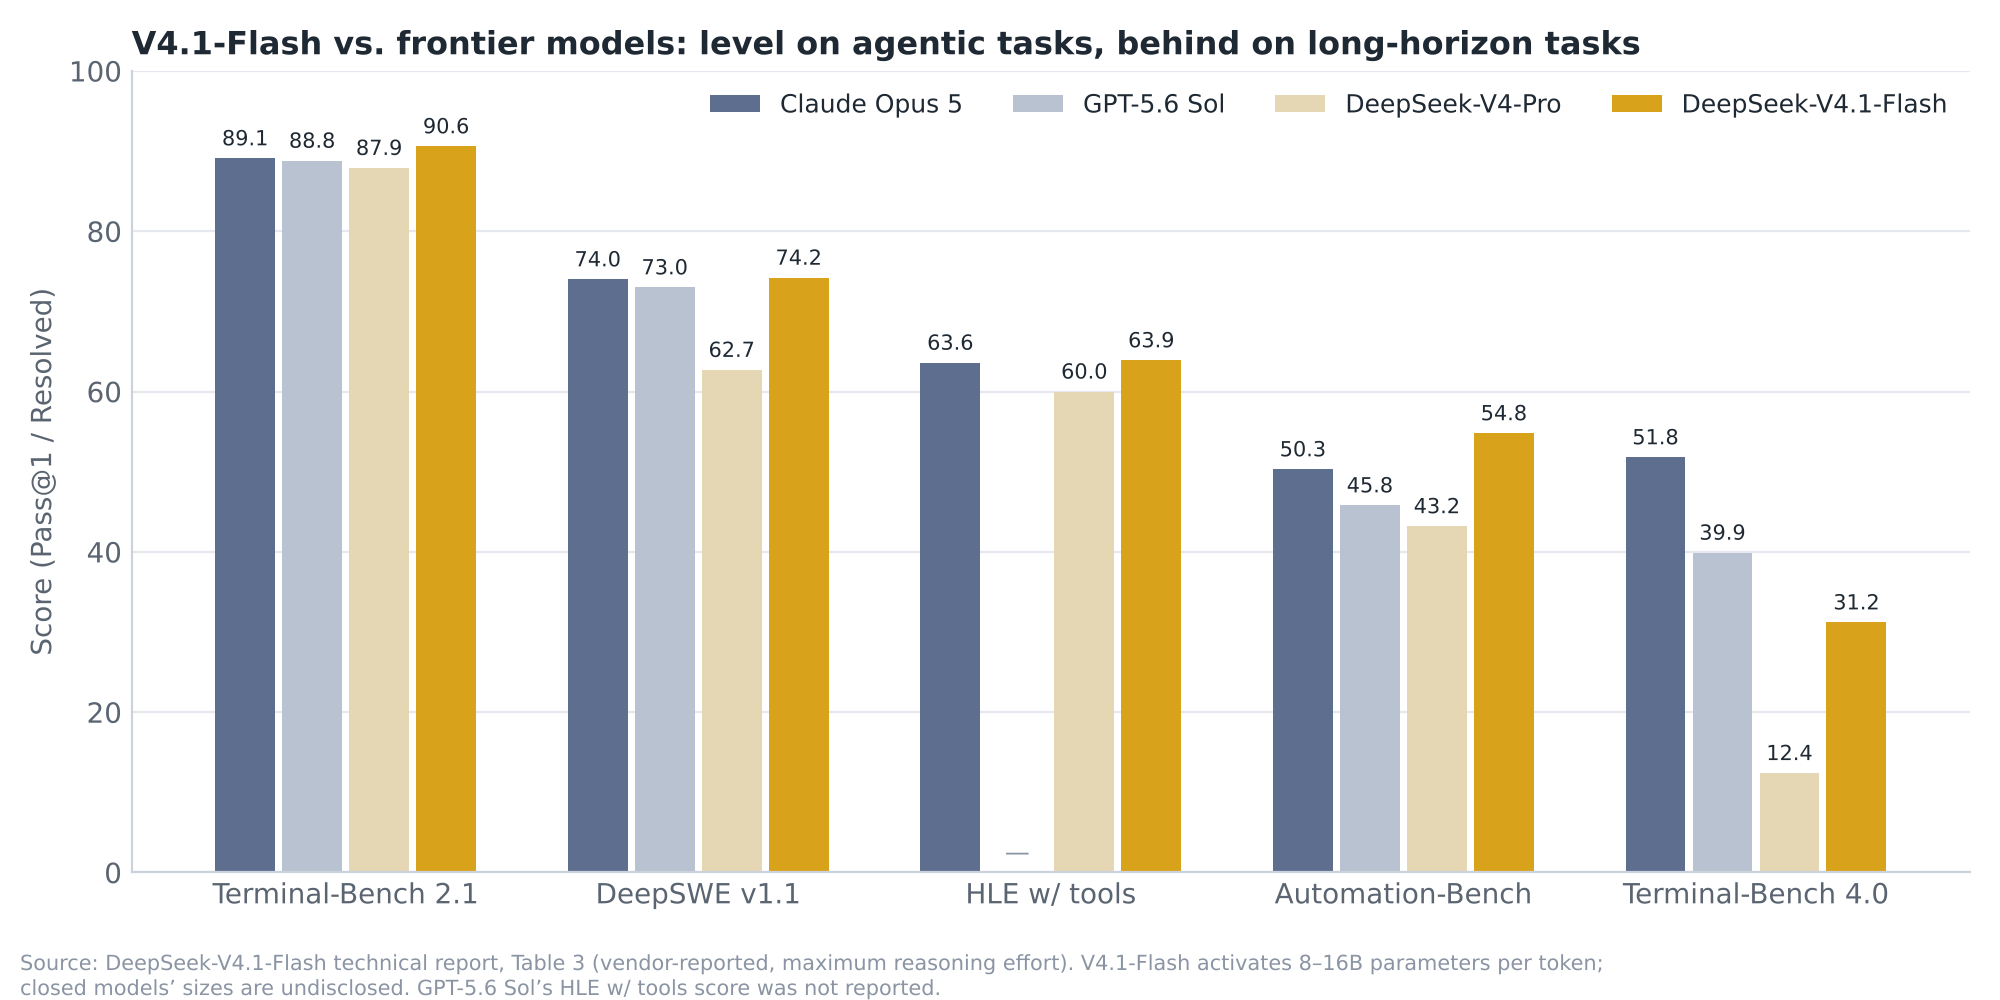
性能と価格について。DeepSeekは、V4.1-Flash-BaseがV4-Pro-Baseの水準に総パラメータ1/3・活性化パラメータ1/4で到達したとしています。ピーク時価格は入力$0.30/M、キャッシュ済み入力$0.006/M、出力$1.20/Mで、オフピークは半額です。ただし第三者の総合指標では(Artificial Analysisで40ポイント、Claude Opus 5は51ポイント)、独立評価ではまだ10ポイントほど差があります。ベンダーが選んだベンチマークと、独立した総合評価は分けて書かなければなりません。これ自体が「平均は人を欺く」ことの生きた教訓です。
2025〜2026年の他の主要MoEモデル(公式モデルカードより):
| モデル | 時期 | 総計 / 活性化 | エキスパート(選択 / 総数) | 活性化率 | その他の設計上の特徴 |
|---|---|---|---|---|---|
| Mixtral 8x7B | 2023-12 | 46.7B / 12.9B | 2/8 | 約28% | 最初の高品質オープンMoE |
| gpt-oss-120b | 2025-08 | 116.8B / 5.1B | 4/128 | 4.4% | MXFP4のMoE重み、スライディングウィンドウと全アテンションの交互配置、attention sink |
| Qwen3-235B-A22B | 2025-04 | 235B / 22B | 8/128 | 9.4% | — |
| Qwen3.5-397B-A17B | 2026-02 | 397B / 17B | 10+1 / 512 | 4.3% | Gated DeltaNet線形アテンションを3:1で混合、KVを約1/4に削減 |
| Kimi K2 / K2.5 | 2025-07 / 2026-01 | 1.04T / 32B | 8+1 / 384 | 3.1% | MuonClip、15.5Tトークンでロススパイクなし |
| Kimi K3 | 2026-07 | 2.8T / 104B | 16 / 896、共有2 | 3.7% | KDA線形アテンション+Gated MLA、MXFP4 QAT |
| Llama 4 Maverick | 2025-04 | 約400B / 17B | 1+共有1 / 128 | 4.3% | 密な層とMoE層の交互配置 |
| DeepSeek-V4.1-Flash | 2026-09 | 552B / 8–16B | 6+1 / 384 | 1.4%–2.9% | 前述のとおり |
トレンドはこうです。2年間でこの分野は「8つのエキスパートから2つ、活性化25%」から「数百〜1,000近くから6〜16個を選び、活性化1.5%〜4.5%」へ移り、スパースの度合いはおよそ1〜1.5年ごとに1桁上がっています。共有エキスパートは標準装備になり、ルーティングには補助損失なしのバイアス、ハッシュルーティング(V4の最初の3層)、潜在空間ルーティング(K3)が使われています。クローズドモデルでは、GoogleがGemini 1.5とGemini 2.5系列がスパースMoEであることを公式に認めています。GPT-4の「1.8TのMoE」は2023年の噂にすぎず、GPT-5.xとClaudeの構成は非公開です。書くとしても「報道によれば」が限度です。
アテンションとKVキャッシュのスパース化
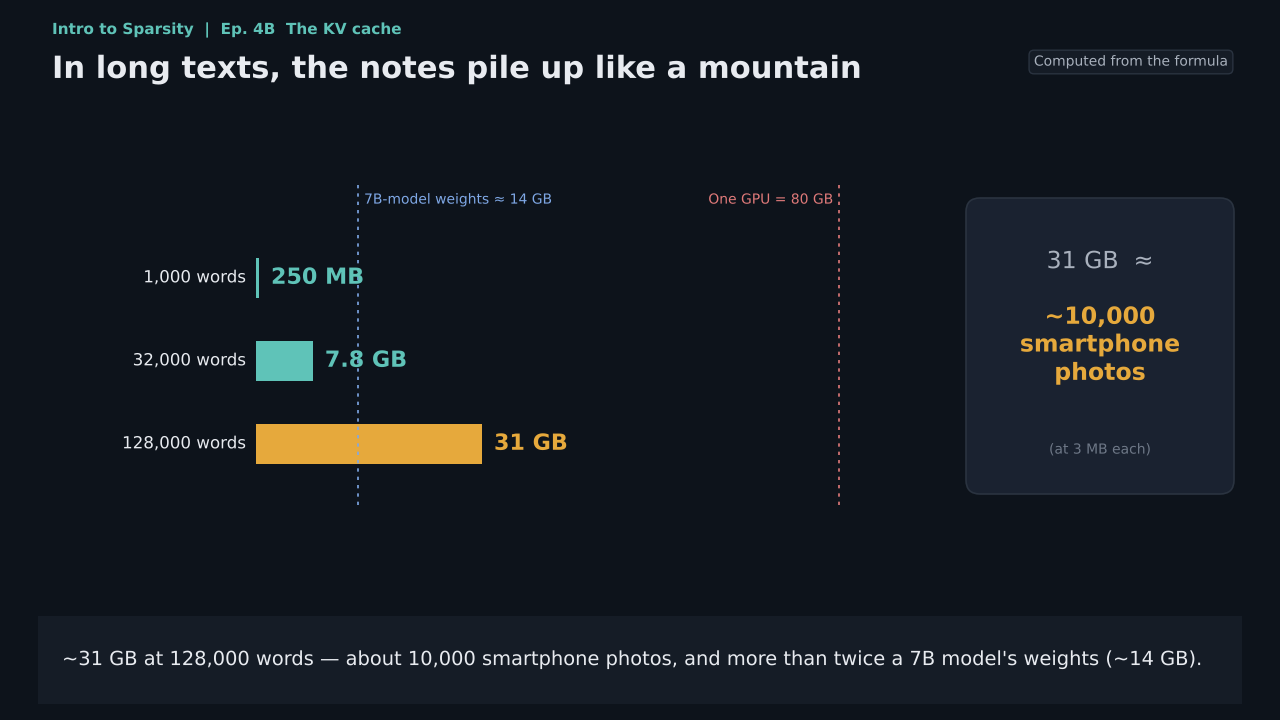
KVキャッシュのサイズ = 2 × L × 層数 × KVヘッド数 × ヘッド次元 × 要素あたりバイト数。64層、8 KVヘッド、ヘッド次元128、FP16、128Kコンテキストを代入すると約31 GiBになります。多くのモデルの重みより大きく、しかもトークンを1つ生成するたびにその全体を読み直さなければなりません。対策は3つあります。KVヘッド数を減らす(GQA/MQA)、低ランク圧縮(MLA)、そしてスパースな追い出しまたはスパースな計算です。
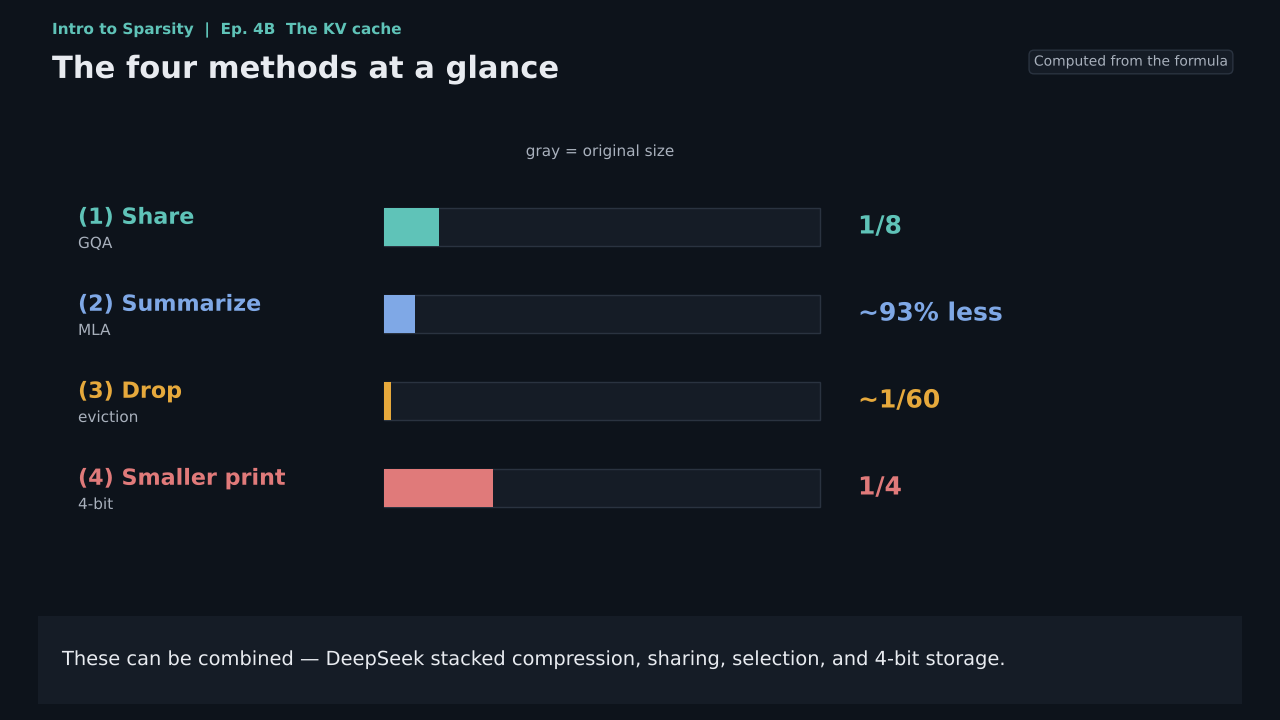
スパースアテンションには3つの世代があり、積み重ねることができます。第1世代は固定パターン(Longformer、BigBird、gpt-ossのスライディングウィンドウ)。第2世代は再学習不要の推論時の動的な追い出し(StreamingLLM、H2O、SnapKV、Quest)。第3世代は学習時からネイティブにスパース性を学習します(NSA、MoBA、DSA、CSA2)。NSA (Yuan et al.、DeepSeek×北京大学×ワシントン大学)はACL 2025のBest Paper Awardを受賞し、長さ64Kで全アテンション比、デコード11.6倍、順伝播9.0倍、逆伝播6.0倍の高速化を達成しました。
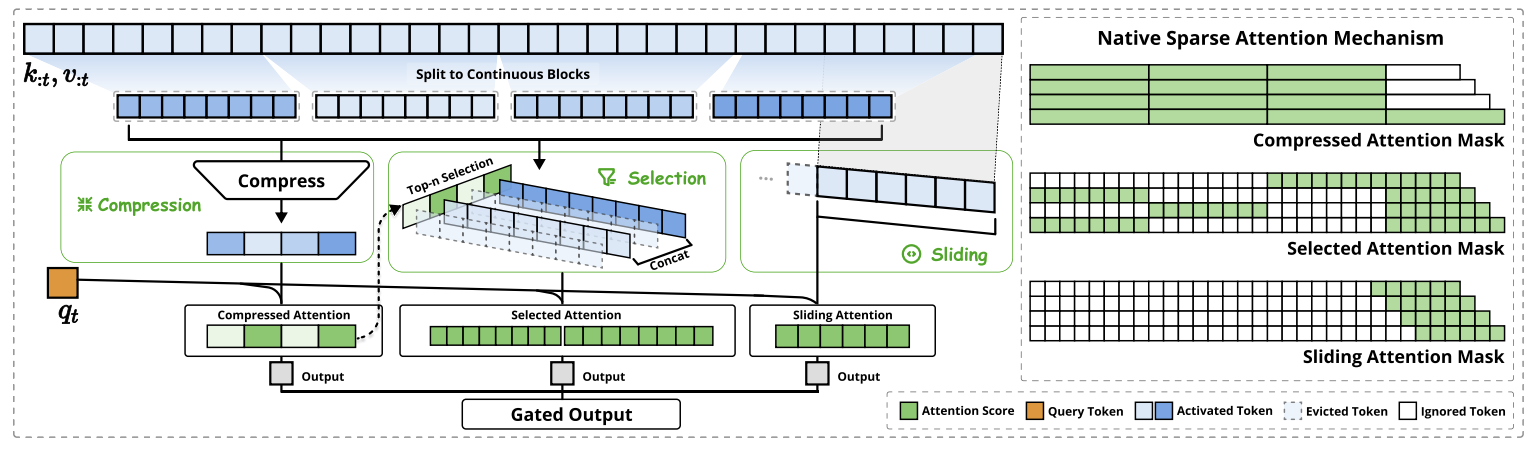
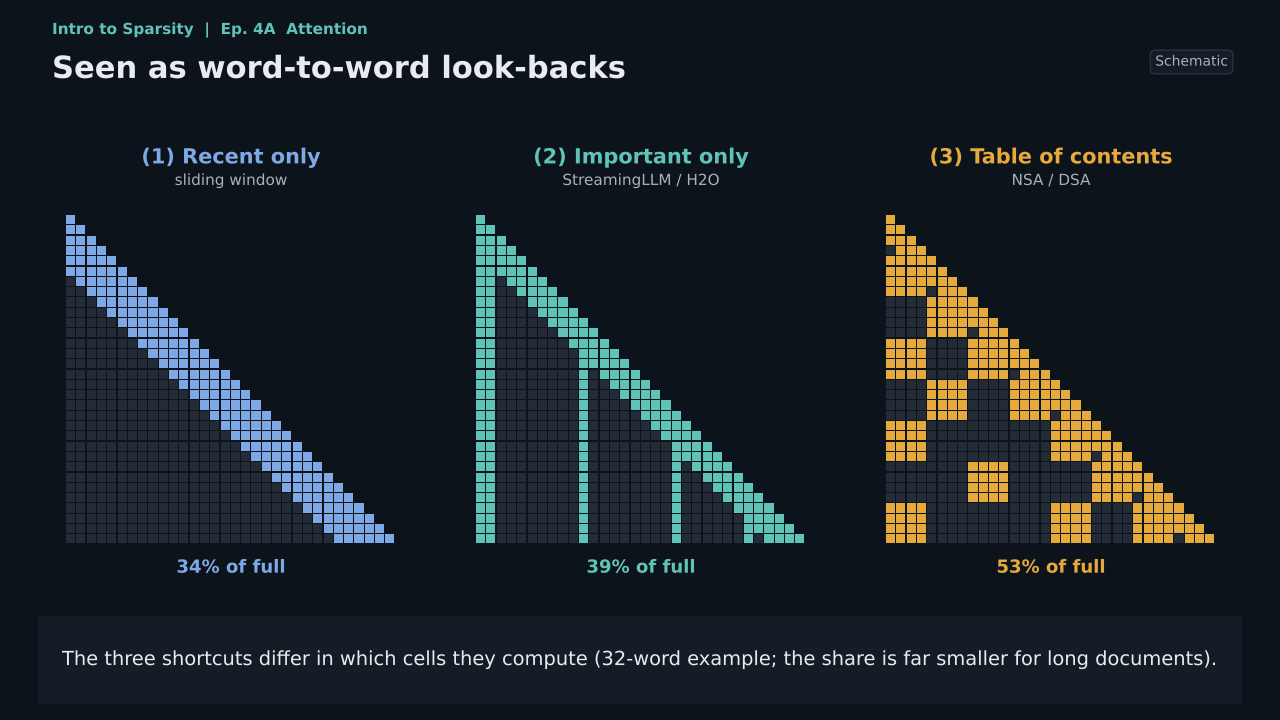
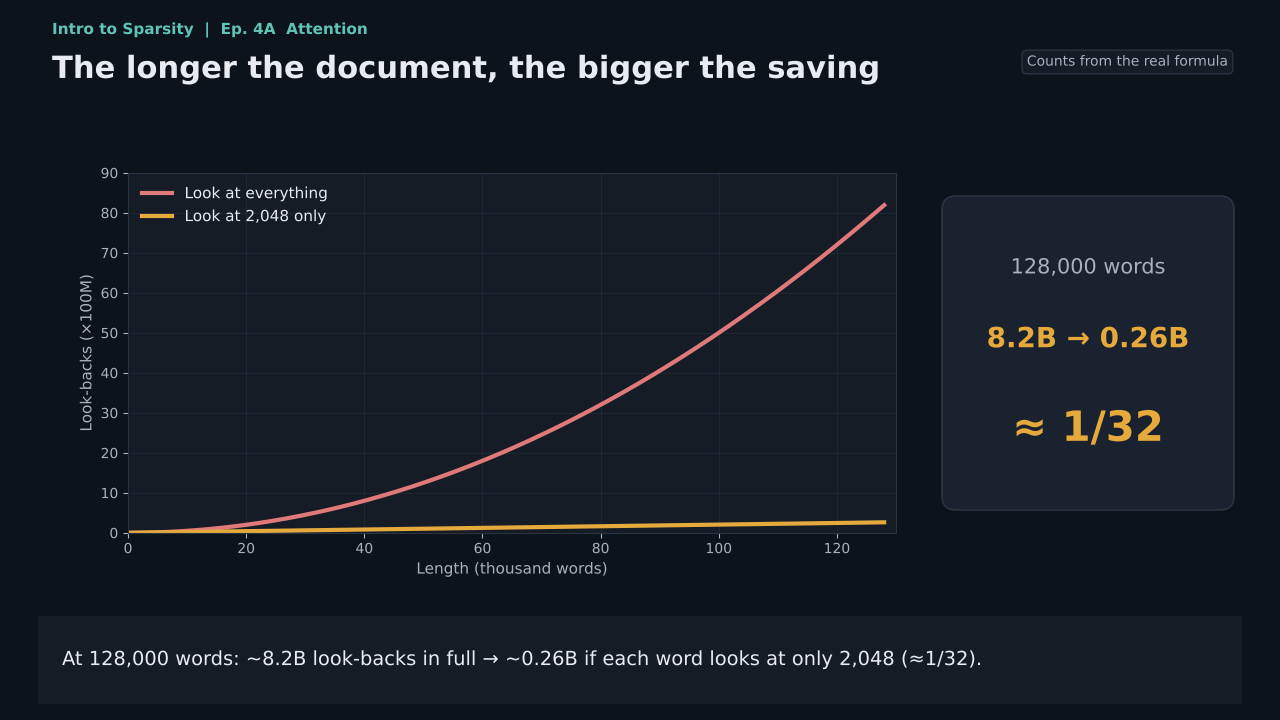
大規模測定からの冷や水。Nawrot et al.のThe Sparse Frontier(arXiv:2504.17768、正式にはFindings of ACL 2026に掲載)は、学習不要のスパースアテンションをQwen2.5の7B〜72B、16K〜128K、9つのタスクで評価し、4つの結論に達しました。非常に長い系列では「大きくてスパース」が「小さくて密」に勝ち、交差点は32〜64K付近にある。プリフィルの最適スパース率は0.80〜0.93(予算にして1/5〜1/15)で、デコードのほうが耐性が高い。ほぼすべての構成が、少なくとも1つのタスクで大きな性能低下を被る。スパースアテンションは万能薬ではない。そして、すべてのタスクとフェーズで最良となる単一の戦略は存在しない。この結果こそが、第3世代の「ネイティブに学習可能なスパース性」を生んだ動機です。
活性化スパース性
Q-Sparse (Wang, Ma, Wang & Wei, arXiv:2407.10969)は、すべての線形層の活性に直接top-kを適用し、STEで逆伝播し、スパース性のスケーリング則を実証しました。最適スパース率はフル精度モデルで約45.58%、1.58ビットモデルで約61.25%で、およそ40%のスパース率で同サイズの密なモデルに匹敵します。Mistral 7Bを40Bトークンで追加学習した場合、Q-Sparseは活性化3.8Bで63.7を記録し、密なベースライン(7.0B)の64.6に迫りました。アブレーションでは、STEを外すか、top-kをReLUに置き換えるかのいずれでも明確な性能低下が起きました。しかもReLUでは学習が進むにつれてスパース率が下がったのに対し、top-kでは一定に保たれました。これは「スパース性は正則化項ではなく、アーキテクチャの制約であるべきだ」という主張を支持します。TEAL、ReLU Strikes Back、Deja Vu、PowerInferがエッジ側の主要な系譜です。
解釈可能性におけるスパース性:SAEの隆盛と疑義
Anthropicの歩みは次のとおりです。Towards Monosemanticity (2023)はスパースオートエンコーダを使い、1層モデルから単義的な特徴を抽出しました。Scaling Monosemanticity (2024)はClaude 3 Sonnetで最大3,400万特徴のSAEを学習し、Golden Gate Claudeで特徴のクランプ(固定)を実証しました。Circuit TracingとOn the Biology of a Large Language Model (2025)は層横断トランスコーダで帰属グラフを構築し、Claude 3.5 Haikuの多段推論を追跡しました。OpenAIではGao et al. (2024)がGPT-4で1,600万特徴のTopK SAEを学習しています。この系譜はOlshausen–Field辞書学習の直系の子孫です。
疑義は2024〜2025年にまとめて到来しました。特徴の吸収(Chanin et al. 2024)。1次元・線形ではない特徴(Engels et al. 2024)。113のプロービングデータセットでロジスティック回帰ベースラインに勝てない(Kantamneni et al. 2025)。SAEが違えば見つかる特徴も違う(Leask et al. 2025)。2025年3月、Google DeepMindの機械的解釈可能性チームは、この分野はSAEに過剰投資してきたとして「SAEの基礎研究の優先度を当面下げる」と発表しました。比較的穏当なコンセンサスは、SAEは未知の概念の発見には向いているが、既知の概念の検出器や制御器としては向いていない、というものです。2026年もSharedSAEやWriteSAEといった新しい研究は出続けていますが、新たな統一的コンセンサスは生まれていません。
統一理論:3つの演算子とtop-kの学習
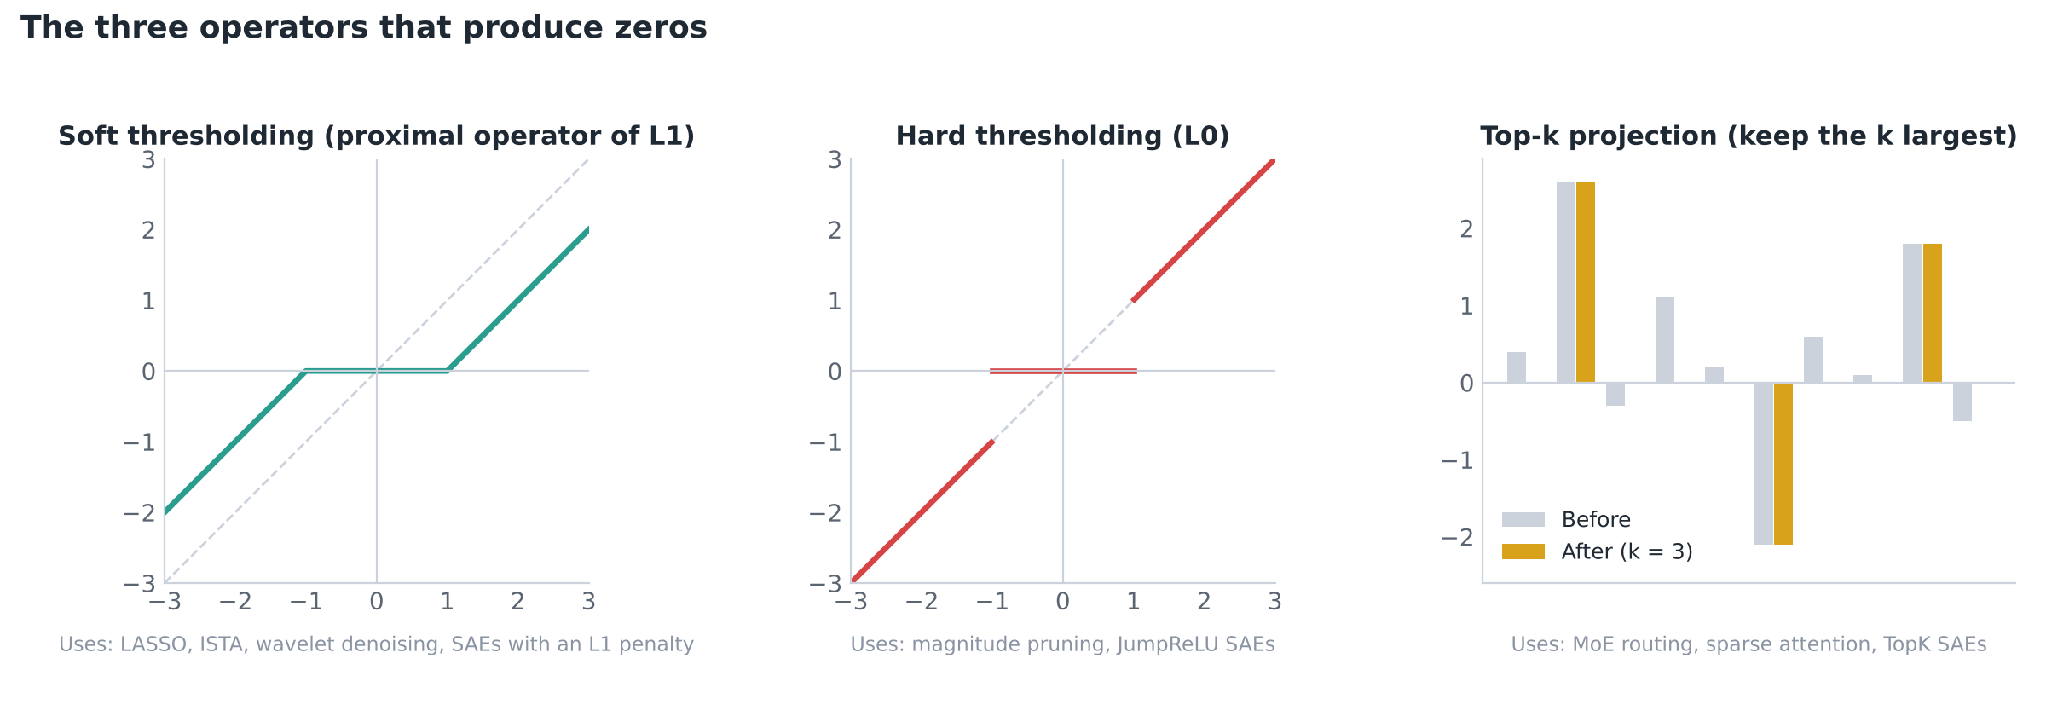
LASSOでもプルーニングでもSAEでもMoEルーティングでも、「ゼロを作り出す」ステップは3つの演算子のいずれかです。
Sλ(y) = sign(y) · max(|y| − λ, 0)、 Hτ(y) = y · 1[|y| > τ]、 Pk(y) = 絶対値の大きい上位k成分だけを残す射影
ソフトしきい値処理はL1の近接作用素です(LASSO、ISTA、ウェーブレットノイズ除去、L1ペナルティのSAE)。ハードしきい値処理はL0に対応します(マグニチュードプルーニング、JumpReLU SAE)。そしてtop-kはkスパースなベクトルの集合への射影です(MoEルーティング、スパースアテンション、TopK SAE、Q-Sparse)。ReLU自体はτ=0の片側ハードしきい値です。現代の大規模モデルのほぼすべてが3つ目を使うのは、トークンあたりの計算量を正確な定数に固定でき、静的なメモリ計画と専用カーネルを可能にするからです。大規模モデルの時代に、スパース性は「正則化項」から「アーキテクチャの制約」へと変わったのです。
top-kは微分可能ではありません。∂TopK/∂sはほぼ至るところでゼロなので、勾配は選ばれたエキスパートのゲート重みにしか届かず、残りは学習できません。工学的な対処は4種類あります。選ばれたエキスパートだけに逆伝播し、補助の負荷分散損失を加える(主流のアプローチ)。Noisy Top-kでノイズを加えて探索を作る(Shazeer 2017)。STE、Gumbel-Softmax、Soft MoEのような連続緩和。そしてDeepSeek-V3以降の補助損失なしバイアス、すなわちs+bで順位付けしつつ重み付けはsで行い、bは負荷に応じて勾配の外で調整する方法です。スパースアテンション側では、NSAは勾配が流れるようにブロックレベルで選択し、DSAはまず密なアテンションでウォームアップしてインデクサーを密なアテンション分布に整合させてから、スパース学習に切り替えます。
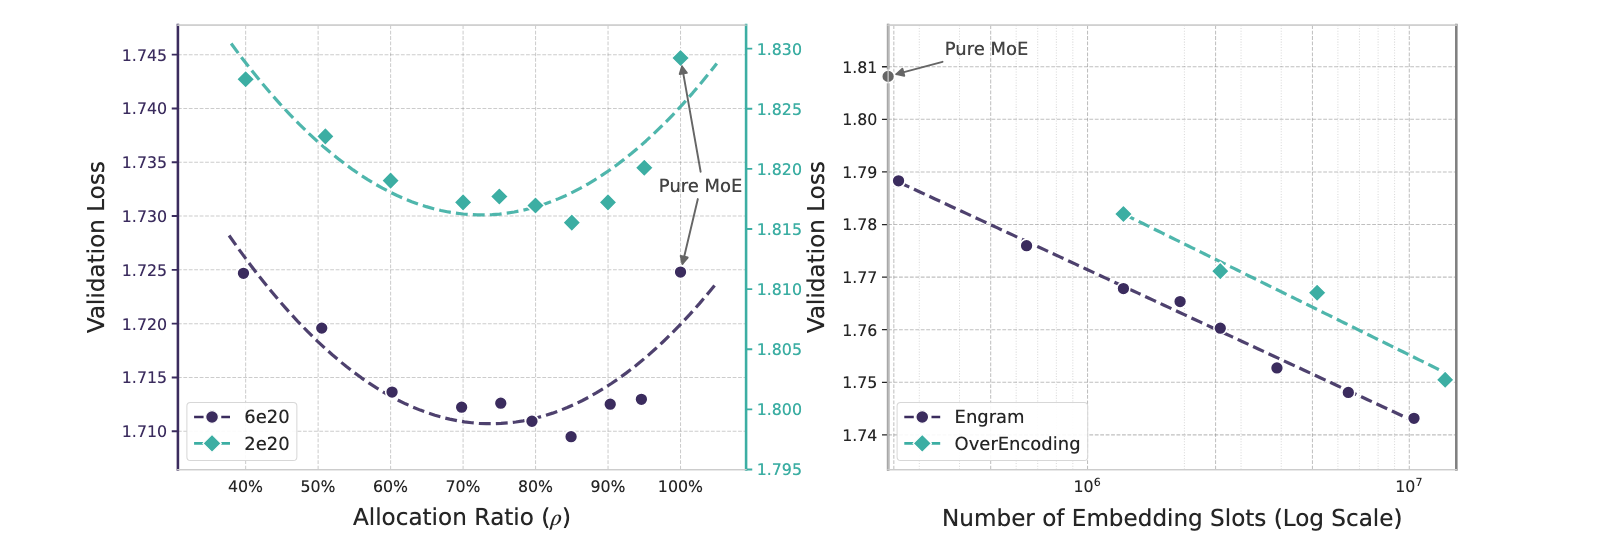
スケーリング則については、Clark et al. (2022)がルーティングされたモデルのスケーリングを統一し、64〜128エキスパートを推奨しました。Krajewski et al. (2024)は、細粒度エキスパートがあらゆる計算予算で密なモデルに勝つことを示しました。Frantar et al. (2023)は、最適な重みスパース率がデータ量とともに上がることを発見しました。DeepSeekのEngram論文(arXiv:2601.07372、2026年1月)は「スパース性予算の配分」という問題を立て、U字型の法則を見つけました。純粋なMoEは最適ではなく、スパースパラメータ予算の約20〜25%を条件付きメモリに配分したときに最良の結果になるのです。その9か月後、この発見はV4.1という製品に組み込まれました。
経済と産業
DeepSeekショック。2025年1月27日、Nvidiaは約17%下落して引け、時価総額およそ5,890億ドル(Bloomberg)〜5,930億ドル(Reuters)が消失しました。米国株式市場の歴史で最大の1日あたり時価総額損失です。
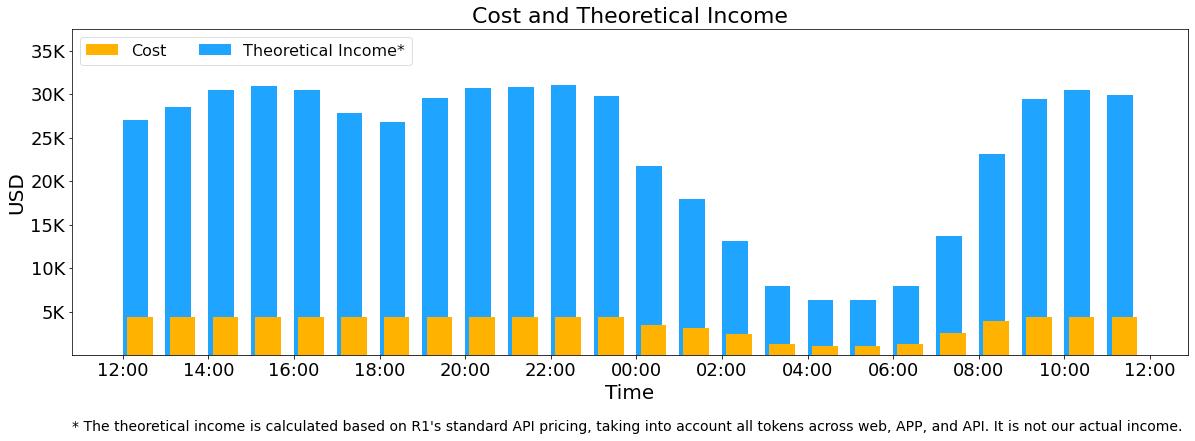
理論上545%の利益率。2025年3月1日、DeepSeekはH800を1時間2ドルと置くと1日のコストは87,072ドルで、すべてをR1価格で課金したと仮定した場合の理論上の1日の収入は562,027ドルだと開示しました。実際の収入ははるかに低いこと、研究開発費や学習コストは含まれないことも明記されています。この数字を引用するときは必ず「理論上の」という言葉を添えてください。
推論価格。Epoch AI (2025年3月)は、同じ能力水準での推論価格が年率9倍から900倍のペースで下がっており、その速度はタスクによって異なると指摘しました。それでも企業の総支払額は増え続けています。エージェントがタスクあたりの呼び出し回数を何倍にも増やすからです。
MoE推論の経済学。メモリは総パラメータで決まり、大きなバッチとエキスパート並列があって初めて各エキスパートに十分なトークンが行き渡ります。MoEは本質的に大規模な集中型サービス向きで、小規模なセルフホスティング向きではありません。vLLMとSGLangはMLA、DSA、V4.1をそれぞれ公開当日からサポートしました。
各研究機関のアプローチの体系的比較
各研究機関を同じ基準で並べると、スパース化への道は1つではなく、複数の戦略が並行して競っていることが分かります。
| 研究機関 | 構成の開示 | 主なスパース性の種類 | エキスパート(選択 / 総数) | アテンション戦略 | KV戦略 | 重みフォーマット | 代表モデル | 際立つ特徴 |
|---|---|---|---|---|---|---|---|---|
| DeepSeek | 技術レポート付きで公開 | MoE+スパースアテンション+条件付きメモリ | 6/384+共有1 | ネイティブスパース(DSA→CSA2)、最初からスパースで学習 | MLA低ランク+FP4+層間再利用、890 B/トークン | FP4/FP8エキスパート | V3, V3.2, V4, V4.1-Flash | 3軸のスパース性を積層。エージェント向けのエンコーダ・デコーダ分業 |
| Moonshot (Kimi) | 重みとレポートを公開 | MoE+線形アテンションハイブリッド | 16/896+共有2 | ブロックスパースMoBA。K3はKDA線形アテンション+Gated MLA | 線形層にはKVなし | MXFP4 QAT | K2, K2.5, K3 | 最大のエキスパート数。MuonClipによる安定学習 |
| Alibaba (Qwen) | モデルカードを公開 | MoE+線形アテンションハイブリッド | 10/512+共有1 | Gated DeltaNetとGated Attentionを3:1で | KVを約1/4に削減 | BF16/FP8 | Qwen3, Qwen3.5 | エッジからフラッグシップまでのフルシリーズ |
| Meta | モデルカードを公開 | MoE | 1/128+共有1 (Maverick) | 密な層とMoE層の交互配置。iRoPE | 標準的なGQA | BF16 | Llama 4 | 10Mコンテキスト(Scout)。Behemothは未リリース |
| OpenAI | gpt-ossのみ公開 | MoE | 4/128 | スライディングウィンドウ(128)と全アテンションの交互配置。attention sink | GQA、8ヘッド | MXFP4 | gpt-oss-120b/20b | GPT-5.xは非公開。SAE研究(Gao 2024) |
| Gemini 1.5と2.5がMoEであることは公式に確認。詳細は非公開 | MoE。エッジ向けには弾力的な構造 | 非公開 | 非公開 | 非公開 | 非公開 | Gemini 1.5/2.5, Gemma 3n | MatFormerの入れ子サブモデル、PLE | |
| Anthropic | 非公開 | 解釈可能性のためのスパース性(SAE、トランスコーダ) | 非公開 | 非公開 | 非公開 | 非公開 | Claudeシリーズ | スパース性を「モデルを理解する」道具として使う |
| Mistral | 重みを公開 | MoE | 2/8 | 標準 | GQA | BF16 | Mixtral 8x7B/8x22B | 最初の高品質オープンMoE(2023年12月) |
| Microsoft Research | 論文を公開 | 活性化スパース性+1.58ビット | — | 標準 | 標準 | 1.58ビット(BitNet) | Q-Sparse, BitNet b1.58 | スパース性と極端な低ビット量子化の組み合わせ |
| Meituan / Ant / Zhipu | モデルカードを公開 | MoEの変種 | さまざま | さまざま | さまざま | さまざま | LongCat-Flash, Ling, GLM-4.5/4.6 | 計算ゼロのエキスパート、ショートカット接続MoE |
ここから3つの観察が導けます。第一に、スパースアーキテクチャのイノベーションの主な源泉は中国のオープンモデル陣営です。細粒度エキスパート、共有エキスパート、補助損失なしの負荷分散、ネイティブスパースアテンション、条件付きメモリ、線形アテンションハイブリッドは、ほぼすべてDeepSeek、Qwen、Kimiが最初に発表しました。第二に、大手クローズド研究機関の構成はブラックボックスであり、gpt-ossやGeminiのレポートといった公開情報から推測するしかありません。「GPT-4は1.8TのMoE」を事実として引用するのはよくある誤りです。第三に、アテンションは2つの道に分岐しています。DeepSeekは「スパースアテンション」(トークンペアの一部だけを計算する)を選び、QwenとKimiは「線形アテンションハイブリッド」(KVキャッシュを再帰的な状態で置き換える)を選びました。どちらもKVキャッシュのメモリと帯域という同じ問題を攻めていますが、数学の道具が違います。前者はスパースで、後者は低ランクの再帰に近いのです。
システムスタック:スパース性を実際に動かす工学
スパースアーキテクチャの利得が実際に実現されるかどうかは、見落とされがちな層、すなわちシステムソフトウェアで決まります。
エキスパート並列と通信。DeepEP (DeepSeekが2025年に公開)は、FP8とNVSHMEM上のRDMAをサポートする高スループット・低レイテンシのall-to-allカーネルを提供し、通信と計算をオーバーラップさせます。MegaBlocks (2023)はMoE計算をブロックスパースGEMMとして書き直してドロップレスMoEを実現し、密なMegatron-LM比で2.4倍の速度を達成しました。
アテンションカーネル。FlashMLAはMLAに最適化されています。DSAとCSA2はインデクサーとスパースアテンションのカーネルが揃っている必要があり、DeepSeekはFlashMLAとDeepGEMMで公開しました。V4.1のCSA2の3モードは、推論エンジンがKVとインデックスの層間再利用を管理しなければならないことを意味します。
推論フレームワーク。vLLMとSGLangはMLA、DSA、V4.1-Flashを公開当日からサポートし、H100/H200/B200/GB200とAMD MI355Xをカバーしています。NVIDIA NeMo AutoModelはV4.1のファインチューニングレシピを提供しており、単一NVLinkドメイン内の64 GPUを必要とします。
階層型ストレージ。V4.1のEngramテーブル(約183 GiB)はホストメモリに置かれ、RDMA越しにプリフェッチされる設計です。EngramをCXLメモリプールに保持し、「知識」をHBMからより安価な階層に移す論文もすでに出ています。SWA Bounded ReplayはスライディングウィンドウKVのSSDへの永続化を回避します。
量子化フォーマット。MXFP4(32要素ごとに8ビットの共有スケール1つ、平均4.25ビット)は2025〜2026年にMoEエキスパート重みのデファクトスタンダードになりました。BlackwellはFP4テンサーコアをネイティブにサポートします。
この節の結論は「ニューラルネットワーク時代」と響き合います。スパース性の勝利には、必ずそれに見合うカーネルとスケジューリングが伴っていました。2:4スパース性が普及しなかったのは、テンサーコアがあっても、成熟したエンドツーエンドのソフトウェアスタックを欠いていたからです。MoEが主流になったのは、DeepEP、MegaBlocks、vLLMがあったからです。
スパース性と深層学習が出会う場所:画像・信号処理の最近の進展
大規模モデルが計算の節約のためにスパース性を使った一方、画像・信号処理は別の道を歩みました。スパース事前分布を深層ネットワークと組み合わせ、不完全でノイズの多い測定から信号を復元する道です。その成果は逆方向にも流れ、大規模モデルの解釈の仕方やアーキテクチャ設計の形を変えています。
アルゴリズム展開:反復スパースソルバーをネットワークに変える
出発点はGregorとLeCun (2010)のLISTAです。ISTAの固定された反復を、有限の層数を持つネットワークに「展開(unroll)」し、そのパラメータを学習可能にします。各層は依然として「線形変換+ソフトしきい値処理」ですが、行列としきい値はデータから学習されます。結果は、手でチューニングしたISTAより1〜2桁速く収束し、しかも解釈可能な構造を保ちます。各層が近接勾配法の1ステップに対応しているからです。アルゴリズム展開はその後、計算イメージングの主流の枠組みになりました。ADMM-NetやISTA-Netは圧縮センシングMRIの再構成に使われ、展開されたネットワークは臨床のアンダーサンプリングデータで古典的なCS手法を上回っています。展開のより深い意義は、深層ネットワークがスパースソルバーの学習可能版として読めることを示した点にあります。この洞察が、のちにスパース辞書でニューラルネットワークを解読する際の直観を供給しました。
プラグアンドプレイ事前分布と、ノイズ除去による正則化
古典的な正則化(L1、全変動)は、事前分布を明示的なペナルティ項として書き下します。2013年以降に現れたプラグアンドプレイ(PnP)の枠組みは、ADMMや近接勾配法の「近接作用素を適用する」ステップが、任意のノイズ除去器、つまり学習済みの深層ノイズ除去ネットワークで置き換えられることを発見しました。事前分布は「1つの数式」から「ブラックボックスのノイズ除去器」になり、スパース事前分布はその特別な場合の1つになったのです。Regularization by Denoising (RED)と、のちの拡散モデル事前分布がこの系譜を受け継いでいます。この見方では、ソフトしきい値処理によるノイズ除去、BM3D、深層ノイズ除去器は、同じ位置にはめ込める3世代の交換部品です。
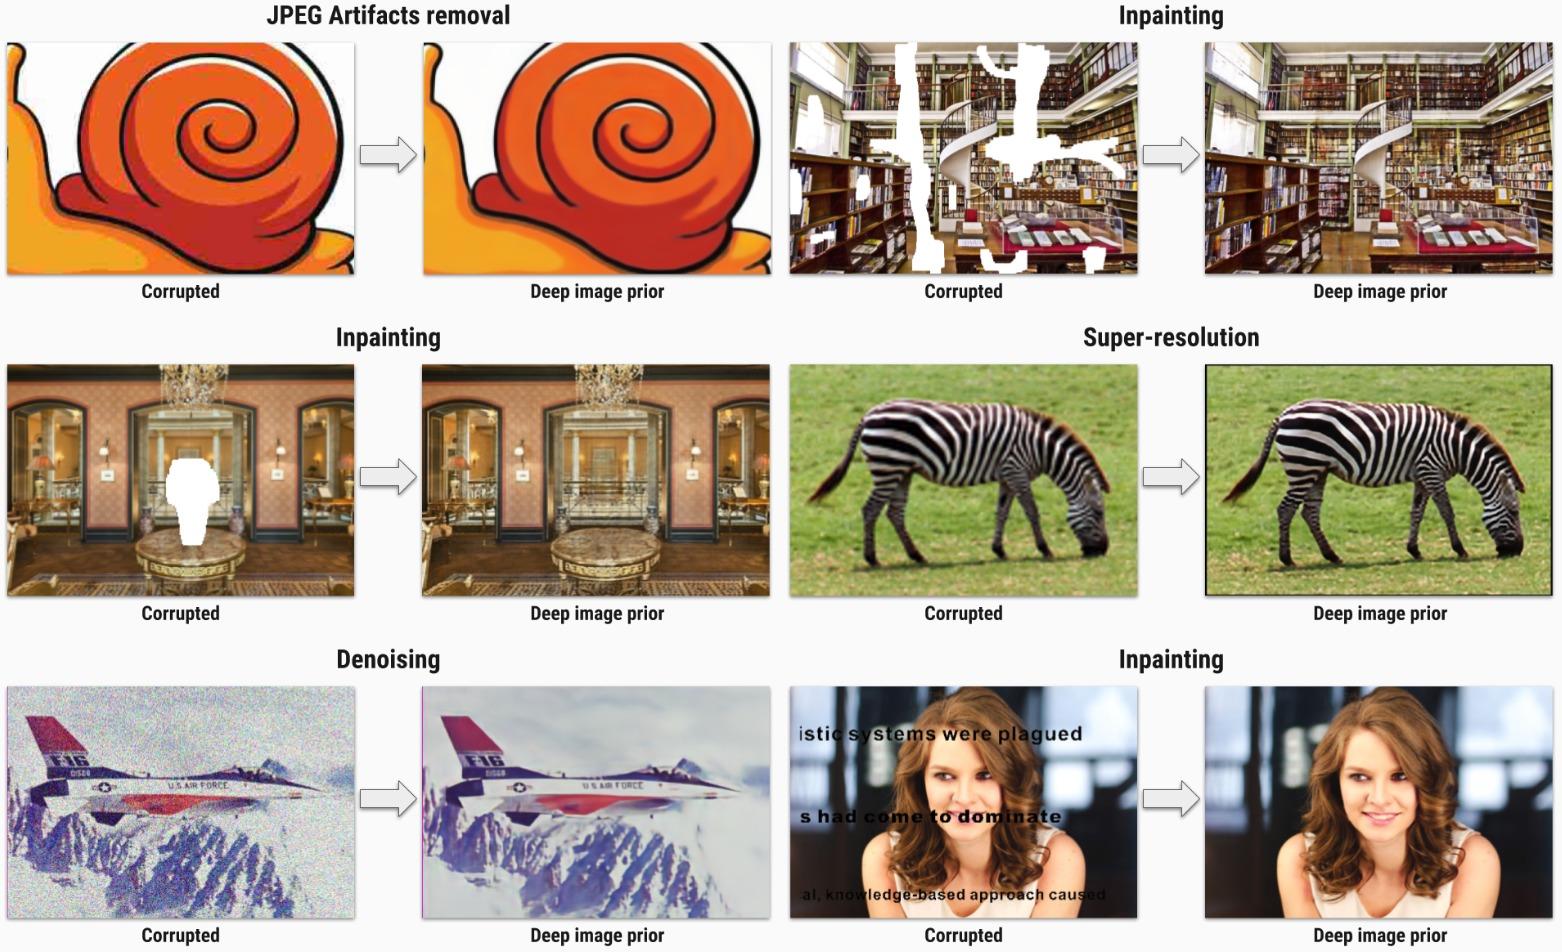
Deep Image Prior:ネットワークの構造そのものが事前分布
Ulyanov、Vedaldi、Lempitsky (2018)のDeep Image Priorは直観に反する結果をもたらしました。ランダム初期化された未学習の畳み込みネットワークを劣化した1枚の画像にフィットさせるだけで、ノイズ除去・超解像・インペインティングができるのです。畳み込みネットワークの構造は自然画像の低周波で自己相似的な統計を好み、ノイズへのフィットは遅いので、早期に停止すればきれいな画像が得られます。これは「前史」で論じた自然画像統計に直結します。ネットワークの構造が「自然画像はある基底のもとでスパースだ」という事前分布を暗黙に符号化しているのであり、違いはその基底がもはや明示的に書き出されないことだけです。DIP以降、「構造こそが事前分布」はニューラルネットワークの帰納バイアスを理解する重要なレンズとなり、古典スパース理論への橋になりました。DIPは、暗黙的で学習可能な「フレーム」によって同じことを適応的に行う手法、すなわち信号の構造を本当に表す成分だけを残す手法と見ることができます。
学習された辞書と構造化フレーム
固定のウェーブレット、K-SVDが学習する非構造的な辞書、深層ネットワークが学習する暗黙的な事前分布の間には、中間の道があります。タイトフレームやユニタリ変換の数学的構造(完全再構成、エネルギー保存)を保ったまま、そのパラメータをデータから学習する道です。非分離型方向性対称重複変換(NSOLT)や格子構造ユニタリネットワーク(LSUN)がこのカテゴリに属します。変換をタイトフレームの多様体に制約し、格子構造でパラメータ化することで、古典的な変換の解釈可能性と可逆性を保ちながら、特定データへの適応性を獲得します。この道の価値は大規模モデルの時代に再発見されつつあります。SAEは過完備な辞書を必要とし、MLAは可逆な低ランク射影を必要とします。どちらも構造的制約とデータへの適応のバランスを探しており、それはまさに構造化フレームがずっと向き合ってきた設計問題なのです。
大規模モデルとの3つの接点
第一に、SAEはスパース符号化そのものです。AnthropicのスパースオートエンコーダはOlshausen–Field辞書学習と数学的に同一で、変わったのはデータだけです。画像パッチから残差ストリームの活性へ。第二に、アルゴリズム展開は「ネットワーク=ソルバー」という読み方を先取りしていました。Anthropicのトランスコーダと帰属グラフは、本質的に、Transformerに対するスパースで読みやすい代替計算グラフの探索です。第三に、構造的事前分布という発想はアーキテクチャ設計に入り込みました。MoEのエキスパートブロック、CSA2の層間再利用、Engramのルックアップテーブルはいずれも、「データはこの構造を持っているはずだ」という信念を、損失関数ではなくネットワークの形そのものに書き込んでいます。これは「統一理論」の節の結論の、画像処理の世界における対応物です。スパース性は正則化項からアーキテクチャの制約へ移行したのです。
応用:スパース性が本当に価値を生んだ場所
スパース性は、処理すべきものが膨大で、本当に重要なものがごく少ない場所で価値を生みます。長文書の審査はその最も典型的な例の1つです。
クラウドでのLLM推論。2026年の低価格フロンティアAPIのほぼすべてが、高度にスパースなMoEモデルから来ています。DeepSeek-V4.1-Flashのオフピーク出力は$0.60/M、gpt-oss-120bはOpenRouterで入力約$0.03/M・出力約$0.17/Mです。
長いコンテキストとエージェント。V4.1の発表でDeepSeekは、エージェントのコストの大半をキャッシュヒット課金が占めることが多く、キャッシュの圧縮でこの部分を大幅に削れると明言しました。キャッシュ済み入力の価格($0.006/M)はキャッシュミス価格($0.30/M)の1/50であり、これがエージェントの経済性の中心的なレバーです。
エッジ。AppleのLLM in a Flash (2023)は、スパースに活性化されるパラメータをフラッシュストレージからオンデマンドで読み込みます。Gemma 3nはMatFormerの入れ子サブモデルと層ごとの埋め込み(PLE)を使います。Qwen3.5-35B-A3Bのような活性化3BのMoEモデルは、ブラウザやエッジの候補になってきました。
マルチモーダル。V4.1は画像トークンに専用のルーティングバイアスを与えています。視覚トークンは数が多く冗長性が高いため、スパースアテンションの理想的なターゲットです。
科学と医療。CS-MRIは日常臨床の平均スキャン時間を約20%、単一シーケンスでは23%〜43%短縮しました。EHTのブラックホール撮像を支えたSMILIパイプラインはスパースモデリングの上に築かれています。
長文書・図面のエンタープライズ審査(私たちの事業に直結)
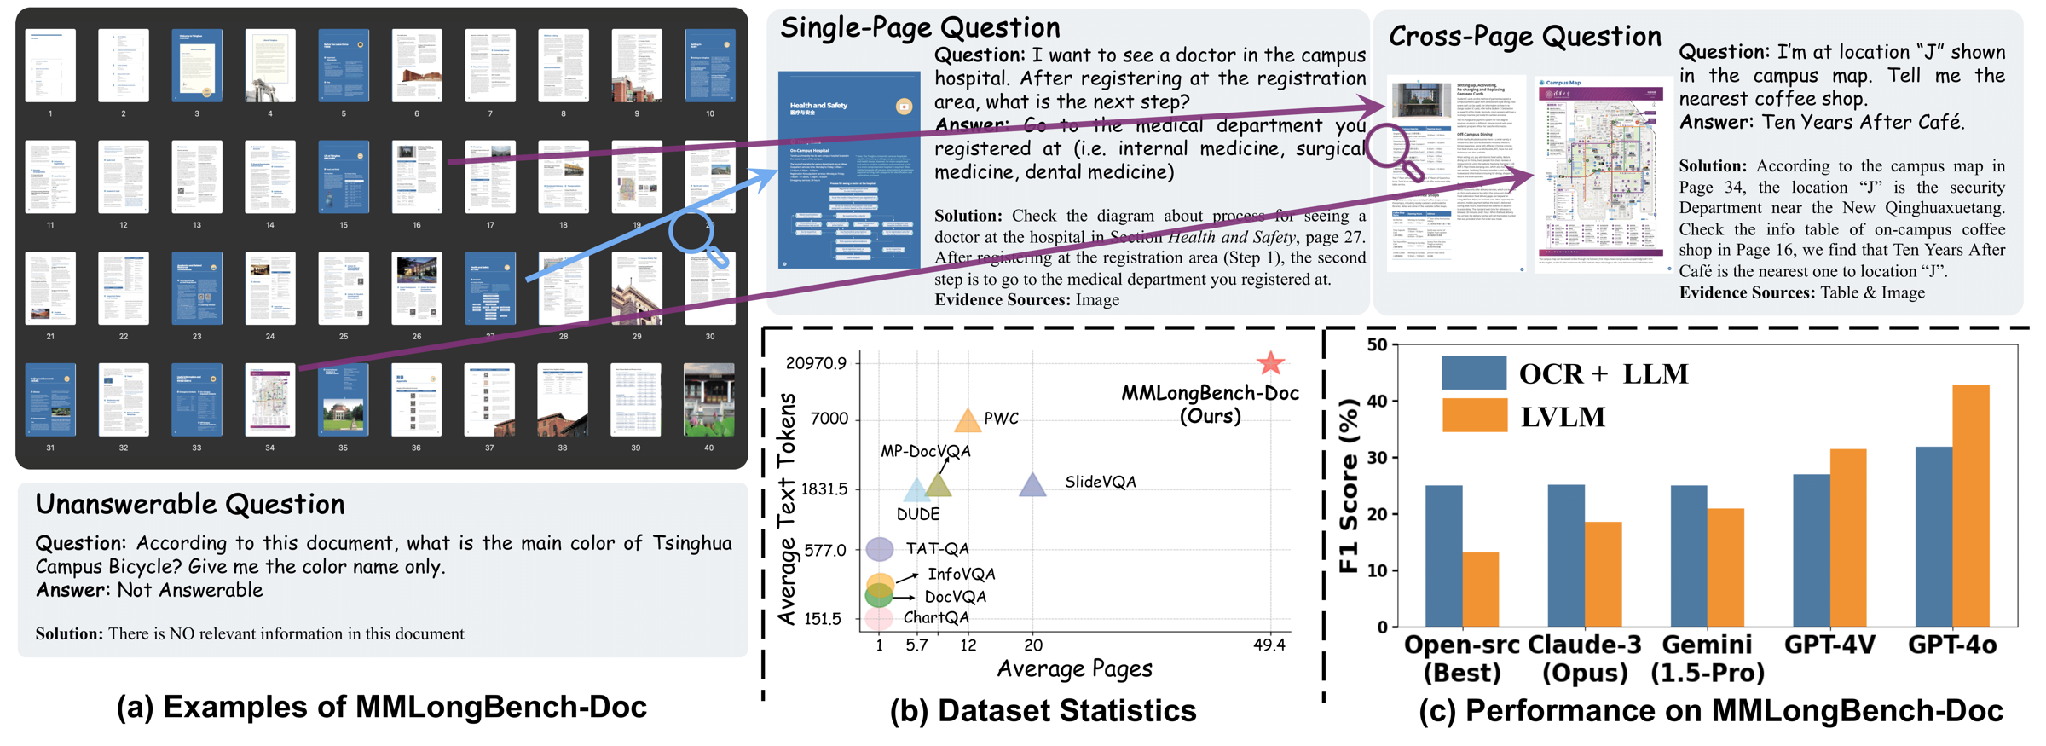
難しさの基準となるベンチマーク。MMLongBench-Doc (NeurIPS 2024 D&B)は平均47.5ページ・テキスト約21,000トークンのPDFを135本集め、専門家が書いた1,082の質問を収録しています。うち33.2%はページ横断の証拠を必要とし、22.8%はハルシネーションを検出するために答えられないよう設計されています。人間のアノテーターのF1は66.0%で、14の視覚言語モデルのうち12は、OCRテキストを対応するテキスト専用モデルに与えた場合より性能が落ちます。LongDocURLの396文書は平均86ページで、質問の52.9%がページ横断です。これらの文書の長さと、ページや要素をまたぐ質問の割合は、建築確認申請(数十ページから100ページを大きく超える図面・構造計算書・申請書類)に酷似しています。
ボトルネックはコンテキスト長だけではありません。散在する証拠の中から正しいtop-Kを選ぶことです。検索(top-Kページの選択)とスパースアテンション(top-Kトークンブロックの選択)は数学的には同じ演算子です。違いは、その選択がモデルの外で起こるか(監査可能で、条文を引用できる)、中で起こるか(エンドツーエンドだが不透明)です。
限界。Sparse Frontierは、スパースアテンションが中程度のスパース率でも個別タスクの性能を落とし得ることを示しています。審査業務における「X条が37ページに記載された寸法と矛盾している」は、まさに「1つ見逃せば答え全体が誤りになる」タスクです。したがって、どちらか一方に賭けるより、検索と長いコンテキストでの再検証のハイブリッドのほうが安全です。SimpleDoc、MDocAgent、LAD-RAGを含む2025年の複数ページ文書の研究も、この道を取っています。
恩恵とコスト
重みのスパース性については、LLM時代には「スパース性は過大評価されている」がおおむね正しい。条件付き計算とアテンションのスパース性については逆で、どちらもすでにフロンティアの既定です。この2つを分けて考えることが、議論全体を理解する鍵です。
恩恵
コスト:活性化率は1.5%〜4.5%まで下がり、価格曲線は急速に下降しています。
容量と計算の分離:総パラメータが知識の容量を決め、活性化パラメータがトークンあたりのコストを決め、両者は独立にスケールできます。Engramはさらに進んで、静的な知識を安価なホストメモリに移します。
長いコンテキストの実用化:V4.1のデコードFLOPsは4Kから1Mの間で約4分の1しか増えません。
解釈可能性の道具:SAEとトランスコーダは未知の概念の発見に使われています。
コストとリスク
メモリは総パラメータで決まる:V4.1のルーティングエキスパート(MXFP4)は約259.5 GiB、Engramテーブルは約183 GiBを占めます。スパース性はストレージを節約しません。
通信オーバーヘッド:エキスパート並列のall-to-allはMoE学習の主要ボトルネックで、EngramはRDMAまたはCXL越しのプリフェッチを必要とします。
学習の不安定さと負荷の偏り:z-loss、バイアス調整、ハッシュルーティングなど、一連のパッチが必要になります。
ファインチューニングが難しい:小さなデータセットではルーティングが崩壊しやすい。V4.1の公式ファインチューニング手順は単一NVLinkドメイン内の64 GPUを要求します。
評価の落とし穴:Sparse Frontierの「ほぼすべての構成が少なくとも1つのタスクで性能を失う」という発見。V4.1はベンダーのベンチマークではフロンティアに並びますが、独立の総合指標では約10ポイント劣ります。
SAEの限界:「解釈可能性におけるスパース性」の節を参照。
重みスパース性は依然として効率で負けている:従来手法は50%〜60%のスパース性の壁を破れずにいます。
代表的な見解(出典から引用)
| 立場 | 出典 | 見解 |
|---|---|---|
| 支持:勝者はハードウェアが決める | Hooker 2021 | アイデアが勝つのは「優れているからではなく、手に入るソフトウェアとハードウェアに適合しているから」 |
| 支持:スパース性の新しい軸 | DeepSeek, Engram 2026 | 「条件付きメモリは次世代スパースモデルに不可欠なモデリングプリミティブになると信じている」 |
| 慎重 | Nawrot et al. 2026 | 「スパースアテンションは銀の弾丸ではない」 |
| 否定的 | Google DeepMind 2025 | 「SAEが解釈可能性のゲームチェンジャーになるとは考えておらず、この分野はSAEに過剰投資してきたと疑っている」 |
| 中間 | arXiv:2506.23845 | SAEは既知の概念への働きかけは不得手だが、未知の概念の発見には強力な道具である |
5種類のスパース性それぞれへの評決(2026年9月)
「スパース性は過大評価か?」に単一の答えはありません。この問いには種類ごとに答える必要があります。
| スパース性の種類 | 2026年の状況 | 評決 | 主な根拠 |
|---|---|---|---|
| 重みスパース性(非構造的プルーニング) | 研究は活発、産業での採用はごくわずか | LLM時代には過大評価。量子化が勝った | 50%〜60%のスパース性の壁。効率的なGPUカーネルの不在。MXFP4がデファクト |
| 構造化スパース性(2:4、ブロック) | ハードウェアサポートはあるが、エンドツーエンドの高速化は限定的 | 部分的に実現。ブロックスパースはMoEという形で勝った | 2:4は実測で2倍に届くことがまれ。MegaBlocksのブロックスパースGEMMはMoEの基盤になった |
| 活性化スパース性(ReLU、top-k活性化) | エッジと研究で注目。クラウドではMoEに吸収 | 潜在力は過小評価。ただし主戦場はエッジ | Q-Sparseは約40%のスパース率で密なモデルに匹敵。TEALとPowerInferはメモリ制約のあるデバイスを狙う |
| 条件付き計算(MoE) | フロンティアの既定アーキテクチャ | 評判どおり。さらに深化中 | 活性化率は2年で25%から1.5%〜4.5%へ。2025〜2026年のフラッグシップ級オープンモデルすべてが採用 |
| アテンションスパース性 | ネイティブに学習可能な版が製品に | 確立。ただしタスク別の性能低下リスクあり | NSAがACL Best Paper受賞。V4.1は最初からスパースで学習。Sparse Frontierの「少なくとも1タスクでの低下」 |
| (並行する系譜)低ランク | MLAとLoRAが広く使われる | 確立。ただしスパース性と混同してはならない | 最大約93%の低ランクKV圧縮(V2)。LoRAはファインチューニングの標準 |
| (道具)スパース辞書 / SAE | 議論が続く | 発見の道具としては確立。検出器・制御器としては過大評価 | GDMが優先度を下げた。113データセットで線形プローブに劣る。Anthropicはトランスコーダと帰属グラフへ移行 |
一文で言えば:スパース性は「活性化」と「アテンション」で勝ち、「重み」で負けました。勝ったのは理論が優れていたからではなく、ゼロの位置にハードウェアが活用できる構造があったからです。
未来(2026〜2030年)
スパース性の次の軸は、もはや「どのパラメータを計算するか」ではなく、「どの知識を保存し、どの履歴を読むか」です。以下に研究のフロンティア、ハードウェアのトレンド、そして反証可能な5つの予測を示します。
研究フロンティア
多軸のスパース性と予算配分。Engram論文が見つけたU字型の法則は、純粋なMoEが最適ではなく、スパース性の予算を「エキスパート」と「条件付きメモリ」に分けるべきことを示しています。27BのEngramモデルは、同じパラメータ数・同じFLOPsのMoEベースラインに対してMMLU +3.4、BBH +5.0、HumanEval +3.0を達成しました。機構の分析によれば、条件付きメモリは初期層を静的な知識の再組み立てから解放します。
ネイティブに学習可能なスパース性が既定になる。V4.1は密なウォームアップなしに、最初から64Kでスパースアテンションを学習します。スパースアテンションが推論時の近似から、学習時の第一級市民になったことを示しています。
スパース性×推論時計算。推論(reasoning)モデルは長い出力を生み、プリフィルもデコードも重くなります。MoEは知識の容量を、長い思考連鎖は推論の深さを提供します。CEDの非対称な活性化は、読み書き比率の異なるワークロードに向けたトレードオフです。
モジュール性と継続学習。エキスパートとメモリテーブルは局所的に編集できます。たとえば、ユーザーの記憶を局所的なパラメータ編集として書き込む研究があります(User as Engram, arXiv:2606.19172)。
スパース性と量子化の組み合わせ。MXFP4のエキスパート、FP4のKV、FP8のEngramはV4.1とK3ですでに併用されています。Q-Sparseの結論は、量子化が積極的であるほど最適なスパースの度合いは高くなる、というものです。
ハードウェアとの協調設計。BlackwellはFP4をネイティブにサポートし、CXLメモリプールとSSDを使った階層型KVストレージが進んでいます。LLMスケールのニューロモーフィックコンピューティングはまだ遠い見通しです。
反証可能な5つの予測(根拠つき)
| 予測 | 期限 | 根拠 |
|---|---|---|
| 主要オープンモデルの少なくとも1つで、グローバルKVがトークンあたり500バイト以下に下がる | 2027年末 | V1からV4.1で437分の1、V4からV4.1の1世代だけで4分の1、FP4はすでに使用中 |
| オープンモデル上位5つのうち少なくとも3つで、トークンあたり活性化率が3%を下回る | 2027年末 | 2026年時点ですでにV4.1 (2.9%)、K3 (3.7%)、Qwen3.5 (4.3%)があり、エキスパート数は世代ごとに倍増している |
| DeepSeek以外の少なくとも2つの主要研究機関が、フラッグシップのオープンモデルにルックアップテーブル型の条件付きメモリを導入する | 2028年 | EngramにはすでにCXL、SSD、学習不要の派生研究があり、NeMoにも載った |
| SAEは、どのフロンティア研究機関でも、公式発表される本番の安全性監視の主要手法にはならない | 2028年 | GDMの優先度引き下げ。下流タスクでのネガティブな結果 |
| 同じ能力水準のAPI単価は年10倍以上のペースで下がり続けるが、企業のタスクあたりエージェント支出は増える | 継続中 | Epochの価格トレンド。エージェントの呼び出し回数の倍増 |
私たちにとって何を意味するのか
審査とは本質的に、膨大な条文とページの中からtop-Kを選び出すタスクであり、スパース化のトレンドが押し下げているのは、まさにこの種のタスクの単価です。長文書・図面の審査エージェントを開発する企業にとって、実行可能な示唆は4つあります。
コスト曲線。「キャッシュヒット率」と「オフピークのバッチ処理の割合」を第一級の指標として扱うこと。審査タスクは本質的にバッチ化可能で、オフラインで実行できます。安定した法令・条例をプロンプトの先頭に置き、プレフィックスキャッシュのヒットを最大化すること。V4.1のキャッシュ済み入力の価格はキャッシュミスの1/50で、オフピークはさらに半額です。
モデル選定。「ページ横断の照合と条文引用」についての自前の評価セットでモデルを選び、平均ではなく最も難しいサブタスクのスコアで判断すること。高度にスパースなオープンMoEを主力の作業馬とし、難しいケースの二重チェックにはクローズドのフロンティアモデルを使うこと。
長いコンテキストの戦略。「top-Kページの検索(監査可能で引用つき)+1Mコンテキストでの再チェック(ページ横断の関係を見逃さないため)」のハイブリッドを採用すること。Sparse Frontierの結論はここに直接当てはまります。スパースアテンション単独に賭けると一部のタスクで性能が落ち、審査はまさに「1つ見逃せば答え全体が誤りになる」タスクです。
セルフホスティングの判断。MoEのメモリは総パラメータで決まります。V4.1のルーティングエキスパートとEngramテーブルは合計440 GiBを超え、公式のファインチューニング手順は単一NVLinkドメイン内の64 GPUを要求します。数十GPU未満の規模ではまず採算が合わないので、APIを選ぶこと。
研究の機会。既存研究は「予算内でどのページを確認するか」を検索問題として扱っています。しかし、ページ横断の整合性チェックにおいて本当にスパースな対象は「ページ」ではなく「ページのペア」です。Pページには P(P−1)/2 のペアがあり、その中からクロスチェックすべきk個のペアを選びます。これはマルチエージェントシステムのスパースな協調グラフにそのまま対応し、すべての(クエリ, キー)ペアを軽量なインデクサーでスコアリングして上位k個を取るというDSAの発想と同型です。私たちが差別化して切り込める方向です。
付録
A. 年表(1948年〜2026年9月)
| 年 | 出来事 | 信頼性 |
|---|---|---|
| 1948 | Shannon, A Mathematical Theory of Communication:冗長性とエントロピーの定式化 | 一次論文 |
| 1961 | Barlowの冗長性削減仮説 | 一次論文 |
| 1967 | Tinney & Walkerのスパース行列順序付け(電力網計算) | 一次論文 |
| 1978 | Rissanenの最小記述長(MDL) | 一次論文 |
| 1987 | Field:自然画像統計と皮質受容野 | 一次論文 |
| 1988–89 | Daubechiesのコンパクト台直交ウェーブレット。Mallatの多重解像度解析 | 一次論文 |
| 1990–93 | OBD / OBSによるプルーニング。Matching Pursuit | 一次論文 |
| 1991 | Jacobs–Jordan–Nowlan–Hintonの局所エキスパート混合 | 一次論文 |
| 1992 / 2000 | JPEG / JPEG2000 | 標準規格 |
| 1994–96 | ウェーブレットしきい値ノイズ除去。Breimanのgarrote。LASSO。Olshausen & Fieldのスパース符号化 | 一次論文 |
| 1998 | Basis Pursuit。DeVoreの非線形近似 | 一次論文 |
| 2001–03 | Attwell & Laughlinのエネルギー収支。Lennieの「おそらく1%未満」 | 一次論文(検証済み) |
| 2004–05 | LARS。Elastic Net | 一次論文 |
| 2006–07 | 圧縮センシング。K-SVD。LustigのCS-MRI | 一次論文 |
| 2009 | Donoho–Tanner相転移 | 一次論文 |
| 2011 | GlorotのReLU(50〜85%の厳密なゼロ)。Robust PCA | 一次論文(検証済み) |
| 2012 | Googleのネコ顔ニューロン | 一次論文(検証済み) |
| 2013–14 | Bengioの条件付き計算とSTE。Gavish–Donohoの最適ハードしきい値 | 一次論文 |
| 2016 | Deep Compression | 一次論文 |
| 2017 | ShazeerのスパースゲートMoE(137BのMoE層) | 一次論文(検証済み) |
| 2019 | 宝くじ仮説。EHT M87*。SartorettiのCS-MRI臨床研究 | 一次論文 |
| 2020 | GShard。HookerのHardware Lottery。Ampereの2:4 | 一次論文 |
| 2021–22 | Switch Transformer。GLaM。ST-MoE。Expert Choice。ClarkのMoEスケーリング | 一次論文 |
| 2023 | Mixtral。SparseGPT / Wanda。StreamingLLM / H2O。Towards Monosemanticity | 一次論文 |
| 2024年1–2月 | DeepSeekMoE。Gemini 1.5がMoEであることを公式確認 | 技術レポート |
| 2024年5月 | DeepSeek-V2 (MLA)。Scaling Monosemanticity。Golden Gate Claude | 技術レポート |
| 2024年6–7月 | GaoのTopK SAE。Q-Sparse | 一次論文(検証済み) |
| 2024年12月 | DeepSeek-V3 (671B/37B) | 技術レポート |
| 2025年1月27日 | DeepSeekショック:Nvidiaの時価総額が1日で約5,890億ドル減少 | 信頼できる報道 |
| 2025年2–3月 | NSA、MoBA。推論システムの理論利益率545%。GDMがSAEの優先度を下げる | 一次論文 / 公式 |
| 2025年4月 | Qwen3 MoE。Sparse Frontierプレプリント。Llama 4 | 公式 / 一次論文 |
| 2025年7–8月 | NSAがACL Best Paper受賞。Kimi K2。gpt-oss | 公式 |
| 2025年9–12月 | DeepSeek-V3.2、DSA | 技術レポート |
| 2026年1月 | Engram:条件付きメモリとU字型のスパース性予算配分 | 一次論文 |
| 2026年2月 | Qwen3.5-397B-A17B | 公式モデルカード |
| 2026年4月24日 | DeepSeek-V4 (Pro 1.6T/49B、Flash 284B/13B) | 技術レポート |
| 2026年7月 | Kimi K3 (2.8T/104B)。Sparse FrontierがFindings of ACL 2026に掲載 | 公式 |
| 2026年9月10日 | DeepSeek-V4.1-Flash (CED、CSA2、890 B/トークン、Engram) | 公式+技術レポート(検証済み) |
B. グラフ化できるデータ系列
DeepSeekのグローバルKVキャッシュ(トークンあたり):V1 ≈ 389 KB(推定)→ V3.2 ≈ 48 KB → V4-Flash ≈ 3.5 KB → V4.1-Flash 890 B。対数スケール。
トークンあたり活性化率:Mixtral 28% → Qwen3 9.4% → gpt-oss 4.4% → Qwen3.5 4.3% → Kimi K3 3.7% → V4.1デコード2.9% / プリフィル1.4%。
エキスパート数(選択 / 総数):2/8 → 4/128 → 8/256 → 6/384 → 10/512 → 16/896。
DeepSeekのAPI価格($/M、入力 / 出力):V4-Flash 0.14 / 0.28。V4-Pro 1.74 / 3.48(8月以降のピーク時出力は3.96)。V4.1-Flashはピーク0.30 / 1.20、オフピーク0.15 / 0.60、キャッシュ0.006。
Sparse Frontier:プリフィルの最適スパース率0.80〜0.93。デコードは0.95でも実用に耐える。交差点は32〜64K。
Glorot 2011のスパース率:MNIST 83.4%、CIFAR10 72.0%、NISTP 68.0%、NORB 73.8%。
Q-Sparse:最適スパース率45.58%(フル精度)/ 61.25%(1.58ビット)。40%前後で密なモデルと同等。
Engram-27BのMoEベースラインに対する差:MMLU +3.4、CMMLU +4.0、BBH +5.0、ARC-C +3.7、HumanEval +3.0、MATH +2.4。
CS-MRI:スキャン時間−20.2%、検査時間−16%、単一シーケンス−23%〜−43%、検査件数+27%。
GPUの計算性能と帯域:「ニューラルネットワーク時代」のGPU表を参照。
C. 逸話とストーリー素材
「Lennieの1%」はいかにして「1〜4%」になったか:誤解を正す導入として使えます。
ネコ顔ニューロン(2012):1,000台のマシンが3日かけて、YouTubeのフレームから独力で「ネコ」を学んだ話。
Outrageously (2017):LSTM時代の137B MoE層が2026年の風景を予告していた話。HintonとDeanの共著は「1991年の古いアイデア×Googleの計算資源」の象徴です。
DeepSeekショック(2025年1月27日)と545%に付く「理論上の」という言葉。
Golden Gate Claude (2024)とGDMの急ブレーキ(2025年3月)。
CS-MRI:患者がスキャナーの台に横たわる時間は20%減り、病院は検査を27%多くこなせるようになった話。
437分の1:トークンあたりの「記憶」が約389 KBから890バイトへ縮んだ話。
Nグラムの帰還:歴史の彼方に葬られたはずの統計的言語モデルが、Engramとしてフロンティアに戻ってきた話。
D. よくある誤解とその訂正
| よくある言い回し | 正確な記述 |
|---|---|
| 脳はニューロンの1〜4%しか使っていない | Lennie 2003の実際の記述は「おそらく1%未満」で、エネルギーに基づく上限の推定。1〜4%はGlorot 2011経由の孫引き |
| ReLUネットワークは90%スパース | Glorot 2011:初期化時に約50%、学習後は50%〜85% |
| GPT-4は16エキスパートの1.8T MoE | OpenAIが一度も確認していない2023年の噂。GPT-5.xとClaudeの構成も同様に非公開 |
| CS-MRIはスキャンを30〜60%高速化する | Sartoretti 2019:平均スキャン時間−20.2%、単一シーケンス−23%〜−43% |
| Shazeer 2017:「最大1000倍」 | 原文は「greater than 1000x(1000倍超)」。137BはMoE層のパラメータ数 |
| Sparse FrontierはICML 2025で発表された | 正式にはFindings of ACL 2026に掲載 |
| DeepSeekの利益率は545% | 自己申告の理論上のコスト利益率。実際ははるかに低く、研究開発費と学習コストを除外している |
| MLAはスパースアテンションである | MLAは低ランク圧縮。実際にスパースなのはDSA / CSA2 |
| スパースアテンションは無制限に圧縮できる | ほぼすべての構成が、少なくとも1つのタスクで大きく性能を失う |
E. 参考文献
古典的基礎:Shannon 1948; Barlow 1961; Tinney & Walker 1967; Rissanen 1978; Field 1987; Mallat 1989; LeCun, Denker & Solla 1990; Jacobs, Jordan, Nowlan & Hinton 1991; Mallat & Zhang 1993; Donoho & Johnstone 1994 (Biometrika); Breiman 1995; Tibshirani 1996 (JRSS-B); Olshausen & Field 1996 (Nature); Chen, Donoho & Saunders 1998; DeVore 1998; Attwell & Laughlin 2001; Lennie 2003 (Curr. Biol.); Efron et al. 2004; Zou & Hastie 2005; Candès, Romberg & Tao 2006; Donoho 2006; Aharon, Elad & Bruckstein 2006; Lustig, Donoho & Pauly 2007; Lee, Battle, Raina & Ng 2007; Donoho & Tanner 2009; Glorot, Bordes & Bengio 2011; Candès, Li, Ma & Wright 2011; Le et al. 2012; Bengio et al. 2013; Gavish & Donoho 2014; Han, Mao & Dally 2016; Shazeer et al. 2017; Frankle & Carbin 2019; Sartoretti et al. 2019; Vranic et al. 2019; Hooker 2021 (CACM); Fedus, Zoph & Shazeer 2021; Clark et al. 2022.
2023〜2026年:Frantar & Alistarh 2023 (SparseGPT); Sun et al. 2023 (Wanda); Xiao et al. 2023 (StreamingLLM); Bricken et al. 2023; Jiang et al. 2024 (Mixtral); Dai et al. 2024 (DeepSeekMoE); DeepSeek-AI 2024 (V2, V3); Templeton et al. 2024; Gao et al. 2024; Wang et al. 2024 (Q-Sparse); Krajewski et al. 2024; Yuan et al. 2025 (NSA); Nawrot et al. 2025/2026 (Sparse Frontier); Kantamneni et al. 2025; OpenAI 2025 (gpt-oss); Google DeepMind 2025 (Gemini 2.5技術レポート, arXiv:2507.06261); Moonshot 2025/2026 (Kimi K2, K3); Alibaba 2026 (Qwen3.5); Cheng et al. 2026 (Engram, arXiv:2601.07372); DeepSeek-AI 2026 (V4, arXiv:2606.19348); DeepSeek-AI 2026 (V4.1-Flash, arXiv:2609.19969); Ma et al. 2024 (MMLongBench-Doc).
教科書とサーベイ:Elad, Sparse and Redundant Representations (2010); Hastie, Tibshirani & Wainwright, Statistical Learning with Sparsity (2015); Mallat, A Wavelet Tour of Signal Processing (3rd ed.); Foucart & Rauhut, A Mathematical Introduction to Compressive Sensing (2013); Hoefler et al. 2021, Sparsity in Deep Learning; Cai et al. 2024, A Survey on Mixture of Experts.
読了
次に読む ↓