Articles
Khả năng giải thích của AI: Lịch sử, Phương pháp và Ứng dụng trong xem xét các bản vẽ kiến trúc
Product
Career
Overview
AIの説明可能性とは、AIがなぜその判断をしたのか、何を見て、何を見落とし、どこに不確実性があり、問題が起きたときにどう追跡できるのかを人間が理解できるようにすることであり、建築図面審査のような高リスク領域でAIを運用するために必要な重要な要素です。本稿は、深層学習の発展とともに生まれたブラックボックス問題の歴史から、決定木やEBMなどの事前的な解釈可能性、LIME・SHAP・反実仮想説明などの事後的な説明可能性、画像モデルのヒートマップ、大規模言語モデルの機械的解釈に至る手法の全体像を整理し、建築図面審査AIへの実装を提案します。結論としては、AIの出力を結論・図面上の位置・規範や条文の根拠・不確実性・ログと人間による確認経路という多層的な証拠チェーンとして設計することが重要であり、説明可能性は追加コストではなくプロダクトの参入障壁になるということです。
はじめに ── AIは本当に「理解」しているのか
近代AIの発展において、深層学習の爆発的な進歩は、何か一つの要因だけによって起きたものではありません。モデル、データ、計算能力という複数の要素が同時に成熟したことで、大きな転換点が生まれました。
1990年代には、Yann LeCunらが提案した畳み込みニューラルネットワーク、いわゆるLeNetが、手書き数字認識や文書認識の分野で高い性能を示しました。その後、Geoffrey Hintonらの研究者によって深層学習の研究はさらに発展していきます。さらに、GPUによる並列計算の発展により、大規模な行列演算が現実的に実行できるようになりました。加えて、Fei-Fei Liらのチームが推進したImageNetという大規模画像データセットによって、AIは大量の実画像を用いて学習し、性能を比較・競争できるようになりました。そして2012年、Alex Krizhevsky、Ilya Sutskever、Geoffrey HintonによるAlexNetがImageNetの画像認識タスクで大きな成果を上げ、現代の深層学習は本格的に注目されるようになりました。
しかし、ここで一つ重要な問いが生まれます。モデルに画像を入力すると、高い精度で認識結果が出力されます。一見すると、AIは確かに「正解している」ように見えます。けれども、私たちは本当に、AIがなぜその答えを出したのかを理解できているのでしょうか。
AIが猫を認識したとき、それは本当に猫の目、耳、輪郭、身体の構造を理解しているのでしょうか。それとも、学習データの中にある統計的なパターンを覚えているだけなのでしょうか。医療画像でリスクを判定するとき、AIは本当に病変を見ているのでしょうか。それとも、画像の中の透かし、撮影機器の癖、病院ごとのマークなど、本来見るべきではない情報に反応している可能性はないのでしょうか。これは、ある人が一万回リンゴが木から落ちる場面を見て、「リンゴは下に落ちる」と正しく予測できるようになったとしても、その人が重力を本当に理解しているとは限らない、という状況に似ています。
自動運転、医療診断、建築図面審査、金融リスク管理のような高リスク領域では、この問題は特に重要です。これらの分野においてAIの誤りは、単に練習問題を一問間違えることではなく、安全、責任、コスト、信頼に直接関わるからです。そのため、説明可能性は単なる「あると便利な技術」ではありません。AIが「結果を出せる存在」から、「人間が理解し、検証し、信頼し、管理できる存在」へ進化するために必要な重要な要素です。
エグゼクティブサマリー
AIの説明可能性とは、簡単に言えば、AIに「もっと上手に話させる」ことではありません。人間が、AIがなぜその判断をしたのか、何を見て、何を見落とし、どこに不確実性があり、問題が起きたときにどう追跡できるのかを理解できるようにすることです。
近年このテーマが重要になっている理由は、単に「ブラックボックスが嫌われている」からではありません。法規制、顧客からの信頼、品質監査、安全責任、部門横断の協業などが、AIに対して「答えだけを出す」段階から「答えと根拠を一緒に出す」段階への移行を強く求めているからです。EUのAI Actは高リスクAIシステムに対して、技術文書、自動ログ、透明性、人間による監督を要求しています。中国のアルゴリズム推薦サービス管理規定や生成AIサービス管理暫定弁法も、アルゴリズムの基本原理・目的・主要な運用メカニズムの公開や説明を求めています。NISTも、AIリスクの重要な原因の一つとして「不可視性・捉えにくさ」を挙げています。
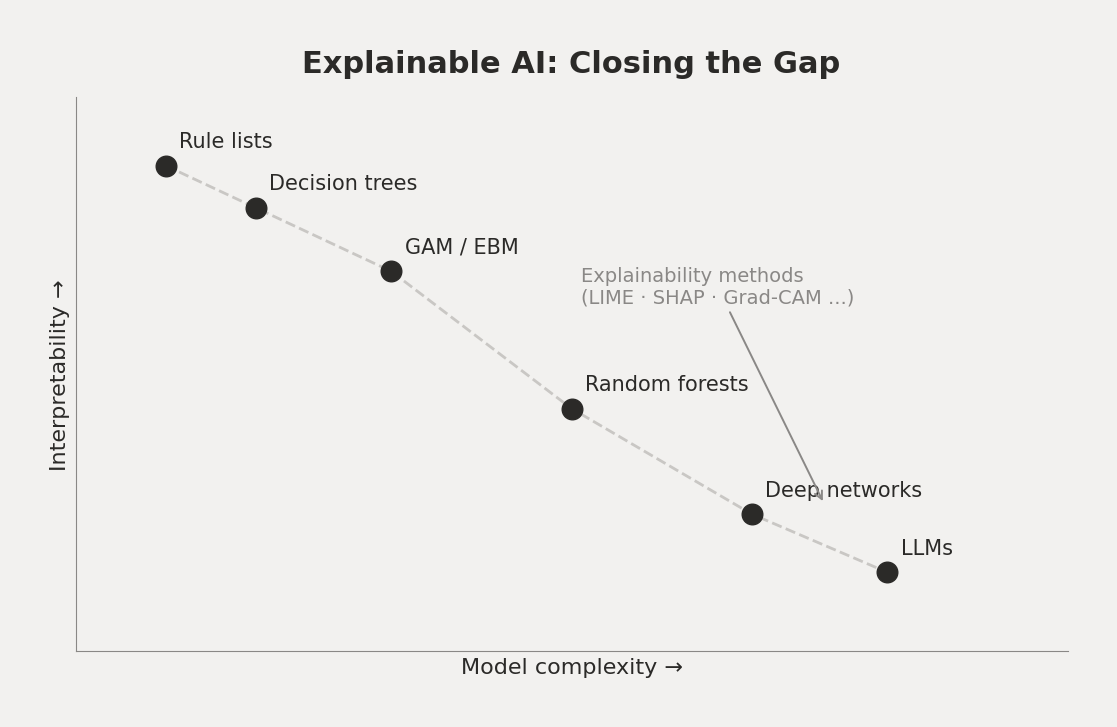
研究の歴史を見ると、初期のAIはルール、決定木、エキスパートシステムが中心で、モデル自体が比較的理解しやすいものでした。しかし深層学習の台頭により精度は急速に向上した一方で、モデルの可読性は大きく低下しました。その結果、2010年代後半にはヒートマップ、LIME、SHAP、Grad-CAM、反実仮想説明など、「ブラックボックスに説明書をつける」方法が登場しました。そして大規模言語モデルの時代になると、研究は外部から説明する方向(根拠の提示、検索証拠、構造化出力)と、内部から説明する方向(ニューロン解釈、疎な特徴、回路追跡、機械的解釈)の二つに進みました。
建築図面審査AIエージェントにとって、説明可能性は単なる学術的な付加価値ではなく、非常に実用的な生産性向上の道具です。建築審査はルールが多く、責任範囲が明確で、誤検出・見逃しのどちらにも敏感な領域です。AIの出力を単なるリスクスコアではなく、結論+図面上の位置+条文根拠+監査ログ+人間による確認入口という多層的な証拠パッケージにすることが、実運用により適しています。
なぜ会社全体でAI説明可能性を理解する必要があるのか
まず最も現実的な点から言うと、説明は装飾ではなく、リスク管理です。DARPAのXAIプロジェクトは、「人間がAIを理解し、適切に信頼し、有効に管理できるようにすること」を主要な目標に掲げました。米国国立標準技術研究所(NIST)も、AIの「捉えにくさ」はリスク測定やリスク管理を難しくすると指摘しています。つまり説明は「見栄えのため」ではなく、組織がAIを本当に管理可能で、説明責任を果たせるプロセスに組み込むために必要なのです。
信頼という観点では、本当に重要なのは「AIをもっと信じさせること」ではなく、「AIを適切に信じられるようにすること」です。説明がないと、人は二つの極端に流れやすくなります。一つは、AIが賢く見えるために過度に依存すること。もう一つは、AIの仕組みがわからないためにまったく使わなくなることです。XAI研究や人間とAIの協働に関する文献では、しばしば「appropriate reliance」、つまり信じるべき場面では信じ、疑うべき場面では疑える状態が重視されます。ただし、説明を追加すれば必ず意思決定が良くなるわけではありません。だからこそ、企業は説明を「AIを信じさせるための話術」ではなく、信頼を調整するための仕組みとして設計する必要があります。
安全性の観点では、説明はモデルが何を「変な近道」として学習しているかを見つける助けになります。多くのモデルは訓練中に、ウォーターマーク、タイトル欄、スキャンノイズ、ページ枠など、本来のタスクとは関係がないが偶然相関している信号を学習してしまうことがあります。建築図面では、レイアウト差、スキャン品質、押印、修正雲、縮尺注記、複数ページの結合など、モデルにとって紛らわしい要素が数多く存在するため、この問題が特に重要です。
生産性の観点でも、説明可能性は過小評価されがちです。AI図面審査の結果が、ヒートマップ、条文、寸法根拠、「なぜこの規則に該当すると判断したか」を同時に示せるようになれば、それは単なる判定器ではなく、新人に対するOJT教材にもなります。監査や部門横断の協業という観点では、一つの結論が「該当箇所、抽出寸法、対応条文、類似過去事例、モデルバージョン、人間による確認提案」まで展開できれば、議論は抽象的な不安から具体的な証拠へ移ります。
歴史と発展の流れ
AI説明可能性の歴史は、モデルが強力になるにつれて、説明手段が後から補強されてきた歴史と見るとわかりやすいです。
| 時期 | 何が起きたか | 説明可能性にとっての意味 |
|---|---|---|
| 初期のルール・木モデル時代 | エキスパートシステム、ルールベース、決定木などが中心。if-then構造を持ち、モデル自体が読めた | 説明とは主に「モデルそのものを読む」ことだった |
| 深層学習によるブラックボックス化 | 深層ネットワークが視覚タスクで大きく発展し、勾配顕著図、特徴可視化などでCNNを理解しようとする研究が進んだ | 説明は「ルールを読む」から「ブラックボックスに可視化による健康診断を行う」方向へ |
| XAIの体系化 | DARPA XAIが高い性能を保ちながら説明可能なモデルを作ることを掲げ、LIME、SHAP、Integrated Gradients、Grad-CAMなどが主流化 | 説明可能性は独立した研究分野になった |
| 忠実性と評価の時代 | 「説明らしく見える」ことと「本当に説明している」ことは違うと意識され、sanity check、infidelity、sensitivityなどの評価が提案された | 説明そのものも検査されるべき対象になった |
| LLMと機械的解釈の時代 | TransformerとLLMの発展により、注意、ニューロン、疎な特徴、内部回路を追跡する研究が進む(Anthropic、OpenAI) | 説明は「モデル内部で何が起きているか」へ広がった |
一言で言えば、初期のAIは透明な機械、深層学習は高性能なブラックボックス、その後はブラックボックスに計器盤とドライブレコーダーをつける段階、そして今日の最前線はエンジンの内部まで開けようとする段階です。この流れを理解すると、企業実装で最も現実的な方針も見えてきます。いきなり大規模モデルを完全に見通そうとするよりも、まずは計器盤、証拠チェーン、人間による確認インターフェースを整える方が、ビジネス価値に直結しやすいのです。
方法の全体像
厳密に言うと、interpretability(解釈可能性)は「モデル自体が理解しやすいこと」に近く、explainability(説明可能性)は「モデル自体が複雑でも、追加手段によって人間に説明できること」に近い概念です。実務では用語にこだわりすぎるよりも、モデル本体を透明にしたいのか、それとも結果を確認可能にしたいのかを明確にすることが重要です。
事前的な解釈可能性
事前的な解釈可能性は「内在的解釈可能性」または「ホワイトボックス手法」とも呼ばれ、モデルを設計する段階から人間が理解しやすい構造を選ぶという考え方です。決定木、ルールリスト、線形モデルは代表的な例です。その後、性能を高めながら可読性も残す方法として、一般化加法モデル、GA2M、Explainable Boosting Machine(EBM)なども提案されました。決定木は特に説明しやすく、「階段の有効幅が一定値未満で、かつその区域が避難経路である場合、リスクを検出する」というようなルールは、建築実務者が直感的に理解できます。
もう一つの重要な方向は制約付き学習です。訓練時に疎性、単調性、安定性などの制約を入れたり、自己説明型ニューラルネットワークのように「概念・貢献・結論」の関係をモデル構造の中に明示的に持たせる方法があります。この場合、説明は事後に付け足されるものではなく、学習そのものの一部になります。
事後的な説明可能性
事後的な説明可能性は、すでに訓練されたモデルをそのまま使い、出力の周辺に説明の足場を作る方法です。局所説明は「この図面が、なぜこの結果になったのか」に答え、全体説明は「このモデルは普段、全体として何を手がかりに判断しているのか」に答えます。
| 方法 | たとえ | 長所 | 限界 | 建築図面審査での直接的価値 |
|---|---|---|---|---|
| 決定木/ルールリスト | 透明なフローチャート | 監査しやすく、教育と合規議論に向く | 複雑なパターン表現には弱い | 明示ルール審査、高頻度の単純条文チェック |
| EBM/GA2M | 読める分項スコアリング | 一部タスクで性能と理解しやすさを両立 | すべての複雑タスクには向かない | 表形式・構造化された審査特徴 |
| LIME | 近所の小さな先生 | モデル非依存、単一結果の説明に便利 | サンプリングにより不安定になりうる | 特定図面での誤検出説明 |
| SHAP | 公平な貢献度分配 | 局所・全体の両方を見られる | 計算と解釈に経験が必要 | 特徴量貢献分析、バージョン比較 |
| 反実仮想 | 修正提案書 | 行動に結びつきやすい | 実際に変更可能かの考慮が必要 | 「どう直せば通るか」の提案 |
| Deep Unrolling | 職人の反復手順を固定工程に分解 | 強力で高速、純粋ブラックボックスより説明しやすい | すべてのタスクに適するわけではない | 画像復元、図面のベクトル化、測定系サブモジュール |
LIMEは、ある一つのサンプルの近くで似たサンプルをたくさん作り、その近傍だけを説明できる小さな代理モデルを訓練する、「そのサンプルの近所だけを教えてくれる小さな先生」のような存在です。SHAPは、各特徴量が結果にどれだけ貢献したかをShapley valueというゲーム理論の考え方で分配します。ただし貢献値は因果関係そのものではないため、解釈には注意が必要です。反実仮想説明は「もし少し違っていたら、どうなっていたか」を示すもので、図面審査では「この扉幅が850mmではなく900mmで、避難方向の矢印が補完されていれば、この項目は通過する可能性が高い」というように、改善提案に近い形で説明できます。
画像モデルにおける説明可能性
ヒートマップは最も説明しやすい概念です。本質的には「影響度の地図」であり、元画像の上に半透明の温度フィルムを重ねて、モデルがどこに注目していたのかを示すイメージです。顕著図、Grad-CAM、Integrated Gradients、LRPなどは、計算方法は異なるものの、しばしばこのような形式で可視化されます。
ただし、ヒートマップは非常に説明しやすい一方で、非常に誤解されやすいものでもあります。ヒートマップは法律根拠でも、因果証明でも、モデルの思考過程をそのまま録画したものでもありません。あくまで、今回の判断でどの領域が大きな手がかりになった可能性があるかを示す線索です。もしモデルが「ここに避難関連の問題がある」と言うなら、ヒートマップは階段室、扉、寸法注記、軸線関係などに集中しているべきです。逆に、タイトル欄、図枠、ウォーターマークなどが強く光っているなら、モデルが本来学ぶべきでない近道を学んでいる可能性があります。
画像説明で非常に重要な切り口が、敵対的サンプルです。人間にはほとんど見えない程度の小さな摂動を入力に加えるだけで、モデルが高い確信度で誤分類してしまうことがあります。これは、モデルが人間にとって自然ではないが予測には役立つ「非ロバスト特徴」を学んでいる可能性を示しています。図面のスキャン、縮小拡大、圧縮、局所的な遮蔽、押印、改訂記号などが、モデルにとって小さいが致命的な入力変化になる可能性があるため、図面AIでは説明可能性とロバスト性を一緒に考えることが重要です。
大規模言語モデル(LLM)における説明可能性
Transformerの中心にある注意機構は、LLMの説明可能性を考える最も自然な入口の一つです。BertVizのようなツールは、異なる層、異なるヘッド、異なるトークン同士の注意関係を可視化します。ただし、注意は説明そのものではありません。注意分布は、モデルが本当に依存している根拠を常に忠実に示すとは限りません。
大規模言語モデル時代に最も身近な「説明」の一つがChain-of-Thought、つまりモデルに手順を書かせることです。しかし、モデルが書いた手順が、必ずしもモデル内部で実際に作用した理由の連鎖とは限りません。したがって、企業実装ではLLMの説明可能性を「もっと詳しく理由を書かせる」ことだけに頼るべきではありません。より堅実な方法は、説明可能性と外部証拠を結びつけることです。RAG、構造化出力、ツール呼び出し、出典引用、ページ番号、条文番号などです。図面審査における大規模言語モデルの最良の説明は、「なぜそう思ったか」という独白ではなく、「どの規範を引用し、図面上のどこを見て、どの数値を抽出し、どう確認すべきか」を示すことです。
近年、LLMの説明可能性の最前線は機械的解釈(mechanistic interpretability)へ進んでいます。Anthropicは、Claude 3 Sonnetの活性から疎な自己符号化器を使ってより単義的な特徴を抽出する研究を発表しました。OpenAIも、GPT-4を用いてGPT-2のニューロンに自動的に説明を付ける研究を行いました。LLM説明可能性は「結果を読めるようにする」段階から、「仕組みを調べ、挙動を制御し、問題を定位する」段階へ進みつつあります。
評価、トレードオフ、限界
説明可能性で本当に難しいのは、何をもって良い説明と呼ぶのかです。実務的には、説明の評価を次の観点に分けると理解しやすくなります。
| 評価軸 | よくある問い | 代表的な方法 |
|---|---|---|
| 忠実性 | 説明はモデルが本当に依存した根拠を反映しているか | Infidelity、Sensitivity、Deletion/Insertion、Sanity Checks |
| 有用性 | 人が見たときに理解・確認・修正が速く正確になるか | ユーザー実験、意思決定精度、確認時間 |
| 頑健性 | 入力が少し変わったときに説明が乱れないか | 摂動テスト、ランダム化テスト、バージョン比較 |
| 行動可能性 | 説明を具体的な修正提案に変換できるか | 反実仮想説明、ルール整合、証拠カード |
| 合規性 | 説明が記録、復盤、説明責任に使えるか | ログ完全性、出典追跡、人間の確認フロー |
「精度と説明可能性は必ずトレードオフになる」とよく言われますが、厳密には必ずしもそうではありません。EBMやGA2Mの研究は、一部のタスクで可説明モデルが非常に高い性能を出せることを示しています。現実的に重要なのは、どの説明が、どのユーザーに、どのタスクで役に立つのかです。成熟した業務向け説明可能性システムは、少なくとも「忠実であること(誤解を招かない)」「有用であること(判断・確認・改善に役立つ)」「追跡可能であること(責任と根拠をたどれる)」という三つの原則を守る必要があります。
建築図面審査AIへの実装提案と今後の展望
最も勧めたいのは、最初から「派手な説明」を作ることではなく、図面審査の証拠チェーンを作ることです。つまり、毎回のAI出力が少なくとも次の五層を持つようにすることです。
結論
図面上の位置
規範・条文根拠
不確実性
ログと人間による確認経路
たとえばAIが平面図上で「避難扉の有効幅が不足している可能性があります」と提示したとします。有用な説明は、単に一文を表示するだけでは不十分です。扉の位置、モデルが注目した寸法注記、OCRまたは図形解析で抽出した有効幅、該当する規範条文、条文のバージョンとページ、さらに「この幅を一定値以上に調整すれば通過する可能性があります」という反実仮想的な修正提案を同時に示すべきです。このような出力は、審査者にとっては確認カード、顧客にとっては説明カード、プロダクトとアルゴリズムチームにとっては学習データになります。
逆に、モデルがタイトル欄の過去の修正説明を現在ページの規範的な記述と誤認したり、押印、透かし、修正雲を構造部材と誤認したりする場合、システムは黙って結論を出すのではなく「説明異常」を検出すべきです。ヒートマップが設計領域ではなく非設計領域に集中している、視覚証拠と条文証拠が一致しない、重要寸法が欠落しているのに信頼度が高すぎる、といった「説明と結論の不整合」を監視することは、単純な精度監視よりも早く問題を発見できる可能性があります。
今後数年、AI説明可能性はおそらく四つの方向に同時に発展します。第一は検証可能AI(重要な性質への形式的保証)、第二は説明可能性の標準化(モデルカード、説明カード、ログ仕様)、第三は説明可能性の自動化(条文証拠カードの自動生成、不自然な高信頼度の自動検出)、第四は説明可能性とプライバシー・安全性の相互作用(階層化された説明)です。
最も明確な提言は、説明可能性をアルゴリズムの付属物ではなく、プロダクト能力として定義することです。建築図面審査という場面で最終的に勝つのは、最も点数を出すのがうまいモデルではなく、結論、証拠、規範、人間の確認を最もよく整理できるシステムです。この意味で、説明可能性は追加コストではなく、プロダクトの参入障壁になります。
Đã đọc
Đọc tiếp ↓