Research
Modelos Sparse: origen, importancia y el futuro en la vanguardia de los LLM
Product
Career
Esta es una traducción automática del texto original en japonés
Overview
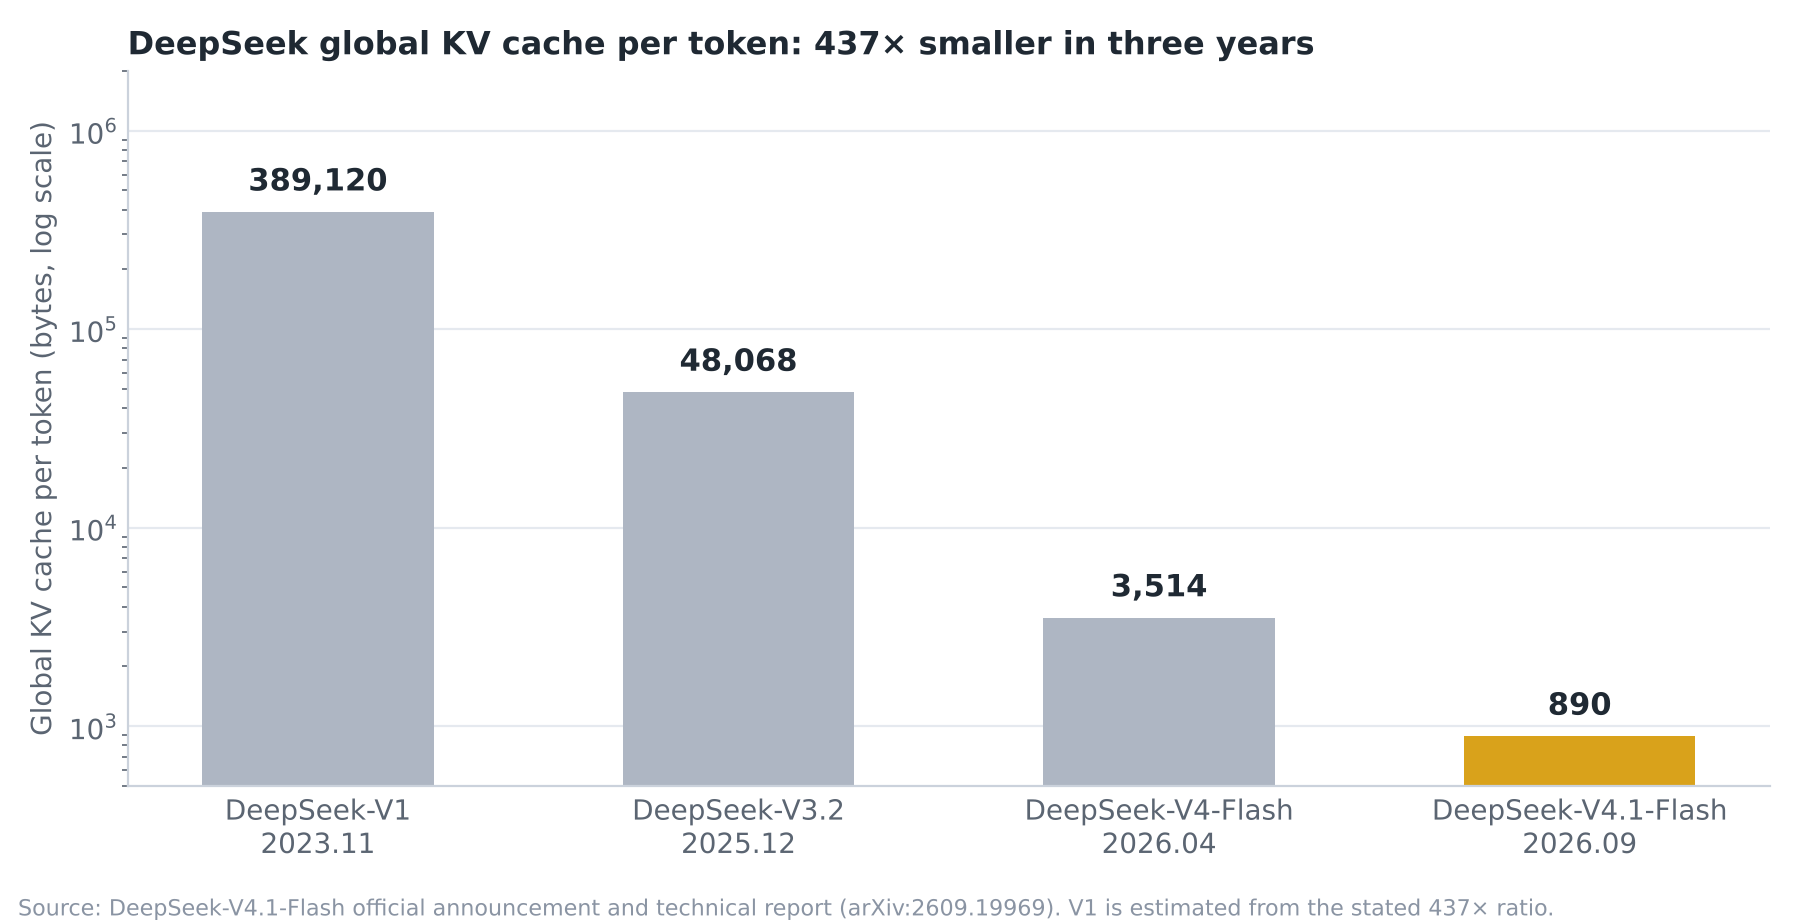
A partir de 2026, la dispersidad (sparsity) ya no es una "técnica de eficiencia opcional". Es una restricción de arquitectura predeterminada en modelos de frontera a gran escala y un factor determinante tanto del costo operativo de los grandes modelos como de la precisión de lectura de agentes que manejan documentos largos. La evidencia más directa es DeepSeek-V4.1-Flash, publicado el 10 de septiembre de 2026. Aunque tiene un backbone de 552B parámetros, solo se activan 8B por token durante el prefill y 16B durante el decode, y el caché global de KV que reside en memoria GPU se comprime a 890 bytes por token, tan solo 1/437 del de DeepSeek-V1 (anuncio oficial de DeepSeek, reporte técnico arXiv:2609.19969).
Tres puntos clave
La genealogía de la dispersidad es continua. Desde la "codificación dispersa del cerebro" de Barlow y Olshausen–Field, pasando por la "dispersidad computable" de wavelets, LASSO y compresión detectada, hasta la "dispersidad como arquitectura" de MoE, atención dispersa y memoria condicional. En el fondo siempre hay la misma distribución previa: "solo un número muy pequeño de componentes realmente importantes". Lo que comparten las tres genealogías exitosas es que el patrón disperso se ajustaba al hardware. La poda de pesos no estructurada fracasó no por la teoría, sino por el hardware.
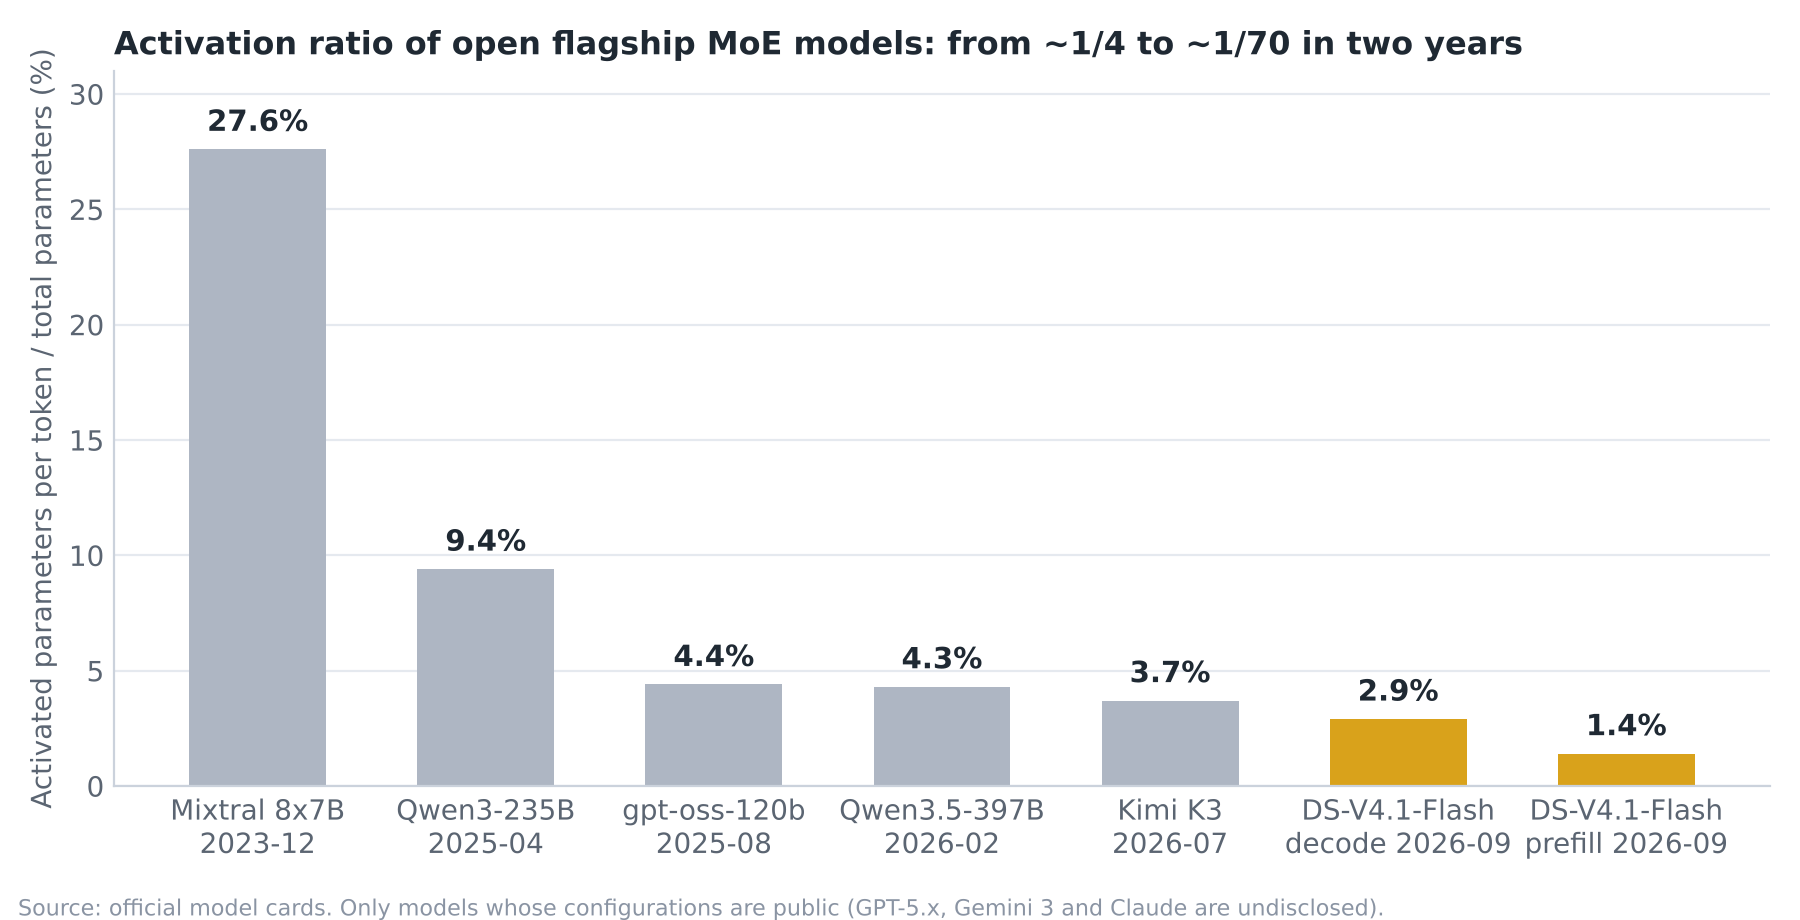
¿Por qué ahora? El escalado ha chocado con el muro del costo de inferencia y memoria, y los agentes que manejan contextos largos han hecho que el caché KV y el prefill sean costos dominantes. Como resultado, el papel de la dispersidad se ha expandido de "ahorro de cálculo" a "ahorro de memoria, ancho de banda y almacenamiento". El MoE mainstream de 2024 activaba aproximadamente el 25% de parámetros por token (Mixtral), pero en 2026 esa proporción ha caído a 1.5%–4.5% (DeepSeek-V4.1, Kimi K3, Qwen3.5).
La dispersidad no es una panacea. La evaluación a mayor escala jamás realizada sobre atención dispersa (Nawrot et al., Findings of ACL 2026) muestra que casi todas las configuraciones dispersas causan degradación severa en al menos una tarea. En el campo de la interpretabilidad, los autocodificadores dispersos (SAE) enfrentaron resultados sistemáticamente negativos en 2025. La selección de modelo debe juzgarse por la puntuación en las tareas más difíciles para el negocio, no por puntuaciones promedio.
Dos ejes que atraviesan este artículo
Cinco tipos de dispersidad: dispersidad de activación, dispersidad de pesos, dispersidad estructurada, computación condicional (MoE) y dispersidad de atención. La discusión sobre "¿es útil la dispersidad?" no puede comenzar sin identificar de qué tipo se habla.
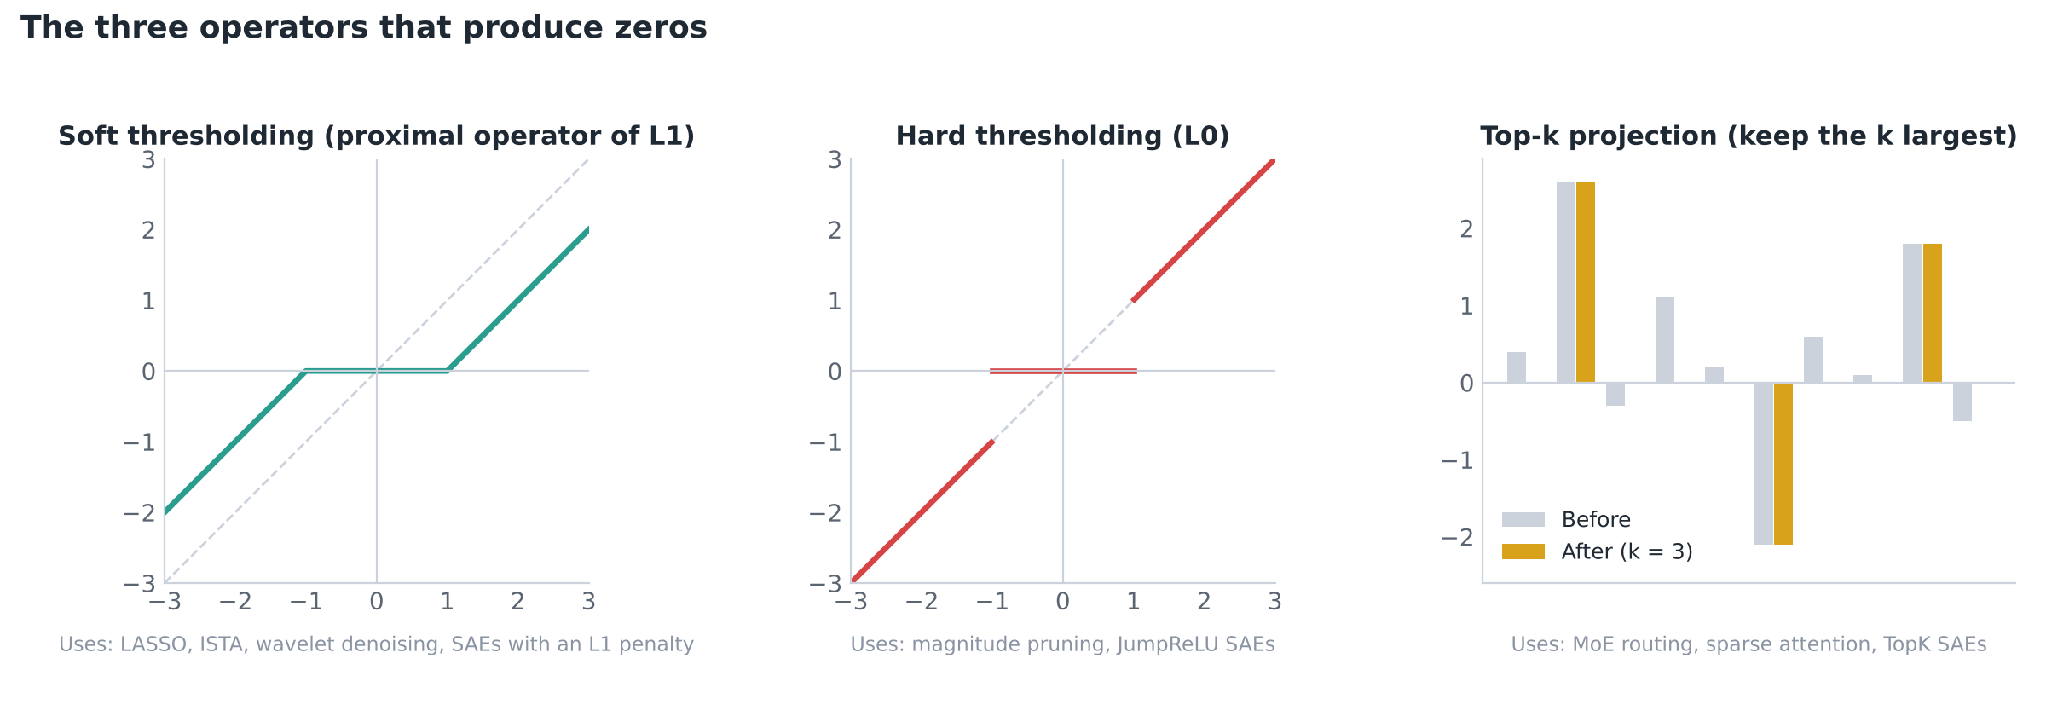
Tres operadores: umbralización suave (operador proximal de L1), umbralización dura (L0) y proyección top-k (proyección a la bola L0). Desde la eliminación de ruido por wavelets de 1994 hasta el enrutamiento de MoE de 2026, el paso de "crear ceros" simplemente aplica uno de estos tres operadores a diferentes objetivos. Casi todos los grandes modelos modernos utilizan el tercero. Porque permite fijar exactamente el número de operaciones por token y se alinea con la granularidad de paralelismo del hardware.
Cinco términos que aparecen repetidamente en toda la exposición
| Término | En una palabra |
|---|---|
| Token | La unidad mínima de texto que procesa el modelo. Una palabra o parte de ella. "Cuántos parámetros se activan por token" significa cuánta computación se utiliza cada vez que se produce un poco de texto. |
| Parámetros y parámetros activados | Los parámetros son el conjunto total de números que retiene el modelo (cuánto sabe). Los parámetros activados son la parte que realmente se utiliza en el cálculo al procesar un token (cuánto cuesta mover). Hacer disperso es separar estos dos. |
| Base y coordenadas | Un conjunto de "bloques de construcción". Los datos pueden escribirse como su suma ponderada, y los pesos corresponden a las coordenadas. Cambiar los bloques cambia el sistema de coordenadas. Los datos son los mismos, pero los valores que se leen cambian. |
| Norma | L2 es la longitud, L1 es la suma de valores absolutos de componentes, L0 es el número de componentes no nulos. Disperso significa que L0 es pequeño. |
| FLOPs y ancho de banda de memoria | El throughput de cálculo es el número de operaciones de multiplicación-acumulación por segundo; el ancho de banda es el número de bytes por segundo que pueden extraerse de la memoria GPU. En la etapa de decodificación de los grandes modelos modernos, el cuello de botella suele ser el segundo. |
Nota sobre terminología: En este artículo, "disperso" se usa estrictamente para significar "la mayoría de elementos son cero". "Bajo rango" significa "ningún elemento es cero, pero hay pocos grados de libertad" (como MLA y LoRA). Aunque los dos se confunden frecuentemente, este artículo los distingue consistentemente.
Cómo leer este artículo
Este artículo procede cronológicamente y responde las mismas cuatro preguntas para cada era. ¿Cuál era el contexto y el cuello de botella en ese momento? ¿Cómo surgió la dispersidad? ¿Qué resolvió y qué sacrificó? ¿Cómo se conecta con los grandes modelos hoy? En el capítulo "Prehistoria" nos preguntamos por qué el mundo es disperso. "Época Clásica" muestra cómo las matemáticas lo convirtieron en una herramienta, "Era de Redes Neuronales" explica por qué la poda fracasó cuando se introdujo dispersidad en redes neuronales. El capítulo central "Presente" discute por qué los grandes modelos cambiaron completamente hacia la dispersidad entre 2023 y 2026, comparando sistemáticamente los enfoques de cada institución. "Donde la dispersidad y el aprendizaje profundo se encuentran" aborda la fusión de dispersidad y aprendizaje profundo en procesamiento de imágenes y señales, mientras que los capítulos "Aplicaciones", "Beneficios y Costos", "Futuro" y "Qué significa para nosotros" cubren aplicaciones, costos, futuro y qué significa todo esto para nosotros. Los apéndices incluyen cronología, datos, anécdotas y referencias.
Prehistoria: ¿Por qué el mundo mismo es disperso?
La dispersidad no es solo una propiedad de los datos, sino una propiedad del par "datos y la manera de describirlo". El mundo se vuelve disperso bajo la base apropiada. E la historia de la ciencia es también una historia de buscar esa base. Este capítulo presenta tres tipos de evidencia empírica y una fuente ideológica, y luego especifica los límites.
Filosofía e teoría de la información: intuición y marco, no origen técnico
La Navaja de Occam es un principio filosófico que favorece la simplicidad, no el punto de partida técnico de modelos dispersos. Shannon (1948) cuantificó la "redundancia". La parte de la longitud del código que excede la entropía de la fuente de información es redundancia compresible, y la representación dispersa es esencialmente una base que hace visible esa redundancia. La complejidad de Kolmogórov (años 60) presentó el ideal de "descripción más corta", pero es incomputable. El MDL (Longitud Mínima de Descripción) de Rissanen (1978) lo convirtió en un criterio práctico para selección de modelo. Los modelos dispersos pueden leerse como un caso especial de MDL: longitud de descripción ≈ número de componentes no nulos × costo de codificación por coeficiente. Estas ideas deberían escribirse como "prehistoria intelectual" en lugar de "inventores de modelos dispersos".
Tres tipos de evidencia de la naturaleza
Imágenes naturales. El espectro de potencia de imágenes naturales sigue aproximadamente una ley de potencia de 1/f² e invariancia de escala aproximada (Field 1987; Ruderman & Bialek 1994; revisión en Simoncelli & Olshausen 2001). En bases locales y paso de banda como wavelets, los coeficientes de imágenes naturales tienen cola pesada. La mayoría están cerca de cero, y solo algunos en bordes son grandes. La teoría de aproximación no lineal (DeVore 1998; Donoho 1993) prueba que para señales suaves por partes, el error de la mejor aproximación de n términos en base wavelets decae más rápidamente que en cualquier base lineal fija. Esta es la base teórica tanto de JPEG2000 como de compresión detectada, y el ejemplo de Haar en la Figura 3 es su demostración mínima.
Lenguaje. La frecuencia de palabras sigue la ley de Zipf. Un puñado de palabras constituye la mayoría de apariciones, y la cola es extremadamente larga. Por eso las representaciones bag-of-words y TF-IDF son extremadamente dispersas. La misma estadística explica también por qué la carga en expertos de MoE es intrínsecamente sesgada, y por qué DeepSeek utiliza tablas de búsqueda de N-gramas como memoria condicional (Engram).
Cerebro. Barlow (1961) propuso la hipótesis de reducción de redundancia. El propósito del sistema sensorial es eliminar la redundancia y construir una representación estadísticamente independiente, hipótesis que es la fuente neurobiológica de la codificación dispersa. Attwell & Laughlin (2001) calcularon el balance energético de la materia gris, de lo cual Lennie (2003, Current Biology 13:493–497) estimó que el costo de un spike es tan alto que "el número de neuronas que pueden estar sustancialmente activas simultáneamente está probablemente restringido estrictamente a menos del 1%".
Hay una cosa que definitivamente necesito corregir aquí. La afirmación ampliamente difundida de que "el cerebro solo usa el 1-4% de las neuronas" es una cita de segunda mano. Cuando Glorot, Bordes y Bengio (2011) citaron a Lennie escribieron "1-4%", y desde entonces ese número se ha copiado repetidamente. El texto original de Lennie dice "probablemente menos del 1%", y además es una estimación superior derivada de restricciones energéticas, no una medición. La dispersidad significa "la proporción de disparo fuerte en un momento dado es baja", no "la mayoría del cerebro está ocioso".
Limitaciones y contraejemplos
Disperso no es bajo rango. Disperso significa que hay pocos coeficientes no nulos bajo alguna base o diccionario (medido por L0/L1). Bajo rango significa que los valores singulares de una matriz son pocos (medido por rango o norma nuclear). LoRA y MLA son bajo rango, MoE, atención top-k y SAE son dispersos. La SVD truncada da una matriz de bajo rango, donde solo el espectro de valores singulares es disperso.
El mundo no siempre es escaso.La PCA robusta (Candès, Li, Ma & Wright 2011) descompone los datos en "bajo rango + escaso", mostrando que los datos reales frecuentemente poseen ambas propiedades. En videos, el fondo es bajo rango y el primer plano es escaso. Las señales dominadas por texturas o ruido no son escasas bajo bases comúnmente utilizadas. La superposición de características en el flujo residual de los LLM significa que las representaciones son densas a nivel de neurona individual, volviéndose escasas solo bajo un diccionario sobredeterminado. Este es el punto de partida para la discusión de SAE en la sección "Escasez en interpretabilidad" del capítulo "presente".
Resumen del capítulo.La escasez es una distribución previa refutable, no una verdad universal. Vale la pena apostar por ella precisamente porque ha sido confirmada repetidamente en imágenes naturales, lenguaje y actividad neuronal. Pero antes de apostar, debe plantearse una pregunta inevitable: ¿bajo qué base es escaso?
Detalles de las tres pruebas: ¿por qué estas leyes estadísticas?
¿De dónde viene el espectro 1/f de las imágenes naturales?Hay dos explicaciones complementarias. La primera es la invariancia de escala. Los objetos en escenas naturales varían en tamaño en órdenes de magnitud, y sus estadísticas permanecen invariantes al ampliar o reducir. Matemáticamente, esto obliga a que el espectro de potencia siga una ley de potencia. La segunda es el modelo de oclusión. Las escenas se componen de objetos superpuestos, los bordes generan discontinuidades, y estas aparecen en el dominio de frecuencias como colas de alta frecuencia que decaen lentamente. Ambas explicaciones convergen en la misma conclusión: las imágenes naturales no son "ruido aleatorio" ni "suave en todas partes", sino "regiones amplias y planas + bordes escasos". Esta es precisamente la estructura en la que las wavelets son más efectivas. Field (1987) fue más allá, señalando que si el ancho de banda de los campos receptivos de células simples en la corteza visual se adapta a esta estadística, entonces la respuesta de cada célula a imágenes naturales tendría colas pesadas: poca o nula actividad la mayoría del tiempo, pero ocasionalmente dispara fuertemente. Este es el significado original de "codificación escasa" en neurociencia.
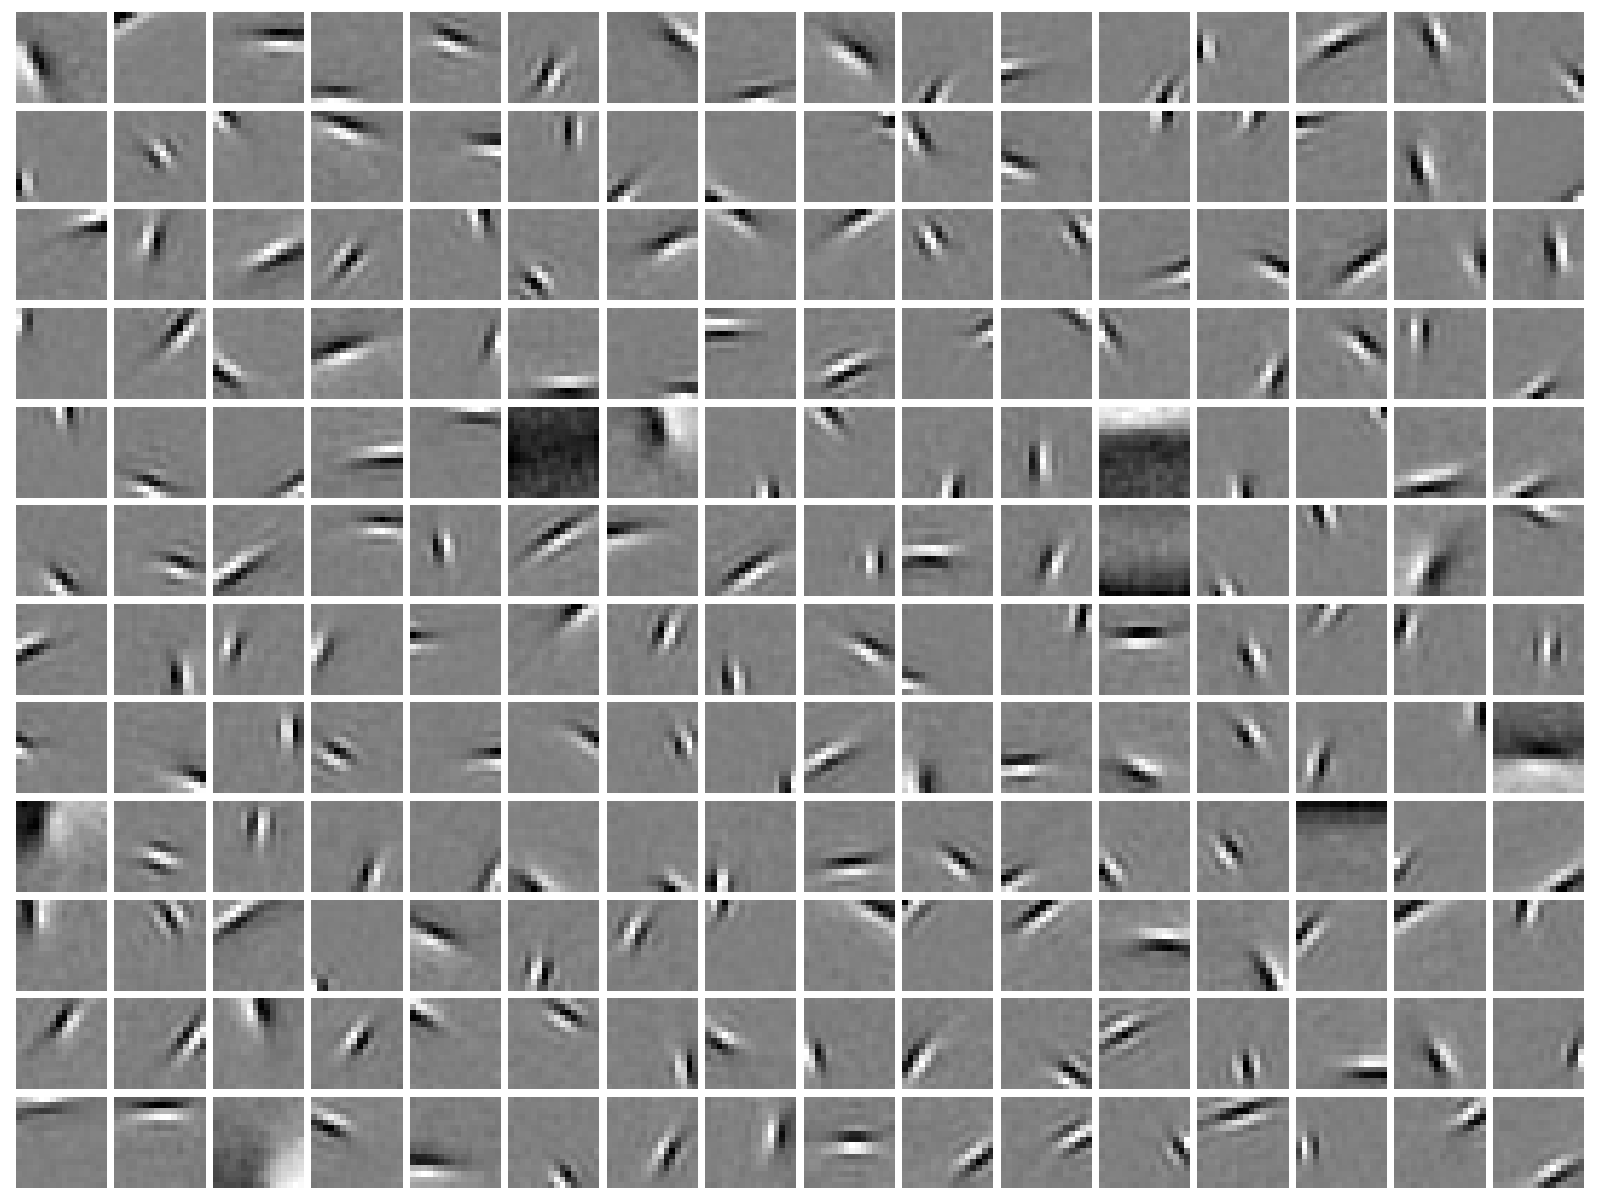
¿Por qué es tan convincente el experimento de Olshausen y Field?El experimento de 1996 impuso solo dos restricciones al algoritmo: reconstruir parches de imágenes naturales con una combinación de funciones base lineales, y mantener los coeficientes lo más escasos posible. Sin conocimiento previo sobre el cerebro. Sin embargo, las funciones base aprendidas resultaron ser locales, selectivas de orientación y bandpasa, sorprendentemente similares a los campos receptivos de células simples V1 en gatos y primates. La fuerza de este resultado radica en su dirección: no fue "algoritmo inspirado en el cerebro", sino "el principio de escasez predijo independientemente la estructura cerebral". Posteriormente, Hromádka, DeWeese, Zador (2008) registraron patrones de disparo altamente escasos en la corteza auditiva de ratas despiertas, y Quian Quiroga et al. (2005) descubrieron "células de concepto" en el hipocampo humano que responden selectivamente a personas específicas o hitos. Ambos se consideran evidencia de la hipótesis de codificación escasa. Existen objeciones. Spanne and Jörntell (2015) argumentan que la codificación escasa estricta no es universal en toda la corteza, y que el grado de escasez depende de la región cerebral y la tarea. Por lo tanto, esto debe escribirse como una "hipótesis ampliamente respaldada" y no como un dogma establecido.
¿Por qué la energía obliga la escasez?El cerebro humano, aunque representa aproximadamente el 2% del peso corporal, consume alrededor del 20% del metabolismo basal en reposo, aproximadamente 20 vatios. Attwell and Laughlin (2001) estimaron que la mayoría de la energía en la sustancia gris se destina a la transmisión sináptica y potenciales de acción. Lennie (2003) razona inversamente: si cada potencial tiene este costo, la corteza no puede permitirse activar una gran proporción de neuronas simultáneamente a alta frecuencia. Este argumento es un "límite superior bajo restricción presupuestaria", arrojando una estimación de "probablemente menos del 1%" en lugar de un valor medido. La importancia radica en la lógica, no en el número específico. En sistemas con energía o ancho de banda limitados, la escasez no es una opción sino una necesidad.La misma lógica reaparece en el capítulo "era de redes neuronales" como el "muro de memoria" en GPU.
La ley de Zipf en lenguaje y la cola larga.Zipf (1935) observó que la frecuencia de palabras es aproximadamente inversamente proporcional a su rango. La segunda palabra más común aparece aproximadamente la mitad de veces que la primera, la décima aproximadamente 1/10 de veces. Mandelbrot posteriormente proporcionó una forma corregida. Una consecuencia directa es que cualquier texto usa solo una pequeña fracción del vocabulario, y la mayoría de palabras aparecen solo una o dos veces. En la era de modelos estadísticos de lenguaje, esto se manifestaba como matrices de frecuencia n-grama extremadamente escasas y el problema de suavizado de "probabilidad cero" (Good–Turing, Kneser–Ney). En la era de modelos grandes reaparece de dos formas. Una es que la carga de enrutamiento en MoE es intrínsecamente sesgada: expertos populares manejan la mayoría de tokens, requiriendo mecanismos de balanceo de carga. La otra es el Engram de DeepSeek. Revive tablas de búsqueda n-gramas en arquitecturas de frontera, canalizando patrones frecuentes por rutas de búsqueda económicas, dejando solo lo que realmente requiere razonamiento para costosas capas Transformer.
Escasez en física e ingeniería
La historia de la escasez es más larga en ingeniería que en aprendizaje automático. En cálculo científico, las matrices de coeficientes en el método de elementos finitos y ecuaciones de flujo de potencia son intrínsecamente escasas. Cada nodo se acopla solo a nodos adyacentes. Tinney and Walker (1967) propusieron un ordenamiento óptimo que reduce "relleno" durante eliminación gaussiana al resolver sistemas de potencia. Este fue el comienzo de métodos directos escasos. Luego Rose (1972) describió el proceso de eliminación en términos de teoría de grafos, Gilbert y otros desarrollaron descomposición LU escasa, y el álgebra lineal escasa se convirtió en un campo. En exploración sísmica, la secuencia de reflectividad subsuperficial se modela como una serie escasa de picos, y el problema de deconvolución se resuelve con regularización L1. Una década antes de la detección comprimida. En procesamiento de señales de radar y arreglos, los objetivos se distribuyen escasamente en el espacio de ángulo, distancia y velocidad, usando reconstrucción escasa para estimación de superresolución.
Lo que estos campos comparten es que patrones de escasez derivan de estructura física (adyacencia, reflexión, cantidad de objetivos), siendo predecibles y aprovechables. Esto es continuo con wavelets en la "era clásica" (donde la estructura proviene de suavidad por partes) y MoE en el "presente" (donde proviene de bloques de expertos), explicando también por qué la escasez de pesos no estructurada fracasa en la "era de redes neuronales": esos ceros carecen de estructura física que el hardware pueda explotar.
Un espejo reflejado en fenómenos sociales, y los límites de esta perspectiva
La ley 80-20 de Pareto, la cola larga de Anderson, y la tradición del análisis factorial de que "pocas variables importantes explican la mayoría de la varianza" son todos espejos de la distribución previa de escasez reflejada en ciencias sociales. Lo que demuestran es que la escasez es una suposición sobre la estructura del mundo, no un teorema. Estadísticos como Gelman han cuestionado "apuesten por la escasez". Argumentan que en muchos problemas de ciencias sociales los efectos verdaderos son densos y pequeños, y métodos escasos los pierden sistemáticamente. La misma crítica aplica a aprendizaje automático. Las características en el flujo residual de LLM se almacenan densamente mediante superposición, y la escasez aparece solo al cambiar a diccionarios sobredeterminados. Por lo tanto, nuestra posición es: la escasez vale la pena como distribución previa inicial porque ha sido confirmada repetidamente en datos naturales masivos. Pero cada vez que apuesten, deben responder "¿bajo qué base es escaso?" y estar preparados para abandonarlo si la evidencia no lo respalda.
Era clásica (1960s–2014): ¿Cómo la escasez se convirtió en una herramienta computacionalmente factible?
Los métodos escasos exitosos en la era clásica comparten un punto común: porque los patrones de escasez eran estructurados y predecibles, pudieron incorporarse en hardware y estándares industriales.Esta es también la premisa de la "derrota" narrada en la "era de redes neuronales". La tabla siguiente organiza hitos según tres preguntas: ¿por qué surgió en ese período?, ¿cuál era el cuello de botella entonces?, ¿qué problema resolvió?
| Hito | ¿Por qué surgió en ese período? | Cuello de botella entonces | ¿Qué problema resolvió? |
|---|---|---|---|
| Métodos directos de matrices escasas (Tinney & Walker 1967) | Redes de potencia a gran escala, memoria en era de KB | Eliminación densa es O(n³), no cabe en memoria | Almacenar solo elementos no nulos, reducir relleno mediante ordenamiento óptimo |
| Wavelets (Daubechies 1988; Mallat 1989) | Bases de Fourier no son escasas para bordes | Energía de bordes dispersa en todo el dominio frecuencial | Señales suave por partes se vuelven escasas en dominio wavelet |
| Matching Pursuit (Mallat & Zhang 1993) | Aparición de diccionarios sobredeterminados | Representación no es única | Selección de átomos por métodos avaros |
| Umbralización wavelet para denoising (Donoho & Johnstone 1994) | Coeficientes escasos, ruido uniforme | Filtros lineales desdibujan hasta bordes | Umbralización suave = operador proximal L1. Casi óptimo minimax |
| Garrote de Breiman 1995 → LASSO (Tibshirani 1996) | Datos de alta dimensión p ≫ n | Mínimos cuadrados mal planteado, selección de subconjuntos inestable | Estimación con contracción y selección de variables simultáneas |
| Basis Pursuit (Chen, Donoho & Saunders 1998) | Optimización convexa madura | L0 es NP-difícil | Relajación convexa mediante L1 |
| Aproximación no lineal (DeVore 1998) | Se necesitaba explicación de optimalidad de "mantener k más grandes" | Aproximación lineal convergía lentamente | Teoría de mejor aproximación por n términos |
| JPEG (1992) / JPEG2000 (2000) | Difusión de imágenes digitales | Ancho de banda y almacenamiento | Transformación escasa + cuantización + codificación entropía |
| LARS (Efron et al. 2004); Elastic Net (Zou & Hastie 2005) | Se necesitaba algoritmo de ruta eficiente para LASSO | Lento de resolver, inestable con variables correlacionadas | Cálculo de toda ruta de regularización de una vez. L1+L2 |
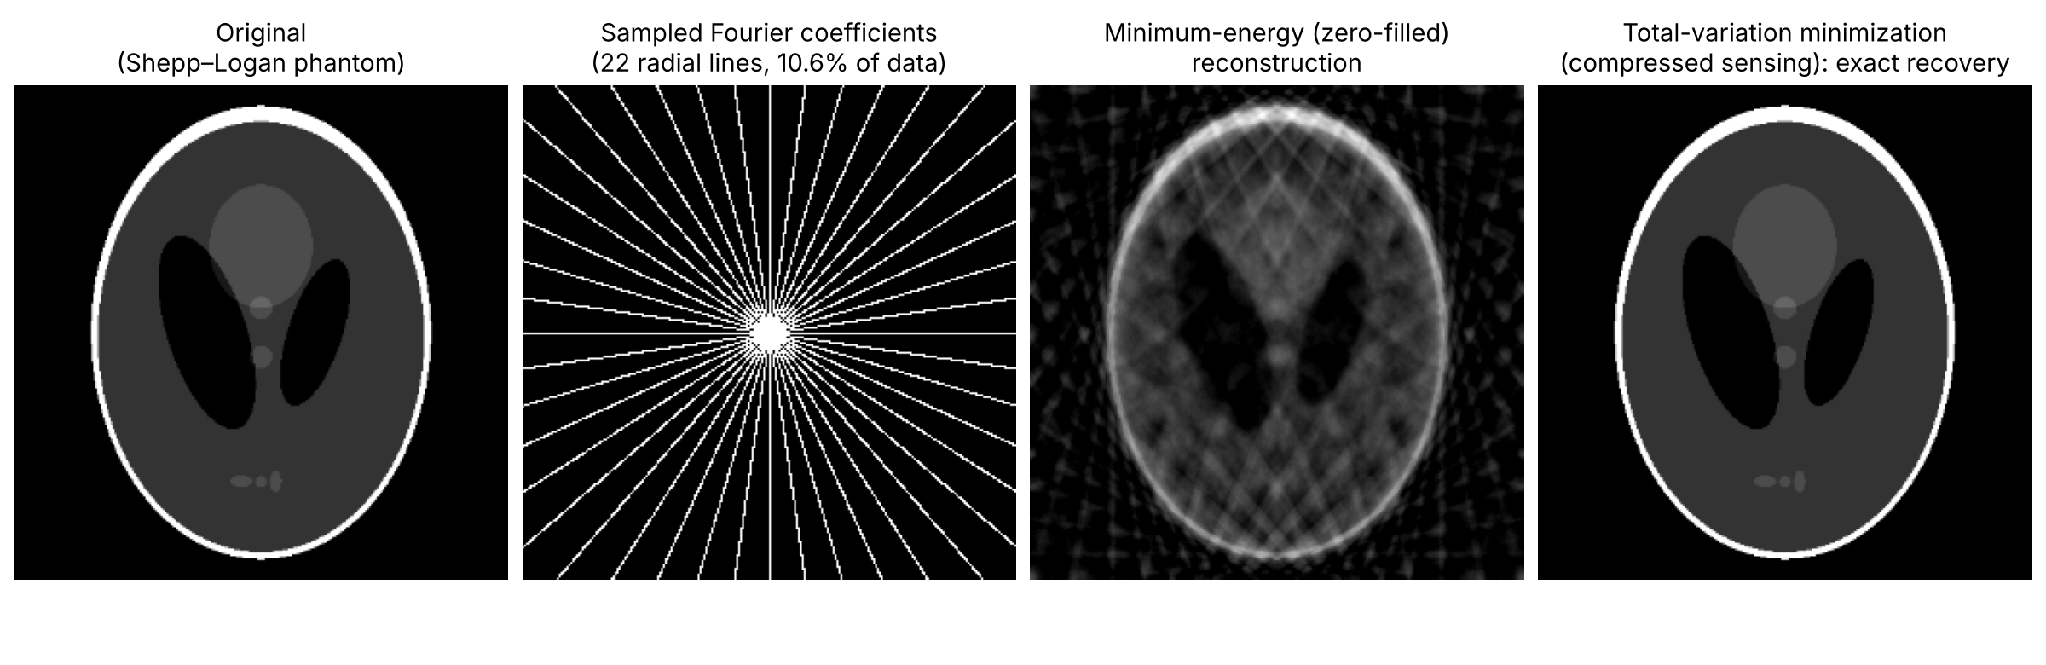
| Detección comprimida (Candès–Romberg–Tao 2006; Donoho 2006) | Teoría de escasez encontró teoría de matrices aleatorias | Muestreo ligado a frecuencia de Nyquist | Bajo condición RIP, recuperación desde m ≳ k·log(n/k) mediciones |
| K-SVD (Aharon, Elad & Bruckstein 2006) | Diccionario aprendible era necesario | Wavelets fijos no se adaptan a datos específicos | Optimización alternada de codificación escasa y actualización de diccionario |
| Transición de fase Donoho–Tanner (2009) | Se necesitaba caracterizar las condiciones para que L1 tuviera éxito | Los límites teóricos eran demasiado laxos | Transición de fase aguda en el plano (m/n, k/m) |
| Codificación dispersa (Olshausen & Field 1996), algoritmos rápidos (Lee, Battle, Raina & Ng 2007) | Respuesta a la hipótesis de Barlow | ¿Por qué los campos receptivos de V1 tienen forma de Gabor? | Los diccionarios dispersos reproducen los campos receptivos de V1 |
| Neurona de cara de gato (Le et al. 2012) | Llegada del aprendizaje distribuido | ¿Emergen características de orden superior de manera no supervisada? | Se describe más adelante |
| Umbral de valor singular duro óptimo (Gavish & Donoho 2014) | Se necesitaba un umbral principista para la reducción de ruido de bajo rango | El rango truncado se elegía por regla empírica | Para matrices cuadradas con σ conocida: (4/√3)√n·σ; con σ desconocida: 2,858 veces la mediana |
El principio de "apostar por la dispersión" en estadística
Hastie, Tibshirani y Friedman enunciaron en The Elements of Statistical Learning el principio de "bet on sparsity" (apostar por la dispersión). Si el modelo verdadero es disperso, L1 puede encontrarlo. Si no es disperso, ninguna técnica funcionará bien. Por lo tanto, apueste por la dispersión. La estadística de alta dimensión ha cuantificado el costo exacto. Para reconstruir un vector k-disperso en dimensión p se necesitan n ≳ k·log p muestras (Wainwright 2009). El resultado correspondiente en detección compresiva es que con m ≳ C·k·log(n/k) mediciones aleatorias, si la constante RIP δ₂ₖ < √2−1 ≈ 0,414, entonces L1 puede reconstruir exactamente (Candès 2008).
Tres casos del mundo real (números verificados)
RM por detección compresiva. Lustig, Donoho y Pauly (2007) sentaron las bases de la RM por detección compresiva. Los números clínicos deben citarse con precisión. Sartoretti et al. (2019, PLoS ONE 14(4): e0214887) reportan que en la práctica clínica diaria se logró una reducción promedio en tiempo de exploración de 20,2%, reducción en tiempo de examen de 16%, reducción en tiempo de adquisición de secuencias aplicables de 23% a 43%, e incremento de 27% en estudios realizados en el mismo período (fuente primaria). Vranic et al. (2019, AJNR 40(1):92–98) reportan aceleración de 25% y 35% en secuencias FLAIR y GRE cerebrales respectivamente. La frecuentemente citada «aceleración de 30%–60%» carece de respaldo en fuentes primarias.
Imágenes de agujeros negros (EHT). Una de las tres tuberías de imágenes que sustentaron la primera imagen de M87* en 2019, SMILI, se encuentra en la línea de modelado disperso (regularización L1+TV) de Honma et al. (2014) y Akiyama et al. (2017). Otra tubería, CHIRP (Bouman et al. 2016), no es detección compresiva pura sino que utiliza priors de parches, por lo que el reportaje de que «un investigador fotografió un agujero negro con detección compresiva» es una simplificación.
Neurona de cara de gato. Le et al. (2012, ICML, arXiv:1112.6209) entrenaron un autocodificador disperso localmente conectado de 9 capas con aproximadamente mil millones de conexiones en 10 millones de fotogramas de YouTube durante «3 días en 1.000 máquinas (16.000 núcleos)». Sin supervisión, emergieron neuronas individuales selectivamente sensibles a caras humanas y caras de gatos, alcanzando 15,8% de precisión en ImageNet aguas abajo, una mejora relativa de 70% sobre el mejor resultado previo. Esta línea de «codificación dispersa → características no supervisadas» decayó después de 2012 bajo la presión de las CNN supervisadas, pero vuelve en 2023 como SAE de Anthropic.
Línea paralela: bajo rango
El SVD truncado (teorema de Eckart–Young–Mirsky) es la mejor aproximación entre todas las matrices de rango ≤ k, y Gavish & Donoho (2014, IEEE T-IT 60(8):5040–5053) proporcionan el umbral duro óptimo para reducción de ruido. Esto es isomórfico estructuralmente con la reducción de ruido por umbral de wavelets. Ambos siguen «cambiar base → aplicar umbral → transformada inversa», siendo la única diferencia que la base wavelet es fija mientras que la base SVD se calcula a partir de los datos. En el primero, la señal permanece dispersa después del umbralado, pero en el segundo la matriz truncada es de bajo rango pero densa. Esta línea vuelve en el capítulo «presente» en forma de MLA y LoRA en modelos de gran escala.
Paso a paso: por qué cada avance ocurrió en su época
De Fourier a wavelets (años 1980). La base de Fourier descompone las señales en ondas sinusoidales globales. Es eficiente para señales estacionarias, pero tremendamente ineficiente para bordes y transitorios. Representar un único paso requiere infinitas componentes de frecuencia, con energía dispersada en todo el espectro de frecuencias. La ingeniería ya disponía de soluciones como la transformada de Gabor y la transformada de Fourier de tiempo corto, pero faltaba un marco matemático unificado. Cuando Mallat (1989) formuló el análisis multirresolución y Daubechies (1988) construyó wavelets ortogonales con soporte compacto, se lograron simultáneamente localidad, estructura multiescala y ortogonalidad. Cada función base wavelet es cero solo fuera de un rango finito, repitiéndose en todas las escalas. Por lo tanto, una señal suave por segmentos produce grandes coeficientes solo en las posiciones de bordes y pocos escalas, siendo casi cero en el resto. DeVore (1998) y Donoho (1993) probaron que esto no es accidental empíricamente. Para la clase de funciones suaves por segmentos, ninguna base lineal fija puede igualar la tasa de decaimiento del error en la mejor aproximación no lineal n-término en base wavelet. JPEG2000 (2000) llevó esta teoría a un estándar, reemplazando la DCT de JPEG con wavelets y reduciendo significativamente el ruido de bloques en la misma velocidad de bits.
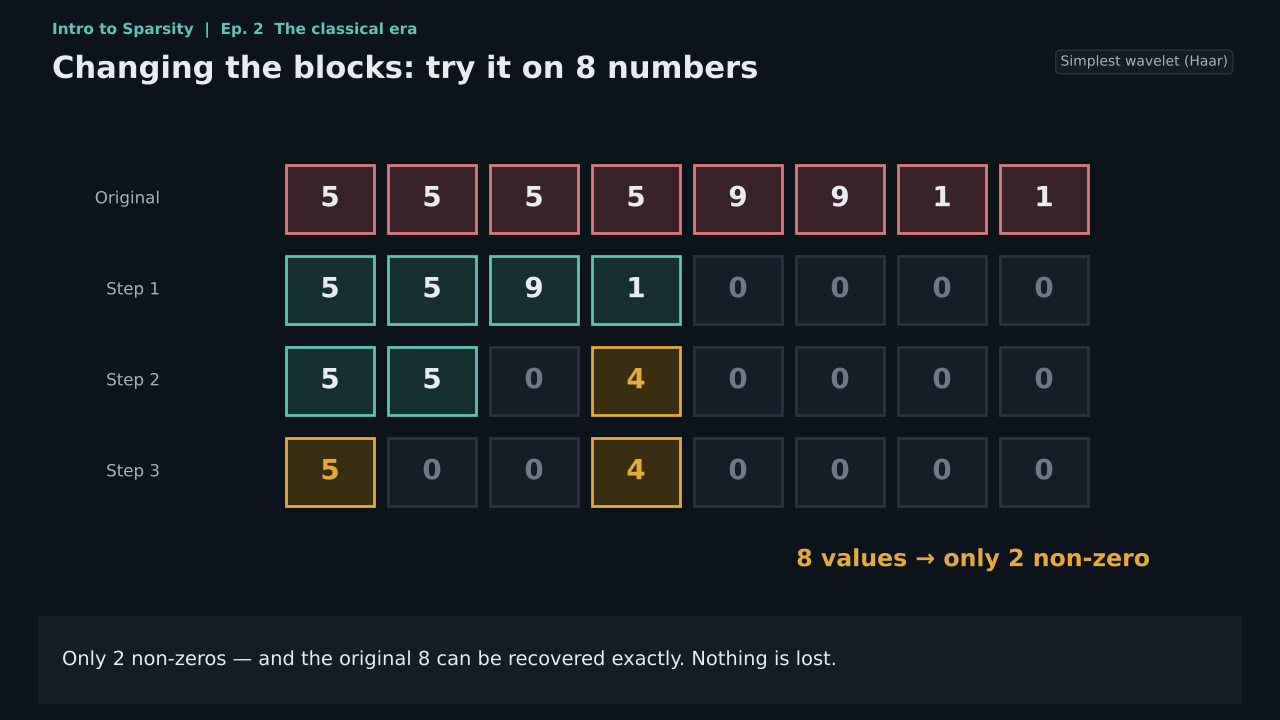
De mínimos cuadrados a LASSO (años 1990). La estadística enfrentaba un tipo diferente de dispersión. No si los coeficientes son dispersos en alguna base, sino «qué variables explicativas son realmente importantes». El enfoque clásico era la selección de subconjuntos (regresión paso a paso, AIC/BIC), pero requería búsqueda combinatoria e era extremadamente inestable ante perturbaciones menores en los datos. Breiman (1995) propuso el garote no negativo, replanteando la selección de variables como un problema continuo de encoger. Inspirado por esto, Tibshirani (1996) propone LASSO, es decir, mínimos cuadrados con penalización L1. El comportamiento de L1 es determinado por su geometría. La región de restricción es un rombo con esquinas, por lo que la solución óptima tiende a caer en una esquina, donde cada esquina corresponde a un punto donde algunos coeficientes son exactamente cero. Este es el mecanismo por el cual «la contracción y la selección ocurren simultáneamente». El cuello de botella algorítmico de LASSO fue eliminado en 2004 por LARS (Efron, Hastie, Johnstone, Tibshirani), permitiendo calcular la trayectoria de regularización completa de una vez. En 2005, Elastic Net de Zou y Hastie agregó L1+L2 para manejar grupos de variables fuertemente correlacionadas. La estadística de alta dimensión proporciona garantías teóricas. Wainwright (2009) probó que n ≳ k·log p muestras son suficientes para reconstruir k coeficientes distintos de cero en dimensión p, y Bickel, Ritov y Tsybakov (2009) establecieron desigualdades de oráculo para LASSO y el selector de Dantzig.
Descubrimiento independiente en procesamiento de señales (1993–1998). Casi simultáneamente, el procesamiento de señales llegó al mismo L1 partiendo de «diccionarios supercompletos». Matching Pursuit (Mallat y Zhang 1993) selecciona átomos codiciosos más correlacionados con el residuo, mientras que Basis Pursuit (Chen, Donoho y Saunders 1998) relaja el problema NP-duro L0 de «encontrar la representación más dispersa» a un programa lineal L1. LASSO y Basis Pursuit son matemáticamente dos parametrizaciones del mismo problema, pero surgieron de dos comunidades con poco contacto mutuo. Esta es la primera instancia en la que la idea de dispersión «converge desde múltiples fuentes».
Reducción de ruido: el momento en que la dispersión generó valor directo por primera vez (1994). La reducción de ruido por umbral wavelet de Donoho y Johnstone convirtió la teoría anterior en un procedimiento de 3 pasos. Transformar a dominio wavelet con una transformada ortogonal. Aplicar umbralado suave con umbral λ=σ√(2 log n) mediante S_λ(w)=sign(w)·max(|w|−λ,0) a los coeficientes. Transformar inversamente de vuelta al dominio de señal. La clave por la cual esto funciona es que la transformada ortogonal conserva las propiedades estadísticas del ruido blanco. En el dominio wavelet, el ruido sigue siendo ruido gaussiano independiente de igual varianza dispersado uniformemente en todos los coeficientes, mientras que la energía de la señal se concentra en pocas magnitudes grandes, por lo que basta descartar coeficientes pequeños. El operador de umbralado suave es precisamente el operador proximal de la penalización L1, y por eso la reducción de ruido, LASSO, luego ISTA/FISTA (Beck y Teboulle 2009), y LISTA (Gregor y LeCun 2010, punto de partida de la expansión de algoritmos), comparten todos el mismo cálculo central.
Sensado comprimido: transformando la escasez de "medir poco y obtener mucho" (2004–2009). Hasta ahora, todos los métodos buscaban representaciones escasas asumiendo que contaban con datos completos. Candès, Romberg, Tao (2006) y Donoho (2006) plantean la pregunta inversa: si sabemos que una señal es k-escasa bajo cierta base, ¿cuántas mediciones se necesitan para su reconstrucción exacta? La respuesta es m ≳ C·k·log(n/k) mediciones lineales aleatorias, muy por debajo de la tasa de Nyquist. La condición es que la matriz de medición cumpla la propiedad de isometría restringida (RIP), es decir, que preserve aproximadamente la longitud de todos los vectores 2k-escasos. Candès (2008) proporciona la condición suficiente δ₂ₖ < √2−1 ≈ 0.414, y Donoho y Tanner (2009) caracterizan la transición de fase abrupta entre el éxito y el fracaso de la reconstrucción L1 usando geometría combinatoria. El significado histórico del sensado comprimido es que elevó la escasez de una "propiedad de representación" a un "principio de muestreo", cambiando directamente el diseño del hardware de imagen. Lustig, Donoho, Pauly (2007) lo llevaron a MRI, reduciendo el tiempo de escaneo a cambio de trayectorias de submuestreo aleatorio. Duarte et al. (2008) crearon una cámara de píxel único, y en radioastronomía, la canalización SMILI utilizó regularización L1 y variación total para la imagen de agujeros negros del EHT.
Aprendizaje de diccionario y codificación escasa: de bases fijas a bases aprendidas (1996–2012). Las wavelets son una base fija diseñada por humanos, no necesariamente óptima para datos específicos. Olshausen and Field (1996) aprendieron un diccionario a partir de datos, reproduciendo campos receptivos de V1. K-SVD (Aharon, Elad, y Bruckstein 2006) proporcionó un algoritmo práctico que alterna entre codificación escasa y actualización SVD por átomo. Lee, Battle, Raina, Ng (2007) aceleraron la codificación escasa L1, avanzando en "self-taught learning". Le et al. (2012) apilaron autocodificadores escasos hasta 9 capas y 1,000 millones de conexiones, aprendiendo sin supervisión neuronas selectivas para caras de gatos a partir de 10 millones de fotogramas de YouTube. Después de AlexNet en 2012, esta genealogía se ocultó durante 10 años a la sombra de las redes convolucionales supervisadas, pero dejó dos legados: el marco de representación "diccionario supercompleto + coeficientes escasos" y la convicción de que "el diccionario puede aprenderse a partir de datos". Cuando Anthropic descodificó características internas de grandes modelos con autocodificadores escasos en 2023, citó precisamente a Olshausen y Field, y uno de los coautores de los trabajos relacionados era el propio Olshausen.
Bajo rango: el gemelo de la escasez (1936–2014). Eckart y Young (1936) demostraron que el truncamiento SVD es la mejor aproximación de bajo rango de una matriz. Bajo rango y escasez son isomorfos estructuralmente. Ambos "concentran energía en unos pocos componentes y descartan la cola", pero actúan sobre objetos diferentes: la escasez corta coordenadas, mientras que el bajo rango corta direcciones. Gavish y Donoho (2014) proporcionaron el umbral duro óptimo para la eliminación de ruido de bajo rango, resonando con el umbral universal de eliminación de ruido con wavelets. PCA robusto (Candès et al. 2011) combina ambos: Datos = bajo rango + escasez. Esta distinción se vuelve decisivamente importante en el capítulo "presente". La MLA de DeepSeek es compresión de bajo rango, mientras que DSA y CSA2 son atención escasa. A menudo se confunden.
Resumen: tres legados que la era clásica dejó al aprendizaje profundo
Primero, encontrar la base correcta es más importante que procesar datos. La misma imagen es densa en base de píxeles y escasa en base de wavelets. La diferencia está enteramente en cómo se describe. Segundo, solo hay tres operaciones que crean ceros: umbral suave (L1), umbral duro (L0) y conservar los k mayores (proyección a bola L0). Tercero, solo la escasez estructurada llega al hardware y los estándares. La estructura de árbol de wavelets entró en JPEG2000, y el submuestreo aleatorio en productos MRI. Los tres legados reaparecen de nuevo, con nuevo atuendo, en la "era de las redes neuronales" y en el "presente".
Era de las redes neuronales (1990–2022): frustración y punto de inflexión de la escasez
La escasez no fue derrotada. La escasez inadecuada para hardware fue derrotada. La poda de pesos no estructurada triunfó en teoría y fracasó en GPU. MoE hizo que la unidad de dispersión fuera un bloque de experto completo, manteniendo multiplicaciones matriciales densas en el interior de cada experto, ganando así la lotería del hardware. Este capítulo explica por qué.
Genealogía de la poda y el "muro de escasez"
OBD (LeCun, Denker & Solla 1990) estima la importancia de cada peso a partir de información de segundo orden; OBS (Hassibi & Stork 1993) lo refinó con la matriz hessiana completa. Deep Compression (Han, Mao & Dally 2016) combinó poda, cuantización y codificación de Huffman, comprimiendo AlexNet de 240 MB a 6.9 MB. La hipótesis de la lotería (Frankle & Carbin 2019) muestra que una red densa contiene una subred escasa que, entrenada sola, alcanza la misma precisión. SparseGPT (Frantar & Alistarh 2023) y Wanda (Sun et al. 2023) demostraron que modelos de clase GPT pueden hacerse escasos al 50% en un solo paso sin perder mucha precisión.
Pero con la era de los LLM, esta genealogía choca con una pared. El artículo ELSA de octubre de 2025 (arXiv:2510.01650) la llama el "muro de escasez". Los métodos existentes "parecen no poder superar el 50–60% de escasez sin perder mucha precisión". ELSA afirma que con ADMM se puede podar LLaMA-2-7B hasta casi el 90%, pero esa afirmación aún está siendo debatida.
Escasez de activación: los números reales de ReLU
Glorot, Bordes, Bengio (2011, AISTATS) es la fuente primaria sobre escasez de activación, y esos números merecen ser citados con precisión. Inmediatamente después de la inicialización uniforme, aproximadamente el 50% de las unidades ocultas emiten ceros exactos. La tasa de escasez exacta promedio después del entrenamiento es 83.4% en MNIST, 72.0% en CIFAR10, 68.0% en NISTP, 73.8% en NORB. La conclusión es que "la tasa de escasez de modelos que generalizan mejor está entre el 50% y el 80%", y puede forzarse escasez de hasta aproximadamente el 85% sin dañar el desempeño. La afirmación "ReLU es 90% escaso" carece de respaldo en las fuentes primarias.
Mientras tanto, hagamos una distinción. Dropout es regularización aleatoria aplicada durante el entrenamiento; durante la inferencia, la red vuelve a ser densa. La poda elimina permanentemente pesos. Ambos pueden escribirse como "aplicación de máscara", pero la aleatoriedad de la máscara, la etapa de actuación y el propósito son completamente diferentes.
Por qué la escasez de pesos no estructurada fue derrotada en la era de GPU
La lotería del hardware. Según la definición de Hooker (The Hardware Lottery, 2020/2021), una idea de investigación gana no porque sea buena, sino porque se adapta al software y hardware disponibles. GPU y TPU se diseñaron para multiplicaciones matriciales densas y continuas. La escasez no estructurada introduce gather/scatter, rompe el flujo de datos en mosaico de GEMM, reduce la reutilización de caché en chip y, generalmente, no puede usar núcleos tensoriales. Empíricamente, librerías como cuSPARSE muestran aceleración clara solo cuando la tasa de escasez supera aproximadamente el 90%; con escasez no estructurada del 50%, casi no existen kernels predefinidos en GPU que superen GEMM denso.
Escasez estructurada 2:4. Las GPU desde Ampere en adelante soportan el patrón donde exactamente 2 de cada 4 pesos son cero, y si se cumple el patrón, el rendimiento teórico se duplica. Pero la tasa de escasez está limitada al 50%, la recuperación de precisión requiere reentrenamiento o ajuste fino, y es raro que la aceleración de extremo a extremo se acerque al doble, por lo que en despliegues de LLM nunca se popularizó como la cuantización.
Por qué ganó la cuantización. La cuantización reduce bits por parámetro, pero no toca la regularidad de la matriz, por lo que cualquier GPU se beneficia naturalmente. Después de GPTQ (2022) y AWQ (2023), MXFP4 se convirtió en formato nativo en 2025–2026. gpt-oss almacena pesos MoE (más del 90% de todos los parámetros) en MXFP4 (aproximadamente 4.25 bits por parámetro), permitiendo caber un modelo de 120b en una sola GPU de 80 GB. Kimi K3 realiza aprendizaje consciente de cuantización (QAT) con pesos MXFP4 y activaciones MXFP8, y los parámetros expertos de DeepSeek-V4 utilizan FP4.
El muro de memoria. De V100 a B200, el aumento en rendimiento de cálculo pico supera enormemente el aumento en ancho de banda de memoria (números de magnitud basados en especificaciones publicadas del fabricante).
| GPU | Rendimiento de cálculo BF16/FP16 denso | Ancho de banda HBM | Operaciones aproximadas por byte |
|---|---|---|---|
| V100 (2017) | Aproximadamente 125 TFLOPS | 0.9 TB/s | 140 |
| A100 (2020) | Aproximadamente 312 TFLOPS | 1.6–2.0 TB/s | 155–195 |
| H100 SXM (2022) | Aproximadamente 989 TFLOPS | 3.35 TB/s | 295 |
| B200 (2024) | Aproximadamente 2.2 PFLOPS (aproximadamente 9 PFLOPS en FP4) | Aproximadamente 8 TB/s | 280 (aproximadamente 1,100 en FP4) |
Durante la decodificación, cada vez que se genera un token, hay que transferir desde la memoria GPU los pesos involucrados en el cálculo. Con un tamaño de lote pequeño, las unidades de cálculo están casi ociosas y el cuello de botella es el ancho de banda. Por eso "reducir los parámetros y KV a leer" es más valioso que "reducir FLOPs". MoE reduce el número de bytes de pesos leídos por token, mientras que la atención dispersa y la compresión de KV reducen el número de bytes del caché. Ambos están exactamente eliminando el gasto más costoso.
Genealogía de la computación condicional (punto de inflexión)
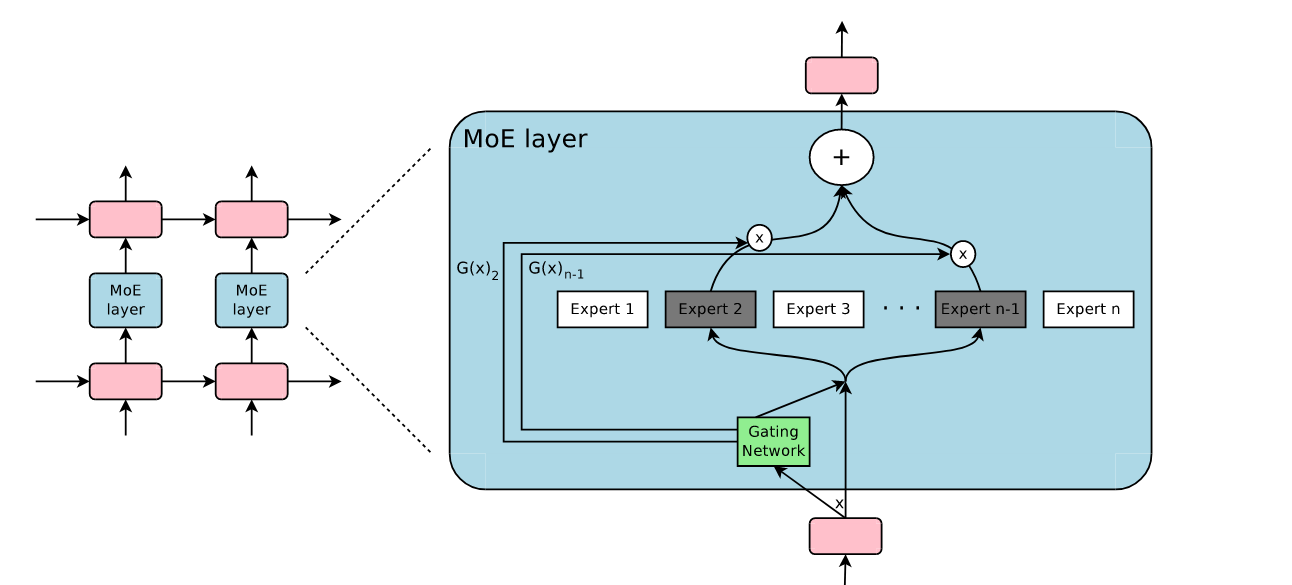
1991 Adaptive Mixtures of Local Experts de Jacobs, Jordan, Nowlan e Hinton. Entrenan múltiples redes de expertos junto con una red de compuerta, con la motivación inicial de reducir la interferencia entre tareas. En 1994, Jordan & Jacobs lo extendieron a MoE jerárquico.
2013 Bengio et al. proponen computación condicional y estimación de gradientes a través de neuronas estocásticas (STE). Eigen, Ranzato y Sutskever experimentaron tempranamente con MoE en redes profundas.
2017 Outrageously Large Neural Networks de Shazeer et al. (con coautores Hinton y Dean). Insertaron capas MoE con compuerta dispersa de hasta 137B de parámetros entre capas LSTM, "mejorando la capacidad del modelo en más de 1000 veces con una pérdida leve en la eficiencia computacional". Noten que el texto original dice "greater than 1000x" y que 137B se refiere al número de parámetros de la capa MoE.
2020-2022 GShard llevó MoE a Transformer y la escaló más allá de 600B, Switch Transformer (Fedus, Zoph & Shazeer 2021) alcanzó 1 billón de parámetros con enrutamiento top-1. GLaM y ST-MoE abordaron problemas de estabilidad (router z-loss), y Expert Choice (2022) invirtió el método, permitiendo que los expertos elijan tokens para equilibrar naturalmente la carga.
Si resumiéramos este apartado en una frase: desde 1991 hasta 2022, la idea de computación condicional no cambió. Lo que cambió fue el hardware y que finalmente llegó una escala para aprovecharlo.
MoE: de los artículos a los productos. Problemas de ingeniería resueltos entre 2017 y 2022
Shazeer et al. (2017) demostraron que se podía expandir la capacidad 1000 veces, pero convertir MoE en un producto confiable requirió cinco años más y resolver cuatro problemas concretos.
Cómo aprender a enrutar. La compuerta genera s = Softmax(W_g·h), se eligen los k expertos principales, y la salida de la capa es y = h + Σ_{i∈T} s_i·FFN_i(h). El problema es que top-k es una selección discreta, por lo que la derivada respecto a s es casi cero en todas partes. El gradiente solo llega a los pesos de compuerta de los expertos seleccionados, y los expertos no seleccionados nunca aprenden. La solución de Shazeer fue compuerta top-k ruidosa: agregan ruido gaussiano aprendible a los logits, lo que permite que el experto que hubiera quedado en k+1 a veces sea seleccionado. Una solución más general es el estimador de paso directo (STE) de Bengio et al. (2013) y posteriormente Gumbel-Softmax.
Cómo equilibrar la carga. Los enrutadores tienen la tendencia de "rich-get-richer" (el que tiene, consigue más). Los expertos populares son seleccionados con más frecuencia, se entrenan mejor y se vuelven aún más seleccionables, hasta que pocos expertos absorben todo el tráfico y el modelo degenera en un modelo efectivamente más pequeño (colapso de expertos). GShard y Switch Transformer introdujeron una pérdida de equilibrio auxiliar L_bal = α·N·Σ f_i·P_i, donde f_i es la fracción de tokens asignados al experto i y P_i es su probabilidad de compuerta promedio. ST-MoE (2022) agregó además router z-loss para contener la explosión de logits. Estas pérdidas auxiliares funcionan, pero perturban el gradiente del objetivo de modelado de lenguaje original. En 2024, DeepSeek-V3 evitó este tradeoff con "sesgo fuera del gradiente" (ver la sección "Presente").
Cómo configurar la capacidad. En el aprendizaje distribuido, se debe fijar de antemano el tamaño del búfer para cada experto, aquí aparece el factor de capacidad. Capacidad por experto = factor_capacidad × (número de tokens / N). Los tokens que exceden la capacidad se descartan (token dropping) y solo pasan por la conexión residual. Un factor de capacidad grande desperdicia memoria, uno pequeño degrada la calidad. MegaBlocks (2023) construyó MoE "sin descarte" con multiplicación de matrices dispersa en bloques, escapando de este dilema.
Cómo sobrevivir la comunicación. Los expertos se colocan en GPU separadas (paralelismo de expertos), y cada capa MoE requiere dos intercambios all-to-all dependientes de datos. Los tokens se envían a las GPU donde residen los expertos, y se recogen los resultados. Este es el principal cuello de botella de comunicación en el entrenamiento de MoE y la razón por la que MoE es adecuada para despliegues grandes y centralizados. Desde DeepSpeed-MoE y Tutel hasta Deep EP de DeepSeek, todos estos sistemas optimizan esta ruta.
Hitos: GShard (2020) llevó MoE a Transformer más allá de 600B. Switch Transformer (2021) alcanzó 1 billón de parámetros con enrutamiento top-1, preentrenándose 4 veces más rápido que T5-XXL. GLaM (2021) tenía 1.2T de parámetros totales con aproximadamente 97B activados, consumiendo alrededor de un tercio de la energía de GPT-3. Expert Choice (2022) invirtió la dirección, dejando que los expertos elijan tokens para equilibrar naturalmente la carga.
Por qué MoE anterior a 2022 aún no era mainstream
Aunque todas estas soluciones de ingeniería estaban presentes, MoE en 2022 seguía siendo un "juguete de grandes empresas" dentro de Google. Hay tres razones. Primero, la presión de costos aún no era lo suficientemente fuerte. En la era de GPT-3, los modelos densos aún progresaban rápidamente y el costo de inferencia no era la principal restricción. Segundo, no había un ecosistema abierto. No existían MoE de pesos abiertos de alta calidad, así que la comunidad no podía reproducir ni mejorar. Tercero, el ajuste fino era difícil. En conjuntos de datos pequeños, el enrutamiento tendía a colapsar, y la adaptación a tareas posteriores no era tan suave como con modelos densos.
Estas tres condiciones cambiaron todas a la vez a finales de 2023. Mixtral 8x7B (diciembre de 2023) se convirtió en el primer MoE de peso abierto de alta calidad, el tráfico a escala ChatGPT hizo que el costo de inferencia fuera el problema más urgente, y DeepSeekMoE (enero de 2024) elevó la eficiencia de costos de MoE a un nuevo nivel con expertos granulares y expertos compartidos. Aquí comienza el "Presente".
Resumen
Las tres genealogías de este capítulo—poda, dispersión de activación y computación condicional—siguieron destinos completamente diferentes antes de 2022. La poda tuvo éxito en teoría y fracasó en hardware. La dispersión de activación (ReLU) se usaba en todas partes pero casi nunca se aprovechaba. La computación condicional tenía todo, solo le faltaba la presión económica. Si comprendemos esta diferencia de destinos, veremos por qué el ganador después de 2023 fue MoE y no poda de pesos. Si la dispersión puede implementarse en la práctica depende de si sus ceros tienen una estructura que el hardware puede utilizar.
Presente (2023-septiembre de 2026): Por qué los LLM apostaron completamente por la dispersión
Para 2026, la tasa de activación por token en los modelos abiertos de vanguardia caerá a 1.5%-4.5%, y la dispersión se extenderá desde FFN a atención, caché de KV, e incluso al almacenamiento del conocimiento en sí. Este capítulo comienza presentando cuatro presiones, luego enumera cinco tipos de dispersión, y finalmente avanza hacia una teoría unificada y consideraciones económicas.
Por qué ahora: 4 presiones
El escalado chocó contra la pared del costo. Los parámetros totales han alcanzado el rango de 1-3T (DeepSeek-V4-Pro con 1.6T, Kimi K3 con 2.8T), y el entrenamiento e inferencia con modelos densos ya no es económicamente viable.
El costo de inferencia superó al costo de entrenamiento. En el resumen de sistemas de inferencia del 1 de marzo de 2025, DeepSeek reveló que agrandaban los lotes mediante paralelismo masivo de expertos entre nodos y mejoraban la eficiencia de GEMM. Esto demuestra que la economía de la inferencia se ha convertido en la restricción única más importante en el diseño de arquitectura.
Los agentes hicieron que la carga de trabajo fuera "centrada en la entrada". El informe técnico de V4.1 comienza señalando que con la proliferación de agentes de larga duración, la carga de trabajo es cada vez más dominada por la entrada, y los gigantescos cachés de KV siguen comprimiendo la capacidad y ancho de banda de HBM y SSD.
Ingenio de ingeniería bajo restricciones de exportación. DeepSeek-V3 se entrenó con 2,048 H800, acumulando aproximadamente 2.788 millones de horas GPU. El H800 es el mismo chip que el H100 pero con ancho de banda NVLink reducido de 900 GB/s a 400 GB/s, lo que generó directamente optimizaciones de comunicación como Deep EP.
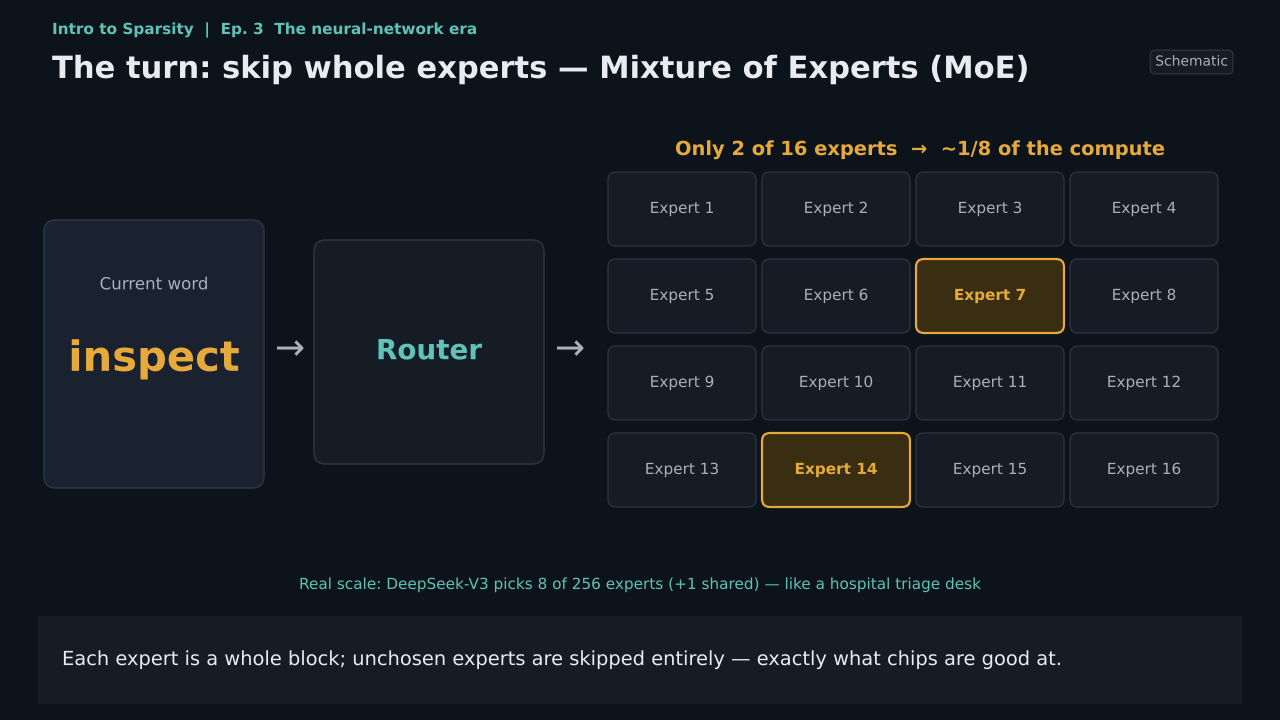
Computación condicional: MoE se convierte en arquitectura predeterminada
Evolución de la familia DeepSeek(todas de reportes técnicos oficiales, tarjetas de modelos y anuncios de API):
| Modelo | Período | Parámetros totales / Activación por token | Composición de expertos | Principales técnicas de dispersión |
|---|---|---|---|---|
| DeepSeekMoE | 2024-01 | — | Expertos de grano fino + expertos compartidos | Dividir expertos en partes más pequeñas, aumentar exponencialmente el número de combinaciones |
| V2 | 2024-05 | 236B / 21B | Compartidos 2 + Enrutamiento 160 | MLA: Compresión simultanea de rango bajo de KV (bajo rango, no disperso) |
| V3 | 2024-12 | 671B / 37B | Compartidos 1 + Enrutamiento 256, 8 selecciones | Balanceo de carga sin pérdida auxiliar, predicción multitokén, entrenamiento FP8 |
| V3.2 | 2025-09/12 | 671B / 37B | Igual que arriba | DSA: Lightning Indexer + atención dispersa top-k por token (k=2048) |
| V4-Flash / V4-Pro | 2026-04-24 | 284B/13B、1.6T/49B | Compartidos 1 + Enrutamiento 256, 6 selecciones / Enrutamiento 384 | Disposición alternada de Compressed Sparse Attention (CSA) y HCA, contexto de 1M, expertos FP4 |
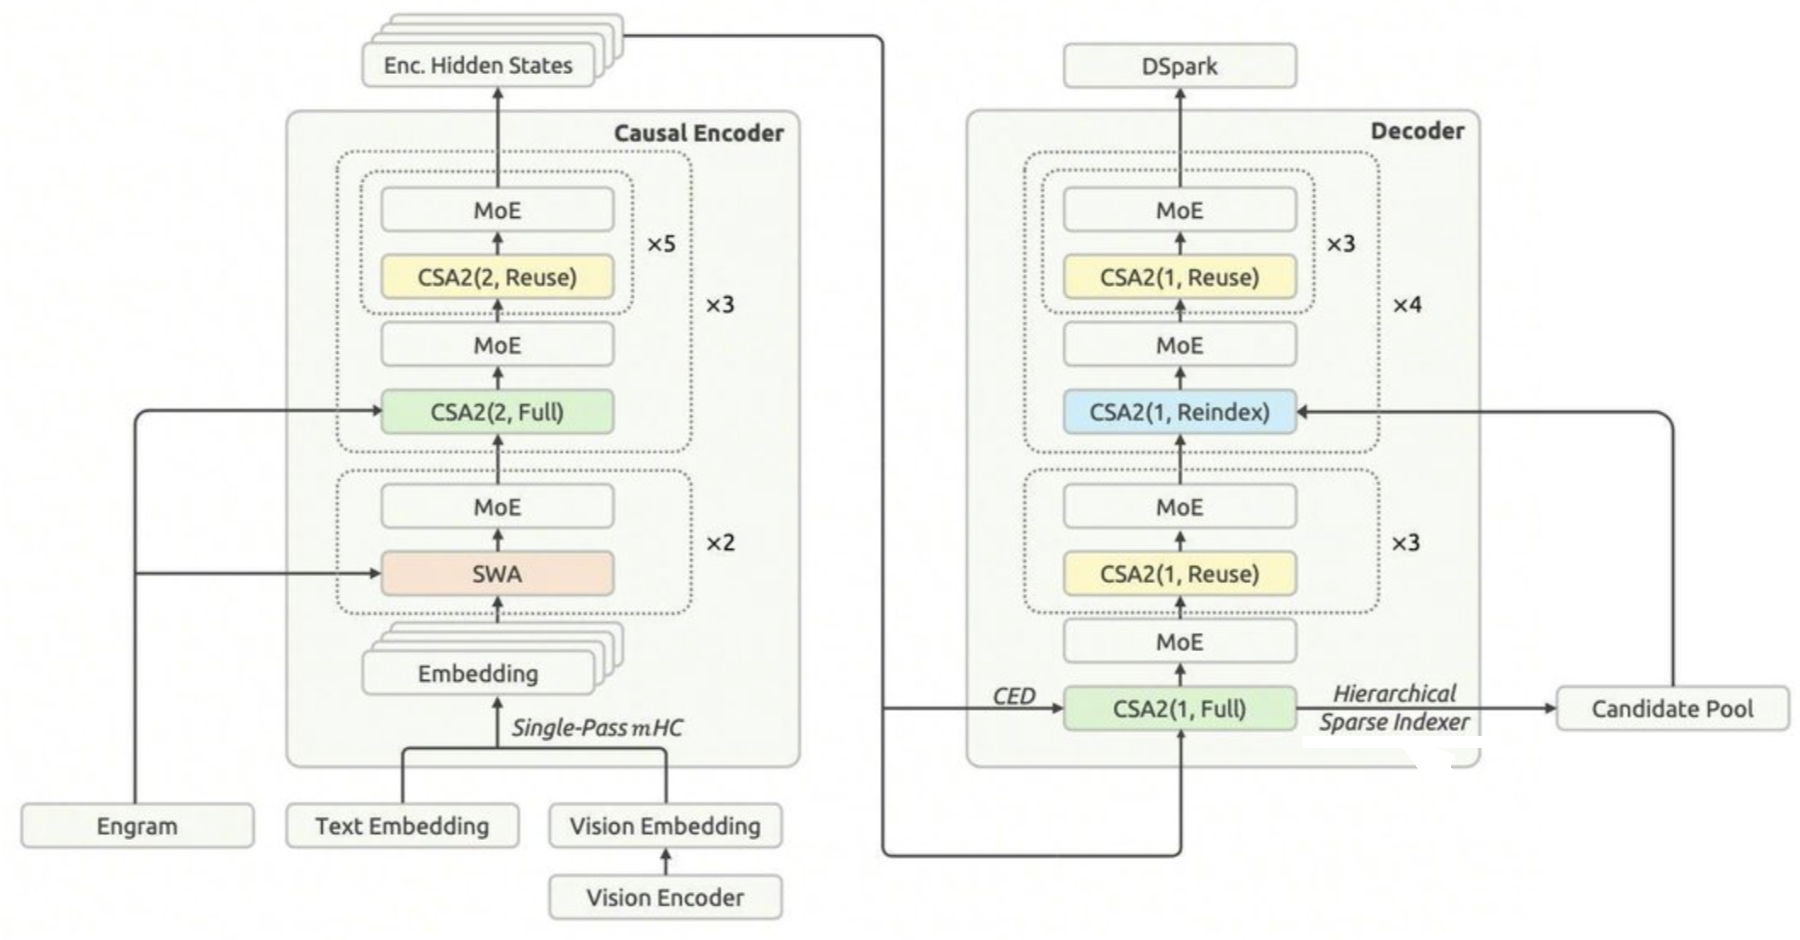
| V4.1-Flash | 2026-09-10 | Backbone 552B + Engram 196B, prefill 8B / decodificación 16B | Compartidos 1 + Enrutamiento 384, 6 selecciones | CED、CSA2、Hierarchical Sparse Indexer、FP4 KV、Engram |
Cinco elementos de diseño de V4.1-Flash(reporte técnico):
CED (Codificador–Decodificador Causal). Se dividen 40 capas en 20 capas de codificador y 20 de decodificador; el KV global del decodificador se proyecta desde el estado oculto final del codificador. Los tokens de entrada pasan solo por el codificador (8B de activación), los tokens de salida por el decodificador (16B). Es la respuesta directa al hecho de que «el agente lee mucho, escribe poco».
Tres modos de CSA2. Full genera su propio KV global y construye el índice. Reindex reutiliza el KV de la capa anterior mientras recalcula top-k. Reuse reutiliza directamente el índice de top-k. La mayoría de las capas son Reuse, es decir, «no vuelven a seleccionar tokens».
Hierarchical Sparse Indexer. La primera capa Full del decodificador crea un conjunto de candidatos; las capas posteriores seleccionan solo de ese conjunto. El costo de cálculo del índice en capas profundas se desvincula de la longitud del contexto.
Cifras de KV. El KV global ocupa 890 bytes por token, aproximadamente 1/4 del V4-Flash, 1/437 del V1. El KV persistente es aproximadamente 1/8 del V4-Flash. Al expandir el contexto de 4K a 1M (256 veces), los FLOPs de decodificación por token aumentan solo aproximadamente 1/4. La atención dispersa se entrenó desde el inicio en 64K, sin precalentamiento con atención densa.
Memoria condicional Engram. Una tabla hash n-gramas de aproximadamente 196B parámetros, a la que se accede de forma dispersa mediante búsqueda por token, y puede colocarse en memoria del host para ser prefetched. No todos los tokens activan todos los parámetros.
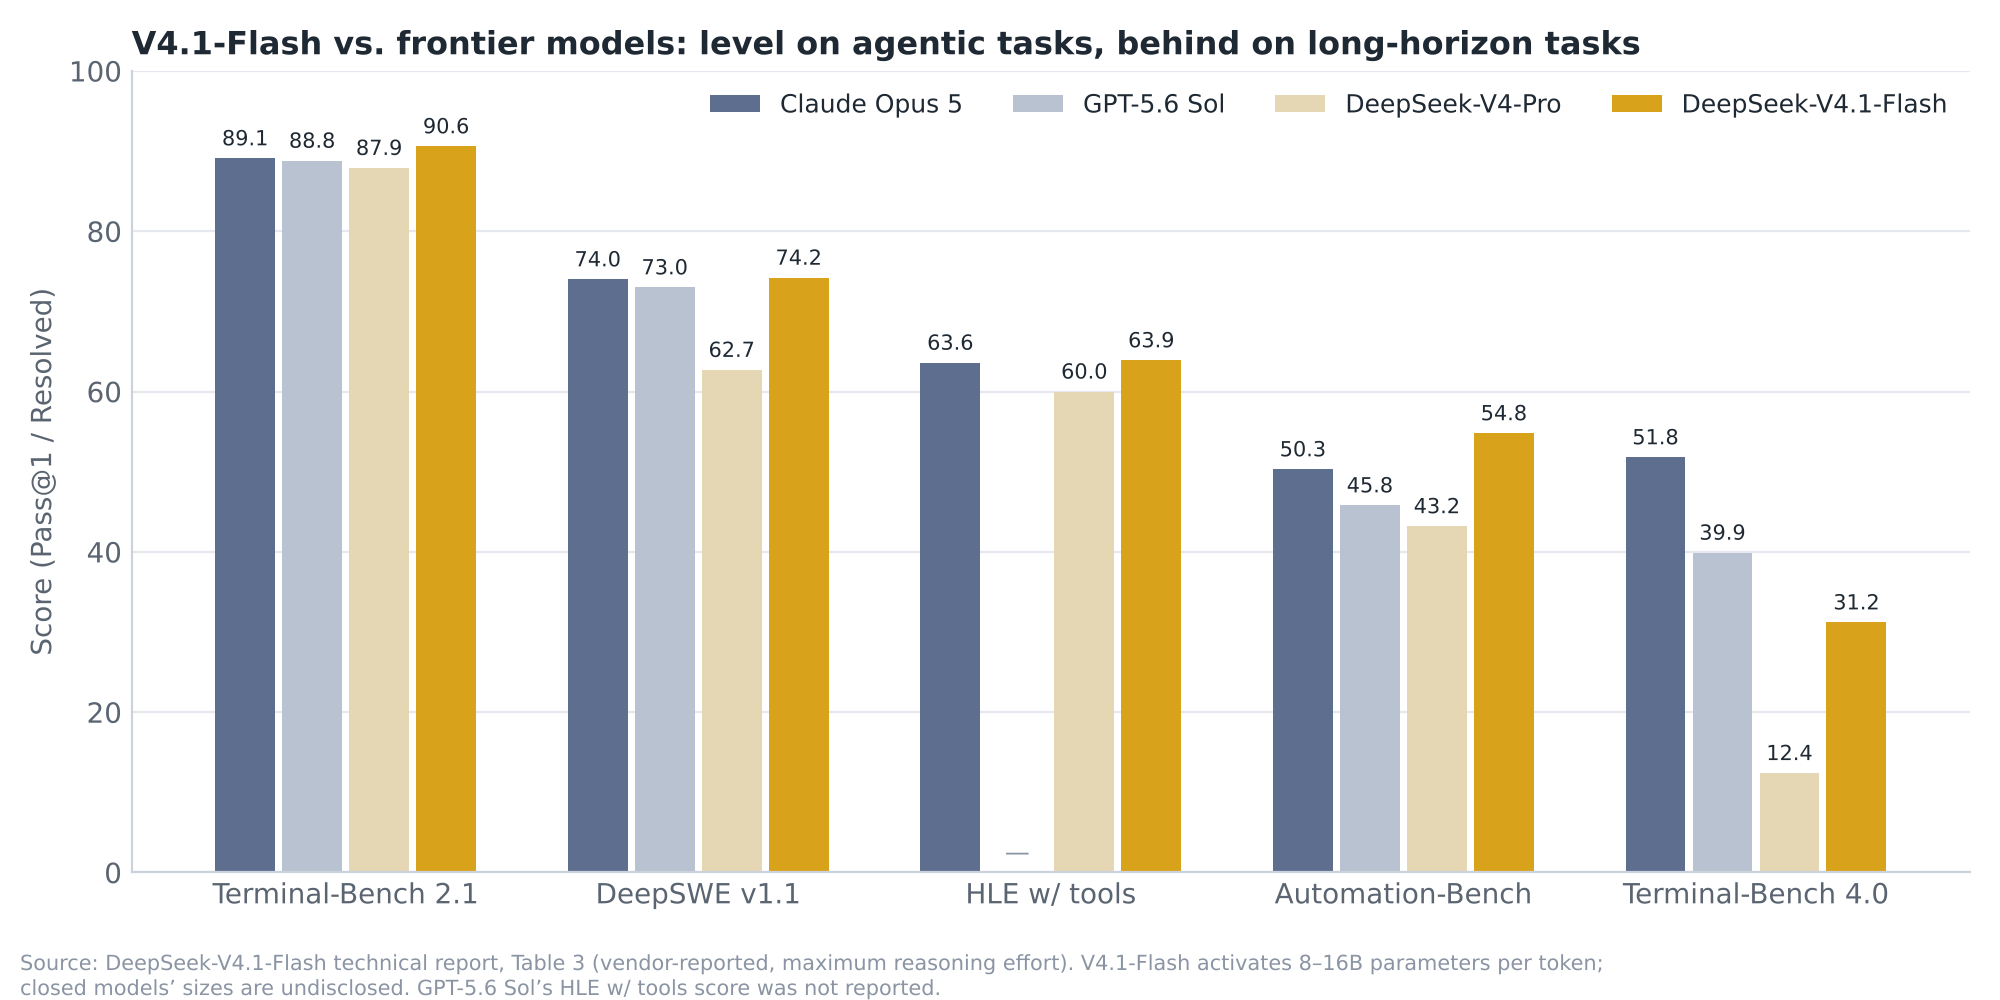
Sobre el desempeño y el precio. DeepSeek reporta que V4.1-Flash-Base alcanza el nivel de V4-Pro-Base con 1/3 del total de parámetros y 1/4 de los parámetros activos. Los precios máximos son $0.30/M para entrada, $0.006/M para entrada en caché, $1.20/M para salida; fuera de pico son la mitad. Sin embargo, en métricas independientes de terceros (40 puntos en Artificial Analysis; Claude Opus 5 tiene 51), la brecha respecto a evaluaciones independientes sigue siendo de aproximadamente 10 puntos. Hay que separar los puntos de referencia elegidos por el fabricante de las evaluaciones integradas independientes. Esto es una lección viviente de que «el promedio engaña».
Otros modelos MoE principales en 2025–2026(de tarjetas de modelos oficiales):
| Modelo | Período | Total / Activación | Expertos (seleccionados / total) | Tasa de activación | Otros rasgos de diseño |
|---|---|---|---|---|---|
| Mixtral 8x7B | 2023-12 | 46.7B / 12.9B | 2/8 | Aproximadamente 28% | Primer MoE abierto de alta calidad |
| gpt-oss-120b | 2025-08 | 116.8B / 5.1B | 4/128 | 4.4% | Pesos MoE MXFP4, disposición alternada de atención con ventana deslizante y global, attention sink |
| Qwen3-235B-A22B | 2025-04 | 235B / 22B | 8/128 | 9.4% | — |
| Qwen3.5-397B-A17B | 2026-02 | 397B / 17B | 10+1 / 512 | 4.3% | Atención lineal DeltaNet con compuerta mezclada 3:1, KV reducido a aproximadamente 1/4 |
| Kimi K2 / K2.5 | 2025-07 / 2026-01 | 1.04T / 32B | 8+1 / 384 | 3.1% | MuonClip, sin picos de pérdida en 15.5T tokens |
| Kimi K3 | 2026-07 | 2.8T / 104B | 16 / 896, compartidos 2 | 3.7% | Atención lineal KDA + MLA con compuerta, QAT MXFP4 |
| Llama 4 Maverick | 2025-04 | Aproximadamente 400B / 17B | 1 + compartidos 1 / 128 | 4.3% | Disposición alternada de capas densas y capas MoE |
| DeepSeek-V4.1-Flash | 2026-09 | 552B / 8–16B | 6+1 / 384 | 1.4%–2.9% | Como se describió anteriormente |
La tendencia es esta: en 2 años el campo pasó de «8 expertos y 2 elegidos, activación 25%» a «varios centenares a casi 1,000 expertos, elegir 6 a 16, activación 1.5% a 4.5%», y el grado de dispersión aumenta aproximadamente un orden de magnitud cada 1–1.5 años. Los expertos compartidos se convirtieron en estándar; el enrutamiento usa sesgo sin pérdida auxiliar, enrutamiento por hash (primeras 3 capas de V4) y enrutamiento en espacio latente (K3). En modelos cerrados, Google ha confirmado públicamente que Gemini 1.5 y las series Gemini 2.5 son MoE dispersos. El «1.8T MoE» de GPT-4 es solo un rumor de 2023; la composición de GPT-5.x y Claude es no pública. Si se escribe al respecto, el máximo es «según reportes».
Dispersión en atención y caché KV
Tamaño del caché KV = 2 × L × número de capas × número de cabezas KV × dimensión de cabeza × bytes por elemento. Con 64 capas, 8 cabezas KV, dimensión de cabeza 128, FP16 y contexto de 128K, da aproximadamente 31 GiB. Es mayor que los pesos de muchos modelos, y todo se debe releer cada vez que se genera un token. Hay tres contramedidas: reducir cabezas KV (GQA/MQA), compresión de bajo rango (MLA), o desalojo disperso o cómputo disperso.
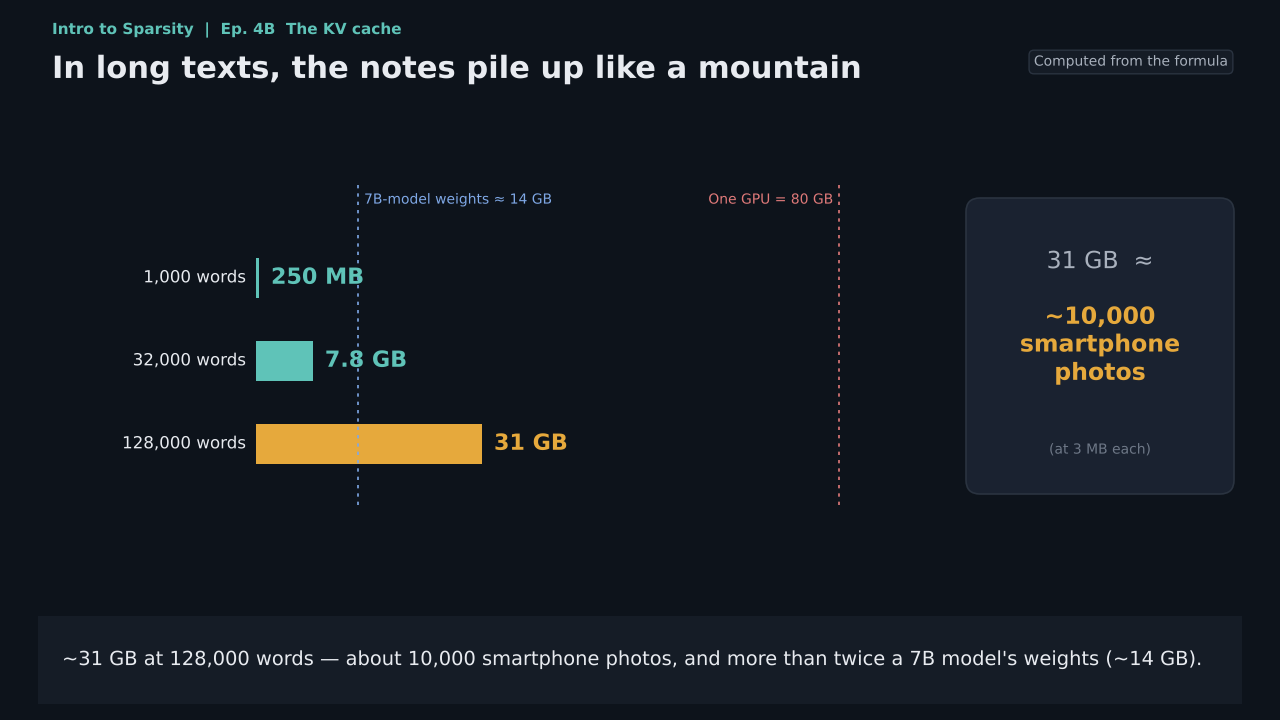
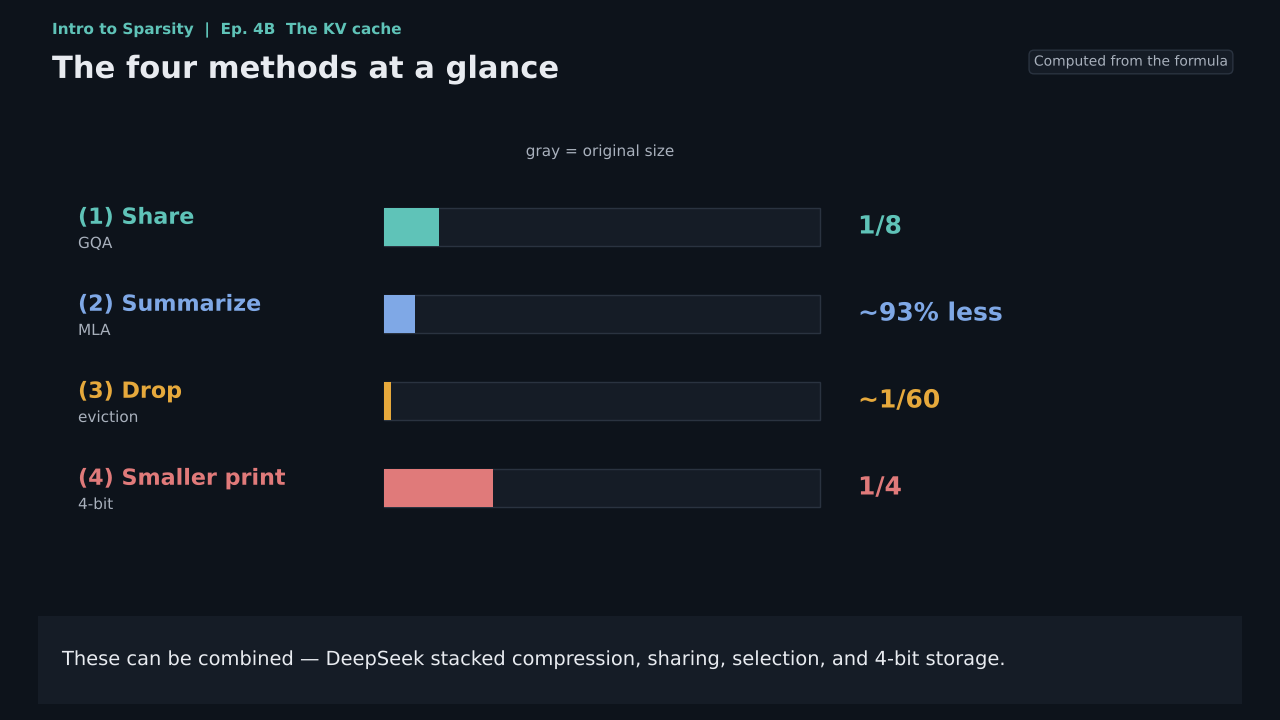
Hay 3 generaciones de atención dispersa, que se pueden acumular. La primera es patrones fijos (Longformer, BigBird, ventana deslizante de gpt-oss). La segunda es desalojo dinámico en inferencia sin reentrenamiento (StreamingLLM, H2O, SnapKV, Quest). La tercera aprende nativamente dispersión desde el entrenamiento (NSA, MoBA, DSA, CSA2). NSA (Yuan et al., DeepSeek × Universidad de Pekín × Universidad de Washington) ganó el Premio al Mejor Artículo de ACL 2025, logrando 11.6× más rápido en decodificación, 9.0× en pasada adelante y 6.0× en pasada atrás en longitud 64K comparado con atención global completa.
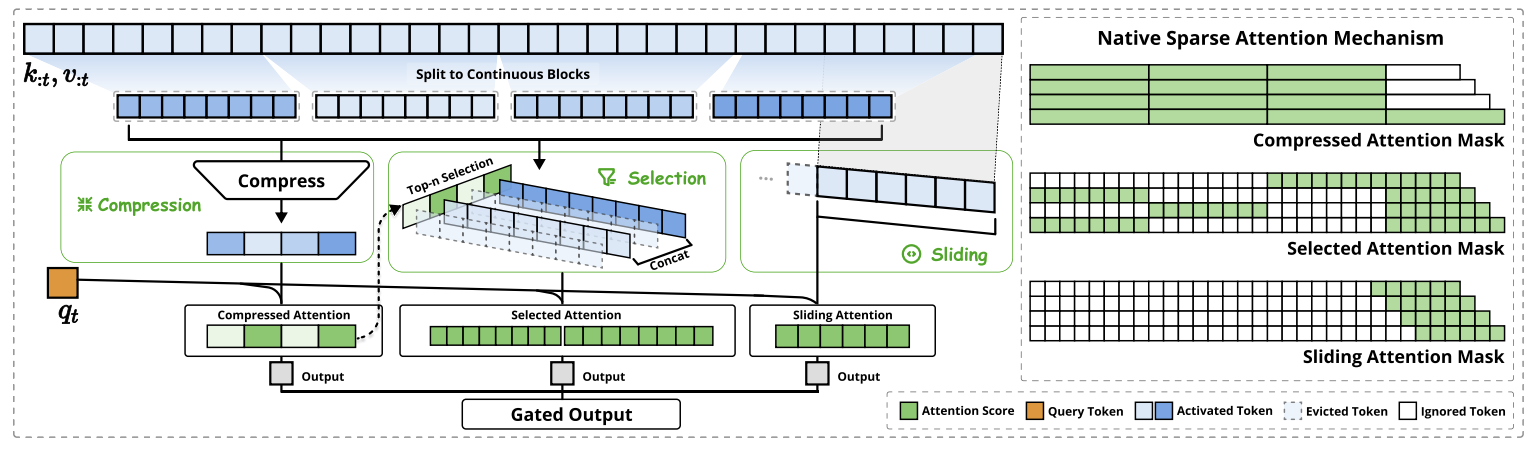
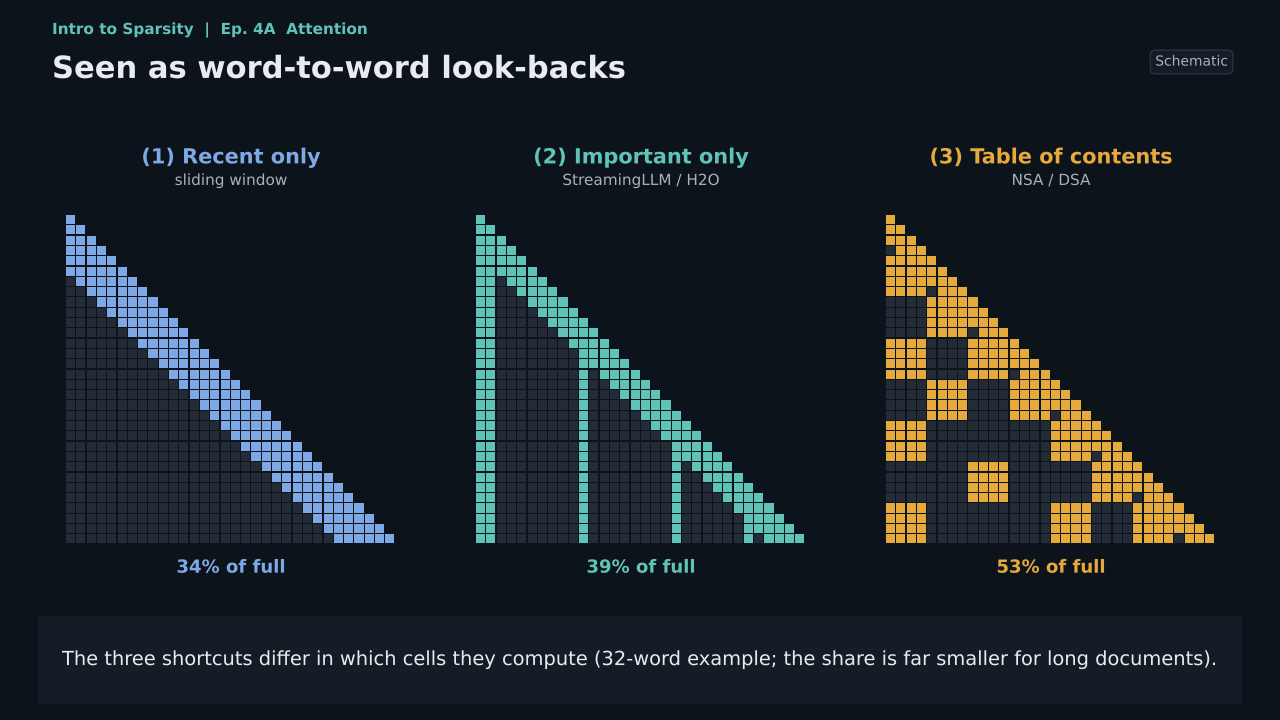
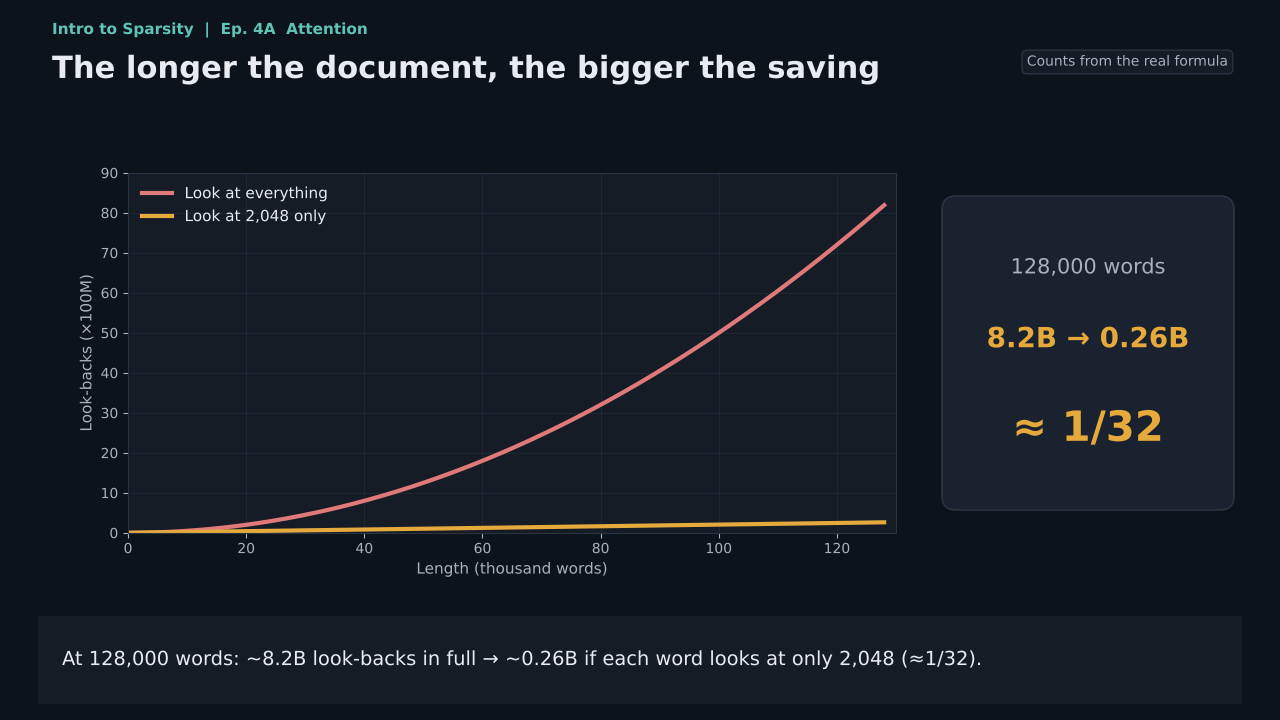
Un jarro de agua fría de la medición a gran escala. The Sparse Frontier de Nawrot et al. (arXiv:2504.17768, publicado formalmente en Findings of ACL 2026) evaluó la atención dispersa sin necesidad de entrenamiento en Qwen2.5 de 7B a 72B, 16K a 128K, y nueve tareas, llegando a cuatro conclusiones. En secuencias muy largas, "grande y disperso" supera a "pequeño y denso", con el punto de intersección alrededor de 32–64K. La tasa de dispersidad óptima en la etapa de prefill es 0,80–0,93 (un presupuesto de 1/5 a 1/15), siendo la decodificación más tolerante. Casi todas las configuraciones sufren una degradación significativa del rendimiento en al menos una tarea. La atención dispersa no es una panacea. Y no existe una única estrategia que sea la mejor para todas las tareas y fases. Este resultado motivó la generación de "dispersidad aprendible nativamente".
Dispersidad de activación
Q-Sparse (Wang, Ma, Wang & Wei, arXiv:2407.10969) aplica top-k directamente a las activaciones en todas las capas lineales, retropropaga con STE, y demostró leyes de escalado de la dispersidad. La tasa de dispersidad óptima es aproximadamente 45,58% en modelos de precisión completa y 61,25% en modelos de 1,58 bits, alcanzando la paridad con modelos densos del mismo tamaño con aproximadamente 40% de dispersidad. Cuando se entrenó Mistral 7B con 40B tokens adicionales, Q-Sparse registró 63,7 con 3,8B de activaciones, aproximándose a la línea base densa (7,0B) de 64,6. En el ablation, tanto remover STE como reemplazar top-k con ReLU causaron una degradación clara del rendimiento. Además, con ReLU la tasa de dispersidad disminuyó durante el entrenamiento, mientras que con top-k se mantuvo constante. Esto respalda la afirmación de que "la dispersidad debe ser una restricción arquitectónica, no un término de regularización". TEAL, ReLU Strikes Back, Deja Vu y PowerInfer son las principales líneas en el lado edge.
Dispersidad en interpretabilidad: el auge y la controversia de los SAE
El recorrido de Anthropic es el siguiente. Towards Monosemanticity (2023) utilizó autocodificadores dispersos para extraer características monosemánticas de un modelo de una capa. Scaling Monosemanticity (2024) entrenó SAE con hasta 34 millones de características en Claude 3 Sonnet y demostró el bloqueo de características en Golden Gate Claude. Circuit Tracing y On the Biology of a Large Language Model (2025) construyeron gráficos de atribución con transcodificadores entre capas y rastrearon el razonamiento multi-paso de Claude 3.5 Haiku. En OpenAI, Gao et al. (2024) entrenaron TopK SAE con 16 millones de características en GPT-4. Esta línea es la descendencia directa del aprendizaje de diccionarios de Olshausen–Field.
Las controversias llegaron en masa en 2024–2025. Absorción de características (Chanin et al. 2024). Características unidimensionales y no lineales (Engels et al. 2024). Incapacidad para superar la línea base de regresión logística en 113 conjuntos de datos de probing (Kantamneni et al. 2025). Las características encontradas difieren según el SAE (Leask et al. 2025). En marzo de 2025, el equipo de interpretabilidad mecánica de Google DeepMind anunció que el campo ha invertido excesivamente en SAE, bajando "la prioridad de la investigación fundamental en SAE por ahora". Un consenso relativamente moderado es que los SAE son buenos para descubrir conceptos desconocidos, pero no para detectar o controlar conceptos conocidos. Aunque nuevas investigaciones como SharedSAE y WriteSAE continúan surgiendo en 2026, aún no ha emergido un nuevo consenso unificador.
Teoría unificada: tres operadores y aprendizaje de top-k
Ya sea LASSO, poda, SAE o enrutamiento MoE, el paso de "crear ceros" es uno de estos tres operadores.
Sλ(y) = sign(y) · max(|y| − λ, 0), Hτ(y) = y · 1[|y| > τ], Pk(y) = proyección que retiene solo los k componentes de mayor valor absoluto
El umbralizado suave es el operador proximal de L1 (LASSO, ISTA, eliminación de ruido de wavelets, SAE con penalización L1). El umbralizado duro corresponde a L0 (poda de magnitud, JumpReLU SAE). Y top-k es la proyección sobre el conjunto de vectores k-dispersos (enrutamiento MoE, atención dispersa, TopK SAE, Q-Sparse). ReLU en sí es umbralizado duro de un lado con τ=0. Casi todos los modelos a gran escala modernos usan el tercero porque fija el número de operaciones por token a una constante precisa, permitiendo planificación de memoria estática y kernels dedicados. En la era de los modelos a gran escala, la dispersidad ha cambiado de "término de regularización" a "restricción arquitectónica".
top-k no es diferenciable. Como ∂TopK/∂s es casi cero en todas partes, el gradiente solo llega a los pesos de compuerta de los expertos seleccionados, dejando el resto sin entrenar. Hay cuatro enfoques de ingeniería. Retropropagación solo a través de expertos seleccionados, sumando una pérdida auxiliar de equilibrio de carga (enfoque predominante). Noisy Top-k añadiendo ruido para crear exploración (Shazeer 2017). Relajaciones continuas como STE, Gumbel-Softmax y Soft MoE. Y desde DeepSeek-V3 en adelante, el método de sesgo sin pérdida auxiliar, es decir, clasificar por s+b pero ponderar por s, ajustando b fuera del gradiente según la carga. En el lado de atención dispersa, NSA selecciona a nivel de bloque para que el gradiente fluya, mientras que DSA primero calienta con atención densa, alineando el indexador a la distribución de atención densa, luego cambia a aprendizaje disperso.
Respecto a las leyes de escalado, Clark et al. (2022) unificó el escalado de modelos enrutados, recomendando 64–128 expertos. Krajewski et al. (2024) mostró que expertos de grano fino superan modelos densos en cualquier presupuesto computacional. Frantar et al. (2023) descubrió que la tasa óptima de dispersidad de pesos aumenta con el volumen de datos. El artículo Engram de DeepSeek (arXiv:2601.07372, enero de 2026) plantea el problema de "asignación de presupuesto de dispersidad" y encuentra una ley en forma de U. MoE puro no es óptimo; los mejores resultados llegan cuando se asigna aproximadamente el 20–25% del presupuesto de parámetros dispersos a memoria condicional. Nueve meses después, este descubrimiento se incorporó en el producto V4.1.
Economía e industria
El shock de DeepSeek. El 27 de enero de 2025, Nvidia cerró con una caída del aproximadamente 17%, perdiendo una capitalización de mercado de aproximadamente 589,000–593,000 millones de dólares (Bloomberg–Reuters). La mayor pérdida de capitalización de mercado en un solo día en la historia del mercado de valores estadounidense.
Margen de beneficio teórico del 545%. El 1 de marzo de 2025, DeepSeek informó que con H800 a 2 dólares por hora, el costo diario es de 87,072 dólares, y suponiendo facturación a precios de R1 en todas partes, los ingresos diarios teóricos son 562,027 dólares. También aclaró que los ingresos reales son mucho más bajos y no incluyen gastos en I+D o costos de entrenamiento. Al citar esta cifra, siempre añada la palabra "teórico".
Precio de inferencia. Epoch AI (marzo de 2025) señaló que el precio de inferencia para niveles de capacidad equivalentes está bajando a tasas de 9x a 900x anuales, siendo la velocidad diferente según la tarea. Aún así, el gasto total de las empresas sigue aumentando. Los agentes multiplican el número de llamadas por tarea.
Economía de la inferencia MoE. La memoria se determina por los parámetros totales; solo con grandes lotes y paralelismo de expertos llega suficiente tokens a cada experto. MoE es inherentemente adecuado para servicios centralizados a gran escala, no para auto-alojamiento pequeño. vLLM y SGLang soportaron MLA, DSA y V4.1 desde el día de lanzamiento público.
Comparación sistemática de enfoques entre instituciones de investigación
Cuando se alinean instituciones de investigación con los mismos criterios, se ve que el camino hacia la dispersidad no es uno solo, sino que múltiples estrategias compiten en paralelo.
| Institución de investigación | Divulgación de configuración | Principales tipos de dispersidad | Expertos (seleccionados / total) | Estrategia de atención | Estrategia de KV | Formato de peso | Modelo representativo | Características destacadas |
|---|---|---|---|---|---|---|---|---|
| DeepSeek | Publicado con reporte técnico | MoE + atención dispersa + memoria condicional | 6/384 + 1 compartido | Dispersidad nativa (DSA→CSA2), entrenado disperso desde el principio | MLA bajo rango + FP4 + reutilización entre capas, 890 B/token | Expertos FP4/FP8 | V3, V3.2, V4, V4.1-Flash | Estratificación de tres ejes de dispersidad. División de codificador–decodificador orientada a agentes |
| Moonshot (Kimi) | Pesos y reporte públicos | MoE + híbrido de atención lineal | 16/896 + 2 compartidos | MoBA disperso por bloque. K3 es atención lineal KDA + MLA puertas | Sin KV en capas lineales | MXFP4 QAT | K2, K2.5, K3 | Mayor número de expertos. Entrenamiento estable con MuonClip |
| Alibaba (Qwen) | Tarjeta de modelo pública | MoE + híbrido de atención lineal | 10/512 + 1 compartido | DeltaNet puertas y atención puertas en relación 3:1 | KV reducido a aproximadamente 1/4 | BF16/FP8 | Qwen3, Qwen3.5 | Serie completa desde edge hasta flagship |
| Meta | Tarjeta de modelo pública | MoE | 1/128 + 1 compartido (Maverick) | Intercalación de capas densas y MoE. iRoPE | GQA estándar | BF16 | Llama 4 | 10M contexto (Scout). Behemoth sin lanzamiento |
| OpenAI | Solo gpt-oss público | MoE | 4/128 | Intercalación de ventana deslizante (128) y atención completa. attention sink | GQA, 8 cabezas | MXFP4 | gpt-oss-120b/20b | GPT-5.x no público. Investigación SAE (Gao 2024) |
| Se confirmó oficialmente que Gemini 1.5 y 2.5 son MoE. Los detalles no se han publicado. | MoE. Arquitectura flexible para dispositivos perimetrales. | No publicado | No publicado | No publicado | No publicado | Gemini 1.5/2.5, Gemma 3n | Submodelos anidados de MatFormer, PLE | |
| Anthropic | No publicado | Sparsity para interpretabilidad (SAE, transcoders) | No publicado | No publicado | No publicado | No publicado | Series Claude | Usar sparsity como herramienta para "entender modelos" |
| Mistral | Pesos publicados | MoE | 2/8 | Estándar | GQA | BF16 | Mixtral 8x7B/8x22B | Primer MoE de código abierto de alta calidad (diciembre de 2023) |
| Microsoft Research | Artículo publicado | Sparsity de activación + cuantización de 1.58 bits | — | Estándar | Estándar | 1.58 bits (BitNet) | Q-Sparse, BitNet b1.58 | Combinación de sparsity y cuantización extrema de bajo bit |
| Meituan / Ant / Zhipu | Model card publicada | Variante de MoE | Varios | Varios | Varios | Varios | LongCat-Flash, Ling, GLM-4.5/4.6 | Expertos de cómputo cero, MoE con conexiones de atajo |
De aquí se pueden extraer tres observaciones. En primer lugar, la principal fuente de innovación en arquitecturas sparse es el campo de modelos abiertos de China. Expertos de grano fino, expertos compartidos, equilibrio de carga sin pérdida auxiliar, atención sparse nativa, memoria condicional e híbridos de atención lineal fueron anunciados por primera vez casi exclusivamente por DeepSeek, Qwen y Kimi. En segundo lugar, la composición de las grandes instituciones de investigación cerrada es una caja negra, y solo se puede inferir de información pública como reportes de gpt-oss y Gemini. Es un error común citar "GPT-4 es un MoE de 1.8T" como hecho. En tercer lugar, la atención se ha bifurcado en dos caminos. DeepSeek eligió "atención sparse" (calcular solo un subconjunto de pares de tokens), mientras que Qwen y Kimi eligieron "híbrido de atención lineal" (reemplazar la caché de KV con un estado recursivo). Ambos atacan el mismo problema de memoria y ancho de banda de la caché de KV, pero utilizan herramientas matemáticas diferentes. El primero es sparse, el segundo es cercano a la recursión de rango bajo.
Stack de sistema: ingeniería para hacer que la sparsity funcione en la práctica
Si las ganancias de la arquitectura sparse se realizan realmente depende de una capa frecuentemente pasada por alto: el software de sistema.
Paralelismo de expertos y comunicación. DeepEP (publicado por DeepSeek en 2025) proporciona un kernel all-to-all de alto rendimiento y baja latencia que admite FP8 y RDMA en NVSHMEM, solapando comunicación y cómputo. MegaBlocks (2023) reescribió el cómputo de MoE como GEMM sparse de bloques, logrando MoE sin pérdidas y alcanzando una velocidad 2.4 veces mayor en comparación con Megatron-LM denso.
Kernels de atención. FlashMLA está optimizado para MLA. DSA y CSA2 requieren indexadores y kernels de atención sparse coordinados; DeepSeek los publicó como FlashMLA y DeepGEMM. Los 3 modos de CSA2 en V4.1 significan que el motor de inferencia debe gestionar la reutilización entre capas de KV e índices.
Framework de inferencia. vLLM y SGLang admitieron MLA, DSA y V4.1-Flash desde el día del lanzamiento, cubriendo H100/H200/B200/GB200 y AMD MI355X. NVIDIA NeMo AutoModel proporciona recetas de fine-tuning para V4.1, que requieren 64 GPUs dentro de un único dominio NVLink.
Almacenamiento jerárquico. La tabla Engram de V4.1 (aproximadamente 183 GiB) se coloca en memoria de host y se prefetcha a través de RDMA. Ya existen artículos que mantienen Engram en grupos de memoria CXL, moviendo el "conocimiento" desde HBM a niveles más económicos. SWA Bounded Replay evita la persistencia en SSD de KV de ventana deslizante.
Formatos de cuantización. MXFP4 (una escala compartida de 8 bits cada 32 elementos, promediando 4.25 bits) se convirtió en el estándar de facto para pesos de expertos de MoE en 2025–2026. Blackwell admite tensor cores FP4 de forma nativa.
La conclusión de esta sección resuena con la "era de las redes neuronales". La victoria de la sparsity siempre vino acompañada de kernels y scheduling correspondientes. La sparsity 2:4 no se popularizó porque, incluso con tensor cores, carecía de un stack de software maduro de extremo a extremo. MoE se convirtió en corriente principal porque DeepEP, MegaBlocks y vLLM existen.
Donde la dispersidad y el aprendizaje profundo se encuentran: avances recientes en procesamiento de imágenes y señales
Mientras que los modelos de gran escala utilizaron la escasez para ahorrar cómputo, el procesamiento de imágenes y señales siguió un camino diferente: combinando distribuciones previas dispersas con redes profundas para recuperar señales a partir de mediciones incompletas y ruidosas. Los resultados han fluido también en la dirección inversa, transformando la forma en que interpretamos los modelos de gran escala y diseñamos su arquitectura.
El punto de partida es LISTA de Gregor y LeCun (2010). Se "despliega" la iteración fija de ISTA en una red con un número finito de capas, cuyos parámetros se hacen aprendibles. Cada capa sigue siendo "transformación lineal + soft-thresholding", pero la matriz y el umbral se aprenden de los datos. El resultado converge 1–2 órdenes de magnitud más rápido que ISTA ajustado manualmente y mantiene la interpretabilidad estructural. Cada capa corresponde a un paso de gradiente proximal. El despliegue de algoritmos se convirtió posteriormente en el marco dominante de la imagen computacional. ADMM-Net e ISTA-Net se utilizan en reconstrucción de MRI de sensibilidad comprimida, y las redes desplegadas superan métodos de CS clásicos en datos de submuestreo clínico. El significado más profundo del despliegue es haber mostrado que las redes profundas pueden leerse como versiones aprendibles de solucionadores sparse. Esta perspectiva proporcionó intuición para descifrar redes neuronales con diccionarios sparse posteriormente.
Distribuciones a priori plug-and-play y regularización por denoising
La regularización clásica (L1, variación total) escribe la distribución a priori explícitamente como término de penalización. El marco plug-and-play (PnP) que emergió después de 2013 descubrió que el paso "aplicar el operador proximal" en ADMM o gradiente proximal puede ser reemplazado por un denoiser arbitrario, es decir, una red de denoising profunda entrenada. La distribución a priori pasó de "una fórmula" a "un denoiser de caja negra", y la distribución a priori sparse se convirtió en uno de sus casos especiales. Regularization by Denoising (RED) y la distribución a priori de modelos de difusión posterior heredan esta línea. En esta visión, denoising por soft-thresholding, BM3D y denoisers profundos son tres generaciones de piezas intercambiables encajadas en la misma posición.
Deep Image Prior: la estructura de la red misma como distribución a priori
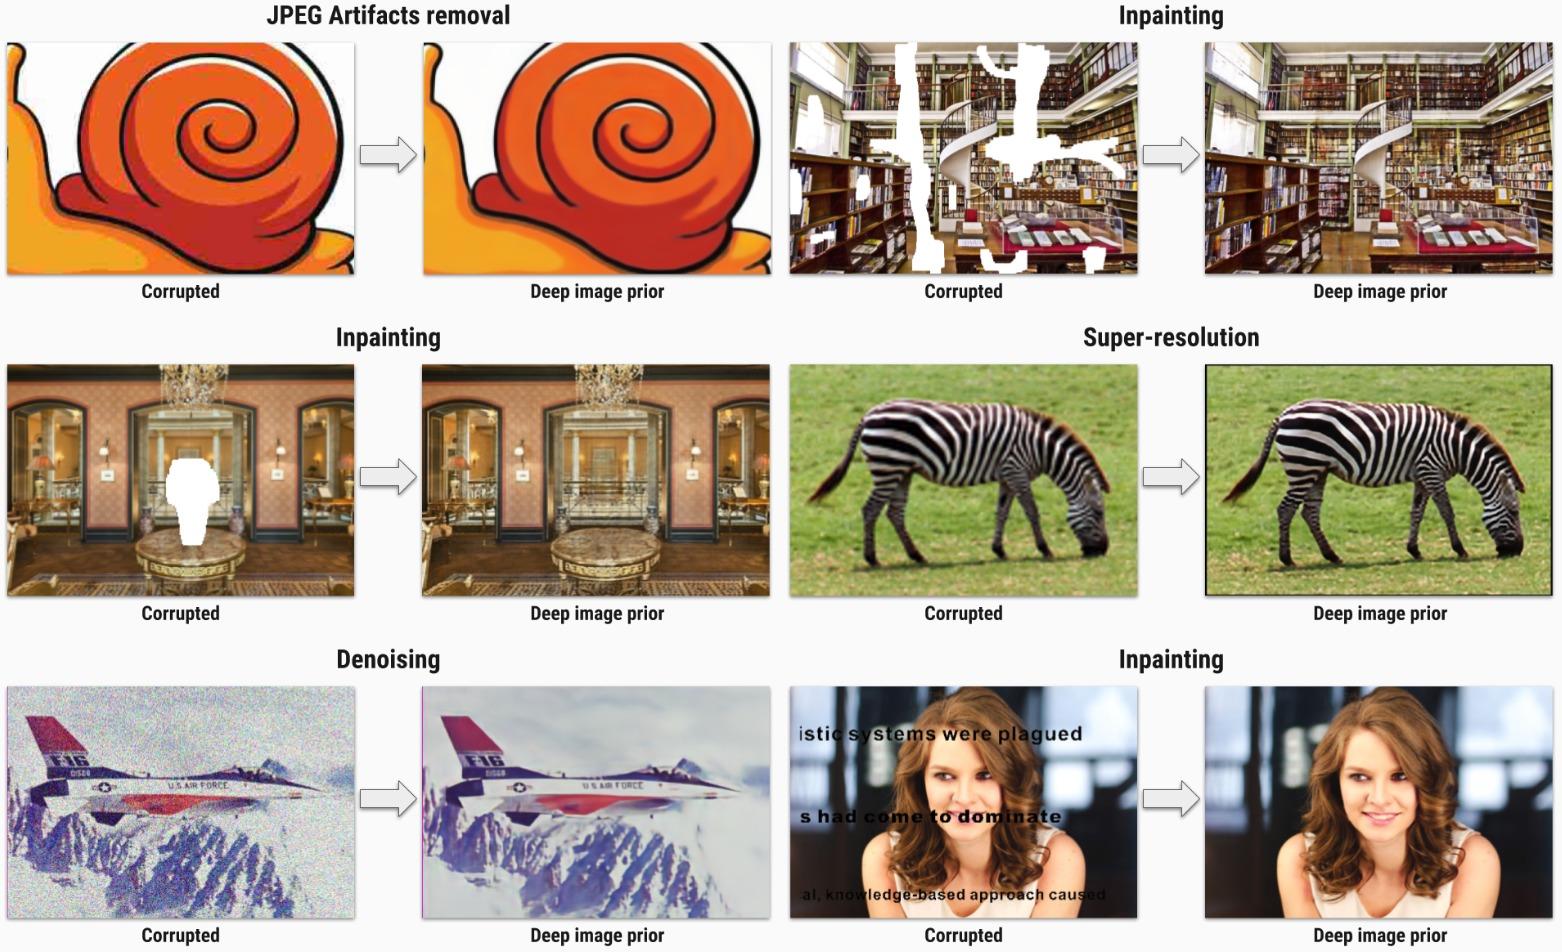
Deep Image Prior de Ulyanov, Vedaldi y Lempitsky (2018) produjo un resultado contraintuitivo. Simplemente ajustando una red convolucional no entrenada inicializada aleatoriamente a una única imagen degradada, se puede realizar denoising, superresolución e inpainting. La estructura de la red convolucional favorece estadísticas autosimilares en bajas frecuencias de imágenes naturales, y el ajuste al ruido es lento, por lo que detener temprano produce imágenes limpias. Esto se conecta directamente con las estadísticas de imagen natural discutidas en la "prehistoria". La estructura de la red codifica implícitamente la distribución a priori de que "las imágenes naturales son sparse bajo alguna base", siendo la única diferencia que esa base ya no se escribe explícitamente. Después de DIP, "la estructura es la distribución a priori" se convirtió en una lente importante para entender el sesgo inductivo de las redes neuronales, y un puente hacia la teoría sparse clásica. DIP puede verse como un método que logra lo mismo de forma adaptativa mediante "frames" aprendibles e implícitos, preservando solo componentes que realmente representen la estructura de la señal.
Diccionarios aprendidos y frames estructurados
Entre wavelets fijos, diccionarios no estructurados que aprende K-SVD y distribuciones a priori implícitas que aprenden redes profundas, hay un camino intermedio. Aprender los parámetros de datos mientras se preserva la estructura matemática de frames ajustados y transformaciones unitarias (reconstrucción perfecta, conservación de energía). Transformaciones simétricas direccionales no separables superpuestas (NSOLT) y redes unitarias de estructura de celosía (LSUN) pertenecen a esta categoría. Al restringir la transformación a la variedad de frames ajustados y parametrizarla con estructura de celosía, se obtiene adaptabilidad a datos específicos mientras se preserva la interpretabilidad y reversibilidad de transformaciones clásicas. El valor de este camino está siendo redescubierto en la era de modelos grandes. Los SAE requieren diccionarios sobreparametrizados; los MLA requieren proyecciones de rango bajo invertibles. Ambos buscan equilibrio entre restricción estructural y adaptabilidad a datos, que es precisamente el problema de diseño que los frames estructurados siempre han enfrentado.
Tres puntos de contacto con modelos grandes
Tres puntos de contacto con modelos a gran escala
En primer lugar, SAE es la codificación dispersa en sí. El autocodificador disperso de Anthropic es matemáticamente idéntico al aprendizaje de diccionario de Olshausen–Field; lo único que cambió fue el dato. De parches de imagen a actividades en el flujo residual. En segundo lugar, el desplegamiento algorítmico anticipaba la lectura "red = solucionador". El transcodificador de Anthropic y los gráficos de atribución son, en esencia, la búsqueda de un gráfico de cálculo alternativo disperso y legible para el Transformer. En tercer lugar, la idea de distribuciones previas estructurales se infiltró en el diseño de arquitectura. Los bloques de expertos de MoE, la reutilización entre capas de CSA2 y las tablas de búsqueda de Engram, en todos los casos, escriben la creencia de que "los datos deberían tener esta estructura" no en la función de pérdida sino en la forma de la red misma. Esto es el correlato en el mundo del procesamiento de imágenes de la conclusión de la sección "teoría unificada". La dispersión ha pasado de ser un término de regularización a ser una restricción arquitectónica.
Aplicaciones: Donde la escasez realmente ha generado valor
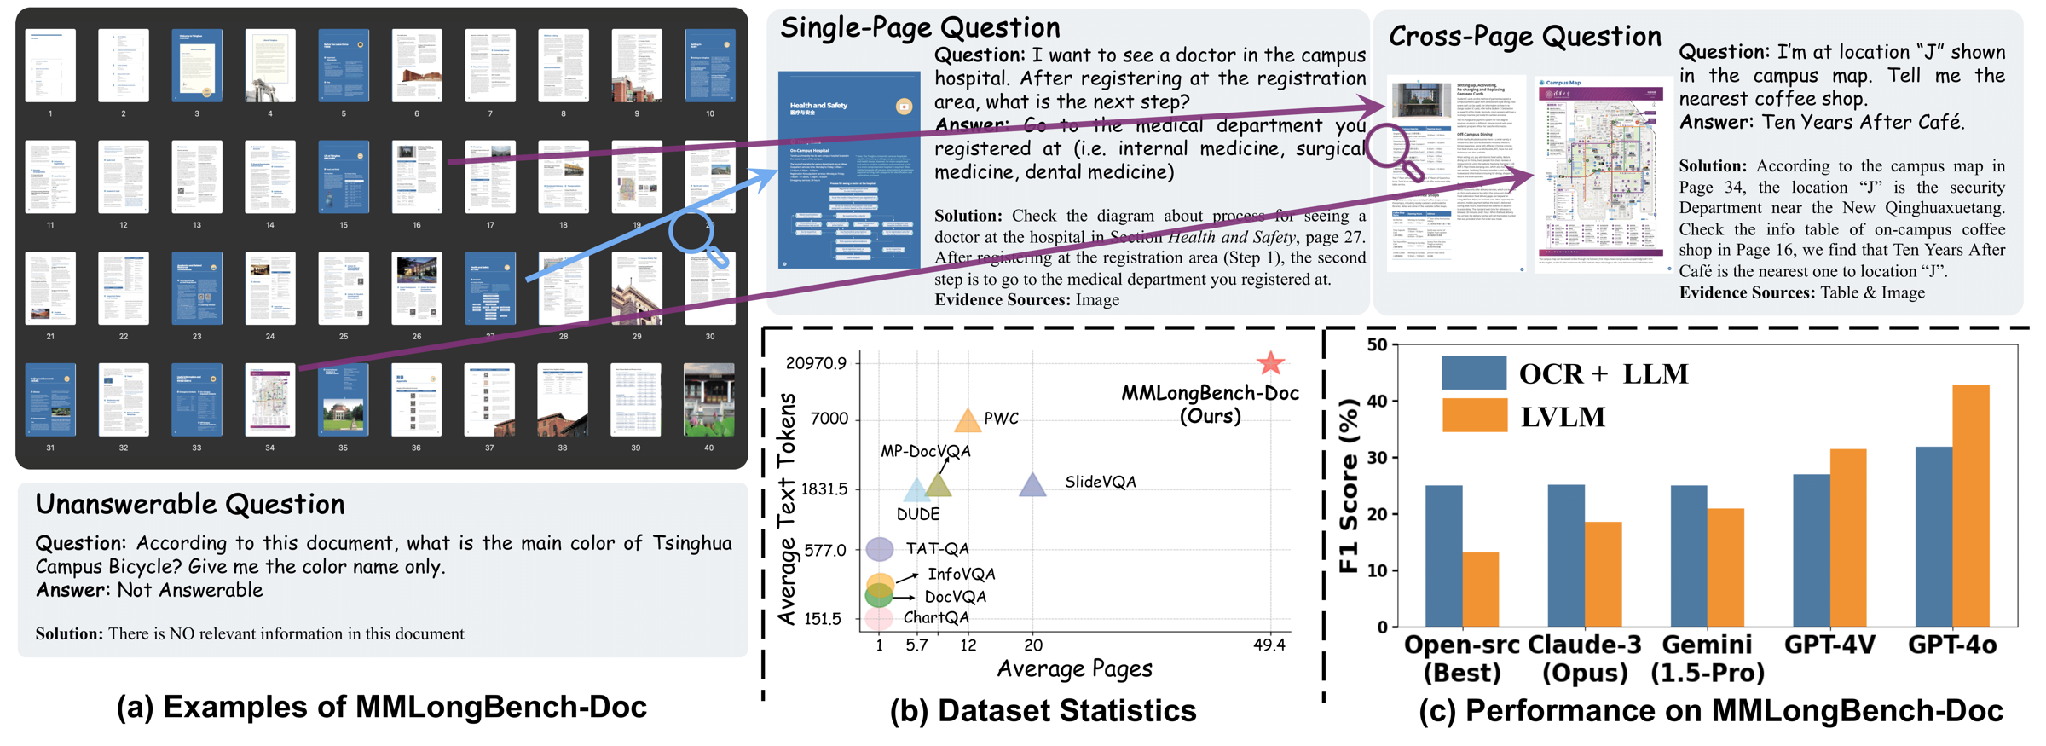
La escasez genera valor en lugares donde hay una cantidad inmensa de material a procesar, pero solo un pequeño número de elementos son realmente importantes. La revisión de documentos largos es uno de los ejemplos más típicos de esto.
Inferencia de LLM en la nube. Casi todas las API de frontera de bajo costo en 2026 provienen de modelos MoE altamente dispersos. La salida fuera de horas de DeepSeek-V4.1-Flash es de $0,60/M, mientras que gpt-oss-120b en OpenRouter es aproximadamente $0,03/M para entrada y aproximadamente $0,17/M para salida.
Contexto largo y agentes. Con el lanzamiento de V4.1, DeepSeek dejó claro que la mayoría del costo de los agentes suele provenir del precio del impacto de caché, y que la compresión de caché puede reducir sustancialmente esta parte. El precio de entrada en caché ($0,006/M) es 1/50 del precio de fallo de caché ($0,30/M), y esta es la palanca central en la economía de los agentes.
Edge. LLM in a Flash de Apple (2023) carga parámetros activados dispersamente desde almacenamiento flash bajo demanda. Gemma 3n utiliza submodelos anidados de MatFormer y incrustación por capa (PLE). Modelos MoE como Qwen3.5-35B-A3B con 3B de activación se están convirtiendo en candidatos para navegadores y edge.
Multimodal. V4.1 proporciona sesgos de enrutamiento dedicados para tokens de imagen. Los tokens visuales son numerosos y altamente redundantes, lo que los convierte en objetivos ideales para atención dispersa.
Ciencia y medicina. CS-MRI redujo el tiempo de exploración promedio en la clínica diaria aproximadamente un 20%, y entre 23% y 43% para una secuencia única. El pipeline SMILI que respalda la imagen de agujeros negros del EHT se basa en modelado disperso.
Revisión empresarial de documentos y planos largos (directamente relevante para nuestro negocio)
Punto de referencia que establece el estándar de dificultad. MMLongBench-Doc (NeurIPS 2024 D&B) recopila 135 PDF que promedian 47,5 páginas y aproximadamente 21.000 tokens de texto, con 1.082 preguntas escritas por expertos. El 33,2% requiere evidencia que abarca múltiples páginas, y el 22,8% está diseñado para ser imposible de responder para detectar alucinaciones. Los anotadores humanos logran un F1 del 66,0%, y de 14 modelos de lenguaje visual, 12 tienen un desempeño peor que cuando se proporciona texto OCR al modelo correspondiente solo de texto. LongDocURL incluye 396 documentos que promedian 86 páginas, con el 52,9% de las preguntas abarcando múltiples páginas. La longitud de estos documentos y la proporción de preguntas que abarcan páginas y elementos son sorprendentemente similares a las solicitudes de revisión de construcción (planos de decenas a más de cien páginas, cálculos estructurales y documentos de solicitud).
El cuello de botella no es solo la longitud del contexto. Es seleccionar el top-K correcto de la evidencia dispersa. La recuperación (selección de páginas top-K) y la atención dispersa (selección de bloques de tokens top-K) son matemáticamente el mismo operador. La diferencia está en si la selección ocurre fuera del modelo (auditable, con citas de disposiciones) o dentro (end-to-end pero opaco).
Limitaciones. Sparse Frontier muestra que la atención dispersa puede reducir el desempeño en tareas individuales incluso con tasas de dispersión moderadas. "La Sección X contradice las dimensiones indicadas en la página 37" en tareas de revisión es precisamente una tarea donde "perder una cosa hace que toda la respuesta sea incorrecta". Por lo tanto, un enfoque híbrido de recuperación y reverificación en contexto largo es más seguro que apostar por uno u otro. Múltiples estudios de documentos multipágina en 2025, incluidos SimpleDoc, MDocAgent y LAD-RAG, también siguen este camino.
Beneficios y costos
Para la dispersión de pesos, "la dispersión está sobrevalorada en la era de LLM" es generalmente correcto. Para la computación condicional y la dispersión de atención es lo opuesto: ambas ya son estándares de facto en la frontera. Distinguir estos dos es clave para entender todo el debate.
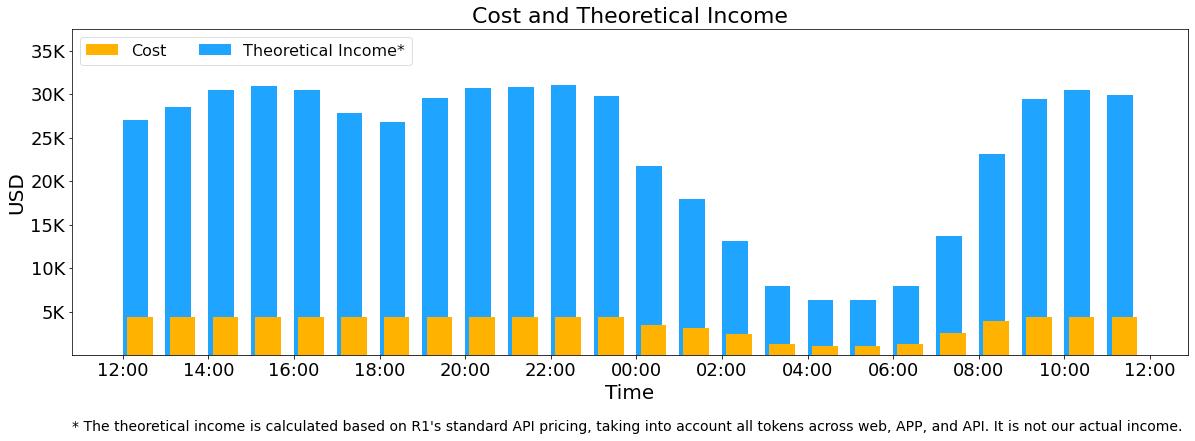
Beneficios
Costo: Las tasas de activación han caído a 1,5%–4,5%, y la curva de precios está cayendo rápidamente.
Separación de capacidad y computación: Los parámetros totales determinan la capacidad del conocimiento, los parámetros activados determinan el costo por token, y ambos pueden escalar independientemente. Engram va más allá, moviendo conocimiento estático a memoria host más económica.
Realización de contexto largo: Los decodeFLOPs de V4.1 aumentan solo aproximadamente una cuarta parte entre 4K y 1M.
Herramienta para interpretabilidad: SAE y transcodificadores se utilizan para descubrir conceptos desconocidos.
Costo y riesgo
La memoria está determinada por parámetros totales: Los expertos de enrutamiento de V4.1 (MXFP4) ocupan aproximadamente 259,5 GiB, la tabla Engram aproximadamente 183 GiB. La dispersión no ahorra almacenamiento.
Sobrecarga de comunicación: All-to-all en paralelismo de expertos es el principal cuello de botella en el entrenamiento de MoE, y Engram requiere prefetching sobre RDMA o CXL.
Inestabilidad del entrenamiento e inclinación de carga: Se requiere una serie de parches: z-loss, ajuste de sesgo, enrutamiento hash, etc.
Difícil de ajustar finamente: El enrutamiento tiende a colapsar en conjuntos de datos pequeños. El procedimiento oficial de ajuste fino de V4.1 requiere 64 GPU dentro de un único dominio NVLink.
Trampas en la evaluación: El hallazgo de Sparse Frontier: "Casi cada configuración pierde rendimiento en al menos una tarea". V4.1 se iguala con la frontera en puntos de referencia de proveedores, pero se queda aproximadamente 10 puntos por debajo en métricas generales independientes.
Limitaciones de SAE: Véase la sección "Dispersión en interpretabilidad".
La dispersión de pesos sigue perdiendo en eficiencia: Los métodos convencionales no pueden romper el muro de 50%–60% de dispersión.
Puntos de vista representativos (citados de fuentes)
| Posición | Fuente | Punto de vista |
|---|---|---|
| A favor: El ganador está determinado por el hardware | Hooker 2021 | Las ideas ganan "no porque sean superiores, sino porque encajan con el software y hardware disponibles" |
| A favor: Nuevo eje de dispersión | DeepSeek, Engram 2026 | "Creo que la memoria condicional se convertirá en una primitiva de modelado esencial para la próxima generación de modelos dispersos" |
| Cauteloso | Nawrot et al. 2026 | "La atención dispersa no es una bala de plata" |
| Negativo | Google DeepMind 2025 | "No creo que SAE sea un cambio de juego para la interpretabilidad, y sospecho que este campo ha invertido excesivamente en SAE" |
| Intermedio | arXiv:2506.23845 | SAE es débil en trabajar con conceptos conocidos, pero es una herramienta poderosa para descubrir conceptos desconocidos |
Veredicto para cada uno de los cinco tipos de dispersión (septiembre de 2026)
No hay una respuesta única a "¿Está sobrevalorada la dispersión?". Esta pregunta requiere respuestas por tipo.
| Tipo de dispersión | Situación en 2026 | Veredicto | Fundamentos principales |
|---|---|---|---|
| Dispersión de pesos (pruning no estructurado) | Investigación activa, adopción industrial mínima | Sobrevalorada en la era de LLM. La cuantización ganó | Muro de 50%–60% de dispersión. Falta de kernels GPU eficientes. MXFP4 es de facto |
| Dispersión estructurada (2:4, bloque) | Soporte de hardware disponible, pero aceleración end-to-end limitada | Parcialmente realizada. La dispersión de bloque ganó en forma de MoE | 2:4 rara vez logra 2x en mediciones reales. GEMM dispersa de bloques de MegaBlocks se convirtió en base de MoE |
| Dispersión de activación (ReLU, activación top-k) | Llamando la atención en edge e investigación. Absorbido por MoE en la nube | Potencial subestimado. Pero el campo de batalla principal es edge | Q-Sparse iguala modelos densos con aproximadamente 40% de tasa de dispersión. TEAL y PowerInfer apuntan a dispositivos con restricciones de memoria |
| Computación condicional (MoE) | Arquitectura estándar de facto de frontera | Tan prometedora como la reputación. Profundizando aún más | Tasa de activación del 25% en 2 años a 1,5%–4,5%. Todos los modelos abiertos de clase insignia en 2025–2026 lo adoptaron |
| Dispersión de atención | Versión entrenable nativamente en productos | Establecida. Pero con riesgo de degradación de rendimiento por tarea | NSA ganó mejor artículo de ACL. V4.1 entrenado disperso desde el principio. "Degradación en al menos una tarea" de Sparse Frontier |
| (Linaje paralelo) Rango bajo | MLA y LoRA ampliamente utilizados | Establecida. Pero no confundir con dispersión | Compresión KV de rango bajo hasta aproximadamente 93% (V2). LoRA es estándar para ajuste fino |
| (Herramienta) Diccionario disperso / SAE | Debate en curso | Establecida como herramienta de descubrimiento. Sobrevalorada como detector y controlador | GDM bajó la prioridad. Por debajo de sondas lineales en 113 conjuntos de datos. Anthropic pasó a transcodificadores y gráficos de atribución |
En una oración: La dispersión ganó en "activación" y "atención", perdió en "pesos". Ganó no porque la teoría fuera superior, sino porque el hardware pudo explotar la estructura de dónde estaban los ceros.
Futuro (2026–2030)
El siguiente eje de dispersión ya no es "qué parámetros calcular", sino "qué conocimiento almacenar y qué historial leer". A continuación se presentan la frontera de la investigación, tendencias de hardware y cinco predicciones falsables.
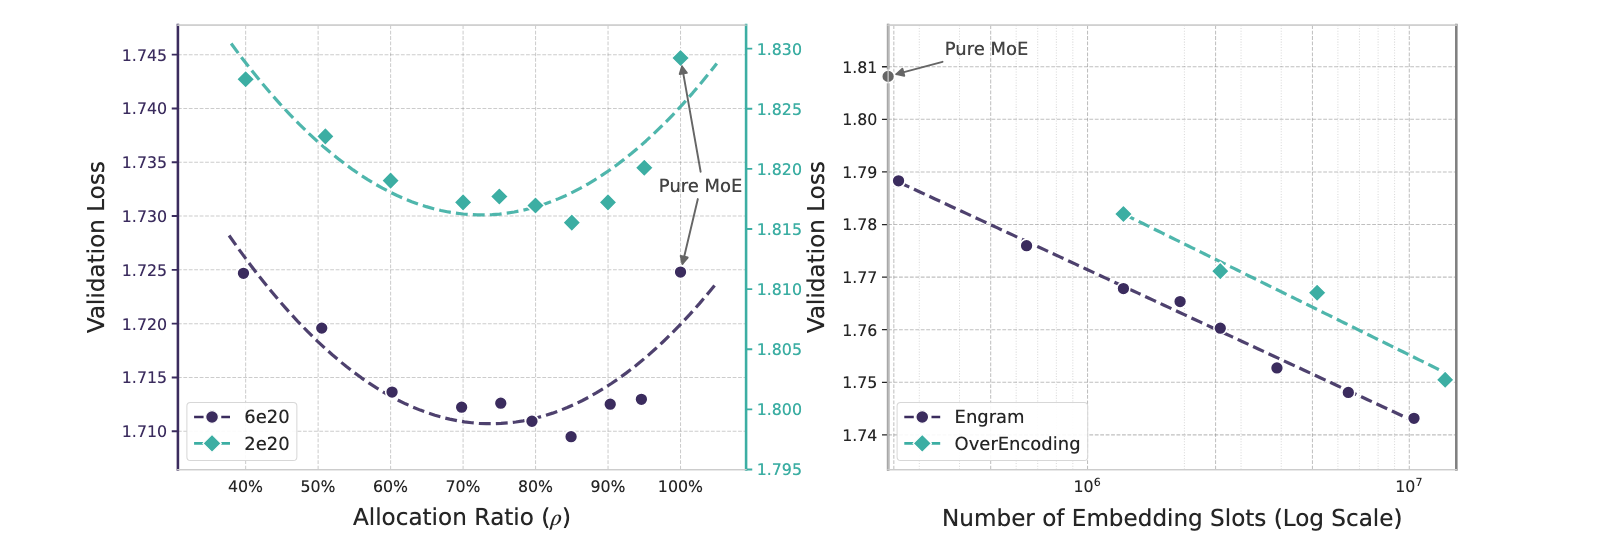
Frontera de investigación
Escasez multieje y asignación de presupuesto. La ley de forma de U que encontró el artículo Engram muestra que MoE puro no es óptimo, y el presupuesto de escasez debe dividirse entre "expertos" y "memoria condicional". El modelo Engram de 27B logró MMLU +3,4, BBH +5,0 y HumanEval +3,0 en comparación con líneas base MoE con el mismo número de parámetros y FLOPs. Según el análisis del mecanismo, la memoria condicional libera las capas iniciales del reensamblaje estático de conocimiento.
La escasez aprendible de forma nativa se convierte en estándar. V4.1 aprende atención escasa en 64K desde el principio, sin calentamiento denso. Esto demuestra que la atención escasa ha pasado de ser una aproximación en tiempo de inferencia a ser un ciudadano de primera clase en tiempo de entrenamiento.
Escasez × computación en tiempo de inferencia. Los modelos de razonamiento generan salidas largas y hacen que tanto el prefill como el decode sean costosos. MoE proporciona capacidad de conocimiento, mientras que las cadenas de pensamiento largas proporcionan profundidad de razonamiento. La activación asimétrica de CED es un tradeoff para cargas de trabajo con diferentes ratios de lectura-escritura.
Modularidad y aprendizaje continuo. Los expertos y tablas de memoria se pueden editar localmente. Por ejemplo, hay investigación sobre escribir la memoria de los usuarios como edición de parámetros locales (User as Engram, arXiv:2606.19172).
Combinación de escasez y cuantización. Expertos MXFP4, KV en FP4, Engram en FP8 ya se usan conjuntamente en V4.1 y K3. La conclusión de Q-Sparse es que cuanto más agresiva es la cuantización, mayor es el grado óptimo de escasez.
Diseño cooperativo con hardware. Blackwell admite FP4 de forma nativa, y el almacenamiento KV jerárquico con grupos de memoria CXL y SSD está avanzando. La informática neuromórfica a escala de LLM sigue siendo una perspectiva distante.
Cinco predicciones refutables (con fundamento)
| Predicción | Plazo | Fundamento |
|---|---|---|
| Al menos uno de los principales modelos abiertos tendrá una caché global KV que cae por debajo de 500 bytes por token | Finales de 2027 | De V1 a V4.1 es 437x, solo una generación de V4 a V4.1 es 4x, FP4 ya está en uso |
| Al menos 3 de los 5 principales modelos abiertos tendrán una tasa de activación por token inferior al 3% | Finales de 2027 | Ya en 2026 existen V4.1 (2,9%), K3 (3,7%), Qwen3.5 (4,3%), y el número de expertos se ha duplicado cada generación |
| Al menos 2 instituciones de investigación principales fuera de DeepSeek introducirán memoria condicional tipo tabla de búsqueda en sus modelos abiertos insignia | 2028 | Engram ya tiene derivadas sin entrenamiento, CXL, SSD, y también se incluyó en NeMo |
| SAE no se convertirá en el principal método de supervisión de seguridad en tiempo de ejecución oficialmente anunciado en ninguna institución de investigación de frontera | 2028 | Reducción de prioridad en GDM. Resultados negativos en tareas descendentes |
| El precio de API por unidad de capacidad equivalente continúa cayendo a un ritmo de más de 10x por año, pero el gasto del agente por tarea de la empresa aumenta | En curso | Tendencias de precios de Epoch. Duplicación en el número de llamadas de agentes |
Lo que significa para nosotros
La revisión es esencialmente una tarea de seleccionar top-K entre innumerables disposiciones y páginas, y la tendencia de escasez está deprimiendo precisamente el precio unitario de este tipo de tareas. Hay cuatro implicaciones prácticas para las empresas que desarrollan agentes de revisión para documentos largos y multimodales.
Curvas de costo. Trate "tasa de acierto de caché" y "proporción de procesamiento por lotes fuera de horas pico" como métricas de primera clase. Las tareas de revisión son inherentemente batcheable y se pueden ejecutar sin conexión. Coloque la legislación y regulaciones estables al comienzo del prompt para maximizar los aciertos de caché de prefijos. El precio de entrada en caché en V4.1 es 1/50 del de un fallo de caché, y fuera de horas pico es la mitad más.
Selección de modelo. Seleccione modelos usando su propio conjunto de evaluación para "cotejo entre páginas y citas de disposiciones", e juzgue por la puntuación de la subtarea más difícil, no por el promedio. Use modelos MoE abiertos altamente escasos como su caballo de batalla principal, y modelos de frontera cerrados para verificación doble de casos difíciles.
Estrategia de contexto largo. Adopte un híbrido de "búsqueda de top-K páginas (auditable y con citas) + reverificación en contexto 1M (para no perder relaciones entre páginas)". La conclusión de Sparse Frontier se aplica directamente aquí. Apostar solo en atención escasa causa caídas de rendimiento en algunos trabajos, y la revisión es precisamente una "tarea donde fallar en ver algo hace que toda la respuesta sea incorrecta".
Decisión sobre auto-hosting. La memoria MoE se determina por parámetros totales. Los expertos de enrutamiento y tabla Engram de V4.1 superan 440 GiB combinados, y el procedimiento oficial de fine-tuning requiere 64 GPUs dentro de un único dominio NVLink. En escalas menores a decenas de GPUs, primero no será rentable, así que elija API.
Oportunidades de investigación. La investigación existente trata "qué página verificar dentro del presupuesto" como un problema de búsqueda. Sin embargo, en la verificación cruzada de consistencia entre páginas, el objeto verdaderamente escaso no es "páginas" sino "pares de páginas". Con P páginas hay P(P−1)/2 pares, y se seleccionan k pares para verificación cruzada entre ellos. Esto corresponde directamente a un gráfico de cooperación escasa en sistemas multiagente, y es isomorfo a la idea de DSA de puntuar todos los pares (consulta, clave) con un indexador ligero y tomar los k principales. Esta es la dirección en la que podemos diferenciarnos y avanzar.
Apéndice
A. Cronología (1948–septiembre de 2026)
| Año | Evento | Confiabilidad |
|---|---|---|
| 1948 | Shannon, A Mathematical Theory of Communication: formalización de redundancia y entropía | Documento primario |
| 1961 | Hipótesis de reducción de redundancia de Barlow | Documento primario |
| 1967 | Ordenamiento de matriz escasa de Tinney & Walker (cálculo de redes eléctricas) | Documento primario |
| 1978 | Longitud de descripción mínima (MDL) de Rissanen | Documento primario |
| 1987 | Field: estadísticas de imágenes naturales y campos receptivos corticales | Documento primario |
| 1988–89 | Wavelets ortogonales con soporte compacto de Daubechies. Análisis de multiresolución de Mallat | Documento primario |
| 1990–93 | Poda OBD / OBS. Matching Pursuit | Documento primario |
| 1991 | Mezcla de expertos locales de Jacobs–Jordan–Nowlan–Hinton | Documento primario |
| 1992 / 2000 | JPEG / JPEG2000 | Estándar |
| 1994–96 | Wavelets con umbral de ruido. Garrote de Breiman. LASSO. Codificación escasa de Olshausen & Field | Documento primario |
| 1998 | Basis Pursuit. Aproximación no lineal de DeVore | Documento primario |
| 2001–03 | Balance energético de Attwell & Laughlin. "Probablemente menos del 1%" de Lennie | Documento primario (verificado) |
| 2004–05 | LARS。Elastic Net | Documento primario |
| 2006–07 | Compressive Sensing. K-SVD. CS-MRI de Lustig | Documento primario |
| 2009 | Transición de fase Donoho–Tanner | Documento primario |
| 2011 | ReLU de Glorot (ceros estrictos 50–85%). Análisis de componentes principal robusto | Documento primario (verificado) |
| 2012 | Neurona de cara de gato de Google | Documento primario (verificado) |
| 2013–14 | Computación condicional de Bengio y STE. Umbral duro óptimo de Gavish–Donoho | Documento primario |
| 2016 | Deep Compression | Documento primario |
| 2017 | MoE de puerta escasa de Shazeer (capa MoE de 137B) | Documento primario (verificado) |
| 2019 | Hipótesis de la lotería. EHT M87*. Investigación clínica CS-MRI de Sarroretti | Documento primario |
| 2020 | GShard. Hardware Lottery de Hooker. Ampere 2:4 | Documento primario |
| 2021–22 | Switch Transformer. GLaM. ST-MoE. Expert Choice. Escalado MoE de Clark | Documento primario |
| 2023 | Mixtral。SparseGPT / Wanda。StreamingLLM / H2O。Towards Monosemanticity | Documento primario |
| Enero–febrero de 2024 | DeepSeekMoE. Gemini 1.5 confirma oficialmente que es MoE | Informe técnico |
| Mayo de 2024 | DeepSeek-V2 (MLA)。Scaling Monosemanticity。Golden Gate Claude | Informe técnico |
| Junio–julio de 2024 | TopK SAE de Gao. Q-Sparse | Documento primario (verificado) |
| Diciembre de 2024 | DeepSeek-V3 (671B/37B) | Informe técnico |
| 27 de enero de 2025 | Shock DeepSeek: capitalización de mercado de Nvidia cae aproximadamente $589 mil millones en un día | Reportaje confiable |
| Febrero–marzo de 2025 | NSA, MoBA. Beneficio teórico de sistema de razonamiento 545%. GDM reduce prioridad de SAE | Documento primario / Oficial |
| Abril de 2025 | Qwen3 MoE. Preimpresión de Sparse Frontier. Llama 4 | Oficial / Documento primario |
| Julio–agosto de 2025 | NSA gana Best Paper en ACL. Kimi K2. gpt-oss | Oficial |
| Septiembre–diciembre de 2025 | DeepSeek-V3.2、DSA | Informe técnico |
| Enero de 2026 | Engram: memoria condicional y asignación de presupuesto de escasez en forma de U | Documento primario |
| Febrero de 2026 | Qwen3.5-397B-A17B | Tarjeta de modelo oficial |
| 24 de abril de 2026 | DeepSeek-V4 (Pro 1.6T/49B、Flash 284B/13B) | Informe técnico |
| Julio de 2026 | Kimi K3 (2.8T/104B). Sparse Frontier publicado en Findings of ACL 2026 | Oficial |
| 10 de septiembre de 2026 | DeepSeek-V4.1-Flash (CED, CSA2, 890 B/token, Engram) | Oficial + Informe técnico (verificado) |
B. Series de datos que se pueden graficar
Caché global KV de DeepSeek (por token): V1 ≈ 389 KB (estimado) → V3.2 ≈ 48 KB → V4-Flash ≈ 3.5 KB → V4.1-Flash 890 B. Escala logarítmica.
Tasa de activación por token: Mixtral 28% → Qwen3 9,4% → gpt-oss 4,4% → Qwen3.5 4,3% → Kimi K3 3,7% → V4.1 decode 2,9% / prefill 1,4%.
Número de expertos (seleccionados / total): 2/8 → 4/128 → 8/256 → 6/384 → 10/512 → 16/896.
Precio de API de DeepSeek ($/M, entrada / salida): V4-Flash 0.14 / 0.28. V4-Pro 1.74 / 3.48 (salida en hora punta después de agosto 3.96). V4.1-Flash es 0.30 / 1.20 en hora punta, 0.15 / 0.60 en hora valle, caché 0.006.
Sparse Frontier: Tasa de dispersión óptima en prefill 0.80–0.93. La decodificación es práctica incluso a 0.95. Intersección 32–64K.
Tasa de dispersión de Glorot 2011: MNIST 83.4%, CIFAR10 72.0%, NISTP 68.0%, NORB 73.8%.
Q-Sparse: Tasa de dispersión óptima 45.58% (precisión completa) / 61.25% (1.58 bits). Alrededor del 40% equivale a modelos densos.
Diferencia de Engram-27B respecto a la línea base MoE: MMLU +3.4, CMMLU +4.0, BBH +5.0, ARC-C +3.7, HumanEval +3.0, MATH +2.4.
CS-MRI: Tiempo de escaneo −20.2%, tiempo de examen −16%, secuencia única −23% a −43%, número de exámenes +27%.
Rendimiento de cálculo y ancho de banda de GPU: Consulte la tabla de GPU en la era de las redes neuronales.
C. Anécdotas y material de historias
Cómo el "1% de Lennie" se convirtió en "1–4%": Útil como introducción para aclarar malentendidos.
Neurona de cara de gato (2012): 1,000 máquinas tardaron 3 días en aprender independientemente "gato" de fotogramas de YouTube.
Outrageously (2017): La historia de cómo la capa MoE de 137B de la era LSTM predijo el panorama de 2026. La coautoría de Hinton y Dean simboliza "ideas antiguas de 1991 × recursos computacionales de Google".
DeepSeek Shock (27 de enero de 2025) y la palabra "teórico" con un aumento del 545%.
Golden Gate Claude (2024) y el frenado repentino de GDM (marzo de 2025).
CS-MRI: La historia de cómo el tiempo que el paciente pasa acostado en la mesa del escáner se redujo en un 20%, y el hospital puede realizar ahora un 27% más exámenes.
437 en 1: La historia de cómo la "memoria" por token se redujo de aproximadamente 389 KB a 890 bytes.
El retorno de N-gramas: La historia de cómo los modelos de lenguaje estadísticos, sepultados en el pasado, regresaron a la frontera como Engram.
D. Malentendidos comunes y sus correcciones
| Expresión común | Descripción exacta |
|---|---|
| El cerebro utiliza solo el 1–4% de las neuronas | La descripción real de Lennie 2003 es "probablemente menos del 1%", una estimación del límite superior basada en energía. 1–4% es una cita secundaria a través de Glorot 2011 |
| Las redes ReLU son 90% dispersas | Glorot 2011: aproximadamente 50% en la inicialización, 50%–85% después del aprendizaje |
| GPT-4 es una MoE de 1.8T con 16 expertos | Un rumor de 2023 que OpenAI nunca ha confirmado. La configuración de GPT-5.x y Claude es igualmente privada |
| CS-MRI acelera los escaneos en un 30–60% | Sartoretti 2019: tiempo de escaneo medio −20.2%, secuencia única −23% a −43% |
| Shazeer 2017: "mayor que 1000x" | El texto original es "greater than 1000x (más de 1000 veces)". 137B es el número de parámetros de la capa MoE |
| Sparse Frontier fue presentada en ICML 2025 | Formalmente publicada en Findings of ACL 2026 |
| El margen de ganancia de DeepSeek es del 545% | Margen de ganancia de costo teórico según reportes propios. En realidad es mucho menor, excluyendo gastos de I+D y costos de aprendizaje |
| MLA es atención dispersa | MLA es compresión de bajo rango. Lo que es realmente disperso es DSA / CSA2 |
| La atención dispersa puede comprimir sin límite | Casi todas las configuraciones pierden rendimiento significativamente en al menos una tarea |
E. Referencias
Fundamentos clásicos: Shannon 1948; Barlow 1961; Tinney & Walker 1967; Rissanen 1978; Field 1987; Mallat 1989; LeCun, Denker & Solla 1990; Jacobs, Jordan, Nowlan & Hinton 1991; Mallat & Zhang 1993; Donoho & Johnstone 1994 (Biometrika); Breiman 1995; Tibshirani 1996 (JRSS-B); Olshausen & Field 1996 (Nature); Chen, Donoho & Saunders 1998; DeVore 1998; Attwell & Laughlin 2001; Lennie 2003 (Curr. Biol.); Efron et al. 2004; Zou & Hastie 2005; Candès, Romberg & Tao 2006; Donoho 2006; Aharon, Elad & Bruckstein 2006; Lustig, Donoho & Pauly 2007; Lee, Battle, Raina & Ng 2007; Donoho & Tanner 2009; Glorot, Bordes & Bengio 2011; Candès, Li, Ma & Wright 2011; Le et al. 2012; Bengio et al. 2013; Gavish & Donoho 2014; Han, Mao & Dally 2016; Shazeer et al. 2017; Frankle & Carbin 2019; Sartoretti et al. 2019; Vranic et al. 2019; Hooker 2021 (CACM); Fedus, Zoph & Shazeer 2021; Clark et al. 2022.
2023–2026: Frantar & Alistarh 2023 (SparseGPT); Sun et al. 2023 (Wanda); Xiao et al. 2023 (StreamingLLM); Bricken et al. 2023; Jiang et al. 2024 (Mixtral); Dai et al. 2024 (DeepSeekMoE); DeepSeek-AI 2024 (V2, V3); Templeton et al. 2024; Gao et al. 2024; Wang et al. 2024 (Q-Sparse); Krajewski et al. 2024; Yuan et al. 2025 (NSA); Nawrot et al. 2025/2026 (Sparse Frontier); Kantamneni et al. 2025; OpenAI 2025 (gpt-oss); Google DeepMind 2025 (Gemini 2.5 Technical Report, arXiv:2507.06261); Moonshot 2025/2026 (Kimi K2, K3); Alibaba 2026 (Qwen3.5); Cheng et al. 2026 (Engram, arXiv:2601.07372); DeepSeek-AI 2026 (V4, arXiv:2606.19348); DeepSeek-AI 2026 (V4.1-Flash, arXiv:2609.19969); Ma et al. 2024 (MMLongBench-Doc).
Libros de texto y encuestas: Elad, Sparse and Redundant Representations (2010); Hastie, Tibshirani & Wainwright, Statistical Learning with Sparsity (2015); Mallat, A Wavelet Tour of Signal Processing (3.ª ed.); Foucart & Rauhut, A Mathematical Introduction to Compressive Sensing (2013); Hoefler et al. 2021, Sparsity in Deep Learning; Cai et al. 2024, A Survey on Mixture of Experts.
Leído
Siguiente lectura ↓