Research
Modèles creux : origines, importance et frontières des LLM pour l'avenir
Product
Career
Traduction automatique du texte original en japonais
Overview
En 2026, la parcimonie (sparsity) n'est plus une « technique d'optimisation optionnelle ». C'est une contrainte architecturale par défaut dans les modèles de grande taille de classe frontière, et elle détermine à la fois le coût opérationnel des grands modèles et la précision de lecture des agents traitant de longs documents. La preuve la plus directe est DeepSeek-V4.1-Flash, publié le 10 septembre 2026. Bien que le squelette possède 552B paramètres, seuls 8B sont activés par jeton lors du remplissage et 16B lors du décodage, et le cache KV global résidant en mémoire GPU est comprimé à 890 octets par jeton, soit 1/437 de celui de DeepSeek-V1 (annonce officielle DeepSeek, rapport technique arXiv:2609.19969).
3 points clés
La généalogie de la parcimonie est continue. Du « codage parcimonieux du cerveau » de Barlow et Olshausen–Field, en passant par « la parcimonie calculable » avec les ondelettes, LASSO et la compression comprimée, jusqu'à « la parcimonie en tant qu'architecture » avec MoE, l'attention parcimonieuse et la mémoire conditionnelle. À la base se trouve toujours la même a priori : « seul un très petit nombre de composantes sont vraiment importantes ». Ce qui est commun aux trois généalogies réussies, c'est que le motif de parcimonie s'adaptait au matériel. L'élagage pondéral non structuré a échoué non pas à cause de la théorie, mais à cause du matériel.
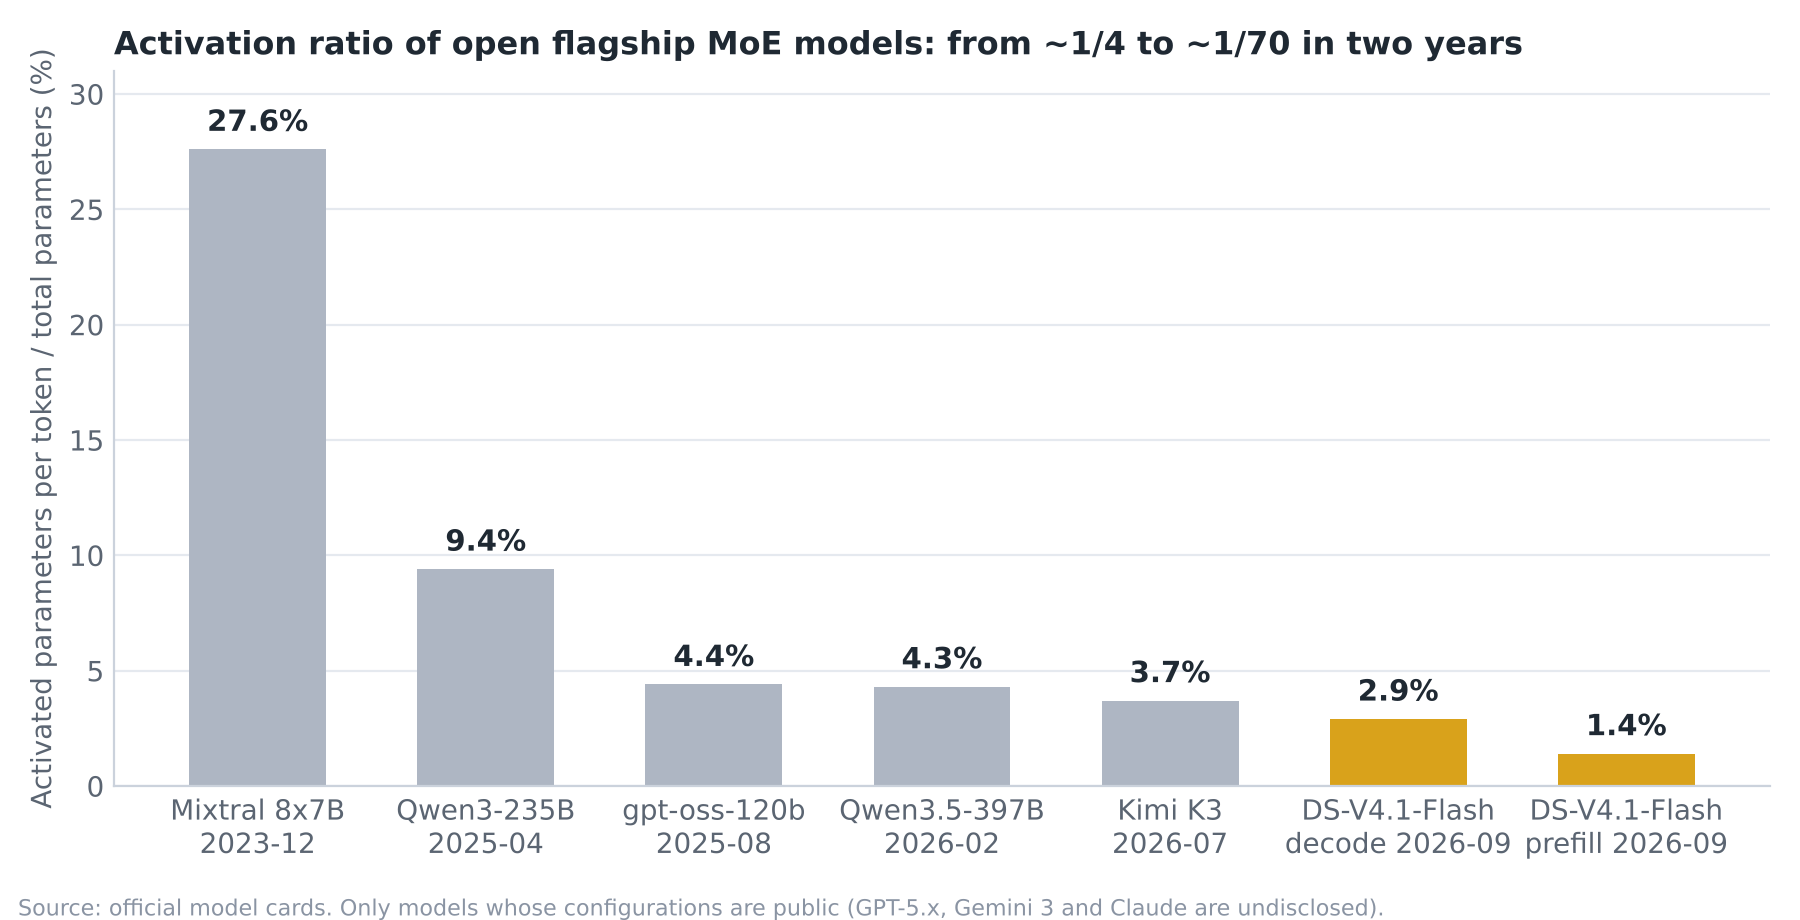
Pourquoi maintenant. L'expansion a beurté le mur du coût d'inférence et de la mémoire, et les agents traitant de longs contextes ont fait du cache KV et du remplissage des coûts dominants. En conséquence, le rôle de la parcimonie s'est élargi de « l'économie de calcul » à « l'économie de mémoire, de bande passante et de stockage ». Le MoE dominant de 2024 activait environ 25% des paramètres par jeton (Mixtral), mais en 2026 cette proportion est tombée à 1,5%–4,5% (DeepSeek-V4.1, Kimi K3, Qwen3.5).
La parcimonie n'est pas une panacée. L'évaluation à plus grande échelle jamais réalisée sur l'attention parcimonieuse (Nawrot et al., Findings of ACL 2026) montre que pratiquement toute configuration parcimonieuse provoque une dégradation importante des performances sur au moins une tâche. Dans le domaine de l'interprétabilité aussi, les auto-encodeurs parcimonieux (SAE) ont fait face à des résultats systématiquement négatifs en 2025. La sélection du modèle doit se faire non pas sur le score moyen, mais sur le score de la tâche la plus difficile pour votre entreprise.
Deux axes traversant cet article
Cinq types de parcimonie : parcimonie d'activation, parcimonie pondérale, parcimonie structurée, calcul conditionnel (MoE) et parcimonie d'attention. Le débat « la parcimonie est-elle utile ? » ne peut commencer que si vous identifiez quel type vous traitez.
Trois opérateurs : seuillage doux (l'opérateur proximal L1), seuillage dur (L0) et projection top-k (projection sur la sphère L0). Du débruitage par ondelettes en 1994 au routage MoE en 2026, l'étape « créer des zéros » n'applique que l'un de ces trois opérateurs à des cibles différentes. Presque tous les grands modèles modernes utilisent le troisième. Car il permet de fixer précisément le nombre d'opérations par jeton et de s'aligner avec la granularité de parallélisme du matériel.
Cinq termes qui apparaissent régulièrement dans l'ensemble du texte
| Terme | En un mot |
|---|---|
| Jeton | L'unité minimale de texte traitée par le modèle. Un mot ou une partie d'un mot. « Combien de paramètres sont activés par jeton ? » signifie combien de calcul est utilisé chaque fois que le modèle produit un peu de texte |
| Paramètres et paramètres activés | Les paramètres sont l'ensemble des nombres que le modèle retient (ce qu'il sait). Les paramètres activés sont la partie réellement utilisée dans le calcul lors du traitement d'un jeton (combien cela coûte de faire fonctionner). La parcimonie consiste à dissocier ces deux |
| Base et coordonnées | Un ensemble de « blocs de construction ». Les données peuvent être écrites comme leur somme pondérée, les poids correspondant aux coordonnées. Changer les blocs change aussi le système de coordonnées. Même si les données sont les mêmes, les valeurs lues changent |
| Norme | L2 est la longueur, L1 est la somme des valeurs absolues des composantes, L0 est le nombre de composantes non nulles. La parcimonie signifie que L0 est petit |
| FLOPs et bande passante mémoire | Le débit de calcul est le nombre d'opérations de multiplication-accumulation par seconde, la bande passante est le nombre d'octets que la mémoire GPU peut transférer par seconde. Au stade du décodage des grands modèles modernes, le goulot d'étranglement est généralement le second |
Note sur la terminologie : dans cet article, nous utilisons « parcimonieux » au sens strict de « la plupart des éléments sont zéro ». « Bas rang » signifie « aucun élément n'est zéro, mais le degré de liberté est petit » (comme MLA ou LoRA). Bien que les deux soient souvent confondus, cet article les distingue systématiquement.
Comment lire cet article
Cet article progresse chronologiquement et répond aux mêmes 4 questions pour chaque époque : quel était le contexte et le goulot d'étranglement de l'époque ? Comment la parcimonie s'est-elle manifestée ? Qu'a-t-elle résolu et qu'a-t-elle coûté ? Comment cela se connecte-t-il aux grands modèles d'aujourd'hui ? Dans le chapitre « Préhistoire », nous explorons pourquoi le monde est parcimonieux. Dans le « Monde classique », nous montrons comment les mathématiques l'ont transformé en outil, et dans le chapitre « Ère des réseaux de neurones », nous expliquons pourquoi l'élagage a échoué quand la parcimonie a été apportée aux réseaux de neurones. Le chapitre central « Présent » traite de la raison pour laquelle les grands modèles ont entièrement changé de cap vers la parcimonie entre 2023 et 2026, et compare systématiquement les approches de chaque institution de recherche. Dans « Où la parcimonie et l'apprentissage profond se rencontrent », nous explorons la fusion entre la parcimonie en traitement d'images et de signaux et l'apprentissage profond. Les chapitres « Applications », « Avantages et coûts », « Avenir » et « Qu'est-ce que cela signifie pour nous ? » traitent des applications, des coûts, du futur et ce que tout cela signifie pour nous. Les appendices rassemblent une chronologie, des données, des anecdotes et des références.
Préhistoire : pourquoi le monde lui-même est parcimonieux
La parcimonie n'est pas une propriété des données seules, mais une propriété de la paire « données et sa description ». Le monde devient parcimonieux sous une base appropriée. Et l'histoire de la science est aussi l'histoire de la recherche de cette base. Ce chapitre présente trois types de preuves empiriques et une source de pensée, puis indique clairement les limites.
Philosophie et théorie de l'information : intuition et cadre, non l'origine technique
Le rasoir d'Occam est un principe philosophique qui privilégie la simplicité, non le point de départ technique des modèles parcimonieux. Shannon (1948) a quantifié la « redondance ». La partie de la longueur de code dépassant l'entropie de la source est redondance compressible, et une représentation parcimonieuse est essentiellement une base qui rend cette redondance visible. La complexité de Kolmogorov (années 1960) a présenté l'idéal d'une « description la plus courte », mais elle est non calculable. La MDL de Rissanen (Minimum Description Length, 1978) l'a transformée en critère pratique pour la sélection de modèles. Un modèle parcimonieux peut se lire comme un cas particulier de MDL. Longueur de description ≈ nombre de composantes non nulles × coût d'encodage par coefficient. Ces idées doivent être écrites non pas comme des « inventeurs de modèles parcimonieux », mais comme une « préhistoire intellectuelle ».
Trois preuves de la nature
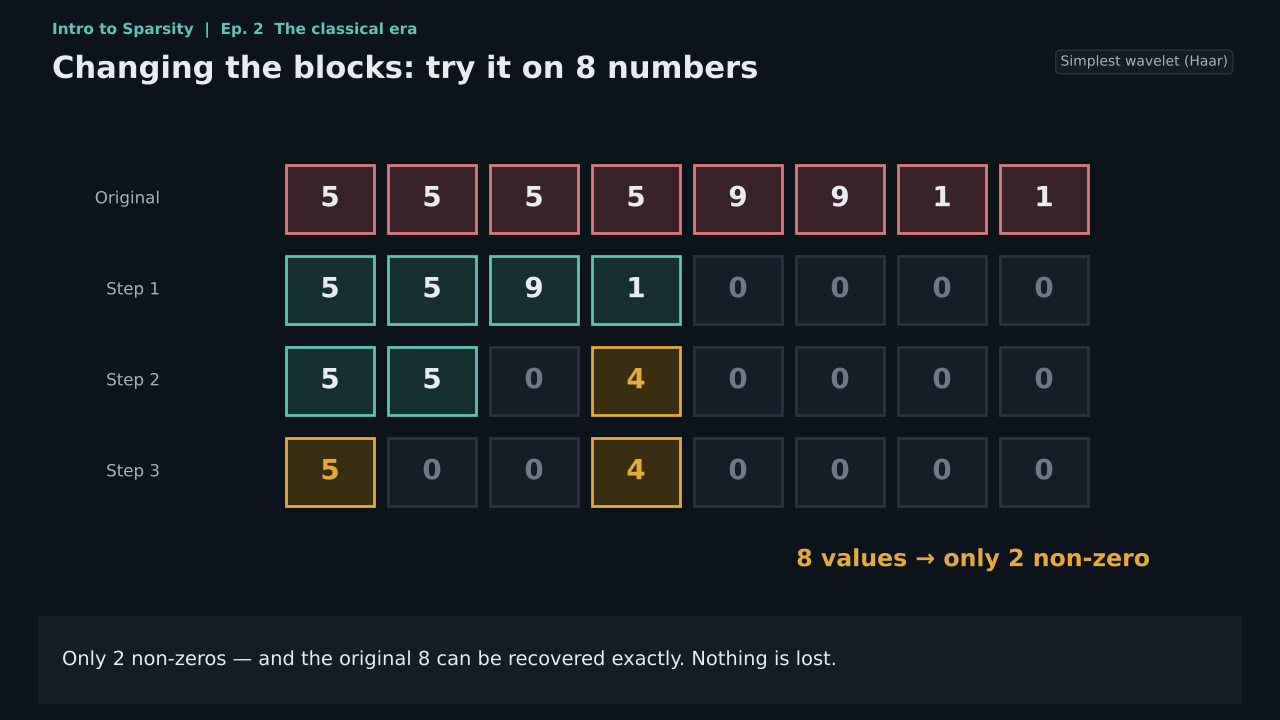
Images naturelles. Le spectre de puissance des images naturelles suit approximativement une loi de puissance 1/f² et montre une invariance d'échelle approximative (Field 1987; Ruderman & Bialek 1994; voir Simoncelli & Olshausen 2001 pour une revue). Avec des bases locales et passe-bande comme les ondelettes, les coefficients des images naturelles deviennent à queue lourde. La plupart sont proches de zéro, seul un petit nombre à proximité des arêtes sont grands. La théorie de l'approximation non linéaire (DeVore 1998; Donoho 1993) prouve que pour les signaux lisses par morceaux, l'erreur de la meilleure approximation à n termes dans une base d'ondelettes décroît plus rapidement que dans toute base linéaire fixe. Ceci est la base théorique à la fois de JPEG2000 et de la compression comprimée, et l'exemple de Haar dans la figure 3 est la plus petite démonstration de cela.
Langage. La fréquence des mots suit la loi de Zipf. Une poignée de mots dominent la plupart des occurrences, la queue est extrêmement longue. C'est pourquoi les représentations bag-of-words ou TF-IDF sont extrêmement parcimonieuses. La même statistique explique aussi pourquoi la charge sur les experts MoE est intrinsèquement biaisée, et pourquoi DeepSeek utilise une table de consultation d'N-grammes comme mémoire conditionnelle (Engram).
Cerveau. Barlow (1961) a proposé l'hypothèse de réduction de la redondance. L'objectif du système sensoriel est de supprimer la redondance et de construire une représentation statistiquement indépendante, hypothèse qui est la source neuroscientifique du codage parcimonieux. Attwell & Laughlin (2001) ont calculé le bilan énergétique de la substance grise, et à partir de là Lennie (2003, Current Biology 13:493–497) a estimé que « le nombre de neurones pouvant être substantiellement actifs simultanément est probablement limité à bien moins de 1% ».
Il y a une chose que je dois absolument corriger ici. L'affirmation largement répandue selon laquelle « le cerveau n'utilise que 1 à 4% des neurones » est un citation d'une citation. Quand Glorot, Bordes et Bengio (2011) ont cité Lennie, ils ont écrit « 1-4% », et ce chiffre a été reproduit depuis. Le texte original de Lennie dit « probablement moins de 1% », et c'est une estimation théorique du limite supérieure dérivée de contraintes énergétiques, pas une mesure. La parcimonie signifie « une faible proportion de neurones tirant fortement à un moment donné », non « une grande partie du cerveau qui traîne ».
Limites et contre-exemples
Parcimonieux n'est pas bas rang. Parcimonieux signifie peu de coefficients non nuls sous une certaine base ou dictionnaire (mesuré en L0/L1). Bas rang signifie peu de valeurs singulières de la matrice (mesuré en rang ou norme nucléaire). LoRA et MLA sont bas rang, MoE, attention top-k et SAE sont parcimonieux. L'SVD tronqué donne une matrice bas rang, et ce qui est parcimonieux là-dedans est seulement le spectre des valeurs singulières.
Le monde n'est pas toujours sparse. La PCA Robuste (Candès, Li, Ma & Wright 2011) décompose les données en « rang faible + sparse », montrant que les données réelles possèdent souvent les deux. Dans une vidéo, l'arrière-plan est de rang faible et l'avant-plan est sparse. Les signaux dominés par la texture ou le bruit ne sont pas sparse dans les bases couramment utilisées. La superposition des caractéristiques dans le flux résiduel des LLM signifie que la représentation est dense au niveau des neurones individuels et ne devient sparse que sous un dictionnaire surcomplété. Ceci est le point de départ de la discussion sur les SAE du chapitre « Maintenant » (section « Parcimonie en interprétabilité »).
Résumé du chapitre. La parcimonie est une distribution a priori réfutable, pas une vérité universelle. Elle mérite d'être prise en considération précisément parce qu'elle a été confirmée à plusieurs reprises dans les images naturelles, le langage et l'activité neuronale. Mais avant de parier, il faut impérativement se poser une question : sous quelle base est-ce sparse ?
Détails sur les trois preuves : pourquoi ces lois statistiques ?
D'où vient le spectre 1/f des images naturelles ? Il existe deux explications complémentaires. La première est l'invariance d'échelle. La taille des objets dans une scène naturelle varie sur plusieurs ordres de grandeur, et les statistiques de l'image restent inchangées qu'on zoome dedans ou dehors. Mathématiquement, cela force le spectre de puissance à suivre une loi de puissance. La deuxième est le modèle d'occlusion. Une scène est composée d'objets qui se chevauchent d'avant en arrière, les arêtes créent des discontinuités, et dans le domaine fréquentiel, les discontinuités apparaissent comme une queue décroissant lentement à haute fréquence. Les deux explications aboutissent à la même conclusion. Les images naturelles ne sont ni du « bruit aléatoire » ni « partout lisses », mais « des régions largement plates + peu d'arêtes ». C'est exactement la structure que la base d'ondelettes maîtrise le mieux. Field (1987) va plus loin en soulignant que si la largeur de bande des champs récepteurs des cellules simples du cortex visuel s'adapte à cette statistique, alors la réponse de chaque cellule aux images naturelles aura une queue lourde, c'est-à-dire qu'elle répondra peu la plupart du temps et parfois très fortement. C'est le sens original du terme « codage sparse » en neurosciences.
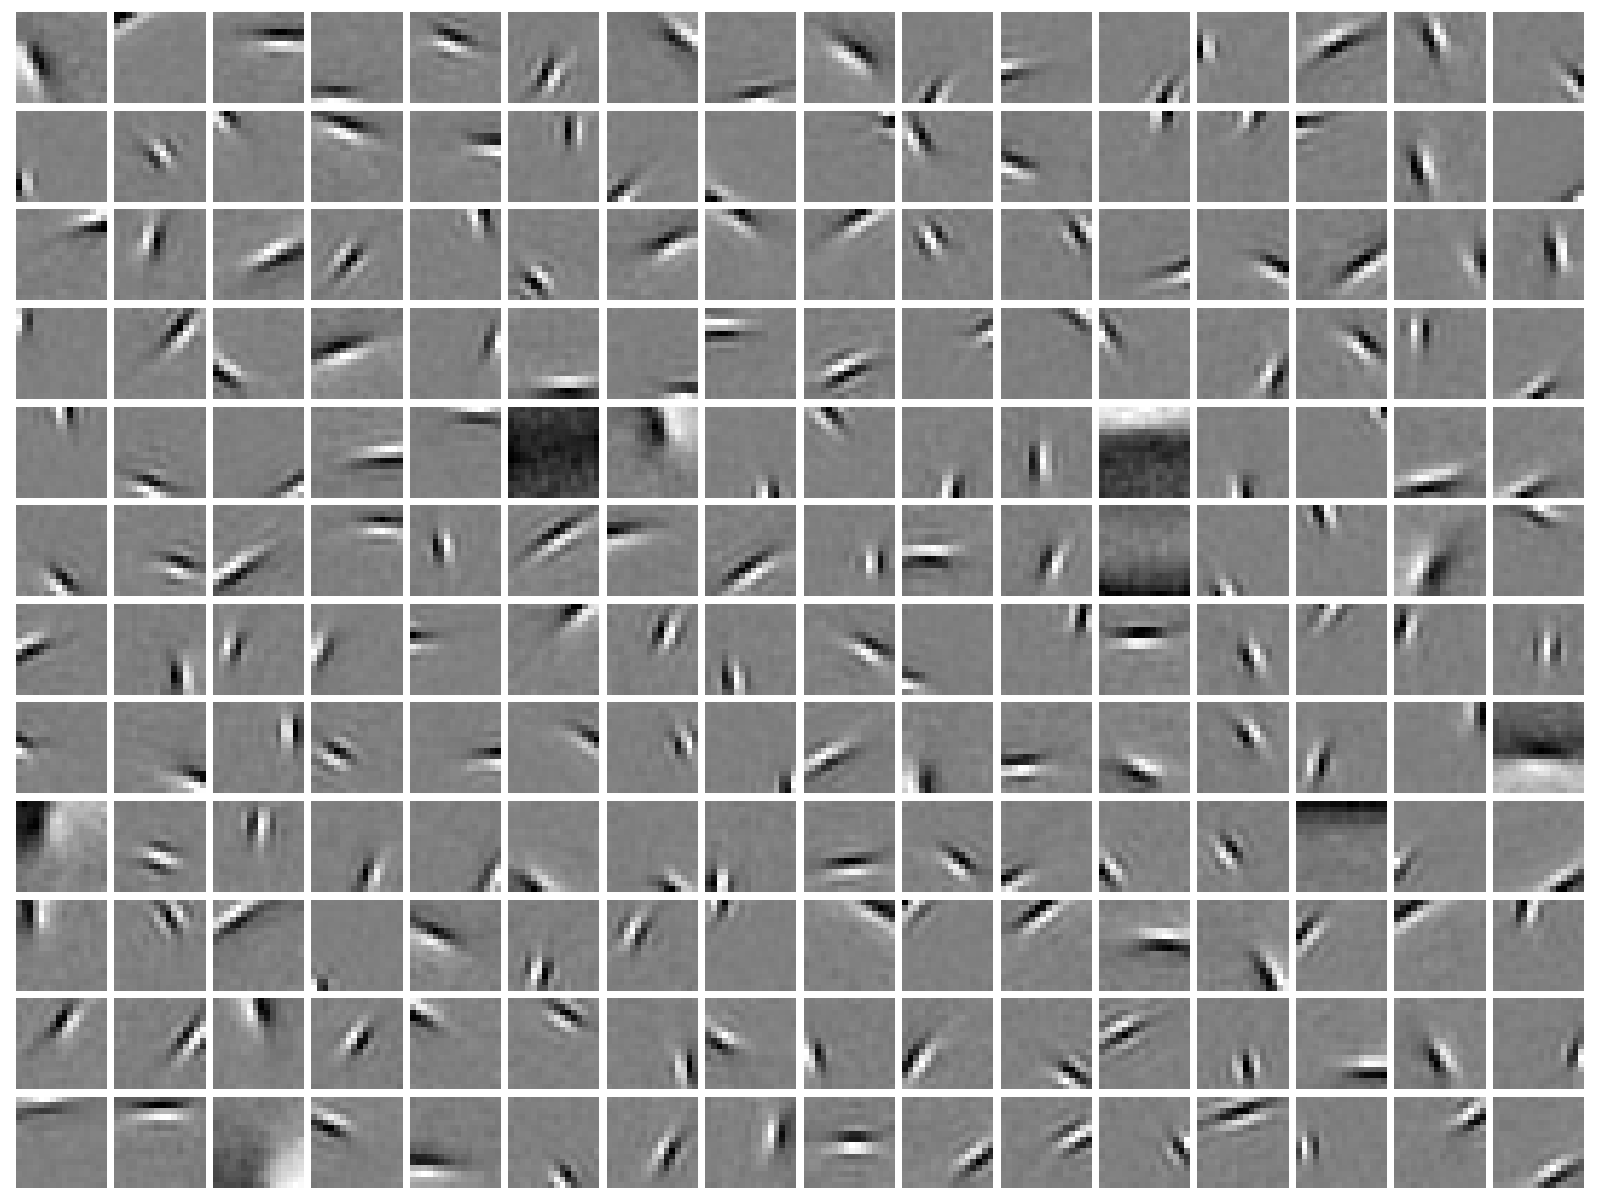
Pourquoi l'expérience d'Olshausen et Field est-elle si convaincante ? L'expérience de 1996 n'a imposé que deux contraintes à l'algorithme : reconstruire les patchs d'images naturelles avec un ensemble de fonctions de base linéaires, et rendre les coefficients aussi sparse que possible. Aucune connaissance préalable du cerveau. Pourtant, les fonctions de base apprises se sont avérées locales, sélectives pour l'orientation et en bande passante, ressemblant étroitement aux champs récepteurs des cellules simples de V1 chez le chat et le singe. La puissance de ce résultat réside dans sa directionnalité. Ce n'est pas un cas de « créer un algorithme inspiré par le cerveau », mais plutôt « le principe de parcimonie prédit indépendamment la structure du cerveau ». Plus tard, Hromádka, DeWeese, Zador (2008) ont enregistré des modèles de tir hautement sparse dans le cortex auditif de rats éveillés, et Quian Quiroga et al. (2005) ont découvert des « cellules conceptuelles » dans l'hippocampe humain réagissant sélectivement à des personnes ou des repères spécifiques. Tous deux sont considérés comme des preuves de l'hypothèse du codage sparse. Il existe des objections. Spanne et Jörntell (2015), par exemple, soutiennent que le codage sparse strictement dit n'est pas universel dans le cortex entier et que le degré de parcimonie dépend de la région du cerveau et de la tâche. Par conséquent, cela devrait être présenté comme « une hypothèse largement soutenue » et non comme un dogme établi.
Pourquoi l'énergie force-t-elle la parcimonie ? Le cerveau humain ne représente qu'environ 2% du poids corporel, mais consomme environ 20% du métabolisme au repos, soit environ 20 watts. Attwell et Laughlin (2001) estiment que la majorité de l'énergie de la substance grise est utilisée pour la transmission synaptique et les potentiels d'action. Lennie (2003) raisonne par l'absurde. Si chaque potentiel d'action coûte si cher, le cortex n'a pas les moyens de faire tirer un grand pourcentage de neurones à haute fréquence simultanément. Cet argument est une limite sous contrainte budgétaire, ce qui donne une estimation plutôt qu'une mesure précise : « probablement moins de 1% ». L'importance réside dans la logique plutôt que dans le chiffre exact. Dans les systèmes à ressources limitées en énergie ou en bande passante, la parcimonie n'est pas une option mais une nécessité. La même logique sera rejouée dans le chapitre « Ère des réseaux de neurones » comme le « mur mémoire » sur GPU.
La loi de Zipf en langage et la queue longue. Zipf (1935) a observé que la fréquence des mots est à peu près inversement proportionnelle à leur rang. Le deuxième mot le plus fréquent apparaît environ moitié moins souvent que le premier, le dixième environ 1/10 de fois plus souvent. Mandelbrot a donné une forme corrigée. Une conséquence directe est que tout texte n'utilise qu'une infime partie du vocabulaire, et la plupart des mots n'apparaissent qu'une ou deux fois. À l'ère des modèles de langage statistique, cela s'est manifesté par une matrice de fréquence de n-grammes extrêmement sparse et des problèmes de lissage de « probabilité zéro » (Good–Turing, Kneser–Ney). À l'ère des grands modèles, cela revient sous deux formes. L'une est que la charge de routage du MoE est intrinsèquement déséquilibrée : puisque les experts populaires traitent la plupart des jetons, un mécanisme d'équilibrage de charge doit intervenir. L'autre est l'Engram de DeepSeek. Il ressuscite les tables de consultation de n-grammes dans l'architecture de frontier, dirigeant les motifs fréquents vers des chemins de consultation bon marché, en ne laissant que ce qui nécessite vraiment une inférence aux couches Transformer coûteuses.
Parcimonie en physique et en ingénierie
L'histoire de la parcimonie est plus ancienne en ingénierie qu'en apprentissage automatique. En calcul scientifique, les matrices de coefficients de la méthode des éléments finis et des équations de flux de puissance sont intrinsèquement sparses. Chaque nœud n'est accouplé qu'aux nœuds adjacents. Tinney et Walker (1967) ont proposé un ordre optimal pour réduire le « remplissage » lors de l'élimination gaussienne lors de la résolution de systèmes électriques. C'est le point de départ des méthodes directes sparses. Rose (1972) a ensuite décrit le processus d'élimination en termes de théorie des graphes, Gilbert et autres ont développé la décomposition LU sparse, et l'algèbre linéaire sparse est devenue un domaine. En prospection sismique, les séquences de réflectivité souterraines sont modélisées comme des suites de pics sparses, et le problème de déconvolution peut être résolu par régularisation L1. C'est vingt ans avant la détection compressée. En traitement de signaux de réseau radar, les cibles sont distribuées sparsement dans l'espace des angles, distances et vitesses, et l'estimation de super-résolution utilise la récupération sparse.
Ce qui est commun à ces domaines, c'est que les modèles de parcimonie proviennent de structures physiques (adjacence, réflexions, nombre de cibles) et sont donc prévisibles et exploitables. C'est une continuation directe des ondelettes à l'« époque classique » (où la structure provient de la douceur par morceaux) et du MoE « maintenant » (où la structure provient des blocs d'experts), et explique aussi pourquoi la parcimonie des poids non structurée s'est effondée à l'« ère des réseaux de neurones ». Ces zéros ne possèdent aucune structure physique que le matériel pourrait exploiter.
Un miroir reflétant les phénomènes sociaux, et les limites de cette façon de penser
La loi 80/20 de Pareto, la queue longue d'Anderson, et la tradition d'analyse factorielle selon laquelle « un petit nombre de variables importantes expliquent la majorité de la variance » sont tous des reflets dans les sciences sociales d'une distribution a priori sparse. Ce qu'ils montrent, c'est que la parcimonie est une hypothèse sur la structure du monde, pas un théorème. Des statisticiens comme Gelman ont remis en question le « pari sur la parcimonie ». Ils soutiennent que dans de nombreux problèmes en sciences sociales, les vrais effets sont denses et petits, et les méthodes sparses les négligent systématiquement. La même critique s'applique à l'apprentissage automatique. Les caractéristiques du flux résiduel des LLM sont stockées densément par superposition, et la parcimonie n'apparaît que lors du passage à un dictionnaire surcomplété. Par conséquent, la position de cet article est la suivante : puisque la parcimonie a été confirmée à plusieurs reprises dans d'énormes quantités de données naturelles, c'est une distribution a priori digne de considération au départ. Cependant, à chaque pari, répondez à « sous quelle base est-ce sparse ? » et soyez prêt à l'abandonner si les preuves ne le soutiennent pas.
Époque classique (années 1960-2014) : comment la parcimonie est devenue un outil calculable
Les méthodes sparses réussies à l'époque classique ont un point commun : c'est précisément parce que les modèles de parcimonie étaient structurés et prévisibles qu'ils ont pu être intégrés dans le matériel et les normes industrielles. C'est aussi une ligne directrice pour la « défaite » racontée dans l'« ère des réseaux de neurones ». Le tableau ci-dessous organise les jalons en répondant à trois questions : pourquoi chaque technique a-t-elle émergé à cette période, quel était le goulot d'étranglement à l'époque, et qu'a-t-elle résolu ?
| Jalon | Pourquoi cela a émergé à cette époque | Goulot d'étranglement à l'époque | Ce qu'il a résolu |
|---|---|---|---|
| Méthodes directes pour matrices sparses (Tinney & Walker 1967) | Les réseaux électriques se sont agrandis, mémoire en unités de KB | L'élimination dense est O(n³) et ne rentre pas en mémoire | Stocker uniquement les éléments non nuls, réduire le remplissage par ordre optimal |
| Ondelettes (Daubechies 1988; Mallat 1989) | La base de Fourier n'est pas sparse pour les arêtes | L'énergie des arêtes se disperse dans tout le domaine fréquentiel | Les signaux lisses par morceaux deviennent sparse en domaine d'ondelette |
| Matching Pursuit (Mallat & Zhang 1993) | Émergence de dictionnaires surcomplétés | La représentation n'est pas unique | Sélection d'atomes par méthode glouton |
| Débruitage par seuillage d'ondelettes (Donoho & Johnstone 1994) | Les coefficients sont sparses, le bruit est uniforme | Les filtres linéaires flouttent aussi les arêtes | Seuillage doux = opérateur proximal de L1. Pratiquement optimal minimax |
| Garrote de Breiman 1995 → LASSO (Tibshirani 1996) | Données haute dimension p ≫ n | Les moindres carrés sont mal posés, la sélection de sous-ensembles instable | Réaliser simultanément la régularisation et la sélection de variables |
| Basis Pursuit (Chen, Donoho & Saunders 1998) | L'optimisation convexe s'est mûrie | L0 est NP-difficile | Relâchement convexe par L1 |
| Approximation non-linéaire (DeVore 1998) | Justification de l'optimalité de « garder les k plus grands » | L'approximation linéaire converge lentement | Théorie de la meilleure approximation par n termes |
| JPEG (1992) / JPEG2000 (2000) | Prolifération de l'imagerie numérique | Bande passante et stockage | Transformation sparse + quantification + codage entropique |
| LARS (Efron et al. 2004); Elastic Net (Zou & Hastie 2005) | Un algorithme de chemin efficace était nécessaire pour LASSO | Lent à résoudre, instable avec variables corrélées | Calculer tout le chemin de régularisation à la fois. L1 + L2 |
| Détection compressée (Candès–Romberg–Tao 2006; Donoho 2006) | La théorie sparse a rencontré la théorie des matrices aléatoires | L'échantillonnage était lié à la fréquence de Nyquist | Sous condition RIP, récupération de m ≳ k·log(n/k) mesures |
| K-SVD (Aharon, Elad & Bruckstein 2006) | Un dictionnaire apprenable était nécessaire | Les ondelettes fixes ne s'adaptent pas à des données spécifiques | Optimisation alternée du codage sparse et de la mise à jour du dictionnaire |
| Transition de phase Donoho–Tanner (2009) | Caractérisation des conditions de succès de L1 était nécessaire | Les bornes théoriques étaient trop relâchées | Transition de phase nette dans le plan (m/n, k/m) |
| Codage parcimonieux (Olshausen & Field 1996), algorithmes rapides (Lee, Battle, Raina & Ng 2007) | Réponse à l'hypothèse de Barlow | Pourquoi les champs récepteurs V1 sont-ils de type Gabor | Les dictionnaires parcimonieux reproduisent les champs récepteurs V1 |
| Neurone de chat-visage (Le et al. 2012) | Émergence de l'apprentissage distribué | Les caractéristiques d'ordre supérieur émergent-elles sans supervision | Présenté ci-après |
| Seuil dur de valeur singulière optimal (Gavish & Donoho 2014) | Un seuil de principe était nécessaire pour la débruitage de faible rang | Le rang tronqué était choisi empiriquement | Pour les matrices carrées, (4/√3)√n·σ si σ est connu, sinon 2,858 fois la médiane |
Le principe « miser sur la parcimonie » en statistique
Hastie, Tibshirani et Friedman ont énoncé le principe « bet on sparsity (miser sur la parcimonie) » dans The Elements of Statistical Learning. Si le vrai modèle est parcimonieux, L1 peut le trouver. S'il ne l'est pas, aucune méthode ne fonctionnera bien. D'où l'idée de miser sur la parcimonie. La statistique en haute dimension a quantifié précisément le coût. Pour reconstruire un vecteur k-parcimonieux en dimension p, n ≳ k·log p échantillons suffisent (Wainwright 2009). Le résultat correspondant en compression sentante est que m ≳ C·k·log(n/k) mesures aléatoires suffisent, et si la constante RIP δ₂ₖ < √2−1 ≈ 0,414 est satisfaite, L1 peut effectuer une reconstruction exacte (Candès 2008).
Trois cas réels (chiffres vérifiés)
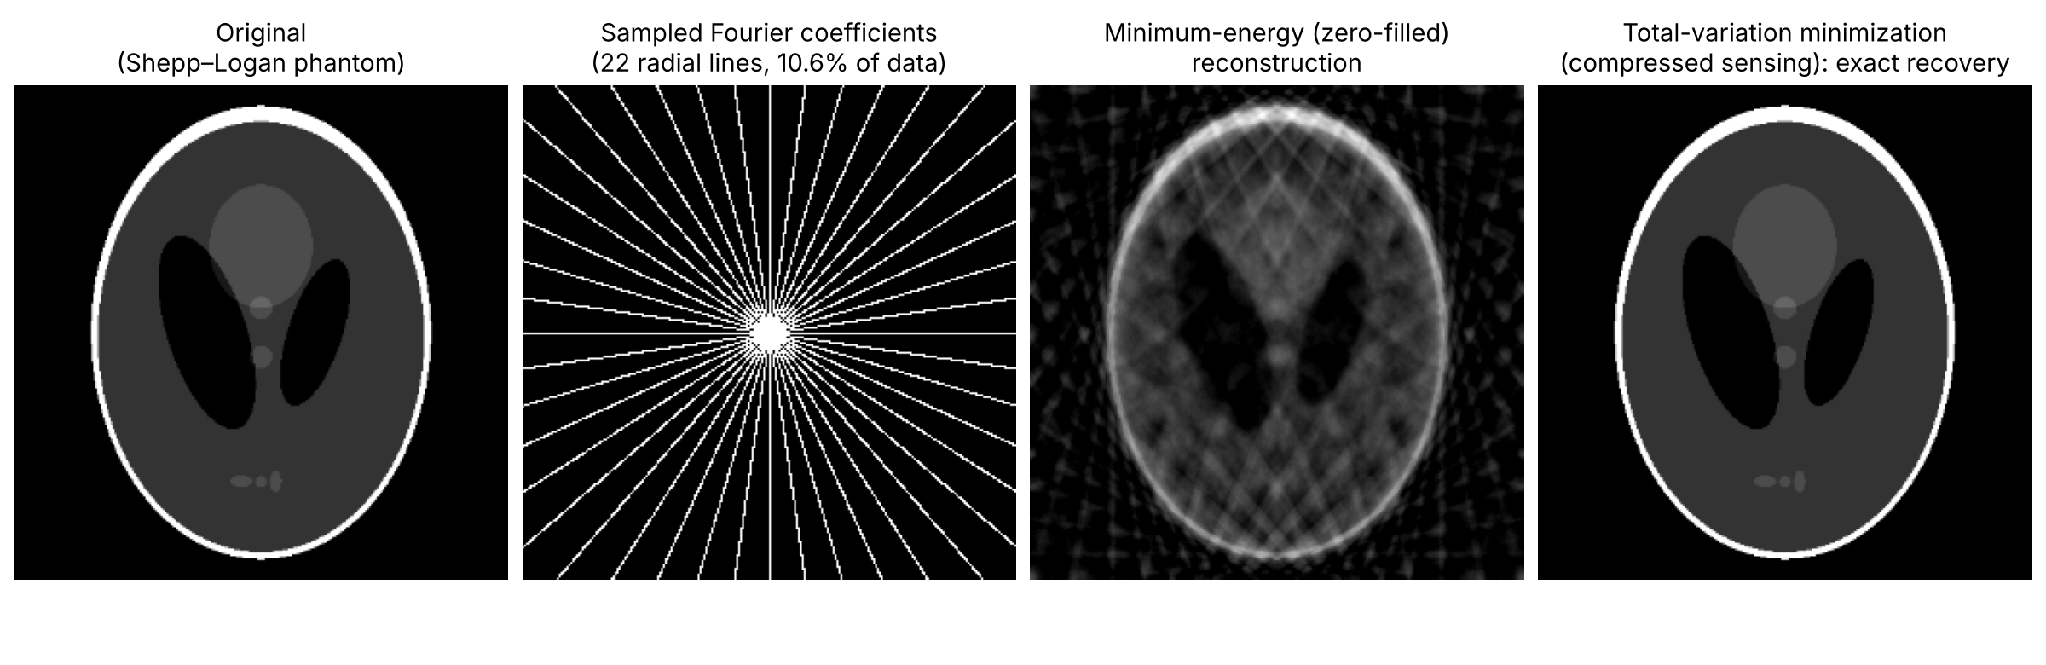
IRM-CS. Lustig, Donoho et Pauly (2007) ont établi les fondations de l'IRM par compression sentante. Les chiffres cliniques doivent être cités avec précision. Sartoretti et al. (2019, PLoS ONE 14(4): e0214887) ont rapporté une réduction moyenne du temps de balayage de 20,2%, du temps d'examen de 16%, du temps d'acquisition des séquences appliquées de 23 % à 43 %, et une augmentation de 27 % du nombre d'examens sur la même période en pratique clinique courante (source primaire). Vranic et al. (2019, AJNR 40(1):92–98) ont rapporté des réductions de 25 % et 35 % respectivement pour les séquences FLAIR et GRE du cerveau. L'affirmation souvent citée d'une accélération de « 30 % à 60 % » n'a pas de soutien dans les sources primaires.
Imagerie des trous noirs (EHT). SMILI, l'un des trois pipelines d'imagerie qui ont soutenu la première image de M87* en 2019, s'inscrit dans la lignée de la modélisation parcimonieuse (régularisation L1+TV) de Honma et al. (2014) et Akiyama et al. (2017). Un autre pipeline, CHIRP (Bouman et al. 2016), n'est pas de la compression sentante pure mais utilise des distributions a priori de patchs, et le reportage selon lequel « un chercheur a photographié un trou noir par compression sentante » est une simplification.
Neurone de chat-visage. Le et al. (2012, ICML, arXiv:1112.6209) ont entraîné un auto-encodeur parcimonieux à 9 couches et connexions locales avec environ 1 milliard de connexions sur 10 millions de frames de YouTube pendant « 3 jours sur 1 000 machines (16 000 cœurs) ». Sans supervision, un neurone unique émergeant sélectivement sensible aux visages humains et félins s'est développé, atteignant 15,8 % de précision sur ImageNet en aval, une amélioration relative de 70 % par rapport à la meilleure performance antérieure. Cette lignée « codage parcimonieux → caractéristiques sans supervision » s'est affaiblie après 2012 avec la domination des CNN supervisés, mais a resurgi en 2023 sous forme d'Auto-encodeurs parcimonieux (SAE) d'Anthropic.
Lignée parallèle : faible rang
La SVD tronquée (théorème d'Eckart–Young–Mirsky) est la meilleure approximation entre toutes les matrices de rang au plus k, et Gavish & Donoho (2014, IEEE T-IT 60(8):5040–5053) ont fourni le seuil dur optimal pour le débruitage. C'est structurellement isomorphe au débruitage par seuillage d'ondelettes. Les deux suivent « changement de base → seuillage → transformation inverse », la différence étant que la base d'ondelette est fixe tandis que la base SVD est calculée à partir des données. Dans le premier cas, le signal reste parcimonieux après seuillage, mais dans le second, la matrice tronquée est de faible rang mais dense. Cette lignée réapparaît au chapitre « Présent » sous la forme MLA et LoRA, revenant aux grands modèles.
Pas à pas : pourquoi chaque progrès s'est-il produit à ce moment
De Fourier aux ondelettes (années 1980). La base de Fourier décompose les signaux en ondes sinusoïdales globales. Elle est efficace pour les signaux stationnaires, mais extrêmement gaspilleuse pour les arêtes et phénomènes transitoires. Exprimer un seul échelon nécessite une infinité de composantes fréquentielles, l'énergie s'étale dans tout le domaine des fréquences. L'ingénierie disposait déjà de contournements comme la transformée de Gabor ou la transformée de Fourier à court terme, mais sans cadre mathématique unifié. Mallat (1989) a formalisé l'analyse multirésolution, et Daubechies (1988) a construit des ondelettes orthogonales à support compact, permettant de satisfaire simultanément localité, structure multirésolution et orthogonalité. Chaque fonction de base d'ondelette est non-nulle uniquement sur une plage finie, répétée à tous les échelles. Par conséquent, un signal lisse par morceaux produit des coefficients importants uniquement aux positions des arêtes et quelques échelles, presque zéro ailleurs. DeVore (1998) et Donoho (1993) ont prouvé que ce n'est pas une coïncidence empirique. Pour la classe des fonctions lisses par morceaux, aucune base linéaire fixe n'égale le taux de décroissance d'erreur de la meilleure approximation non-linéaire n-terme en base d'ondelette. JPEG2000 (2000) a transformé cette théorie en norme, remplaçant la DCT de JPEG par des ondelettes, réduisant considérablement le bruit de bloc au même débit.
Des moindres carrés au LASSO (années 1990). La statistique affronta un type différent de parcimonie : non pas si les coefficients sont parcimonieux sous une certaine base, mais « quelles variables explicatives comptent vraiment ». L'approche classique était la sélection de sous-ensemble (régression pas à pas, AIC/BIC), mais c'est une recherche combinatoire, extrêmement instable face à de légères perturbations des données. Breiman (1995) proposa le garrote non-négatif, reformulant la sélection de variables comme un problème de contraction continue. Inspiré par cela, Tibshirani (1996) proposa LASSO, c'est-à-dire les moindres carrés avec pénalité L1. Le comportement de L1 est déterminé par sa géométrie. La région de contrainte est un losange aux angles aigus, la solution optimale se pose aisément sur un angle, et chaque angle correspond à un point où certains coefficients sont exactement zéro. C'est le mécanisme par lequel « contraction et sélection se produisent simultanément ». Le goulot d'étranglement algorithmique du LASSO a été levé en 2004 par LARS (Efron, Hastie, Johnstone, Tibshirani), permettant de calculer le chemin de régularisation entier d'un coup. En 2005, Elastic Net de Zou et Hastie traita les groupes de variables fortement corrélées avec L1+L2. La statistique en haute dimension fournit des garanties théoriques. Wainwright (2009) prouva que pour reconstruire k coefficients non-zéro en dimension p, n ≳ k·log p échantillons suffisent, et Bickel, Ritov, Tsybakov (2009) établirent l'inégalité oracle pour LASSO et le sélecteur Dantzig.
Découverte indépendante en traitement du signal (1993–1998). Presque au même moment, le traitement du signal partit des « dictionnaires surcomplètes » pour arriver au même L1. La Poursuite d'Appariement (Mallat et Zhang 1993) sélectionnait goulûment l'atome le plus corrélé au résidu, et la Poursuite de Basis (Chen, Donoho et Saunders 1998) relaxait le problème NP-difficile de L0 « trouver la représentation la plus parcimonieuse » en programmation linéaire L1. LASSO et Basis Pursuit sont mathématiquement deux paramétrages du même problème, mais émergèrent de deux communautés ayant peu d'échanges. La parcimonie comme idée est le premier cas de « convergence de multiples sources ».
Débruitage : le moment où la parcimonie produisit directement de la valeur (1994). Le débruitage par seuillage d'ondelettes de Donoho et Johnstone transforma la théorie ci-dessus en procédure à 3 étapes. Passer au domaine des ondelettes par transformation orthogonale. Appliquer le seuillage doux des coefficients avec seuil λ=σ√(2 log n) : S_λ(w)=sign(w)·max(|w|−λ,0). Revenir au domaine du signal par transformation inverse. La clé du succès est que la transformation orthogonale préserve les propriétés statistiques du bruit blanc. Même en domaine d'ondelette, le bruit reste du bruit gaussien indépendant à variance égale s'étalant uniformément sur tous les coefficients, tandis que l'énergie du signal se concentre dans peu de coefficients importants, il suffit donc de rejeter les petits. L'opérateur de seuillage doux est précisément l'opérateur proximal de la pénalité L1, et c'est pourquoi le débruitage, LASSO, puis ISTA/FISTA (Beck et Teboulle 2009), et LISTA (Gregor et LeCun 2010, point de départ du déroulement d'algorithme), partagent tous le même calcul central.
Détection comprimée : transformer la parcimonie en « mesurer peu pour obtenir beaucoup » (2004–2009). Jusqu'à présent, toutes les méthodes cherchaient une représentation parcimonieuse en supposant que les données complètes étaient disponibles. Candès, Romberg et Tao (2006) et Donoho (2006) posent la question inverse : si nous savons qu'un signal est k-parcimonieux sous une certaine base, combien de mesures exactement faut-il pour le reconstruire ? La réponse est m ≳ C·k·log(n/k) mesures linéaires aléatoires, bien en deçà du taux de Nyquist. La condition est que la matrice de mesure satisfasse la propriété d'isométrie restreinte (RIP), c'est-à-dire qu'elle préserve approximativement la norme de tous les vecteurs 2k-parcimonieux. Candès (2008) donne la condition suffisante δ₂ₖ < √2−1 ≈ 0,414, et Donoho et Tanner (2009) caractérisent à l'aide de la géométrie combinatoire la transition de phase nette entre succès et échec de la récupération L1. L'importance historique de la détection comprimée est qu'elle élève la parcimonie de « propriété de la représentation » à « principe d'échantillonnage » et modifie directement la conception du matériel d'imagerie. Lustig, Donoho et Pauly (2007) l'appliquent à l'IRM, raccourcissant le temps de numérisation au prix d'un sous-échantillonnage aléatoire. Duarte et al. (2008) construisent une caméra monopixel, et en astronomie radio, le pipeline SMILI utilise la régularisation L1 et de variation totale pour l'imagerie de trous noirs du projet EHT.
Apprentissage de dictionnaire et codage parcimonieux : des bases fixes aux bases apprises (1996–2012). Les ondelettes sont une base fixe conçue par l'homme, qui n'est pas nécessairement optimale pour des données particulières. Olshausen et Field (1996) apprennent un dictionnaire à partir des données et reproduisent les champs récepteurs du V1. K-SVD (Aharon, Elad et Bruckstein 2006) fournit un algorithme pratique alternant codage parcimonieux et mise à jour SVD par atome. Lee, Battle, Raina et Ng (2007) accélèrent le codage parcimonieux L1 et font progresser l'« apprentissage autodidacte ». Le et al. (2012) empilent un autoencodeur parcimonieux jusqu'à 9 couches et 1 milliard de connexions, apprenant sans supervision à partir de 10 millions de frames YouTube des neurones sélectifs aux visages de chats. Après AlexNet en 2012, cette lignée reste cachée pendant dix ans à l'ombre des réseaux de convolution supervisés, mais elle laisse deux choses : le cadre de représentation « dictionnaire surcomplet + coefficients parcimonieux » et la conviction que « le dictionnaire peut être appris à partir des données ». Quand Anthropic a décodé les caractéristiques internes des grands modèles avec des autoencodeurs parcimonieux en 2023, c'est précisément Olshausen et Field qu'ils ont cités, et Olshausen lui-même figurait parmi les coauteurs des articles connexes.
Faible rang : le jumeau de la parcimonie (1936–2014). Eckart et Young (1936) prouvent que la SVD tronquée est la meilleure approximation de rang faible d'une matrice. Faible rang et parcimonie sont structurellement isomorphes. Les deux « concentrent l'énergie dans quelques composantes et abandonnent la queue », mais l'objet sur lequel ils agissent diffère. La parcimonie supprime les coordonnées, le rang faible supprime les directions. Gavish et Donoho (2014) donnent le seuil dur optimal pour la débruitage de rang faible, en résonance avec le seuil universel du débruitage par ondelettes. L'ACP robuste (Candès et al. 2011) les combine : Données = rang faible + parcimonieux. Cette distinction devient cruciale dans le chapitre « Présent ». L'MLA de DeepSeek est une compression de rang faible, tandis que DSA et CSA2 sont les véritables attentions parcimonieuses. Les deux sont souvent confondus.
Résumé : trois héritages que l'ère classique a laissés à l'apprentissage profond
Premièrement, trouver la bonne base est plus important que de traiter les données. La même image est dense en base pixels et parcimonieuse en base ondelettes. La différence réside entièrement dans la façon de la décrire. Deuxièmement, il n'existe que trois opérations qui créent des zéros : le seuillage doux (L1), le seuillage dur (L0) et la conservation des k plus grands éléments (projection sur la boule L0). Troisièmement, seule la parcimonie structurée atteint le matériel et les normes. La structure d'arbre des ondelettes entre dans JPEG2000, le sous-échantillonnage aléatoire dans les produits d'IRM. Les trois héritages réapparaissent tous, revêtus de nouveaux habits, à l'« ère des réseaux de neurones » et au « présent ».
L'ère des réseaux de neurones (1990–2022) : débâcle et tournant de la parcimonie
La parcimonie n'a pas été vaincue. La parcimonie inadaptée au matériel a été vaincue. L'élagage non structuré des poids réussit en théorie et échoue sur GPU. Le Mixture-of-Experts élève l'unité de parcimonie à des blocs experts entiers, tandis que l'intérieur de chaque expert reste une multiplication de matrice dense, remportant ainsi le jackpot matériel. Ce chapitre explique pourquoi.
Généalogie de l'élagage et « le mur de la parcimonie »
OBD (LeCun, Denker & Solla 1990) estime l'importance de chaque poids à partir d'informations du second ordre, OBS (Hassibi & Stork 1993) l'affine avec la matrice hessienne complète. Deep Compression (Han, Mao & Dally 2016) combine élagage, quantification et codage de Huffman, comprimant AlexNet de 240 MB à 6,9 MB. L'hypothèse de la loterie (Frankle & Carbin 2019) montre que les réseaux denses contiennent un sous-réseau parcimonieux capable d'atteindre la même précision s'il était entraîné seul. SparseGPT (Frantar & Alistarh 2023) et Wanda (Sun et al. 2023) montrent que les modèles de classe GPT peuvent être rendus 50% parcimonieux en une seule passe avec une perte de précision minime.
Cependant, à l'ère des LLM, cette lignée se heurte à un mur. L'article ELSA d'octobre 2025 (arXiv:2510.01650) l'appelle « le mur de la parcimonie ». Les méthodes existantes ne semblent pas pouvoir dépasser 50–60% de parcimonie sans réduire significativement la précision. ELSA prétend que l'utilisation de l'ADMM permet d'élaguer LLaMA-2-7B jusqu'à près de 90%, mais cette affirmation est toujours en débat.
Parcimonie d'activation : les chiffres réels de ReLU
Glorot, Bordes et Bengio (2011, AISTATS) sont la source primaire de la parcimonie d'activation, et leurs chiffres méritent d'être cités avec précision. Immédiatement après l'initialisation uniforme, environ 50% des unités cachées produisent exactement zéro. Après apprentissage, le taux de parcimonie exact moyen est de 83,4% sur MNIST, 72,0% sur CIFAR10, 68,0% sur NISTP, et 73,8% sur NORB. La conclusion est que « le taux de parcimonie des modèles qui généralisent le mieux se situe entre 50% et 80% », et qu'on peut imposer une parcimonie jusqu'à environ 85% sans perte de performance. L'affirmation « ReLU est 90% parcimonieux » n'a pas de soutien dans les sources originales.
Profitons-en pour faire une distinction. Dropout est une régularisation aléatoire appliquée pendant l'entraînement ; lors de l'inférence, le réseau redevient dense. L'élagage supprime définitivement les poids. Les deux peuvent être écrits comme « application d'un masque », mais le caractère aléatoire du masque, l'étape à laquelle il agit et le but sont complètement différents.
Pourquoi la parcimonie non structurée des poids a échoué à l'ère du GPU
La loterie matérielle. Selon la définition de Hooker (The Hardware Lottery, 2020/2021), une idée de recherche gagne non parce qu'elle est excellente, mais parce qu'elle s'adapte aux logiciels et matériels disponibles. Les GPU et TPU sont conçus pour les multiplications matricielles denses et continues. La parcimonie non structurée introduit des opérations gather/scatter, brise le flux de données en tuiles du GEMM, réduit la réutilisation du cache sur puce, et généralement n'utilise pas les tensor cores. Empiriquement, des bibliothèques comme cuSPARSE ne montrent une accélération claire que lorsque le taux de parcimonie dépasse environ 90%, et avec 50% de parcimonie non structurée, il existe presque aucun noyau standard capable de surpasser le GEMM dense sur GPU.
Parcimonie structurée 2:4. Depuis Ampere, les GPU supportent le motif où exactement 2 poids sur 4 sont zéro, et si le motif est respecté, le débit théorique double. Mais le taux de parcimonie plafonne à 50%, la récupération de précision nécessite un réapprentissage ou un fine-tuning, et l'accélération de bout en bout se rapproche rarement de 2×, donc l'accélération s'est moins généralisée pour le déploiement de LLM que la quantification.
Pourquoi la quantification a remporté. La quantification réduit le nombre de bits par paramètre, mais ne touche pas à la régularité de la matrice, de sorte que tout GPU en bénéficie naturellement. Après GPTQ (2022) et AWQ (2023), MXFP4 devient le format natif 2025–2026. gpt-oss stocke les poids MoE (plus de 90% de tous les paramètres) en MXFP4 (4,25 bits par paramètre), ce qui rend possible le chargement d'un modèle 120b sur un seul GPU 80 GB. Kimi K3 effectue l'apprentissage conscient de la quantification (QAT) avec des poids MXFP4 et des activations MXFP8, et les paramètres experts de DeepSeek-V4 utilisent FP4.
Le mur de la mémoire. De V100 à B200, la croissance du pic de puissance de calcul dépasse de loin celle de la bande passante mémoire (chiffres d'ordre de grandeur basés sur les spécifications publiques de chaque fournisseur).
| GPU | Puissance de calcul BF16/FP16 dense | Bande passante HBM | Opérations par octet (approximation) |
|---|---|---|---|
| V100 (2017) | environ 125 TFLOPS | 0.9 TB/s | 140 |
| A100 (2020) | environ 312 TFLOPS | 1.6–2.0 TB/s | 155–195 |
| H100 SXM (2022) | environ 989 TFLOPS | 3.35 TB/s | 295 |
| B200 (2024) | environ 2,2 PFLOPS (environ 9 PFLOPS en FP4) | environ 8 TB/s | 280 (environ 1 100 en FP4) |
Lors du décodage, chaque fois qu'un token est généré, les poids impliqués dans le calcul doivent être transportés de la mémoire GPU. Avec une petite taille de batch, les unités de calcul sont largement inactives, et le goulot d'étranglement devient la bande passante. C'est pourquoi « réduire les FLOPs » est moins précieux que « réduire les paramètres et KV à lire ». MoE réduit le nombre d'octets de poids lus par token, et l'attention sparse ainsi que la compression KV réduisent le nombre d'octets de cache. Les deux réduisent précisément les dépenses les plus coûteuses.
La généalogie du calcul conditionnel (tournant)
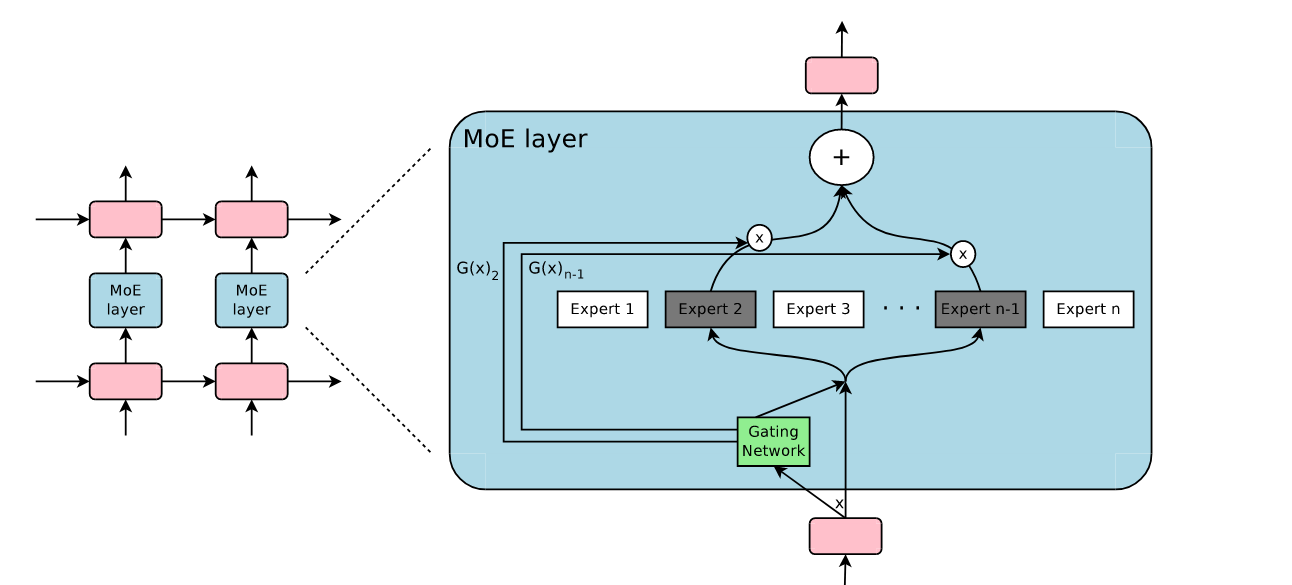
1991 Adaptive Mixtures of Local Experts par Jacobs, Jordan, Nowlan et Hinton. Plusieurs réseaux d'experts étaient entraînés ensemble avec un réseau de gating, la motivation initiale étant de réduire l'interférence entre tâches. En 1994, Jordan & Jacobs l'étendent à une MoE hiérarchique.
2013 Bengio et al. proposent le calcul conditionnel et l'estimation de gradient via des neurones stochastiques (STE). Eigen, Ranzato et Sutskever tentent les premiers expériences de MoE sur des réseaux profonds.
2017 Outrageously Large Neural Networks par Shazeer et al. (co-auteurs incluant Hinton et Dean). Des couches MoE sparse avec gating de jusqu'à 137B paramètres sont insérées entre les couches LSTM, « améliorant la capacité du modèle de plus de 1000x avec seulement une légère perte d'efficacité de calcul ». Notez que l'original dit « greater than 1000x » et que 137B se réfère au nombre de paramètres dans les couches MoE.
2020-2022 GShard apporte MoE à Transformer et le scale à plus de 600B, Switch Transformer (Fedus, Zoph & Shazeer 2021) atteint 1 trillion de paramètres avec routage top-1. GLaM et ST-MoE s'attaquent aux problèmes de stabilité (router z-loss), et Expert Choice (2022) inverse le paradigme en laissant les experts choisir les tokens, équilibrant naturellement la charge.
En une phrase pour cette section : de 1991 à 2022, l'idée du calcul conditionnel n'a pas changé. Ce qui a changé, c'est le matériel et l'arrivée finalement de l'échelle pour l'accompagner.
De MoE en papier à MoE en produit : problèmes d'ingénierie résolus entre 2017 et 2022
Shazeer et al. (2017) ont montré qu'on pouvait augmenter la capacité de 1000 fois, mais faire de MoE un produit fiable a nécessité 5 années supplémentaires et la résolution de 4 problèmes concrets.
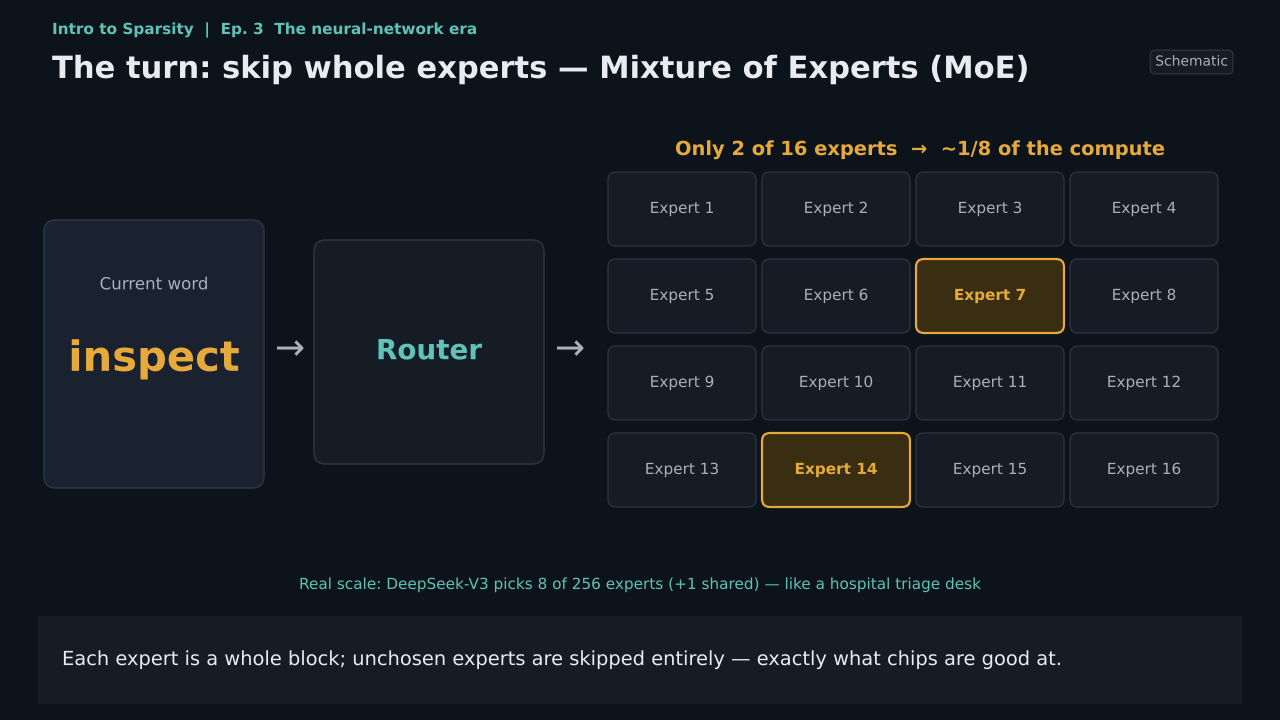
Comment apprendre le routage. Le gate produit s = Softmax(W_g·h), les k meilleurs experts sont sélectionnés, et la sortie de la couche est y = h + Σ_{i∈T} s_i·FFN_i(h). Le problème est que top-k est un choix discret, donc la dérivée par rapport à s est nulle presque partout. Le gradient ne parvient qu'aux poids de gate des experts sélectionnés, et les experts non sélectionnés ne reçoivent jamais d'opportunité d'apprentissage. La solution de Shazeer est le Noisy Top-k gating, qui ajoute un bruit gaussien apprenable aux logits, permettant à un expert qui aurait pu être en position k+1 d'être parfois sélectionné. Une solution plus générale comprend l'estimateur Straight-Through (STE) de Bengio et al. (2013) et le Gumbel-Softmax plus tardif.
Comment équilibrer la charge. Le routeur a une tendance au rich-get-richer. Les experts populaires sont plus sélectionnés, s'entraînent mieux parce qu'ils sont sélectionnés, deviennent encore plus sélectionnables, jusqu'à ce qu'un petit nombre d'experts détienne tout le trafic et le modèle dégénère en un modèle plus petit (expert collapse). GShard et Switch Transformer introduisent une perte d'équilibrage auxiliaire L_bal = α·N·Σ f_i·P_i, où f_i est la fraction de tokens assignés à l'expert i et P_i sa probabilité de gate moyenne. ST-MoE (2022) supprime davantage les explosions de logit avec router z-loss. Ces pertes auxiliaires fonctionnent, mais distordent le gradient de l'objectif principal de modélisation du langage. En 2024, DeepSeek-V3 a contourné ce compromis avec un « biais hors gradient » (voir la section « Présent »).
Comment définir la capacité. En apprentissage distribué, la taille de buffer de chaque expert doit être fixée à l'avance, d'où arrive le facteur de capacité. Capacité par expert = capacity_factor × (nombre de tokens / N). Les tokens au-delà de la capacité sont supprimés (token dropping) et ne passent que par la connexion résiduelle. Une capacité élevée gaspille de la mémoire, une capacité faible dégrade la qualité. MegaBlocks (2023) construit une MoE « sans suppression » avec des produits matriciels block-sparse, s'échappant de ce dilemme.
Comment survivre à la communication. Les experts sont placés sur des GPUs différents (expert parallelism), et chaque couche MoE demande 2 échanges all-to-all dépendant des données. Les tokens sont envoyés vers les GPUs où résident les experts, et les résultats sont récupérés. C'est le goulot d'étranglement de communication majeur de l'apprentissage MoE et la raison pour laquelle MoE convient aux déploiements à grande échelle et centralisés. De DeepSpeed-MoE et Tutel à DeepEP de DeepSeek, ces systèmes optimisent tous cette trajectoire.
Jalons : GShard (2020) apporte MoE à Transformer et le scale à plus de 600B. Switch Transformer (2021) atteint 1 trillion de paramètres avec routage top-1 et pré-entraîne 4 fois plus vite que T5-XXL. GLaM (2021) avec 1.2T paramètres totaux et ~97B activés, a consommé environ un tiers de l'énergie de GPT-3. Expert Choice (2022) inverse la direction, laissant les experts choisir les tokens pour équilibrer naturellement la charge.
Pourquoi MoE n'était-elle pas encore mainstream avant 2022
Même avec ces solutions d'ingénierie en place, MoE en 2022 était encore un « jouet de grandes entreprises » au sein de Google. Il y a trois raisons. Premièrement, la pression sur les coûts n'était pas encore assez forte. À l'époque de GPT-3, les modèles denses progressaient encore rapidement, et le coût d'inférence n'était pas une contrainte majeure. Deuxièmement, il n'y avait pas d'écosystème ouvert. Il n'existait pas de MoE de haute qualité à poids ouverts, et la communauté ne pouvait ni reproduire ni améliorer. Troisièmement, le fine-tuning était difficile. Sur les petits ensembles de données, le routage s'effondrait facilement, et l'adaptation aux tâches en aval n'était pas aussi fluide qu'avec les modèles denses.
Ces trois conditions ont changé d'un coup à fin 2023. Mixtral 8x7B (décembre 2023) devint le premier MoE ouvert de haute qualité, le trafic à l'échelle de ChatGPT fit du coût d'inférence le problème le plus urgent, et DeepSeekMoE (janvier 2024) éleva l'efficacité de coût de MoE à un nouveau niveau avec des experts à grain fin et des experts partagés. C'est là que commence le « Présent ».
Résumé
Les trois généalogies de cette section — élagage, sparsité d'activation et calcul conditionnel — ont suivi des destins complètement différents avant 2022. L'élagage a réussi en théorie et échoué dans le matériel. La sparsité d'activation (ReLU) était utilisée partout et à peine exploitée nulle part. Le calcul conditionnel avait tout en place, il ne manquait que la pression économique. Comprendre cette différence de destin explique pourquoi le gagnant après 2023 n'a pas été l'élagage des poids mais MoE. Qu'on puisse rendre la sparsité pratique dépend de si ses zéros ont une structure que le matériel peut exploiter.
Présent (2023-septembre 2026) : Pourquoi les LLM ont misé entièrement sur la sparsité
D'ici 2026, le taux d'activation par token des modèles ouverts de pointe descendra à 1,5 %-4,5 %, et la sparsité s'étendra de FFN à l'attention, aux caches KV, et au stockage de la connaissance elle-même. Cette section présente d'abord quatre pressions, puis inventorie cinq types de sparsité, puis avance vers une théorie unifiée et l'économie.
Pourquoi maintenant : quatre pressions
La mise à l'échelle s'est heurtée au mur des coûts. Le nombre total de paramètres a atteint la gamme 1-3T (DeepSeek-V4-Pro à 1,6T, Kimi K3 à 2,8T), et l'apprentissage et l'inférence avec des modèles denses ne sont plus économiquement viables.
Le coût d'inférence a dépassé le coût d'apprentissage. Dans l'aperçu des systèmes d'inférence du 1er mars 2025, DeepSeek a révélé qu'il augmente les batch avec un large expert parallelism inter-nœuds et améliore l'efficacité GEMM. L'économie de l'inférence est devenue la contrainte unique et la plus importante dans la conception architecturale.
Les agents ont rendu les charges « centrées sur l'entrée ». Le rapport technique de V4.1 déclare au début que, avec la propagation des agents longue durée, les charges sont dominées par l'entrée, et les énormes caches KV pressent continuellement la capacité et la bande passante de HBM et SSD.
Ingéniosité technique sous contrôle des exportations. DeepSeek-V3 a été entraîné sur 2 048 H800, avec environ 2,788 millions d'heures GPU au total. Le H800 est le même chip que le H100 mais avec sa bande passante NVLink réduite de 900 GB/s à 400 GB/s, ce qui a directement généré des optimisations de communication comme DeepEP.
Calcul conditionnel : MoE devient l'architecture par défaut
Évolution de la famille DeepSeek (tous les rapports techniques officiels, fiches de modèles et annonces d'API):
| Modèle | Période | Paramètres totaux / Activations par token | Configuration d'experts | Principales techniques de parcimonie |
|---|---|---|---|---|
| DeepSeekMoE | 2024-01 | — | Experts à grain fin + experts partagés | Subdivision fine des experts, augmentation exponentielle du nombre de combinaisons |
| V2 | 2024-05 | 236B / 21B | 2 partagés + 160 routés | MLA : compression de faible rang simultanée des KV (faible rang, non parcimonieux) |
| V3 | 2024-12 | 671B / 37B | 1 partagé + 256 routés, 8 sélections | Équilibrage des charges sans perte auxiliaire, prédiction multi-tokens, apprentissage FP8 |
| V3.2 | 2025-09/12 | 671B / 37B | Idem | DSA : Lightning Indexer + attention parcimonieuse top-k par token (k=2048) |
| V4-Flash / V4-Pro | 2026-04-24 | 284B/13B、1.6T/49B | 1 partagé + 256 routés, 6 sélections / 384 routés | Disposition alternée de Compressed Sparse Attention (CSA) et HCA, contexte 1M, experts FP4 |
| V4.1-Flash | 2026-09-10 | Backbone 552B + Engram 196B, préfill 8B / décodage 16B | 1 partagé + 384 routés, 6 sélections | CED、CSA2、Hierarchical Sparse Indexer、FP4 KV、Engram |
Les 5 éléments de conception de V4.1-Flash (rapport technique) :
CED (Causal Encoder–Decoder). Les 40 couches sont divisées en 20 couches d'encodeur et 20 couches de décodeur, le KV global du décodeur étant projeté à partir de l'état caché final de l'encodeur. Les tokens d'entrée ne passent que par l'encodeur (activations 8B), les tokens de sortie par le décodeur (16B). C'est une réponse directe au fait que « les agents lisent beaucoup et écrivent peu ».
Les 3 modes de CSA2. Full génère son propre KV global et construit l'index. Reindex réutilise le KV de la couche précédente tout en recalculant le top-k. Reuse réutilise directement l'index top-k. La plupart des couches sont en Reuse. Autrement dit, la plupart des couches ne « resélectionnent pas les tokens ».
Hierarchical Sparse Indexer. La première couche Full du décodeur crée un pool de candidats, les couches suivantes ne sélectionnent que parmi celui-ci. Le coût de calcul de l'index dans les couches profondes est découplé de la longueur du contexte.
Les chiffres du KV. Le KV global fait 890 octets par token, environ 1/4 de V4-Flash, 1/437 de V1. Le KV persistant fait environ 1/8 de V4-Flash. Même en élargissant le contexte de 4K à 1M (256 fois), les FLOPs de décodage par token ne s'accroissent que d'environ 1/4. L'attention parcimonieuse est entraînée nativement dès 64K, sans préchauffage en attention dense.
Mémoire conditionnelle Engram. Table de hachage N-gramme d'environ 196B paramètres, accédée parcimonieusement via consultation par token, pouvant être placée en mémoire hôte et prérécupérée. Elle n'est pas activée pour tous les tokens.
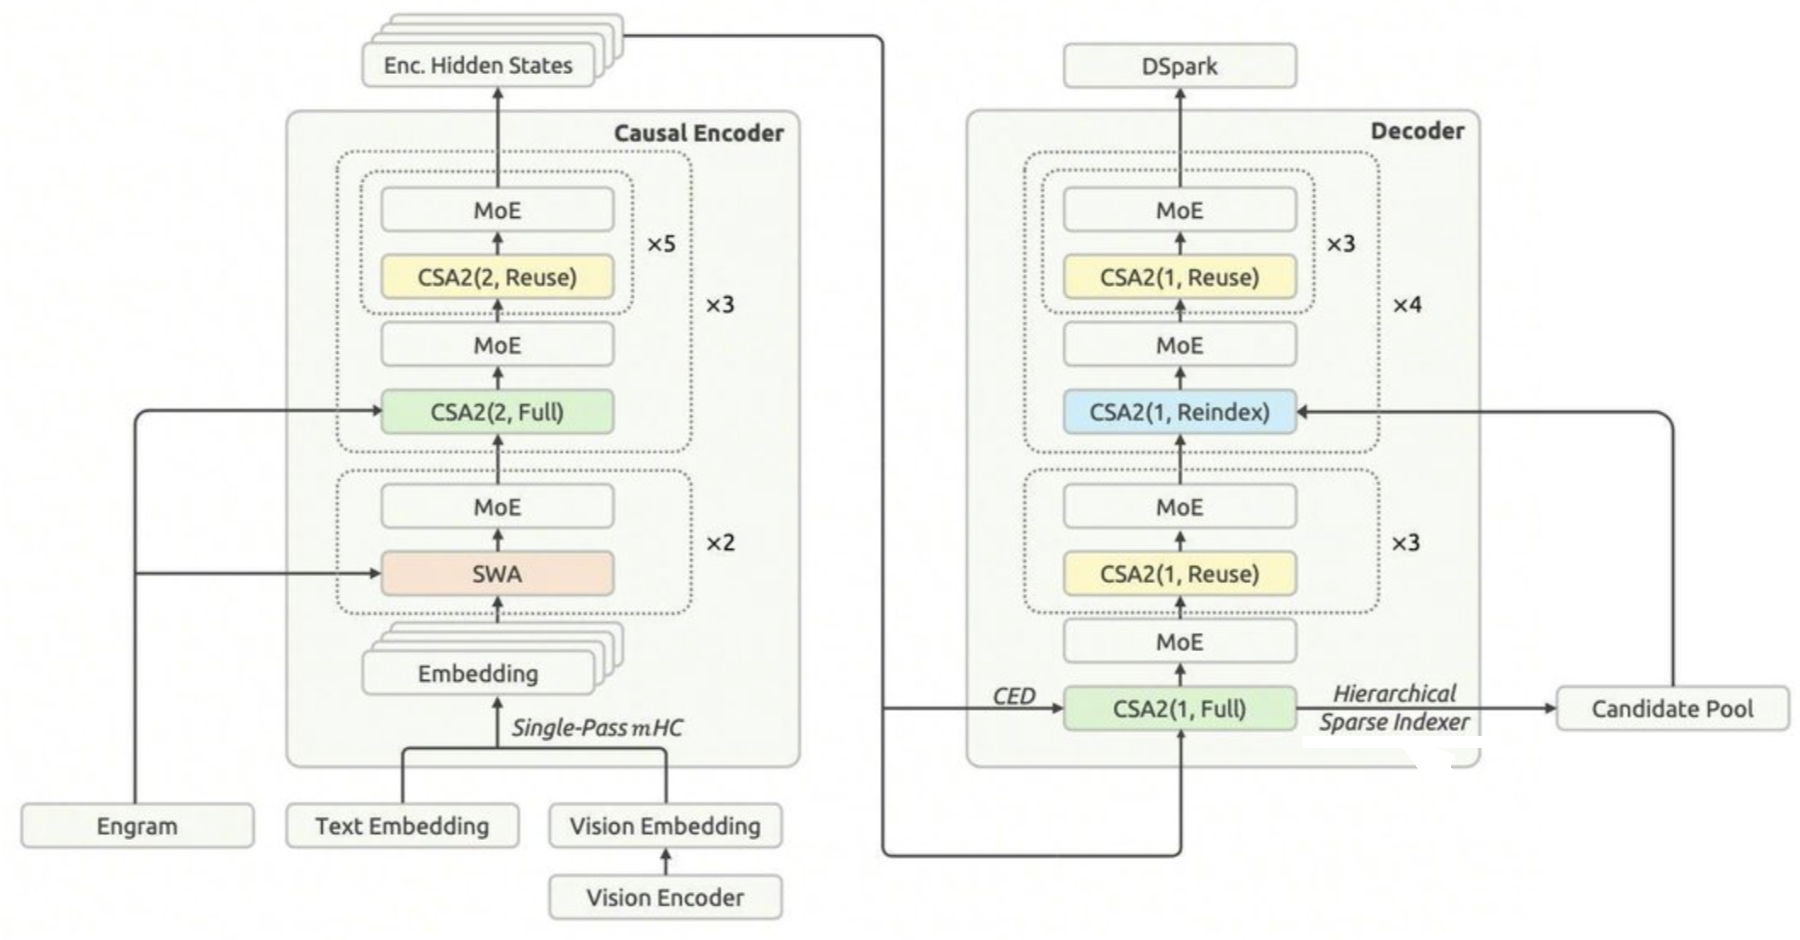
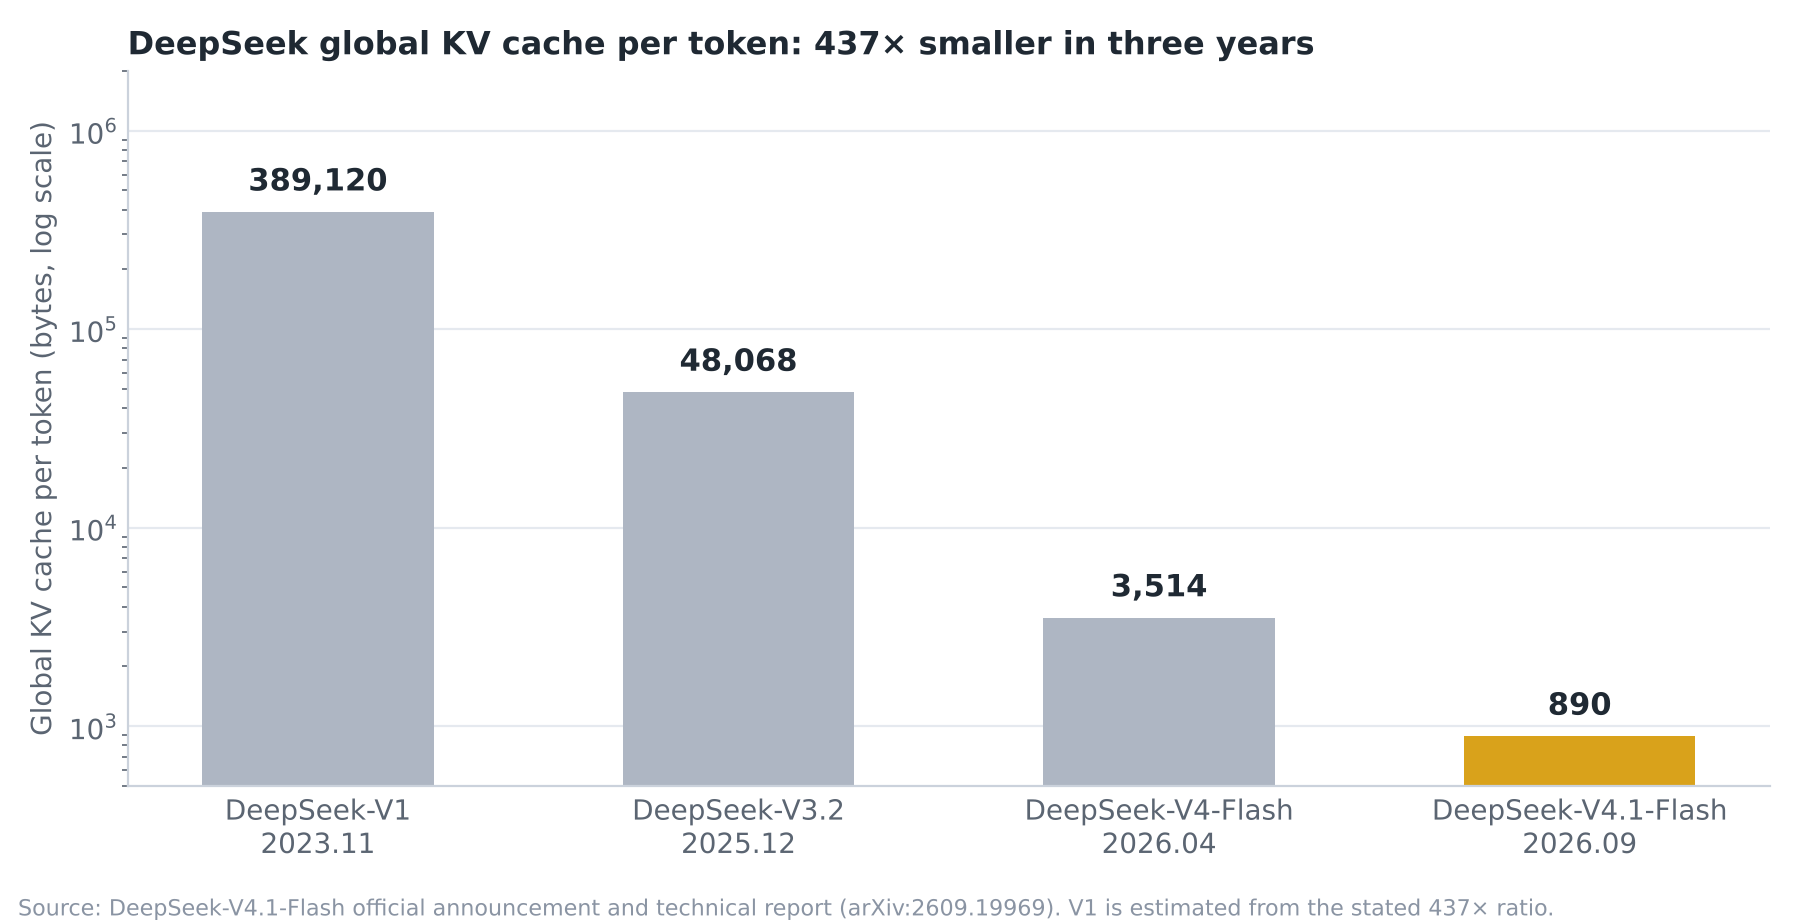
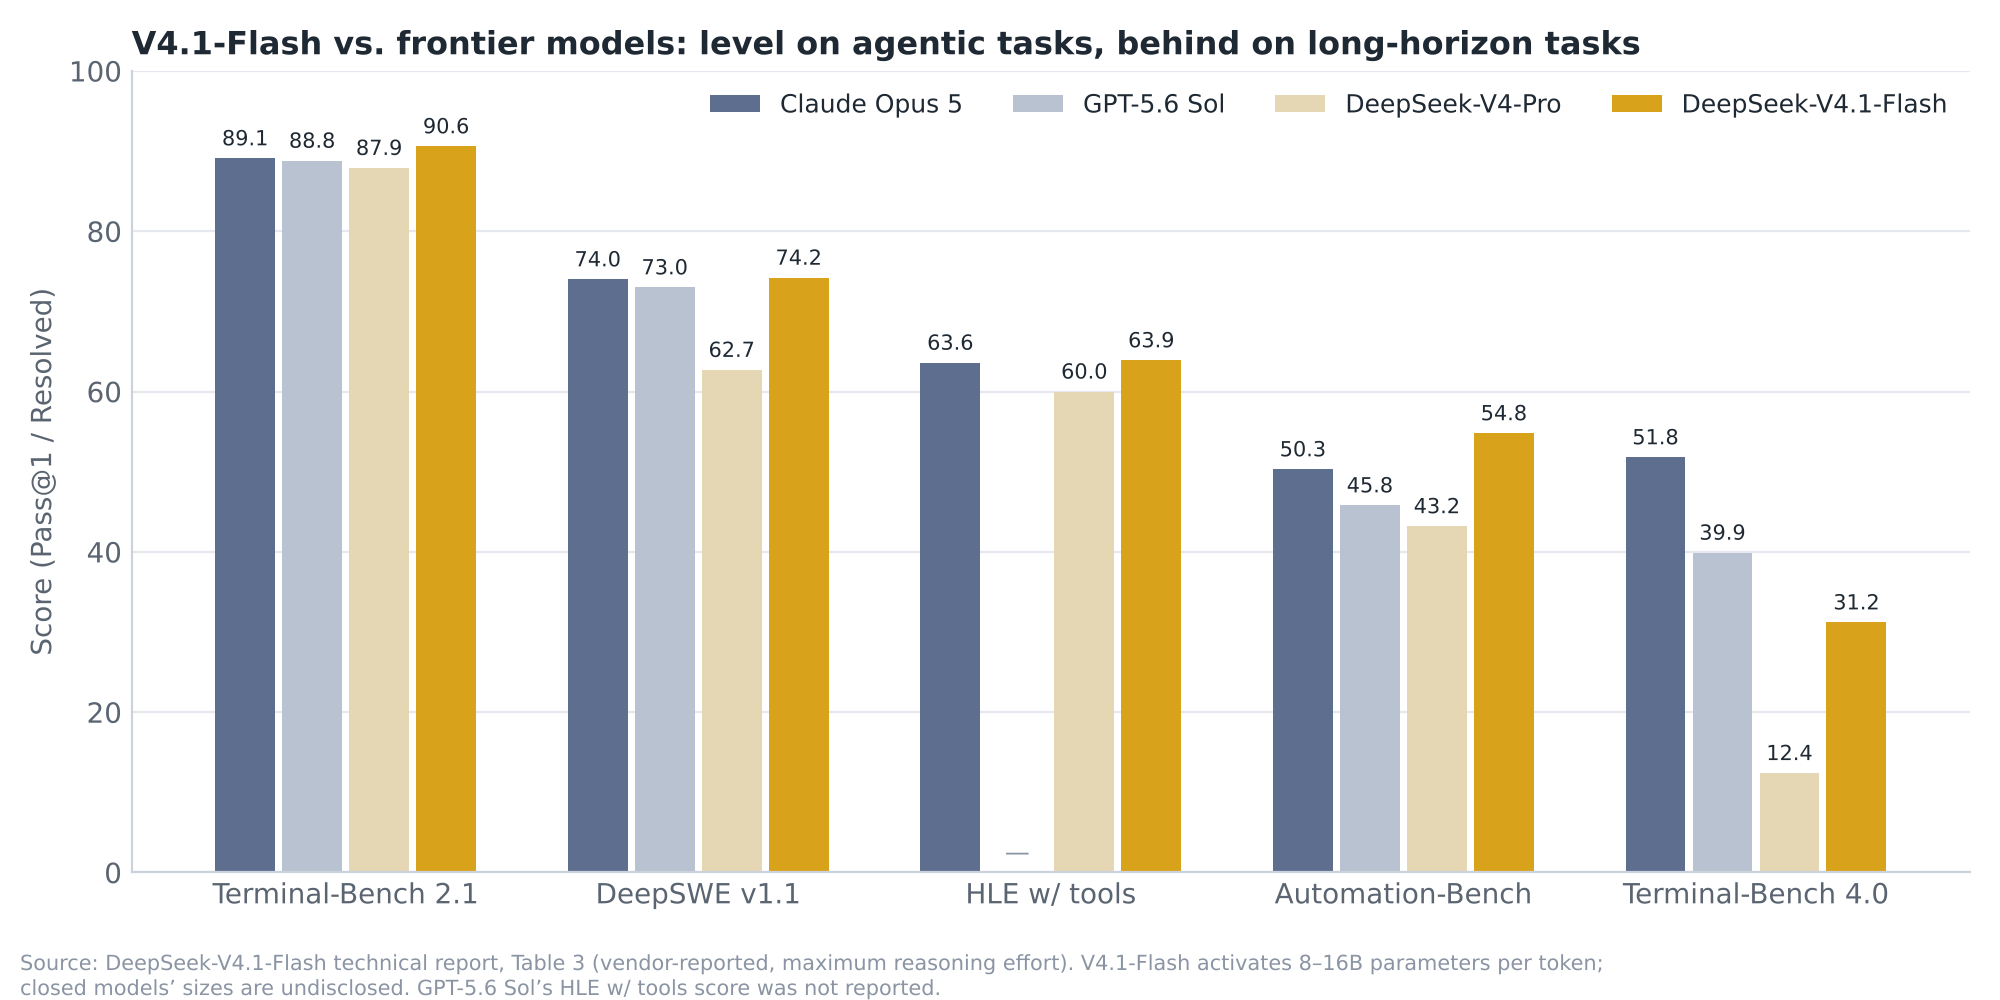
Performances et tarifs. DeepSeek affirme que V4.1-Flash-Base atteint le niveau de V4-Pro-Base avec 1/3 des paramètres totaux et 1/4 des paramètres activés. Le tarif de pointe est 0,30 $/M en entrée, 0,006 $/M en entrée en cache, 1,20 $/M en sortie ; hors pointe, les prix sont moitié moins. Toutefois selon les indicateurs synthétiques tiers (40 points sur Artificial Analysis, Claude Opus 5 affiche 51 points), l'écart reste d'environ 10 points en évaluation indépendante. Les benchmarks choisis par le fournisseur et l'évaluation synthétique indépendante doivent être séparés. C'est en soi une leçon vivante du fait que « la moyenne trompe ».
Autres modèles MoE majeurs de 2025-2026 (fiches de modèles officielles) :
| Modèle | Période | Total / Activé | Experts (sélectionnés / total) | Taux d'activation | Autres caractéristiques de conception |
|---|---|---|---|---|---|
| Mixtral 8x7B | 2023-12 | 46.7B / 12.9B | 2/8 | Environ 28 % | Premier MoE ouvert de haute qualité |
| gpt-oss-120b | 2025-08 | 116.8B / 5.1B | 4/128 | 4.4% | Poids MoE en MXFP4, disposition alternée attention glissante et globale, attention sink |
| Qwen3-235B-A22B | 2025-04 | 235B / 22B | 8/128 | 9.4% | — |
| Qwen3.5-397B-A17B | 2026-02 | 397B / 17B | 10+1 / 512 | 4.3% | Mélange linéaire Gated DeltaNet 3:1, réduction KV environ 1/4 |
| Kimi K2 / K2.5 | 2025-07 / 2026-01 | 1.04T / 32B | 8+1 / 384 | 3.1% | MuonClip, aucun pic de perte sur 15.5T tokens |
| Kimi K3 | 2026-07 | 2.8T / 104B | 16 / 896, 2 partagés | 3.7% | Attention linéaire KDA + Gated MLA, QAT MXFP4 |
| Llama 4 Maverick | 2025-04 | Environ 400B / 17B | 1 + 1 partagé / 128 | 4.3% | Disposition alternée couches denses et MoE |
| DeepSeek-V4.1-Flash | 2026-09 | 552B / 8–16B | 6+1 / 384 | 1.4%–2.9% | Voir ci-dessus |
La tendance est celle-ci. En deux ans, le domaine s'est déplacé de « 8 experts dont 2 activés, 25 % d'activation » à « plusieurs centaines à près de 1 000 dont 6-16 sélectionnés, 1,5 % à 4,5 % d'activation », et le degré de parcimonie augmente d'un ordre de grandeur environ tous les 1-1,5 ans. Les experts partagés sont devenus standard ; le routage utilise un biais sans perte auxiliaire, le routage par hachage (3 premières couches de V4), et le routage en espace latent (K3). Pour les modèles fermés, Google a reconnu officiellement que Gemini 1.5 et les séries Gemini 2.5 sont des MoE parcimonieux. Le « MoE 1.8T » d'OpenAI GPT-4 n'est qu'une rumeur de 2023 ; la composition de GPT-5.x et Claude restent propriétaires. Si l'on écrit à ce sujet, le maximum est « d'après les rapports ».
Parcimonie de l'attention et du cache KV
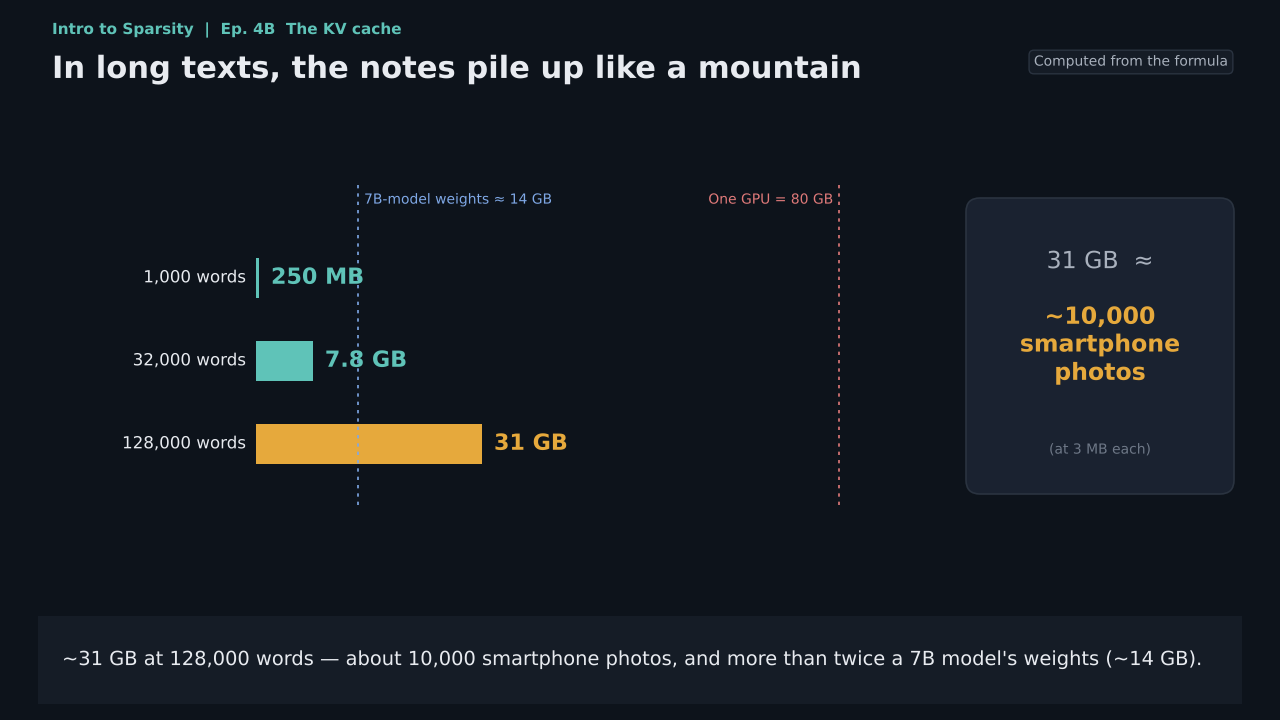
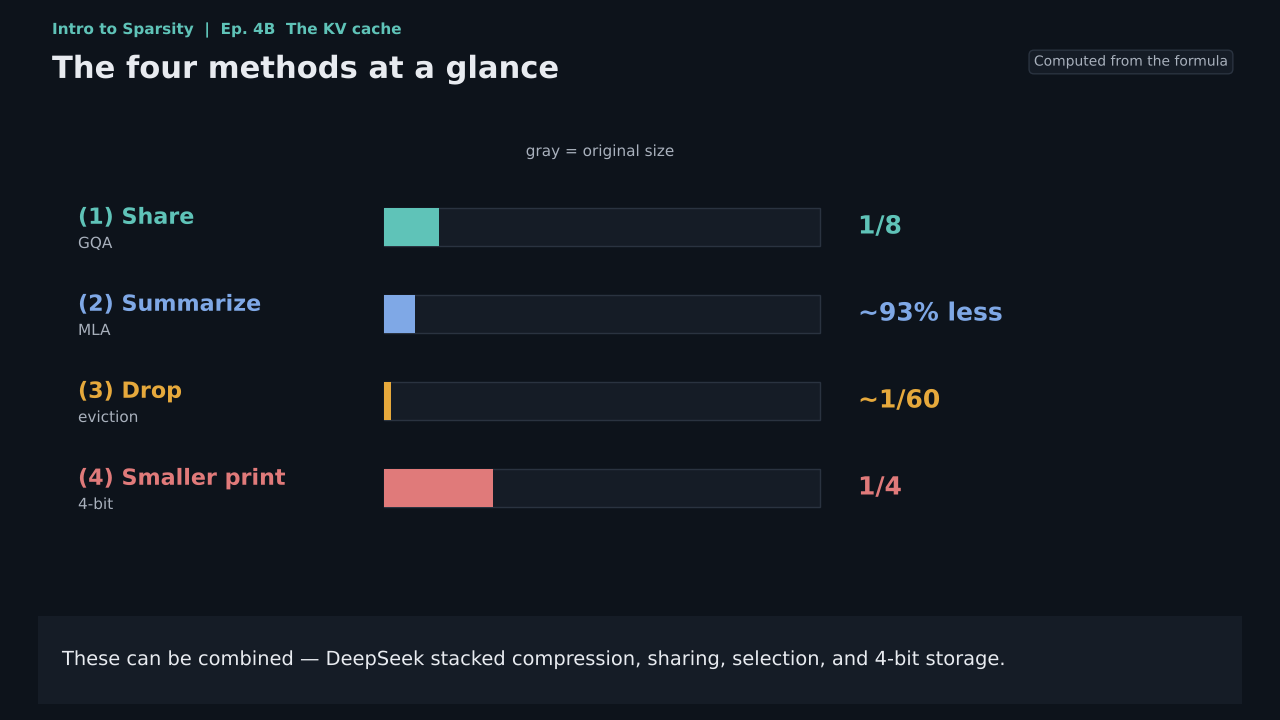
Taille du cache KV = 2 × L × nombre de couches × nombre de têtes KV × dimension de la tête × octets par élément. En substituant 64 couches, 8 têtes KV, dimension 128, FP16, contexte 128K, on obtient environ 31 GiB. C'est plus grand que les poids de beaucoup de modèles, et toute sa totalité doit être relue à chaque génération de token. Il y a 3 solutions : réduire le nombre de têtes KV (GQA/MQA), compression de faible rang (MLA), ou expulsion parcimonieuse ou calcul parcimonieux.
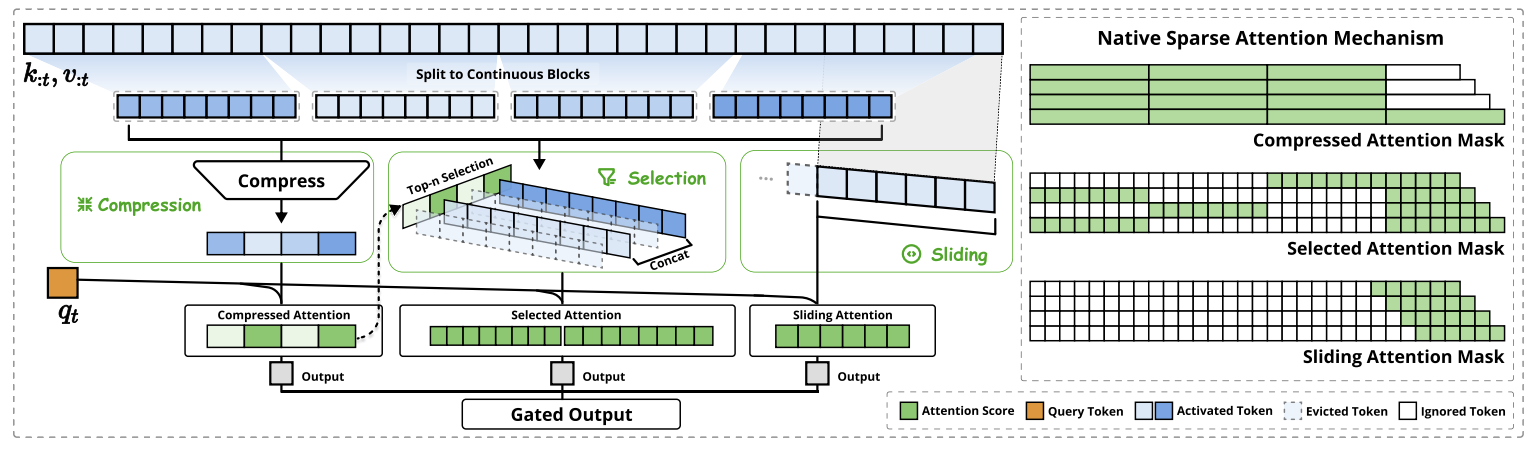
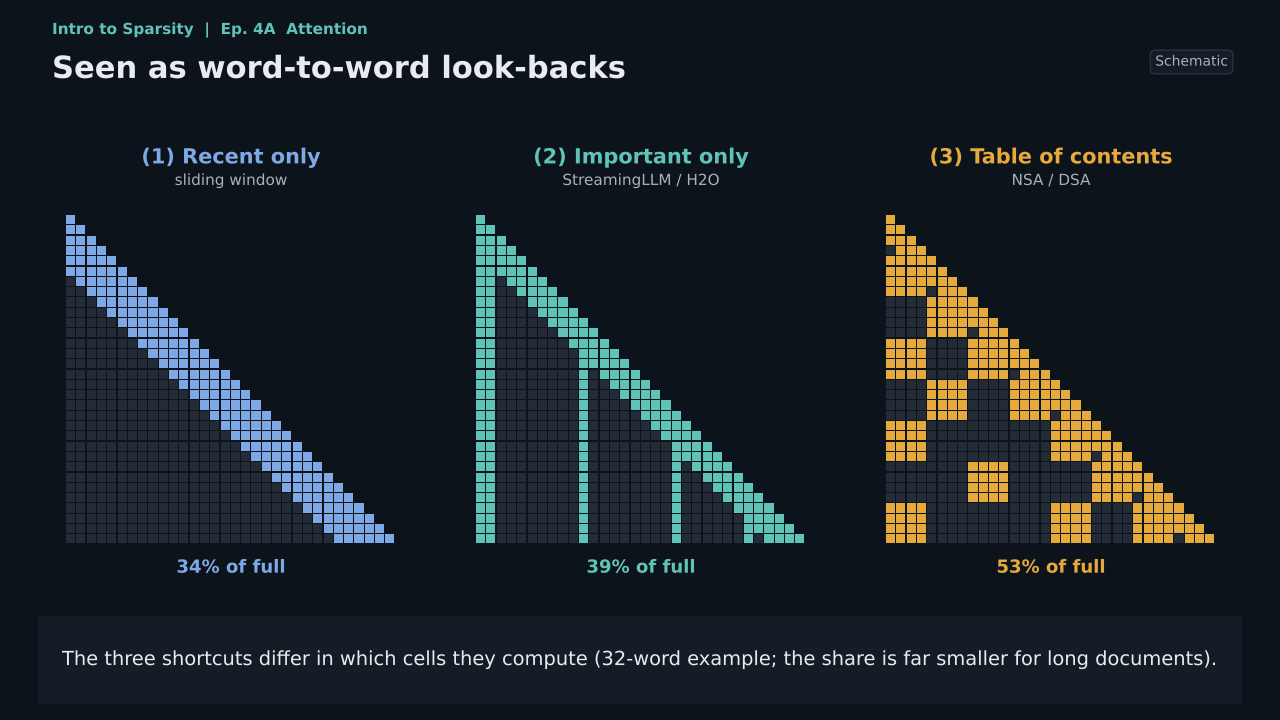
Il y a 3 générations d'attention parcimonieuse qui peuvent se superposer. La 1ère génération est les motifs fixes (Longformer, BigBird, fenêtre glissante gpt-oss). La 2e génération est l'expulsion dynamique à l'inférence sans réentraînement (StreamingLLM, H2O, SnapKV, Quest). La 3e génération apprend nativement la parcimonie dès l'entraînement (NSA, MoBA, DSA, CSA2). NSA (Yuan et al., DeepSeek × Université de Pékin × Université de Washington) a reçu le Best Paper Award d'ACL 2025, atteignant une accélération de 11,6× en décodage, 9,0× en propagation avant et 6,0× en rétropropagation par rapport à l'attention complète à longueur 64K.
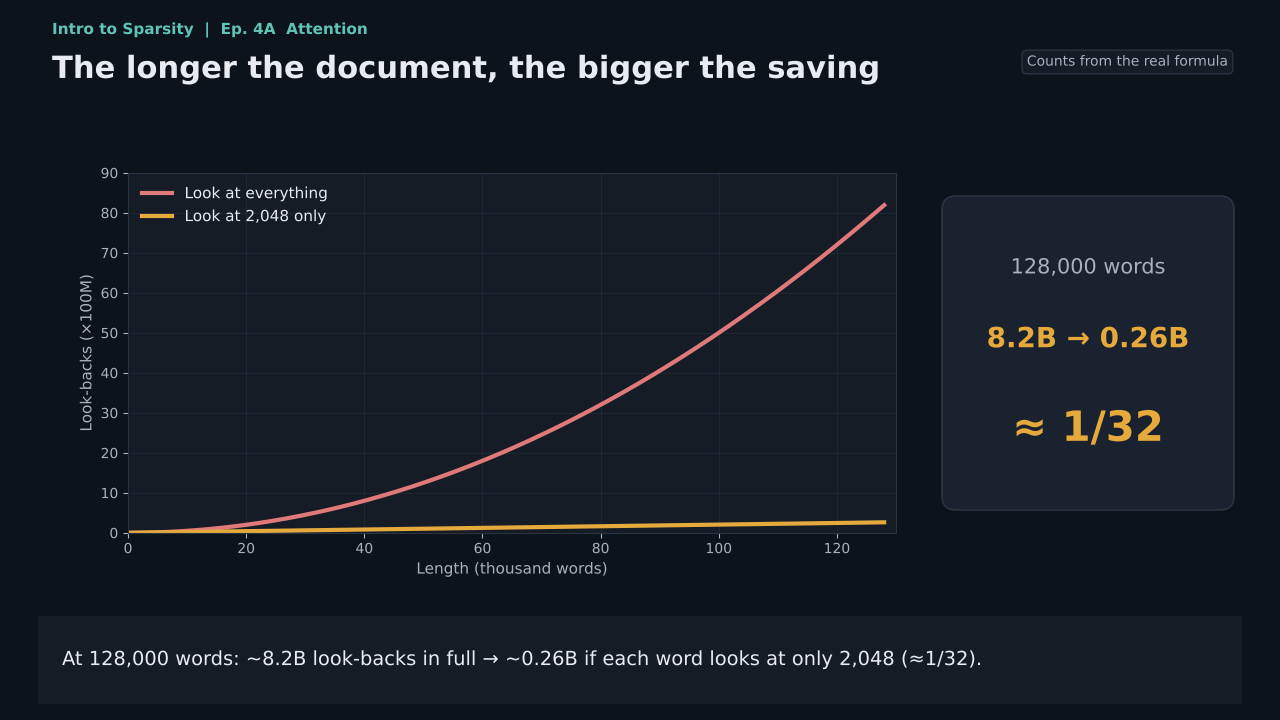
Un coup d'eau froide des mesures à grande échelle. The Sparse Frontier de Nawrot et al. (arXiv:2504.17768, publié officiellement dans Findings of ACL 2026) a évalué l'attention parcimonieuse sans apprentissage sur Qwen2.5 aux versions 7B à 72B, 16K à 128K, et sur 9 tâches, et a atteint 4 conclusions. Pour les séquences très longues, « grand et parcimonieux » l'emporte sur « petit et dense », et l'intersection se situe autour de 32 à 64K. Le taux de parcimonie optimal pour le préfilling est 0,80 à 0,93 (en termes de budget, 1/5 à 1/15), et le décodage a une plus grande tolérance. Presque toutes les configurations subissent une baisse de performance majeure sur au moins une tâche. L'attention parcimonieuse n'est pas une panacée. Et il n'existe pas une stratégie unique qui soit meilleure sur toutes les tâches et toutes les phases. C'est ce résultat qui a motivé la naissance de la troisième génération de « parcimonie nativement entraînable ».
Parcimonie d'activation
Q-Sparse (Wang, Ma, Wang & Wei, arXiv:2407.10969) applique directement top-k à l'activation de toutes les couches linéaires, rétropropage avec STE, et a démontré les lois d'échelle de la parcimonie. Le taux de parcimonie optimal est d'environ 45,58 % pour les modèles en précision complète et d'environ 61,25 % pour les modèles à 1,58 bit, et à un taux de parcimonie d'environ 40 %, il rivalise avec un modèle dense de la même taille. Lors du fine-tuning de Mistral 7B sur 40B tokens, Q-Sparse a enregistré 63,7 avec 3,8B d'activations, se rapprochant du baseline dense (7,0B) avec 64,6. Les ablations ont montré une baisse de performance claire, que ce soit en supprimant STE ou en remplaçant top-k par ReLU. De plus, avec ReLU, le taux de parcimonie a diminué à mesure que l'entraînement progressait, tandis qu'avec top-k, il est resté constant. Cela soutient l'argument selon lequel « la parcimonie devrait être une contrainte architecturale, et non un terme de régularisation ». TEAL, ReLU Strikes Back, Deja Vu et PowerInfer constituent les principales lignées côté edge.
Parcimonie en interprétabilité : l'essor et les doutes autour des SAE
La démarche d'Anthropic s'est déroulée comme suit. Towards Monosemanticity (2023) a utilisé des autoencodeurs creux pour extraire des caractéristiques monosémantiques d'un modèle monocouche. Scaling Monosemanticity (2024) a entraîné des SAE de jusqu'à 34 millions de caractéristiques sur Claude 3 Sonnet et a démontré le clamping de caractéristiques avec Golden Gate Claude. Circuit Tracing et On the Biology of a Large Language Model (2025) ont construit des graphes d'attribution avec des transcodeurs inter-couches et ont tracé le raisonnement multi-étapes de Claude 3.5 Haiku. Chez OpenAI, Gao et al. (2024) ont entraîné TopK SAE de 16 millions de caractéristiques sur GPT-4. Cette lignée est une descendante directe de l'apprentissage de dictionnaire Olshausen–Field.
Les doutes sont tous arrivés en 2024–2025. Absorption de caractéristiques (Chanin et al. 2024). Caractéristiques unidimensionnelles et non linéaires (Engels et al. 2024). Incapacité à surpasser la régression logistique sur 113 ensembles de données de probing (Kantamneni et al. 2025). Les caractéristiques trouvées diffèrent selon les SAE (Leask et al. 2025). En mars 2025, l'équipe de mechanical interpretability de Google DeepMind a annoncé que le domaine avait surexposé les SAE et qu'elle « réduirait temporairement la priorité de la recherche fondamentale sur les SAE ». Le consensus relativement modéré est que les SAE sont bien adaptées à la découverte de concepts inconnus, mais pas à la détection ou au contrôle de concepts connus. Bien que de nouvelles recherches comme SharedSAE et WriteSAE continuent à être produites en 2026, aucun nouveau consensus unifié n'a émergé.
Théorie unifiée : trois opérateurs et l'entraînement de top-k
Que ce soit dans LASSO, le pruning, les SAE, ou le routage MoE, l'étape qui « crée des zéros » est l'un des trois opérateurs suivants.
Sλ(y) = sign(y) · max(|y| − λ, 0), Hτ(y) = y · 1[|y| > τ], Pk(y) = projection conservant uniquement les k composantes de plus grande valeur absolue
Le seuillage doux est l'opérateur proximal de L1 (LASSO, ISTA, débruitage par ondelettes, SAE avec pénalité L1). Le seuillage dur correspond à L0 (pruning par magnitude, JumpReLU SAE). Et top-k est la projection sur l'ensemble des vecteurs k-creux (routage MoE, attention parcimonieuse, TopK SAE, Q-Sparse). ReLU lui-même est le seuillage dur unilatéral avec τ=0. Si presque tous les modèles à grande échelle modernes utilisent le troisième, c'est parce qu'il permet de fixer le nombre de calculs par token à une constante exacte, ce qui rend possibles la planification mémoire statique et les noyaux dédiés. À l'ère des modèles à grande échelle, la parcimonie est passée d'un « terme de régularisation » à une « contrainte architecturale ».
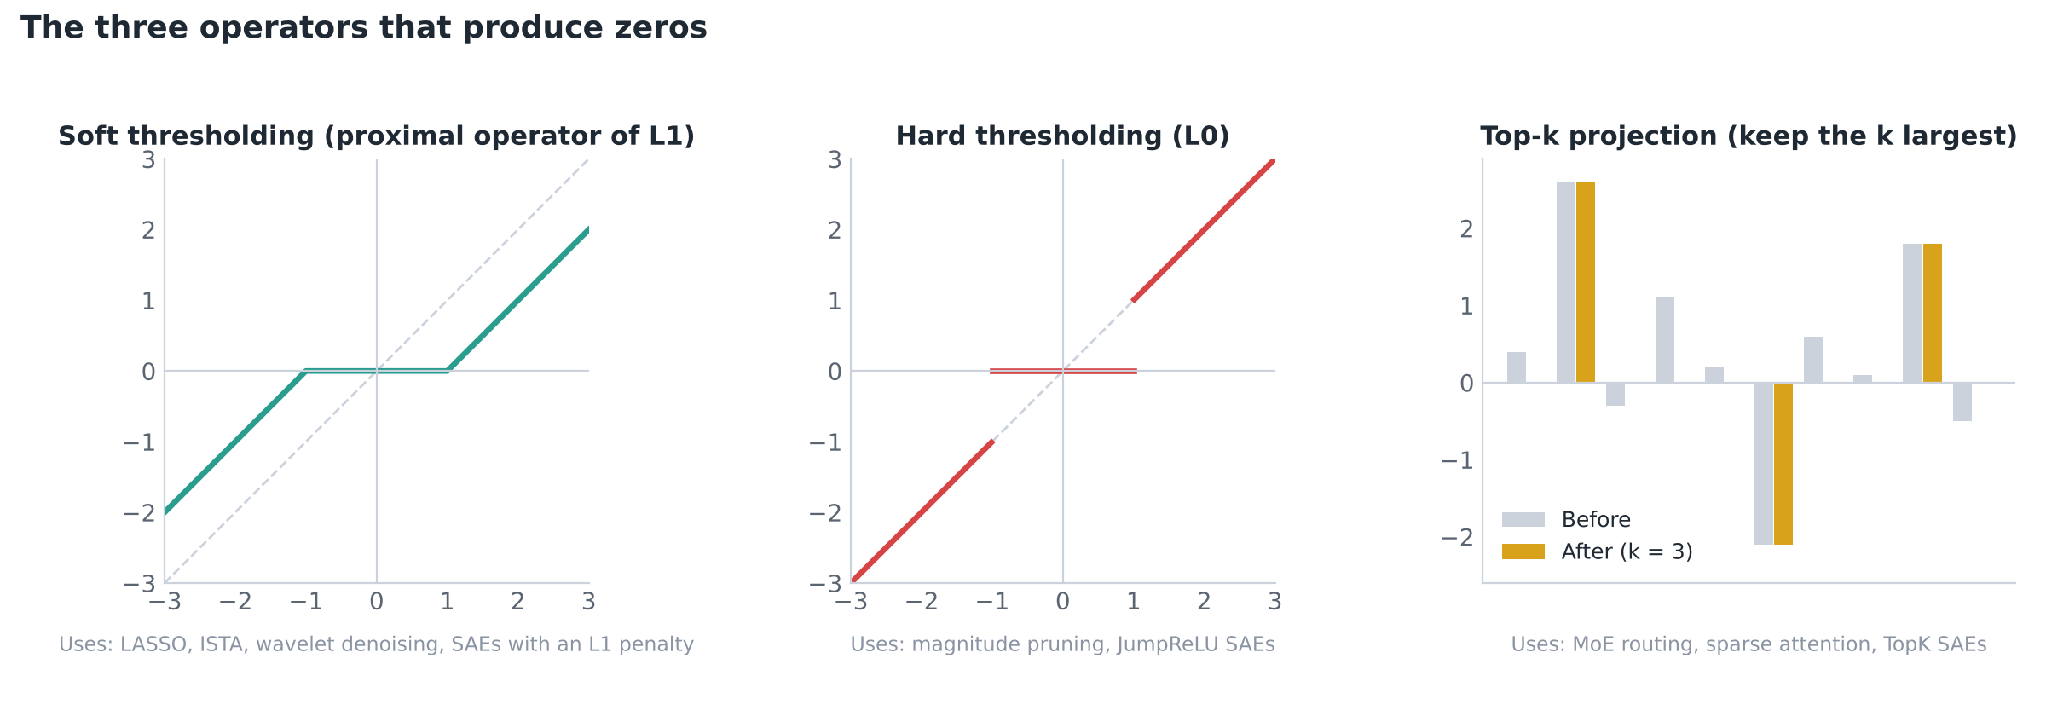
top-k n'est pas différentiable. Puisque ∂TopK/∂s est presque partout zéro, le gradient n'atteint que les poids des portes des experts sélectionnés, tandis que les autres ne peuvent pas apprendre. Il y a quatre approches d'ingénierie pour contourner cela : rétropropager uniquement aux experts sélectionnés et ajouter une perte de rééquilibrage auxiliaire (approche dominante) ; ajouter du bruit avec Noisy Top-k pour créer l'exploration (Shazeer 2017) ; utiliser une relaxation continue comme STE, Gumbel-Softmax ou Soft MoE ; et enfin la méthode sans perte auxiliaire de DeepSeek-V3 et ultérieur, c'est-à-dire classer avec s+b tout en pondérer avec s, et ajuster b en fonction de la charge en dehors du graphe de gradient. Du côté de l'attention parcimonieuse, NSA sélectionne au niveau des blocs pour que le gradient circule, tandis que DSA commence d'abord par un échauffage avec attention dense pour aligner l'indexeur sur la distribution d'attention dense avant de basculer vers l'apprentissage parcimonieux.
Concernant les lois d'échelle, Clark et al. (2022) ont unifié l'échelle des modèles routés et recommandé 64 à 128 experts. Krajewski et al. (2024) ont montré que les experts à grain fin surpassent les modèles denses à tous les budgets de calcul. Frantar et al. (2023) ont découvert que le taux de parcimonie optimal augmente avec la quantité de données. Le document Engram de DeepSeek (arXiv:2601.07372, janvier 2026) pose le problème de l'« allocation du budget de parcimonie » et trouve une loi en forme de U. Le pur MoE n'est pas optimal ; les meilleurs résultats se produisent lorsqu'environ 20 à 25 % du budget de paramètres creux est alloué à la mémoire conditionnelle. Neuf mois plus tard, cette découverte a été intégrée dans un produit appelé V4.1.
Économie et industrie
Le choc DeepSeek. Le 27 janvier 2025, Nvidia a chuté d'environ 17 % à la clôture, et une capitalisation boursière d'environ 589 milliards de dollars (Bloomberg) à 593 milliards de dollars (Reuters) a disparu. C'est la plus grande perte de capitalisation boursière en une seule journée de l'histoire du marché boursier américain.
Marge théorique de 545 %. Le 1er mars 2025, DeepSeek a divulgué que si l'on fixe les H800 à 2 dollars par heure, le coût quotidien est de 87 072 dollars, et le revenu théorique quotidien en facturation de tous les appels au prix de R1 est de 562 027 dollars. DeepSeek a également clarifié que le revenu réel est bien inférieur et que les coûts de recherche et développement et d'entraînement ne sont pas inclus. Lorsque vous citez ce chiffre, ajoutez toujours le mot « théorique ».
Prix de l'inférence. Epoch AI (mars 2025) a souligné que le prix de l'inférence au même niveau de capacité baisse à un rythme de 9 fois à 900 fois par an, et que cette vitesse varie selon les tâches. Pourtant, les dépenses totales des entreprises continuent d'augmenter. C'est parce que les agents multiplient plusieurs fois le nombre d'appels par tâche.
Économie de l'inférence MoE. La mémoire est déterminée par le nombre total de paramètres, et ce n'est que grâce aux grands batches et au parallélisme des experts que chaque expert reçoit suffisamment de tokens. MoE est intrinsèquement conçu pour les services centralisés à grande échelle, et non pour le self-hosting à petite échelle. vLLM et SGLang ont supporté MLA, DSA et V4.1 depuis le jour de leur publication publique.
Comparaison systématique de l'approche de chaque institution de recherche
En alignant les institutions de recherche selon les mêmes critères, on constate que le chemin vers la parcimonie n'en est pas un seul, mais que plusieurs stratégies sont en concurrence en parallèle.
| Institution de recherche | Divulgation de la configuration | Principaux types de parcimonie | Experts (sélectionnés / total) | Stratégie d'attention | Stratégie KV | Format de poids | Modèle représentatif | Caractéristiques remarquables |
|---|---|---|---|---|---|---|---|---|
| DeepSeek | Publié avec rapport technique | MoE + attention parcimonieuse + mémoire conditionnelle | 6/384 + partagé 1 | Parcimonie native (DSA→CSA2), entraîné parcimonieux dès le départ | MLA faible rang + FP4 + réutilisation inter-couches, 890 B/token | Experts FP4/FP8 | V3, V3.2, V4, V4.1-Flash | Trois axes de parcimonie empilés. Division du travail encodeur-décodeur pour les agents |
| Moonshot (Kimi) | Poids et rapport publics | MoE + hybride attention linéaire | 16/896 + partagé 2 | MoBA parcimonieux en bloc. K3 est attention linéaire KDA + MLA gated | Pas de KV pour les couches linéaires | MXFP4 QAT | K2, K2.5, K3 | Plus grand nombre d'experts. Entraînement stable avec MuonClip |
| Alibaba (Qwen) | Carte de modèle publique | MoE + hybride attention linéaire | 10/512 + partagé 1 | Gated DeltaNet et Gated Attention dans un ratio 3:1 | KV réduit d'environ 1/4 | BF16/FP8 | Qwen3, Qwen3.5 | Série complète de l'edge au flagship |
| Meta | Carte de modèle publique | MoE | 1/128 + partagé 1 (Maverick) | Alternance de couches denses et de couches MoE. iRoPE | GQA standard | BF16 | Llama 4 | Contexte de 10M (Scout). Behemoth n'est pas encore publié |
| OpenAI | Seul gpt-oss est public | MoE | 4/128 | Alternance de fenêtre glissante (128) et attention complète. attention sink | GQA, 8 têtes | MXFP4 | gpt-oss-120b/20b | GPT-5.x est non-public. Recherche SAE (Gao 2024) |
| Gemini 1.5 et 2.5 sont confirmés officiellement comme étant MoE. Les détails ne sont pas divulgués. | MoE. Architecture flexible pour les appareils périphériques. | Non divulgué | Non divulgué | Non divulgué | Non divulgué | Gemini 1.5/2.5, Gemma 3n | Sous-modèles imbriqués MatFormer, PLE | |
| Anthropic | Non divulgué | Parcimonie pour l'interprétabilité (SAE, transcodeur) | Non divulgué | Non divulgué | Non divulgué | Non divulgué | Série Claude | Utiliser la parcimonie comme outil pour « comprendre le modèle » |
| Mistral | Poids publiés | MoE | 2/8 | Standard | GQA | BF16 | Mixtral 8x7B/8x22B | Premier MoE open source de haute qualité (décembre 2023) |
| Microsoft Research | Article publié | Parcimonie d'activation + 1,58 bits | — | Standard | Standard | 1,58 bits (BitNet) | Q-Sparse, BitNet b1.58 | Combinaison de parcimonie et de quantification extrême en bits faibles |
| Meituan / Ant / Zhipu | Fiche modèle publiée | Variante MoE | Divers | Divers | Divers | Divers | LongCat-Flash, Ling, GLM-4.5/4.6 | Expert avec calcul zéro, MoE avec connexion de raccourci |
Trois observations en découle. Premièrement, la principale source d'innovation en architectures parcimonieuses est le camp des modèles open source chinois. Les experts à granularité fine, les experts partagés, l'équilibrage des charges sans perte auxiliaire, l'attention parcimonieuse native, la mémoire conditionnelle et l'hybride attention linéaire ont été presque tous annoncés en premier par DeepSeek, Qwen et Kimi. Deuxièmement, la composition des grandes institutions de recherche fermées est une boîte noire, et nous ne pouvons que la déduire à partir d'informations publiques telles que les rapports GPT-oss et Gemini. Citer « GPT-4 est un MoE de 1,8T » comme un fait est une erreur courante. Troisièmement, l'attention s'est divisée en deux voies. DeepSeek a choisi « l'attention parcimonieuse » (ne calculer qu'une partie des paires de jetons), tandis que Qwen et Kimi ont choisi « l'hybride attention linéaire » (remplacer le cache KV par un état récursif). Les deux s'attaquent au même problème de mémoire et de bande passante du cache KV, mais les outils mathématiques sont différents. Le premier est parcimonieux, tandis que le second est proche de la récursion de faible rang.
Pile système : ingénierie pour mettre en œuvre réellement la parcimonie
La réalisation réelle des gains d'une architecture parcimonieuse dépend d'une couche souvent négligée : les logiciels système.
Parallélisme expert et communication. DeepEP (publié par DeepSeek en 2025) fournit un noyau all-to-all à haut débit et faible latence supportant FP8 et RDMA sur NVSHMEM, en chevauchant la communication et le calcul. MegaBlocks (2023) a réécrit le calcul MoE en tant que GEMM creux par bloc pour réaliser un MoE sans gouttes, atteignant une vitesse 2,4 fois supérieure à celle de Megatron-LM dense.
Noyau d'attention. FlashMLA est optimisé pour MLA. DSA et CSA2 doivent disposer à la fois d'indexeurs et de noyaux d'attention parcimonieuse, et DeepSeek les a publiés avec FlashMLA et DeepGEMM. Les 3 modes de CSA2 dans V4.1 signifient que le moteur d'inférence doit gérer la réutilisation inter-couches de KV et d'indices.
Cadre d'inférence. vLLM et SGLang ont supporté MLA, DSA et V4.1-Flash dès le premier jour, couvrant H100/H200/B200/GB200 et AMD MI355X. NVIDIA NeMo AutoModel fournit des recettes de réglage fin V4.1, nécessitant 64 GPU au sein d'un seul domaine NVLink.
Stockage hiérarchique. La table Engram de V4.1 (environ 183 GiB) est placée en mémoire hôte et préchargée via RDMA. Il existe déjà des articles portant sur la conservation d'Engram dans un pool de mémoire CXL, transférant la « connaissance » de la HBM vers une couche moins chère. SWA Bounded Replay évite la persistence SSD du KV de fenêtre glissante.
Format de quantification. MXFP4 (une échelle partagée de 8 bits pour 32 éléments, moyenne 4,25 bits) est devenue le standard de facto pour les poids d'expert MoE entre 2025 et 2026. Blackwell supporte nativement les noyaux tenseurs FP4.
La conclusion de cette section résonne avec l'« ère des réseaux de neurones ». Chaque victoire de la parcimonie s'accompagnait inévitablement de noyaux et d'ordonnancement correspondants. La parcimonie 2:4 ne s'est pas généralisée car, même avec des noyaux tenseurs, il manquait une pile logicielle mature de bout en bout. MoE est devenu courant grâce à DeepEP, MegaBlocks et vLLM.
Où la parcimonie rencontre l'apprentissage profond : avancées récentes du traitement d'image et de signal
Alors que les grands modèles ont utilisé la parcimonie pour économiser le calcul, le traitement d'images et de signaux a emprunté une voie différente : combiner des distributions a priori parcimonieuses avec des réseaux profonds pour restaurer des signaux à partir de mesures incomplètes et bruitées. Les résultats de cette approche ont également influencé la direction inverse, modifiant la façon dont nous interprétons les grands modèles et façonnant leur conception architecturale.
Le point de départ est LISTA de Gregor et LeCun (2010). Les itérations fixes d'ISTA sont « déroulées » en un réseau ayant un nombre fini de couches, dont les paramètres deviennent apprentissables. Chaque couche reste toujours « transformation linéaire + seuillage doux », mais la matrice et le seuil sont appris à partir des données. Le résultat converge 1 à 2 ordres de grandeur plus rapidement que l'ISTA réglé manuellement, tout en conservant une structure interprétable. Chaque couche correspond à une étape de la méthode du gradient proximal. Le déroulement d'algorithme est devenu par la suite le cadre principal du traitement d'image computationnelle. ADMM-Net et ISTA-Net sont utilisés pour la reconstruction d'IRM en détection comprimée, et les réseaux déroulés surpassent les méthodes classiques de CS sur des données de sous-échantillonnage clinique. La signification plus profonde du déroulement est de montrer que les réseaux profonds peuvent être lus comme une version apprentissable des solveurs creux. Cette intuition a fourni par la suite la compréhension pour décoder les réseaux de neurones avec des dictionnaires creux.
Priors connectés et branchés, régularisation par débruitage
La régularisation classique (L1, variation totale) écrit explicitement le prior comme un terme de pénalité. Le cadre Plug-and-Play (PnP) apparu après 2013 a découvert que l'étape « appliquer l'opérateur proximal » d'ADMM ou de la méthode du gradient proximal pouvait être remplacée par un débruiteur arbitraire, c'est-à-dire un réseau de débruitage profond entraîné. Le prior passe d'« une formule unique » à « un débruiteur boîte noire », et le prior parcimonieux en devient un cas particulier. Regularization by Denoising (RED) et les priors de modèles de diffusion ultérieurs héritent de cette lignée. Dans ce point de vue, le débruitage par seuillage doux, BM3D et les débruiteurs profonds sont trois générations de pièces interchangeables qui s'emboîtent à la même position.
Deep Image Prior : la structure du réseau elle-même est un prior
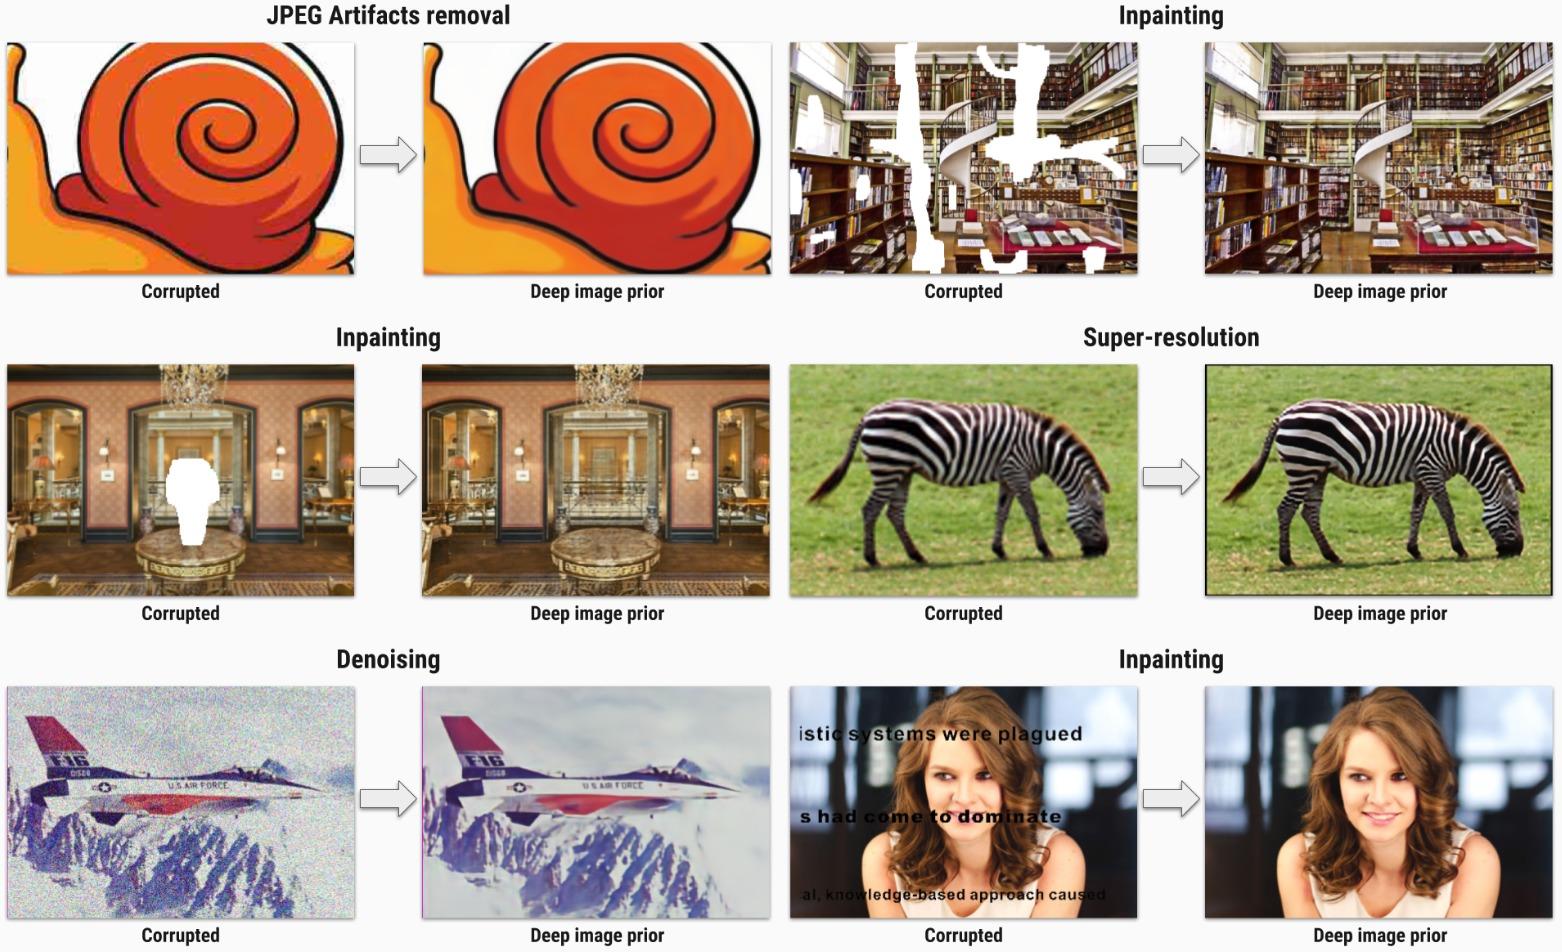
Deep Image Prior d'Ulyanov, Vedaldi et Lempitsky (2018) donne un résultat contre-intuitif. En ajustant simplement un réseau convolutif non entraîné initialisé aléatoirement à une seule image dégradée, on peut effectuer du débruitage, de la super-résolution et de l'inpainting. La structure du réseau convolutif préfère les statistiques auto-similaires à basse fréquence des images naturelles, et l'ajustement au bruit est lent, donc l'arrêt précoce donne une image claire. Cela se relie directement aux statistiques d'image naturelle discutées dans la « préhistoire ». La structure du réseau encode implicitement le prior « les images naturelles sont parcimonieuses sous certaines bases », et la seule différence est que ces bases ne sont plus écrites explicitement. Après DIP, « la structure en tant que prior » est devenue une lentille importante pour comprendre le biais inductif des réseaux de neurones et un pont vers la théorie classique parcimonieuse. On peut voir DIP comme une méthode qui accomplit la même chose de manière adaptative par le biais d'une « trame » implicite et apprentissable, c'est-à-dire une méthode qui ne conserve que les composantes qui représentent vraiment la structure du signal.
Dictionnaires appris et trames structurées
Entre les ondelettes fixes, les dictionnaires non structurés appris par K-SVD et les priors implicites appris par les réseaux profonds, il existe un chemin intermédiaire. Apprendre les paramètres à partir des données tout en préservant la structure mathématique des trames serrées ou des transformations unitaires (reconstruction parfaite, conservation de l'énergie). NSOLT (transformation symétrique directionnelle non séparable) et LSUN (réseau unitaire à structure en treillis) appartiennent à cette catégorie. En contraignant la transformation à la variété des trames serrées et en la paramétrisant par une structure en treillis, on gagne l'adaptabilité à des données spécifiques tout en préservant l'interprétabilité et la réversibilité des transformations classiques. La valeur de cette voie est en train d'être redécouverte à l'ère des grands modèles. SAE nécessite un dictionnaire surcomplèt, et MLA nécessite une projection de faible rang réversible. Les deux cherchent un équilibre entre contrainte structurelle et adaptation aux données, ce qui est exactement le problème de conception auquel les trames structurées se sont toujours confrontées.
Trois points de contact avec les grands modèles
Trois points de contact avec les modèles de grande taille
Premièrement, l'AES est lui-même un codage sparse. L'autoencodeur sparse d'Anthropic est mathématiquement identique à l'apprentissage de dictionnaire d'Olshausen-Field ; seules les données ont changé. Des patchs d'image aux activations du flux résiduel. Deuxièmement, le dépliage algorithmique a devancé la lecture « réseau = solveur ». Le transcodeur d'Anthropic et les graphes d'attribution constituent essentiellement une exploration de graphes de calcul alternatifs, sparsifiés et lisibles, pour le Transformer. Troisièmement, l'idée de distribution a priori structurelle s'est immiscée dans la conception architecturale. Les blocs d'experts de MoE, la réutilisation intercouches de CSA2, les tables de consultation d'Engram inscrivent tous une croyance — « les données doivent posséder cette structure » — non pas dans la fonction de perte, mais dans la forme même du réseau. C'est le correspondant de la conclusion de la section « théorie unifiée » dans le monde du traitement d'image. La sparsité a migré d'un terme de régularisation vers une contrainte architecturale.
Applications : où la parcimonie a vraiment créé de la valeur
La parcimonie crée de la valeur dans les lieux où il y a énormément de choses à traiter, mais très peu qui sont vraiment importantes. L'examen de longs documents en est l'un des exemples les plus typiques.
Inférence LLM dans le cloud. Presque toutes les API frontier bas de gamme en 2026 proviennent de modèles MoE hautement spars. La sortie hors pointe de DeepSeek-V4.1-Flash est de $0,60/M, gpt-oss-120b est environ $0,03/M en entrée et $0,17/M en sortie sur OpenRouter.
Contexte long et agents. Lors de l'annonce de V4.1, DeepSeek a déclaré que la majorité des coûts d'agent provient souvent de la facturation des accès au cache, et que la compression du cache pourrait réduire considérablement cette partie. Le prix de l'entrée en cache ($0,006/M) est 1/50 du prix d'accès manqué au cache ($0,30/M), ce qui est le levier central de l'économie des agents.
Edge. LLM in a Flash d'Apple (2023) charge à la demande depuis le stockage flash les paramètres activés sparsément. Gemma 3n utilise les sous-modèles imbriqués de MatFormer et l'intégration par couche (PLE). Les modèles MoE avec 3B d'activations comme Qwen3.5-35B-A3B deviennent des candidats viables pour le navigateur et l'edge.
Multimodal. V4.1 applique un biais de routage dédié aux jetons d'image. Les jetons visuels sont nombreux et hautement redondants, ce qui en fait des cibles idéales pour l'attention sparse.
Science et médecine. CS-MRI a réduit le temps d'examen moyen en clinique quotidienne d'environ 20 %, et de 23 % à 43 % pour une seule séquence. Le pipeline SMILI soutenant l'imagerie des trous noirs de l'EHT est construit sur une modélisation sparse.
Examen d'entreprise de documents et plans longs (directement lié à notre activité)
Benchmark établissant la difficulté. MMLongBench-Doc (NeurIPS 2024 D&B) a rassemblé 135 PDF d'une moyenne de 47,5 pages et ~21 000 jetons de texte, avec 1 082 questions rédigées par des experts. Parmi celles-ci, 33,2 % nécessitent des preuves traversant les pages, et 22,8 % sont conçues pour être sans réponse afin de détecter les hallucinations. Le F1 des annotateurs humains est de 66,0 %, et sur 14 modèles de vision-langage, 12 se comportent moins bien que lorsque du texte OCR est fourni aux modèles texte uniquement correspondants. Les 396 documents de LongDocURL font en moyenne 86 pages, avec 52,9 % des questions traversant les pages. La longueur de ces documents et la proportion de questions traversant pages et éléments sont étrangement similaires aux demandes d'approbation architecturale (plans et documents de calcul structurel/demandes de plus de dizaines à bien au-delà de 100 pages).
Le goulot d'étranglement n'est pas seulement la longueur du contexte. C'est de choisir le bon top-K parmi les preuves dispersées. La récupération (sélection des top-K pages) et l'attention sparse (sélection des top-K blocs de jetons) sont mathématiquement le même opérateur. La différence est que ce choix se produit-il en dehors du modèle (auditable, peut citer les articles) ou à l'intérieur (bout en bout mais opaque).
Limites. Sparse Frontier montre que l'attention sparse peut dégrader les performances de tâches individuelles même à des taux de sparsité modérés. Dans les tâches d'examen, « l'article X en page 37 contredit la dimension énoncée ailleurs » est exactement un « tâche où oublier un seul élément rend toute la réponse erronée ». Par conséquent, un hybride de récupération et de re-vérification en contexte long est plus sûr que de parier sur l'un ou l'autre. Les recherches multiples pages de 2025, dont SimpleDoc, MDocAgent et LAD-RAG, suivent également cette voie.
Avantages et coûts
Pour la sparsité des poids, « la sparsité est surévaluée » à l'ère des LLM est largement correct. Pour le calcul conditionnel et la sparsité d'attention, c'est l'inverse — tous deux sont déjà le défaut du frontier. Distinguer ces deux catégories est la clé pour comprendre le débat entier.
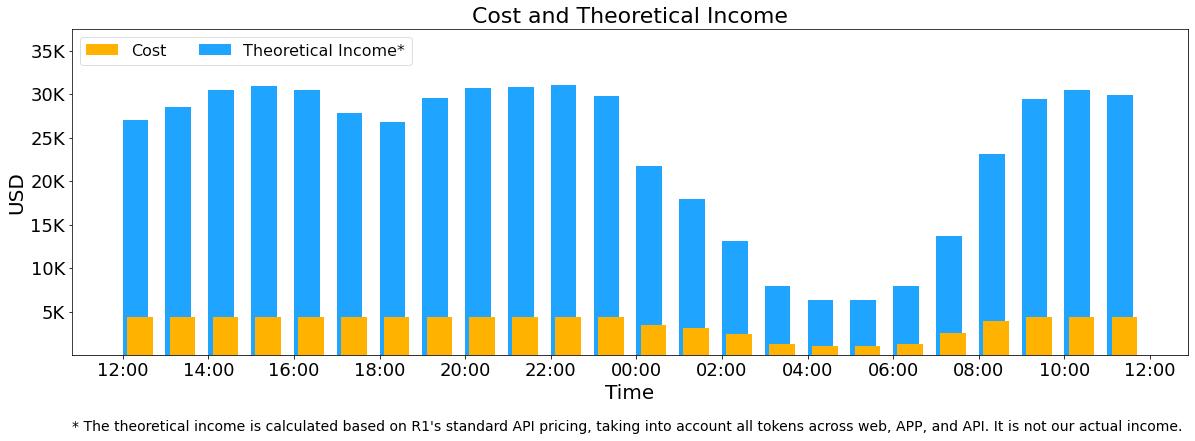
Avantages
Coût : le taux d'activation baisse jusqu'à 1,5 %–4,5 %, et la courbe de prix s'effondre rapidement.
Séparation de la capacité et du calcul : le nombre total de paramètres détermine la capacité de connaissance, les paramètres activés déterminent le coût par jeton, et les deux peuvent s'adapter indépendamment. Engram va plus loin, en déplaçant la connaissance statique vers une mémoire d'accueil moins chère.
Réalisation du contexte long : les FLOPs de décodage de V4.1 n'augmentent que d'environ un quart entre 4K et 1M.
Outil d'interprétabilité : SAE et transcodeurs sont utilisés pour découvrir des concepts inconnus.
Coûts et risques
La mémoire est déterminée par le nombre total de paramètres : les experts de routage de V4.1 (MXFP4) occupent environ 259,5 GiB, et les tables Engram environ 183 GiB. La sparsité n'économise pas le stockage.
Surcharge de communication : l'all-to-all de parallélisme d'experts est le goulot d'étranglement principal de la formation MoE, et Engram nécessite de la prélecture sur RDMA ou CXL.
Instabilité de l'apprentissage et déséquilibre de charge : une série de correctifs est nécessaire, notamment la perte-z, l'ajustement du biais et le routage par hachage.
L'ajustement fin est difficile : le routage a tendance à s'effondrer sur les petits ensembles de données. La procédure officielle d'ajustement fin de V4.1 nécessite 64 GPU dans un seul domaine NVLink.
Pièges de l'évaluation : la découverte de Sparse Frontier selon laquelle « presque toutes les configurations perdent des performances sur au moins une tâche ». V4.1 correspond au frontier sur les benchmarks des fournisseurs, mais est environ 10 points plus faible sur les indicateurs complets indépendants.
Limites des SAE : voir la section « Sparsité dans l'interprétabilité ».
La sparsité des poids perd toujours en efficacité : les méthodes conventionnelles ne peuvent pas dépasser le mur de sparsité de 50 %–60 %.
Perspectives représentatives (citées des sources)
| Position | Source | Perspective |
|---|---|---|
| Favorable : les gagnants sont décidés par le matériel | Hooker 2021 | Les idées gagnent non pas « parce qu'elles sont meilleures, mais parce qu'elles correspondent aux logiciels et matériels disponibles » |
| Favorable : nouveau axe de sparsité | DeepSeek, Engram 2026 | « Je crois que la mémoire conditionnelle deviendra une primitive de modélisation essentielle pour la prochaine génération de modèles spars » |
| Prudent | Nawrot et al. 2026 | « L'attention sparse n'est pas une balle d'argent » |
| Négatif | Google DeepMind 2025 | « Je ne crois pas que les SAE deviennent un game-changer en interprétabilité, et je soupçonne que ce domaine a sur-investi dans les SAE » |
| Intermédiaire | arXiv:2506.23845 | Les SAE sont faibles pour traiter les concepts connus, mais un outil puissant pour découvrir les concepts inconnus |
Verdict sur chacun des 5 types de sparsité (septembre 2026)
Il n'y a pas de réponse unique à « la sparsité est-elle surévaluée ? » Cette question nécessite une réponse par type.
| Type de sparsité | Situation en 2026 | Verdict | Principales raisons |
|---|---|---|---|
| Sparsité des poids (élagage non structuré) | La recherche est active, l'adoption industrielle est minime | Surévaluée à l'ère des LLM. La quantification a gagné. | Mur de sparsité de 50 %–60 %. Absence de noyaux GPU efficaces. MXFP4 est devenu de facto |
| Sparsité structurée (2:4, bloc) | Le support matériel existe, mais l'accélération bout en bout est limitée | Partiellement réalisée. Le sparsité bloc a gagné sous la forme de MoE. | 2:4 atteint rarement 2× dans les mesures réelles. Le bloc-sparse GEMM de MegaBlocks est devenu la base de MoE |
| Sparsité d'activation (ReLU, activation top-k) | Attention sur l'edge et la recherche. Absorbée par MoE dans le cloud | Potentiel sous-estimé. Mais le principal champ de bataille est l'edge. | Q-Sparse égale les modèles denses à ~40% de sparsité. TEAL et PowerInfer ciblent les appareils avec contraintes mémoire |
| Calcul conditionnel (MoE) | Architecture par défaut du frontier | Conforme à la réputation. Approfondissement en cours | Le taux d'activation a baissé de 25 % à 1,5 %–4,5 % en 2 ans. Tous les modèles open source de classe flagship 2025–2026 l'adoptent |
| Sparsité d'attention | Version entraînable de manière native en production | Établie. Mais risque de dégradation de performance par tâche | NSA a remporté ACL Best Paper. V4.1 formé sparse dès le départ. « Au moins une tâche baisse » de Sparse Frontier |
| (Lignée parallèle) Faible rang | MLA et LoRA largement utilisés | Établie. Ne pas confondre avec la sparsité. | Compression KV faible rang jusqu'à ~93 % (V2). LoRA est la norme pour l'ajustement fin |
| (Outil) Dictionnaire sparse / SAE | Le débat continue | Établi comme outil de découverte. Surévalué comme détecteur/contrôleur. | GDM a abaissé la priorité. Inférieur à la sonde linéaire sur 113 ensembles de données. Anthropic s'est tourné vers les transcodeurs et les graphiques d'attribution |
En un mot : La sparsité a gagné en « activation » et « attention », perdu en « poids ». Elle a gagné non pas parce que la théorie était meilleure, mais parce que le matériel pouvait exploiter la structure aux positions des zéros.
Avenir (2026–2030)
L'axe suivant de la sparsité n'est plus « quel paramètre calculer », mais « quelle connaissance stocker et quel historique lire ». Ci-dessous, le frontier de la recherche, les tendances du matériel, et cinq prédictions falsifiables.
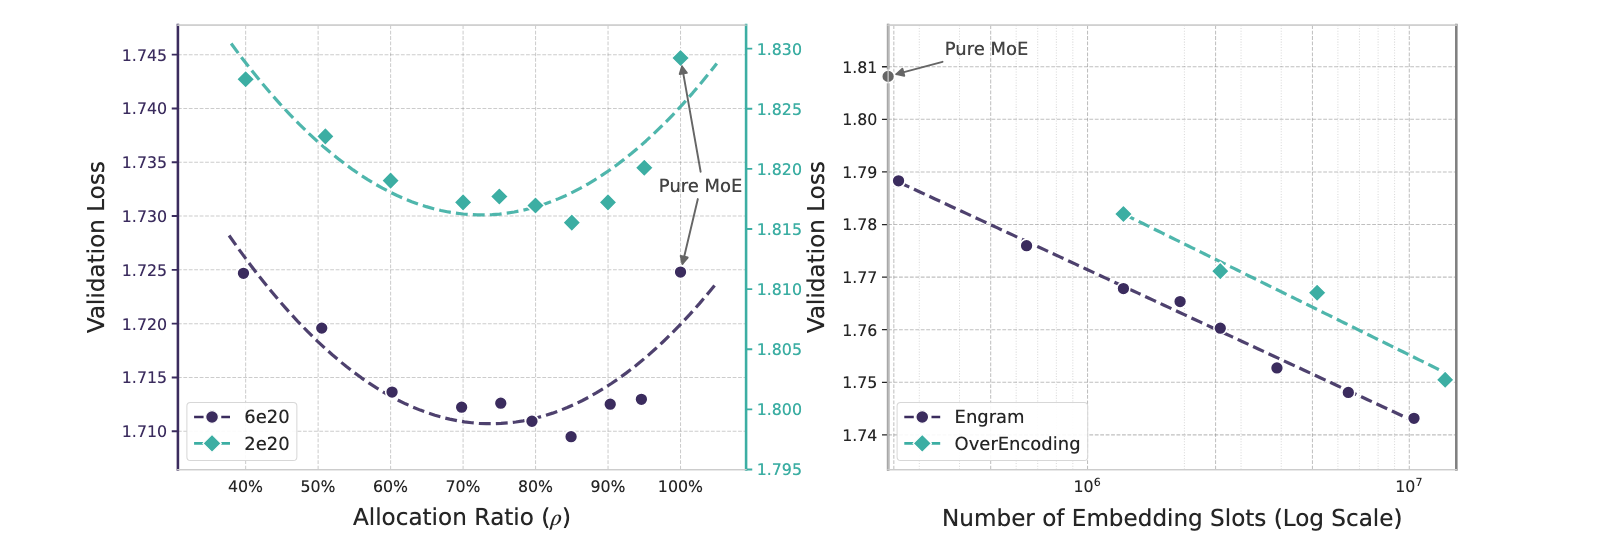
Research Frontier
Multi-axis sparsity and budget allocation. The U-shaped law discovered in the Engram paper shows that pure MoE is not optimal and that sparsity budget should be divided between "experts" and "conditional memory." The 27B Engram model achieved +3.4 MMLU, +5.0 BBH, and +3.0 HumanEval over MoE baselines with the same parameter count and FLOPs. According to mechanistic analysis, conditional memory frees early layers from static knowledge reassembly.
Native learnable sparsity becomes the default. V4.1 learns sparse attention at 64K from the start, without dense warmup. This shows that sparse attention has transitioned from inference-time approximation to first-class citizen during training.
Sparsity × reasoning computation. Reasoning models generate long outputs, making both prefill and decode expensive. MoE provides capacity for knowledge; long chains of thought provide depth for reasoning. CED's asymmetric activation is a tradeoff for workloads with different read-write ratios.
Modularity and continual learning. Experts and memory tables can be edited locally. For instance, there is research on writing user memory as local parameter edits (User as Engram, arXiv:2606.19172).
Combination of sparsity and quantization. MXFP4 experts, FP4 KV, and FP8 Engram are already used together in V4.1 and K3. The conclusion of Q-Sparse is that the more aggressive quantization is, the higher the optimal degree of sparsity.
Co-design with hardware. Blackwell natively supports FP4, and hierarchical KV storage using CXL memory pools and SSDs is advancing. LLM-scale neuromorphic computing remains a distant prospect.
Five falsifiable predictions (with reasoning)
| Prediction | Deadline | Reasoning |
|---|---|---|
| At least one major open model's global KV drops below 500 bytes per token | End of 2027 | From V1 to V4.1 it is 1/437, from V4 to V4.1 alone 1/4, FP4 is already in use |
| At least 3 of the top 5 open models achieve activation rate below 3% per token | End of 2027 | Already as of 2026 there are V4.1 (2.9%), K3 (3.7%), Qwen3.5 (4.3%), and expert count doubles every generation |
| At least 2 major research institutions other than DeepSeek adopt lookup-table-style conditional memory in their flagship open model | 2028 | Engram already has CXL, SSD, and training-free derivative research; it also shipped in NeMo |
| SAE will not become a primary official safety monitoring method announced by any frontier research institution | 2028 | Priority downgrade of GDM. Negative results on downstream tasks |
| API unit price at the same capability level continues to fall 10× per year or faster, but enterprise spending per task on agents increases | Ongoing | Epoch price trends. Agent call count doubled |
What it means for us
Review is fundamentally a task of selecting top-K from vast clauses and pages, and the sparsity trend is pushing down precisely the unit cost of this class of task. For companies developing review agents for long documents and drawings, there are four actionable takeaways.
Cost curve. Treat "cache hit rate" and "proportion of off-peak batch processing" as first-class metrics. Review tasks are inherently batchable and runnable offline. Place stable statutes and ordinances at the start of the prompt to maximize prefix cache hits. In V4.1, cached input pricing is 1/50 of cache misses, and off-peak is half again.
Model selection. Select models using your own evaluation set for "cross-page reconciliation and clause citation," and judge by the score on the hardest subtask, not the average. Use highly sparse open MoE as the main workhorse, and close-sourced frontier models for double-checking hard cases.
Long context strategy. Adopt a hybrid of "search top-K pages (auditable with citations) + re-check on 1M context (to catch cross-page relationships)" . The conclusion of Sparse Frontier applies directly here. Betting on sparse attention alone causes performance to drop on some tasks, and review is precisely a "one missed item breaks the whole answer" task.
Self-hosting decision. MoE memory is determined by total parameters. V4.1's routing experts and Engram table exceed 440 GiB combined, and the official fine-tuning procedure requires 64 GPUs within a single NVLink domain. Below tens of GPUs, self-hosting rarely pays for itself; choose an API.
Research opportunity. Existing work treats "which pages to check within budget" as a search problem. But in cross-page consistency checking, the truly sparse object is not "pages" but "page pairs." P pages have P(P−1)/2 pairs, and we select k pairs to cross-check. This maps directly to a sparse cooperation graph in multi-agent systems, and scoring all (query, key) pairs with a lightweight indexer and taking top-k is structurally identical to DSA's idea. This is a direction where we can differentiate and break through.
Appendix
A. Timeline (1948–September 2026)
| Year | Event | Confidence |
|---|---|---|
| 1948 | Shannon, A Mathematical Theory of Communication: formalization of redundancy and entropy | Primary paper |
| 1961 | Barlow's redundancy reduction hypothesis | Primary paper |
| 1967 | Tinney & Walker sparse matrix ordering (power grid computation) | Primary paper |
| 1978 | Rissanen's Minimum Description Length (MDL) | Primary paper |
| 1987 | Field: natural image statistics and cortical receptive fields | Primary paper |
| 1988–89 | Daubechies compactly supported orthogonal wavelets. Mallat's multiresolution analysis | Primary paper |
| 1990–93 | OBD / OBS pruning. Matching Pursuit | Primary paper |
| 1991 | Jacobs–Jordan–Nowlan–Hinton mixture of local experts | Primary paper |
| 1992 / 2000 | JPEG / JPEG2000 | Standard |
| 1994–96 | Wavelet threshold denoising. Breiman's garrote. LASSO. Olshausen & Field sparse coding | Primary paper |
| 1998 | Basis Pursuit. DeVore nonlinear approximation | Primary paper |
| 2001–03 | Attwell & Laughlin energy budget. Lennie's "likely less than 1%" | Primary paper (verified) |
| 2004–05 | LARS。Elastic Net | Primary paper |
| 2006–07 | Compressed sensing. K-SVD. Lustig CS-MRI | Primary paper |
| 2009 | Donoho–Tanner phase transition | Primary paper |
| 2011 | Glorot ReLU (50–85% strict zeros). Robust PCA | Primary paper (verified) |
| 2012 | Google's cat-face neuron | Primary paper (verified) |
| 2013–14 | Bengio conditional computation and STE. Gavish–Donoho optimal hard threshold | Primary paper |
| 2016 | Deep Compression | Primary paper |
| 2017 | Shazeer sparse gate MoE (137B MoE layer) | Primary paper (verified) |
| 2019 | Lottery ticket hypothesis. EHT M87*. Sartorettis CS-MRI clinical study | Primary paper |
| 2020 | GShard. Hooker Hardware Lottery. Ampere's 2:4 | Primary paper |
| 2021–22 | Switch Transformer. GLaM. ST-MoE. Expert Choice. Clark's MoE scaling | Primary paper |
| 2023 | Mixtral。SparseGPT / Wanda。StreamingLLM / H2O。Towards Monosemanticity | Primary paper |
| January–February 2024 | DeepSeekMoE. Gemini 1.5 officially confirmed to be MoE | Technical report |
| May 2024 | DeepSeek-V2 (MLA)。Scaling Monosemanticity。Golden Gate Claude | Technical report |
| June–July 2024 | Gao's TopK SAE. Q-Sparse | Primary paper (verified) |
| December 2024 | DeepSeek-V3 (671B/37B) | Technical report |
| January 27, 2025 | DeepSeek Shock: Nvidia's market cap fell by approximately $589 billion in one day | Trusted reporting |
| February–March 2025 | NSA, MoBA. Theoretical profit margin of inference systems 545%. GDM downgrades SAE priority | Primary paper / Official |
| April 2025 | Qwen3 MoE. Sparse Frontier preprint. Llama 4 | Official / Primary paper |
| July–August 2025 | NSA wins ACL Best Paper. Kimi K2. gpt-oss | Official |
| September–December 2025 | DeepSeek-V3.2、DSA | Technical report |
| January 2026 | Engram: conditional memory and U-shaped sparsity budget allocation | Primary paper |
| February 2026 | Qwen3.5-397B-A17B | Official model card |
| April 24, 2026 | DeepSeek-V4 (Pro 1.6T/49B、Flash 284B/13B) | Technical report |
| July 2026 | Kimi K3 (2.8T/104B). Sparse Frontier published in Findings of ACL 2026 | Official |
| September 10, 2026 | DeepSeek-V4.1-Flash (CED, CSA2, 890 B/token, Engram) | Official + Technical report (verified) |
B. Graphable data series
DeepSeek global KV cache (per token): V1 ≈ 389 KB (estimated) → V3.2 ≈ 48 KB → V4-Flash ≈ 3.5 KB → V4.1-Flash 890 B. Log scale.
Activation rate per token: Mixtral 28% → Qwen3 9.4% → gpt-oss 4.4% → Qwen3.5 4.3% → Kimi K3 3.7% → V4.1 decode 2.9% / prefill 1.4%.
Nombre d'experts (sélectionnés / total) : 2/8 → 4/128 → 8/256 → 6/384 → 10/512 → 16/896.
Prix de l'API DeepSeek ($/M, entrée / sortie) : V4-Flash 0.14 / 0.28. V4-Pro 1.74 / 3.48 (sortie en heures de pointe à partir d'août 3.96). V4.1-Flash en heures de pointe 0.30 / 1.20, hors heures de pointe 0.15 / 0.60, cache 0.006.
Sparse Frontier : Taux d'éparse optimal de préfillage 0.80–0.93. Le décodage tolère 0.95. L'intersection se situe à 32–64K.
Taux d'éparse Glorot 2011 : MNIST 83.4 %, CIFAR10 72.0 %, NISTP 68.0 %, NORB 73.8 %.
Q-Sparse : Taux d'éparse optimal 45.58 % (précision complète) / 61.25 % (1.58 bits). Équivalent à un modèle dense autour de 40 %.
Différence d'Engram-27B par rapport à la ligne de base MoE : MMLU +3.4, CMMLU +4.0, BBH +5.0, ARC-C +3.7, HumanEval +3.0, MATH +2.4.
CS-MRI : Temps de balayage −20.2 %, temps d'examen −16 %, séquence unique −23 % à −43 %, nombre d'examens +27 %.
Puissance de calcul et bande passante du GPU : Consultez le tableau GPU à l'ère des réseaux de neurones.
C. Anecdotes et matériel narratif
Comment « 1 % de Lennie » est devenu « 1–4 % » : Peut être utilisé comme introduction pour corriger les malentendus.
Neurone visage de chat (2012) : Histoire de 1 000 machines qui ont appris indépendamment à reconnaître les « chats » à partir de vidéos YouTube en trois jours.
Outrageously (2017) : Histoire de la couche MoE 137B à l'époque LSTM qui annonçait le paysage de 2026. La coauteur de Hinton et Dean symbolise « l'ancienne idée de 1991 × ressources informatiques de Google ».
Le choc DeepSeek (27 janvier 2025) et le mot « théorique » attaché à 545 %.
Golden Gate Claude (2024) et le coup de frein du GDM (mars 2025).
CS-MRI : Histoire de la façon dont le temps qu'un patient passe allongé sur le chariot du scanner a diminué de 20 %, et comment l'hôpital peut maintenant effectuer 27 % plus d'examens.
437 pour 1 : Histoire de la façon dont la « mémoire » par jeton a rétréci d'environ 389 KB à 890 octets.
Le retour de N-gramme : Histoire de la façon dont le modèle de langage statistique, jadis enterré dans l'histoire ancienne, est revenu à la frontière en tant qu'Engram.
D. Malentendus courants et corrections
| Formulation courante | Description précise |
|---|---|
| Le cerveau n'utilise que 1 à 4 % de ses neurones | La description réelle de Lennie 2003 est « probablement moins de 1 % », une estimation de la limite supérieure basée sur l'énergie. 1–4 % est une citation indirecte via Glorot 2011 |
| Les réseaux ReLU sont 90 % éparses | Glorot 2011 : environ 50 % à l'initialisation, 50 %–85 % après apprentissage |
| GPT-4 est une MoE 1.8T avec 16 experts | Une rumeur de 2023 qu'OpenAI n'a jamais confirmée. Les configurations de GPT-5.x et Claude sont tout aussi non publiques |
| CS-MRI accélère les balayages de 30 à 60 % | Sartoretti 2019 : temps de balayage moyen −20.2 %, séquence unique −23 % à −43 % |
| Shazeer 2017 : « plus de 1 000 fois » | Le texte original est « greater than 1000x ». 137B est le nombre de paramètres de la couche MoE |
| Sparse Frontier a été présenté à l'ICML 2025 | Officiellement publié dans Findings of ACL 2026 |
| Le taux de bénéfice de DeepSeek est de 545 % | Taux d'avantage théorique auto-déclaré. En pratique, beaucoup plus bas, hors frais de recherche et développement et coûts d'apprentissage |
| MLA est une attention éparse | MLA est une compression de faible rang. Ce qui est réellement épars, c'est DSA / CSA2 |
| L'attention éparse peut compresser sans limite | Presque toutes les configurations perdent significativement des performances sur au moins une tâche |
E. Références
Fondamentaux classiques : Shannon 1948; Barlow 1961; Tinney & Walker 1967; Rissanen 1978; Field 1987; Mallat 1989; LeCun, Denker & Solla 1990; Jacobs, Jordan, Nowlan & Hinton 1991; Mallat & Zhang 1993; Donoho & Johnstone 1994 (Biometrika); Breiman 1995; Tibshirani 1996 (JRSS-B); Olshausen & Field 1996 (Nature); Chen, Donoho & Saunders 1998; DeVore 1998; Attwell & Laughlin 2001; Lennie 2003 (Curr. Biol.); Efron et al. 2004; Zou & Hastie 2005; Candès, Romberg & Tao 2006; Donoho 2006; Aharon, Elad & Bruckstein 2006; Lustig, Donoho & Pauly 2007; Lee, Battle, Raina & Ng 2007; Donoho & Tanner 2009; Glorot, Bordes & Bengio 2011; Candès, Li, Ma & Wright 2011; Le et al. 2012; Bengio et al. 2013; Gavish & Donoho 2014; Han, Mao & Dally 2016; Shazeer et al. 2017; Frankle & Carbin 2019; Sartoretti et al. 2019; Vranic et al. 2019; Hooker 2021 (CACM); Fedus, Zoph & Shazeer 2021; Clark et al. 2022.
2023–2026 : Frantar & Alistarh 2023 (SparseGPT); Sun et al. 2023 (Wanda); Xiao et al. 2023 (StreamingLLM); Bricken et al. 2023; Jiang et al. 2024 (Mixtral); Dai et al. 2024 (DeepSeekMoE); DeepSeek-AI 2024 (V2, V3); Templeton et al. 2024; Gao et al. 2024; Wang et al. 2024 (Q-Sparse); Krajewski et al. 2024; Yuan et al. 2025 (NSA); Nawrot et al. 2025/2026 (Sparse Frontier); Kantamneni et al. 2025; OpenAI 2025 (gpt-oss); Google DeepMind 2025 (Gemini 2.5技術レポート, arXiv:2507.06261); Moonshot 2025/2026 (Kimi K2, K3); Alibaba 2026 (Qwen3.5); Cheng et al. 2026 (Engram, arXiv:2601.07372); DeepSeek-AI 2026 (V4, arXiv:2606.19348); DeepSeek-AI 2026 (V4.1-Flash, arXiv:2609.19969); Ma et al. 2024 (MMLongBench-Doc).
Manuels et sondages : Elad, Sparse and Redundant Representations (2010); Hastie, Tibshirani & Wainwright, Statistical Learning with Sparsity (2015); Mallat, A Wavelet Tour of Signal Processing (3e éd.); Foucart & Rauhut, A Mathematical Introduction to Compressive Sensing (2013); Hoefler et al. 2021, Sparsity in Deep Learning; Cai et al. 2024, A Survey on Mixture of Experts.