Research
स्पार्स मॉडल: मूल, महत्व, और LLM के अग्रभाग और भविष्य
Product
Career
यह जापानी मूल पाठ से स्वचालित अनुवाद है
Overview
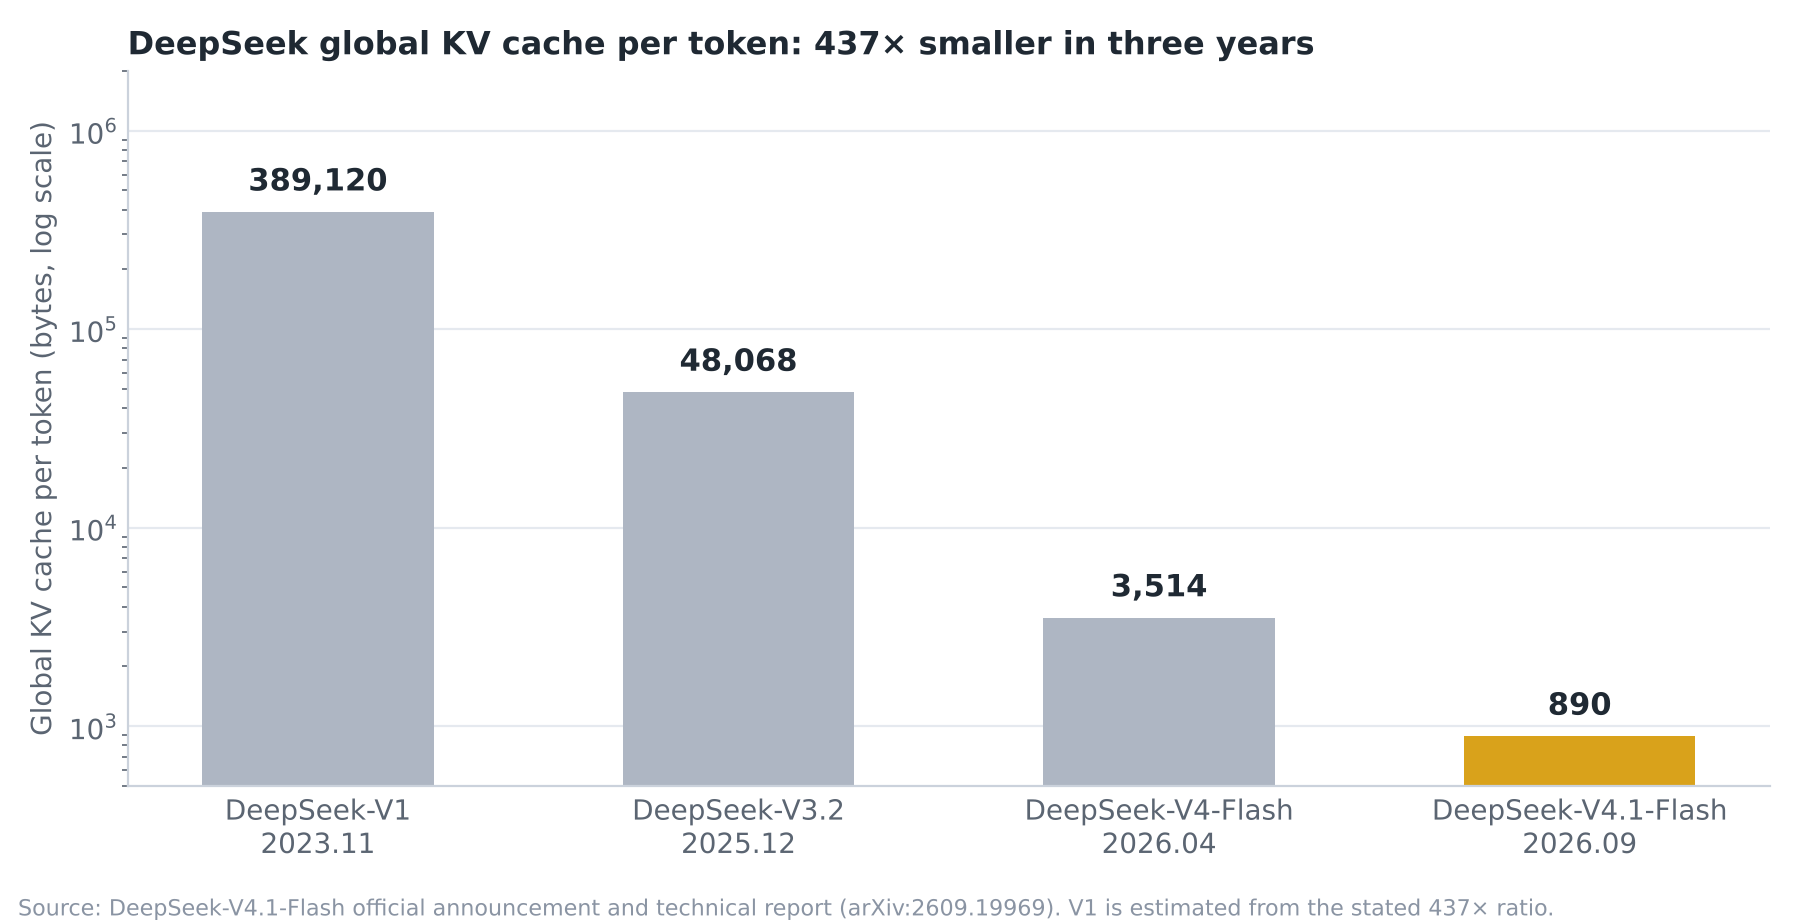
2026 तक, विरलता (sparsity) अब "उपयोगी या नहीं हो सकने वाली दक्षता तकनीक" नहीं रह गई है। यह अग्रणी स्तरीय बड़े मॉडल में एक डिफ़ॉल्ट आर्किटेक्चर बाधा है, और बड़े मॉडल के संचालन लागत और लंबे दस्तावेज़ों को संभालने वाले एजेंट की पठन सटीकता दोनों को निर्धारित करता है। सबसे सीधा प्रमाण DeepSeek-V4.1-Flash है, जो 10 सितंबर 2026 को जारी किया गया था। बैकबोन में 552B पैरामीटर हैं, लेकिन प्रति टोकन सक्रिय किए जाने वाले केवल प्रीफिल में 8B और डिकोड में 16B हैं, और GPU मेमोरी में निवास करने वाला वैश्विक KV कैश प्रति टोकन 890 बाइट है, जो DeepSeek-V1 का 1/437 तक संपीड़ित है (DeepSeek आधिकारिक घोषणा, तकनीकी रिपोर्ट arXiv:2609.19969)।
3 मुख्य बिंदु
विरलता का वंशावली सतत है। Barlow और Olshausen–Field के "मस्तिष्क की विरल कोडिंग" से, वेवलेट · LASSO · संपीड़न संवेदन जैसी "गणना योग्य विरलता" के माध्यम से, MoE · विरल ध्यान · सशर्त स्मृति जैसी "आर्किटेक्चर के रूप में विरलता" तक। इसके मूल में हमेशा समान पूर्व-वितरण (prior) है: "सच में महत्वपूर्ण घटक बहुत कम हैं।" तीनों सफल वंशावलियों में सामान्य बात यह है कि विरल पैटर्न हार्डवेयर के अनुकूल था। अनुरचित वजन प्रूनिंग विफल हुई क्योंकि सिद्धांत के कारण नहीं, बल्कि हार्डवेयर के कारण।
अभी क्यों। स्केलिंग अनुमान लागत और मेमोरी की दीवार से टकरा गई, और लंबे संदर्भ को संभालने वाले एजेंट KV कैश और प्रीफिल को प्रमुख लागत बना गए। इसके परिणामस्वरूप, विरलता की भूमिका "गणना बचत" से "मेमोरी · बैंडविड्थ · भंडारण बचत" तक विस्तृत हुई। 2024 में मुख्यधारा MoE प्रति टोकन लगभग 25% पैरामीटर सक्रिय कर रहा था (Mixtral), लेकिन 2026 में वह अनुपात 1.5% से 4.5% तक गिर गया है (DeepSeek-V4.1, Kimi K3, Qwen3.5)।
विरलता कोई रामबाण नहीं है। विरल ध्यान पर सबसे बड़े पैमाने पर किए गए मूल्यांकन (Nawrot et al., Findings of ACL 2026) से पता चला है कि लगभग सभी विरल विन्यास कम से कम एक कार्य में बड़े प्रदर्शन में गिरावट का कारण बनते हैं। व्याख्या क्षेत्र में भी, विरल ऑटोएनकोडर (SAE) को 2025 में व्यवस्थित नकारात्मक परिणामों का सामना करना पड़ा। मॉडल चयन औसत स्कोर के बजाय अपने व्यवसाय के लिए सबसे कठिन कार्य के स्कोर के आधार पर किया जाना चाहिए।
इस लेख को पार करने वाली 2 धुरियाँ
5 प्रकार की विरलता: सक्रियण की विरलता, वजन की विरलता, संरचित विरलता, सशर्त कंप्यूटिंग (MoE), और ध्यान की विरलता। "क्या विरलता उपयोगी है" बहस तब तक शुरू नहीं हो सकती जब तक हम यह निर्धारित न कर लें कि किस प्रकार की बात है।
3 ऑपरेटर: मृदु थ्रेसहोल्डिंग (L1 निकटस्थता ऑपरेटर), कठोर थ्रेसहोल्डिंग (L0), और top-k प्रक्षेपण (L0 गोले में प्रक्षेपण)। 1994 की वेवलेट शोर निवारण से लेकर 2026 की MoE रूटिंग तक, "शून्य बनाना" चरण केवल इन 3 ऑपरेटरों में से किसी एक को विभिन्न लक्ष्यों पर लागू कर रहा है। आधुनिक बड़े मॉडल का लगभग सभी तीसरे का उपयोग कर रहे हैं। क्योंकि प्रति टोकन गणना को सटीक रूप से ठीक किया जा सकता है और यह हार्डवेयर के समानांतर अनाज के साथ संरेखित होता है।
पूरे लेख में 5 शब्द बार-बार दिखाई देते हैं
| शब्दावली | एक शब्द में कहें तो |
|---|---|
| टोकन | मॉडल द्वारा संसाधित टेक्स्ट की सबसे छोटी इकाई। शब्द, या इसका हिस्सा। "प्रति टोकन कितने पैरामीटर सक्रिय हैं" का अर्थ है, टेक्स्ट को थोड़ा आउटपुट करने के लिए कितनी गणना का उपयोग किया जा रहा है। |
| पैरामीटर और सक्रिय पैरामीटर | पैरामीटर मॉडल द्वारा संरक्षित संख्याओं का कुल (कितना जानता है)। सक्रिय पैरामीटर 1 टोकन को संसाधित करते समय वास्तव में गणना में उपयोग किए जाने वाले हिस्से (चलाने में कितना खर्च होता है)। विरलीकरण इन दोनों को अलग करना है। |
| आधार और निर्देशांक | "इकट्ठा करने वाले ब्लॉक" का एक सेट। डेटा को इसके भारित योग के रूप में लिखा जा सकता है, भार निर्देशांक में है। ब्लॉक बदलें तो समन्वय प्रणाली भी बदल जाती है। डेटा समान है, लेकिन पठनीय मान बदल जाता है। |
| मानदंड | L2 लंबाई है, L1 घटकों के निरपेक्ष मानों का योग है, L0 गैर-शून्य घटकों की संख्या है। विरलता का अर्थ है L0 छोटा है। |
| FLOPs और मेमोरी बैंडविड्थ | कंप्यूटिंग थ्रूपुट प्रति सेकंड कुल गुणन संचालन की संख्या है, बैंडविड्थ प्रति सेकंड GPU मेमोरी से स्थानांतरित किए जा सकने वाली बाइट की संख्या है। आधुनिक बड़े मॉडल के डिकोड चरण में, अड़चन आमतौर पर बाद वाली है। |
शब्दावली पर नोट: इस लेख में हम "विरल" का उपयोग सख्ती से "अधिकांश तत्व शून्य हैं" के अर्थ में करते हैं। "कम रैंक" का अर्थ है "कोई भी तत्व शून्य नहीं है, लेकिन स्वतंत्रता कम है" (MLA या LoRA आदि)। दोनों को अक्सर भ्रमित किया जाता है, लेकिन इस लेख में हम लगातार अंतर करते हैं।
इस लेख को कैसे पढ़ें
यह लेख कालक्रम में आगे बढ़ता है, और प्रत्येक युग के लिए समान 4 प्रश्नों का उत्तर देता है। उस समय की पृष्ठभूमि और अड़चन क्या थी। विरलता किस तंत्र द्वारा प्रकट हुई। इसने क्या हल किया और क्या कीमत दी। यह आज के बड़े मॉडल से कैसे जुड़ता है। "पूर्व इतिहास" अध्याय में, हम पूछते हैं कि दुनिया विरल क्यों है। "शास्त्रीय युग" में गणित ने इसे कैसे एक उपकरण में बदल दिया, यह दिखाया गया है। "तंत्रिका नेटवर्क युग" में विरलता को तंत्रिका नेटवर्क में लाने पर प्रूनिंग विफल क्यों हुई, इसकी व्याख्या की गई है। "वर्तमान" का केंद्रीय अध्याय 2023-2026 में बड़े मॉडल क्यों विरलीकरण की ओर पूरी तरह मुड़ गए, इस पर चर्चा करता है और विभिन्न शोध संस्थानों के दृष्टिकोण की व्यवस्थित तुलना करता है। "विरलता और गहन शिक्षा जहाँ मिलते हैं" छवि और संकेत प्रसंस्करण में विरलता और गहन शिक्षा के संलयन को संभालता है, और "अनुप्रयोग" "लाभ और लागत" "भविष्य" और "हमारे लिए इसका अर्थ क्या है" प्रत्येक अध्याय में अनुप्रयोग, लागत, भविष्य, और यह सभी कुछ हमारे लिए क्या मायने रखता है, को संबोधित करता है। परिशिष्ट में कालक्रम, डेटा, उपाख्यान और संदर्भ संकलित हैं।
पूर्व इतिहास: दुनिया स्वयं विरल क्यों है
विरलता केवल डेटा का एक गुण नहीं है, बल्कि "डेटा और इसके वर्णन के तरीके" युग्म का एक गुण है। दुनिया उपयुक्त आधार के तहत विरल हो जाती है। और विज्ञान का इतिहास उस आधार की खोज का इतिहास भी है। इस अध्याय में, हम 3 प्रकार के अनुभवजन्य प्रमाण और 1 बौद्धिक स्रोत प्रदान करते हैं, और फिर सीमाएँ स्पष्ट करते हैं।
दर्शन और सूचना सिद्धांत: सीधे अंतर्ज्ञान और ढाँचा, तकनीकी उत्पत्ति नहीं
Occam की नस्तर सरलता को पसंद करने वाले दार्शनिक सिद्धांत है, विरल मॉडल की तकनीकी शुरुआत नहीं है। Shannon (1948) ने "अनावश्यकता" को परिमाणित किया। कोड लंबाई के उस हिस्से को जो सूचना स्रोत की एन्ट्रापी से अधिक हो, संपीड़ित की जा सकने वाली अनावश्यकता है, और विरल प्रतिनिधित्व मूलतः उस अनावश्यकता को सतह पर लाने वाले आधार को संदर्भित करता है। कोलमोगोरोव जटिलता (1960 का दशक) "सबसे छोटे विवरण" का आदर्श प्रस्तुत करता है, लेकिन यह गणना योग्य नहीं है। Rissanen का MDL (न्यूनतम विवरण लंबाई, 1978) इसे मॉडल चयन के लिए एक व्यावहारिक मानदंड में बदल देता है। विरल मॉडल को MDL के एक विशेष मामले के रूप में पढ़ा जा सकता है। विवरण लंबाई ≈ गैर-शून्य घटकों की संख्या × प्रति गुणांक कोडिंग लागत, इस तरीके से। ये विचार "विरल मॉडल के आविष्कारक" नहीं बल्कि "बौद्धिक पूर्व इतिहास" के रूप में लिखे जाने चाहिए।
प्रकृति से 3 प्रमाण
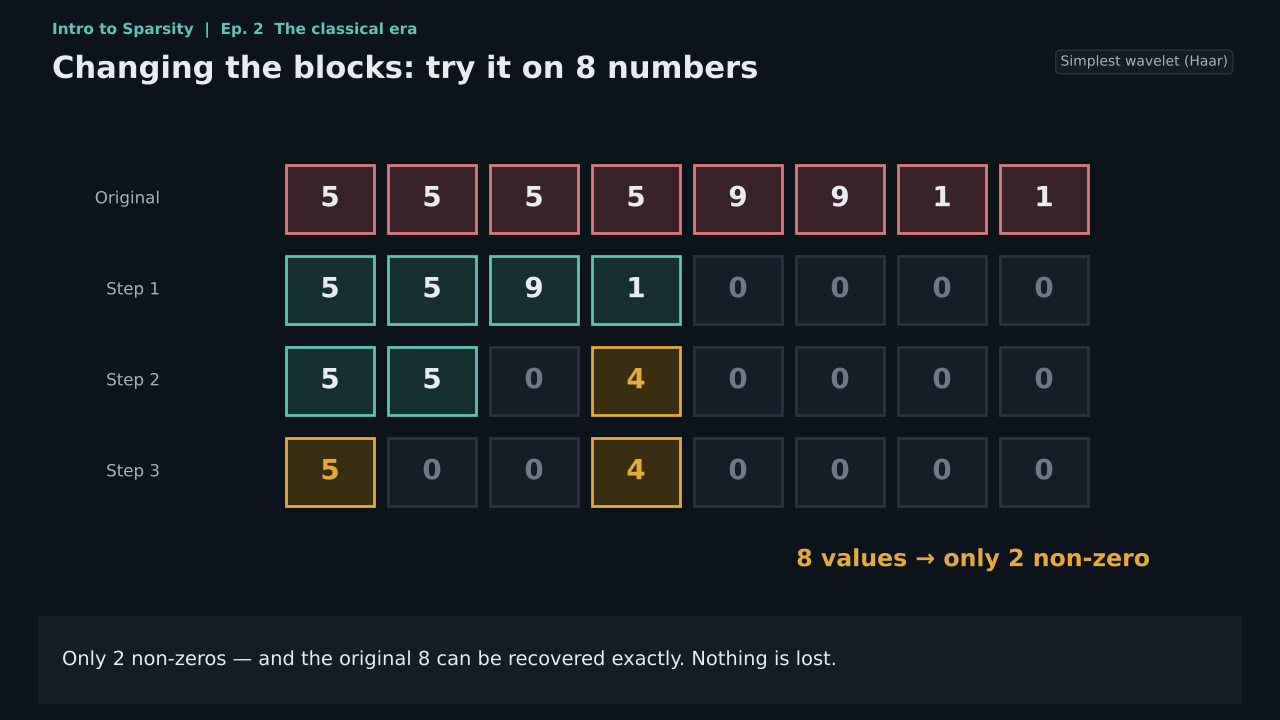
प्राकृतिक छवियां। प्राकृतिक छवियों का पावर स्पेक्ट्रम लगभग 1/f² शक्ति नियम का पालन करता है और अनुमानित स्केल अपरिवर्तनीयता प्रदर्शित करता है (Field 1987; Ruderman & Bialek 1994; समीक्षा के रूप में Simoncelli & Olshausen 2001)। वेवलेट जैसे स्थानीय, बैंडपास आधार में, प्राकृतिक छवि गुणांक भारी-पूंछ वाले हो जाते हैं। अधिकांश शून्य के करीब होते हैं, केवल किनारे के हिस्सों की कुछ बड़ी होती है। अरैखिक सन्निकटन सिद्धांत (DeVore 1998; Donoho 1993) साबित करता है कि खंड-वार चिकने संकेत के लिए, वेवलेट आधार में सर्वोत्तम n-पद सन्निकटन की त्रुटि किसी भी निश्चित रैखिक आधार की तुलना में तेजी से घटती है। यह JPEG2000 और संपीड़न संवेदन दोनों का सैद्धांतिक आधार है, और चित्र 3 का Haar उदाहरण इसका सबसे न्यूनतम प्रदर्शन है।
भाषा। शब्द की आवृत्ति Zipf के नियम का पालन करती है। एक मुट्ठी भर शब्द अधिकांश होती हैं, और पूंछ अत्यंत लंबी होती है। इसलिए bag-of-words या TF-IDF का प्रतिनिधित्व अत्यंत विरल हो जाता है। समान सांख्यिकी MoE के विशेषज्ञों का भार अनिवार्य रूप से पक्षपाती होना, और DeepSeek N-ग्राम लुकअप तालिका को सशर्त स्मृति (Engram) के रूप में क्यों उपयोग करता है, यह भी समझाता है।
मस्तिष्क। Barlow (1961) ने अनावश्यकता न्यूनीकरण परिकल्पना प्रस्तुत की। संवेदी प्रणाली का उद्देश्य अनावश्यकता को दूर करना और सांख्यिकीय रूप से स्वतंत्र प्रतिनिधित्व बनाना है, यह विरल कोडिंग का तंत्रिका विज्ञान स्रोत है। Attwell & Laughlin (2001) ने ग्रे मैटर की ऊर्जा बजट की गणना की, और इससे Lennie (2003, Current Biology 13:493–497) ने अनुमान लगाया कि, एक स्पाइक की लागत बहुत अधिक है, इसलिए "एक साथ पर्याप्त रूप से सक्रिय हो सकने वाले न्यूरॉन की संख्या शायद 1% से भी कम सख्ती से सीमित है।"
यहाँ एक बात है जो हमें निश्चित रूप से सुधारनी चाहिए। व्यापक रूप से प्रचलित दावा कि "मस्तिष्क केवल 1-4% न्यूरॉन का उपयोग करता है" पोते-दर-पोते का एक संदर्भ है। Glorot, Bordes, Bengio (2011) ने Lennie का उद्धरण करते समय "1-4%" लिखा, और तब से वह संख्या बार-बार स्थानांतरित की गई है। Lennie के मूल पाठ का कहना है "शायद 1% से भी कम", और वह भी ऊर्जा बाधा से प्राप्त एक अनुमानित ऊपरी सीमा है, माप मूल्य नहीं। विरलता का अर्थ है "एक विशेष क्षण में दृढ़ता से आग लगने वाले का अनुपात कम है", यह नहीं कि "मस्तिष्क का अधिकांश हिस्सा निष्क्रिय है।"
सीमाएँ और प्रतिउदाहरण
विरल कम रैंक नहीं है। विरल का अर्थ है किसी विशेष आधार या शब्दकोश के तहत गैर-शून्य गुणांक कम होना (L0/L1 द्वारा मापा जाता है)। कम रैंक का अर्थ है मैट्रिक्स के अकेले मान कम होना (रैंक या नाभिकीय मानदंड द्वारा मापा जाता है)। LoRA और MLA कम रैंक हैं, MoE · top-k ध्यान · SAE विरल हैं। काटे हुए SVD द्वारा दिया जाने वाला कम रैंक मैट्रिक्स है, और वहाँ विरल केवल अकेले मान की स्पेक्ट्रम है।
दुनिया हमेशा विरल नहीं होती। Robust PCA (Candès, Li, Ma & Wright 2011) डेटा को "निम्न-रैंक + विरल" में विघटित करता है, यह दिखाता है कि वास्तविक डेटा अक्सर दोनों को एक साथ रखता है। वीडियो में पृष्ठभूमि निम्न-रैंक है, अग्रभाग विरल है। बनावट या शोर से हावी सिग्नल सामान्य रूप से उपयोग किए जाने वाले आधार में विरल नहीं होते हैं। LLM के अवशिष्ट धारा में विशेषताओं का सुपरपोजिशन मतलब है कि व्यक्तिगत न्यूरॉन स्तर पर प्रतिनिधित्व घना है, और केवल अधिक-पूर्ण शब्दकोश के तहत विरल हो जाता है। यह इस अध्याय के "वर्तमान" खंड में SAE चर्चा का प्रस्थान बिंदु है ("व्याख्या में विरलता" अनुभाग)।
इस अध्याय का सारांश। विरलता एक खंडन योग्य पूर्व वितरण है, सार्वभौमिक सत्य नहीं। प्राकृतिक चित्र, भाषा और तंत्रिका गतिविधि में बार-बार पुष्टि की गई है, इसलिए इस पर "दांव लगाने" लायक है। लेकिन दांव लगाने से पहले, आपको अवश्य एक प्रश्न रखना चाहिए। किस आधार के तहत विरल है? यह प्रश्न है।
तीन साक्ष्य का विवरण: ये सांख्यिकीय कानून क्यों हैं?
प्राकृतिक चित्र की 1/f स्पेक्ट्रम कहाँ से आती है? दो पूरक व्याख्याएँ हैं। पहली स्केल अपरिवर्तनीयता है। प्राकृतिक दृश्यों में दिखाई देने वाली वस्तुओं का आकार कई अंकों तक फैलता है, और चाहे आप ज़ूम इन करें या ज़ूम आउट करें, छवि के आंकड़े नहीं बदलते। गणितीय रूप से, यह पावर स्पेक्ट्रम को पावर-लॉ में बदलने के लिए बाध्य करता है। दूसरी ओक्लूजन मॉडल है। दृश्य आगे-पीछे अतिव्यापी वस्तुओं से बना है, किनारे असंततता पैदा करते हैं, और असंततता आवृत्ति डोमेन में धीमी क्षय करने वाली उच्च-आवृत्ति पूंछ के रूप में दिखाई देती है। दोनों व्याख्याएं एक ही निष्कर्ष पर पहुंचती हैं। प्राकृतिक छवियां न तो "यादृच्छिक शोर" हैं और न ही "हर जगह चिकनी" हैं, बल्कि "व्यापक सपाट क्षेत्र + कुछ किनारे" हैं। यह वह संरचना है जिसमें वेवलेट आधार सबसे अच्छा है। Field (1987) आगे बढ़ता है और नोट करता है कि यदि दृश्य प्र皮質के सरल कोशिकाओं की ग्रहणशील क्षेत्र की बैंडविड्थ इस आँकड़े के अनुरूप है, तो प्रत्येक कोशिका की प्राकृतिक छवि के लिए प्रतिक्रिया भारी-पूंछ वाली होगी, अर्थात् अधिकांश समय यह लगभग प्रतिक्रिया नहीं करता है, लेकिन कभी-कभी मजबूती से फायर करता है। यह तंत्रिका विज्ञान में "विरल कोडिंग" शब्द का मूल अर्थ है।
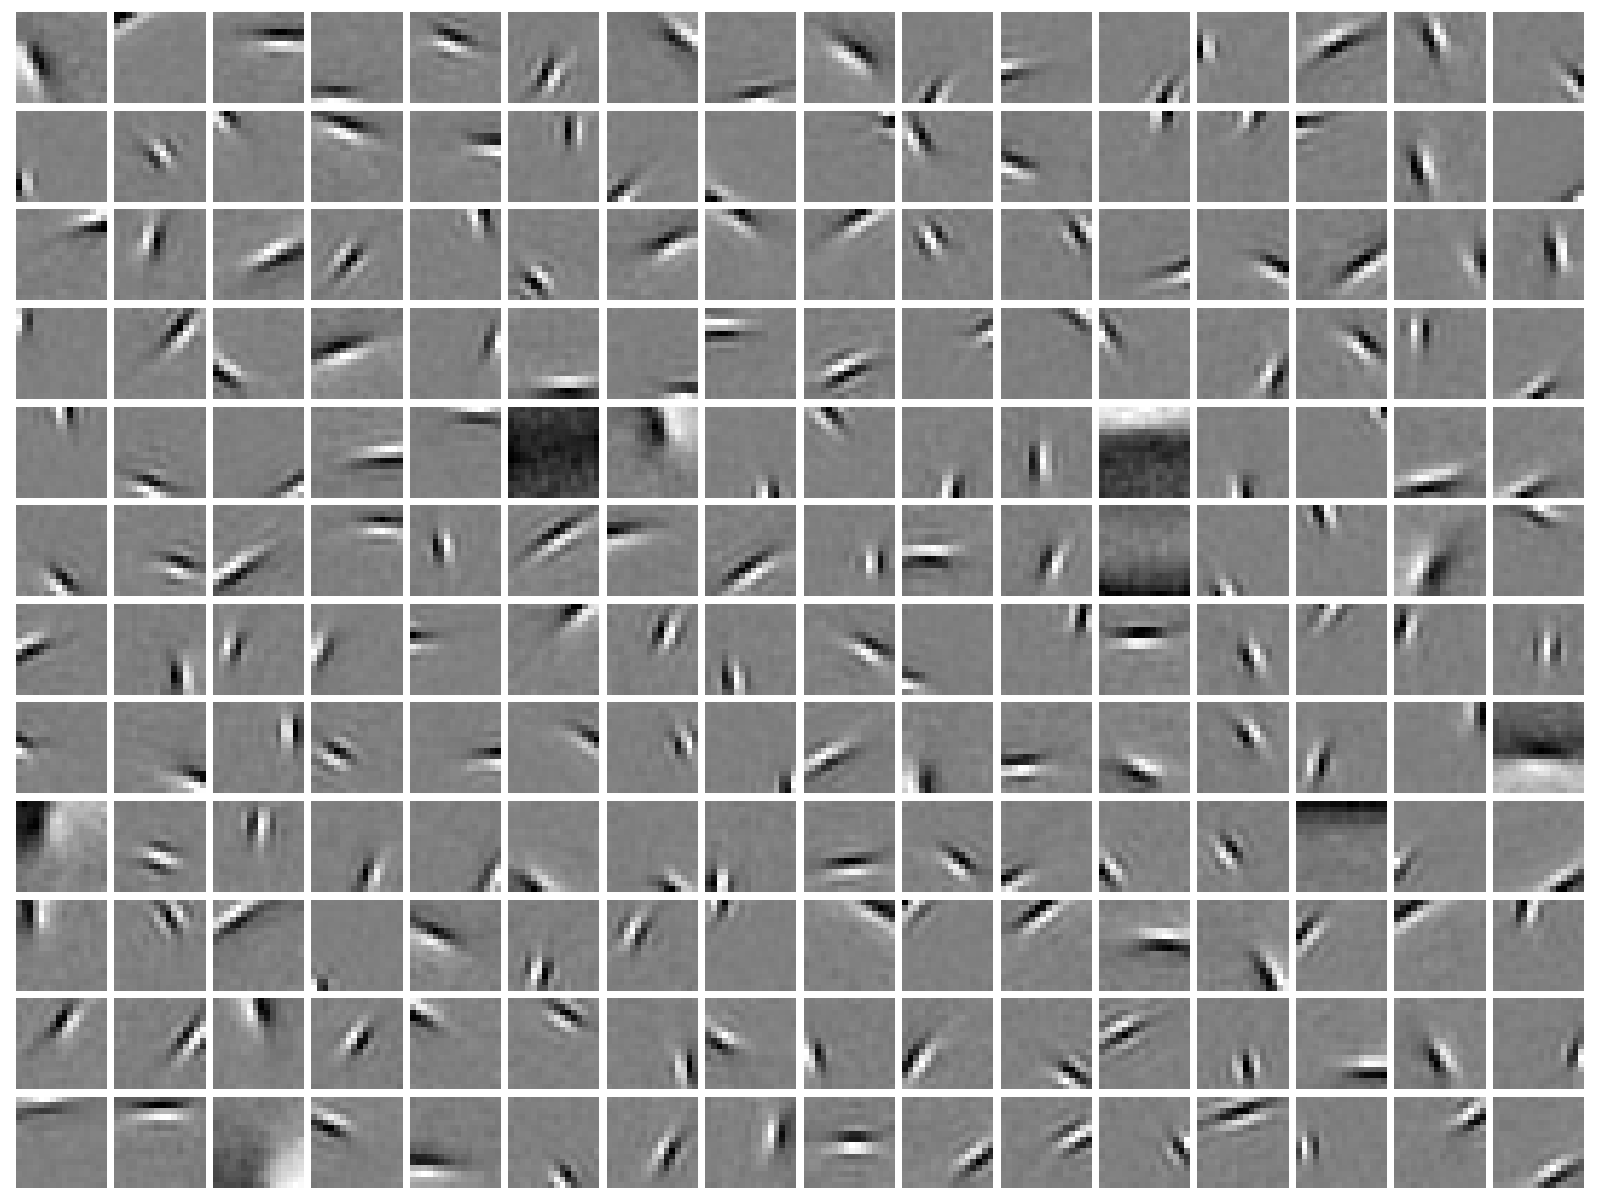
Olshausen और Field का प्रयोग इतना आकर्षक क्यों है? 1996 के प्रयोग ने एल्गोरिदम पर केवल दो प्रतिबंध लगाए थे। प्राकृतिक छवि पैच को रैखिक आधार फ़ंक्शन के सेट से पुनर्निर्माण करना, और गुणांक को यथासंभव विरल बनाना। मस्तिष्क के बारे में कोई पूर्व ज्ञान नहीं था। फिर भी सीखे गए आधार फ़ंक्शन स्थानीय, अभिविन्यास-चयनात्मक, और बैंडपास बन गए, और वे बिल्लियों और बंदरों के V1 सरल कोशिकाओं की ग्रहणशील क्षेत्र से बहुत मिलते-जुलते थे। इस परिणाम की शक्ति दिशा में निहित है। "एल्गोरिदम को मस्तिष्क से संकेत लेकर बनाया गया था" नहीं, बल्कि "विरलता के सिद्धांत ने स्वतंत्र रूप से मस्तिष्क की संरचना की भविष्यवाणी की थी"। बाद में Hromádka, DeWeese, Zador (2008) ने जागृत चूहों के श्रवण प्रांतस्था में अत्यधिक विरल फायरिंग पैटर्न रिकॉर्ड किए, और Quian Quiroga et al. (2005) ने मानव हिप्पोकैम्पस में "अवधारणा कोशिकाओं" की खोज की जो विशिष्ट व्यक्तियों या स्थलों के लिए चयनात्मक रूप से प्रतिक्रिया करती हैं। ये सभी विरल कोडिंग परिकल्पना के साक्ष्य माने जाते हैं। असहमति भी है। Spanne and Jörntell (2015) जैसे तर्क देते हैं कि सख्त विरल कोडिंग पूरे प्रांतस्था में सार्वभौमिक नहीं है, और विरलता की डिग्री मस्तिष्क क्षेत्र और कार्य पर निर्भर करती है। इसलिए इसे "व्यापक रूप से समर्थित परिकल्पना" के रूप में लिखा जाना चाहिए, न कि एक स्थापित सिद्धांत के रूप में।
ऊर्जा विरलता को क्यों बाध्य करती है? मानव मस्तिष्क शरीर के वजन का लगभग 2% है, फिर भी आराम के समय की चयापचय का लगभग 20%, लगभग 20 वाट का उपयोग करता है। Attwell and Laughlin (2001) ने अनुमान लगाया कि ग्रे पदार्थ में अधिकांश ऊर्जा सिनेप्टिक संचरण और कार्य क्षमता में जाती है। Lennie (2003) वहाँ से पीछे की ओर काम करता है। यदि एक स्पाइक की यह लागत है, तो प्रांतस्था में न्यूरॉन्स का एक बड़ा हिस्सा एक साथ उच्च-आवृत्ति पर फायर करने की जगह नहीं है। यह तर्क "बजट बाधा के तहत एक ऊपरी सीमा" है, इसलिए परिणाम एक माप नहीं बल्कि "संभवतः 1% से कम" का अनुमान है। महत्व ठोस संख्या में नहीं बल्कि तर्क में निहित है। सीमित ऊर्जा या बैंडविड्थ वाली प्रणालियों में, विरलता एक विकल्प नहीं बल्कि एक आवश्यकता है। यही तर्क "न्यूरल नेटवर्क युग" के अध्याय में GPU पर "मेमोरी की दीवार" के रूप में फिर से खेला जाता है।
भाषा में Zipf का नियम और लंबी पूंछ। Zipf (1935) ने देखा कि शब्द की आवृत्ति इसकी रैंक के लगभग व्युत्क्रमानुपाती होती है। दूसरा सबसे आम शब्द लगभग आधी आवृत्ति में पहले के रूप में दिखाई देता है, दसवां लगभग 1/10 की आवृत्ति में। बाद में Mandelbrot ने एक सुधार दिया। प्रत्यक्ष परिणाम यह है कि कोई भी पाठ शब्दावली का केवल एक छोटा अंश उपयोग करता है, और अधिकांश शब्द केवल 1 या 2 बार दिखाई देते हैं। सांख्यिकीय भाषा मॉडल के युग में, यह एक अत्यंत विरल n-ग्राम आवृत्ति मैट्रिक्स और "शून्य संभावना" स्मूथिंग समस्या (Good–Turing, Kneser–Ney) के रूप में दिखाई दिया। बड़े मॉडल के युग में यह दो रूपों में वापस आया है। एक यह है कि MoE की रूटिंग लोड संरचनात्मक रूप से तिरछा है। लोकप्रिय विशेषज्ञ अधिकांश टोकन को संभालते हैं, इसलिए लोड संतुलन तंत्र हस्तक्षेप करना चाहिए। दूसरा DeepSeek का Engram है। N-ग्राम लुकअप टेबल को फ्रंटियर आर्किटेक्चर में पुनर्जीवित करना, आवृत्त पैटर्न को सस्ते लुकअप पथ पर भेजना, और केवल वास्तविक अनुमान की आवश्यकता वाली चीजों को महंगे Transformer परत में रखना।
भौतिकी और इंजीनियरिंग में विरलता
विरलता का इतिहास मशीन लर्निंग से इंजीनियरिंग में लंबा है। वैज्ञानिक कंप्यूटिंग में, परिमित तत्व विधि और विद्युत प्रवाह समीकरणों के गुणांक मैट्रिक्स स्वाभाविक रूप से विरल हैं। प्रत्येक नोड केवल आसन्न नोड्स से जुड़ा होता है। Tinney and Walker (1967) ने विद्युत प्रणाली को हल करते समय Gaussian消除 के दौरान "फिल-इन" को कम करने के लिए एक इष्टतम क्रम प्रस्तावित किया। यह विरल प्रत्यक्ष विधि का शुरुआत था। इसके बाद Rose (1972) ने消除 प्रक्रिया को ग्राफ सिद्धांत के संदर्भ में वर्णित किया, Gilbert और अन्य ने विरल LU अपघटन विकसित किया, और विरल रैखिक बीजगणित एक क्षेत्र बन गया। भूकंप अन्वेषण में, भूमिगत परावर्तनशीलता श्रृंखला को विरल स्पाइक अनुक्रम के रूप में मॉडल किया जाता है, और deconvolution समस्या L1 नियमितकरण से हल होती है। यह संपीड़न संवेदन के 20 साल आगे है। राडार और सरणी सिग्नल प्रोसेसिंग में, लक्ष्य कोण, दूरी और गति के स्थान में विरल रूप से वितरित होते हैं, और अल्ट्रा-रेजोलिউशन अनुमान विरल पुनर्स्थापन का उपयोग करते हैं।
इन क्षेत्रों के बीच आम बात यह है कि विरलता पैटर्न भौतिक संरचना (निकटता, प्रतिबिंब, लक्ष्यों की संख्या) से आते हैं, इसलिए पूर्वानुमानित और उपयोगी होते हैं। यह "शास्त्रीय युग" के वेवलेट (संरचना का स्रोत खंडहर-चिकनाई है) और "वर्तमान" की MoE (संरचना का स्रोत विशेषज्ञ ब्लॉक है) के साथ निरंतर है, और यह भी समझाता है कि "न्यूरल नेटवर्क युग" में गैर-संरचित वजन विरलता क्यों हारती है। उन शून्य में कोई भौतिक संरचना नहीं है, और हार्डवेयर इसका उपयोग नहीं कर सकता।
सामाजिक घटनाओं में दर्पण, और इस विचारधारा की सीमाएँ
Pareto का 80/20 नियम, Anderson की लंबी पूंछ, और "कुछ महत्वपूर्ण चर अधिकांश विचरण की व्याख्या करते हैं" कारक विश्लेषण की परंपरा सभी समाज विज्ञान में प्रतिबिंबित विरलता पूर्व वितरण के दर्पण हैं। ये दिखाते हैं कि विरलता विश्व की संरचना के बारे में एक धारणा है, न कि एक प्रमेय। Gelman और अन्य सांख्यिकीविद् "विरलता पर दांव लगाओ" पर सवाल उठाते हैं। वे तर्क देते हैं कि सामाजिक विज्ञान की कई समस्याओं में वास्तविक प्रभाव घना और छोटा होता है, और विरल तरीके इसे व्यवस्थित रूप से याद करते हैं। यही आलोचना मशीन लर्निंग पर भी लागू होती है। LLM के अवशिष्ट धारा में विशेषताएं superposition द्वारा घना रूप से संग्रहीत होती हैं, और विरलता केवल अधिक-पूर्ण शब्दकोश में स्विच करने पर दिखाई देती है। इसलिए इस लेख की स्थिति इस प्रकार है। विरलता विशाल प्राकृतिक डेटा में बार-बार पुष्टि की गई है, इसलिए यह शुरुआत में दांव लगाने के लायक एक पूर्व वितरण है। लेकिन हर बार दांव लगाते समय, "किस आधार के तहत विरल?" का उत्तर दें, और यदि साक्ष्य समर्थन नहीं करते तो इसे छोड़ने के लिए तैयार रहें।
शास्त्रीय युग (1960s–2014): विरलता कैसे एक गणनीय उपकरण बन गई
शास्त्रीय युग में सफल विरल तरीकों में एक आम बात है। विरलता पैटर्न संरचित और पूर्वानुमानित था, इसलिए ही हार्डवेयर और उद्योग मानकों में शामिल किया जा सका। यह "न्यूरल नेटवर्क युग" में वर्णित "पराजय" का भी पूर्वाभास है। नीचे दी गई तालिका प्रत्येक विधि क्यों उस अवधि में दिखाई दी, उस समय की बाधा क्या थी, और इसने क्या हल किया - इन तीन प्रश्नों के साथ मील के पत्थर को व्यवस्थित करती है।
| मील का पत्थर | यह क्यों उस समय में प्रकट हुआ | तब की बाधा | इसने क्या हल किया |
|---|---|---|---|
| विरल मैट्रिक्स प्रत्यक्ष विधि (Tinney & Walker 1967) | विद्युत नेटवर्क बड़े हो गए, मेमोरी KB इकाइयों के समय में | घनी消除विधि O(n³) में काम करती है और मेमोरी में नहीं आती | केवल गैर-शून्य तत्वों को संग्रहीत करें, इष्टतम क्रम से फिल-इन को कम करें |
| वेवलेट (Daubechies 1988; Mallat 1989) | Fourier आधार किनारों के लिए विरल नहीं है | किनारों की ऊर्जा आवृत्ति डोमेन में फैल गई | खंडहर-चिकना सिग्नल वेवलेट डोमेन में विरल हो जाता है |
| Matching Pursuit (Mallat & Zhang 1993) | अधिक-पूर्ण शब्दकोश का आगमन | प्रतिनिधित्व अद्वितीय नहीं है | लालची विधि द्वारा परमाणु चयन |
| वेवलेट थ्रेसहोल्ड शोर निवारण (Donoho & Johnstone 1994) | गुणांक विरल हैं, शोर एकरूप है | रैखिक फिल्टर किनारों तक धुंधलापन लाता है | नरम थ्रेसहोल्ड = L1 निकटता ऑपरेटर। लगभग minimax इष्टतम |
| Breiman का garrote 1995 → LASSO (Tibshirani 1996) | p ≫ n उच्च-आयामी डेटा | कम से कम वर्ग बीमार-अभिप्राय, सबसेट चयन अस्थिर | सिकुड़न अनुमान और चर चयन एक साथ प्राप्त करें |
| Basis Pursuit (Chen, Donoho & Saunders 1998) | उत्तल अनुकूलन परिपक्व हुआ | L0 NP-कठिन है | L1 द्वारा उत्तल छूट |
| अरैखिक सन्निकटन (DeVore 1998) | "सबसे बड़े k को रखने" की इष्टतमता की व्याख्या की जरूरत थी | रैखिक सन्निकटन धीरे-धीरे अभिसरण करता है | सर्वोत्तम n-शब्द सन्निकटन सिद्धांत |
| JPEG (1992) / JPEG2000 (2000) | डिजिटल छवि का प्रसार | बैंडविड्थ और भंडारण | विरल रूपांतर + quantization + entropy कोडिंग |
| LARS (Efron et al. 2004); Elastic Net (Zou & Hastie 2005) | LASSO के लिए कुशल पथ एल्गोरिदम की जरूरत थी | हल करना धीमा है, संबंधित चर में अस्थिर | पूरा नियमितकरण पथ एक साथ कंप्यूट करें। L1+L2 |
| संपीड़न संवेदन (Candès–Romberg–Tao 2006; Donoho 2006) | विरल सिद्धांत यादृच्छिक मैट्रिक्स सिद्धांत से मिला | नमूनाकरण Nyquist आवृत्ति से बंधा था | RIP स्थिति के तहत, m ≳ k·log(n/k) मापन से पुनर्स्थापन |
| K-SVD (Aharon, Elad & Bruckstein 2006) | सीखने योग्य शब्दकोश की जरूरत थी | निश्चित वेवलेट विशिष्ट डेटा के लिए उपयुक्त नहीं है | विरल कोडिंग और शब्दकोश अद्यतन का वैकल्पिक अनुकूलन |
| Donoho–Tanner चरण संक्रमण (2009) | L1 की सफलता के लिए आवश्यक शर्तों की विशेषता बताई जानी चाहिए थी | सैद्धांतिक सीमा बहुत ढीली थी | (m/n, k/m) समतल में तीव्र चरण संक्रमण |
| स्पार्स कोडिंग (Olshausen & Field 1996), तेज़ एल्गोरिदम (Lee, Battle, Raina & Ng 2007) | Barlow परिकल्पना के लिए प्रतिक्रिया | V1 ग्राहक क्षेत्र Gabor जैसे क्यों हैं | स्पार्स शब्दकोश V1 ग्राहक क्षेत्र को पुनः प्रस्तुत करते हैं |
| बिल्ली का चेहरा न्यूरॉन (Le et al. 2012) | वितरित शिक्षा का आगमन | क्या उच्च-स्तरीय विशेषताएं बिना पर्यवेक्षण के उभरती हैं | बाद में चर्चा की गई |
| इष्टतम विलक्षण मान कठोर थ्रेसहोल्ड (Gavish & Donoho 2014) | निम्न-रैंक शोर निवारण के लिए सिद्धांत आधारित थ्रेसहोल्ड आवश्यक था | ट्रंकेटेड रैंक अनुभवजन्य नियम द्वारा चुना गया था | वर्गीय मैट्रिक्स के लिए σ ज्ञात है तो (4/√3)√n·σ, अज्ञात है तो माध्यिका का 2.858 गुना |
आंकड़ों में "स्पार्सिटी पर दांव लगाएं" का सिद्धांत
Hastie, Tibshirani, Friedman ने The Elements of Statistical Learning में "bet on sparsity (स्पार्सिटी पर दांव लगाएं)" का सिद्धांत प्रस्तावित किया। यदि सच्चा मॉडल स्पार्स है, तो L1 इसे ढूंढ सकता है। यदि स्पार्स नहीं है, तो कोई भी विधि काम नहीं करेगी। इसलिए स्पार्सिटी पर दांव लगाएं। उच्च-आयामी सांख्यिकी ने इसकी सटीक कीमत को परिमाण करा दिया है। p-आयामी k-स्पार्स वेक्टर को पुनः प्राप्त करने के लिए n ≳ k·log p नमूने पर्याप्त हैं (Wainwright 2009)। संपीड़न संवेदन में संबंधित परिणाम m ≳ C·k·log(n/k) यादृच्छिक माप हैं, यदि RIP स्थिरांक δ₂ₖ < √2−1 ≈ 0.414 को संतुष्ट करता है तो L1 सटीक पुनः प्राप्ति की गारंटी देता है (Candès 2008)।
वास्तविक दुनिया के तीन उदाहरण (संख्याएं सत्यापित हैं)
CS-MRI। Lustig, Donoho, Pauly (2007) ने संपीड़न संवेदन MRI की नींव रखी। नैदानिक संख्याओं को सटीक रूप से उद्धृत किया जाना चाहिए। Sartoretti et al. (2019, PLoS ONE 14(4): e0214887) ने बताया कि नैदानिक अभ्यास में औसत स्कैन समय 20.2% कम हुआ, परीक्षा समय 16% कम हुआ, लागू अनुक्रमों का स्कैन समय 23%–43% कम हुआ, और उसी अवधि में परीक्षाओं की संख्या 27% बढ़ी (प्राथमिक स्रोत)। Vranic et al. (2019, AJNR 40(1):92–98) ने मस्तिष्क के FLAIR और GRE अनुक्रमों में क्रमशः 25% और 35% में कमी की सूचना दी। अक्सर उद्धृत "30%–60% त्वरण" के पास प्राथमिक स्रोत समर्थन नहीं है।
ब्लैक होल इमेजिंग (EHT)। 2019 में M87* की पहली छवि का समर्थन करने वाली तीन इमेजिंग पाइपलाइनों में से एक SMILI, Honma et al. (2014) और Akiyama et al. (2017) की स्पार्स मॉडलिंग (L1+TV नियमितकरण) परंपरा में है। एक अन्य पाइपलाइन CHIRP (Bouman et al. 2016) शुद्ध संपीड़न संवेदन नहीं है बल्कि पैच पूर्ववर्ती का उपयोग करती है, और "एक शोधकर्ता ने संपीड़न संवेदन के साथ एक ब्लैक होल की तस्वीर लीं" रिपोर्टिंग सरलीकृत है।
बिल्ली का चेहरा न्यूरॉन। Le et al. (2012, ICML, arXiv:1112.6209) ने लगभग 1 बिलियन कनेक्शन वाले 9-परत स्थानीय रूप से जुड़े स्पार्स ऑटोएनकोडर को YouTube के 10 मिलियन फ्रेम पर "1,000 मशीन (16,000 कोर) के साथ 3 दिन" के लिए प्रशिक्षित किया। बिना पर्यवेक्षण के, मानव चेहरों और बिल्ली के चेहरों के लिए चुनिंदा रूप से प्रतिक्रिया करने वाले एकल न्यूरॉन उभरे, और डाउनस्ट्रीम ImageNet में 15.8% सटीकता तक पहुंचे, पूर्ववर्ती सर्वश्रेष्ठ से 70% सापेक्ष सुधार। यह "स्पार्स कोडिंग → बिना पर्यवेक्षण विशेषताएं" परंपरा 2012 के बाद पर्यवेक्षित CNN द्वारा दबा दी गई, लेकिन 2023 में Anthropic के SAE के रूप में वापस आई।
समानांतर परंपरा: निम्न-रैंक
ट्रंकेटेड SVD (Eckart–Young–Mirsky प्रमेय) रैंक k या कम के सभी मैट्रिक्स के बीच सर्वश्रेष्ठ सन्निकटन है, और Gavish & Donoho (2014, IEEE T-IT 60(8):5040–5053) ने शोर निवारण के लिए इष्टतम कठोर थ्रेसहोल्ड दिया। यह तरंगिका थ्रेसहोल्ड शोर निवारण के साथ संरचनात्मक रूप से समरूप है। दोनों "आधार बदलना → थ्रेसहोल्ड → उलटा रूपांतर" का पालन करते हैं, अंतर यह है कि तरंगिका आधार स्थिर है जबकि SVD आधार डेटा से गणना की जाती है। पूर्व में सिग्नल थ्रेसहोल्ड के बाद स्पार्स रहता है, लेकिन बाद में ट्रंकेटेड मैट्रिक्स निम्न-रैंक लेकिन घनी है। यह परंपरा "वर्तमान" अध्याय में MLA और LoRA के रूप में बड़े मॉडलों में वापस आती है।
एक-एक करके: प्रत्येक प्रगति उस समय में क्यों हुई
फूरिए से तरंगिका तक (1980 के दशक)। फूरिए आधार सिग्नलों को वैश्विक साइन तरंगों में विघटित करता है। स्थिर सिग्नल के लिए कुशल है, लेकिन किनारों और क्षणिक घटनाओं के लिए अत्यंत अपशिष्ट है। एकल कदम का प्रतिनिधित्व करने के लिए अनंत आवृत्ति घटकों की आवश्यकता होती है, और ऊर्जा संपूर्ण आवृत्ति डोमेन में बिखर जाती है। इंजीनियरिंग में पहले से ही Gabor रूपांतर और शॉर्ट-टाइम फूरिए रूपांतर जैसे समाधान थे, लेकिन एकीकृत गणितीय ढांचा नहीं था। Mallat (1989) ने बहु-संकल्प विश्लेषण को औपचारिक रूप दिया, और Daubechies (1988) ने कॉम्पैक्ट समर्थन के साथ ऑर्थोगोनल तरंगिकाओं का निर्माण किया, जिससे स्थानीयता, बहु-स्तरीय संरचना और ऑर्थोगोनालिटी को एक साथ संतुष्ट किया जा सके। प्रत्येक तरंगिका आधार फ़ंक्शन केवल परिमित श्रेणी में गैर-शून्य होता है और सभी पैमानों पर दोहराया जाता है। इसलिए खंडशः चिकने सिग्नल किनारों की स्थिति और कुछ पैमानों पर केवल बड़े गुणांक बनाते हैं, और बाकी सब लगभग शून्य होते हैं। DeVore (1998) और Donoho (1993) ने साबित किया कि यह अनुभवजन्य संयोग नहीं है। खंडशः चिकने कार्यों की कक्षा में, कोई भी निश्चित रैखिक आधार तरंगिका आधार में सर्वश्रेष्ठ n-अवधि अरैखिक सन्निकटन की त्रुटि क्षय दर के साथ प्रतिद्वंद्विता नहीं कर सकता। JPEG2000 (2000) ने इस सिद्धांत को मानक में बदल दिया, JPEG के DCT को तरंगिका से बदल दिया, और समान बिट दर पर ब्लॉक शोर को बहुत कम कर दिया।
न्यूनतम वर्ग से LASSO तक (1990 के दशक)। सांख्यिकी को एक अलग प्रकार की स्पार्सिटी का सामना करना पड़ा। क्या गुणांक किसी आधार के अंतर्गत स्पार्स हैं, यह नहीं, बल्कि "कौन से व्याख्यात्मक चर वास्तव में महत्वपूर्ण हैं"। शास्त्रीय दृष्टिकोण उपसमुच्चय चयन (स्टेपवाइज़ रिग्रेशन, AIC/BIC) था, लेकिन यह संयोजी खोज था, और डेटा के मामूली परिवर्तन के लिए अत्यंत अस्थिर है। Breiman (1995) ने गैर-नकारात्मक garotte का प्रस्ताव दिया, चर चयन को निरंतर संकुचन समस्या के रूप में पुनः तैयार किया। इससे प्रेरित Tibshirani (1996) LASSO, यानी L1 दंड के साथ न्यूनतम वर्ग प्रस्तावित करते हैं। L1 का व्यवहार इसकी ज्यामिति द्वारा निर्धारित होता है। बाधा क्षेत्र कोणों वाला एक हीरा है, और इष्टतम समाधान कोनों पर बैठने की संभावना है, प्रत्येक कोण कुछ गुणांक के सटीक शून्य होने के बिंदु से मेल खाता है। यह "संकुचन और चयन एक साथ होते हैं" की प्रणाली है। LASSO की एल्गोरिदमिक बाधा 2004 की LARS (Efron, Hastie, Johnstone, Tibshirani) द्वारा दूर की गई, पूरे नियमितकरण पथ को एक बार में गणना करने में सक्षम। 2005 में Zou और Hastie की Elastic Net L1+L2 के साथ दृढ़ता से सहसंबद्ध चर समूहों को संभालने के लिए आई। उच्च-आयामी सांख्यिकी सैद्धांतिक गारंटी देती है। Wainwright (2009) ने साबित किया कि p-आयामों में k गैर-शून्य गुणांक पुनः प्राप्त करने के लिए n ≳ k·log p नमूने पर्याप्त हैं, और Bickel, Ritov, Tsybakov (2009) ने LASSO और Dantzig चयनकर्ता के लिए oracle असमानताएं स्थापित कीं।
संकेत प्रक्रिया में स्वतंत्र खोज (1993–1998)। लगभग उसी समय, संकेत प्रसंस्करण "अत्यधिक पूर्ण शब्दकोश" से शुरू करके उसी L1 तक पहुंचा। Matching Pursuit (Mallat and Zhang 1993) अवशेष के साथ सबसे सहसंबद्ध परमाणु को लालची रूप से चुनता है, Basis Pursuit (Chen, Donoho, and Saunders 1998) "सबसे स्पार्स प्रतिनिधित्व खोजना" NP-कठिन L0 समस्या को L1 रैखिक प्रोग्रामिंग में शिथिल करता है। LASSO और Basis Pursuit गणितीय रूप से एक ही समस्या की 2 पैरामीटरीकरण हैं, लेकिन लगभग संचार रहित 2 समुदायों से उभरे। स्पार्सिटी विचार "एकाधिक स्रोतों से अभिसरण" का पहला उदाहरण है।
शोर निवारण: जहां स्पार्सिटी ने पहली बार सीधे मूल्य दिया (1994)। Donoho और Johnstone की तरंगिका थ्रेसहोल्ड शोर निवारण ने उपरोक्त सिद्धांत को 3-चरणीय प्रक्रिया में बदल दिया। ऑर्थोगोनल रूपांतर से तरंगिका डोमेन में जाना। थ्रेसहोल्ड λ=σ√(2 log n) के साथ सॉफ्ट थ्रेसहोल्डिंग S_λ(w)=sign(w)·max(|w|−λ,0) को गुणांक पर लागू करना। उलटे रूपांतर से संकेत डोमेन में वापस जाना। यह काम करने की कुंजी यह है कि ऑर्थोगोनल रूपांतर श्वेत शोर के सांख्यिकीय गुणों को संरक्षित करता है। तरंगिका डोमेन में, शोर सभी गुणांकों में समान रूप से समान विचरण के स्वतंत्र गॉसियन शोर के रूप में रहता है, जबकि संकेत ऊर्जा कुछ बड़े गुणांकों में केंद्रित होती है, इसलिए छोटे गुणांकों को छोड़ना पर्याप्त है। सॉफ्ट थ्रेसहोल्डिंग ऑपरेटर ठीक L1 दंड का निकट ऑपरेटर है, और यही कारण है कि शोर निवारण, LASSO, बाद में ISTA/FISTA (Beck and Teboulle 2009), और LISTA (Gregor and LeCun 2010, एल्गोरिदम विस्तार का प्रारंभिक बिंदु), सभी एक ही मूल संगणना साझा करते हैं।
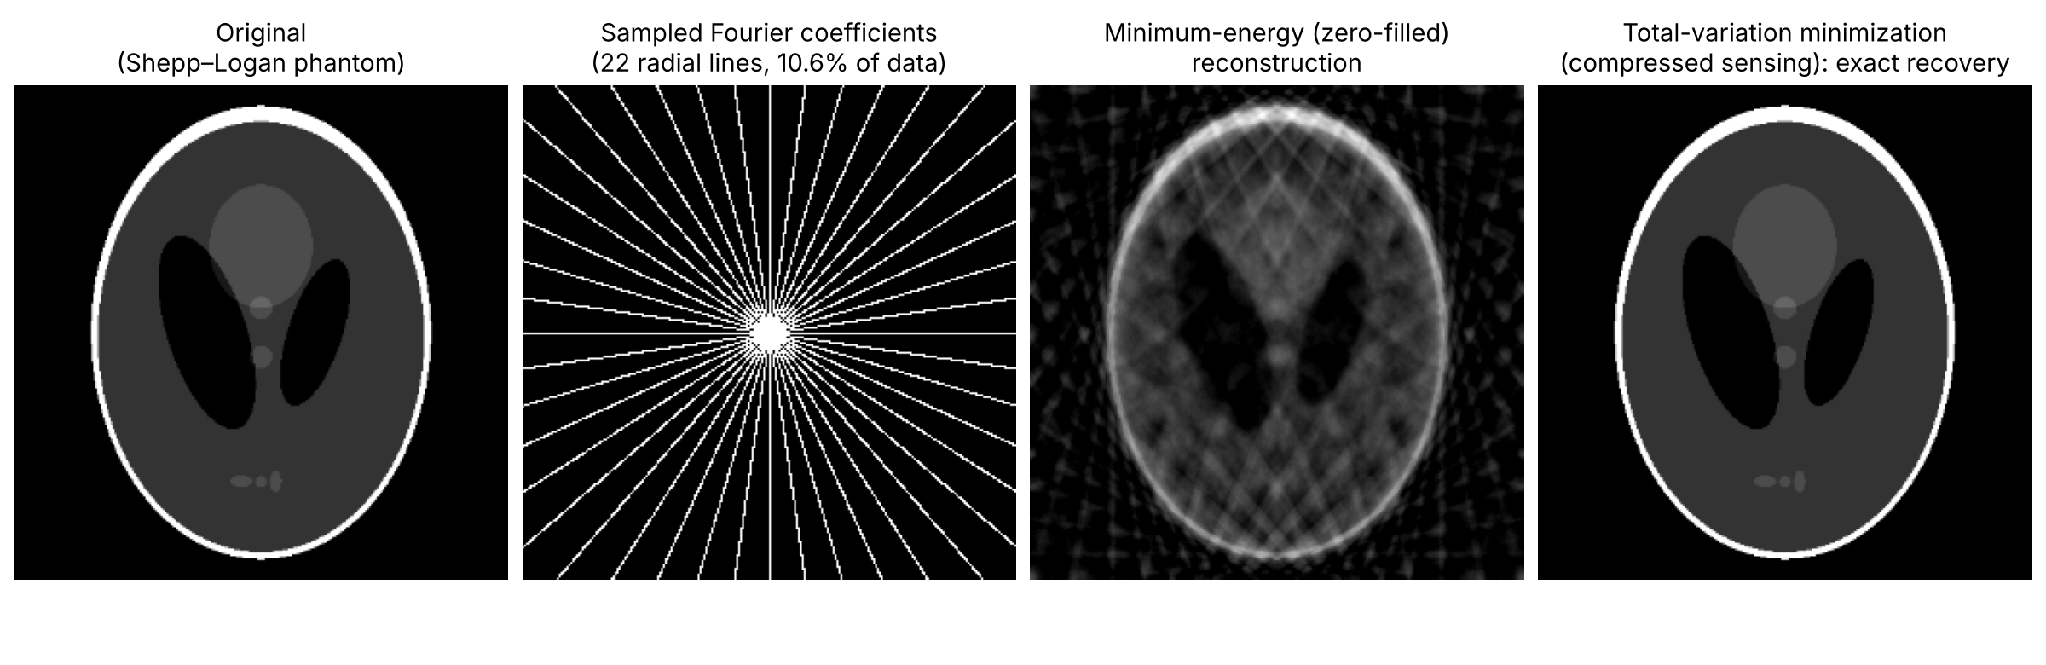
संपीड़न संवेदन: स्पार्सिटी को "कम मापकर अधिक प्राप्त करें" में बदलना (2004–2009)। अब तक के सभी तरीके पूर्ण डेटा उपलब्ध होने की धारणा के तहत स्पार्स प्रतिनिधित्व खोज रहे थे। Candès, Romberg, Tao (2006) और Donoho (2006) विपरीत प्रश्न उठाते हैं: यदि हम जानते हैं कि एक संकेत किसी आधार के तहत k-स्पार्स है, तो सटीक पुनर्निर्माण के लिए कितने माप आवश्यक हैं? उत्तर है m ≳ C·k·log(n/k) यादृच्छिक रैखिक माप, जो न्यक्विस्ट दर से बहुत कम है। शर्त यह है कि माप मैट्रिक्स प्रतिबंधित समरूपता (RIP) को संतुष्ट करे, अर्थात्, सभी 2k-स्पार्स वेक्टरों की लंबाई को लगभग संरक्षित रखे। Candès (2008) पर्याप्त शर्त δ₂ₖ < √2−1 ≈ 0.414 देते हैं, और Donoho और Tanner (2009) ने संयोजी ज्यामिति का उपयोग करके L1 पुनर्निर्माण की सफलता और विफलता के बीच तीव्र चरण संक्रमण को चिह्नित किया। संपीड़न संवेदन का ऐतिहासिक महत्व यह है कि इसने स्पार्सिटी को "प्रतिनिधित्व की संपत्ति" से "नमूनाकरण के सिद्धांत" में उन्नत किया, और इमेजिंग हार्डवेयर डिज़ाइन को सीधे बदल दिया। Lustig, Donoho, Pauly (2007) ने इसे MRI में लाए, यादृच्छिक अंडरसैम्पलिंग प्रक्षेपवक्र के बदले में स्कैन समय को कम किया। Duarte et al. (2008) ने एक सिंगल-पिक्सल कैमरा बनाया, और रेडियो खगोल विज्ञान में SMILI पाइपलाइन EHT के ब्लैक होल इमेजिंग के लिए L1 और कुल भिन्नता नियमितीकरण का उपयोग करता है।
शब्दकोश सीखना और स्पार्स कोडिंग: निश्चित आधार से सीखा गया आधार तक (1996–2012)। वेवलेट मानव-डिज़ाइन किए गए निश्चित आधार हैं और विशेष डेटा के लिए इष्टतम नहीं हो सकते। Olshausen और Field (1996) ने डेटा से शब्दकोश सीखा और V1 के ग्राहक क्षेत्रों को पुनः प्राप्त किया। K-SVD (Aharon, Elad, और Bruckstein 2006) स्पार्स कोडिंग और प्रत्येक परमाणु के लिए SVD अपडेट को वैकल्पिक रूप से करने के लिए एक व्यावहारिक एल्गोरिदम प्रदान करते हैं। Lee, Battle, Raina, Ng (2007) ने L1 स्पार्स कोडिंग को तेज़ किया और "स्व-शिक्षित सीखने" को आगे बढ़ाया। Le et al. (2012) ने 9 परतों और 1 बिलियन कनेक्शन तक स्पार्स ऑटोएनकोडर को ढेर किया, और YouTube के 10 मिलियन फ़्रेम से बिना निरीक्षण के बिल्ली के चेहरे-चयनात्मक न्यूरॉन्स सीखे। 2012 में AlexNet के बाद से, यह वंशक्रम 10 साल के लिए पर्यवेक्षित कन्वोलिूशनल नेटवर्क की छाया में छिपा रहता है, लेकिन दो चीजें छोड़ता है: "ओवरकंप्लीट शब्दकोश + स्पार्स गुणांक" की प्रतिनिधित्व रूपरेखा, और "शब्दकोश को डेटा से सीखा जा सकता है" का विश्वास। 2023 में जब Anthropic ने स्पार्स ऑटोएनकोडर के साथ बड़े पैमाने के मॉडल की आंतरिक विशेषताओं को डिकोड किया, तो उन्होंने Olshausen और Field को ही उद्धृत किया, और संबंधित पत्रों के सह-लेखक में Olshausen स्वयं थे।
कम रैंक: स्पार्सिटी का जुड़वां (1936–2014)। Eckart और Young (1936) ने साबित किया कि छंटनी SVD मैट्रिक्स का सर्वश्रेष्ठ कम-रैंक अनुमान है। कम रैंक और स्पार्सिटी संरचनात्मक रूप से समरूप हैं। दोनों ही "ऊर्जा को कुछ घटकों में केंद्रित करते हैं और पूंछ को काटते हैं", लेकिन कार्य का विषय अलग है। स्पार्सिटी निर्देशांक को काटती है, कम रैंक दिशाओं को काटता है। Gavish और Donoho (2014) कम-रैंक शोर निकालने के लिए इष्टतम हार्ड-थ्रेसहोल्ड देते हैं, जो वेवलेट शोर निकालने की सार्वभौमिक थ्रेसहोल्ड से गूंजता है। Robust PCA (Candès et al. 2011) दोनों को जोड़ता है: डेटा = कम रैंक + स्पार्स। यह अंतर "वर्तमान" अध्याय में महत्वपूर्ण हो जाता है। DeepSeek का MLA कम-रैंक संपीड़न है, और DSA और CSA2 ही स्पार्स अटेंशन हैं। दोनों अक्सर भ्रमित होते हैं।
सारांश: शास्त्रीय युग ने गहरे शिक्षण के लिए 3 विरासतें छोड़ी हैं
पहला, डेटा को संसाधित करने की तुलना में सही आधार खोजना अधिक महत्वपूर्ण है। एक ही छवि पिक्सल आधार में सघन है और वेवलेट आधार में स्पार्स है। अंतर पूरी तरह से वर्णन के तरीके में निहित है। दूसरा, शून्य बनाने के लिए केवल 3 संक्रिया हैं: नरम-थ्रेसहोल्डिंग (L1), कठोर-थ्रेसहोल्डिंग (L0), और सबसे बड़े k को रखना (L0 गोले पर प्रक्षेपण)। तीसरा, केवल संरचित स्पार्सिटी ही हार्डवेयर और मानक तक पहुंचती है। वेवलेट का ट्री संरचना JPEG2000 में प्रवेश किया, यादृच्छिक अंडरसैम्पलिंग MRI उत्पादों में प्रवेश किया। तीनों विरासतें "तंत्रिका नेटवर्क युग" और "वर्तमान" में नए रूप में फिर से प्रकट होती हैं।
तंत्रिका नेटवर्क युग (1990–2022): स्पार्सिटी की विफलता और मोड़
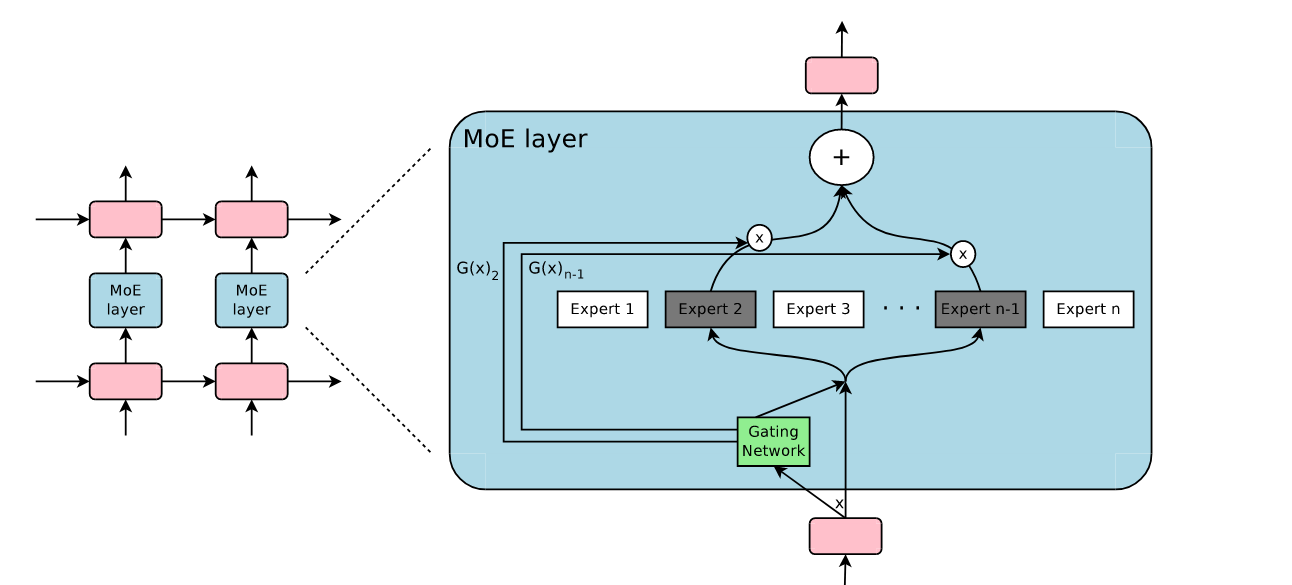
स्पार्सिटी हार नहीं गई। हार्डवेयर के साथ असंगत स्पार्सिटी हार गई। गैर-संरचित वजन प्रूनिंग सिद्धांत में सफल रही, GPU पर विफल रही। MoE स्पार्सिफिकेशन की इकाई को पूरे विशेषज्ञ ब्लॉक में बदलता है, प्रत्येक विशेषज्ञ के आंतरिक को सघन मैट्रिक्स गुणन के रूप में रखता है, इसलिए यह हार्डवेयर लॉटरी जीता। इस अध्याय में हम समझाते हैं क्यों।
प्रूनिंग की वंशावली और "स्पार्सिटी की दीवार"
OBD (LeCun, Denker & Solla 1990) प्रत्येक वजन के महत्व का अनुमान द्विघात जानकारी से लगाता है, OBS (Hassibi & Stork 1993) इसे पूर्ण हेसियन मैट्रिक्स से परिष्कृत करता है। Deep Compression (Han, Mao & Dally 2016) प्रूनिंग, क्वांटाइज़ेशन, और हफ़मैन कोडिंग को जोड़ता है, AlexNet को 240 MB से 6.9 MB तक संपीड़ित करता है। लॉटरी परिकल्पना (Frankle & Carbin 2019) दिखाती है कि एक सघन नेटवर्क में एक स्पार्स सबनेटवर्क होता है जो स्वतंत्र रूप से प्रशिक्षित होने पर भी समान सटीकता तक पहुंच सकता है। SparseGPT (Frantar & Alistarh 2023) और Wanda (Sun et al. 2023) दिखाते हैं कि GPT-क्लास मॉडल को सटीकता को मुश्किल से त्याग किए बिना 50% स्पार्स तक वन-शॉट में बनाया जा सकता है।
लेकिन जब LLM का युग आता है, तो यह वंशक्रम एक दीवार पर टकराता है। अक्टूबर 2025 का ELSA पेपर (arXiv:2510.01650) इसे "स्पार्सिटी की दीवार" कहता है। मौजूदा तरीके "सटीकता को बहुत नुकसान पहुंचाए बिना 50–60% स्पार्सिटी से अधिक नहीं जा सकते हैं" ऐसा प्रतीत होता है। ELSA का दावा है कि ADMM का उपयोग करके LLaMA-2-7B को 90% के पास तक प्रूनिंग किया जा सकता है, लेकिन वह दावा अभी भी विचार के तहत है।
सक्रियकरण स्पार्सिटी: ReLU की वास्तविक संख्याएं
Glorot, Bordes, Bengio (2011, AISTATS) सक्रियकरण स्पार्सिटी के प्राथमिक स्रोत हैं, और उनकी संख्याओं को सटीक रूप से उद्धृत करने के लिए समझदारी है। समान आरंभीकरण के तुरंत बाद, लगभग 50% छिपी इकाइयां सख्ती से शून्य आउटपुट करती हैं। प्रशिक्षण के बाद औसत सख्त स्पार्सिटी दर MNIST पर 83.4%, CIFAR10 पर 72.0%, NISTP पर 68.0%, NORB पर 73.8%। निष्कर्ष यह है कि "सबसे अच्छी तरह से सामान्यीकरण करने वाले मॉडल की स्पार्सिटी दर 50% से 80% के बीच है" और प्रदर्शन को नुकसान पहुंचाए बिना लगभग 85% तक स्पार्सिटी को मजबूर किया जा सकता है। "ReLU 90% स्पार्स है" के दावे के लिए मूल स्रोत में कोई समर्थन नहीं है।
वैसे, एक अंतर रखने के लिए एक बात है। ड्रॉपआउट सीखने के दौरान लागू यादृच्छिक नियमितीकरण है, और अनुमान के समय नेटवर्क सघन लौटता है। प्रूनिंग वजन को स्थायी रूप से हटाता है। दोनों को "मुखौटा लागू करना" लिखा जा सकता है, लेकिन मुखौटा की यादृच्छिकता, कार्य करने का चरण, और उद्देश्य पूरी तरह से अलग हैं।
गैर-संरचित वजन स्पार्सिटी GPU युग में क्यों हार गई
हार्डवेयर लॉटरी। Hooker की परिभाषा (The Hardware Lottery, 2020/2021) के अनुसार, एक अनुसंधान विचार इसलिए जीतता है क्योंकि यह एक बेहतर विचार है, बल्कि इसलिए कि यह उपलब्ध सॉफ़्टवेयर और हार्डवेयर के साथ संरेखित है। GPU और TPU सघन और निरंतर मैट्रिक्स गुणन के लिए डिज़ाइन किए गए हैं। गैर-संरचित स्पार्सिटी gather/scatter लाता है, GEMM की टाइल की गई डेटाफ़्लो को तोड़ता है, ऑन-चिप कैश पुन: उपयोग को कम करता है, और आमतौर पर टेंसर कोर का उपयोग नहीं कर सकता। अनुभवजन्य रूप से, cuSPARSE जैसी लाइब्रेरी स्पष्ट त्वरण तभी दिखाती है जब स्पार्सिटी लगभग 90% से अधिक हो, और 50% गैर-संरचित स्पार्सिटी पर, सघन GEMM को GPU पर हराने के लिए लगभग कोई बनी-बनाई कर्नल नहीं है।
2:4 संरचित स्पार्सिटी। Ampere और बाद में GPU, 4 वजन के बीच बिल्कुल 2 शून्य के पैटर्न का समर्थन करते हैं, और पैटर्न पूरा होने पर सैद्धांतिक थ्रूपुट 2 गुना है। लेकिन स्पार्सिटी 50% पर एक सीमा है, और सटीकता की वसूली को पुनः शिक्षण या फाइन-ट्यूनिंग की आवश्यकता है, और अंत-से-अंत तक त्वरण 2 गुना के करीब आने में विरल होता है, इसलिए LLM तैनाती में यह क्वांटाइज़ेशन जितना व्यापक नहीं हुआ।
क्वांटाइज़ेशन क्यों जीता। क्वांटाइज़ेशन प्रति पैरामीटर बिट्स की संख्या कम करता है, लेकिन मैट्रिक्स की नियमितता को नहीं छूता, इसलिए कोई भी GPU स्वाभाविक रूप से लाभान्वित होता है। GPTQ (2022) और AWQ (2023) के बाद, MXFP4 2025–2026 की देशी प्रारूप बन गई। gpt-oss MoE वजन (कुल पैरामीटर का 90% से अधिक) को MXFP4 (प्रति पैरामीटर 4.25 बिट्स) में संग्रहीत करता है, और यह 120b मॉडल को 1 x 80 GB GPU में फिट करना संभव बनाता है। Kimi K3 MXFP4 वजन और MXFP8 सक्रियकरण के साथ क्वांटाइज़ेशन-जागरूक सीखने (QAT) करता है, और DeepSeek-V4 परिवार के विशेषज्ञ पैरामीटर FP4 का उपयोग करते हैं।
स्मृति की दीवार। V100 से B200 तक, पीक कंप्यूटिंग प्रदर्शन की वृद्धि मेमोरी बैंडविड्थ की वृद्धि को बहुत अधिक पार निकल गई है (प्रत्येक विक्रेता के प्रकाशित विनिर्देशों पर आधारित क्रम-परिमाण के अंक)।
| GPU | घनी BF16/FP16 कंप्यूटिंग प्रदर्शन | HBM बैंडविड्थ | प्रति बाइट संचालन (अनुमानित) |
|---|---|---|---|
| V100 (2017) | लगभग 125 TFLOPS | 0.9 TB/s | 140 |
| A100 (2020) | लगभग 312 TFLOPS | 1.6–2.0 TB/s | 155–195 |
| H100 SXM (2022) | लगभग 989 TFLOPS | 3.35 TB/s | 295 |
| B200 (2024) | लगभग 2.2 PFLOPS (FP4 के लिए लगभग 9 PFLOPS) | लगभग 8 TB/s | 280 (FP4 के लिए लगभग 1,100) |
डिकोडिंग के दौरान, हर बार एक टोकन उत्पन्न करने पर, GPU मेमोरी से गणना में शामिल भार को निकाला जाना चाहिए। छोटे बैच आकार पर, कम्प्यूटेशनल यूनिट्स ज्यादातर निष्क्रिय रहते हैं, और बाधा बैंडविड्थ बन जाती है। यही कारण है कि "FLOPs को कम करना" से अधिक "पढ़ने योग्य पैरामीटर और KV को कम करना" अधिक मूल्यवान है। MoE टोकन प्रति पढ़े गए भार के बाइट्स को कम करता है, और स्पार्स अटेंशन और KV कम्प्रेशन कैश के बाइट्स को कम करते हैं। दोनों सटीक रूप से सबसे महंगे आइटम को काट रहे हैं।
सशर्त गणना का वंशावली (महत्वपूर्ण मोड़)
1991 Jacobs, Jordan, Nowlan, और Hinton द्वारा Adaptive Mixtures of Local Experts। कई विशेषज्ञ नेटवर्क को एक गेटिंग नेटवर्क के साथ प्रशिक्षित किया जाता है, और प्रारंभिक प्रेरणा कार्यों के बीच हस्तक्षेप को कम करना था। 1994 में, Jordan & Jacobs ने इसे पदानुक्रमित MoE तक विस्तारित किया।
2013 Bengio और अन्य द्वारा सशर्त गणना और संभाव्यवादी न्यूरॉन के माध्यम से ग्रेडिएंट अनुमान (STE) का प्रस्ताव। Eigen, Ranzato, और Sutskever ने गहरे नेटवर्क में MoE को जल्दी आजमाया।
2017 Shazeer और अन्य द्वारा Outrageously Large Neural Networks (सह-लेखक Hinton और Dean)। LSTM परतों के बीच 137B पैरामीटर तक के स्पार्स गेट MoE परत को डाला गया, जिससे "गणना दक्षता के न्यूनतम नुकसान के साथ मॉडल क्षमता को 1000 गुना से अधिक में सुधार किया गया"। ध्यान दें कि मूल पाठ "greater than 1000x" है, और 137B MoE परत के पैरामीटर संख्या को संदर्भित करता है।
2020–2022 GSharp ने MoE को Transformer में लाया और 600B से अधिक तक स्केल किया, Switch Transformer (Fedus, Zoph & Shazeer 2021) top-1 रूटिंग के साथ 1 ट्रिलियन पैरामीटर तक पहुंचे। GLaM और ST-MoE ने स्थिरता मुद्दों (router z-loss) को संबोधित किया, और Expert Choice (2022) ने विशेषज्ञों को टोकन चुनने के तरीके को उलट दिया, बोझ को स्वाभाविक रूप से संतुलित किया।
इस खंड को एक वाक्य में कहें तो: 1991 से 2022 तक, सशर्त गणना का विचार नहीं बदला। जो बदला वह हार्डवेयर और उसके अनुरूप स्केल के अंतिम आगमन थे।
MoE को कागज से उत्पाद तक: 2017–2022 में हल किई गई इंजीनियरिंग समस्याएं
Shazeer et al. (2017) ने दिखाया कि क्षमता को 1000 गुना तक विस्तारित किया जा सकता है, लेकिन MoE को एक विश्वसनीय उत्पाद बनाने के लिए 5 साल और चार विशिष्ट समस्याओं के समाधान की आवश्यकता थी।
रूटिंग को कैसे सीखें। गेट s = Softmax(W_g·h) को आउटपुट करता है, शीर्ष k विशेषज्ञ चुने जाते हैं, और परत का आउटपुट y = h + Σ_{i∈T} s_i·FFN_i(h) बन जाता है। समस्या यह है कि top-k एक असतत चुनाव है, इसलिए s के संबंध में व्युत्पन्न लगभग हर जगह शून्य है। ग्रेडिएंट केवल चुने गए विशेषज्ञों के गेट वजन तक पहुंचता है, और अचुने गए विशेषज्ञों को कभी भी सीखने का मौका नहीं मिलता। Shazeer का समाधान Noisy Top-k गेटिंग था, logits में सीखने योग्य गाऊसी शोर जोड़ना, ताकि k+1 स्थान पर होना चाहिए वाले विशेषज्ञ को कभी-कभी चुना जा सके। अधिक सामान्य समाधान Bengio et al. (2013) से सीधे-सीधा अनुमानक (STE) और बाद में Gumbel-Softmax हैं।
बोझ को कैसे संतुलित करें। राउटर के पास rich-get-richer (जो समृद्ध हैं वह और समृद्ध हो जाते हैं) की प्रवृत्ति होती है। लोकप्रिय विशेषज्ञ अधिक चुने जाते हैं, जितना अधिक चुने जाते हैं उतना बेहतर सीखते हैं, और अधिक चुने जाने की संभावना बढ़ जाती है, अंततः कुछ विशेषज्ञ सभी ट्रैफिक को संभालते हैं और मॉडल वास्तव में एक छोटे मॉडल में परिणत हो जाता है (विशेषज्ञ पतन)। GSharp और Switch Transformer ने सहायक लोड-बैलेंसिंग हानि L_bal = α·N·Σ f_i·P_i शुरू की। f_i विशेषज्ञ i को आवंटित किए गए टोकन का अनुपात है, P_i उसकी औसत गेट संभावना है। ST-MoE (2022) ने router z-loss के साथ logits विस्फोट को आगे दबाया। ये सहायक हानियां काम करती हैं, लेकिन मूल भाषा मॉडलिंग उद्देश्य फ़ंक्शन के ग्रेडिएंट को परेशान करती हैं। 2024 में, DeepSeek-V3 ने "ग्रेडिएंट के बाहर पूर्वाग्रह" के साथ इस ट्रेडऑफ से बचा ("वर्तमान" अध्याय देखें)।
क्षमता को कैसे निर्धारित करें। वितरित सीखने में, प्रत्येक विशेषज्ञ के बफर आकार को पहले से तय करना आवश्यक है, और यहां क्षमता कारक दिखाई देता है। प्रति विशेषज्ञ क्षमता = capacity_factor × (टोकन संख्या / N)। क्षमता से अधिक टोकन को ड्रॉप किया जाता है (token dropping), और केवल अवशिष्ट कनेक्शन से गुजरता है। बड़ी क्षमता मेमोरी बर्बादी है, छोटी क्षमता गुणवत्ता में गिरावट है। MegaBlocks (2023) ने ब्लॉक-स्पार्स मैट्रिक्स गुणन के साथ "ड्रॉपलेस" MoE बनाया, इस दुविधा से बाहर निकल गया।
संचार को कैसे संभालें। विशेषज्ञ अलग-अलग GPUs पर रखे जाते हैं (विशेषज्ञ समांतरता), और प्रत्येक MoE परत दो डेटा-निर्भर all-to-all आदान-प्रदान की मांग करता है। टोकन को विशेषज्ञों वाले GPU को भेजें, परिणाम वापस लें। यह MoE सीखने में प्रमुख संचार बाधा है, और MoE बड़े पैमाने पर केंद्रीकृत परिनियोजन के लिए अनुकूल होने का कारण भी है। DeepSpeed-MoE और Tutel से DeepSeek के DeepEP तक, ये सभी सिस्टम इस पथ को अनुकूलित कर रहे हैं।
मील के पत्थर: GShard (2020) ने MoE को Transformer में लाया और 600B से अधिक तक। Switch Transformer (2021) top-1 रूटिंग के साथ 1 ट्रिलियन पैरामीटर तक पहुंचे, और T5-XXL की तुलना में 4 गुना तेजी से पूर्व-प्रशिक्षण किया। GLaM (2021) में कुल 1.2T पैरामीटर और लगभग 97B सक्रियण थे, GPT-3 की तुलना में लगभग एक-तिहाई ऊर्जा खपत। Expert Choice (2022) ने दिशा उलट दी, विशेषज्ञों को टोकन चुनने दिया और बोझ को स्वाभाविक रूप से संतुलित किया।
2022 से पहले MoE अभी भी मुख्यधारा क्यों नहीं था
इन इंजीनियरिंग समाधानों के साथ भी, 2022 का MoE अभी भी Google के अंदर "बड़ी कंपनी का खिलौना" था। तीन कारण हैं। पहला, लागत दबाव अभी तक काफी मजबूत नहीं था। GPT-3 के समय में, घने मॉडल अभी भी तेजी से प्रगति कर रहे थे, और अनुमान लागत मुख्य बाधा नहीं था। दूसरा, खुली पारिस्थितिकी नहीं थी। उच्च-गुणवत्ता के खुले-वजन वाले MoE मौजूद नहीं थे, और समुदाय पुनरुत्पादन या सुधार नहीं कर सकता था। तीसरा, फाइन-ट्यूनिंग मुश्किल थी। छोटे डेटासेट पर, रूटिंग ढह जाती है, और डाउनस्ट्रीम कार्यों में अनुकूलन घने मॉडल जितना चिकना नहीं था।
ये 3 शर्तें 2023 के अंत में एक बार में बदल गईं। Mixtral 8x7B (दिसंबर 2023) पहला उच्च-गुणवत्ता का खुला MoE बन गया, ChatGPT-स्तर की ट्रैफिक ने अनुमान लागत को सबसे गंभीर समस्या बना दिया, और DeepSeekMoE (जनवरी 2024) ने बारीक-दानेदार विशेषज्ञ और साझा विशेषज्ञों के साथ MoE की लागत-प्रभावशीलता को एक नए स्तर पर ले गया। यहां से "वर्तमान" शुरू होता है।
सारांश
इस अध्याय की 3 वंशावली, अर्थात् प्रूनिंग, सक्रियण स्पार्सिटी, और सशर्त गणना, 2022 से पहले बिल्कुल अलग भाग्य से गुजरी। प्रूनिंग सिद्धांत में सफल रहा, लेकिन हार्डवेयर में असफल रहा। सक्रियण स्पार्सिटी (ReLU) हर जगह उपयोग की जाती थी, लेकिन लगभग हर जगह दोहन नहीं की गई। सशर्त गणना सब कुछ सही थी, केवल आर्थिक दबाव की कमी थी। भाग्य के इस अंतर को समझने से, आप समझ सकते हैं कि 2023 के बाद से विजेता प्रूनिंग नहीं बल्कि MoE क्यों रहा है। स्पार्सिटी को व्यावहारिक बनाया जा सकता है या नहीं, यह इस बात पर निर्भर करता है कि उसके शून्य हार्डवेयर द्वारा उपयोग किए जाने वाले संरचना हैं या नहीं।
वर्तमान (2023–सितंबर 2026): LLM ने स्पार्सिटी पर पूरी तरह क्यों दांव लगाया
2026 तक, अत्याधुनिक खुले मॉडलों में प्रति-टोकन सक्रियण दर 1.5% से 4.5% तक गिर जाएगी, और स्पार्सिटी FFN से अटेंशन, KV कैश, और ज्ञान भंडारण के बहुत ही तरीके तक फैलेगी। यह अध्याय पहले 4 दबाव दिखाता है, फिर 5 प्रकार की स्पार्सिटी को क्रम से सूचीबद्ध करता है, और अंत में एकीकृत सिद्धांत और अर्थव्यवस्था पर जाता है।
अभी क्यों: 4 दबाव
स्केलिंग लागत की दीवार से टकराई। कुल पैरामीटर 1–3T क्षेत्र तक पहुंच गए (DeepSeek-V4-Pro 1.6T, Kimi K3 2.8T), और घने मॉडलों के साथ सीखना और अनुमान आर्थिक रूप से व्यवहार्य नहीं रह गया।
अनुमान लागत ने सीखने की लागत को पार कर दिया। 2025 की 1 मार्च की अनुमान प्रणाली समीक्षा में, DeepSeek ने नोड्स भर में बड़े पैमाने पर विशेषज्ञ समांतरता के साथ बैच को बड़ा करना, GEMM दक्षता को बढ़ाना प्रकट किया। यह दर्शाता है कि अनुमान की अर्थव्यवस्था आर्किटेक्चर डिजाइन में एकल सबसे महत्वपूर्ण बाधा बन गई है।
एजेंटों ने वर्कलोड को "इनपुट-केंद्रित" बना दिया। V4.1 की तकनीकी रिपोर्ट शुरुआत में कहती है कि दीर्घ-चलने वाले एजेंटों के प्रसार के साथ, वर्कलोड तेजी से इनपुट द्वारा हावी हो गया है, और विशाल KV कैश HBM और SSD क्षमता और स्थानांतरण बैंडविड्थ को लगातार दबाता है।
निर्यात नियंत्रण के तहत इंजीनियरिंग रचनात्मकता। DeepSeek-V3 को 2,048 H800 के साथ, कुल लगभग 2.788 मिलियन GPU घंटों में प्रशिक्षित किया गया। H800, H100 के समान चिप है, लेकिन NVLink बैंडविड्थ 900 GB/s से 400 GB/s तक कटी गई है, और यह सीधे DeepEP जैसे संचार अनुकूलन को जन्म देता है।
सशर्त गणना: MoE डिफ़ॉल्ट आर्किटेक्चर बन जाता है
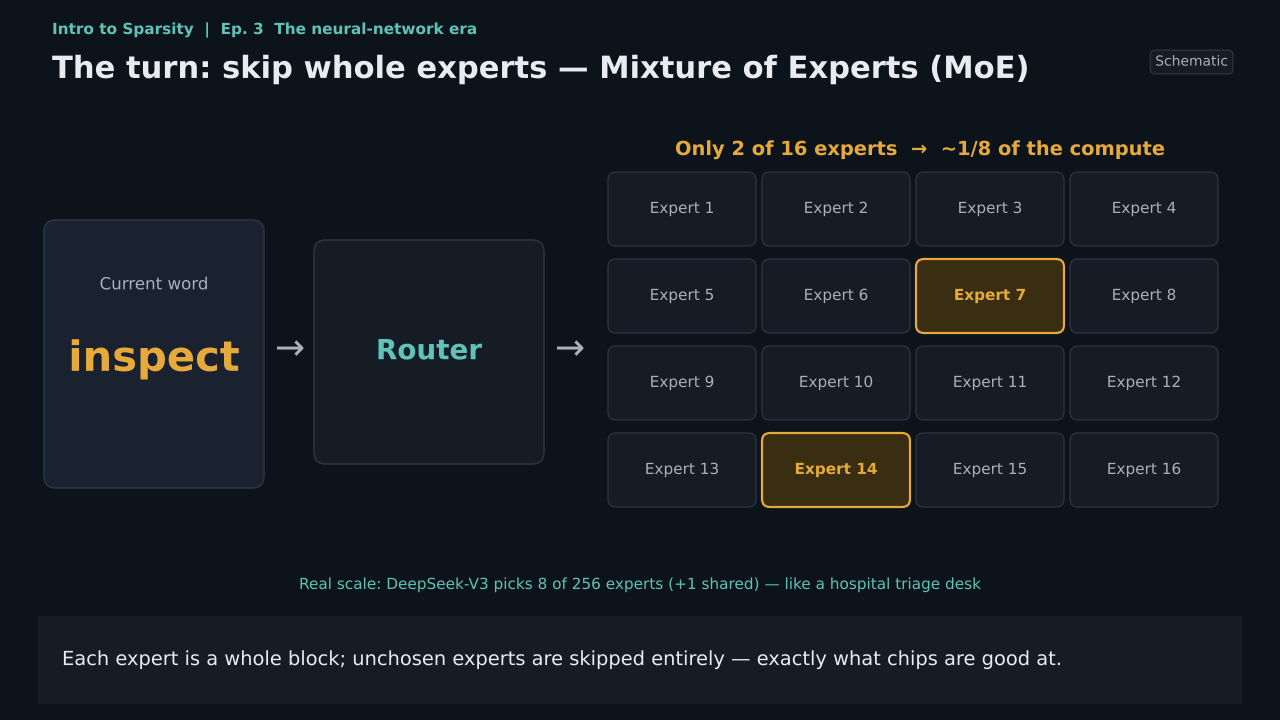
DeepSeek परिवार का विकास(सभी आधिकारिक तकनीकी रिपोर्ट, मॉडल कार्ड और API घोषणाओं से):
| DeepSeek परिवार का विकास (सभी आधिकारिक तकनीकी रिपोर्ट, मॉडल कार्ड और API घोषणा से): | मॉडल | समय अवधि | कुल पैरामीटर / प्रति टोकन सक्रियकरण | विशेषज्ञ संरचना |
|---|---|---|---|---|
| DeepSeekMoE | 2024-01 | — | मुख्य विरल तकनीकें | महीन-दानेदार विशेषज्ञ + साझा विशेषज्ञ |
| V2 | 2024-05 | 236B / 21B | विशेषज्ञों को बारीकी से विभाजित करें, संयोजन संख्या को घातांकीय रूप से बढ़ाएं | साझा 2 + राउटिंग 160 |
| V3 | 2024-12 | 671B / 37B | MLA: KV का निम्न-रैंक समवर्ती संपीड़न (निम्न-रैंक है, विरल नहीं) | साझा 1 + राउटिंग 256, 8 चयन |
| V3.2 | 2025-09/12 | 671B / 37B | सहायक हानि के बिना लोड संतुलन, बहु-टोकन भविष्यवाणी, FP8 प्रशिक्षण | वही |
| V4-Flash / V4-Pro | 2026-04-24 | 284B/13B、1.6T/49B | DSA: Lightning Indexer + टोकन-वार शीर्ष-k (k=2048) विरल ध्यान | साझा 1 + राउटिंग 256, 6 चयन / राउटिंग 384 |
| V4.1-Flash | 2026-09-10 | संपीड़ित विरल ध्यान (CSA) और HCA का प्रत्यावर्ती प्लेसमेंट, 1M संदर्भ, FP4 विशेषज्ञ | बैकबोन 552B + Engram 196B, प्रीफिल 8B / डिकोड 16B | CED、CSA2、Hierarchical Sparse Indexer、FP4 KV、Engram |
V4.1-Flash के 5 डिज़ाइन तत्व(तकनीकी रिपोर्ट):
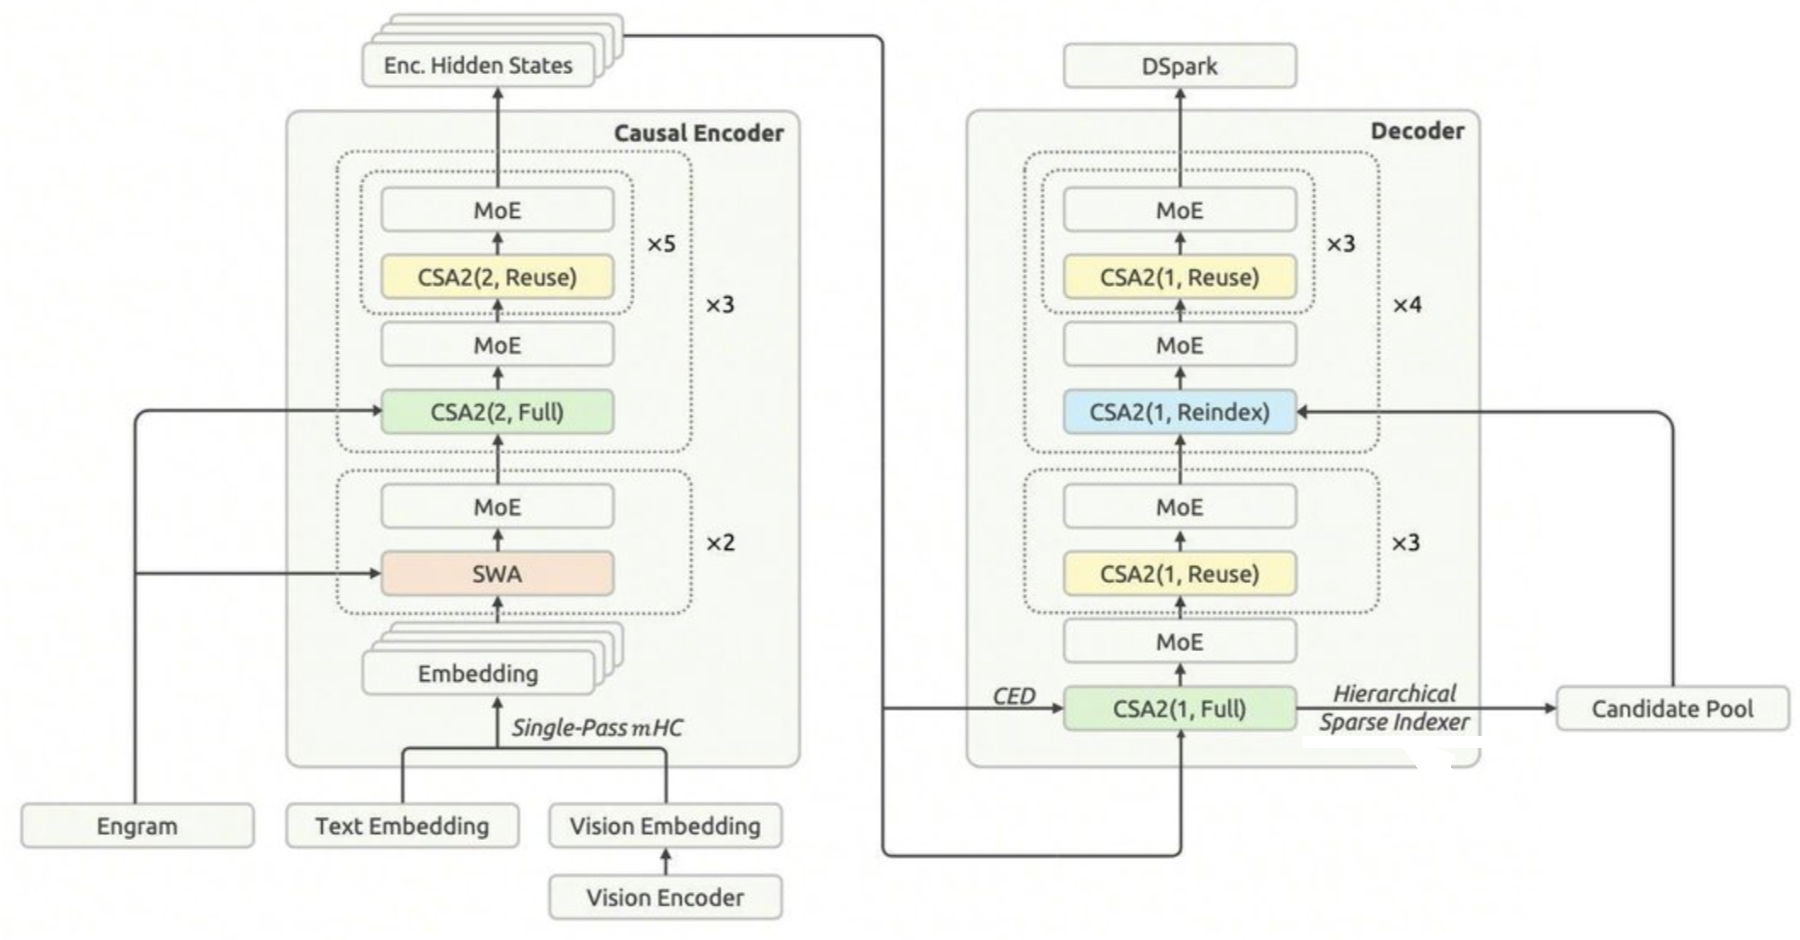
CED (कारणात्मक एनकोडर–डिकोडर)। 40 परतों को 20 परत एनकोडर और 20 परत डिकोडर में विभाजित किया जाता है, डिकोडर का वैश्विक KV एनकोडर की अंतिम छिपी अवस्था से प्रक्षेपित होता है। इनपुट टोकन केवल एनकोडर के माध्यम से जाते हैं (सक्रियण 8B), आउटपुट टोकन डिकोडर के माध्यम से जाते हैं (16B)। यह "एजेंट बहुत पढ़ता है, बस थोड़ा ही लिखता है" इस तथ्य का प्रत्यक्ष उत्तर है।
CED (कारणात्मक एनकोडर–डिकोडर)। 40 परतों को 20 एनकोडर परतों और 20 डिकोडर परतों में विभाजित किया जाता है, डिकोडर की वैश्विक KV एनकोडर की अंतिम छिपी स्थिति से प्रक्षेपित होती है। इनपुट टोकन केवल एनकोडर से गुजरते हैं (सक्रियकरण 8B), आउटपुट टोकन डिकोडर से गुजरते हैं (16B)। "एजेंट बहुत पढ़ते हैं, थोड़ा लिखते हैं" इस तथ्य का सीधा जवाब है।
CSA2 की 3 विधियां। Full अपना वैश्विक KV उत्पन्न करता है और एक इंडेक्स बनाता है। Reindex पिछली परत के KV का पुन: उपयोग करते हुए top-k की पुनः गणना करता है। Reuse top-k इंडेक्स को वैसे ही पुन: उपयोग करता है। अधिकांश परतें Reuse हैं। इसका मतलब है कि अधिकांश परतें "टोकन को दोबारा नहीं चुनती" हैं।
पदानुक्रमित विरल इंडेक्सर। डिकोडर की पहली Full परत एक उम्मीदवार पूल बनाती है, बाद की परतें केवल उसी से चुनती हैं। गहरी परतों में इंडेक्स गणना लागत संदर्भ लंबाई से अलग हो जाती है।
KV की संख्या। वैश्विक KV 890 बाइट प्रति टोकन है, V4-Flash का लगभग 1/4, V1 का 1/437। स्थायी KV V4-Flash का लगभग 1/8 है। संदर्भ को 4K से 1M तक (256 गुना) बढ़ाने के बाद भी, प्रति टोकन डिकोड FLOPs केवल लगभग 1/4 बढ़ता है। विरल ध्यान 64K से प्रशिक्षित किया जाता है, घने ध्यान में कोई वार्मअप नहीं है।
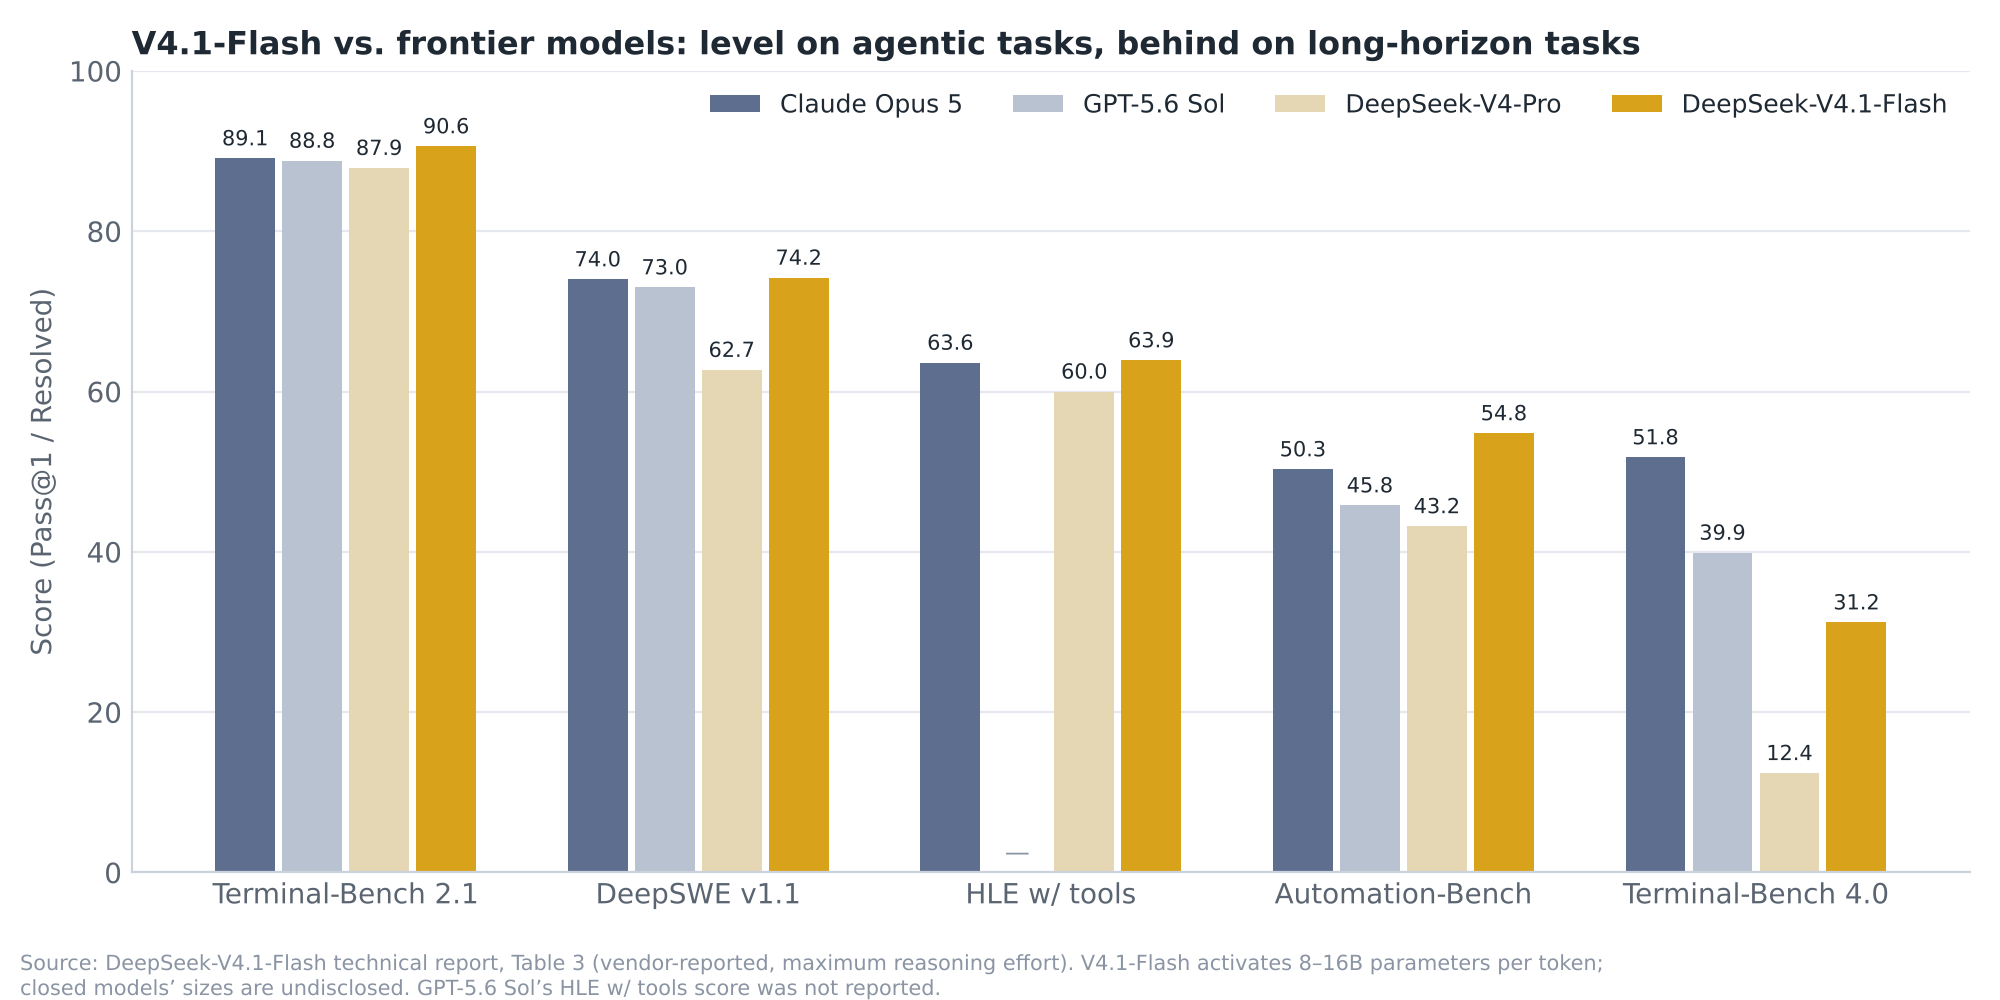
प्रदर्शन और मूल्य निर्धारण के बारे में। DeepSeek का दावा है कि V4.1-Flash-Base ने V4-Pro-Base के स्तर को कुल पैरामीटर 1/3 और सक्रिय पैरामीटर 1/4 में प्राप्त किया है। पीक समय की कीमत इनपुट $0.30/M, कैश किया गया इनपुट $0.006/M, आउटपुट $1.20/M है, और ऑफ-पीक समय में आधी कीमत है। हालांकि तीसरे पक्ष के समग्र संकेतकों में (Artificial Analysis में 40 अंक, Claude Opus 5 में 51 अंक), स्वतंत्र मूल्यांकन में अभी भी लगभग 10 अंक का अंतर है। विक्रेता द्वारा चुने गए बेंचमार्क और स्वतंत्र समग्र मूल्यांकन को अलग से लिखा जाना चाहिए। यह स्वयं "औसत लोगों को धोखा देता है" का एक जीवंत पाठ है।
2025〜2026年के अन्य प्रमुख MoE मॉडल(आधिकारिक मॉडल कार्ड से):
| मॉडल | मॉडल | समय अवधि | कुल / सक्रियकरण | विशेषज्ञ (चयन / कुल) | सक्रियकरण दर |
|---|---|---|---|---|---|
| Mixtral 8x7B | 2023-12 | 46.7B / 12.9B | 2/8 | डिज़ाइन की अन्य विशेषताएं | लगभग 28% |
| gpt-oss-120b | 2025-08 | 116.8B / 5.1B | 4/128 | 4.4% | पहला उच्च-गुणवत्ता वाला खुला MoE |
| Qwen3-235B-A22B | 2025-04 | 235B / 22B | 8/128 | 9.4% | — |
| Qwen3.5-397B-A17B | 2026-02 | 397B / 17B | 10+1 / 512 | 4.3% | MXFP4 MoE भार, स्लाइडिंग विंडो और पूर्ण ध्यान का प्रत्यावर्ती प्लेसमेंट, ध्यान सिंक |
| Kimi K2 / K2.5 | 2025-07 / 2026-01 | 1.04T / 32B | 8+1 / 384 | 3.1% | Gated DeltaNet रैखिक ध्यान को 3:1 में मिश्रित, KV को लगभग 1/4 तक कम किया |
| Kimi K3 | 2026-07 | 2.8T / 104B | MuonClip, 15.5T टोकन पर कोई हानि स्पाइक नहीं | 3.7% | 16 / 896, साझा 2 |
| Llama 4 Maverick | 2025-04 | KDA रैखिक ध्यान + Gated MLA, MXFP4 QAT | लगभग 400B / 17B | 4.3% | 1 + साझा 1 / 128 |
| DeepSeek-V4.1-Flash | 2026-09 | 552B / 8–16B | 6+1 / 384 | 1.4%–2.9% | घने और MoE परतों का प्रत्यावर्ती प्लेसमेंट |
पहले के अनुसार
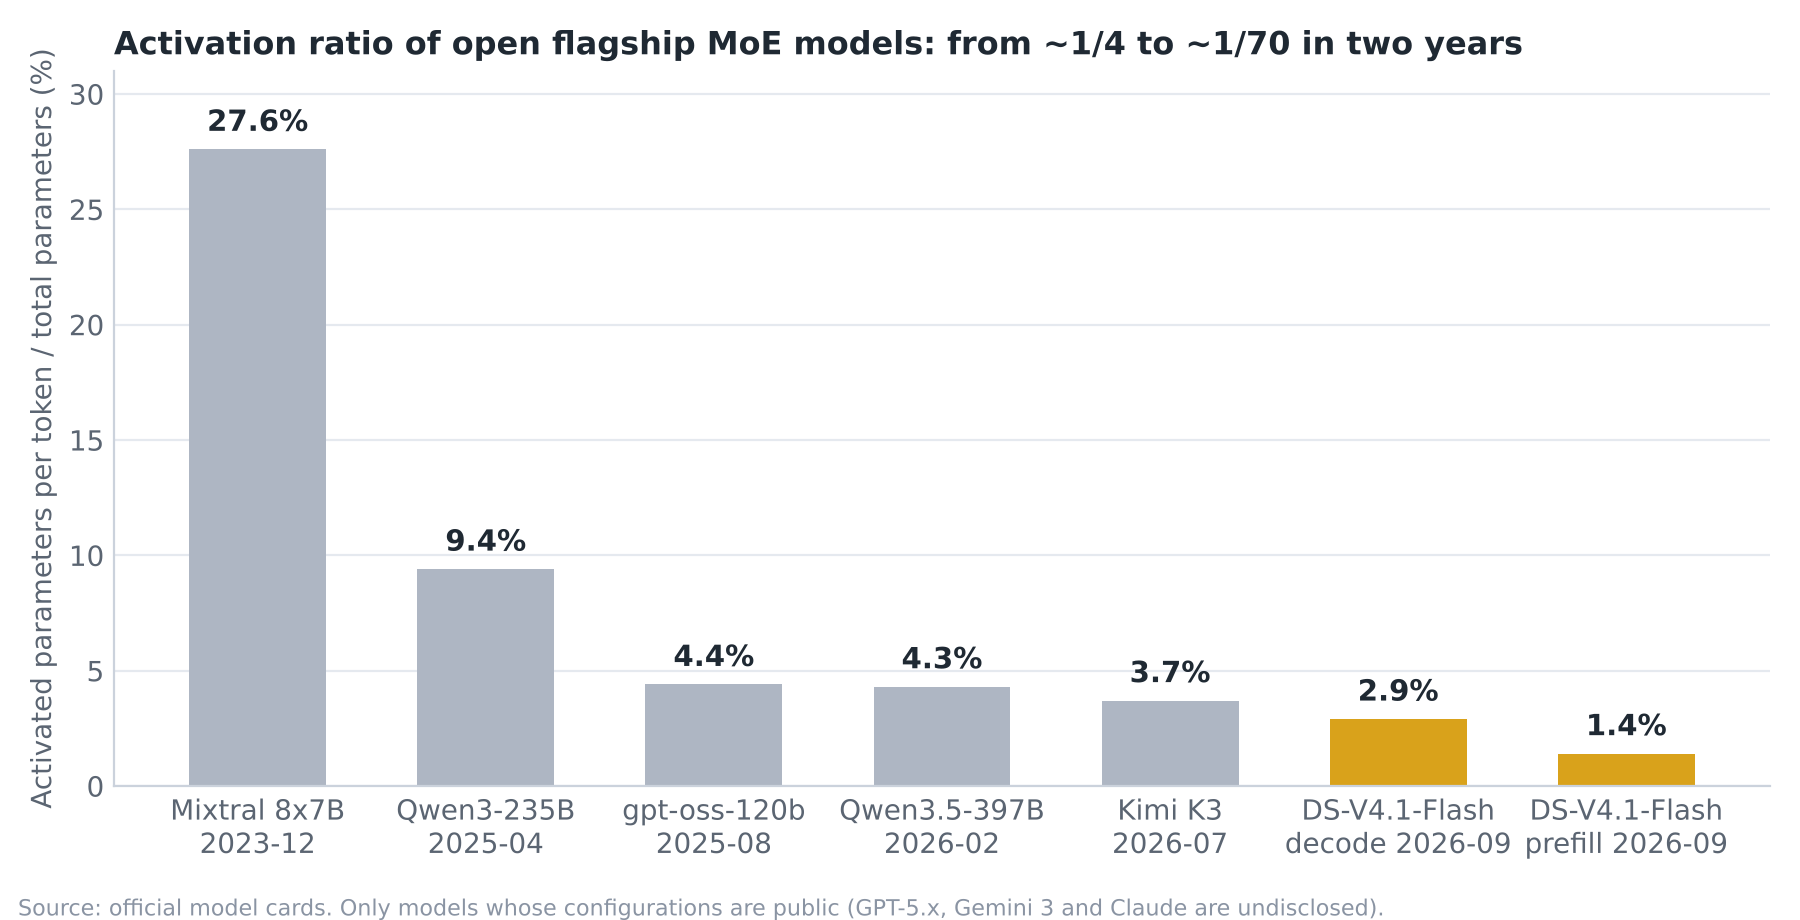
चित्र 10. सार्वजनिक संरचना वाले प्रमुख मॉडलों के कुल पैरामीटर अनुपात में प्रति-टोकन सक्रियकरण पैरामीटर। Mixtral (2023-12) के 27.6% से V4.1-Flash के प्रीफिल चरण के 1.4% तक, 2 वर्षों में लगभग 20 गुना। बंद मॉडल संरचना गैर-सार्वजनिक है इसलिए शामिल नहीं हैं।
ध्यान और KV कैश विरलकरण
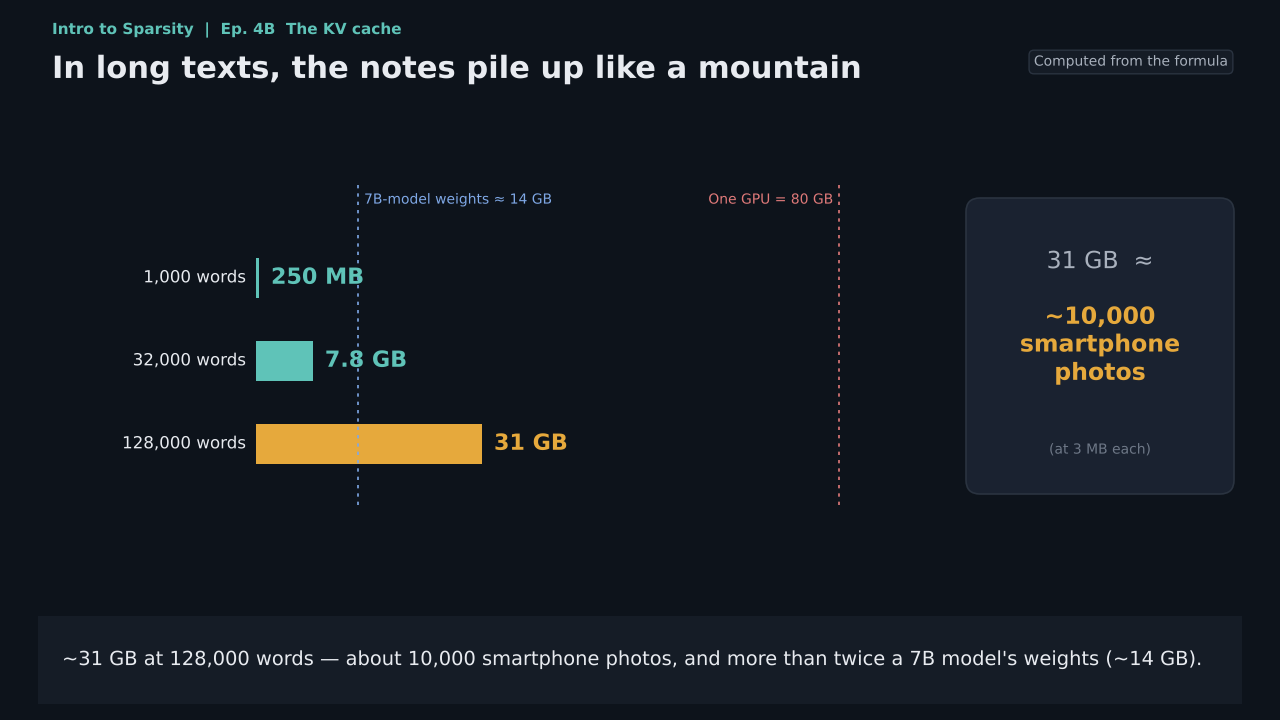
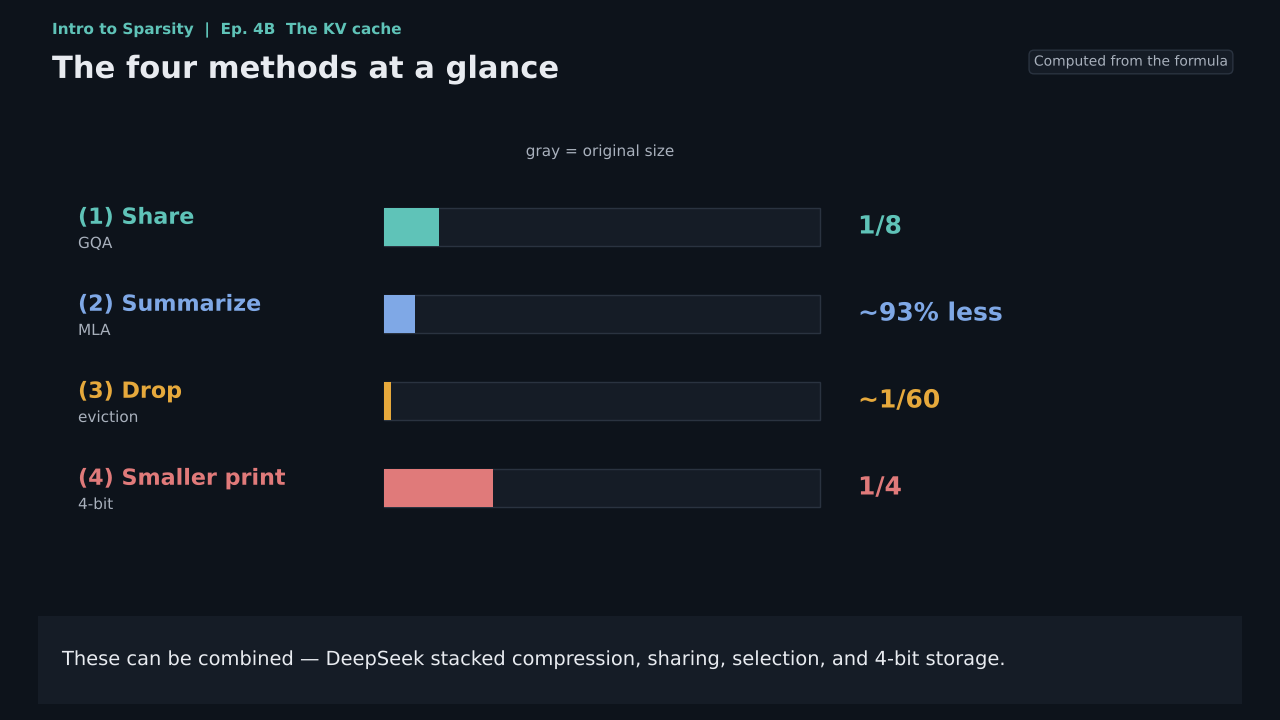
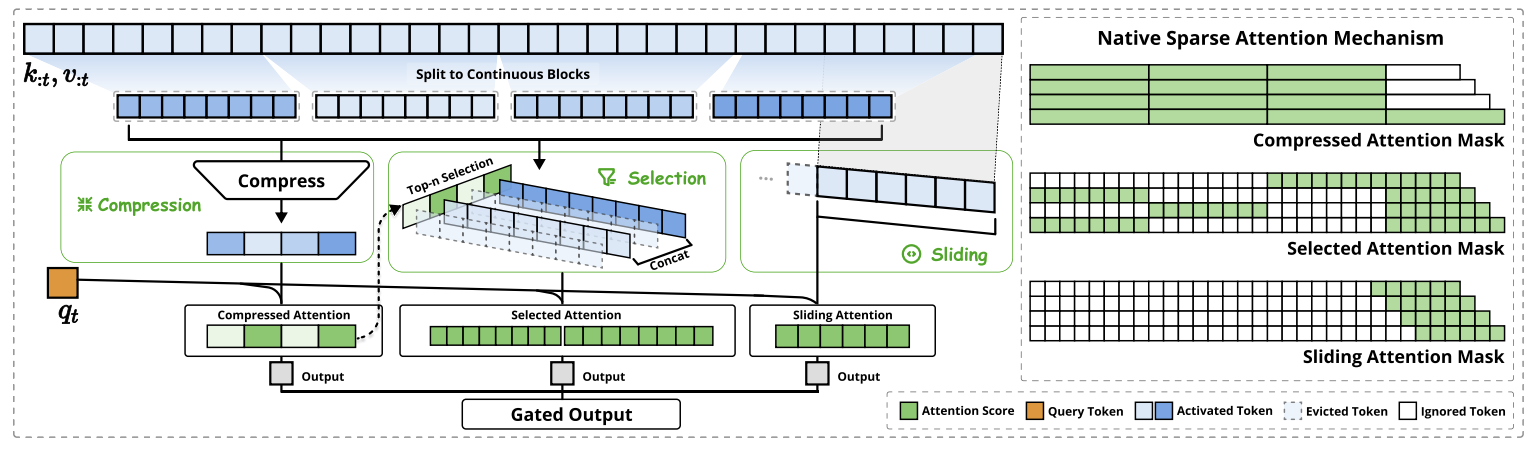
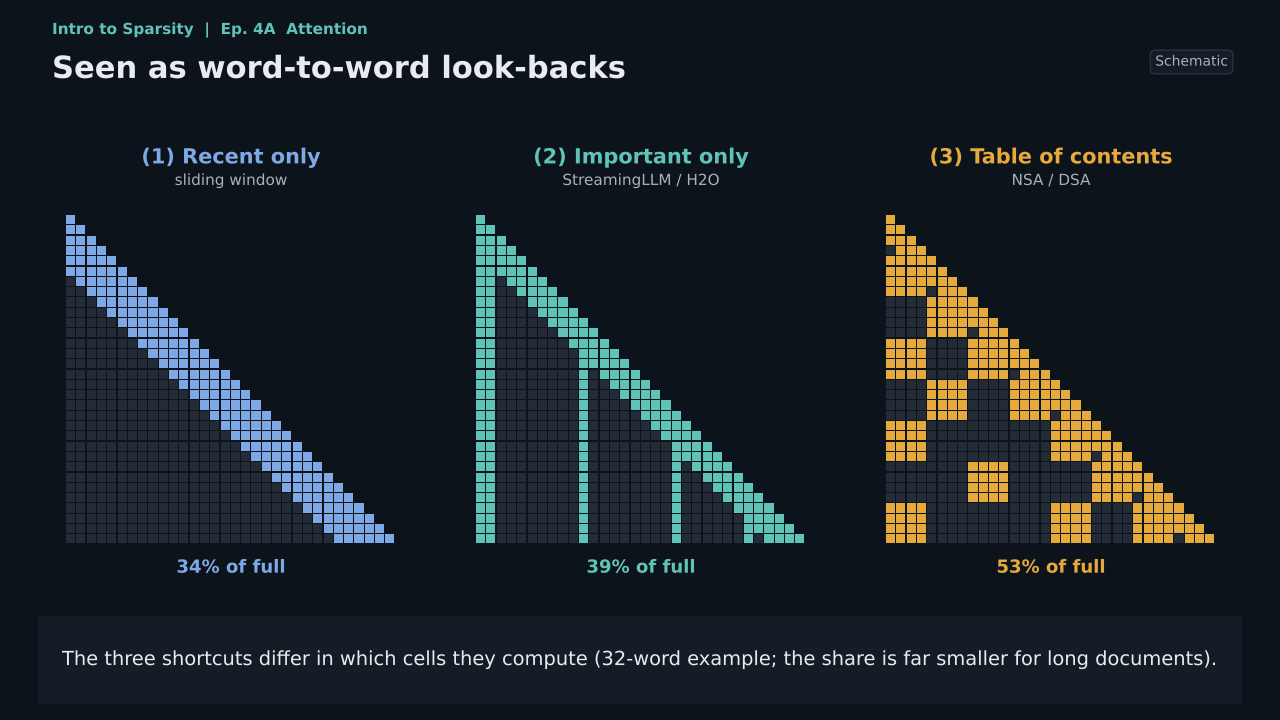
स्पार्स अटेंशन की तीन पीढ़ियां हैं जिन्हें स्तरीय रूप से बिछाया जा सकता है। पहली पीढ़ी निश्चित पैटर्न है (Longformer, BigBird, gpt-oss की स्लाइडिंग विंडो)। दूसरी पीढ़ी अनुमान समय पर गतिशील निष्कासन है जिसे पुनः सीखने की आवश्यकता नहीं है (StreamingLLM, H2O, SnapKV, Quest)। तीसरी पीढ़ी प्रशिक्षण समय से स्वाभाविक रूप से विरलता सीखती है (NSA, MoBA, DSA, CSA2)। NSA (Yuan et al., DeepSeek × बीजिंग विश्वविद्यालय × वाशिंगटन विश्वविद्यालय) ने ACL 2025 का Best Paper Award जीता है और 64K लंबाई पर संपूर्ण अटेंशन अनुपात, डिकोड में 11.6 गुना, फॉरवर्ड पास में 9.0 गुना, और बैकवर्ड पास में 6.0 गुना तेजी प्राप्त की है।
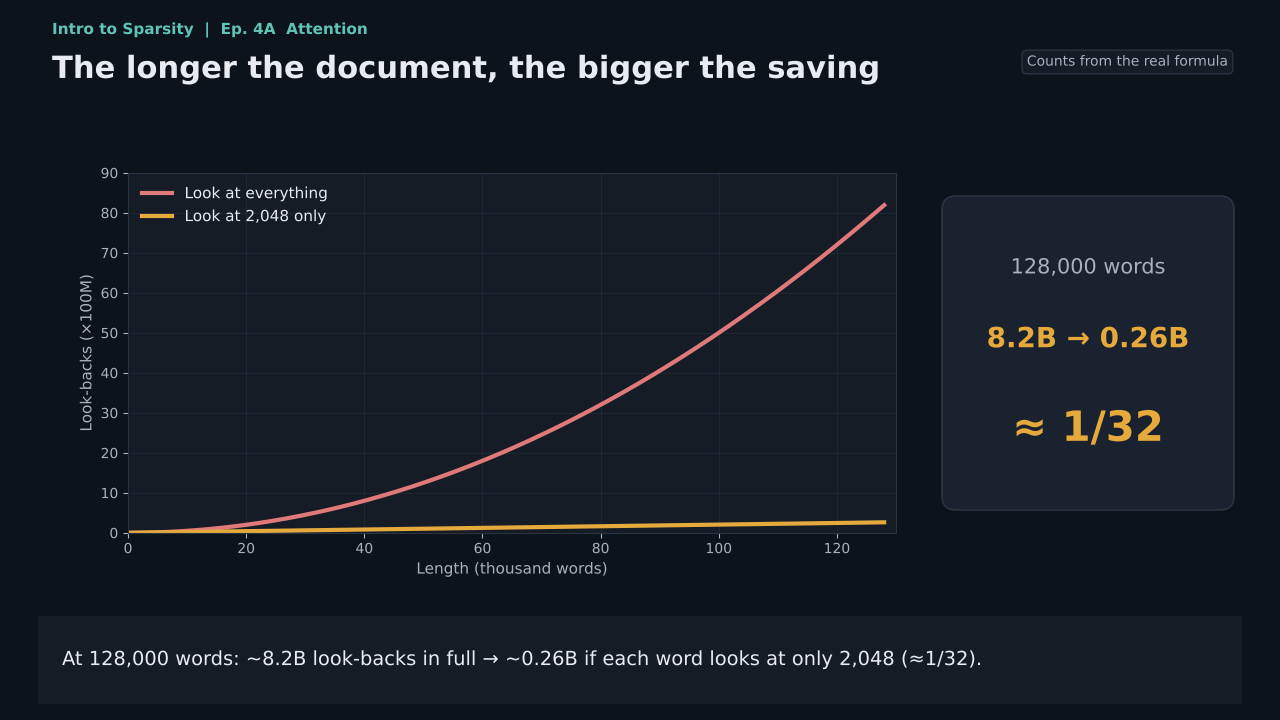
बड़े पैमाने पर माप से सावधानी। Nawrot et al. का The Sparse Frontier (arXiv:2504.17768, औपचारिक रूप से ACL 2026 की खोजों में प्रकाशित) ने प्रशिक्षण-मुक्त विरल ध्यान का मूल्यांकन Qwen2.5 के 7B–72B, 16K–128K, 9 कार्यों पर किया और चार निष्कर्षों तक पहुँचा। बहुत लंबे अनुक्रमों में "बड़ा और विरल" "छोटा और घना" को हराता है, प्रतिच्छेद बिंदु 32–64K के पास है। प्रीफिल के लिए इष्टतम विरलता दर 0.80–0.93 (बजट में 1/5–1/15) है, डिकोड अधिक लचीला है। लगभग सभी कॉन्फ़िगरेशन कम से कम एक कार्य में बड़े प्रदर्शन में गिरावट का सामना करते हैं। विरल ध्यान एक रामबाण नहीं है। और सभी कार्यों और चरणों में सर्वोत्तम एक एकल रणनीति मौजूद नहीं है। यह परिणाम ही था जो तीसरी पीढ़ी के "मूल रूप से प्रशिक्षणयोग्य विरलता" को जन्म देता है।
सक्रिय विरलता
Q-Sparse (Wang, Ma, Wang & Wei, arXiv:2407.10969) सभी रैखिक परतों की सक्रियताओं में सीधे top-k लागू करता है, STE के साथ बैकप्रॉप करता है, और विरलता के स्केलिंग कानूनों को प्रदर्शित करता है। इष्टतम विरलता दर पूर्ण परिशुद्धता मॉडल में लगभग 45.58%, 1.58-बिट मॉडल में लगभग 61.25% है, और लगभग 40% की विरलता दर पर समान आकार के घने मॉडल की बराबरी करता है। Mistral 7B को 40B टोकन पर अतिरिक्त प्रशिक्षण देने पर, Q-Sparse ने 3.8B सक्रियताओं के साथ 63.7 दर्ज किया, घने आधारभूत (7.0B) के 64.6 के करीब। एब्लेशन में, STE को हटाने या top-k को ReLU से बदलने से स्पष्ट प्रदर्शन में गिरावट आई। और ReLU में, जहाँ प्रशिक्षण के दौरान विरलता दर गिरी, top-k में यह स्थिर रही। यह "विरलता एक नियमितीकरण पद नहीं, बल्कि एक वास्तुकला बाधा होनी चाहिए" के दावे का समर्थन करता है। TEAL, ReLU Strikes Back, Deja Vu, और PowerInfer एजन के पक्ष में मुख्य वंशपरंपरा हैं।
व्याख्यायोग्यता में विरलता: SAE का उदय और संदेह
Anthropic का पथ इस प्रकार है। Towards Monosemanticity (2023) विरल ऑटोएनकोडर का उपयोग करके एक-परत मॉडल से एकार्थी विशेषताएँ निकालता है। Scaling Monosemanticity (2024) Claude 3 Sonnet पर 34 मिलियन तक की विशेषताओं के SAE को प्रशिक्षित करता है और Golden Gate Claude में विशेषता क्लैंपिंग का प्रदर्शन करता है। Circuit Tracing और On the Biology of a Large Language Model (2025) परत-व्यापी ट्रांसकोडर के साथ एट्रिब्यूशन ग्राफ़ बनाते हैं और Claude 3.5 Haiku के बहु-चरणीय तर्क को ट्रेस करते हैं। OpenAI में Gao et al. (2024) GPT-4 पर 16 मिलियन विशेषताओं का TopK SAE प्रशिक्षित करता है। यह वंशपरंपरा Olshausen–Field शब्दकोश सीखने की प्रत्यक्ष संतान है।
संदेह 2024–2025 में एकत्र आया। विशेषता अवशोषण (Chanin et al. 2024)। एक-आयामी, गैर-रैखिक विशेषताएँ (Engels et al. 2024)। 113 प्रोबिंग डेटासेट पर लॉजिस्टिक प्रतिगमन आधारभूत को हराने में असमर्थ (Kantamneni et al. 2025)। अलग SAE विभिन्न विशेषताएँ खोजते हैं (Leask et al. 2025)। मार्च 2025 में, Google DeepMind की यांत्रिक व्याख्यायोग्यता टीम ने घोषणा की कि इस क्षेत्र ने SAE में अत्यधिक निवेश किया है और "SAE बुनियादी अनुसंधान की प्राथमिकता को निकट अवधि के लिए कम करेगी"। अपेक्षाकृत संतुलित सर्वसम्मति यह है कि SAE अज्ञात अवधारणाओं की खोज के लिए उपयुक्त हैं, लेकिन ज्ञात अवधारणाओं के डिटेक्टर या नियंत्रक के रूप में नहीं। 2026 में SharedSAE और WriteSAE जैसे नए अनुसंधान सामने आते रहते हैं, लेकिन कोई नई एकीकृत सर्वसम्मति नहीं उभरी है।
एकीकृत सिद्धांत: 3 ऑपरेटर और top-k सीखना
LASSO में हो, प्रूनिंग में, SAE में, या MoE रूटिंग में, "शून्य बनाने" का कदम तीनों ऑपरेटरों में से किसी एक है।
Sλ(y) = sign(y) · max(|y| − λ, 0), Hτ(y) = y · 1[|y| > τ], Pk(y) = निरपेक्ष मान में शीर्ष k घटकों को रखने वाला प्रक्षेपण
नरम थ्रेसहोल्डिंग L1 का समीपवर्ती ऑपरेटर है (LASSO, ISTA, वेवलेट शोर हटाना, L1 पेनल्टी SAE)। कठोर थ्रेसहोल्डिंग L0 से मेल खाता है (परिमाण प्रूनिंग, JumpReLU SAE)। और top-k k-विरल वेक्टर सेट का प्रक्षेपण है (MoE रूटिंग, विरल ध्यान, TopK SAE, Q-Sparse)। ReLU स्वयं τ=0 की एकतरफा कठोर थ्रेसहोल्डिंग है। आधुनिक बड़े मॉडल लगभग सभी तीसरी का उपयोग करते हैं क्योंकि यह प्रति-टोकन संगणना को एक सटीक स्थिरांक में निर्धारित करता है, स्थिर मेमोरी योजना और समर्पित कर्नल को सक्षम करता है। बड़े मॉडल के युग में, विरलता "नियमितीकरण पद" से "वास्तुकला बाधा" में बदल गई है।
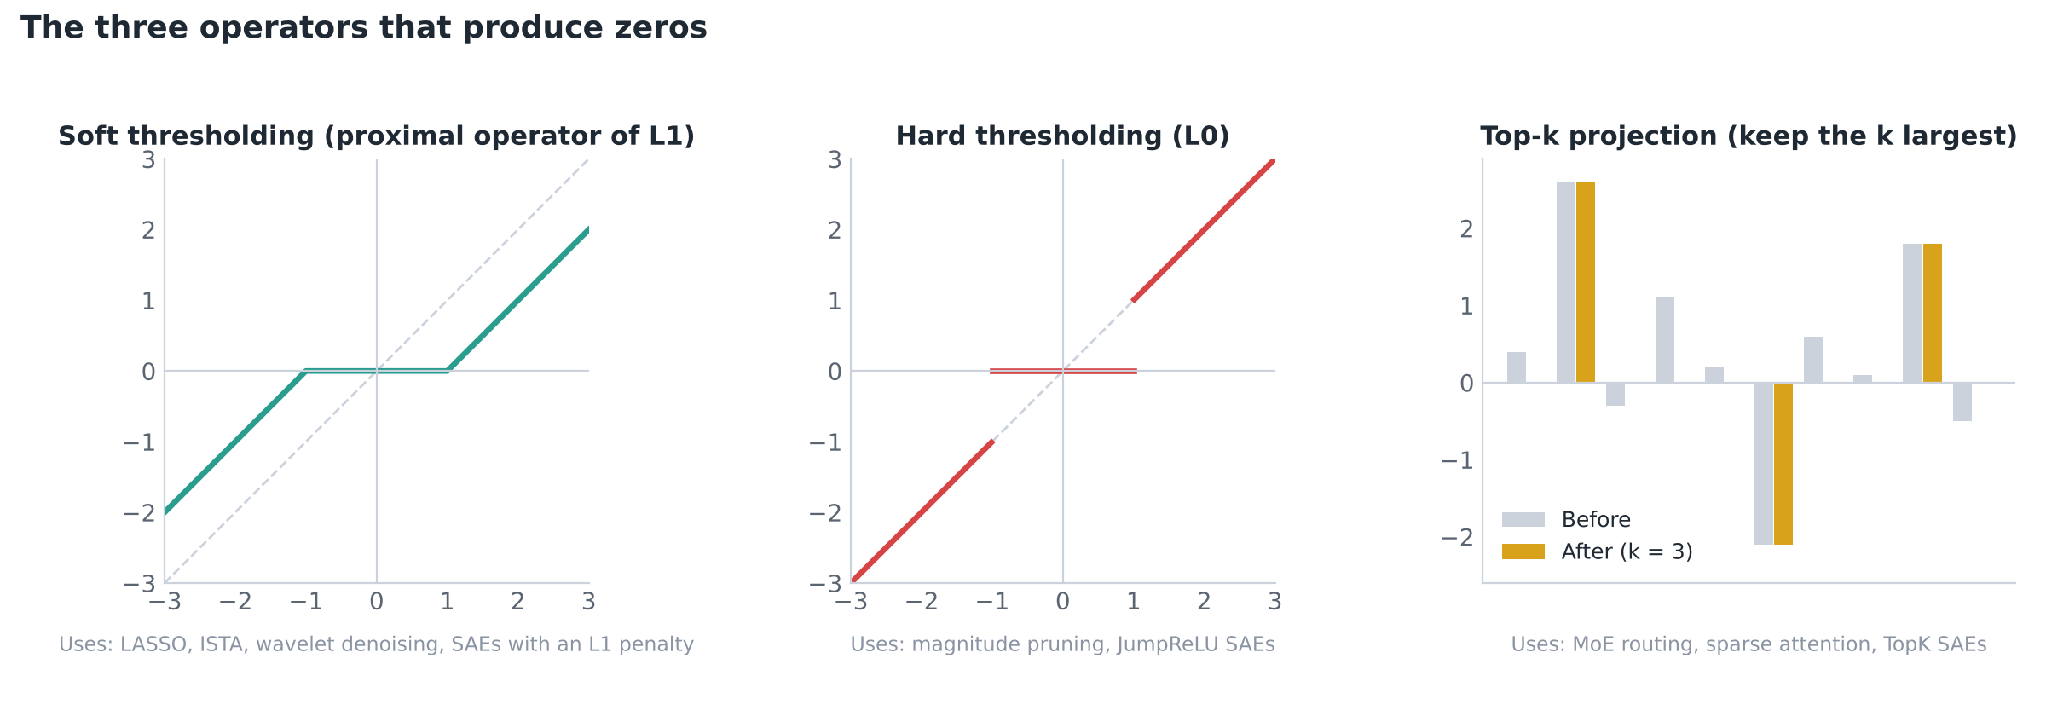
top-k अवकलनीय नहीं है। ∂TopK/∂s लगभग हर जगह शून्य है, इसलिए ढाल केवल चयनित विशेषज्ञ के गेट वजन तक पहुँचती है, बाकी सीख नहीं सकते। इंजीनियरिंग उपचार 4 प्रकार हैं। केवल चयनित विशेषज्ञों को बैकप्रॉप करें और सहायक लोड-बैलेंसिंग हानि जोड़ें (मुख्यधारा पद्धति)। Noisy Top-k के साथ खोज बनाने के लिए शोर जोड़ें (Shazeer 2017)। STE, Gumbel-Softmax, Soft MoE जैसे सतत विश्राम। और DeepSeek-V3 के बाद की सहायक हानि-रहित पूर्वाग्रह, अर्थात s+b से रैंक करना जबकि s से भार देना, b को लोड के अनुसार ग्रेडिएंट के बाहर समायोजित करना। विरल ध्यान की ओर, NSA ब्लॉक स्तर पर चुनता है जहाँ ढाल बहती है, DSA पहले घने ध्यान के साथ वार्मअप करता है, इंडेक्सर को घने ध्यान वितरण के साथ संरेखित करता है, फिर विरल सीखने पर स्विच करता है।
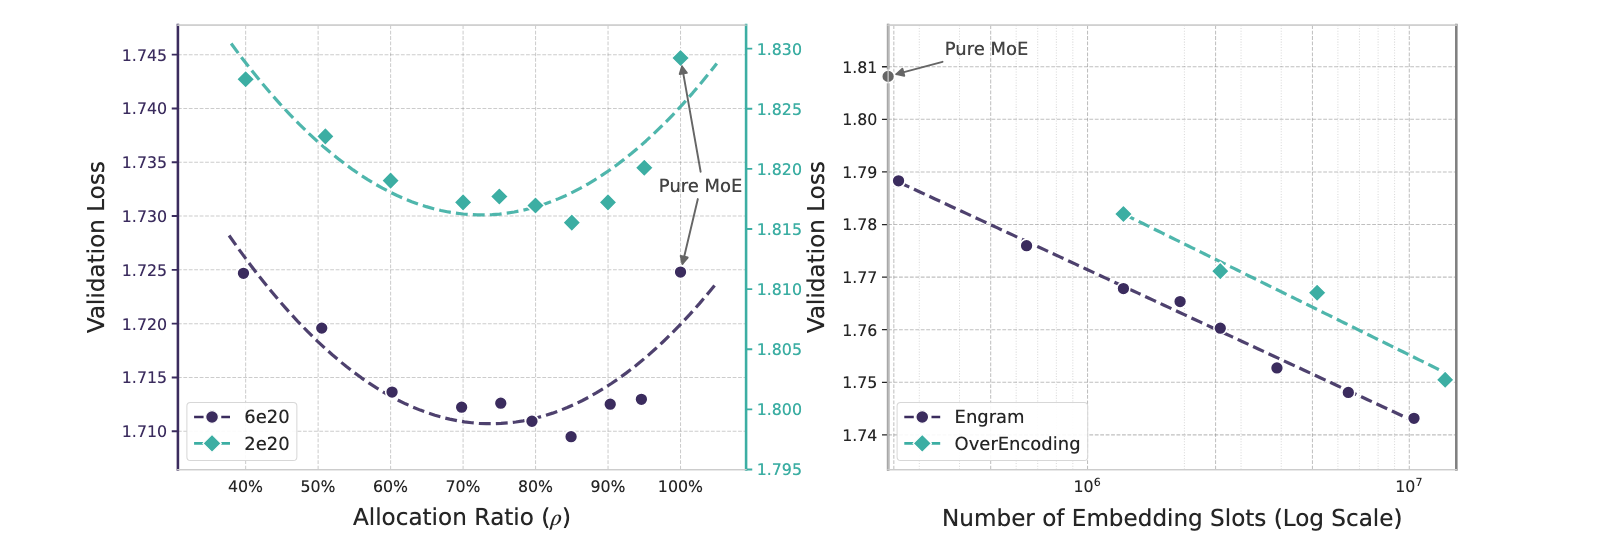
स्केलिंग कानूनों के लिए, Clark et al. (2022) ने रूटेड मॉडल के स्केलिंग को एकीकृत किया, 64–128 विशेषज्ञों की सिफारिश की। Krajewski et al. (2024) ने दिखाया कि सूक्ष्मदानेदार विशेषज्ञ सभी कंप्यूटिंग बजट पर घने मॉडल को हराते हैं। Frantar et al. (2023) ने पाया कि इष्टतम वजन विरलता दर डेटा की मात्रा के साथ बढ़ती है। DeepSeek की Engram पेपर (arXiv:2601.07372, जनवरी 2026) ने "विरलता बजट आबंटन" की समस्या निर्धारित की, एक U-आकार का कानून खोजा। शुद्ध MoE इष्टतम नहीं है; जब सशर्त मेमोरी को विरल पैरामीटर बजट का लगभग 20–25% आवंटित किया जाता है तो सर्वोत्तम परिणाम प्राप्त होते हैं। नौ महीने बाद, यह खोज V4.1 नाम के उत्पाद में शामिल की गई।
अर्थशास्त्र और उद्योग
DeepSeek शॉक। 27 जनवरी 2025 को, Nvidia लगभग 17% गिरा और समापन हुआ, लगभग $589 बिलियन (Bloomberg) से $593 बिलियन (Reuters) का बाजार मूल्य खो गया। अमेरिकी स्टॉक बाजार के इतिहास में सबसे बड़ा एक-दिन की बाजार पूंजीकरण नुकसान।
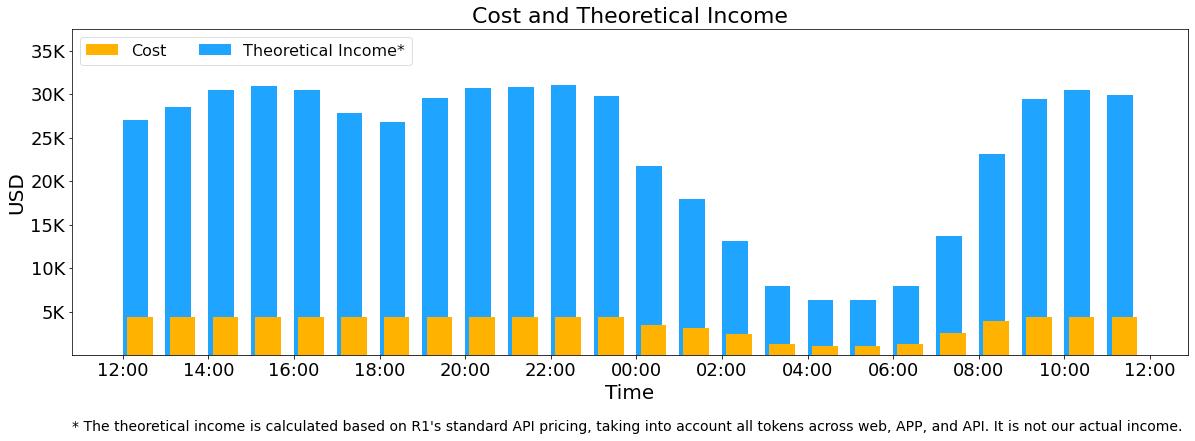
सैद्धांतिक रूप से 545% लाभ मार्जिन। 1 मार्च 2025 को, DeepSeek ने प्रकट किया कि H800 को प्रति घंटा $2 पर रखते हुए दैनिक लागत $87,072 है, और सभी को R1 मूल्य पर चार्ज करने की मान्यता देते हुए सैद्धांतिक दैनिक राजस्व $562,027 है। वास्तविक राजस्व बहुत कम है, अनुसंधान और विकास व्यय और प्रशिक्षण लागत शामिल नहीं हैं, यह भी स्पष्ट किया गया है। इस आंकड़े का हवाला देते समय, हमेशा "सैद्धांतिक रूप से" शब्द जोड़ें।
अनुमान मूल्य। Epoch AI (मार्च 2025) ने इंगित किया कि समान क्षमता स्तर पर अनुमान मूल्य वार्षिक 9 गुना से 900 गुना की गति से गिर रहा है, और यह गति कार्य के अनुसार भिन्न होती है। फिर भी, कंपनियों का कुल भुगतान बढ़ता रहता है। एजेंट प्रति-कार्य कॉलों की संख्या को कई गुना बढ़ाते हैं।
MoE अनुमान की अर्थशास्त्र। मेमोरी कुल पैरामीटरों द्वारा निर्धारित है, बड़ी बैच और विशेषज्ञ समानांतरकरण के साथ ही प्रत्येक विशेषज्ञ को पर्याप्त टोकन मिलते हैं। MoE अनिवार्य रूप से बड़ी केंद्रीकृत सेवा के लिए उपयुक्त है, छोटे स्व-होस्टिंग के लिए नहीं। vLLM और SGLang ने सार्वजनिक होने के दिन से MLA, DSA, V4.1 का समर्थन किया।
प्रत्येक अनुसंधान संस्थान की पद्धति की व्यवस्थित तुलना
प्रत्येक अनुसंधान संस्थान को समान मानदंडों से संरेखित करने पर, विरलीकरण का मार्ग एक नहीं है, कई रणनीतियाँ समानांतर में प्रतिस्पर्धा करती हैं।
| अनुसंधान संस्थान | संरचना का प्रकटीकरण | विरलता के मुख्य प्रकार | विशेषज्ञ (चयनित / कुल) | ध्यान रणनीति | KV रणनीति | वजन प्रारूप | प्रतिनिधि मॉडल | विशिष्ट विशेषताएँ |
|---|---|---|---|---|---|---|---|---|
| DeepSeek | तकनीकी रिपोर्ट के साथ जारी | MoE+विरल ध्यान+सशर्त मेमोरी | 6/384+साझा 1 | मूल विरलता (DSA→CSA2), शुरुआत से विरल सीखना | MLA कम-रैंक+FP4+परत-व्यापी पुनः उपयोग, 890 B/टोकन | FP4/FP8 विशेषज्ञ | V3, V3.2, V4, V4.1-Flash | 3-अक्ष विरलता को स्तरित। एजेंट के लिए एनकोडर-डिकोडर विभाजन |
| Moonshot (Kimi) | वजन और रिपोर्ट जारी | MoE+रैखिक ध्यान हाइब्रिड | 16/896+साझा 2 | ब्लॉक विरल MoBA। K3 KDA रैखिक ध्यान+Gated MLA है | रैखिक परत में कोई KV नहीं | MXFP4 QAT | K2, K2.5, K3 | सबसे बड़ी विशेषज्ञ संख्या। MuonClip द्वारा स्थिर सीखना |
| Alibaba (Qwen) | मॉडल कार्ड जारी | MoE+रैखिक ध्यान हाइब्रिड | 10/512+साझा 1 | Gated DeltaNet और Gated Attention 3:1 में | KV लगभग 1/4 तक कम | BF16/FP8 | Qwen3, Qwen3.5 | एजन से फ्लैगशिप तक पूरी श्रृंखला |
| Meta | मॉडल कार्ड जारी | MoE | 1/128+साझा 1 (Maverick) | घने परत और MoE परत का प्रत्यावर्ती प्लेसमेंट। iRoPE | मानक GQA | BF16 | Llama 4 | 10M संदर्भ (Scout)। Behemoth अप्रकाशित है |
| OpenAI | केवल gpt-oss जारी | MoE | 4/128 | स्लाइडिंग विंडो (128) और पूर्ण ध्यान का प्रत्यावर्ती। attention sink | GQA, 8 हेड | MXFP4 | gpt-oss-120b/20b | GPT-5.x गैर-सार्वजनिक। SAE अनुसंधान (Gao 2024) |
| Gemini 1.5 और 2.5 MoE होने की आधिकारिक रूप से पुष्टि की गई है। विवरण गोपनीय हैं | MoE। एज डिवाइस के लिए लचीली संरचना | गोपनीय | गोपनीय | गोपनीय | गोपनीय | Gemini 1.5/2.5, Gemma 3n | MatFormer की नेस्टेड सबमॉडल, PLE | |
| Anthropic | गोपनीय | व्याख्यात्मकता के लिए विरलता (SAE, ट्रांसकोडर) | गोपनीय | गोपनीय | गोपनीय | गोपनीय | Claude श्रृंखला | विरलता को "मॉडल को समझने" के उपकरण के रूप में उपयोग करें |
| Mistral | वजन सार्वजनिक किए गए | MoE | 2/8 | मानक | GQA | BF16 | Mixtral 8x7B/8x22B | पहला उच्च-गुणवत्ता वाला ओपन MoE (दिसंबर 2023) |
| Microsoft Research | पेपर सार्वजनिक किया गया | सक्रियकरण विरलता + 1.58 बिट | — | मानक | मानक | 1.58 बिट (BitNet) | Q-Sparse, BitNet b1.58 | विरलता और चरम निम्न-बिट परिमाणीकरण का संयोजन |
| Meituan / Ant / Zhipu | मॉडल कार्ड सार्वजनिक किए गए | MoE का वेरिएंट | विविध | विविध | विविध | विविध | LongCat-Flash, Ling, GLM-4.5/4.6 | शून्य गणना विशेषज्ञ, शॉर्टकट कनेक्शन MoE |
यहां से तीन अवलोकन निकाले जा सकते हैं। पहला, विरल आर्किटेक्चर नवाचार का मुख्य स्रोत चीन का ओपन मॉडल समुदाय है। बारीक-दाने विशेषज्ञ, साझा विशेषज्ञ, सहायक हानि के बिना लोड संतुलन, मूल विरल ध्यान, सशर्त मेमोरी, रैखिक ध्यान हाइब्रिड लगभग सभी पहली बार DeepSeek, Qwen और Kimi द्वारा प्रकाशित किए गए थे। दूसरा, बड़ी बंद अनुसंधान संस्थाओं की संरचना एक ब्लैक बॉक्स है, और हम केवल gpt-oss या Gemini की रिपोर्ट जैसी सार्वजनिक जानकारी से अनुमान लगा सकते हैं। "GPT-4 1.8T MoE है" को तथ्य के रूप में उद्धृत करना एक सामान्य गलती है। तीसरा, ध्यान दो रास्तों में विभाजित है। DeepSeek ने "विरल ध्यान" (टोकन जोड़ी के केवल कुछ की गणना) चुना, जबकि Qwen और Kimi ने "रैखिक ध्यान हाइब्रिड" (KV कैश को पुनरावर्ती स्थिति से बदलना) चुना। दोनों KV कैश मेमोरी और बैंडविड्थ की एक ही समस्या को संबोधित करते हैं, लेकिन गणितीय उपकरण अलग हैं। पूर्व विरल है, बाद वाला निम्न-रैंक पुनरावृत्ति के करीब है।
सिस्टम स्टैक: विरलता को वास्तव में काम में लाने की इंजीनियरिंग
विरल आर्किटेक्चर के लाभ वास्तव में महसूस होते हैं या नहीं, यह अक्सर अनदेखी किए गए स्तर द्वारा निर्धारित होता है, अर्थात् सिस्टम सॉफ्टवेयर।
विशेषज्ञ समानांतरकरण और संचार। DeepEP (DeepSeek द्वारा 2025 में जारी) FP8 और NVSHMEN पर RDMA को समर्थन करने वाली उच्च-थ्रूपुट, निम्न-विलंबता all-to-all कर्नल प्रदान करता है, और संचार और गणना को ओवरलैप करता है। MegaBlocks (2023) MoE गणना को ब्लॉक विरल GEMM के रूप में फिर से लिखता है ड्रॉपलेस MoE को महसूस करते हुए, घने Megatron-LM की तुलना में 2.4x गति प्राप्त करता है।
ध्यान कर्नल। FlashMLA MLA के लिए अनुकूलित है। DSA और CSA2 को इंडेक्सर और विरल ध्यान कर्नल की आवश्यकता होती है, DeepSeek ने FlashMLA और DeepGEMM के साथ जारी किए। V4.1 के CSA2 के 3 मोड का मतलब है कि अनुमान इंजन को KV और इंडेक्स के क्रॉस-लेयर पुन: उपयोग को प्रबंधित करना चाहिए।
अनुमान ढांचा। vLLM और SGLang ने जारी होने के दिन से MLA, DSA, V4.1-Flash का समर्थन किया, H100/H200/B200/GB200 और AMD MI355X को कवर किया। NVIDIA NeMo AutoModel V4.1 के फाइन-ट्यूनिंग रेसिपी प्रदान करता है, जिसके लिए एक एकल NVLink डोमेन के भीतर 64 GPU की आवश्यकता होती है।
पदानुक्रमित भंडारण। V4.1 की Engram तालिका (लगभग 183 GiB) होस्ट मेमोरी में रखी जाती है, RDMA पर प्रीफेच की जाती है। Engram को CXL मेमोरी पूल में रखने और "ज्ञान" को HBM से सस्ती परत में स्थानांतरित करने का एक पेपर पहले से ही बाहर है। SWA Bounded Replay स्लाइडिंग विंडो KV को SSD पर स्थायी होने से बचाता है।
परिमाणीकरण प्रारूप। MXFP4 (32 तत्वों के प्रति एक साझा पैमाने पर 8 बिट, औसतन 4.25 बिट) 2025–2026 में MoE विशेषज्ञ वजन का डीफैक्टो मानक बन गया है। Blackwell FP4 टेंसर कोर का मूल रूप से समर्थन करता है।
इस खंड का निष्कर्ष "तंत्रिका नेटवर्क युग" के साथ गूंजता है। विरलता की जीत हमेशा इसके अनुरूप कर्नल और शेड्यूलिंग के साथ आई है। 2:4 विरलता व्यापक नहीं हुई क्योंकि, टेंसर कोर के बावजूद, परिपक्व एंड-टू-एंड सॉफ्टवेयर स्टैक की कमी थी। MoE मुख्यधारा बन गया क्योंकि DeepEP, MegaBlocks और vLLM थे।
विरलता और गहन शिक्षा जहां मिलते हैं: छवि और सिग्नल प्रसंस्करण में हाल के विकास
जहां बड़े मॉडल ने गणना की बचत के लिए विरलता का उपयोग किया, छवि और सिग्नल प्रसंस्करण एक अलग रास्ता चला गया। विरल पूर्व वितरण को गहन नेटवर्क के साथ जोड़ते हुए, अधूरे और शोरदार माप से सिग्नल को पुनः प्राप्त करना। इसके परिणाम रिवर्स दिशा में भी बहते हैं, बड़े मॉडल को समझने के तरीके और आर्किटेक्चर डिजाइन को बदलते हैं।
एल्गोरिथ्म प्रसार: पुनरावृत्ति विरल सॉल्वर को नेटवर्क में बदलना
प्रारंभिक बिंदु Gregor और LeCun (2010) का LISTA है। ISTA की निश्चित पुनरावृत्ति को, सीमित संख्या में परतों वाले नेटवर्क में "प्रसारित (unroll)" करें, और इसके मापदंडों को सीखने योग्य बनाएं। प्रत्येक परत अभी भी "रैखिक परिवर्तन + नरम थ्रेसहोल्डिंग" है, लेकिन मैट्रिक्स और थ्रेसहोल्ड डेटा से सीखे जाते हैं। परिणाम हाथ से ट्यून किए गए ISTA की तुलना में 1-2 परिमाण अधिक तेजी से अभिसरित होता है, और अभी भी व्याख्यात्मक संरचना को बनाए रखता है। प्रत्येक परत निकट-प्रवणता विधि के 1 चरण के अनुरूप है। एल्गोरिदम प्रसार बाद में कम्प्यूटेशनल इमेजिंग का मुख्य ढांचा बन गया। ADMM-Net और ISTA-Net को संपीड़ित संवेदन MRI पुनर्निर्माण में उपयोग किया जाता है, और प्रसारित नेटवर्क नैदानिक अंडरसैंपलिंग डेटा पर शास्त्रीय CS विधियों से अधिक है। प्रसार का गहरा महत्व यह दिखाना है कि गहन नेटवर्क को विरल सॉल्वर के सीखने योग्य संस्करण के रूप में पढ़ा जा सकता है। यह अंतर्दृष्टि बाद में विरल शब्दकोश के साथ तंत्रिका नेटवर्क को डिकोड करते समय अंतर्ज्ञान प्रदान करती है।
प्लग-एंड-प्ले पूर्व वितरण और शोर में कमी द्वारा नियमितीकरण
शास्त्रीय नियमितीकरण (L1, कुल भिन्नता) स्पष्ट रूप से पूर्व वितरण को दंड शब्द के रूप में लिखते हैं। 2013 के बाद प्रकट होने वाले प्लग-एंड-प्ले (PnP) ढांचे में पाया गया कि ADMM या निकट-प्रवणता विधि का "निकट ऑपरेटर लागू करें" चरण एक मनमानी शोर में कमी करने वाले, अर्थात् प्रशिक्षित गहन शोर में कमी करने वाले नेटवर्क द्वारा प्रतिस्थापित किया जा सकता है। पूर्व वितरण "एक सूत्र" से "ब्लैक बॉक्स शोर में कमी करने वाला" बन गया, और विरल पूर्व वितरण इसके विशेष मामलों में से एक है। नियमितीकरण द्वारा शोर में कमी (RED) और बाद की विसरण मॉडल पूर्व वितरण इस वंशक्रम को जारी रखते हैं। इस दृश्य में, नरम थ्रेसहोल्डिंग द्वारा शोर में कमी, BM3D, गहन शोर में कमी वाले उपकरण एक ही स्थान में फिट किए जाने वाले विनिमय के 3 पीढ़ी हैं।
Deep Image Prior: नेटवर्क की संरचना ही पूर्व वितरण है
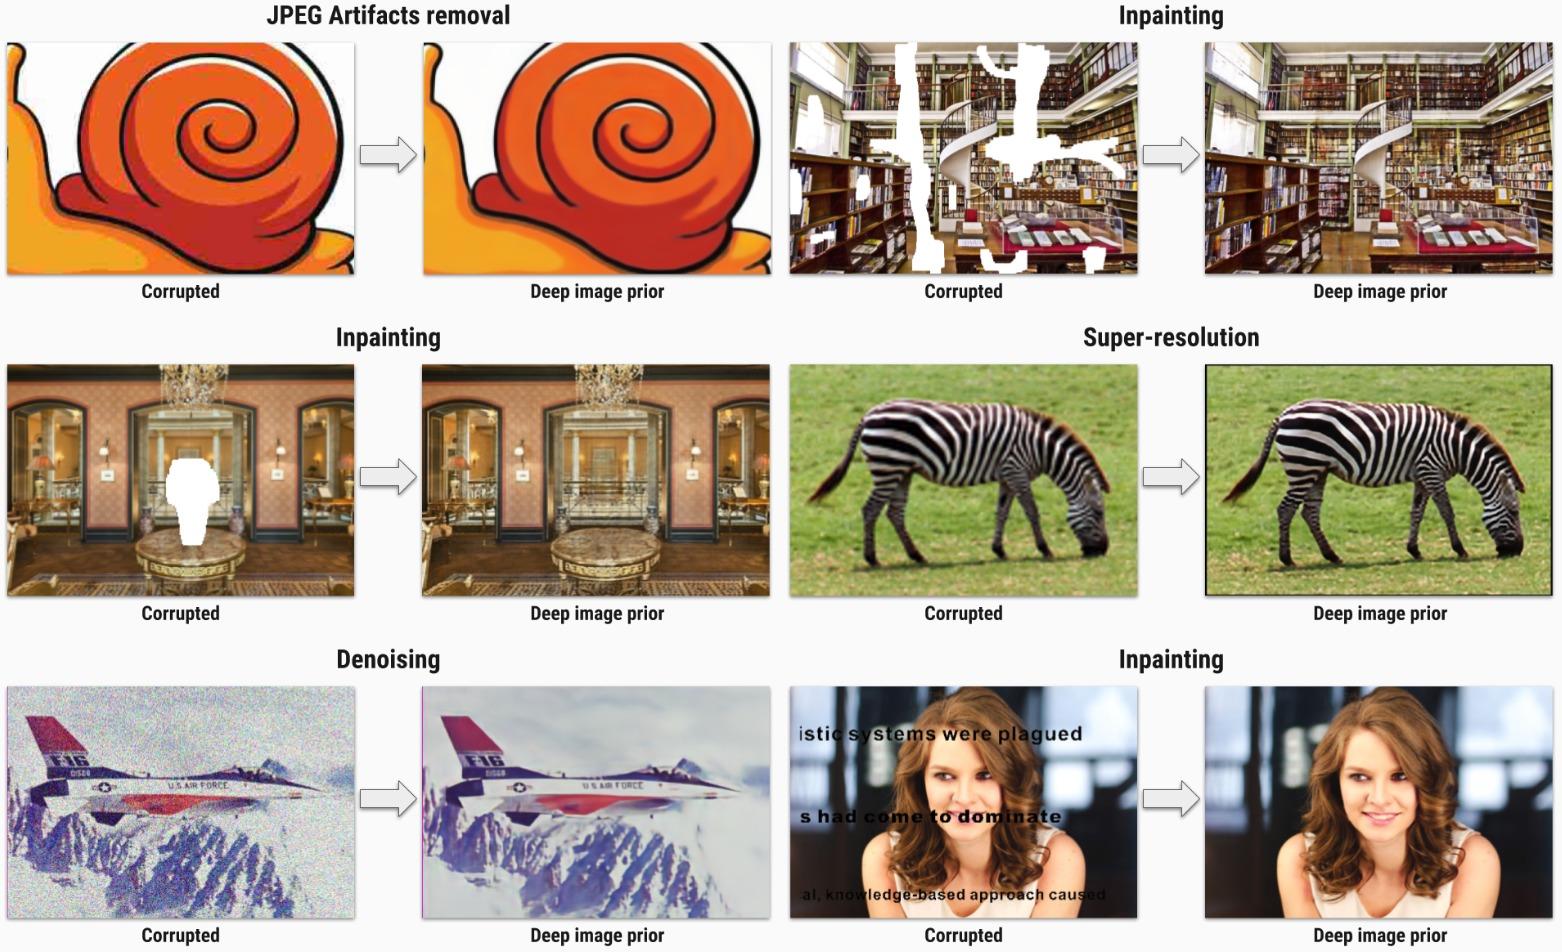
Ulyanov, Vedaldi और Lempitsky (2018) का Deep Image Prior प्रत्यक्षीकरण के विरुद्ध परिणाम देता है। एक यादृच्छिक रूप से शुरू किए गए अप्रशिक्षित कन्वोलूशनल नेटवर्क को केवल एक बिगड़ी हुई एकल छवि पर फिट करने से शोर में कमी, सुपर-रिजोल्यूशन, inpainting संभव बनता है। कन्वोलूशनल नेटवर्क की संरचना प्राकृतिक छवियों के निम्न आवृत्ति में स्व-समरूप सांख्यिकी के लिए पसंदीदा है, और शोर की फिटिंग धीमी है, इसलिए जल्दी बंद करने से एक स्वच्छ छवि मिलती है। यह "पूर्वइतिहास" में चर्चा की गई प्राकृतिक छवि सांख्यिकी से सीधे जुड़ा हुआ है। नेटवर्क की संरचना "प्राकृतिक छवियां कुछ आधार के तहत विरल हैं" के पूर्व वितरण को अंतर्निहित रूप से एनकोड करती है, अंतर का केवल यह है कि वह आधार अब स्पष्ट रूप से लिखा नहीं गया है। DIP के बाद, "संरचना ही पूर्व वितरण है" तंत्रिका नेटवर्क के आगमन पूर्वाग्रह को समझने के लिए एक महत्वपूर्ण लेंस बन गया है, और शास्त्रीय विरल सिद्धांत के लिए एक पुल। DIP को स्पष्ट और सीखने योग्य "फ्रेम" द्वारा एक ही काम को अनुकूल रूप से करने की विधि के रूप में देखा जा सकता है, जो सिग्नल की संरचना को वास्तव में व्यक्त करने वाले घटकों को रखता है।
सीखा गया शब्दकोश और संरचित फ्रेम
निश्चित wavelet, K-SVD द्वारा सीखा गया गैर-संरचित शब्दकोश, गहन नेटवर्क द्वारा सीखा गया अंतर्निहित पूर्व वितरण के बीच एक मध्यवर्ती रास्ता है। कसे फ्रेम या एकात्मक परिवर्तन की गणितीय संरचना (पूर्ण पुनर्निर्माण, ऊर्जा संरक्षण) को संरक्षित रखते हुए, उनके मापदंडों को डेटा से सीखना। गैर-वियोज्य दिशात्मक रूप से सममित ओवरलैप परिवर्तन (NSOLT) और जाली संरचना एकात्मक नेटवर्क (LSUN) इस श्रेणी से संबंधित हैं। परिवर्तन को कसे फ्रेम के कई गुणा पर प्रतिबंधित करके, और जाली संरचना के साथ पैरामीटर निर्धारण करके, शास्त्रीय परिवर्तन की व्याख्यात्मकता और प्रतिवर्तनीयता को बनाए रखते हुए विशिष्ट डेटा के अनुकूलता प्राप्त करते हैं। बड़े मॉडल के समय इस मार्ग का मूल्य फिर से खोजा जा रहा है। SAE को अधिक पूर्ण शब्दकोश की आवश्यकता है, MLA को प्रतिवर्ती निम्न-रैंक प्रक्षेपण की आवश्यकता है। दोनों संरचनात्मक बाधा और डेटा अनुकूलता का संतुलन खोज रहे हैं, और यह बिल्कुल वही डिजाइन समस्या है जिसका संरचित फ्रेम हमेशा सामना कर रहे हैं।
बड़े मॉडल के साथ 3 संपर्क बिंदु
पहला, SAE विरल कोडिंग ही है। Anthropic का विरल ऑटोएनकोडर गणितीय रूप से Olshausen–Field शब्दकोश सीखने के समान है, केवल डेटा बदल गया है। छवि पैच से अवशिष्ट धारा का सक्रियकरण तक। दूसरा, एल्गोरिदम प्रसार "नेटवर्क = सॉल्वर" पढ़ने की पूर्वानुमान लगाया गया था। Anthropic का ट्रांसकोडर और एट्रिब्यूशन ग्राफ मूलत: Transformer के लिए विरल और पठनीय विकल्प गणना ग्राफ की खोज है। तीसरा, संरचित पूर्व वितरण का विचार आर्किटेक्चर डिजाइन में प्रवेश कर गया। MoE विशेषज्ञ ब्लॉक, CSA2 का क्रॉस-लेयर पुन: उपयोग, Engram की लुकअप तालिका सभी "डेटा को इस संरचना रखनी चाहिए" में विश्वास को, हानि फ़ंक्शन के बजाय नेटवर्क रूप में लिखते हैं। यह "एकीकृत सिद्धांत" खंड के निष्कर्ष की, छवि प्रसंस्करण की दुनिया में पत्राचार है। विरलता नियमितीकरण शब्द से आर्किटेक्चर बाधा में चली गई है।
आवेदन: विरलता ने वास्तव में मूल्य कहां दिया
विरलता वहां मूल्य देती है जहां प्रसंस्करण करने योग्य चीज विशाल है, और वास्तव में महत्वपूर्ण चीज बहुत कम है। लंबे दस्तावेज की समीक्षा इसका सबसे विशिष्ट उदाहरण है।
क्लाउड में LLM अनुमान।2026 में कम लागत वाली फ्रंटियर API का लगभग सभी अत्यधिक विरल MoE मॉडल से आता है। DeepSeek-V3 4.1-Flash की ऑफ-पीक आउटपुट $0.60/M है, gpt-oss-120b OpenRouter पर इनपुट लगभग $0.03/M और आउटपुट लगभग $0.17/M है।
लंबा संदर्भ और एजेंट।V4.1 की घोषणा में DeepSeek ने कहा कि एजेंट की अधिकांश लागत अक्सर कैश हिट बिलिंग से आती है, और कैश संपीड़न इस हिस्से को काफी हद तक कम कर सकता है। कैश किए गए इनपुट की कीमत ($0.006/M) कैश मिस कीमत ($0.30/M) का 1/50 है, और यह एजेंट अर्थशास्त्र में केंद्रीय लीवर है।
एज।Apple का LLM in a Flash (2023) विरल रूप से सक्रिय किए गए पैरामीटर को फ्लैश स्टोरेज से ऑन-डिमांड पढ़ता है। Gemma 3n MatFormer के नेस्टेड सबमॉडल और प्रति-परत एम्बेडिंग (PLE) का उपयोग करता है। Qwen3.5-35B-A3B जैसे 3B सक्रियता MoE मॉडल ब्राउज़र और एज के लिए उम्मीदवार बन गए हैं।
मल्टीमॉडल।V4.1 छवि टोकन को समर्पित रूटिंग पूर्वाग्रह देता है। विज़ुअल टोकन संख्या में बड़े और अत्यधिक अनावश्यक हैं, इसलिए विरल ध्यान के लिए आदर्श लक्ष्य हैं।
विज्ञान और चिकित्सा।CS-MRI ने दैनिक नैदानिक स्कैन समय को लगभग 20% और एकल अनुक्रम में 23%-43% कम कर दिया है। EHT ब्लैक होल इमेजिंग का समर्थन करने वाली SMILI पाइपलाइन विरल मॉडलिंग पर निर्मित है।
लंबे दस्तावेज़ और ड्राइंग की एंटरप्राइज समीक्षा (हमारे व्यवसाय से सीधे संबंधित)
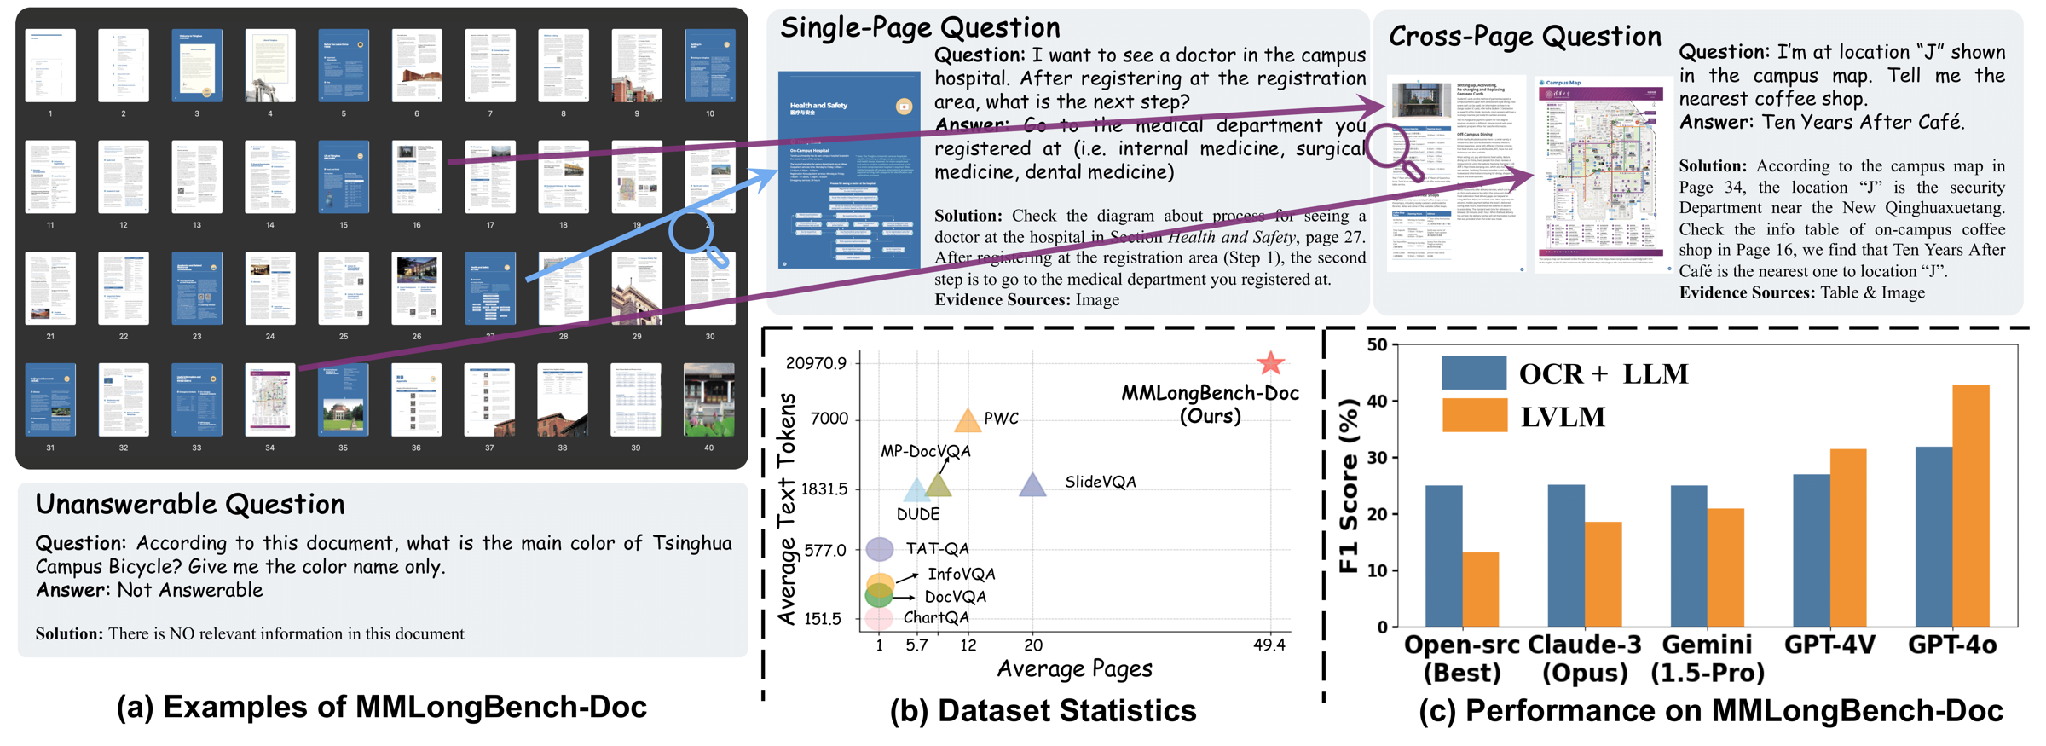
कठिनाई के लिए बेंचमार्क मानदंड।MMLongBench-Doc (NeurIPS 2024 D&B) ने औसतन 47.5 पृष्ठ और लगभग 21,000 टोकन पाठ वाले 135 PDF एकत्र किए हैं, विशेषज्ञों द्वारा लिखे गए 1,082 प्रश्न दर्ज हैं। इनमें से 33.2% को पृष्ठ-व्यापी साक्ष्य की आवश्यकता है, और 22.8% को हॉलुसिनेशन का पता लगाने के लिए बिना उत्तर देने योग्य बनाया गया है। मानव एनोटेटर का F1 66.0% है, और 14 विज़ुअल भाषा मॉडलों में से 12 OCR पाठ को संबंधित पाठ-केवल मॉडल को देने से बदतर प्रदर्शन करते हैं। LongDocURL में 396 दस्तावेज़ औसतन 86 पृष्ठ हैं, और 52.9% प्रश्न पृष्ठ-व्यापी हैं। इन दस्तावेज़ों की लंबाई और पृष्ठ और तत्वों को फैलाने वाले प्रश्नों का अनुपात निर्माण अनुमोदन आवेदनों (दसियों पृष्ठ से 100 पृष्ठ से बहुत अधिक ड्राइंग, संरचनात्मक गणना, और आवेदन दस्तावेज़) से मिलता-जुलता है।
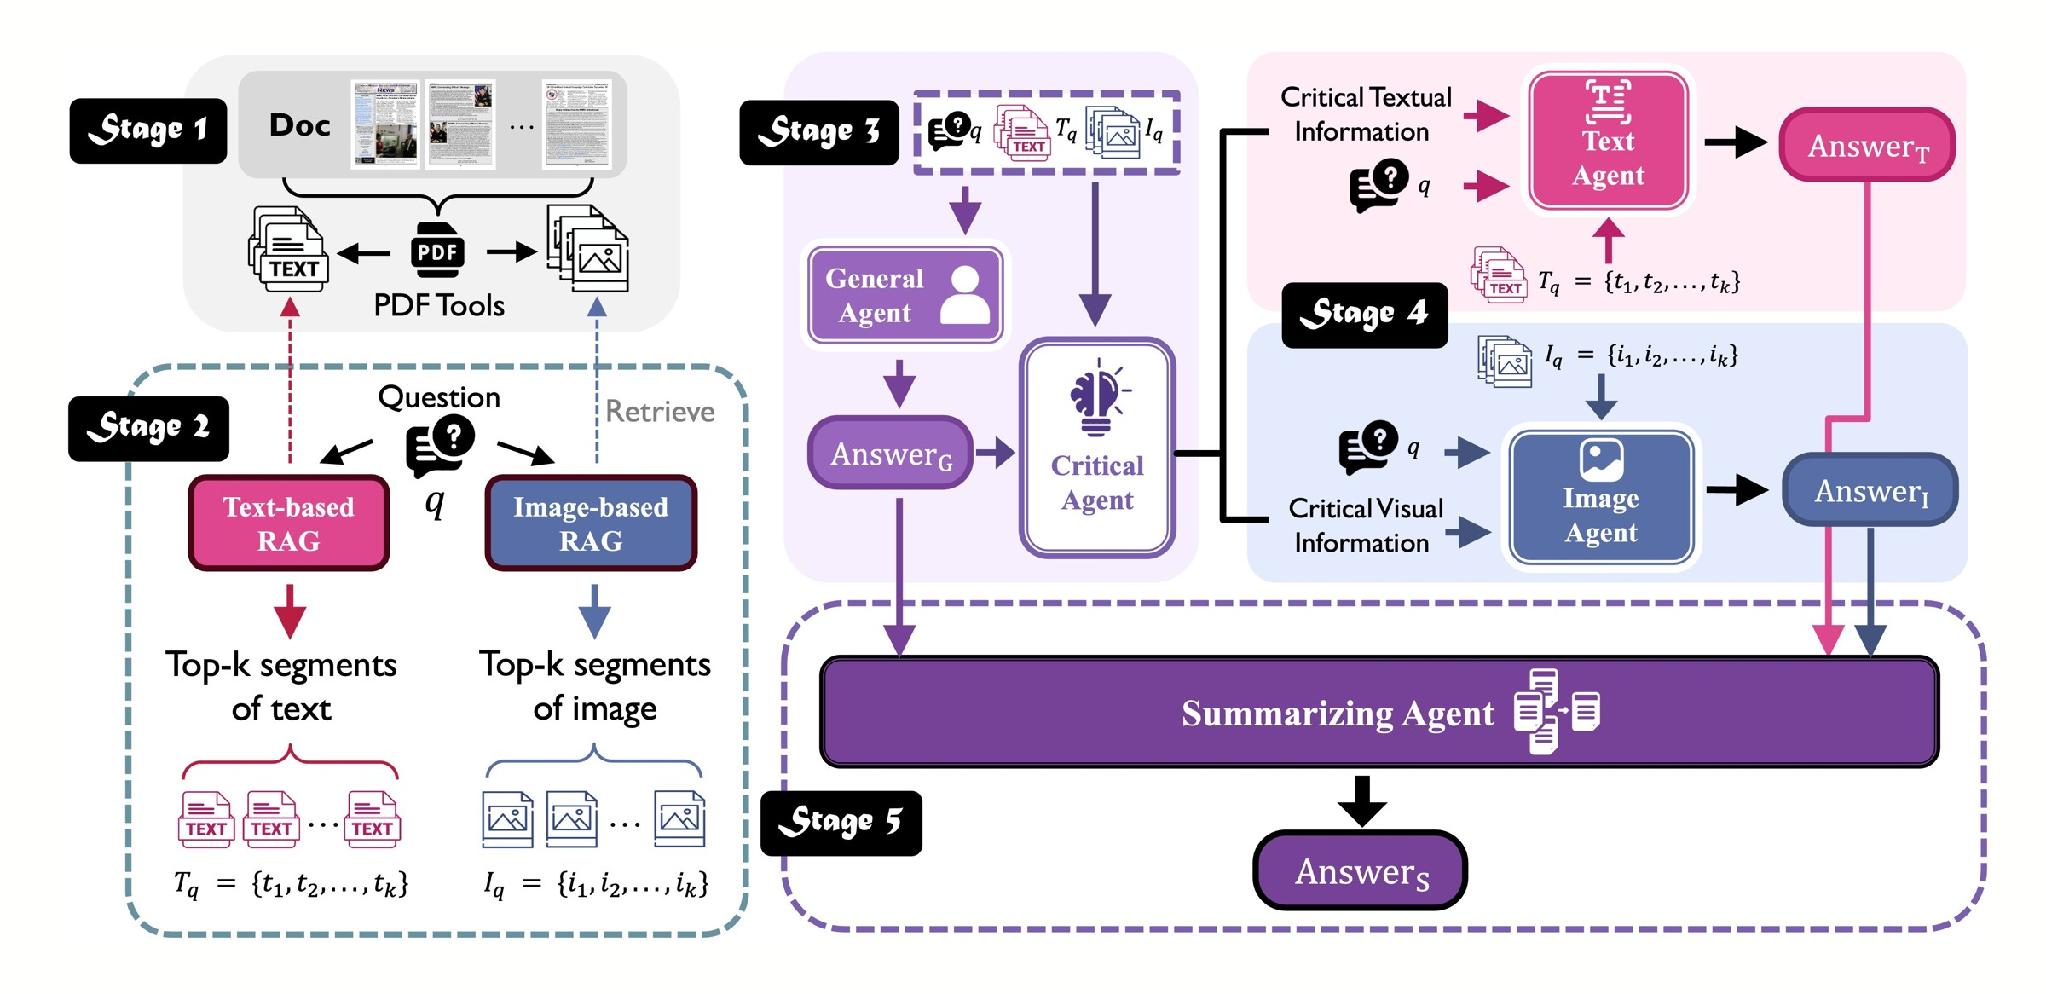
बाधा केवल संदर्भ लंबाई नहीं है। बिखरे हुए साक्ष्य से सही top-K चुनना है।खोज (top-K पृष्ठों का चयन) और विरल ध्यान (top-K टोकन ब्लॉक का चयन) गणितीय रूप से एक ही ऑपरेटर हैं। अंतर यह है कि क्या वह चयन मॉडल के बाहर होता है (ऑडिट करने योग्य, वर्गों को उद्धृत कर सकते हैं) या अंदर (एंड-टू-एंड लेकिन अपारदर्शी)।
सीमाएं।Sparse Frontier दिखाता है कि विरल ध्यान मध्यम विरलता दर में भी व्यक्तिगत कार्य प्रदर्शन को कम कर सकता है। समीक्षा कार्य में "धारा X 37 वें पृष्ठ पर बताए गए आयाम से विरोधाभास रखती है" ठीक एक "एक को भी याद करने से पूरा उत्तर गलत हो जाता है" कार्य है। इसलिए, केवल एक पर दांव लगाने के बजाय, खोज और लंबे संदर्भ में पुः-सत्यापन का एक हाइब्रिड अधिक सुरक्षित है। SimpleDoc, MDocAgent, और LAD-RAG सहित 2025 के बहु-पृष्ठ दस्तावेज़ अनुसंधान भी इस रास्ते पर जा रहे हैं।
लाभ और लागत
वजन विरलता के लिए, LLM युग में "विरलता को अत्यधिक मूल्यांकित किया गया है" मोटे तौर पर सही है। शर्तीय गणना और ध्यान विरलता के लिए विपरीत सत्य है, दोनों ही पहले से ही फ्रंटियर के डिफ़ॉल्ट हैं।इन दोनों को अलग करके सोचना पूरी चर्चा को समझने की कुंजी है।
लाभ
लागत: सक्रियता दर 1.5%-4.5% तक गिर गई है, और कीमत वक्र तेजी से नीचे जा रहा है।
क्षमता और गणना का पृथक्करण: कुल पैरामीटर ज्ञान की क्षमता निर्धारित करता है, सक्रिय पैरामीटर प्रति-टोकन लागत निर्धारित करता है, और दोनों स्वतंत्र रूप से स्केल कर सकते हैं। Engram और भी आगे जाता है, स्थिर ज्ञान को सस्ती होस्ट मेमोरी में स्थानांतरित करता है।
लंबे संदर्भ का व्यावहारिक अनुप्रयोग: V4.1 की डिकोड FLOPs 4K से 1M के बीच केवल लगभग एक चौथाई बढ़ता है।
व्याख्यात्मकता के लिए उपकरण: SAE और ट्रांसकोडर अज्ञात अवधारणाओं की खोज के लिए उपयोग किए जाते हैं।
लागत और जोखिम
स्मृति कुल पैरामीटर द्वारा निर्धारित होती है: V4.1 की रूटिंग विशेषज्ञ (MXFP4) लगभग 259.5 GiB, Engram तालिका लगभग 183 GiB पर कब्जा करती है। विरलता स्टोरेज बचाती नहीं है।
संचार ओवरहेड: विशेषज्ञ समानांतर all-to-all MoE सीखने की मुख्य बाधा है, और Engram को RDMA या CXL पर प्रीफेचिंग की आवश्यकता है।
सीखने की अस्थिरता और भार पूर्वाग्रह: z-loss, पूर्वाग्रह समायोजन, हैश रूटिंग जैसे कई पैच की आवश्यकता है।
फाइन-ट्यूनिंग मुश्किल है: छोटे डेटासेट पर रूटिंग आसानी से टूट जाती है। V4.1 की आधिकारिक फाइन-ट्यूनिंग प्रक्रिया एक एकल NVLink डोमेन के भीतर 64 GPUs की मांग करती है।
मूल्यांकन के नुकसान: Sparse Frontier का "लगभग सभी कॉन्फ़िगरेशन कम से कम एक कार्य में प्रदर्शन खोते हैं" निष्कर्ष। V4.1 विक्रेता बेंचमार्क पर फ्रंटियर के साथ-साथ है, लेकिन स्वतंत्र समग्र मेट्रिक्स पर लगभग 10 अंक पिछड़ा है।
SAE की सीमाएं: "व्याख्यात्मकता में विरलता" अनुभाग देखें।
वजन विरलता अभी भी दक्षता में हारी है: परंपरागत तरीके 50%-60% विरलता की दीवार को नहीं तोड़ सकते।
प्रतिनिधि विचार (स्रोतों से उद्धृत)
| स्थिति | स्रोत | विचार |
|---|---|---|
| समर्थन: विजेता हार्डवेयर द्वारा तय होते हैं | Hooker 2021 | विचार जीतते हैं क्योंकि "वे बेहतर हैं नहीं बल्कि वे उपलब्ध सॉफ़्टवेयर और हार्डवेयर के साथ फिट हैं" |
| समर्थन: विरलता के नए अक्ष | DeepSeek, Engram 2026 | "मुझे विश्वास है कि शर्तीय स्मृति अगली पीढ़ी के विरल मॉडल के लिए एक अनिवार्य मॉडलिंग आदिम बन जाएगी" |
| सावधान | Nawrot et al. 2026 | "विरल ध्यान चांदी की गोली नहीं है" |
| नकारात्मक | Google DeepMind 2025 | "मुझे नहीं लगता कि SAE व्याख्यात्मकता के लिए गेम चेंजर होंगे, और मुझे संदेह है कि यह क्षेत्र SAE में अत्यधिक निवेश कर रहा है" |
| मध्यवर्ती | arXiv:2506.23845 | SAE ज्ञात अवधारणाओं के साथ काम करने में कमजोर है लेकिन अज्ञात अवधारणाओं की खोज के लिए एक शक्तिशाली उपकरण है |
पाँच प्रकार की विरलता में से प्रत्येक के लिए निर्णय (सितंबर 2026)
"क्या विरलता को अत्यधिक मूल्यांकित किया गया है?" का कोई एकल उत्तर नहीं है। इस सवाल का जवाब प्रकार दर प्रकार देना चाहिए।
| विरलता का प्रकार | 2026 की स्थिति | निर्णय | मुख्य कारण |
|---|---|---|---|
| वजन विरलता (गैर-संरचित प्रूनिंग) | अनुसंधान सक्रिय है, औद्योगिक अपनाना न्यूनतम है | LLM युग में अत्यधिक मूल्यांकित। क्वांटाइजेशन जीता। | 50%-60% विरलता की दीवार। कुशल GPU कर्नेल की कमी। MXFP4 वास्तविक मानक है। |
| संरचित विरलता (2:4, ब्लॉक) | हार्डवेयर समर्थन है लेकिन एंड-टू-एंड स्पीडअप सीमित है | आंशिक रूप से महसूस किया गया। ब्लॉक विरलता MoE के रूप में जीती। | 2:4 वास्तविक परीक्षण में 2x तक शायद ही कभी पहुंचता है। MegaBlocks ब्लॉक विरल GEMM MoE का आधार बन गया। |
| सक्रियता विरलता (ReLU, top-k सक्रियता) | एज और अनुसंधान में ध्यान। क्लाउड में MoE द्वारा अवशोषित | संभावना को कम करके आंका गया। लेकिन मुख्य युद्ध का मैदान एज है। | Q-Sparse लगभग 40% विरलता दर पर घने मॉडल से मेल खाता है। TEAL और PowerInfer स्मृति-सीमित डिवाइस को लक्ष्य करते हैं। |
| शर्तीय गणना (MoE) | फ्रंटियर की डिफ़ॉल्ट आर्किटेक्चर | प्रतिष्ठा के अनुसार। और गहरा जा रहा है। | सक्रियता दर 2 वर्षों में 25% से 1.5%-4.5% तक गई। 2025-2026 के सभी फ्लैगशिप ओपन मॉडल ने अपनाया। |
| ध्यान विरलता | मूल रूप से प्रशिक्षण योग्य संस्करण उत्पादों में है | स्थापित। लेकिन कार्य-विशिष्ट प्रदर्शन हानि का जोखिम है। | NSA ने ACL Best Paper जीता। V4.1 शुरुआत से विरल प्रशिक्षित है। Sparse Frontier की "कम से कम एक कार्य पर हानि"। |
| (समानांतर वंश) निम्न-रैंक | MLA और LoRA व्यापक रूप से उपयोग किए जाते हैं | स्थापित। लेकिन विरलता से भ्रमित न हों। | अधिकतम लगभग 93% निम्न-रैंक KV संपीड़न (V2)। LoRA फाइन-ट्यूनिंग का मानक है। |
| (उपकरण) विरल शब्दकोश / SAE | चर्चा जारी है | खोज के उपकरण के रूप में स्थापित। डिटेक्टर और नियंत्रक के रूप में अत्यधिक मूल्यांकित। | GDM ने प्राथमिकता को कम किया। 113 डेटासेट पर रैखिक प्रोब से बदतर। Anthropic ट्रांसकोडर और प्रशंसा ग्राफ में स्थानांतरित हुआ। |
एक वाक्य में: विरलता "सक्रियता" और "ध्यान" में जीती, "वजन" में हारी। जीतना का कारण यह नहीं था कि सिद्धांत बेहतर था बल्कि यह कि शून्य की स्थिति में हार्डवेयर एक संरचना का उपयोग कर सकता था।
भविष्य (2026-2030)
विरलता का अगला अक्ष अब "कौन सी पैरामीटर गणना करें" नहीं है बल्कि "किस ज्ञान को संग्रहीत करें और कौन का इतिहास पढ़ें" है।नीचे अनुसंधान की फ्रंटियर, हार्डवेयर प्रवृत्तियां, और पाँच प्रतिबद्ध योग्य भविष्यवाणियां दी गई हैं।
अनुसंधान सीमांत
बहु-अक्षीय विरलता और बजट आवंटन। Engram पत्र द्वारा मिला गया U-आकार का नियम दिखाता है कि विशुद्ध MoE इष्टतम नहीं है, और विरलता बजट को "विशेषज्ञों" और "शर्तसापेक्ष मेमोरी" में विभाजित किया जाना चाहिए। 27B Engram मॉडल ने समान पैरामीटर गणना और समान FLOPs के MoE आधार रेखा के विरुद्ध MMLU +3.4, BBH +5.0, HumanEval +3.0 हासिल किए। तंत्र विश्लेषण के अनुसार, शर्तसापेक्ष मेमोरी प्रारंभिक परतों को स्थिर ज्ञान पुनर्संयोजन से मुक्त करती है।
मूल रूप से सीखने योग्य विरलता मानक बन जाती है। V4.1 सघन वार्मअप के बिना, शुरुआत से ही 64K पर विरल ध्यान सीखता है। यह दर्शाता है कि विरल ध्यान अनुमान-समय सन्निकटन से, प्रशिक्षण-समय प्रथम-श्रेणी नागरिक बन गया है।
विरलता × अनुमान-समय कम्प्यूटेशन। तर्क (reasoning) मॉडल लंबे आउटपुट उत्पन्न करते हैं, प्रीफिल और डीकोड दोनों भारी होते हैं। MoE ज्ञान क्षमता प्रदान करता है, लंबी विचार श्रृंखला तर्क की गहराई प्रदान करती है। CED का असममित सक्रियण विभिन्न पढ़ने-लिखने अनुपात वाले कार्यभार के लिए एक ट्रेडऑफ है।
मॉड्यूलारिटी और सतत शिक्षा। विशेषज्ञ और मेमोरी तालिकाएँ स्थानीय रूप से संपादन योग्य हैं। उदाहरण के लिए, ऐसे अनुसंधान हैं जो उपयोगकर्ता स्मृति को स्थानीय पैरामीटर संपादन के रूप में लिखते हैं (User as Engram, arXiv:2606.19172)।
विरलता और परिमाणीकरण का संयोजन। MXFP4 विशेषज्ञ, FP4 KV, FP8 Engram पहले से V4.1 और K3 में एक साथ उपयोग किए जा रहे हैं। Q-Sparse का निष्कर्ष यह है कि परिमाणीकरण जितना अधिक आक्रामक है, इष्टतम विरलता की डिग्री उतनी ही अधिक है।
हार्डवेयर सह-डिज़ाइन। Blackwell मूल रूप से FP4 का समर्थन करता है, और CXL मेमोरी पूल और SSD का उपयोग करके स्तरीय KV स्टोरेज प्रगति कर रहा है। LLM पैमाने पर न्यूरोमॉर्फिक कम्प्यूटिंग अभी भी दूर की संभावना है।
पाँच खंडनीय भविष्यवाणियाँ (तर्क के साथ)
| भविष्यवाणी | समय सीमा | तर्क |
|---|---|---|
| मुख्य ओपन मॉडल में से कम से कम एक में, वैश्विक KV प्रति टोकन 500 बाइट से नीचे गिरेगी | 2027 के अंत तक | V1 से V4.1 में 437वां भाग, V4 से V4.1 के केवल 1 पीढ़ी में एक चौथाई, FP4 पहले से उपयोग में है |
| ओपन मॉडल के शीर्ष 5 में से कम से कम 3 में, प्रति टोकन सक्रियण दर 3% से कम होगी | 2027 के अंत तक | 2026 तक पहले से ही V4.1 (2.9%), K3 (3.7%), Qwen3.5 (4.3%) है, और विशेषज्ञ संख्या हर पीढ़ी में दोगुनी हो रही है |
| DeepSeek के अलावा कम से कम 2 प्रमुख अनुसंधान संस्थान फ्लैगशिप ओपन मॉडल में लुकअप-टेबल-प्रकार की शर्तसापेक्ष मेमोरी तैनात करेंगे | 2028 | Engram में पहले से CXL, SSD, प्रशिक्षण-मुक्त व्युत्पन्न अनुसंधान है, और NeMo में भी मौजूद है |
| SAE आधिकारिक रूप से घोषित उत्पादन सुरक्षा निगरानी के प्रमुख तरीके के रूप में किसी भी सीमांत अनुसंधान संस्थान में मुख्य पद्धति नहीं बनेगी | 2028 | GDM की प्राथमिकता में कमी। डाउनस्ट्रीम कार्यों में नकारात्मक परिणाम |
| समान क्षमता स्तर की API इकाई कीमत प्रति वर्ष 10 गुना से अधिक की गति से गिरती रहेगी, लेकिन कार्य-प्रति-कार्य कॉर्पोरेट एजेंट व्यय बढ़ेगा | चल रहा है | Epoch मूल्य प्रवृत्ति। एजेंट कॉल गणना का दोगुनीकरण |
इसका हमारे लिए क्या मतलब है
समीक्षा अनिवार्य रूप से विशाल शर्तें और पृष्ठों के बीच से शीर्ष-K को चुनने का कार्य है, और विरलता प्रवृत्ति ठीक इसी प्रकार के कार्य की इकाई कीमत को दबा रही है। लंबे दस्तावेज़ और ड्राइंग समीक्षा एजेंट विकसित करने वाली कंपनियों के लिए, चार व्यावहारिक निहितार्थ हैं।
लागत वक्र। "कैश हिट दर" और "ऑफ-पीक बैच प्रोसेसिंग का अनुपात" को प्रथम-श्रेणी मेट्रिक्स के रूप में मानें। समीक्षा कार्य स्वाभाविक रूप से बैच-योग्य हैं और ऑफलाइन चलाए जा सकते हैं। स्थिर कानून और अध्यादेश प्रॉम्प्ट के शुरुआत में रखें, उपसर्ग कैश हिट को अधिकतम करें। V4.1 में कैश्ड इनपुट की कीमत कैश मिस का 1/50 है, और ऑफ-पीक आगे आधी है।
मॉडल चयन। "पृष्ठ-क्रॉस मिलान और शर्तापत्र उद्धरण" पर अपने स्वयं के मूल्यांकन सेट के साथ मॉडल का चयन करें, और औसत के बजाय सबसे कठिन उप-कार्य के स्कोर से निर्णय लें। कम विरल ओपन MoE को मुख्य कार्य-घोड़े के रूप में उपयोग करें, और कठिन मामलों की दोहरी जांच के लिए बंद सीमांत मॉडल का उपयोग करें।
लंबे संदर्भ रणनीति। "शीर्ष-K पृष्ठ खोज (ऑडिट योग्य और उद्धृत) + 1M संदर्भ में पुनः जांच (पृष्ठ-क्रॉस संबंध याद न करने के लिए)" का हाइब्रिड अपनाएँ। Sparse Frontier का निष्कर्ष सीधे यहाँ लागू होता है। केवल विरल ध्यान पर दांव लगाने से कुछ कार्यों में प्रदर्शन गिरता है, और समीक्षा बिल्कुल "एक को याद करें और पूरा उत्तर गलत हो" कार्य है।
स्व-होस्टिंग निर्णय। MoE मेमोरी कुल पैरामीटर से निर्धारित होती है। V4.1 की राउटिंग विशेषज्ञ और Engram तालिका 440 GiB से अधिक है, और आधिकारिक फाइन-ट्यूनिंग प्रक्रिया एकल NVLink डोमेन में 64 GPUs की आवश्यकता है। दर्जनों GPU से कम के पैमाने पर, यह पहले सस्ता नहीं पड़ता, इसलिए API चुनें।
अनुसंधान के अवसर। मौजूदा अनुसंधान "बजट के भीतर कौन से पृष्ठों की जांच करें" को खोज समस्या के रूप में मानता है। लेकिन पृष्ठ-क्रॉस सुसंगतता जांच में, जो वास्तव में विरल है वह "पृष्ठ" नहीं बल्कि "पृष्ठ जोड़ी" है। P पृष्ठों में P(P−1)/2 जोड़ी हैं, और आप उनमें से क्रॉस-चेक करने के लिए k जोड़ी चुनते हैं। यह बहु-एजेंट सिस्टम के विरल सहयोग ग्राफ के साथ सीधे संवाद करता है, और सभी (क्वेरी, कुंजी) जोड़ी को हल्के-फुल्के इंडेक्सर के साथ स्कोर करके शीर्ष k को लेना DSA विचार के समान है। यह वह दिशा है जिसमें हम अलग कर सकते हैं और तोड़ सकते हैं।
परिशिष्ट
A. कालक्रम (1948–2026 सितंबर)
| वर्ष | घटना | विश्वसनीयता |
|---|---|---|
| 1948 | Shannon, A Mathematical Theory of Communication: अतिरिक्तता और एंट्रॉपी का औपचारिकीकरण | प्राथमिक पत्र |
| 1961 | Barlow की अतिरिक्तता कमी परिकल्पना | प्राथमिक पत्र |
| 1967 | Tinney & Walker विरल मैट्रिक्स अनुक्रमण (विद्युत नेटवर्क गणना) | प्राथमिक पत्र |
| 1978 | Rissanen की न्यूनतम विवरण लंबाई (MDL) | प्राथमिक पत्र |
| 1987 | Field: प्राकृतिक छवि आंकड़े और प्रांतस्थ ग्रहणशील क्षेत्र | प्राथमिक पत्र |
| 1988–89 | Daubechies की कॉम्पैक्ट-समर्थित ऑर्थोगोनल वेवलेट। Mallat का बहु-संकल्प विश्लेषण | प्राथमिक पत्र |
| 1990–93 | OBD / OBS द्वारा प्रूनिंग। Matching Pursuit | प्राथमिक पत्र |
| 1991 | Jacobs–Jordan–Nowlan–Hinton का स्थानीय विशेषज्ञ मिश्रण | प्राथमिक पत्र |
| 1992 / 2000 | JPEG / JPEG2000 | मानक |
| 1994–96 | वेवलेट थ्रेसहोल्ड शोर निवारण। Breiman का garrote। LASSO। Olshausen & Field की विरल कोडिंग | प्राथमिक पत्र |
| 1998 | Basis Pursuit। DeVore का अरैखिक सन्निकटन | प्राथमिक पत्र |
| 2001–03 | Attwell & Laughlin ऊर्जा बजट। Lennie की "संभवतः 1% से कम" | प्राथमिक पत्र (सत्यापित) |
| 2004–05 | LARS。Elastic Net | प्राथमिक पत्र |
| 2006–07 | संपीड़न संवेदन। K-SVD। Lustig की CS-MRI | प्राथमिक पत्र |
| 2009 | Donoho–Tanner चरण संक्रमण | प्राथमिक पत्र |
| 2011 | Glorot का ReLU (50–85% कठोर शून्य)। Robust PCA | प्राथमिक पत्र (सत्यापित) |
| 2012 | Google की बिल्ली का चेहरा न्यूरॉन | प्राथमिक पत्र (सत्यापित) |
| 2013–14 | Bengio की शर्तसापेक्ष गणना और STE। Gavish–Donoho का इष्टतम कठोर थ्रेसहोल्ड | प्राथमिक पत्र |
| 2016 | Deep Compression | प्राथमिक पत्र |
| 2017 | Shazeer की विरल गेट MoE (137B MoE परत) | प्राथमिक पत्र (सत्यापित) |
| 2019 | लॉटरी परिकल्पना। EHT M87*। Sartoretti की CS-MRI क्लीनिकल अध्ययन | प्राथमिक पत्र |
| 2020 | GShard। Hooker की Hardware Lottery। Ampere का 2:4 | प्राथमिक पत्र |
| 2021–22 | Switch Transformer। GLaM। ST-MoE। Expert Choice। Clark की MoE स्केलिंग | प्राथमिक पत्र |
| 2023 | Mixtral。SparseGPT / Wanda。StreamingLLM / H2O。Towards Monosemanticity | प्राथमिक पत्र |
| 2024 जनवरी–फरवरी | DeepSeekMoE। Gemini 1.5 आधिकारिक रूप से MoE की पुष्टि करता है | तकनीकी रिपोर्ट |
| 2024 मई | DeepSeek-V2 (MLA)。Scaling Monosemanticity。Golden Gate Claude | तकनीकी रिपोर्ट |
| 2024 जून–जुलाई | Gao की TopK SAE। Q-Sparse | प्राथमिक पत्र (सत्यापित) |
| 2024 दिसंबर | DeepSeek-V3 (671B/37B) | तकनीकी रिपोर्ट |
| 2025 27 जनवरी | DeepSeek शॉक: Nvidia बाजार पूंजीकरण एक दिन में लगभग $589 बिलियन गिरती है | विश्वसनीय समाचार |
| 2025 फरवरी–मार्च | NSA, MoBA। तर्क प्रणाली सैद्धांतिक लाभ मार्जिन 545%। GDM SAE की प्राथमिकता कम करता है | प्राथमिक पत्र / आधिकारिक |
| 2025 अप्रैल | Qwen3 MoE। Sparse Frontier प्रीप्रिंट। Llama 4 | आधिकारिक / प्राथमिक पत्र |
| 2025 जुलाई–अगस्त | NSA ACL सर्वश्रेष्ठ पत्र पुरस्कार जीतता है। Kimi K2। gpt-oss | आधिकारिक |
| 2025 सितंबर–दिसंबर | DeepSeek-V3.2、DSA | तकनीकी रिपोर्ट |
| 2026 जनवरी | Engram: शर्तसापेक्ष मेमोरी और विरलता बजट आवंटन का U-आकार | प्राथमिक पत्र |
| 2026 फरवरी | Qwen3.5-397B-A17B | आधिकारिक मॉडल कार्ड |
| 2026 24 अप्रैल | DeepSeek-V4 (Pro 1.6T/49B、Flash 284B/13B) | तकनीकी रिपोर्ट |
| 2026 जुलाई | Kimi K3 (2.8T/104B)। Sparse Frontier ACL 2026 के निष्कर्षों में प्रकाशित | आधिकारिक |
| 2026 10 सितंबर | DeepSeek-V4.1-Flash (CED, CSA2, 890 B/टोकन, Engram) | आधिकारिक + तकनीकी रिपोर्ट (सत्यापित) |
B. ग्राफ़िक डेटा श्रृंखला
DeepSeek की वैश्विक KV कैश (प्रति टोकन): V1 ≈ 389 KB (अनुमानित) → V3.2 ≈ 48 KB → V4-Flash ≈ 3.5 KB → V4.1-Flash 890 B। लॉगरिदमिक पैमाना।
प्रति टोकन सक्रियण दर: Mixtral 28% → Qwen3 9.4% → gpt-oss 4.4% → Qwen3.5 4.3% → Kimi K3 3.7% → V4.1 डीकोड 2.9% / प्रीफिल 1.4%।
विशेषज्ञ संख्या (चयनित / कुल):2/8 → 4/128 → 8/256 → 6/384 → 10/512 → 16/896।
DeepSeek API मूल्य ($/M, इनपुट / आउटपुट):V4-Flash 0.14 / 0.28। V4-Pro 1.74 / 3.48(अगस्त के बाद की पीक आउटपुट 3.96)। V4.1-Flash पीक 0.30 / 1.20, ऑफ-पीक 0.15 / 0.60, कैश 0.006।
Sparse Frontier:प्रीफिल का इष्टतम विरल दर 0.80〜0.93। डिकोड 0.95 पर भी व्यावहारिक उपयोग में सहन करता है। चौराहा 32〜64K है।
Glorot 2011 विरलता दर:MNIST 83.4%, CIFAR10 72.0%, NISTP 68.0%, NORB 73.8%।
Q-Sparse:इष्टतम विरलता दर 45.58%(पूर्ण सटीकता) / 61.25%(1.58 बिट)। 40% के आसपास घने मॉडल के बराबर।
Engram-27B का MoE आधारभूत अंतर:MMLU +3.4, CMMLU +4.0, BBH +5.0, ARC-C +3.7, HumanEval +3.0, MATH +2.4।
CS-MRI:स्कैन समय−20.2%, परीक्षा समय−16%, एकल अनुक्रम−23%〜−43%, परीक्षा मात्रा+27%।
GPU की कंप्यूटिंग शक्ति और बैंडविड्थ: "न्यूरल नेटवर्क युग" के GPU तालिका को देखें।
C. किस्से और कहानी सामग्री
कैसे "लेनी का 1%" "1〜4%" बन गया:गलतफहमी को सुधारने के परिचय के रूप में उपयोग किया जा सकता है।
बिल्ली का चेहरा न्यूरॉन (2012):1,000 मशीनें 3 दिन ले गईं, YouTube फ्रेम से स्वतंत्र रूप से "बिल्ली" सीखने की कहानी।
Outrageously (2017):LSTM युग की 137B MoE परत ने 2026 के दृश्य की भविष्यवाणी की थी। Hinton और Dean का सह-लेखन "1991 के पुरानी विचार × Google की कम्प्यूटेशनल संसाधन" का प्रतीक है।
DeepSeek शॉक (25 जनवरी, 2025) और 545% के साथ संलग्न "सैद्धांतिक" शब्द।
Golden Gate Claude (2024) और GDM की अचानक ब्रेकिंग (मार्च 2025)।
CS-MRI:रोगी स्कैनर टेबल पर लेटे रहने का समय 20% कम हो गया, और अस्पताल 27% अधिक परीक्षा कर सकता है की कहानी।
437 में 1:प्रति टोकन "मेमोरी" लगभग 389 KB से 890 बाइट तक सिकुड़ने की कहानी।
N-ग्राम की वापसी:इतिहास के अंधकार में दफन सांख्यिकीय भाषा मॉडल Engram के रूप में सीमावर्ती क्षेत्र में वापस आ गया की कहानी।
D. सामान्य गलतफहमी और उनका सुधार
| आम अभिव्यक्ति | सटीक विवरण |
|---|---|
| मस्तिष्क केवल 1〜4% न्यूरॉन का उपयोग करता है | Lennie 2003 की वास्तविक लिखावट "शायद 1% से कम" है ऊर्जा-आधारित ऊपरी सीमा का अनुमान। 1〜4% Glorot 2011 के माध्यम से पोती-दौहित्र संदर्भ है |
| ReLU नेटवर्क 90% विरल है | Glorot 2011:आरंभीकरण पर लगभग 50%, सीखने के बाद 50%〜85% |
| GPT-4 16 विशेषज्ञ का 1.8T MoE है | OpenAI ने कभी 2023 की अफवाह की पुष्टि नहीं की। GPT-5.x और Claude की संरचना भी समान रूप से गोपनीय है |
| CS-MRI स्कैन को 30〜60% तेज करता है | Sartoretti 2019:औसत स्कैन समय−20.2%, एकल अनुक्रम−23%〜−43% |
| Shazeer 2017:"1000 बार से अधिक" | मूल पाठ "greater than 1000x(1000x से अधिक)" है। 137B MoE परत पैरामीटर संख्या है |
| Sparse Frontier को ICML 2025 में प्रस्तुत किया गया | आधिकारिक रूप से ACL 2026 की निष्कर्ष में प्रकाशित |
| DeepSeek का लाभ मार्जिन 545% है | स्व-घोषित सैद्धांतिक लागत लाभ मार्जिन। वास्तव में बहुत कम है, अनुसंधान और विकास लागत और प्रशिक्षण लागत को बाहर रखते हुए |
| MLA विरल ध्यान है | MLA निम्न-रैंक संपीड़न है। वास्तव में विरल DSA / CSA2 है |
| विरल ध्यान असीमित संपीड़न कर सकता है | लगभग सभी कॉन्फ़िगरेशन कम से कम एक कार्य पर बड़े प्रदर्शन हानि करते हैं |
E. संदर्भ
शास्त्रीय नींव:Shannon 1948; Barlow 1961; Tinney & Walker 1967; Rissanen 1978; Field 1987; Mallat 1989; LeCun, Denker & Solla 1990; Jacobs, Jordan, Nowlan & Hinton 1991; Mallat & Zhang 1993; Donoho & Johnstone 1994 (Biometrika); Breiman 1995; Tibshirani 1996 (JRSS-B); Olshausen & Field 1996 (Nature); Chen, Donoho & Saunders 1998; DeVore 1998; Attwell & Laughlin 2001; Lennie 2003 (Curr. Biol.); Efron et al. 2004; Zou & Hastie 2005; Candès, Romberg & Tao 2006; Donoho 2006; Aharon, Elad & Bruckstein 2006; Lustig, Donoho & Pauly 2007; Lee, Battle, Raina & Ng 2007; Donoho & Tanner 2009; Glorot, Bordes & Bengio 2011; Candès, Li, Ma & Wright 2011; Le et al. 2012; Bengio et al. 2013; Gavish & Donoho 2014; Han, Mao & Dally 2016; Shazeer et al. 2017; Frankle & Carbin 2019; Sartoretti et al. 2019; Vranic et al. 2019; Hooker 2021 (CACM); Fedus, Zoph & Shazeer 2021; Clark et al. 2022.
2023〜2026:Frantar & Alistarh 2023 (SparseGPT); Sun et al. 2023 (Wanda); Xiao et al. 2023 (StreamingLLM); Bricken et al. 2023; Jiang et al. 2024 (Mixtral); Dai et al. 2024 (DeepSeekMoE); DeepSeek-AI 2024 (V2, V3); Templeton et al. 2024; Gao et al. 2024; Wang et al. 2024 (Q-Sparse); Krajewski et al. 2024; Yuan et al. 2025 (NSA); Nawrot et al. 2025/2026 (Sparse Frontier); Kantamneni et al. 2025; OpenAI 2025 (gpt-oss); Google DeepMind 2025 (Gemini 2.5 तकनीकी रिपोर्ट, arXiv:2507.06261); Moonshot 2025/2026 (Kimi K2, K3); Alibaba 2026 (Qwen3.5); Cheng et al. 2026 (Engram, arXiv:2601.07372); DeepSeek-AI 2026 (V4, arXiv:2606.19348); DeepSeek-AI 2026 (V4.1-Flash, arXiv:2609.19969); Ma et al. 2024 (MMLongBench-Doc).
पाठ्यपुस्तक और सर्वेक्षण:Elad, Sparse and Redundant Representations (2010); Hastie, Tibshirani & Wainwright, Statistical Learning with Sparsity (2015); Mallat, A Wavelet Tour of Signal Processing (3rd ed.); Foucart & Rauhut, A Mathematical Introduction to Compressive Sensing (2013); Hoefler et al. 2021, Sparsity in Deep Learning; Cai et al. 2024, A Survey on Mixture of Experts.
पढ़ा हुआ
इसके बाद पढ़ें ↓