Research
스파스 모델: 기원, 중요한 이유, 그리고 LLM의 최전선과 미래
Product
Career
일본어 원문으로부터의 자동 번역입니다
Overview
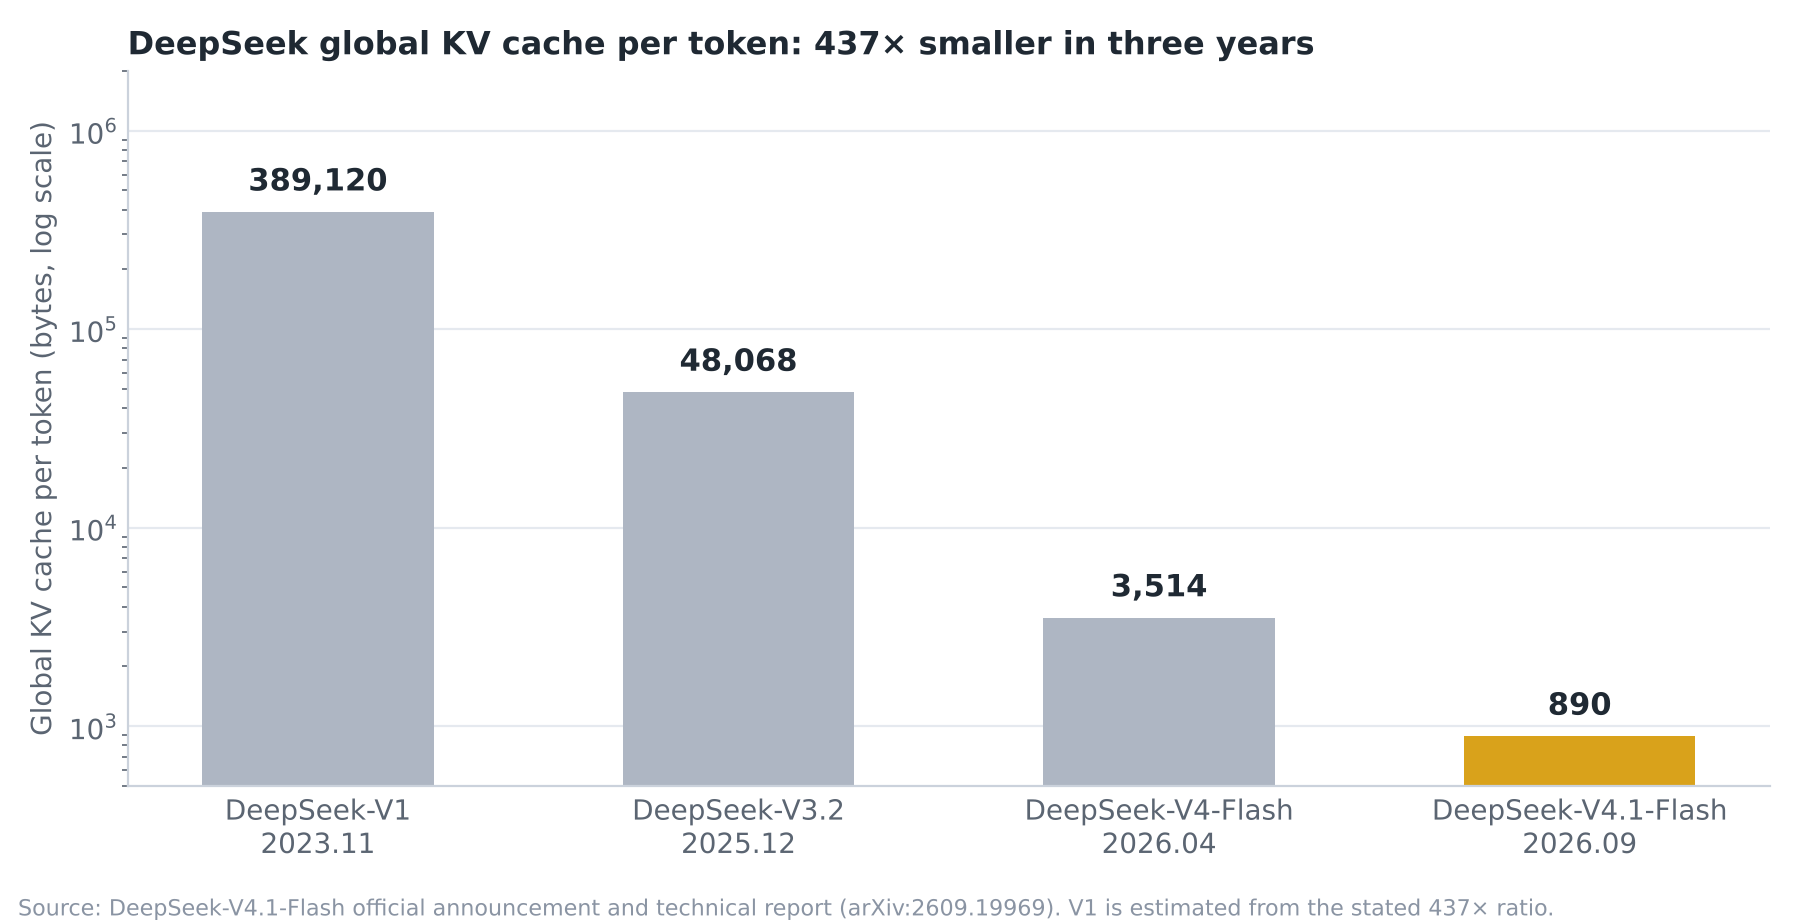
2026년 현재, 스파ース성(sparsity)은 더 이상 "있어도 되고 없어도 되는 효율화 기법"이 아닙니다. 프론티어급 대규모 모델에서의 표준 아키텍처 제약이며, 대규모 모델의 운영 비용과 장문서를 다루는 에이전트의 독해 정확도를 모두 결정하는 요인이 되었습니다. 가장 직접적인 증거는 2026년 9월 10일에 공개된 DeepSeek-V4.1-Flash입니다. 백본은 552B 파라미터를 가지고 있지만, 1토큰당 활성화되는 것은 프리필 시 8B, 디코드 시 16B에 불과하며, GPU 메모리에 상주하는 글로벌 KV 캐시는 1토큰당 890바이트로, DeepSeek-V1의 1/437로까지 압축되었습니다(DeepSeek 공식 발표, 기술 보고서 arXiv:2609.19969).
3가지 핵심 요점
스파ース성의 계보는 연속적입니다. Barlow나 Olshausen–Field의 "뇌의 스파ース 부호화"에서 시작하여, 웨이블릿·LASSO·압축 센싱이라는 "계산 가능한 스파ース성"을 거쳐, MoE·스파스 어텐션·조건부 메모리라는 "아키텍처로서의 스파ース성"으로 진화했습니다. 그 근저에는 항상 동일한 사전분포(prior)가 있습니다. 즉, "정말 중요한 성분은 극히 일부뿐"이라는 것입니다. 성공한 3가지 계보에 공통되는 점은 스파스의 패턴이 하드웨어와 잘 맞았다는 것입니다. 비구조적 가중치 프루닝이 실패한 것은 이론 때문이 아니라 하드웨어 때문이었습니다.
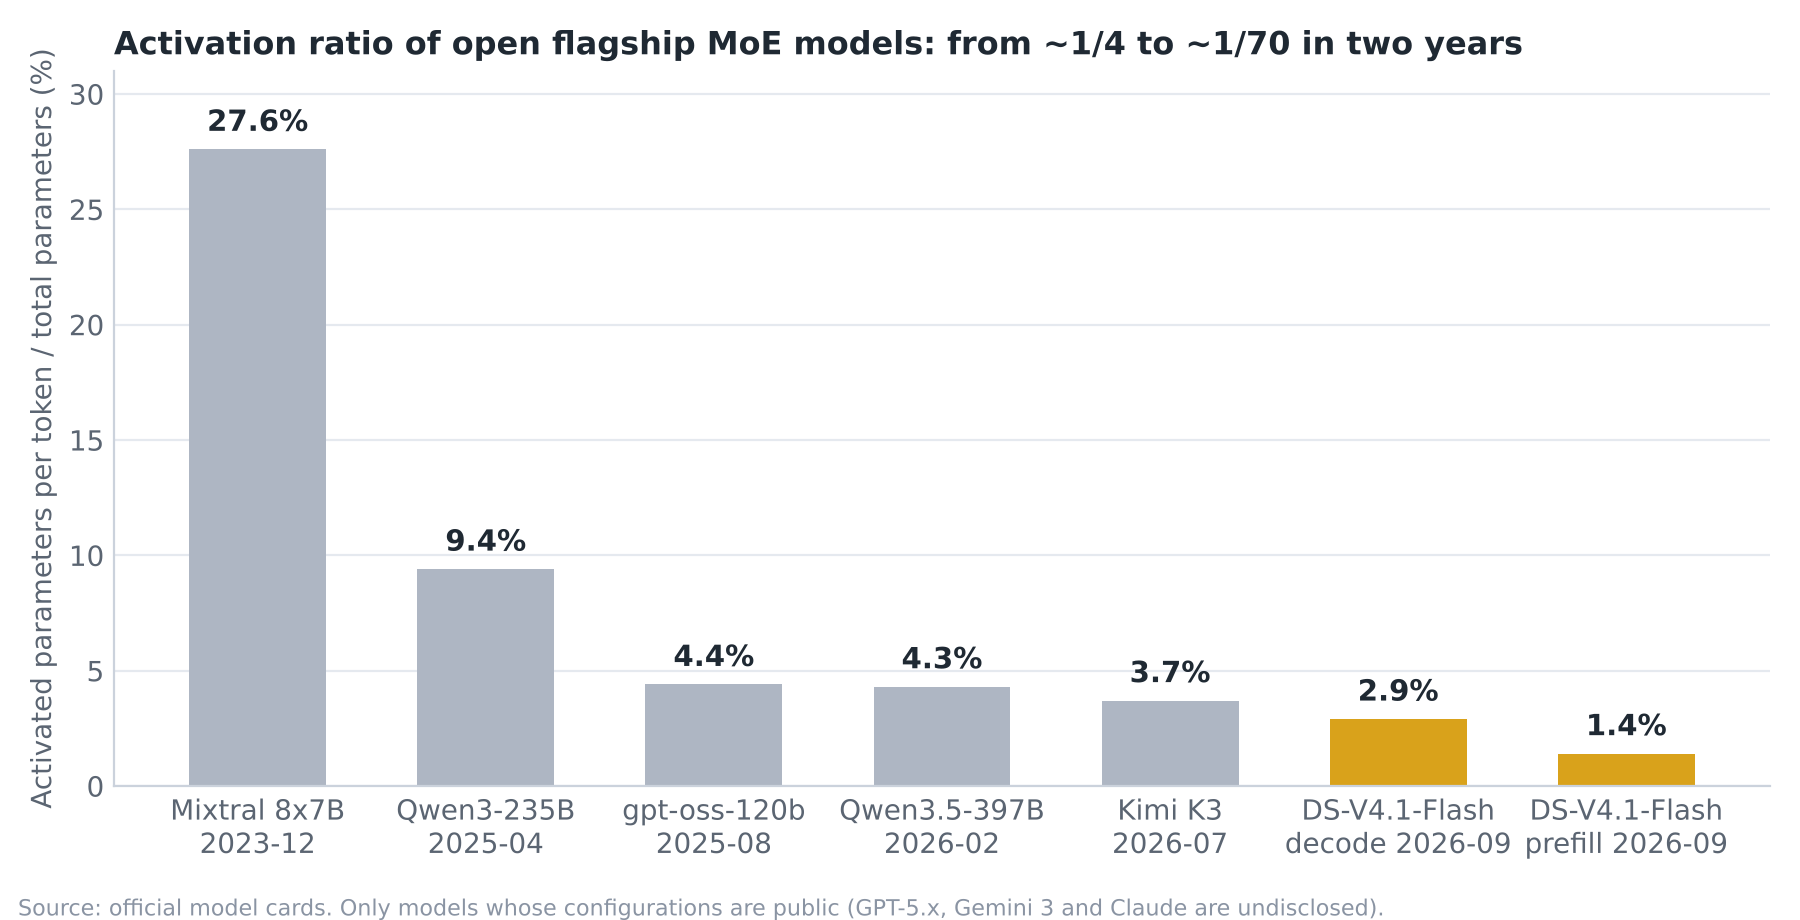
왜 지금인가요? 스케일링이 추론 비용과 메모리의 벽에 부딪혔고, 긴 컨텍스트를 다루는 에이전트에 의해 KV 캐시와 프리필이 지배적인 비용이 되었기 때문입니다. 그 결과 스파ース성의 역할은 "계산 절약"에서 "메모리·대역폭·스토리지 절약"으로 확대되었습니다. 2024년의 주류 MoE는 1토큰당 약 25%의 파라미터를 활성화했지만(Mixtral), 2026년에는 그 비율이 1.5%~4.5%까지 떨어졌습니다(DeepSeek-V4.1, Kimi K3, Qwen3.5).
스파ース성은 만능약이 아닙니다. 스파스 어텐션에 관한 역대 최대 규모의 평가(Nawrot et al., Findings of ACL 2026)는 거의 모든 스파스 구성이 최소 1개 이상의 작업에서 큰 성능 저하를 보임을 밝혔습니다. 해석가능성 분야에서도 스파스 오토인코더(SAE)는 2025년에 체계적인 부정적 결과에 직면했습니다. 모델 선정은 평균 점수가 아니라 귀사의 사업에 가장 어려운 작업의 점수로 판단해야 합니다.
본 문서를 관통하는 2가지 축
5가지 유형의 스파ース성: 활성화의 스파ース성, 가중치의 스파ース성, 구조화된 스파ース성, 조건부 계산(MoE), 그리고 어텐션의 스파ース성입니다. "스파ース성이 도움이 되는가"라는 논의는 어느 종류의 이야기인지 특정하지 않으면 시작할 수 없습니다.
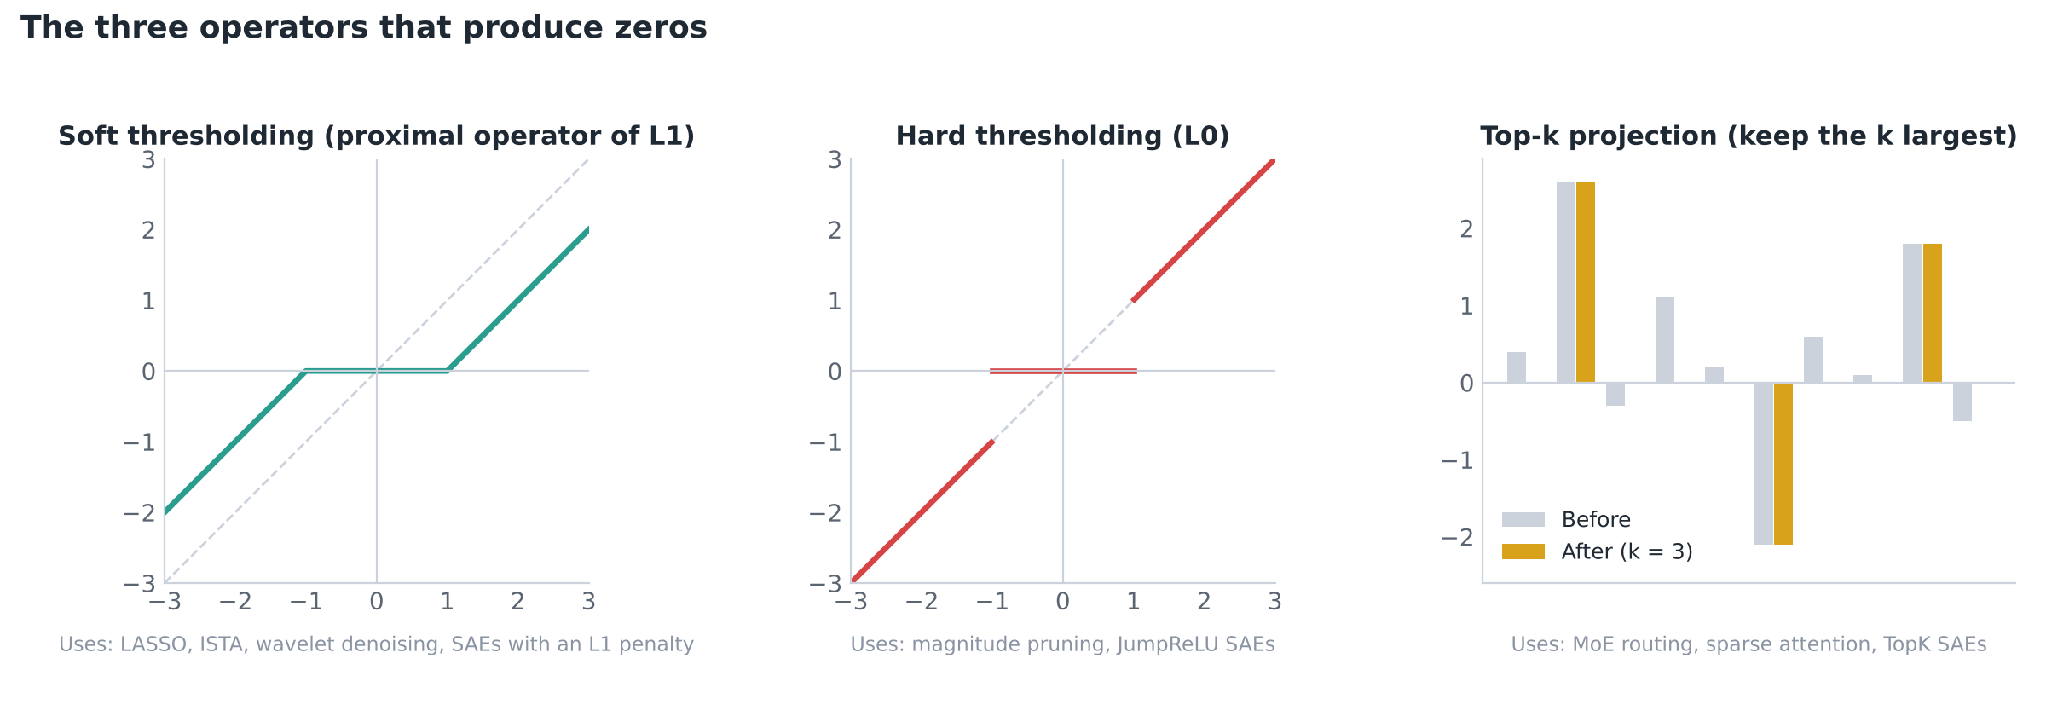
3가지 연산자: 소프트 임계값 처리(L1의 근접 작용소), 하드 임계값 처리(L0), 그리고 top-k 사영(L0 구로의 사영)입니다. 1994년의 웨이블릿 노이즈 제거에서 2026년의 MoE 라우팅까지, "영을 만드는" 단계는 이 3가지 연산자 중 하나를 서로 다른 대상에 적용하는 것일 뿐입니다. 현대의 대규모 모델은 거의 모두 세 번째를 사용합니다. 1토큰당 계산량을 정확히 고정할 수 있고, 하드웨어의 병렬 처리 단위와 일치하기 때문입니다.
전체에서 반복해서 등장하는 5가지 용어
| 용어 | 한마디로 |
|---|---|
| 토큰 | 모델이 처리하는 텍스트의 최소 단위. 단어, 또는 그 일부. "1토큰당 몇 파라미터가 활성화되는가"란 텍스트를 조금 출력할 때마다 얼마나 많은 계산을 사용하는지를 의미합니다 |
| 파라미터와 활성화 파라미터 | 파라미터는 모델이 보유한 수치의 총체(얼마나 많이 알고 있는가). 활성화 파라미터는 1토큰을 처리할 때 실제로 계산에 사용되는 부분(구동하는 데 얼마나 드는가). 스파스화란 이 둘을 분리하는 것입니다 |
| 기저와 좌표 | "조립 블록"의 집합. 데이터는 그 가중합으로 나타낼 수 있고, 가중치가 좌표에 해당합니다. 블록을 바꾸면 좌표계도 바뀝니다. 데이터는 같아도 읽어낸 값은 달라집니다 |
| 노름 | L2는 길이, L1은 성분의 절댓값의 합, L0은 영이 아닌 성분의 개수. 스파스란 L0이 작은 것입니다 |
| FLOPs와 메모리 대역폭 | 계산 처리량은 초당 곱셈-덧셈 연산의 횟수, 대역폭은 초당 GPU 메모리에서 꺼낼 수 있는 바이트 수입니다. 현대의 대규모 모델의 디코드 단계에서 병목은 대개 후자입니다 |
용어에 대한 주석: 본 문서에서는 "스파스"를 엄격히 "요소의 대다수가 영"이라는 의미로 사용합니다. "저랭크"는 "모든 요소가 영이 아니지만 자유도가 적다"는 뜻입니다(MLA나 LoRA 등). 둘은 자주 혼동되지만, 본 문서에서는 일관되게 구별합니다.
본 문서의 읽는 방법
본 문서는 시간순으로 진행되며, 각 시대에 대해 동일한 4가지 질문에 답합니다. 당시의 배경과 병목은 무엇이었는가. 스파ース성은 어떤 메커니즘으로 나타났는가. 무엇을 해결했고, 무엇을 대가로 했는가. 오늘날의 대규모 모델과 어떻게 연결되는가. "전사"장에서는 왜 세계가 스파스한지를 물으며, "고전 시대"에서는 수학이 어떻게 그것을 도구로 변환했는지를 보여주고, "신경망 시대"에서는 스파ース성이 신경망으로 들어왔을 때 왜 프루닝이 실패했는지를 설명합니다. 중심이 되는 "현재" 장에서는 2023~2026년에 대규모 모델이 스파스화로 완전히 방향을 바꾼 이유를 논하고, 각 연구 기관의 접근 방식을 체계적으로 비교합니다. "스파ース성과 심층학습이 만나는 장소"에서는 이미지·신호 처리에서의 스파스성과 심층학습의 융합을 다루고, "응용""이득과 비용""미래""우리에게 무엇을 의미하는가" 각 장에서 응용·비용·미래, 그리고 이 모든 것이 우리에게 무엇을 의미하는지를 다룹니다. 부록에는 연표·데이터·에피소드·참고문헌을 정리했습니다.
전사: 왜 세계 자체가 스파스한가
스파ース성은 데이터만의 성질이 아니라 "데이터와 그 기술 방식"의 조의 성질입니다. 세계는 적절한 기저 아래에서 스파스해집니다. 그리고 과학의 역사는 그 기저를 찾는 역사이기도 했습니다. 이 장에서는 3가지 유형의 경험적 증거와 1가지 사상적 원류를 제시하고, 그 위에 한계를 명시합니다.
철학과 정보 이론: 직관과 틀일 뿐, 기술적 기원은 아닙니다
오컴의 면도날은 단순함을 선호하는 철학적 원리일 뿐 스파스모델의 기술적 출발점은 아닙니다. Shannon (1948)은 "중복성"을 정량화했습니다. 부호 길이 중 정보원의 엔트로피를 초과하는 부분은 압축 가능한 중복성이며, 스파스 표현이란 본질적으로 그 중복성을 표면화시키는 기저를 의미합니다. 콜모고로프 복잡도(1960년대)는 "최단 기술"이라는 이상을 제시했지만 계산 불가능합니다. Rissanen의 MDL(최소 기술 길이, 1978)이 그것을 모델 선택의 실용적 기준으로 바꾸었습니다. 스파스모델은 MDL의 특수한 경우로 읽을 수 있습니다. 기술 길이 ≈ 영이 아닌 성분의 개수 × 계수 하나당의 부호화 비용, 이런 식입니다. 이 사상들은 "스파스모델의 발명자"가 아니라 "지적인 전사"로 기술되어야 합니다.
자연으로부터의 3가지 증거
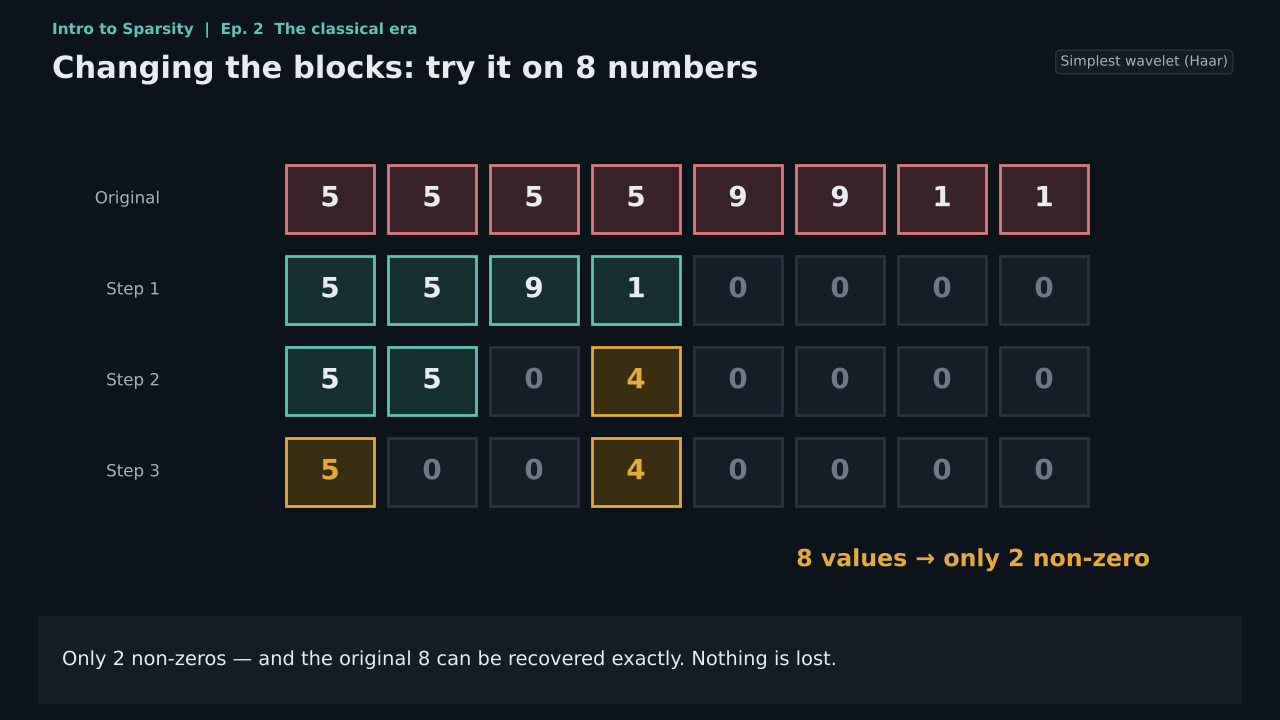
자연 이미지. 자연 이미지의 파워 스펙트럼은 대략 1/f²의 멱법칙을 따르며 근사적 스케일 불변성을 보입니다(Field 1987; Ruderman & Bialek 1994; 리뷰로서 Simoncelli & Olshausen 2001). 웨이블릿 같은 국소적·대역통과적 기저에서는 자연 이미지의 계수가 헤비테일을 띱니다. 대다수는 영에 가깝고, 엣지 부분의 극소수만 큽니다. 비선형 근사 이론(DeVore 1998; Donoho 1993)은 구간별 매끄러운 신호에 대해 웨이블릿 기저에서의 최고 n항 근사 오차가 어떤 고정 선형 기저보다도 빠르게 감소함을 증명했습니다. 이것은 JPEG2000과 압축 센싱 둘 다의 이론적 기반이며, 그림 3의 Haar 예제가 가장 작은 시연입니다.
언어. 단어의 빈도는 Zipf의 법칙을 따릅니다. 한줌의 단어가 출현의 대다수를 차지하고, 꼬리는 극도로 깁니다. 따라서 bag-of-words나 TF-IDF 표현은 극히 스파스합니다. 동일한 통계가 MoE의 전문가에 대한 부하가 본질적으로 편향되는 이유와 DeepSeek이 N그램 룩업 테이블을 조건부 메모리(Engram)로 사용하는 이유도 설명합니다.
뇌. Barlow (1961)는 중복성 감소 가설을 제안했습니다. 감각계의 목적은 중복성을 제거하고 통계적으로 독립적인 표현을 구축하는 것이라는 가설로, 이것이 스파스 부호화의 신경과학적 기원입니다. Attwell & Laughlin (2001)은 회백질의 에너지 수지를 계산했고, 이로부터 Lennie (2003, Current Biology 13:493–497)는 스파이크 1회의 비용이 매우 높기 때문에 "동시에 실질적으로 활동할 수 있는 뉴런의 수는 아마도 1% 미만으로 엄격히 제한된다"고 추정했습니다.
여기서 반드시 바로잡아야 할 점이 하나 있습니다. 널리 유포된 "뇌는 뉴런의 1~4%만 사용한다"는 주장은 간접 인용입니다. Glorot, Bordes, Bengio (2011)가 Lennie를 인용할 때 "1~4%"라고 썼고, 이후 그 숫자가 계속 전재되어 왔습니다. Lennie의 원문은 "아마도 1% 미만"이며, 게다가 그것은 에너지 제약에서 유도한 추정상의 상한일 뿐 측정값이 아닙니다. 스파ース성이 의미하는 것은 "어떤 순간에 강하게 발화하는 비율이 낮다"는 것이지, "뇌의 대부분이 노는 것"은 아닙니다.
한계와 반례
스파스는 저랭크가 아닙니다. 스파스란 어떤 기저나 사전 아래에서 영이 아닌 계수가 적은 것(L0/L1로 측정). 저랭크란 행렬의 특이값이 적은 것(랭크나 핵 노름으로 측정). LoRA와 MLA는 저랭크이고, MoE·top-k 어텐션·SAE는 스파스입니다. 절단 SVD가 주는 것은 저랭크 행렬이며, 거기서 스파스한 것은 특이값 스펙트럼뿐입니다.
세계가 항상 스파스한 것은 아닙니다.Robust PCA(Candès, Li, Ma & Wright 2011)는 데이터를 "저랭크+스파스"로 분해하여, 실제 데이터가 종종 둘을 모두 가지고 있음을 보였습니다. 동영상에서 배경은 저랭크이고 전경은 스파스입니다. 텍스처나 노이즈가 지배하는 신호는 일반적으로 사용되는 기저에서는 스파스하지 않습니다. LLM의 잔차 스트림에서 특징의 중첩(superposition)은 개별 뉴런 수준에서는 표현이 밀집되어 있으며, 과완비 사전 하에서만 스파스하게 됨을 의미합니다. 이것이 "현재" 장의 SAE 논의("해석가능성에서의 스파스성" 섹션)의 출발점입니다.
이 장의 요약.스파스성은 반박 가능한 사전분포이며 보편적인 진리가 아닙니다. 자연 이미지, 언어, 신경 활동에서 반복적으로 확인되어 왔기에 "베팅할" 가치가 있습니다. 하지만 베팅하기 전에 반드시 하나의 질문을 제기해야 합니다. 어떤 기저 하에서 스파스한가? 하는 질문입니다.
3가지 증거의 세부사항: 왜 이러한 통계 법칙인가?
자연 이미지의 1/f 스펙트럼은 어디서 나오는가?2가지 상호보완적 설명이 있습니다. 첫 번째는 스케일 불변성입니다. 자연 장면에 나타나는 물체의 크기는 몇 자릿수에 걸쳐 있으며, 확대하든 축소하든 이미지의 통계는 변하지 않습니다. 수학적으로 이는 파워 스펙트럼이 멱법칙을 따르도록 강제합니다. 두 번째는 폐색(occlusion) 모델입니다. 장면은 앞뒤로 겹치는 물체로 구성되며, 엣지는 불연속을 생성하고, 불연속은 주파수 영역에서는 천천히 감쇠하는 고주파 꼬리로 나타납니다. 두 설명 모두 같은 결론에 도달합니다. 자연 이미지는 "난수 노이즈"도 아니고 "어디나 부드러운" 것도 아니라, "넓고 평탄한 영역+소수의 엣지"입니다. 이것이 웨이블릿 기저가 가장 잘하는 구조입니다. Field (1987)는 한 걸음 더 나아가 시각 피질의 단순세포의 수용 야의 대역폭이 이 통계에 맞다면, 각 세포의 자연 이미지에 대한 반응은 헤비 테일을 가질 것이라고, 즉 대부분의 시간에는 거의 반응하지 않고 때때로 강하게 발화한다고 지적했습니다. 이것이 신경과학에서 "스파스 부호화"라는 말의 원래 의미입니다.
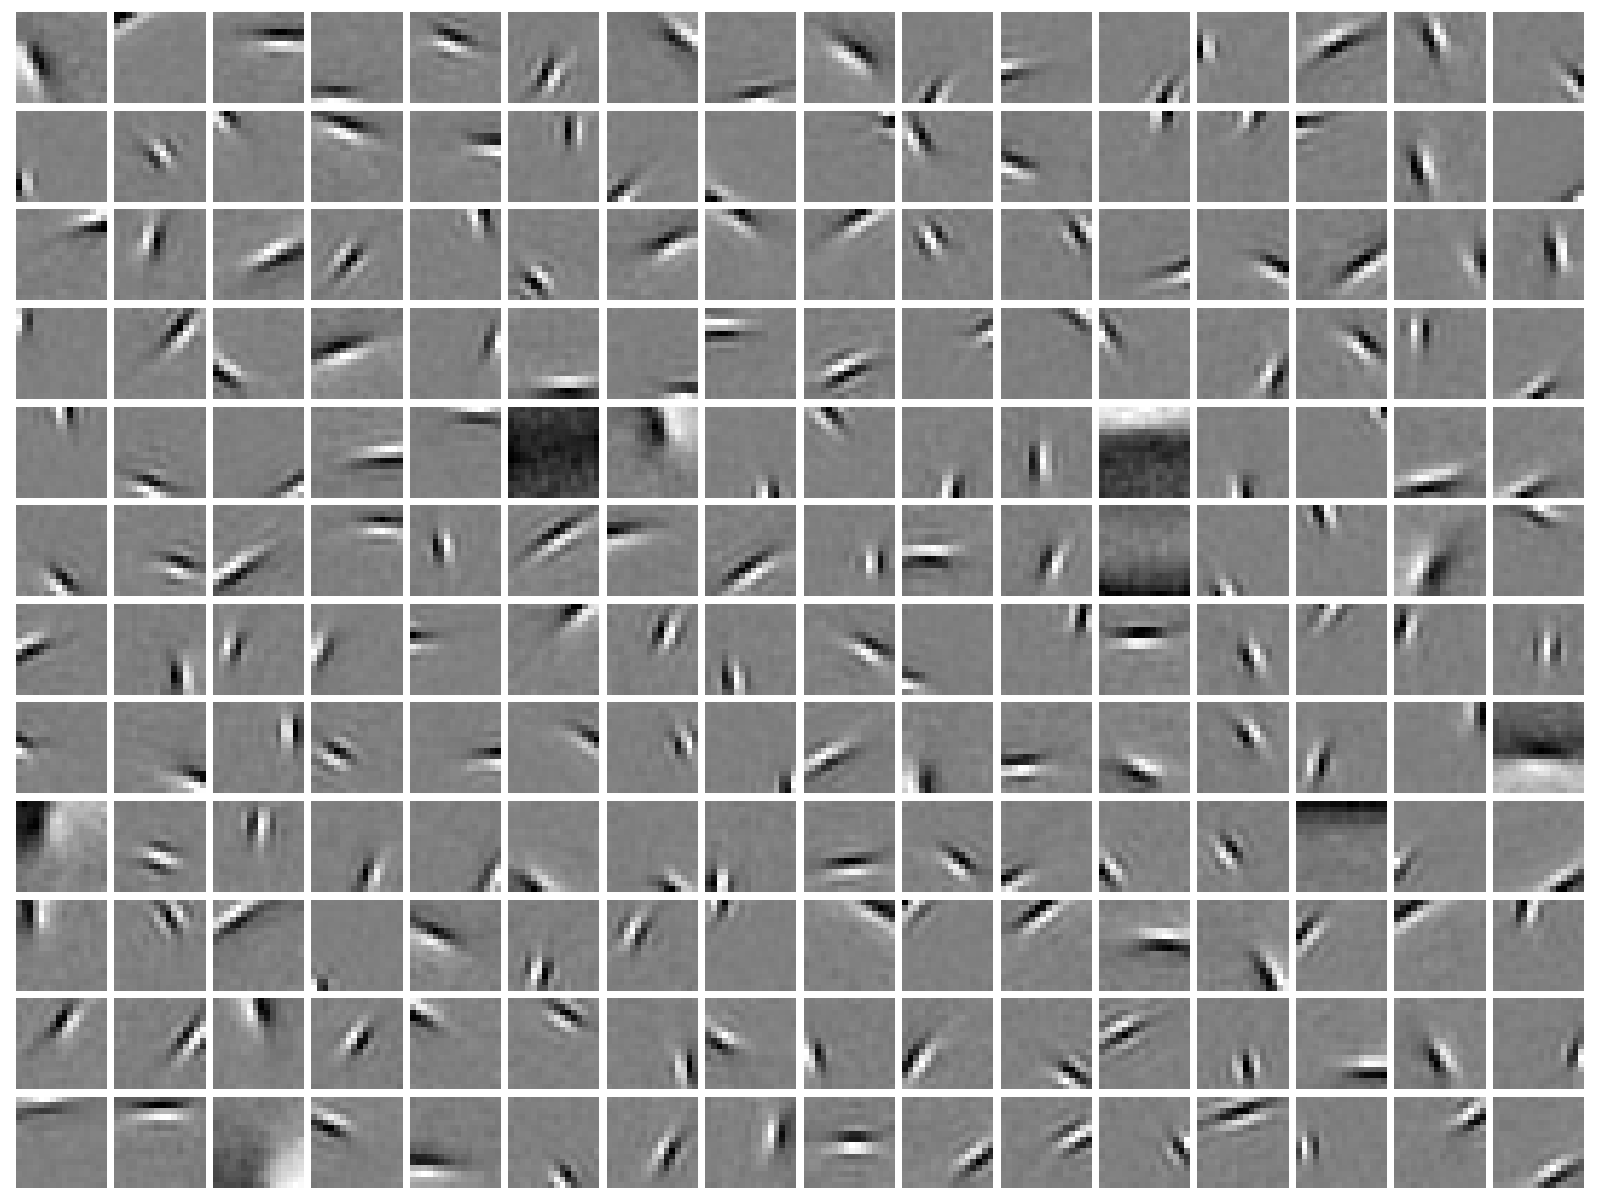
Olshausen과 Field의 실험은 왜 그렇게 설득력이 있는가?1996년 실험이 알고리즘에 부과한 제약은 단 2가지였습니다. 자연 이미지 패치를 선형 기저함수의 조합으로 재구성하는 것, 그리고 계수를 가능한 한 스파스하게 하는 것입니다. 뇌에 대한 선험 지식은 전혀 없습니다. 그럼에도 학습된 기저함수는 국소적, 방향 선택적, 대역통과적이 되었으며, 고양이와 원숭이의 V1 단순세포의 수용 야와 매우 유사했습니다. 이 결과의 힘은 그 방향성에 있습니다. "뇌에서 영감을 얻어 알고리즘을 만들었던" 것이 아니라, "스파스성의 원리가 뇌의 구조를 독립적으로 예언했던" 것입니다. 나중에 Hromádka, DeWeese, Zador (2008)는 각성 쥐의 청각 피질에서 고도로 스파스한 발화 패턴을 기록했고, Quian Quiroga et al. (2005)는 인간 해마에서 특정 인물이나 랜드마크에 선택적으로 반응하는 "개념 세포"를 발견했습니다. 모두 스파스 부호화 가설의 증거로 간주됩니다. 이의를 제기하는 입장도 있습니다. Spanne and Jörntell (2015) 등은 엄격한 스파스 부호화가 피질 전체에서 보편적이지 않으며, 스파스의 정도는 뇌 영역과 과제에 따라 다르다고 주장합니다. 따라서 이는 "광범위하게 지지받는 가설"로 기술해야 하며, 확정된 통설로 기술해서는 안 됩니다.
왜 에너지가 스파스성을 강제하는가?인간의 뇌는 체중의 약 2%이지만, 안정시 대사의 약 20%, 약 20와트를 소비합니다. Attwell and Laughlin (2001)은 회백질의 에너지 대부분이 시냅스 전달과 활동전위에 사용된다고 추정했습니다. Lennie (2003)는 여기서 역산합니다. 스파이크 1회에 이만큼의 비용이 든다면, 피질은 뉴런의 큰 비율을 동시에 높은 빈도로 발화시킬 여유가 없다고 말입니다. 이 논의는 "예산 제약 하의 상한"이므로, 얻어지는 것은 측정값이 아닌 "아마 1% 미만"이라는 추정값입니다. 의의는 구체적인 수치가 아니라 논리에 있습니다. 에너지나 대역이 제한된 시스템에서는, 스파스성은 선택지가 아니라 필연입니다.같은 논리가 "뉴럴 네트워크 시대" 장에서 GPU 상의 "메모리 벽"으로 다시 나타납니다.
언어에서의 Zipf의 법칙과 롱테일.Zipf (1935)는 단어의 빈도가 그 순위에 거의 반비례함을 관찰했습니다. 2번째로 많은 단어는 1번째의 약 절반, 10번째는 약 1/10의 빈도로 나타납니다. 나중에 Mandelbrot이 수정된 형식을 제시했습니다. 직접적인 결과는 어떤 텍스트도 어휘의 극히 일부만 사용하며, 대부분의 단어는 1, 2회만 나타난다는 것입니다. 통계적 언어 모델 시대에는 이는 극도로 스파스한 n-그램 빈도 행렬과 "제로 확률" 평활화 문제(Good–Turing, Kneser–Ney)로 나타났습니다. 대규모 모델 시대에는 2가지 형태로 돌아왔습니다. 하나는 MoE의 라우팅 부하가 본질적으로 편향된다는 것입니다. 인기 있는 전문가가 토큰의 대부분을 담당하기 때문에, 부하 분산 메커니즘이 개입할 수밖에 없습니다. 다른 하나는 DeepSeek의 Engram입니다. N-그램의 룩업 테이블을 프론티어 아키텍처에 부활시켜, 빈출 패턴은 저비용 룩업 경로로 보내고, 정말 추론이 필요한 것만 고비용 Transformer 계층에 남깁니다.
물리학과 공학에서의 스파스성
스파스성의 역사는 기계학습보다 공학이 더 깁니다. 과학 계산에서는 유한요소법이나 전력조류 방정식의 계수 행렬이 본질적으로 스파스합니다. 각 노드가 인접 노드하고만 결합하기 때문입니다. Tinney and Walker (1967)는 전력계통을 해결하면서 가우스 소거 중 "필인"을 줄이는 최적 순서를 제안했습니다. 이것이 스파스 직접법의 출발점입니다. 이어서 Rose (1972)가 소거 과정을 그래프 이론의 언어로 기술했고, Gilbert 등이 스파스 LU 분해를 발전시켜, 스파스 선형대수는 하나의 분야가 되었습니다. 지진탐사에서는 지하의 반사 계수 수열이 스파스한 스파이크 열로 모델링되며, 디콘볼루션 문제는 L1 정칙화로 풀립니다. 압축 센싱의 20년 선행입니다. 레이더·어레이 신호처리에서는 대상이 각도, 거리, 속도 공간에 스파스하게 분포하며, 초해상도 추정에 스파스 복원이 사용됩니다.
이 분야들에 공통되는 점은 스파스 패턴이 물리적 구조(인접 관계, 반사, 대상의 개수)에서 나오기 때문에 예측 가능하고 활용 가능하다는 것입니다. 이는 "고전 시대"의 웨이블릿(구조의 원천은 구간별 매끄러움)이나 "현재"의 MoE(구조의 원천은 전문가 블록)와 맥이 닿아있으며, "뉴럴 네트워크 시대"에서 비구조적 가중치 스파스성이 패배하는 이유도 설명합니다. 그 제로에는 물리적 구조가 없어서 하드웨어가 활용할 수 없기 때문입니다.
사회 현상에 비친 거울과 이 사고방식의 한계
Pareto의 80대 20 법칙, Anderson의 롱테일, 그리고 "소수의 중요한 변수가 분산의 대부분을 설명한다"는 인수분석의 전통은 모두 사회과학에 비친 스파스 사전분포의 거울입니다. 이들이 보여주는 것은 스파스성이 세계의 구조에 대한 가정이며 정리가 아니라는 것입니다. Gelman 등의 통계학자들은 "스파스성에 베팅하라"는 것에 의문을 제기해왔습니다. 사회과학의 많은 문제에서 참 효과는 밀집되고 작으며, 스파스 방법은 그것을 체계적으로 놓친다고 주장합니다. 같은 비판이 기계학습에도 적용됩니다. LLM의 잔차 스트림의 특징은 중첩에 의해 밀집되게 저장되며, 스파스성은 과완비 사전으로 전환할 때만 나타납니다. 따라서 본 글의 입장은 다음과 같습니다. 스파스성은 막대한 자연 데이터에서 반복적으로 확인되어 왔으므로, 처음에 베팅할 만한 사전분포입니다. 다만 베팅할 때마다 "어떤 기저 하에서 스파스한가?"에 답하고, 증거가 지지하지 않으면 포기할 준비를 해두어야 합니다.
고전 시대(1960년대~2014년): 스파스성이 어떻게 계산 가능한 도구가 되었는가
고전 시대에 성공한 스파스 방법에는 하나의 공통점이 있습니다. 스파스 패턴이 구조화되어 있고 예측 가능했기에 하드웨어나 업계 표준에 포함될 수 있었던 것입니다.이는 "뉴럴 네트워크 시대"에서 언급되는 "패배"의 복선이기도 합니다. 아래 표는 각각의 방법이 왜 그 시기에 나타났는지, 당시의 병목이 무엇이었는지, 무엇을 해결했는지라는 3가지 질문으로 마일스톤을 정리한 것입니다.
| 마일스톤 | 왜 그 시기에 나타났는가 | 당시의 병목 | 무엇을 해결했는가 |
|---|---|---|---|
| 스파스 행렬의 직접법(Tinney & Walker 1967) | 전력망이 대규모화, 메모리는 KB 단위의 시대 | 밀집 소거법은 O(n³)로 메모리에 맞지 않음 | 0이 아닌 요소만 저장하고, 최적 순서로 필인 감소 |
| 웨이블릿(Daubechies 1988; Mallat 1989) | 푸리에 기저는 엣지에 대해 스파스하지 않음 | 엣지의 에너지가 주파수 영역 전체에 산산조각남 | 구간별 매끄러운 신호가 웨이블릿 영역에서 스파스해짐 |
| Matching Pursuit (Mallat & Zhang 1993) | 과완비 사전의 등장 | 표현이 일의적이지 않음 | 탐욕 알고리즘에 의한 원자 선택 |
| 웨이블릿 임계값 노이즈 제거(Donoho & Johnstone 1994) | 계수는 스파스, 노이즈는 균일 | 선형 필터는 엣지까지 흐림 | 소프트 임계값 처리=L1의 근접 작용소. 거의 미니맥스 최적 |
| Breiman의 garrote 1995 → LASSO (Tibshirani 1996) | p ≫ n의 고차원 데이터 | 최소 제곱은 부정확한 설정, 부분 집합 선택은 불안정 | 축소 추정과 변수 선택을 동시에 실현 |
| Basis Pursuit (Chen, Donoho & Saunders 1998) | 볼록 최적화가 성숙 | L0은 NP 어려움 | L1에 의한 볼록 완화 |
| 비선형 근사(DeVore 1998) | "큰 것부터 k개 남기기"의 최적성 설명이 필요했음 | 선형 근사는 수렴이 느림 | 최적 n항 근사의 이론 |
| JPEG (1992) / JPEG2000 (2000) | 디지털 이미지의 보급 | 대역폭과 저장소 | 스파스 변환+양자화+엔트로피 부호화 |
| LARS (Efron et al. 2004); Elastic Net (Zou & Hastie 2005) | LASSO에 효율적인 경로 알고리즘이 필요했음 | 풀기가 느림, 상관된 변수에서 불안정 | 정칙화 경로 전체를 일괄 계산. L1+L2 |
| 압축 센싱(Candès–Romberg–Tao 2006; Donoho 2006) | 스파스 이론이 난수 행렬 이론과 만남 | 샘플링은 나이퀴스트 주파수에 제한됨 | RIP 조건 하에서, m ≳ k·log(n/k)회 측정으로부터 복원 |
| K-SVD (Aharon, Elad & Bruckstein 2006) | 학습 가능한 사전이 필요했음 | 고정 웨이블릿은 특정 데이터에 적합하지 않음 | 스파스 부호화와 사전 업데이트의 교대 최적화 |
| Donoho–Tanner 상전이(2009) | L1이 성공하는 조건의 특성화가 필요했다 | 이론상 한계가 너무 느슨했다 | (m/n, k/m) 평면에서의 날카로운 상전이 |
| 희소 부호화(Olshausen & Field 1996), 고속 알고리즘(Lee, Battle, Raina & Ng 2007) | Barlow 가설에 대한 응답 | V1 수용장은 왜 Gabor 형태인가 | 희소 사전이 V1 수용장을 재현하다 |
| 고양이 얼굴 뉴런(Le et al. 2012) | 분산 학습의 등장 | 고차 특징은 비지도 학습으로 출현하는가 | 후술 |
| 최적 특이값 하드 임계값(Gavish & Donoho 2014) | 저랭크 노이즈 제거에 원칙적인 임계값이 필요했다 | 절단 랭크는 경험적 규칙으로 선택되었다 | 정방 행렬에서 σ가 알려진 경우 (4/√3)√n·σ, 미지의 경우 중앙값의 2.858배 |
통계학에서의 "희소성에 베팅하라"는 원칙
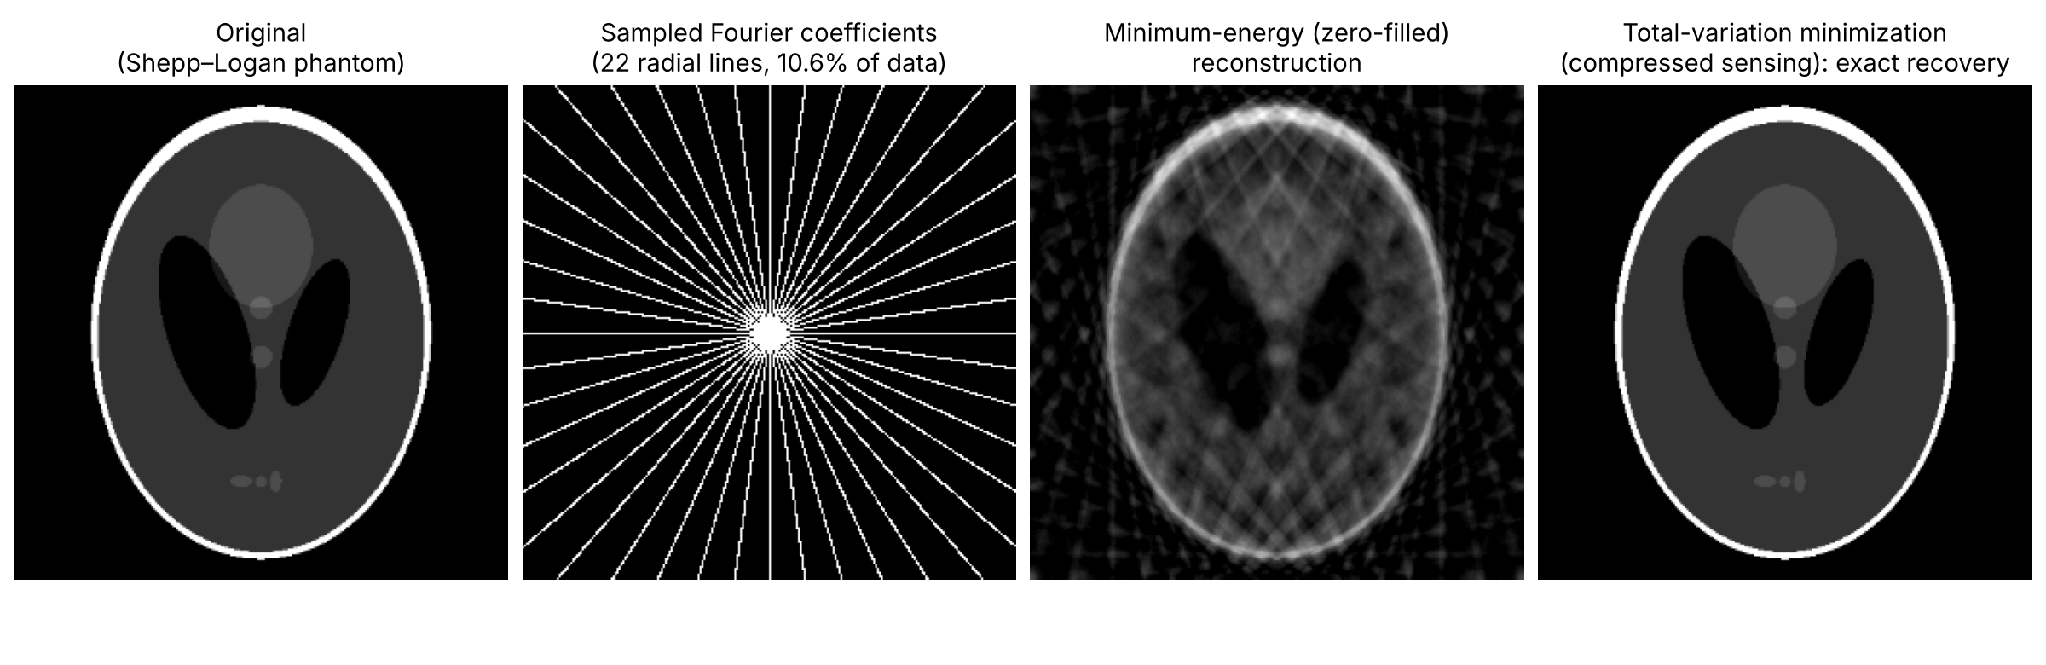
Hastie, Tibshirani, Friedman은 The Elements of Statistical Learning에서 "스파스성에 베팅하라(bet on sparsity)"는 원칙을 주창했습니다. 참 모델이 희소하다면, L1은 그것을 찾을 수 있다. 희소하지 않다면, 어떤 방법도 잘 작동하지 않는다. 따라서 희소성에 베팅하라는 것입니다. 고차원 통계학은 그 정확한 대가를 정량화했습니다. p차원의 k희소 벡터를 복원하려면 n ≳ k·log p 개의 샘플이면 충분합니다(Wainwright 2009). 압축 센싱에서의 대응하는 결과는 m ≳ C·k·log(n/k)번의 무작위 측정으로, RIP 상수가 δ₂ₖ < √2−1 ≈ 0.414를 만족하면 L1으로 정확히 복원할 수 있습니다(Candès 2008).
실제 세계의 3가지 사례(수치는 검증됨)
CS-MRI. Lustig, Donoho, Pauly (2007)가 압축 센싱 MRI의 기초를 정립했습니다. 임상 수치는 정확하게 인용되어야 합니다. Sartoretti et al. (2019, PLoS ONE 14(4): e0214887)은 일상 임상에서 평균 스캔 시간이 20.2% 단축, 검사 시간이 16% 단축, 적용된 시퀀스의 촬영 시간이 23%~43% 단축, 같은 기간의 검사 건수가 27% 증가했다고 보고했습니다(1차 자료). Vranic et al. (2019, AJNR 40(1):92–98)은 뇌의 FLAIR와 GRE 시퀀스에서 각각 25%와 35%의 단축을 보고했습니다. 자주 인용되는 "30%~60%의 고속화"는 1차 자료의 뒷받침이 없습니다.
블랙홀 영상(EHT). 2019년 M87*의 첫 번째 이미지를 지원한 3가지 영상 파이프라인 중 하나인 SMILI는 Honma et al. (2014)과 Akiyama et al. (2017)의 희소 모델링(L1+TV 정규화) 계통에 속합니다. 다른 파이프라인인 CHIRP (Bouman et al. 2016)는 순수 압축 센싱이 아니라 패치 사전 분포를 사용하고 있으며, "한 명의 연구자가 압축 센싱으로 블랙홀을 촬영했다"는 보도는 단순화입니다.
고양이 얼굴 뉴런. Le et al. (2012, ICML, arXiv:1112.6209)은 약 10억 개 연결의 9층 국소 연결 희소 자동 인코더를 YouTube의 1,000만 프레임으로 "1,000대 기계(16,000개 코어)에서 3일간" 학습시켰습니다. 비지도 학습으로 인간의 얼굴과 고양이 얼굴에 선택적으로 반응하는 단일 뉴런이 출현했으며, 다운스트림 ImageNet에서 15.8%의 정확도에 도달하여 기존 최고치에서 상대적으로 70% 개선했습니다. 이 "희소 부호화 → 비지도 특징" 계통은 2012년 이후 지도 학습 CNN에 의해 쇠퇴하지만, 2023년에 Anthropic의 SAE로 복귀합니다.
병렬 계통: 저랭크
절단 SVD(Eckart–Young–Mirsky 정리)는 랭크 k 이하의 모든 행렬 중에서의 최적 근사이며, Gavish & Donoho (2014, IEEE T-IT 60(8):5040–5053)는 노이즈 제거를 위한 최적의 하드 임계값을 제시했습니다. 이는 웨이블릿 임계값 노이즈 제거와 구조적으로 동형입니다. 둘 다 "기저를 변환 → 임계값 처리 → 역변환"을 따르며, 차이점은 웨이블릿 기저는 고정되어 있는 반면 SVD의 기저는 데이터로부터 계산된다는 것뿐입니다. 전자에서는 신호가 임계값 처리 후에도 희소로 남아있지만, 후자에서는 절단된 행렬은 저랭크이지만 밀집되어 있습니다. 이 계통은 "현재" 장에서 MLA와 LoRA의 형태로 대규모 모델로 돌아옵니다.
한 걸음씩: 각각의 진보가 그 시기에 일어난 이유
푸리에에서 웨이블릿으로(1980년대). 푸리에 기저는 신호를 전역 정현파로 분해합니다. 정상 신호에는 효율적이지만, 모서리와 과도 현상에는 극도로 낭비적입니다. 하나의 스텝을 표현하려면 무한개의 주파수 성분이 필요하고, 에너지가 주파수 영역 전체에 퍼집니다. 공학에는 Gabor 변환이나 단시간 푸리에 변환과 같은 회피책이 이미 있었지만, 통일된 수학적 프레임워크가 없었습니다. Mallat (1989)이 다중 해상도 분석을 정식화하고, Daubechies (1988)이 컴팩트한 지지를 갖는 직교 웨이블릿을 구성함으로써, 국소성·다중스케일 구조·직교성의 3가지를 동시에 만족할 수 있게 되었습니다. 각 웨이블릿 기저 함수는 유한한 범위에서만 0이 아니며, 모든 스케일에서 반복됩니다. 따라서 구간별로 부드러운 신호는 모서리의 위치와 적은 수의 스케일에서만 큰 계수를 생성하고, 그 외에는 거의 0이 됩니다. DeVore (1998)과 Donoho (1993)는 이것이 경험적 우연이 아님을 증명했습니다. 구간별로 부드러운 함수의 클래스에서는 어떤 고정 선형 기저도 웨이블릿 기저에서의 최적 n항 비선형 근사의 오차 감쇠율을 따라갈 수 없습니다. JPEG2000 (2000)은 이 이론을 표준 규격으로 변환하여 JPEG의 DCT를 웨이블릿으로 대체하고, 동일한 비트레이트에서 블록 노이즈를 크게 감소시켰습니다.
최소제곱법에서 LASSO로(1990년대). 통계학이 직면한 것은 다른 종류의 희소성이었습니다. 계수가 어떤 기저에서 희소한지 여부가 아니라, "어느 설명 변수가 실제로 중요한가"입니다. 고전적인 접근은 부분집합 선택(단계적 회귀, AIC/BIC)이었지만, 이는 조합 탐색이며 데이터의 작은 섭동에 극도로 불안정합니다. Breiman (1995)은 음이 아닌 garotte를 제안하여 변수 선택을 연속적 축소 문제로 재설정했습니다. 이에 영감을 받은 Tibshirani (1996)는 LASSO, 즉 L1 페널티가 있는 최소제곱법을 제안합니다. L1의 동작은 그 기하학으로 결정됩니다. 제약 영역은 각을 가진 다이아몬드 모양이고, 최적해는 각에 올라타기 쉬우며, 각 모서리는 일부 계수가 정확히 0이 되는 점에 대응합니다. 이것이 "축소와 선택이 동시에 발생"하는 메커니즘입니다. LASSO의 알고리즘적 병목은 2004년의 LARS(Efron, Hastie, Johnstone, Tibshirani)가 제거했으며, 정규화 경로 전체를 한 번에 계산할 수 있게 했습니다. 2005년에는 Zou와 Hastie의 Elastic Net이 L1+L2로 강하게 상관된 변수 그룹을 처리할 수 있게 했습니다. 고차원 통계학은 이론적 보장을 제공합니다. Wainwright (2009)는 p차원에서 k개의 0이 아닌 계수를 복원하려면 n ≳ k·log p개의 샘플이면 충분함을 증명했으며, Bickel, Ritov, Tsybakov (2009)는 LASSO와 Dantzig 선택자의 오라클 부등식을 확립했습니다.
신호 처리에서의 독립적 발견(1993~1998년). 거의 같은 시기에 신호 처리는 "과완전 사전"에서 출발하여 같은 L1에 도달했습니다. Matching Pursuit (Mallat and Zhang 1993)은 잔차와 가장 상관되는 아톰을 탐욕스럽게 선택하고, Basis Pursuit (Chen, Donoho, and Saunders 1998)는 "가장 희소한 표현을 찾기"라는 NP 어려운 L0 문제를 L1 선형 계획법으로 완화했습니다. LASSO와 Basis Pursuit은 수학적으로는 같은 문제의 2가지 매개변수화이지만, 거의 교류가 없는 2개 커뮤니티에서 탄생했습니다. 희소성이라는 개념이 "여러 원천으로부터 수렴하는" 첫 번째 사례입니다.
노이즈 제거: 희소성이 처음으로 직접 가치를 만든 순간(1994년). Donoho와 Johnstone의 웨이블릿 임계값 노이즈 제거는 위의 이론을 3단계 절차로 변환했습니다. 직교 변환으로 웨이블릿 영역으로 이동합니다. 계수에 임계값 λ=σ√(2 log n)의 소프트 임계값 처리 S_λ(w)=sign(w)·max(|w|−λ,0)을 적용합니다. 역변환으로 신호 영역으로 돌아옵니다. 이것이 작동하는 핵심은 직교 변환이 백색 잡음의 통계적 성질을 보존한다는 것입니다. 웨이블릿 영역에서도 잡음은 등분산 독립 가우스 잡음으로서 모든 계수에 균등하게 퍼져 있는 반면, 신호의 에너지는 적은 수의 큰 계수에 집중되므로, 작은 계수를 버리면 됩니다. 소프트 임계값 처리 연산자는 정확히 L1 페널티의 근접 연산자이며, 따라서 노이즈 제거, LASSO, 나중의 ISTA/FISTA (Beck and Teboulle 2009), 그리고 LISTA (Gregor and LeCun 2010, 알고리즘 전개의 출발점)가 모두 같은 핵심 연산을 공유하는 이유입니다.
압축 센싱: 스파ース성을 "적게 측정하여 많이 얻는" 원리로 전환(2004~2009년). 지금까지의 어떤 방법도 완전한 데이터가 손에 있다는 전제 하에서 스파ース 표현을 찾고 있었습니다. Candès, Romberg, Tao (2006)와 Donoho (2006)는 역의 질문을 제시합니다. 신호가 어떤 기저 아래에서 k-스파스하다는 것을 알고 있다면, 정확한 복원에 몇 번의 측정이 필요할까요? 답은 m ≳ C·k·log(n/k)번의 무작위 선형 측정이며, 이는 나이퀴스트 레이트보다 훨씬 낮습니다. 조건은 측정 행렬이 제한된 등거리성(RIP)을 만족해야 한다는 것입니다. 즉, 모든 2k-스파스 벡터의 길이를 거의 보존해야 합니다. Candès (2008)는 충분조건 δ₂ₖ < √2−1 ≈ 0.414를 제시했으며, Donoho와 Tanner (2009)는 조합 기하를 사용하여 L1 복원의 성공과 실패 사이의 날카로운 상전이를 특징지었습니다. 압축 센싱의 역사적 의의는 스파ース성을 "표현의 특성"에서 "샘플링의 원리"로 승격시키고, 이미징 하드웨어 설계를 직접 변경했다는 점입니다. Lustig, Donoho, Pauly (2007)는 이를 MRI에 적용하여 무작위 언더샘플링 궤적과 교환하여 스캔 시간을 단축했습니다. Duarte et al. (2008)은 싱글 픽셀 카메라를 만들었으며, 전파 천문학에서 SMILI 파이프라인은 EHT의 블랙홀 이미징에 L1 정규화와 전변분 정규화를 사용했습니다.
사전 학습과 스파ース 부호화: 고정 기저에서 학습 기저로(1996~2012년). 웨이블릿은 사람이 설계한 고정 기저이며 특정 데이터에 최적이라고 할 수 없습니다. Olshausen and Field (1996)는 데이터에서 사전을 학습하여 V1의 수용 필드를 재현했습니다. K-SVD (Aharon, Elad, and Bruckstein 2006)는 스파ース 부호화와 원자별 SVD 업데이트를 교대로 수행하는 실용적인 알고리즘을 제공했습니다. Lee, Battle, Raina, Ng (2007)은 L1 스파ース 부호화를 고속화하여 "자체 학습"을 진전시켰습니다. Le et al. (2012)는 스파스 오토인코더를 9층·10억 연결까지 쌓아, YouTube의 1,000만 프레임에서 감독되지 않은 고양이 얼굴 선택적 뉴런을 학습했습니다. 2012년 AlexNet 이후 이 계통은 감독된 합성곱 신경망의 그림자에 10년간 숨겨져 있지만, 두 가지를 남겼습니다: "과완전 사전 + 스파스 계수"라는 표현 프레임워크와 "사전은 데이터에서 학습될 수 있다"는 확신입니다. 2023년 Anthropic이 스파스 오토인코더로 대규모 모델의 내부 특징을 해독했을 때, 인용한 것은 바로 Olshausen과 Field였으며, 관련 논문의 공동 저자에는 Olshausen 본인이 있었습니다.
저랭크: 스파ース성의 쌍둥이(1936~2014년). Eckart and Young (1936)은 절단 SVD가 행렬의 최적 저랭크 근사임을 증명했습니다. 저랭크와 스파거성은 구조적으로 동형입니다. 둘 다 "에너지를 소수의 성분에 집중시키고 꼬리를 자른다"는 의미이지만, 작용하는 대상이 다릅니다. 스파버성은 좌표를 자르고, 저랭크는 방향을 자릅니다. Gavish and Donoho (2014)는 저랭크 노이즈 제거의 최적 하드 임계값을 제시했으며, 웨이블릿 노이즈 제거의 보편적 임계값과 공명했습니다. 견고한 PCA (Candès et al. 2011)는 둘을 결합합니다. 데이터 = 저랭크 + 스파버성입니다. 이 구별은 "현재" 장에서 결정적으로 중요해집니다. DeepSeek의 MLA는 저랭크 압축이며, DSA와 CSA2야말로 스파스 주의입니다. 둘은 종종 혼동됩니다.
요약: 고전 시대가 딥러닝에 남긴 3가지 유산
첫째, 데이터 처리보다 올바른 기저를 찾는 것이 더 중요하다는 것입니다. 같은 이미지가 픽셀 기저에서는 밀집되어 있고, 웨이블릿 기저에서는 스파스합니다. 모든 차이는 표현 방식에 있습니다. 둘째, 0을 만드는 연산은 3가지뿐이라는 것입니다. 소프트 임계값 처리(L1), 하드 임계값 처리(L0), 그리고 큰 것부터 k개를 유지하는 것(L0 구로의 사영)입니다. 셋째, 구조화된 스파서성만이 하드웨어와 표준 규격에 도달한다는 것입니다. 웨이블릿의 트리 구조는 JPEG2000에, 무작위 언더샘플링은 MRI 제품에 포함되었습니다. 3가지 유산은 모두 "신경망 시대"와 "현재"에서 새로운 모습으로 다시 등장합니다.
신경망 시대(1990~2022년): 스파서성의 좌절과 전환점
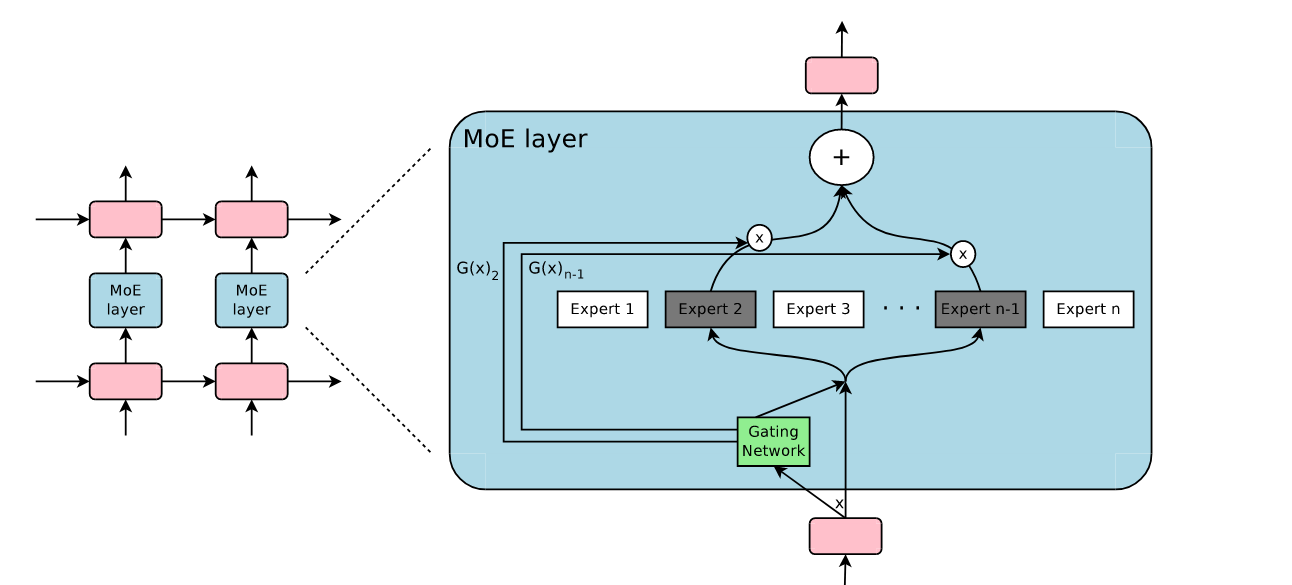
스파서성이 패배한 것이 아닙니다. 하드웨어에 맞지 않는 스파서성이 패배한 것입니다. 비구조화된 가중치 프루닝은 이론에서는 성공했지만 GPU 위에서는 패배했습니다. MoE는 스파스화의 단위를 전문가 블록 전체로 만들었고, 각 전문가의 내부는 밀집 행렬 곱셈으로 남아 있었기 때문에 하드웨어의 복권을 맞췄습니다. 이 장에서는 그 이유를 설명합니다.
프루닝의 계통과 "스파서성의 벽"
OBD (LeCun, Denker & Solla 1990)는 이차 정보에서 각 가중치의 중요도를 추정했고, OBS (Hassibi & Stork 1993)는 이를 완전한 헤시안 행렬로 정교화했습니다. Deep Compression (Han, Mao & Dally 2016)은 프루닝, 양자화, 허프만 부호화를 결합하여 AlexNet을 240 MB에서 6.9 MB로 압축했습니다. 복권 가설 (Frankle & Carbin 2019)는 밀집 네트워크 내에 단독으로 학습해도 동일한 정확도에 도달할 수 있는 스파스 부분 네트워크가 포함되어 있음을 보였습니다. SparseGPT (Frantar & Alistarh 2023)와 Wanda (Sun et al. 2023)는 GPT 클래스 모델을 정확도를 거의 잃지 않으면서 원샷으로 50% 스파스하게 할 수 있음을 보였습니다.
하지만 LLM 시대가 오면 이 계통은 벽에 부딪힙니다. 2025년 10월 ELSA 논문(arXiv:2510.01650)은 이를 "스파서성의 벽"이라고 부릅니다. 기존 방법은 "정확도를 크게 떨어뜨리지 않으면서 50~60%의 스파서성을 넘을 수 없는 것으로 보인다"는 것입니다. ELSA는 ADMM을 사용하면 LLaMA-2-7B를 거의 90%까지 프루닝할 수 있다고 주장하고 있지만, 그 주장은 아직 논의 중입니다.
활성화 스파서성: ReLU의 실제 수치
Glorot, Bordes, Bengio (2011, AISTATS)가 활성화 스파서성의 일차 자료이며, 그 수치는 정확하게 인용할 가치가 있습니다. 균등 초기화 직후, 숨겨진 유닛의 약 50%가 엄격한 0을 출력합니다. 학습 후 평균 엄격 스파스율은 MNIST에서 83.4%, CIFAR10에서 72.0%, NISTP에서 68.0%, NORB에서 73.8%입니다. 결론은 "가장 잘 일반화하는 모델의 스파스율은 50%에서 80% 사이"이며, 성능을 손상시키지 않으면서 약 85%까지 스파서성을 강제할 수 있다는 것입니다. "ReLU는 90% 스파스"라는 주장은 원전의 뒷받침이 없습니다.
그런데 하나의 구별을 해두겠습니다. Dropout은 학습 시에 적용되는 무작위 정규화이며, 추론 시에는 네트워크가 다시 밀집됩니다. 프루닝은 가중치를 영구적으로 삭제합니다. 둘 다 "마스크의 적용"으로 쓸 수 있지만, 마스크의 무작위성, 작용하는 단계, 목적은 완전히 다릅니다.
왜 비구조화된 가중치 스파서성은 GPU 시대에 패배했는가
하드웨어의 복권. Hooker의 정의(The Hardware Lottery, 2020/2021)에 따르면, 연구 아이디어가 이기는 것은 좋은 아이디어이기 때문이 아니라 입수할 수 있는 소프트웨어와 하드웨어에 적합하기 때문입니다. GPU와 TPU는 밀집하고 연속적인 행렬 곱셈을 위해 설계되었습니다. 비구조화된 스파서성은 gather/scatter를 가져오고, GEMM의 타일화된 데이터 흐름을 깨뜨리며, 온칩 캐시 재사용을 줄이고, 대부분 텐서 코어를 사용할 수 없습니다. 경험적으로, cuSPARSE와 같은 라이브러리가 명확한 가속을 보이는 것은 스파스율이 약 90%를 초과할 때부터이며, 50%의 비구조화된 스파서성에서는 GPU 위에서 밀집 GEMM을 이기는 기성 커널이 거의 존재하지 않습니다.
2:4 구조화 스파서성. Ampere 이후의 GPU는 4개의 가중치 중 정확히 2개가 0인 패턴을 지원하며, 패턴이 만족되면 이론 처리량은 2배가 됩니다. 하지만 스파스율은 50%에서 한계에 다다르고, 정확도 회복에는 재학습이나 미세 조정이 필요하며, 종단간 가속화가 2배에 가까워지는 일은 드물기 때문에, LLM 배포에서는 양자화만큼 널리 퍼지지 않았습니다.
왜 양자화가 이겼는가. 양자화는 매개변수당 비트 수를 줄이지만, 행렬의 규칙성에는 손을 대지 않으므로 모든 GPU가 자연스럽게 이득을 봅니다. GPTQ (2022)와 AWQ (2023) 이후, MXFP4는 2025~2026년의 기본 형식이 되었습니다. gpt-oss는 MoE의 가중치(전체 매개변수의 90% 이상)를 MXFP4(매개변수당 4.25비트)로 저장하고 있으며, 이것이 120b 모델을 1개의 80 GB GPU에 수용하는 것을 가능하게 했습니다. Kimi K3는 MXFP4 가중치와 MXFP8 활성화로 양자화 인식 학습(QAT)을 수행하고 있으며, DeepSeek-V4 계열의 전문가 매개변수는 FP4를 사용하고 있습니다.
메모리의 벽. V100부터 B200까지 피크 계산 성능의 증가는 메모리 대역폭의 증가를 훨씬 능가했습니다(각 업체의 공표 사양에 기반한 대략적 수치).
| GPU | 밀집 BF16/FP16 계산 성능 | HBM 대역폭 | 바이트당 연산 수(대략) |
|---|---|---|---|
| V100 (2017) | 약 125 TFLOPS | 0.9 TB/s | 140 |
| A100 (2020) | 약 312 TFLOPS | 1.6–2.0 TB/s | 155–195 |
| H100 SXM (2022) | 약 989 TFLOPS | 3.35 TB/s | 295 |
| B200 (2024) | 약 2.2 PFLOPS (FP4의 경우 약 9 PFLOPS) | 약 8 TB/s | 280 (FP4의 경우 약 1,100) |
디코딩 중에는 토큰을 하나 생성할 때마다 계산에 관여하는 가중치를 GPU 메모리에서 꺼내야 합니다. 배치 크기가 작으면 연산 유닛은 대부분 유휴 상태이며, 병목은 대역폭이 됩니다. 따라서 "FLOPs를 줄인다"는 것보다 "읽어야 할 파라미터와 KV를 줄인다"는 것이 더 가치 있습니다. MoE는 토큰당 읽는 가중치의 바이트 수를 줄이고, 스파스 어텐션과 KV 압축은 캐시의 바이트 수를 줄입니다. 둘 다 정확히 가장 비용이 많이 드는 항목을 삭감하고 있는 것입니다.
조건부 계산의 계보(전환점)
1991년 Jacobs, Jordan, Nowlan, Hinton의 Adaptive Mixtures of Local Experts. 여러 개의 전문가 네트워크를 게이팅 네트워크와 함께 학습시키는 것으로, 초기 동기는 작업 간 간섭을 줄이는 것이었습니다. 1994년에는 Jordan & Jacobs가 계층형 MoE로 확장합니다.
2013년 Bengio 등이 조건부 계산과 확률적 뉴런을 통한 그래디언트 추정(STE)을 제안합니다. Eigen, Ranzato, Sutskever가 깊은 네트워크에서 MoE를 초기에 시도했습니다.
2017년 Shazeer 등의 Outrageously Large Neural Networks(공저자는 Hinton과 Dean). 최대 137B 파라미터의 스파스 게이트 MoE 레이어를 LSTM 레이어 사이에 삽입하여 "계산 효율의 약간의 손실만으로 모델 용량을 1000배 이상 개선"했습니다. 원문에서 "greater than 1000x"이고, 137B는 MoE 레이어의 파라미터 수를 의미함을 주의하십시오.
2020〜2022년 GShard가 MoE를 Transformer에 가져와 600B 이상으로 확장했고, Switch Transformer (Fedus, Zoph & Shazeer 2021)는 top-1 라우팅으로 1조 파라미터에 도달했습니다. GLaM과 ST-MoE는 안정성 문제(router z-loss)에 대응했고, Expert Choice (2022)는 전문가가 토큰을 선택하는 방식으로 반전시켜 부하를 자연스럽게 균형잡혔습니다.
이 절을 한 문장으로 말하면: 1991년부터 2022년까지 조건부 계산이라는 아이디어는 변하지 않았습니다. 바뀐 것은 하드웨어와 그에 맞는 규모가 드디어 도래했다는 것입니다.
MoE를 논문에서 제품으로: 2017〜2022년에 해결된 공학적 문제들
Shazeer et al. (2017)은 용량을 1000배 확장할 수 있음을 보여주었지만, MoE를 신뢰할 수 있는 제품으로 만들려면 추가로 5년과 4개의 구체적인 문제 해결이 필요했습니다.
라우팅을 어떻게 학습하는가. 게이트는 s = Softmax(W_g·h)를 출력하고, 상위 k개의 전문가가 선택되며, 레이어의 출력은 y = h + Σ_{i∈T} s_i·FFN_i(h)가 됩니다. 문제는 top-k가 이산적 선택이므로 s에 관한 미분이 거의 모든 곳에서 0이 된다는 것입니다. 그래디언트는 선택된 전문가의 게이트 가중치에만 도달하고, 선택되지 않은 전문가는 영원히 학습 기회를 얻지 못합니다. Shazeer의 해결책은 Noisy Top-k 게이팅으로, 로짓에 학습 가능한 가우스 노이즈를 더해 k+1위가 될 예정이던 전문가가 때때로 선택되도록 했습니다. 더 일반적인 해결책은 Bengio et al. (2013)의 스트레이트 스루 추정량(STE)과 나중의 Gumbel-Softmax입니다.
부하를 어떻게 균형잡는가. 라우터는 부익부빈익빈의 경향이 있습니다. 인기 있는 전문가일수록 선택되고, 선택될수록 더 잘 학습되며, 더 선택되기 쉬워지고, 결국 소수의 전문가가 모든 트래픽을 안게 되어 모델이 실질적으로 작은 모델로 퇴화합니다(전문가 붕괴). GShardと Switch Transformer는 보조 부하 분산 손실 L_bal = α·N·Σ f_i·P_i를 도입했습니다. f_i는 전문가 i에 할당된 토큰의 비율, P_i는 그 평균 게이트 확률입니다. ST-MoE (2022)는 추가로 router z-loss로 로짓의 폭발을 억제했습니다. 이러한 보조 손실은 작동하지만 본래의 언어 모델링 목적 함수의 그래디언트를 교란시킵니다. 2024년 DeepSeek-V3는 "그래디언트 외부 바이어스"로 이 트레이드오프를 피했습니다("현재" 장 참조).
용량을 어떻게 설정하는가. 분산 학습에서는 각 전문가의 버퍼 크기를 미리 고정해야 하며, 여기서 용량 계수(capacity factor)가 등장합니다. 전문가당 용량 = capacity_factor × (토큰 수 / N)입니다. 용량을 초과한 토큰은 드롭되고(token dropping), 잔차 연결만 통과합니다. 용량 계수가 크면 메모리 낭비, 작으면 품질 저하입니다. MegaBlocks (2023)는 블록 스파스 행렬 곱으로 "드롭 없는" MoE를 구축하여 이 딜레마에서 벗어났습니다.
통신을 어떻게 견디는가. 전문가는 서로 다른 GPU에 배치되고(전문가 병렬), 각 MoE 레이어는 데이터 의존적 all-to-all 교환을 2번 요청합니다. 토큰을 전문가가 있는 GPU로 보내고 결과를 수집하는 것입니다. 이것은 MoE 학습의 주요 통신 병목이며, MoE가 대규모 중앙 집중식 배포에 적합한 이유이기도 합니다. DeepSpeed-MoE에서 Tutel을 거쳐 DeepSeek의 DeepEP에 이르기까지 이 모든 시스템은 이 경로를 최적화하고 있습니다.
이정표: GShard (2020)는 MoE를 Transformer에 가져와 600B 이상으로. Switch Transformer (2021)는 top-1 라우팅으로 1조 파라미터에 도달하여 T5-XXL보다 4배 빠르게 사전학습했습니다. GLaM (2021)은 전체 파라미터 1.2T, 활성화 약 97B로 GPT-3의 약 3분의 1 에너지 소비였습니다. Expert Choice (2022)는 방향을 반전시켜 전문가가 토큰을 선택하도록 하여 부하를 자연스럽게 균형잡혔습니다.
2022년 이전 MoE는 왜 아직 주류가 아니었는가
이러한 공학적 해결책이 모두 갖춰져도 2022년의 MoE는 여전히 Google 사내의 "대기업의 장난감"이었습니다. 이유는 3가지입니다. 첫째, 비용 압력이 아직 충분히 강하지 않았습니다. GPT-3 시대에는 밀집 모델이 여전히 빠르게 진화하고 있었고, 추론 비용은 주요 제약 조건이 아니었습니다. 둘째, 개방형 에코시스템이 없었습니다. 고품질의 오픈 웨이트 MoE가 존재하지 않아 커뮤니티는 재현과 개선을 할 수 없었습니다. 셋째, 미세 조정이 어려웠습니다. 작은 데이터셋에서는 라우팅이 붕괴되기 쉬웠고, 다운스트림 작업에 대한 적응은 밀집 모델만큼 부드럽지 않았습니다.
이 3가지 조건이 2023년 말에 동시에 바뀌었습니다. Mixtral 8x7B (2023년 12월)가 최초의 고품질 오픈 MoE가 되었고, ChatGPT 규모의 트래픽이 추론 비용을 가장 절실한 문제로 만들었으며, DeepSeekMoE (2024년 1월)가 세분화된 전문가와 공유 전문가로 MoE의 비용 효율을 새로운 수준으로 끌어올렸습니다. 여기서부터 "현재"가 시작됩니다.
요약
이 장의 3가지 계보, 즉 프루닝·활성화 스파스성·조건부 계산은 2022년 이전에 전혀 다른 운명을 따랐습니다. 프루닝은 이론에서 성공했지만 하드웨어에서 실패했습니다. 활성화 스파스성(ReLU)은 어디서나 사용되었지만 거의 활용되지 않았습니다. 조건부 계산은 모든 것이 갖춰져 있었는데 경제적 압력만 부족했습니다. 이러한 운명의 차이를 이해하면 2023년 이후 승자가 가중치 프루닝이 아니라 MoE였던 이유를 알 수 있습니다. 스파스성을 실용화할 수 있는지는 그 0이 하드웨어가 활용할 수 있는 구조를 가지고 있는지에 따라 결정됩니다.
현재(2023년〜2026년 9월): LLM이 왜 스파스성에 전적으로 베팅했는가
2026년까지 최첨단 오픈 모델의 토큰당 활성화율은 1.5%〜4.5%까지 떨어지며, 스파스성은 FFN에서 어텐션, KV 캐시, 그리고 지식 저장 자체까지 확산될 것입니다. 이 장에서는 먼저 4가지 압력을 제시한 후, 5가지 유형의 스파스성을 순서대로 정리하고, 마지막으로 통일 이론과 경제 이야기로 진행합니다.
왜 지금인가: 4가지 압력
스케일링이 비용 벽에 부딪혔습니다. 총 파라미터는 1〜3T 영역에 도달했으며(DeepSeek-V4-Pro가 1.6T, Kimi K3가 2.8T), 밀집 모델의 학습과 추론은 경제적으로 성립하지 않게 되었습니다.
추론 비용이 학습 비용을 앞질렀습니다. 2025년 3월 1일의 추론 시스템 개요에서 DeepSeek은 노드를 넘는 대규모 전문가 병렬로 배치를 늘리고 GEMM의 효율을 높이고 있음을 공개했습니다. 추론의 경제성이 아키텍처 설계의 단일하고 가장 중요한 제약이 되었음을 보여줍니다.
에이전트가 워크로드를 "입력 중심"으로 만들었습니다. V4.1 기술 보고서는 서두에서 장시간 운영되는 에이전트의 보급에 따라 워크로드는 점점 더 입력에 지배당하며, 거대한 KV 캐시가 HBM과 SSD의 용량·전송 대역폭을 계속 압박하고 있다고 기술합니다.
수출 규제 하의 공학적 창의성. DeepSeek-V3는 2,048개의 H800으로 총 약 278만 8천 GPU 시간 동안 학습되었습니다. H800은 H100과 동일한 칩이지만 NVLink 대역폭이 900 GB/s에서 400 GB/s로 삭감되었으며, 이것이 DeepEP 같은 통신 최적화를 직접 촉발했습니다.
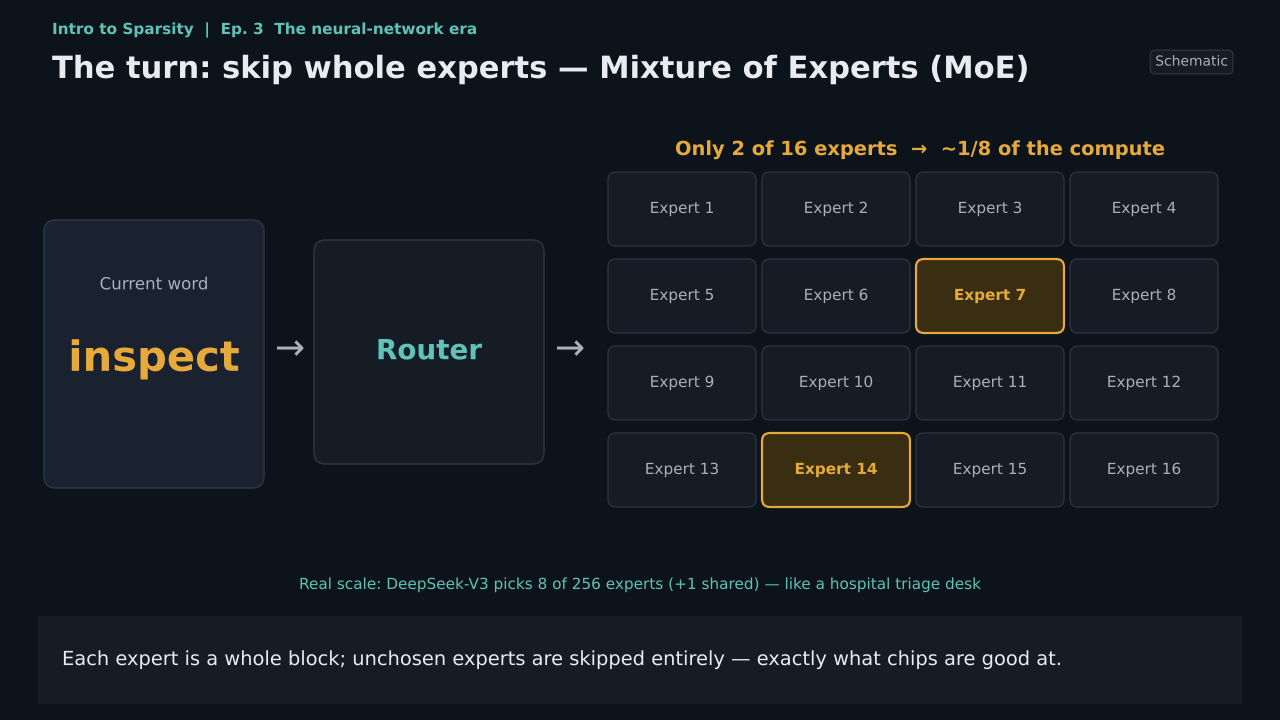
조건부 계산: MoE가 기본 아키텍처가 되다
DeepSeek 계열의 진화(모두 공식 기술 보고서·모델 카드·API 공시에서):
| 모델 | 시기 | 총 파라미터 / 토큰당 활성화 | 전문가 구성 | 주요 스파스화 기술 |
|---|---|---|---|---|
| DeepSeekMoE | 2024-01 | — | 세립 전문가 + 공유 전문가 | 전문가를 세밀하게 분할하여 조합 수를 지수적으로 늘림 |
| V2 | 2024-05 | 236B / 21B | 공유 2 + 라우팅 160 | MLA: KV의 저랭크 동시 압축(저랭크이지 스파스가 아님) |
| V3 | 2024-12 | 671B / 37B | 공유 1 + 라우팅 256, 8 선택 | 보조 손실 없는 부하 분산, 멀티토큰 예측, FP8 학습 |
| V3.2 | 2025-09/12 | 671B / 37B | 동상 | DSA: Lightning Indexer + 토큰 단위 top-k(k=2048)의 스파스 어텐션 |
| V4-Flash / V4-Pro | 2026-04-24 | 284B/13B、1.6T/49B | 공유 1 + 라우팅 256, 6 선택 / 라우팅 384 | Compressed Sparse Attention (CSA)와 HCA의 교대 배치, 1M 컨텍스트, FP4 전문가 |
| V4.1-Flash | 2026-09-10 | 백본 552B + Engram 196B, 프리필 8B / 디코드 16B | 공유 1 + 라우팅 384, 6 선택 | CED、CSA2、Hierarchical Sparse Indexer、FP4 KV、Engram |
V4.1-Flash의 5가지 설계 요소(기술 보고서):
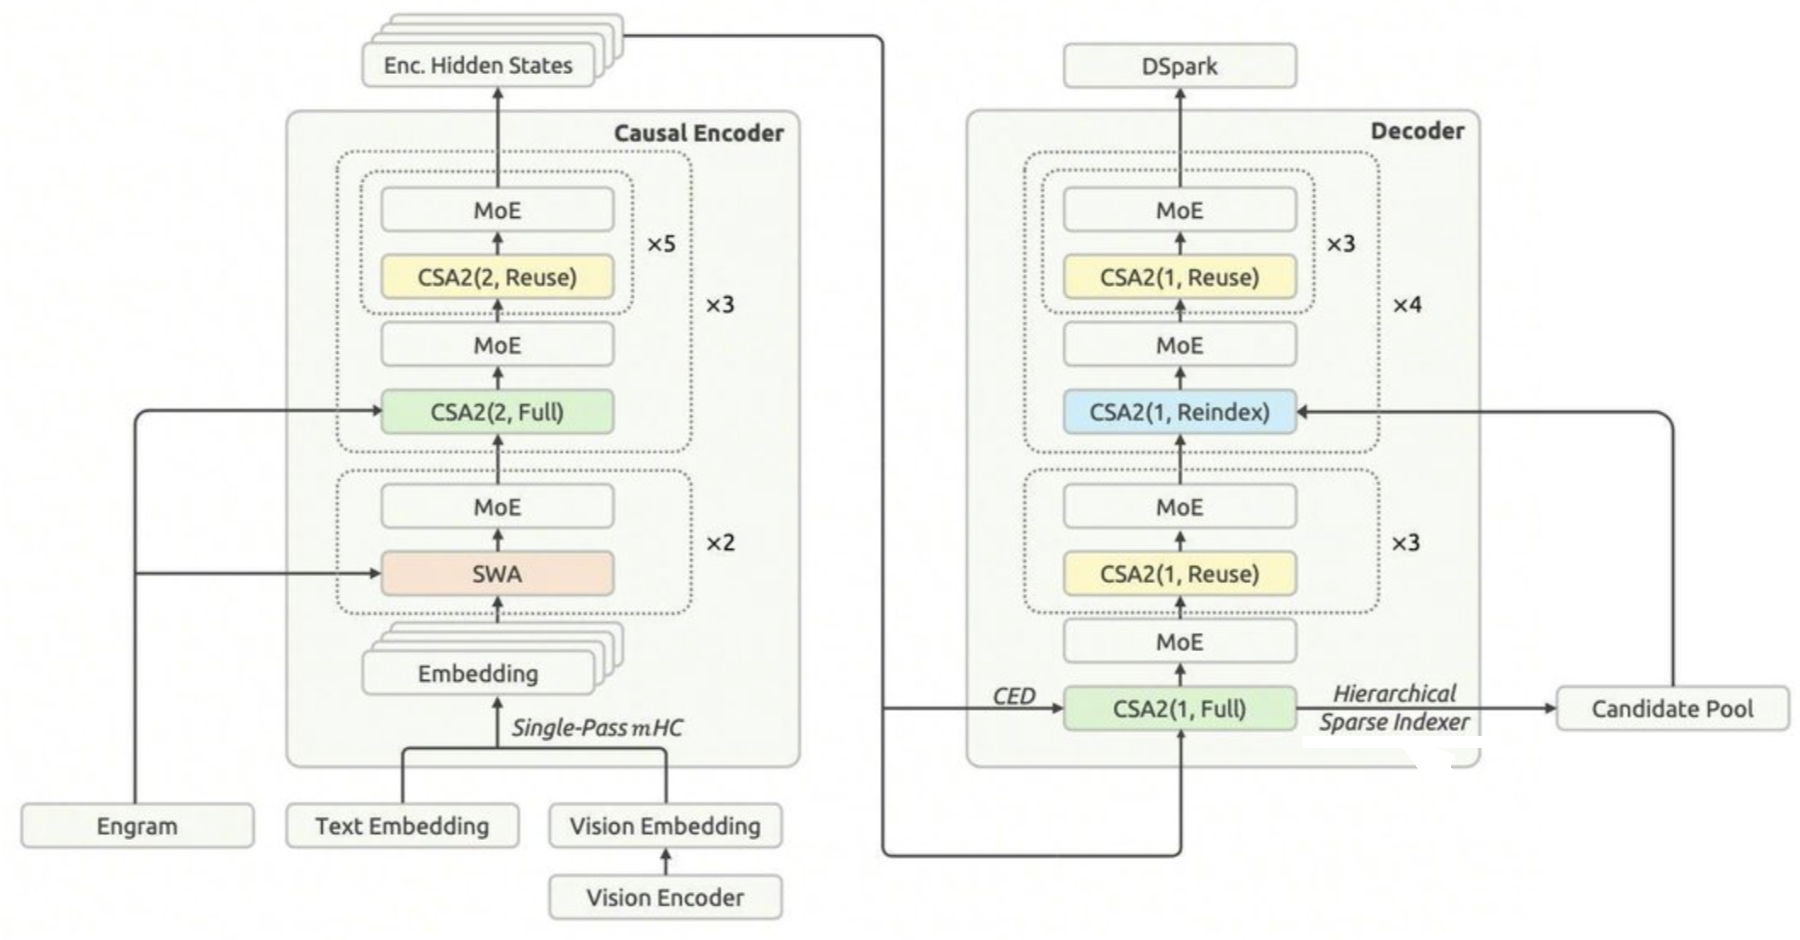
CED (Causal Encoder–Decoder). 40층을 20층의 인코더와 20층의 디코더로 분할하며, 디코더의 글로벌 KV는 인코더의 최종 은닉 상태에서 투영됩니다. 입력 토큰은 인코더만을 통과하고(활성화 8B), 출력 토큰은 디코더를 통과합니다(16B). "에이전트는 많이 읽고, 조금만 쓴다"는 현실에 대한 직접적인 대답입니다.
CSA2의 3가지 모드. Full은 자신의 글로벌 KV를 생성하고 인덱스를 구축합니다. Reindex는 이전 층의 KV를 재활용하면서 top-k를 재계산합니다. Reuse는 top-k 인덱스까지 그대로 재활용합니다. 대다수의 층은 Reuse입니다. 즉, 대다수의 층은 "토큰을 다시 선택하지 않습니다."
Hierarchical Sparse Indexer. 디코더의 첫 번째 Full 층이 후보 풀을 만들고, 이후의 층은 그 중에서만 선택합니다. 깊은 층에서의 인덱스 계산 비용이 컨텍스트 길이에서 분리됩니다.
KV의 수치. 글로벌 KV는 토큰당 890바이트로, V4-Flash의 약 1/4, V1의 1/437입니다. 지속되는 KV는 V4-Flash의 약 1/8입니다. 컨텍스트를 4K에서 1M으로(256배) 확대해도, 토큰당 디코드 FLOPs는 약 1/4만 증가합니다. 스파스 어텐션은 처음부터 64K에서 학습되었으며, 밀집 어텐션의 워밍업은 없습니다.
Engram 조건부 메모리. 약 196B 파라미터의 N그램 해시 테이블로, 토큰별 조회를 통해 스파스하게 접근되며, 호스트 메모리에 배치하여 프리페치할 수 있습니다. 모든 토큰에서 활성화되지는 않습니다.
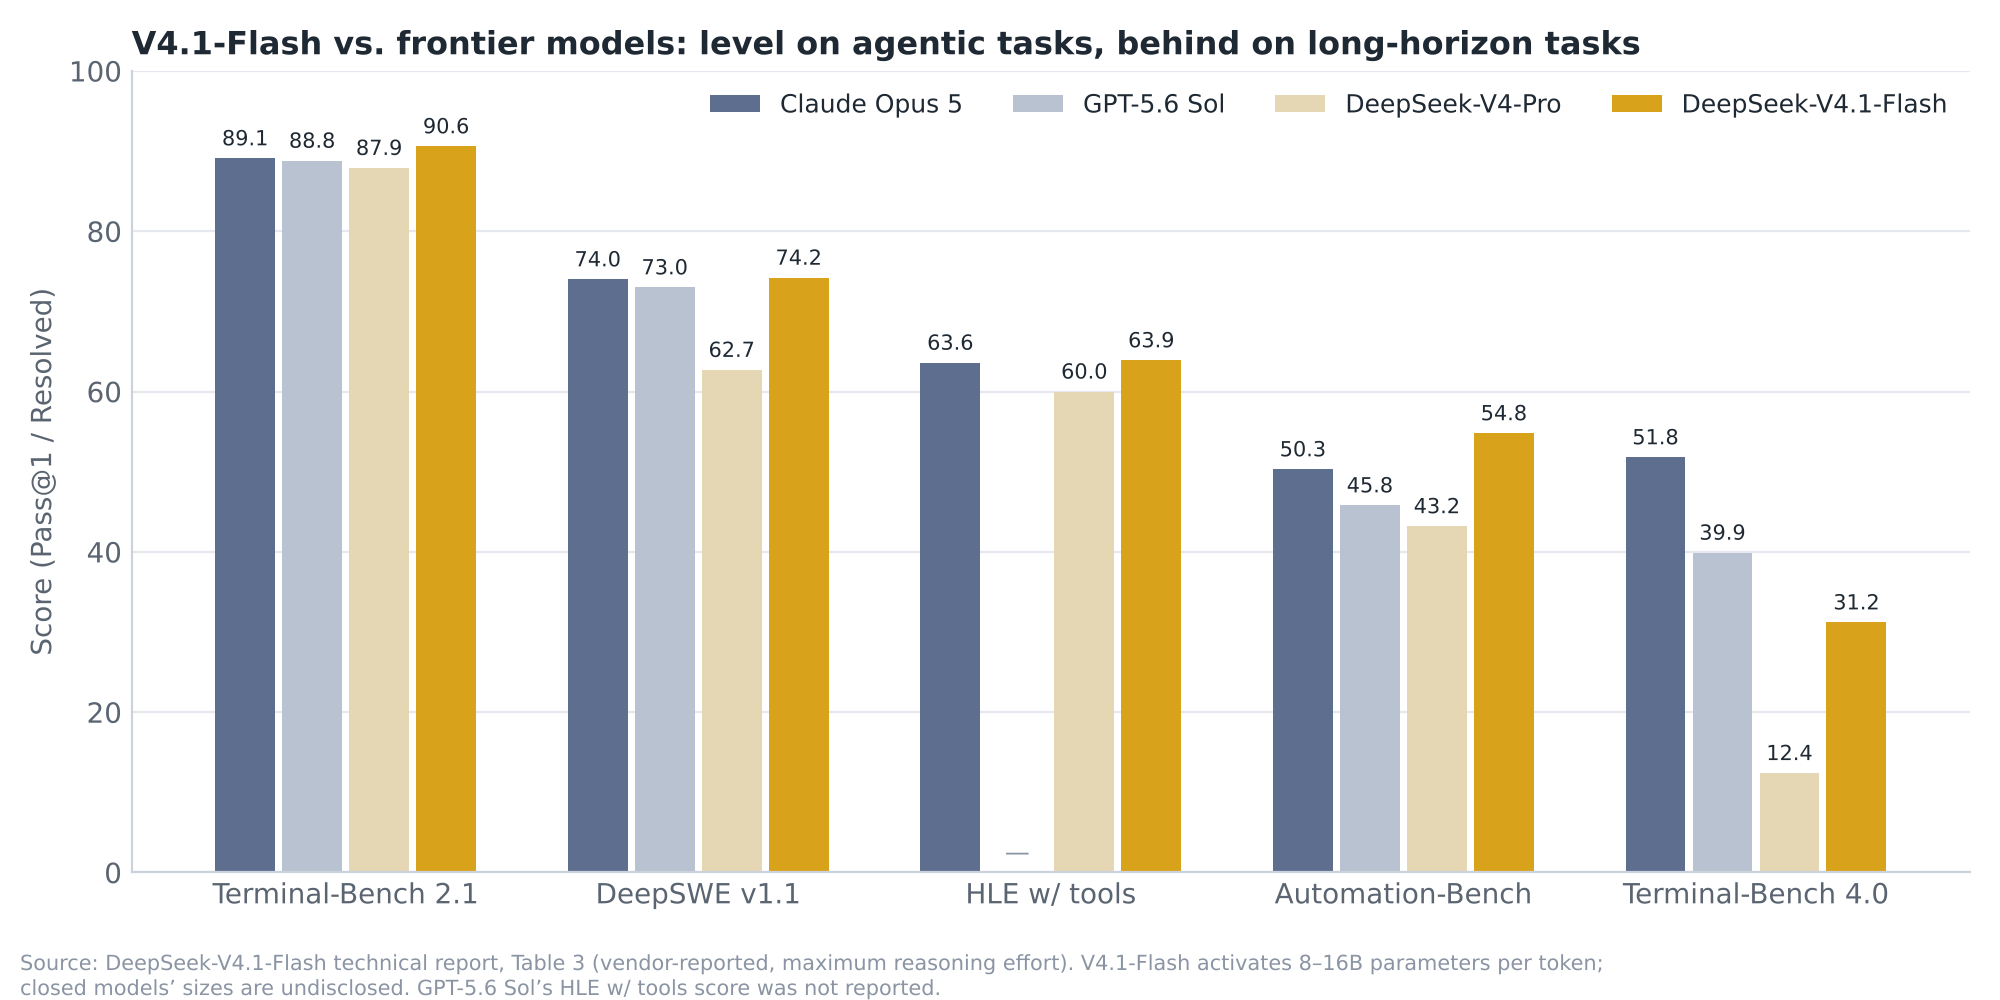
성능과 가격에 대하여. DeepSeek은 V4.1-Flash-Base가 V4-Pro-Base 수준에 총 파라미터 1/3·활성화 파라미터 1/4로 도달했다고 밝히고 있습니다. 피크 시간 가격은 입력 $0.30/M, 캐시된 입력 $0.006/M, 출력 $1.20/M이며, 비피크 시간은 반값입니다. 다만 제3자 종합 지표에서는(Artificial Analysis에서 40포인트, Claude Opus 5는 51포인트), 독립적 평가에서는 여전히 약 10포인트의 차이가 있습니다. 벤더가 선택한 벤치마크와 독립적인 종합 평가는 따로 기술해야 합니다. 이것 자체가 "평균은 사람을 속인다"는 살아있는 교훈입니다.
2025~2026년의 기타 주요 MoE 모델(공식 모델 카드에서):
| 모델 | 시기 | 총 / 활성화 | 전문가(선택 / 총 수) | 활성화율 | 기타 설계 특징 |
|---|---|---|---|---|---|
| Mixtral 8x7B | 2023-12 | 46.7B / 12.9B | 2/8 | 약 28% | 최초의 고품질 오픈 MoE |
| gpt-oss-120b | 2025-08 | 116.8B / 5.1B | 4/128 | 4.4% | MXFP4의 MoE 가중치, 슬라이딩 윈도우와 전체 어텐션의 교대 배치, attention sink |
| Qwen3-235B-A22B | 2025-04 | 235B / 22B | 8/128 | 9.4% | — |
| Qwen3.5-397B-A17B | 2026-02 | 397B / 17B | 10+1 / 512 | 4.3% | Gated DeltaNet 선형 어텐션을 3:1로 혼합, KV를 약 1/4로 축소 |
| Kimi K2 / K2.5 | 2025-07 / 2026-01 | 1.04T / 32B | 8+1 / 384 | 3.1% | MuonClip, 15.5T 토큰에서 손실 스파이크 없음 |
| Kimi K3 | 2026-07 | 2.8T / 104B | 16 / 896, 공유 2 | 3.7% | KDA 선형 어텐션 + Gated MLA, MXFP4 QAT |
| Llama 4 Maverick | 2025-04 | 약 400B / 17B | 1 + 공유 1 / 128 | 4.3% | 밀집 층과 MoE 층의 교대 배치 |
| DeepSeek-V4.1-Flash | 2026-09 | 552B / 8–16B | 6+1 / 384 | 1.4%–2.9% | 전술한 바와 같음 |
트렌드는 이렇습니다. 2년간 이 분야는 "8개 전문가에서 2개, 활성화 25%"에서 "수백~1,000에 가까운 전문가 중 6~16개를 선택, 활성화 1.5%~4.5%"로 이동했으며, 스파스의 정도는 대략 1~1.5년마다 1자릿수씩 증가하고 있습니다. 공유 전문가는 표준 기능이 되었으며, 라우팅에는 보조 손실 없는 편향, 해시 라우팅(V4의 첫 3층), 잠재 공간 라우팅(K3)이 사용됩니다. 클로즈드 모델에서는 Google이 Gemini 1.5 및 Gemini 2.5 계열이 스파스 MoE임을 공식 인정했습니다. GPT-4의 "1.8T MoE"는 2023년의 소문일 뿐이며, GPT-5.x와 Claude의 구성은 비공개입니다. 쓸 때도 "보도에 따르면" 정도가 한계입니다.
어텐션과 KV 캐시의 스파스화
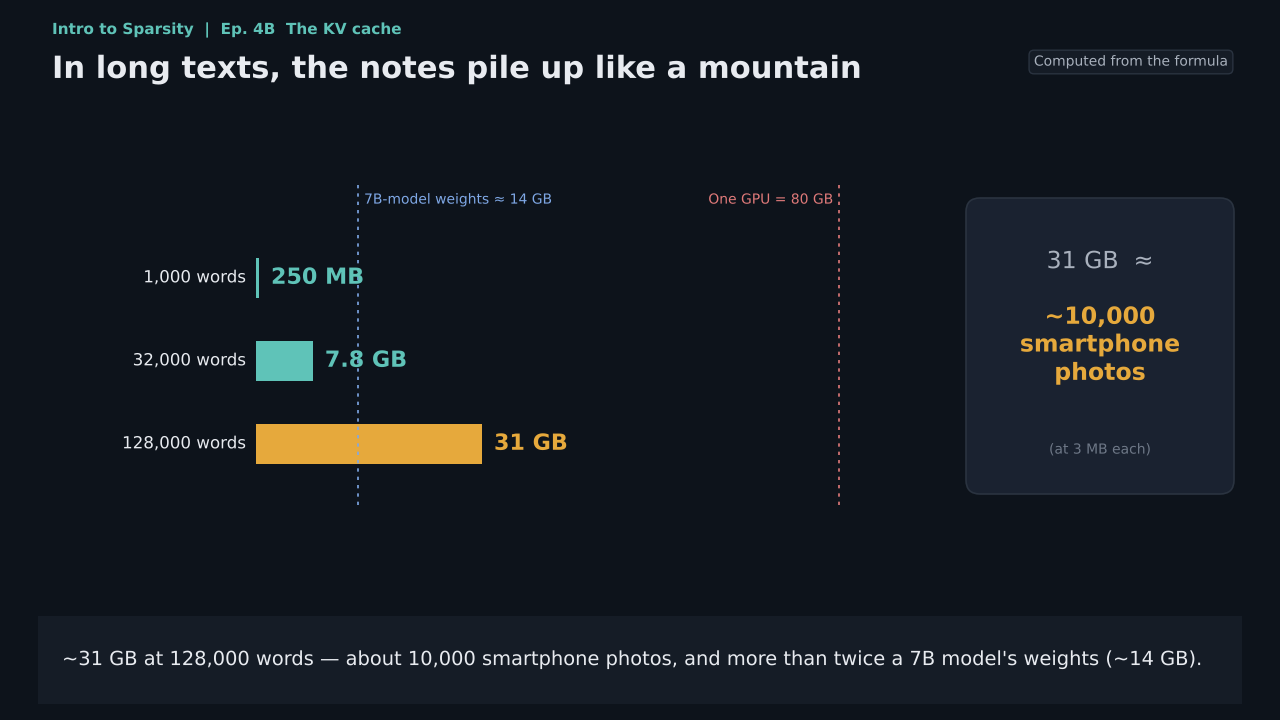
KV 캐시의 크기 = 2 × L × 층 수 × KV 헤드 수 × 헤드 차원 × 요소당 바이트 수. 64층, 8개 KV 헤드, 헤드 차원 128, FP16, 128K 컨텍스트를 대입하면 약 31 GiB가 됩니다. 많은 모델의 가중치보다 크고, 게다가 토큰 1개를 생성할 때마다 그 전체를 다시 읽어야 합니다. 대책은 3가지입니다. KV 헤드 수를 줄이기(GQA/MQA), 저랭크 압축(MLA), 그리고 스파스한 제거 또는 스파스한 계산입니다.
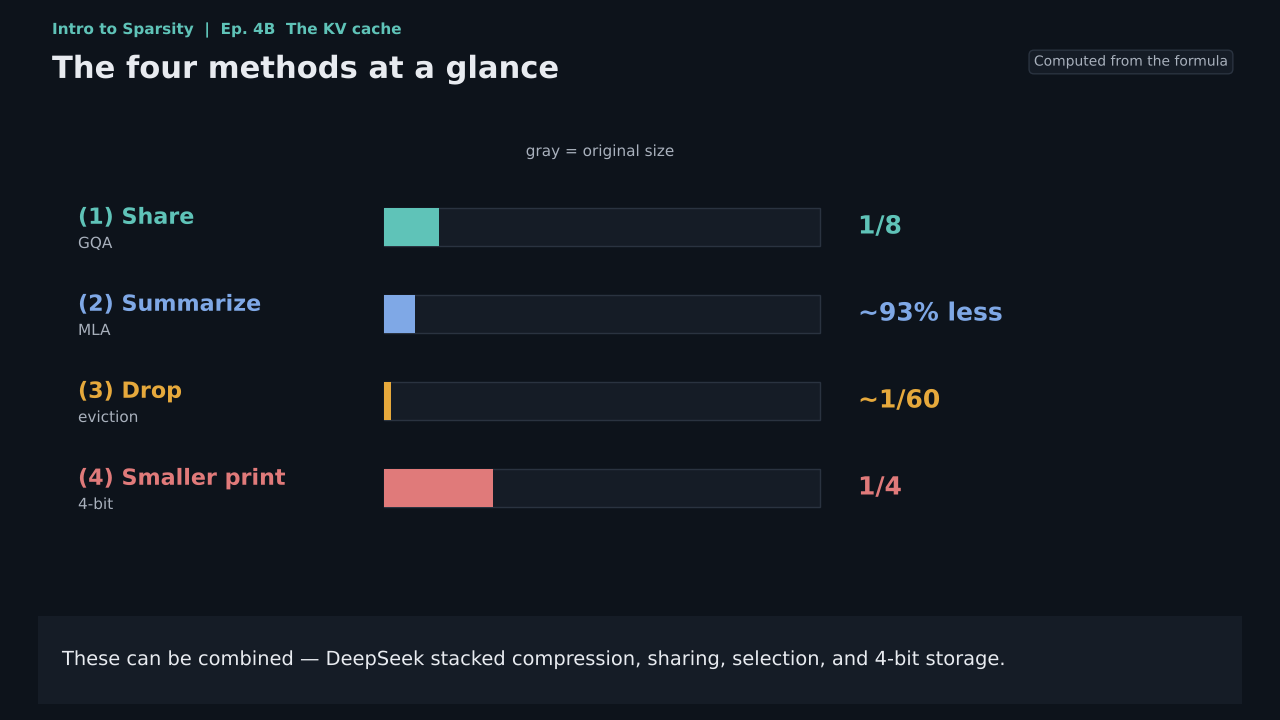
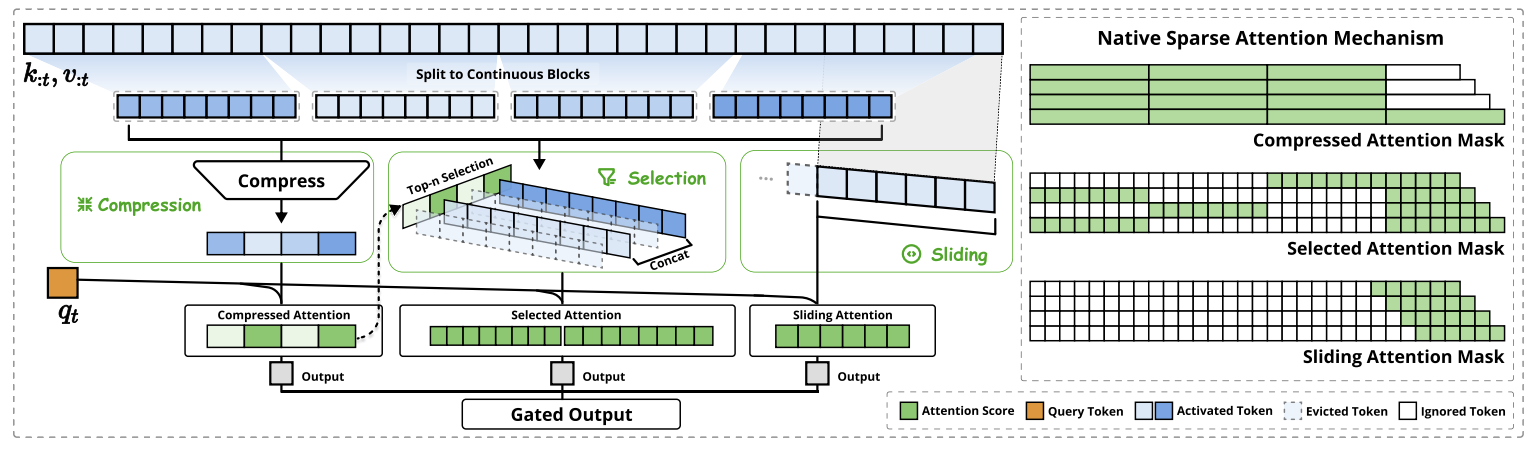
스파스 어텐션에는 3가지 세대가 있으며, 쌓을 수 있습니다. 제1세대는 고정 패턴(Longformer, BigBird, gpt-oss의 슬라이딩 윈도우). 제2세대는 재학습 불필요의 추론 시점 동적 제거(StreamingLLM, H2O, SnapKV, Quest). 제3세대는 학습 시부터 기본적으로 스파스성을 학습합니다(NSA, MoBA, DSA, CSA2). NSA(Yuan et al., DeepSeek×베이징 대학교×워싱턴 대학교)는 ACL 2025의 Best Paper Award를 수상했으며, 길이 64K에서 전체 어텐션 대비 디코드 11.6배, 순전파 9.0배, 역전파 6.0배의 고속화를 달성했습니다.
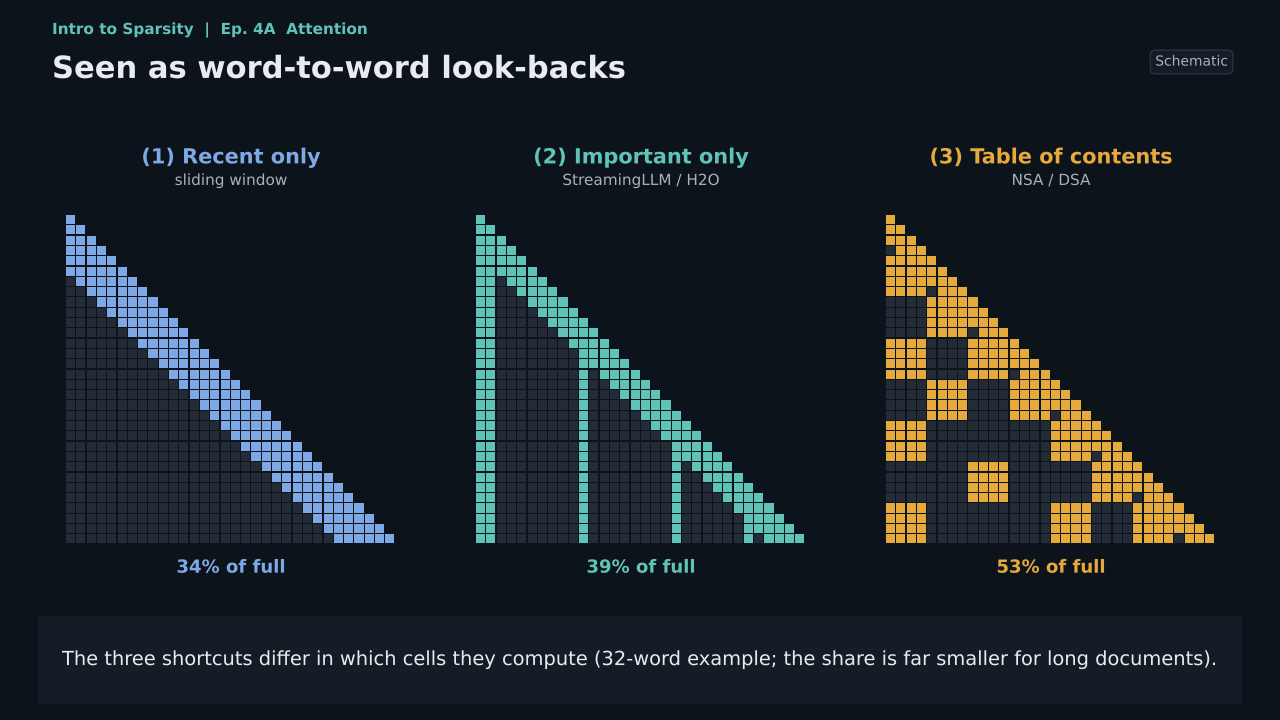
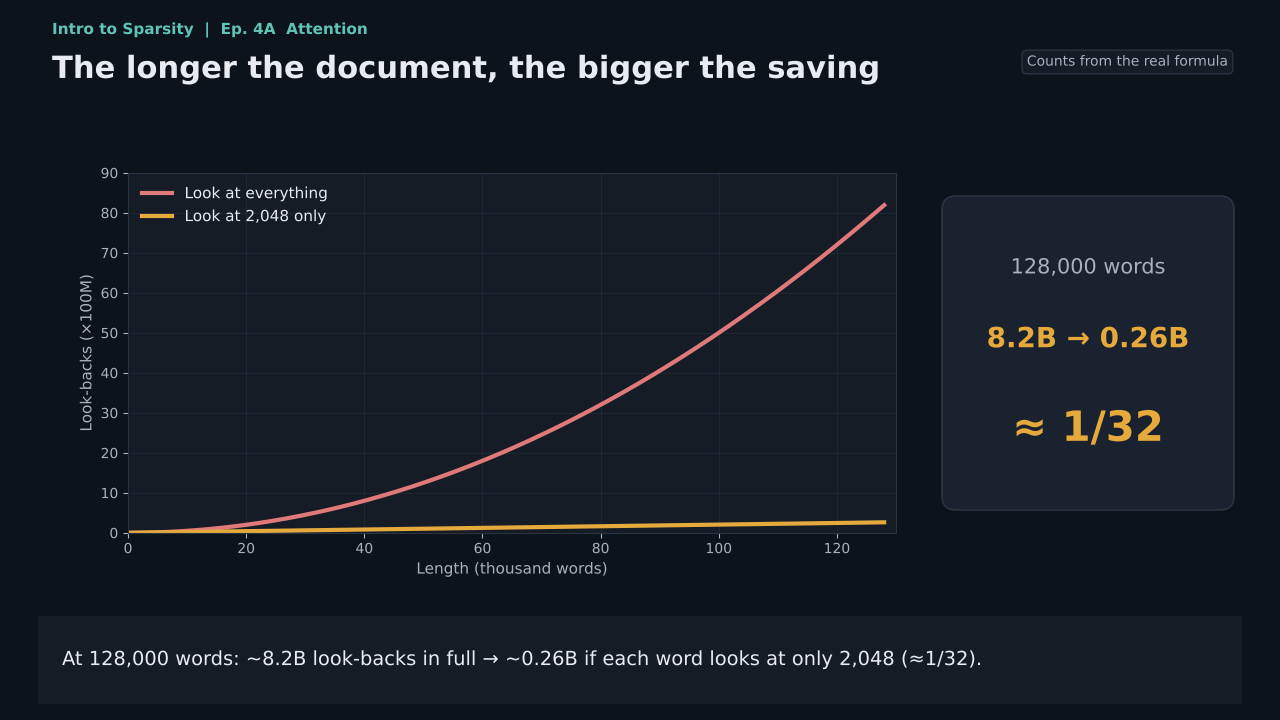
대규모 측정의 찬물. Nawrot et al.의 The Sparse Frontier (arXiv:2504.17768, 공식적으로는 ACL 2026의 Findings에 게재)는 학습 불필요의 스파스 어텐션을 Qwen2.5의 7B~72B, 16K~128K, 9개 태스크에서 평가하여 4가지 결론에 도달했다. 매우 긴 시퀀스에서는 "크고 스파스"가 "작고 밀집"을 이기며, 교점은 32~64K 근처에 있다. 프리필의 최적 스파스율은 0.80~0.93(예산으로 1/5~1/15)이고, 디코딩이 더 높은 내성을 보인다. 거의 모든 구성이 최소한 1개의 태스크에서 큰 성능 저하를 입는다. 스파스 어텐션은 만능약이 아니다. 그리고 모든 태스크와 단계에서 최적인 단일 전략은 존재하지 않는다. 이 결과가 바로 3세대의 "학습 가능한 네이티브 스파스성"을 낳은 동기이다.
활성화 스파스성
Q-Sparse (Wang, Ma, Wang & Wei, arXiv:2407.10969)는 모든 선형 레이어의 활성에 직접 top-k를 적용하고, STE로 역전파하며, 스파스성의 스케일링 법칙을 실증했다. 최적 스파스율은 전정밀 모델에서 약 45.58%, 1.58비트 모델에서 약 61.25%이며, 약 40% 스파스율에서 동일 크기의 밀집 모델에 필적한다. Mistral 7B를 40B토큰으로 추가 학습한 경우, Q-Sparse는 활성화 3.8B에서 63.7을 기록하여 밀집 베이스라인(7.0B)의 64.6에 근접했다. 절제 실험에서는 STE를 제거하거나 top-k를 ReLU로 대체하면 모두 명확한 성능 저하가 발생했다. 더구나 ReLU에서는 학습이 진행되면서 스파스율이 감소한 반면, top-k에서는 일정하게 유지되었다. 이는 "스파스성은 정칙화항이 아닌 아키텍처 제약이어야 한다"는 주장을 뒷받침한다. TEAL, ReLU Strikes Back, Deja Vu, PowerInfer가 엣지 측의 주요 계통이다.
해석 가능성에서의 스파스성: SAE의 융성과 의문
Anthropic의 발걸음은 다음과 같다. Towards Monosemanticity (2023)는 스파스 오토인코더를 사용하여 1층 모델에서 단의 특징을 추출했다. Scaling Monosemanticity (2024)는 Claude 3 Sonnet에서 최대 3,400만 특징의 SAE를 학습하고 Golden Gate Claude에서 특징의 클램프(고정)를 실증했다. Circuit Tracing과 On the Biology of a Large Language Model (2025)는 층 횡단 트랜스코더로 귀속 그래프를 구축하고 Claude 3.5 Haiku의 다단 추론을 추적했다. OpenAI에서는 Gao et al. (2024)이 GPT-4에서 1,600만 특징의 TopK SAE를 학습하고 있다. 이 계통은 Olshausen–Field 사전 학습의 직계 자손이다.
의문은 2024~2025년에 집중되어 나타났다. 특징의 흡수(Chanin et al. 2024). 1차원·비선형 특징(Engels et al. 2024). 113개의 프로빙 데이터셋에서 로지스틱 회귀 베이스라인을 이기지 못함(Kantamneni et al. 2025). SAE가 다르면 발견되는 특징도 다름(Leask et al. 2025). 2025년 3월, Google DeepMind의 기계적 해석 가능성 팀은 이 분야가 SAE에 과도하게 투자해왔다며 "SAE의 기초 연구 우선순위를 당면 낮추겠다"고 발표했다. 상대적으로 온건한 합의는 SAE는 미지의 개념 발견에는 적합하지만, 알려진 개념의 감지기나 제어기로서는 적합하지 않다는 것이다. 2026년에도 SharedSAE나 WriteSAE 같은 새로운 연구가 계속 나오고 있지만, 새로운 통일적 합의는 아직 나오지 않았다.
통일 이론: 3개의 연산자와 top-k의 학습
LASSO든 프루닝이든 SAE든 MoE 라우팅이든, "0을 만드는" 단계는 3개의 연산자 중 하나이다.
Sλ(y) = sign(y) · max(|y| − λ, 0), Hτ(y) = y · 1[|y| > τ], Pk(y) = 절댓값이 큰 상위 k 성분만 남기는 사영
소프트 임계값 처리는 L1의 근접 작용소이다(LASSO, ISTA, 웨이블릿 노이즈 제거, L1 페널티의 SAE). 하드 임계값 처리는 L0에 대응한다(크기 프루닝, JumpReLU SAE). 그리고 top-k는 k-스파스 벡터 집합으로의 사영이다(MoE 라우팅, 스파스 어텐션, TopK SAE, Q-Sparse). ReLU 자체는 τ=0의 편측 하드 임계값이다. 현대의 대규모 모델 거의 모두가 3번째를 사용하는 것은 토큰당 계산량을 정확한 상수에 고정할 수 있고, 정적인 메모리 계획과 전용 커널을 가능하게 하기 때문이다. 대규모 모델의 시대에 스파스성은 "정칙화항"에서 "아키텍처 제약"으로 변했다.
top-k는 미분 불가능하다. ∂TopK/∂s는 거의 모든 곳에서 0이므로, 기울기는 선택된 에키스퍼트의 게이트 가중치에만 전달되고 나머지는 학습할 수 없다. 공학적 대처는 4가지이다. 선택된 에키스퍼트에만 역전파하고 보조 부하 분산 손실을 더한다(주류 접근). Noisy Top-k로 노이즈를 더해 탐색을 만든다(Shazeer 2017). STE, Gumbel-Softmax, Soft MoE 같은 연속 완화. 그리고 DeepSeek-V3 이후의 보조 손실 없는 편향, 즉 s+b로 순위를 매기면서 가중치는 s로 하고, b는 부하에 따라 기울기 외부에서 조정하는 방법이다. 스파스 어텐션 측에서는, NSA는 기울기가 흐르도록 블록 레벨에서 선택하고, DSA는 먼저 밀집 어텐션으로 워밍업하여 인덱서를 밀집 어텐션 분포에 정렬한 후, 스파스 학습으로 전환한다.
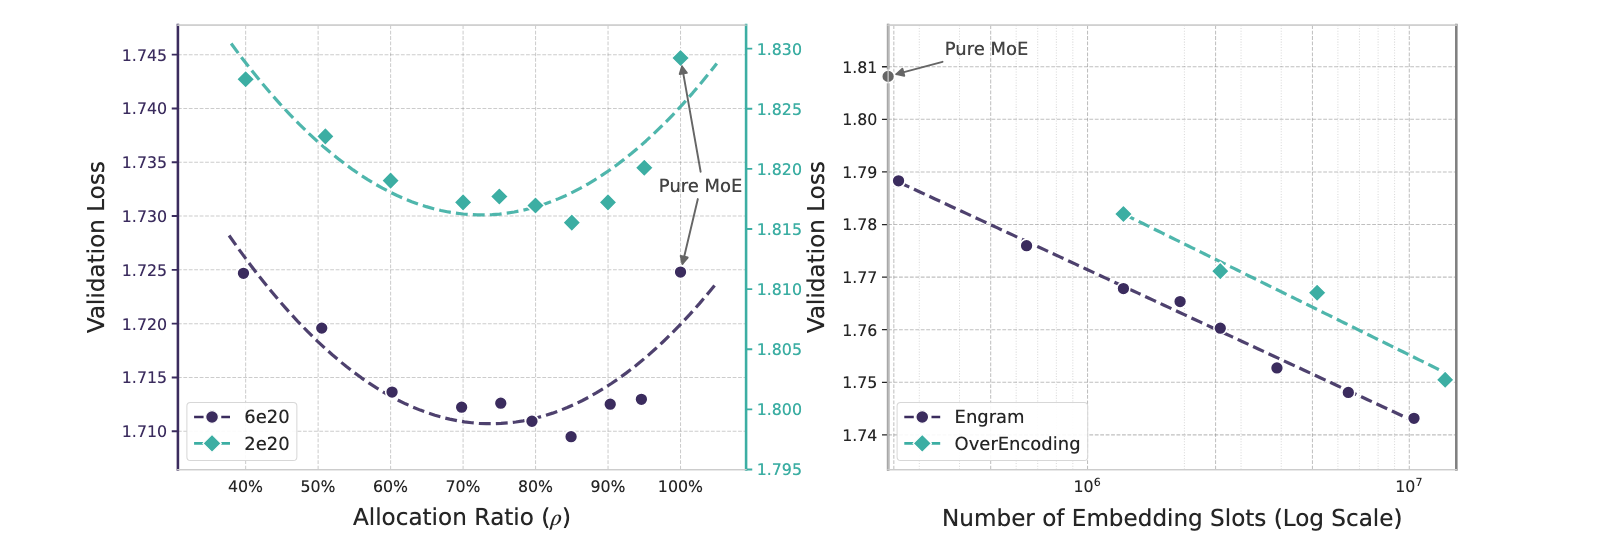
스케일링 법칙에 대해, Clark et al. (2022)는 라우팅된 모델의 스케일링을 통일하고 64~128 에키스퍼트를 권장했다. Krajewski et al. (2024)는 세분화된 에키스퍼트가 모든 계산 예산에서 밀집 모델을 이긴다는 것을 보였다. Frantar et al. (2023)는 최적의 가중치 스파스율이 데이터량과 함께 증가한다는 것을 발견했다. DeepSeek의 Engram 논문(arXiv:2601.07372, 2026년 1월)은 "스파스성 예산 배분"이라는 문제를 제시하고 U자형 법칙을 찾았다. 순수 MoE는 최적이 아니며, 스파스 파라미터 예산의 약 20~25%를 조건부 메모리에 배분했을 때 최고 성능이 나온다. 그 9개월 후, 이 발견은 V4.1이라는 제품에 통합되었다.
경제와 산업
DeepSeek 쇼크. 2025년 1월 27일, Nvidia는 약 17% 하락하여 마감했고, 시가총액 약 5,890억 달러(Bloomberg)~5,930억 달러(Reuters)가 사라졌다. 미국 주식시장 역사상 최대의 하루 시가총액 손실이다.
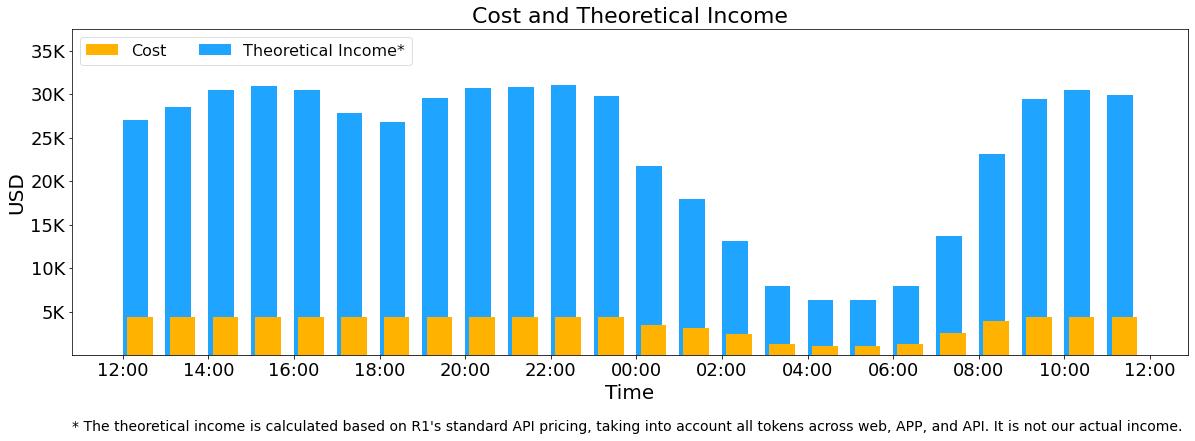
이론상 545% 이윤율. 2025년 3월 1일, DeepSeek은 H800을 시간당 2달러로 두면 하루 비용은 87,072달러이고, 모두를 R1 가격으로 청구했다고 가정한 경우의 이론상 하루 수입은 562,027달러라고 공개했다. 실제 수입은 훨씬 낮다는 것, 연구 개발비나 학습 비용은 포함되지 않는다는 것도 명시했다. 이 수치를 인용할 때는 반드시 "이론상"이라는 말을 붙여주기 바란다.
추론 가격. Epoch AI (2025년 3월)는 동일 능력 수준에서의 추론 가격이 연율 9배에서 900배 속도로 내려가고 있으며, 그 속도는 태스크에 따라 다르다고 지적했다. 그럼에도 기업의 총 지불액은 계속 증가하고 있다. 에이전트가 태스크당 호출 횟수를 몇 배로 늘리기 때문이다.
MoE 추론의 경제학. 메모리는 전체 파라미터로 결정되며, 큰 배치와 에키스퍼트 병렬처리가 있어야 각 에키스퍼트에 충분한 토큰이 분배된다. MoE는 본질적으로 대규모 집중식 서비스에 적합하고, 소규모 자체 호스팅에는 적합하지 않다. vLLM과 SGLang은 MLA, DSA, V4.1을 각각 공개 당일부터 지원했다.
각 연구 기관의 접근 방식의 체계적 비교
각 연구 기관을 동일한 기준으로 나열하면, 스파스화로의 길이 하나가 아니라 여러 전략이 병행하여 경쟁하고 있음을 알 수 있다.
| 연구 기관 | 구성의 공개 | 주요 스파스성의 종류 | 에키스퍼트(선택 / 총수) | 어텐션 전략 | KV 전략 | 가중치 포맷 | 대표 모델 | 두드러진 특징 |
|---|---|---|---|---|---|---|---|---|
| DeepSeek | 기술 리포트를 포함하여 공개 | MoE+스파스 어텐션+조건부 메모리 | 6/384+공유 1 | 네이티브 스파스(DSA→CSA2), 처음부터 스파스로 학습 | MLA 저랭크+FP4+층간 재사용, 890 B/토큰 | FP4/FP8 에키스퍼트 | V3, V3.2, V4, V4.1-Flash | 3축의 스파스성을 적층. 에이전트용 인코더·디코더 분업 |
| Moonshot (Kimi) | 가중치와 리포트를 공개 | MoE+선형 어텐션 하이브리드 | 16/896+공유 2 | 블록 스파스 MoBA. K3는 KDA 선형 어텐션+Gated MLA | 선형 레이어에는 KV 없음 | MXFP4 QAT | K2, K2.5, K3 | 최대의 에키스퍼트 수. MuonClip을 사용한 안정적 학습 |
| Alibaba (Qwen) | 모델 카드를 공개 | MoE+선형 어텐션 하이브리드 | 10/512+공유 1 | Gated DeltaNet과 Gated Attention을 3:1로 | KV를 약 1/4로 축소 | BF16/FP8 | Qwen3, Qwen3.5 | 엣지부터 플래그십까지의 풀 시리즈 |
| Meta | 모델 카드를 공개 | MoE | 1/128+공유 1 (Maverick) | 밀집 레이어와 MoE 레이어의 교대 배치. iRoPE | 표준 GQA | BF16 | Llama 4 | 10M 컨텍스트(Scout). Behemoth는 미공개 |
| OpenAI | gpt-oss만 공개 | MoE | 4/128 | 슬라이딩 윈도우(128)와 전체 어텐션의 교대 배치. attention sink | GQA, 8 헤드 | MXFP4 | gpt-oss-120b/20b | GPT-5.x는 비공개. SAE 연구(Gao 2024) |
| Gemini 1.5와 2.5가 MoE라는 것은 공식적으로 확인되었습니다. 세부사항은 비공개입니다. | MoE. 엣지 향 비유연한 구조입니다. | 비공개 | 비공개 | 비공개 | 비공개 | Gemini 1.5/2.5, Gemma 3n | MatFormer의 중첩 부분모델, PLE | |
| Anthropic | 비공개 | 해석가능성을 위한 희소성(SAE, 트랜스코더) | 비공개 | 비공개 | 비공개 | 비공개 | Claude 시리즈 | 희소성을 "모델을 이해하는" 도구로 사용합니다. |
| Mistral | 가중치 공개 | MoE | 2/8 | 표준 | GQA | BF16 | Mixtral 8x7B/8x22B | 첫 번째 고품질 오픈 MoE(2023년 12월) |
| Microsoft Research | 논문 공개 | 활성화 희소성 + 1.58비트 | — | 표준 | 표준 | 1.58비트(BitNet) | Q-Sparse, BitNet b1.58 | 희소성과 극도로 낮은 비트 양자화의 조합 |
| Meituan / Ant / Zhipu | 모델 카드 공개 | MoE의 변형 | 다양함 | 다양함 | 다양함 | 다양함 | LongCat-Flash, Ling, GLM-4.5/4.6 | 계산 제로 전문가, 숏컷 연결 MoE |
여기서 세 가지 관찰이 나옵니다. 첫째, 희소 아키텍처 혁신의 주요 원천은 중국의 오픈 모델 진영입니다. 세분화된 전문가, 공유 전문가, 보조 손실 없는 로드 밸런싱, 네이티브 희소 어텐션, 조건부 메모리, 선형 어텐션 하이브리드는 거의 모두 DeepSeek, Qwen, Kimi가 처음 발표했습니다. 둘째, 주요 폐쇄형 연구기관의 구성은 블랙박스이며, GPT-OS나 Gemini의 보고서 같은 공개 정보에서만 추측할 수 있습니다. "GPT-4는 1.8T의 MoE"를 사실로 인용하는 것은 흔한 오류입니다. 셋째, 어텐션은 두 가지 방향으로 나뉩니다. DeepSeek은 "희소 어텐션"(토큰 쌍의 일부만 계산하는)을 선택했고, Qwen과 Kimi는 "선형 어텐션 하이브리드"(KV 캐시를 재귀적 상태로 대체하는)를 선택했습니다. 둘 다 KV 캐시의 메모리와 대역폭이라는 같은 문제를 다루고 있지만, 수학적 도구가 다릅니다. 전자는 희소이고 후자는 저순위 재귀에 가깝습니다.
시스템 스택: 희소성을 실제로 동작시키는 엔지니어링
희소 아키텍처의 이득이 실제로 실현되는지 여부는 간과되기 쉬운 계층, 즉 시스템 소프트웨어에 의해 결정됩니다.
전문가 병렬 처리와 통신. DeepEP(DeepSeek이 2025년에 공개)는 FP8과 NVSHMEN 상의 RDMA를 지원하는 높은 처리량, 낮은 지연시간의 all-to-all 커널을 제공하여 통신과 계산을 오버래핑합니다. MegaBlocks(2023)은 MoE 계산을 블록 희소 GEMM으로 다시 작성하여 드롭리스 MoE를 실현했으며, 밀집된 Megatron-LM 대비 2.4배의 속도를 달성했습니다.
어텐션 커널. FlashMLA는 MLA에 최적화되어 있습니다. DSA와 CSA2는 인덱서와 희소 어텐션의 커널이 갖춰져 있어야 하며, DeepSeek은 FlashMLA와 DeepGEMM으로 공개했습니다. V4.1의 CSA2 3모드는 추론 엔진이 KV와 인덱스의 층간 재사용을 관리해야 함을 의미합니다.
추론 프레임워크. vLLM과 SGLang은 MLA, DSA, V4.1-Flash를 공개 당일부터 지원하며, H100/H200/B200/GB200과 AMD MI355X를 커버합니다. NVIDIA NeMo AutoModel은 V4.1의 파인튜닝 레시피를 제공하며, 단일 NVLink 도메인 내 64개 GPU가 필요합니다.
계층형 스토리지. V4.1의 Engram 테이블(약 183 GiB)은 호스트 메모리에 배치되며, RDMA를 통해 프리페치되도록 설계되어 있습니다. Engram을 CXL 메모리 풀에 보관하고 "지식"을 HBM에서 더 저렴한 계층으로 옮기는 논문도 이미 나왔습니다. SWA Bounded Replay는 슬라이딩 윈도우 KV의 SSD 지속성을 회피합니다.
양자화 포맷. MXFP4(32개 요소마다 8비트의 공유 스케일 1개, 평균 4.25비트)는 2025~2026년에 MoE 전문가 가중치의 사실상 표준이 되었습니다. Blackwell은 FP4 텐서 코어를 기본적으로 지원합니다.
이 섹션의 결론은 "신경망 시대"와 울려 퍼집니다. 희소성의 승리에는 항상 그에 걸맞는 커널과 스케줄링이 따랐습니다. 2:4 희소성이 보급되지 않은 것은 텐서 코어가 있어도 성숙한 엔드-투-엔드 소프트웨어 스택이 부족했기 때문입니다. MoE가 주류가 된 것은 DeepEP, MegaBlocks, vLLM이 있었기 때문입니다.
희소성과 심층 학습이 만나는 장소: 이미지·신호 처리의 최근 진전
대규모 모델이 계산 절약을 위해 희소성을 사용한 반면, 이미지·신호 처리는 다른 길을 걸었습니다. 희소 사전분포를 심층 네트워크와 결합하여 불완전하고 노이잡한 측정으로부터 신호를 복원하는 길 말입니다. 그 성과는 역방향으로도 흘러, 대규모 모델의 해석 방식과 아키텍처 설계를 바꾸고 있습니다.
알고리즘 전개: 반복 희소 솔버를 네트워크로 변환
출발점은 Gregor과 LeCun(2010)의 LISTA입니다. ISTA의 고정된 반복을 유한한 층수를 가진 네트워크로 "전개(unroll)"하고, 그 매개변수를 학습 가능하게 합니다. 각 계층은 여전히 "선형 변환 + 소프트 임계값 처리"이지만, 행렬과 임계값은 데이터에서 학습됩니다. 결과는 손으로 튜닝한 ISTA보다 1~2자릿수 빠르게 수렴하면서도 해석 가능한 구조를 유지합니다. 각 계층이 근접 경사도법의 1 스텝에 대응하기 때문입니다. 알고리즘 전개는 그 후 계산 이미징의 주류 프레임워크가 되었습니다. ADMM-Net과 ISTA-Net은 압축 센싱 MRI 재구성에 사용되며, 전개된 네트워크는 임상 언더샘플링 데이터에서 고전적인 CS 기법을 능가합니다. 전개의 더 깊은 의의는 심층 네트워크가 희소 솔버의 학습 가능한 버전으로 읽을 수 있음을 보여준 점에 있습니다. 이 통찰력은 나중에 희소 사전으로 신경망을 해독할 때의 직관을 제공했습니다.
플러그 앤 플레이 사전분포와 노이즈 제거를 통한 정규화
고전적인 정규화(L1, 전변동)는 사전분포를 명시적인 페널티 항으로 작성합니다. 2013년 이후에 나타난 플러그 앤 플레이(PnP) 프레임워크는 ADMM이나 근접 경사도법의 "근접 작용소를 적용하는" 단계가 임의의 노이즈 제거기, 즉 학습된 심층 노이즈 제거 네트워크로 대체될 수 있음을 발견했습니다. 사전분포는 "하나의 공식"에서 "블랙박스 노이즈 제거기"로 변했으며, 희소 사전분포는 그 특수한 경우 중 하나가 되었습니다. Regularization by Denoising(RED)과 나중의 확산 모델 사전분포가 이 계보를 이어받고 있습니다. 이러한 관점에서 보면 소프트 임계값 처리를 통한 노이즈 제거, BM3D, 심층 노이즈 제거기는 같은 위치에 끼워 넣을 수 있는 3세대의 교환 부품입니다.
Deep Image Prior: 네트워크의 구조 자체가 사전분포
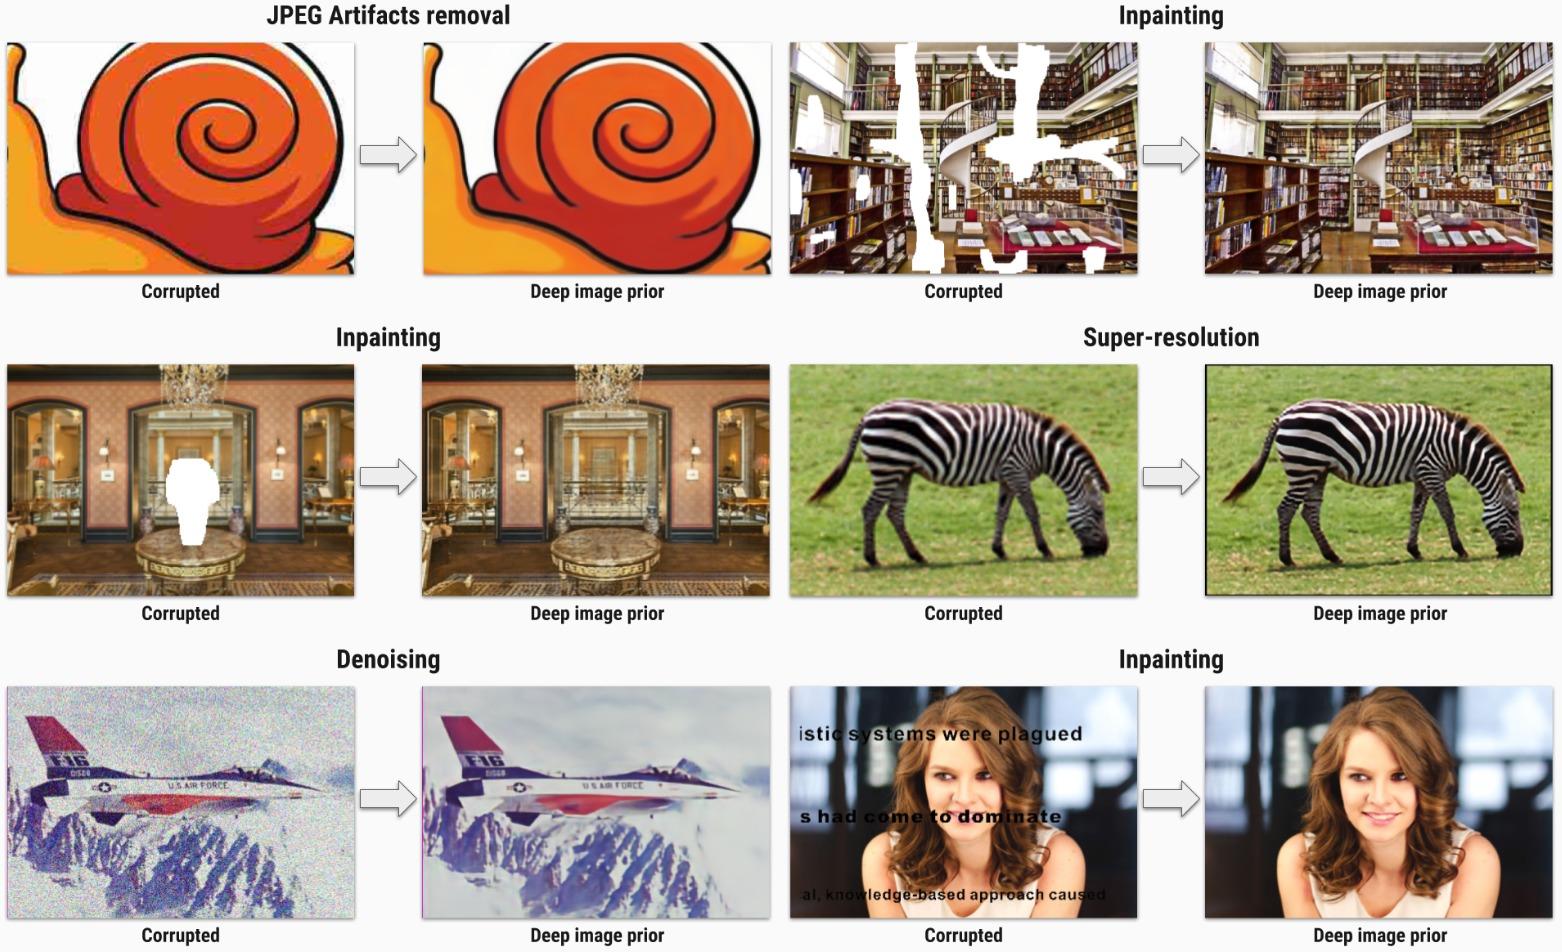
Ulyanov, Vedaldi, Lempitsky(2018)의 Deep Image Prior는 직관에 반하는 결과를 가져왔습니다. 무작위로 초기화된 미학습 합성곱 네트워크를 열화된 1장의 이미지에 피팅하기만 해도 노이즈 제거·초해상도·인페인팅이 가능한 것입니다. 합성곱 네트워크의 구조는 자연 이미지의 저주파에서 자기유사적인 통계를 선호하며, 노이즈에 대한 피팅은 느리므로, 조기에 중지하면 깨끗한 이미지를 얻을 수 있습니다. 이는 "전사"에서 논의된 자연 이미지 통계와 직결됩니다. 네트워크의 구조가 "자연 이미지는 어떤 기저 아래에서 희소하다"는 사전분포를 암묵적으로 부호화하고 있으며, 차이점은 그 기저가 더 이상 명시적으로 쓰여지지 않는다는 것뿐입니다. DIP 이후, "구조 자체가 사전분포"라는 개념은 신경망의 귀납 편향을 이해하는 중요한 렌즈가 되었으며, 고전 희소 이론으로의 다리가 되었습니다. DIP는 암묵적이고 학습 가능한 "프레임"으로 같은 일을 적응적으로 수행하는 기법, 즉 신호의 구조를 정말로 나타내는 성분만을 남기는 기법으로 볼 수 있습니다.
학습된 사전과 구조화된 프레임
고정된 웨이블릿, K-SVD가 학습하는 비구조적 사전, 심층 네트워크가 학습하는 암묵적 사전분포 사이에는 중간의 길이 있습니다. 타이트 프레임이나 유니터리 변환의 수학적 구조(완전 재구성, 에너지 보존)를 유지하면서 그 매개변수를 데이터에서 학습하는 길입니다. 비분리형 방향성 대칭 중복 변환(NSOLT)과 격자 구조 유니터리 네트워크(LSUN)가 이 카테고리에 속합니다. 변환을 타이트 프레임의 다양체로 제한하고 격자 구조로 매개변수화함으로써, 고전 변환의 해석 가능성과 가역성을 유지하면서 특정 데이터에 대한 적응성을 획득합니다. 이 길의 가치는 대규모 모델의 시대에 재발견되고 있습니다. SAE는 과완전 사전을 필요로 하며, MLA는 가역적 저순위 사영을 필요로 합니다. 둘 다 구조적 제약과 데이터에 대한 적응성의 균형을 모색하고 있으며, 그것은 정확히 구조화된 프레임이 오래전부터 직면해온 설계 문제입니다.
대규모 모델과의 3가지 접점
첫째, SAE는 희소 부호화 자체입니다. Anthropic의 희소 자동인코더는 Olshausen–Field 사전 학습과 수학적으로 동일하며, 변한 것은 데이터뿐입니다. 이미지 패치에서 잔차 스트림의 활성으로. 둘째, 알고리즘 전개는 "네트워크 = 솔버"라는 읽기를 선취했습니다. Anthropic의 트랜스코더와 귀속 그래프는 본질적으로 Transformer에 대한 희소하고 읽기 쉬운 대체 계산 그래프의 탐색입니다. 셋째, 구조적 사전분포라는 발상은 아키텍처 설계에 파고들었습니다. MoE의 전문가 블록, CSA2의 층간 재사용, Engram의 룩업 테이블은 모두 "데이터는 이 구조를 가져야 한다"는 믿음을 손실 함수가 아니라 네트워크의 형태 자체에 써 넣고 있습니다. 이는 "통일 이론" 섹션의 결론의, 이미지 처리 세계에서의 대응물입니다. 희소성은 정규화 항에서 아키텍처의 제약으로 전환되었습니다.
응용: 희소성이 정말 가치를 만든 곳
희소성은 처리해야 할 것이 방대하고 정말 중요한 것이 극히 적은 곳에서 가치를 만듭니다. 장문서 검토는 그 가장 전형적인 예 중 하나입니다.
클라우드에서의 LLM 추론. 2026년 저가 프론티어 API의 거의 모든 것이 고도로 스파스한 MoE 모델에서 나온다. DeepSeek-V3.1-Flash의 비피크 출력은 $0.60/M, gpt-oss-120b는 OpenRouter에서 입력 약 $0.03/M, 출력 약 $0.17/M이다.
긴 컨텍스트와 에이전트. V3.1 발표에서 DeepSeek은 에이전트 비용의 대부분이 캐시 히트 청구로 차지되는 경우가 많으며, 캐시 압축으로 이 부분을 크게 줄일 수 있다고 명시했다. 캐시된 입력 가격($0.006/M)은 캐시 미스 가격($0.30/M)의 1/50이며, 이것이 에이전트 경제성의 핵심 레버이다.
엣지. Apple의 LLM in a Flash (2023)는 스파스하게 활성화되는 파라미터를 플래시 스토리지에서 필요시 로드한다. Gemma 3n은 MatFormer의 중첩 서브모델과 계층별 임베딩(PLE)을 사용한다. Qwen3.5-35B-A3B 같은 활성화 3B의 MoE 모델은 브라우저와 엣지의 후보가 되고 있다.
멀티모달. V3.1은 이미지 토큰에 전용 라우팅 바이어스를 준다. 시각 토큰은 수가 많고 중복성이 높아 스파스 어텐션의 이상적인 대상이다.
과학과 의료. CS-MRI는 일상 임상 평균 스캔 시간을 약 20%, 단일 시퀀스에서는 23%~43% 단축했다. EHT의 블랙홀 이미징을 지원한 SMILI 파이프라인은 스파스 모델링 위에 구축되었다.
장문서·도면의 엔터프라이즈 심사(우리 사업과 직결)
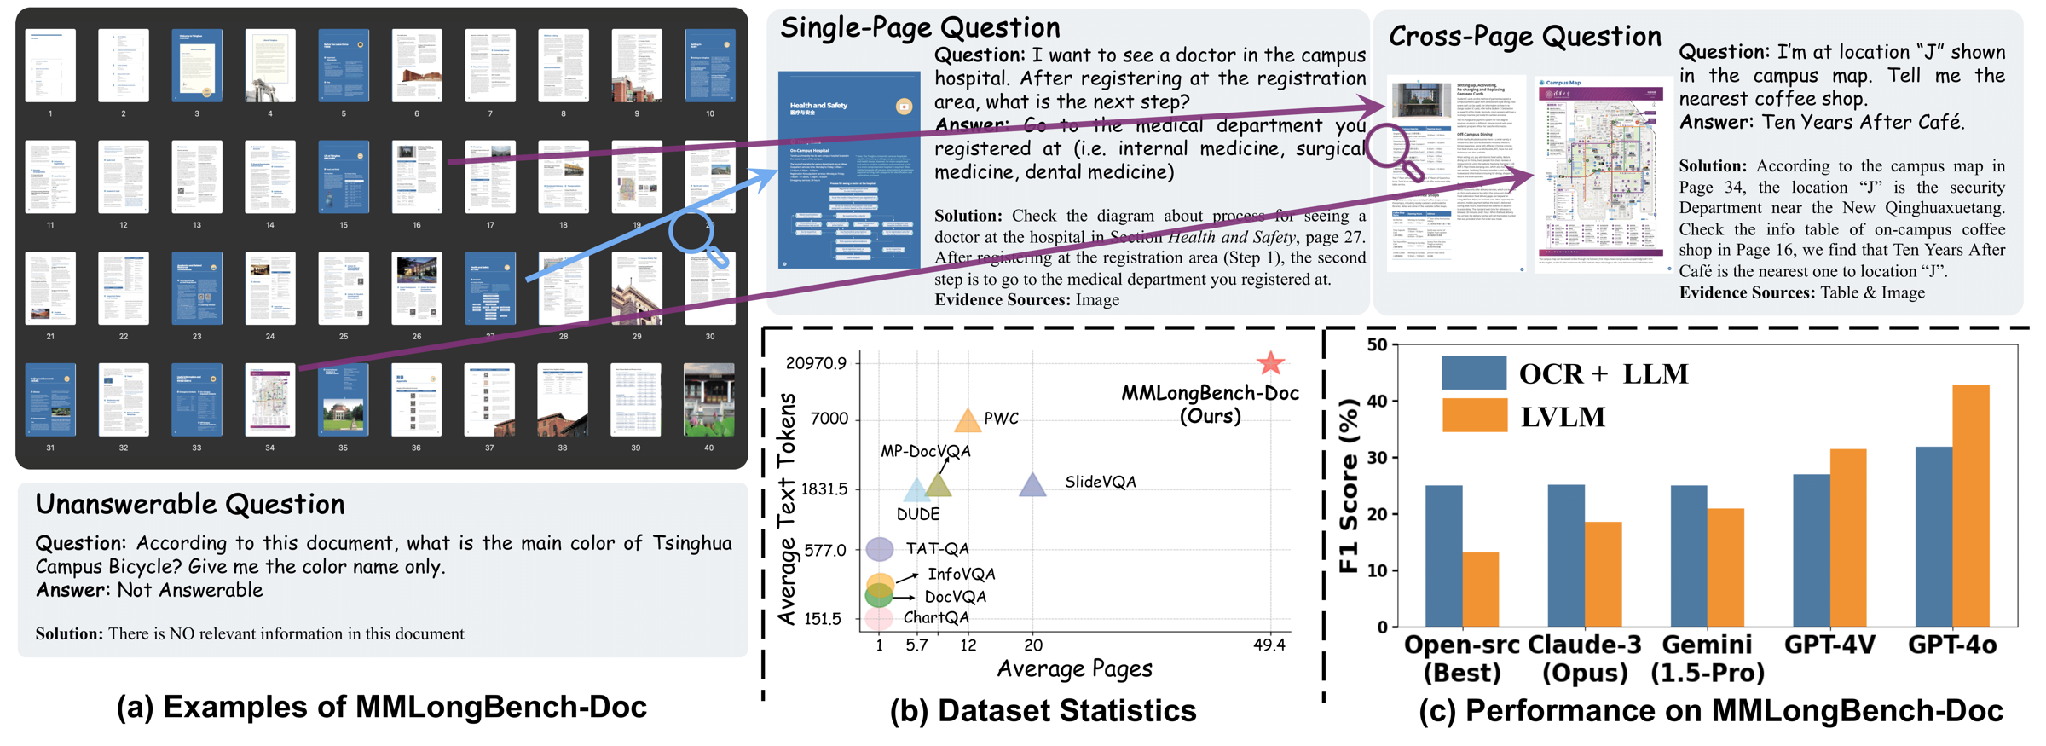
난이도의 기준이 되는 벤치마크. MMLongBench-Doc (NeurIPS 2024 D&B)는 평균 47.5페이지·텍스트 약 21,000토큰의 PDF 135개를 수집하고 전문가가 작성한 1,082개의 질문을 기록했다. 이 중 33.2%는 페이지 간 증거를 필요로 하고, 22.8%는 환각을 감지하기 위해 답변 불가능하도록 설계되었다. 인간 주석자의 F1은 66.0%이고, 14개의 시각 언어 모델 중 12개는 OCR 텍스트를 해당 텍스트 전용 모델에 제공한 경우보다 성능이 떨어진다. LongDocURL의 396개 문서는 평균 86페이지이고, 질문의 52.9%가 페이지 간이다. 이러한 문서의 길이와 페이지나 요소를 포함한 질문의 비율은 건축 허가 신청(수십 페이지에서 100페이지를 훨씬 넘는 도면·구조 계산서·신청 서류)과 매우 유사하다.
병목은 컨텍스트 길이만이 아니다. 분산된 증거 중에서 올바른 top-K를 선택하는 것이다. 검색(top-K 페이지 선택)과 스파스 어텐션(top-K 토큰 블록 선택)은 수학적으로는 같은 연산자다. 차이는 그 선택이 모델 외부에서 일어나는가(감사 가능하고 조문을 인용 가능한), 아니면 내부에서 일어나는가(엔드투엔드이지만 불투명한)이다.
한계. Sparse Frontier는 중간 정도의 스파스율에서도 스파스 어텐션이 개별 작업 성능을 저하시킬 수 있음을 보여준다. 심사 업무의 "X조가 37페이지에 기재된 치수와 모순된다"는 정확히 "1개를 놓치면 전체 답이 잘못되는" 작업이다. 따라서 한쪽에 거는 것보다 검색과 긴 컨텍스트에서의 재검증 하이브리드가 더 안전하다. SimpleDoc, MDocAgent, LAD-RAG를 포함한 2025년의 여러 페이지 문서 연구도 이 경로를 취하고 있다.
이점과 비용
가중치 스파스성에 대해서는 LLM 시대에 「스파스성은 과대평가되고 있다」는 대체로 옳다. 조건부 계산과 어텐션 스파스성에 대해서는 반대로 둘 다 이미 프론티어의 표준이다. 이 둘을 나누어 생각하는 것이 전체 논의를 이해하는 핵심이다.
이점
비용: 활성화율은 1.5%~4.5%까지 내려가고 가격 곡선이 빠르게 하강한다.
용량과 계산의 분리: 총 파라미터가 지식의 용량을 결정하고, 활성화 파라미터가 토큰당 비용을 결정하며, 둘은 독립적으로 스케일할 수 있다. Engram은 더 나아가 정적 지식을 저가의 호스트 메모리로 옮긴다.
긴 컨텍스트의 실용화: V3.1의 디코드 FLOPs은 4K에서 1M 사이에서 약 4분의 1만 증가한다.
해석 가능성의 도구: SAE와 트랜스코더는 미지의 개념 발견에 사용된다.
비용과 위험
메모리는 총 파라미터로 결정된다: V3.1의 라우팅 전문가(MXFP4)는 약 259.5 GiB, Engram 테이블은 약 183 GiB를 차지한다. 스파스성은 스토리지를 절약하지 않는다.
통신 오버헤드: 전문가 병렬 all-to-all은 MoE 학습의 주요 병목이고, Engram은 RDMA 또는 CXL을 통한 프리페치가 필요하다.
학습 불안정성과 부하 편향: z-loss, 바이어스 조정, 해시 라우팅 등 일련의 패치가 필요하다.
파인튜닝이 어렵다: 작은 데이터셋에서는 라우팅이 붕괴되기 쉽다. V3.1의 공식 파인튜닝 절차는 단일 NVLink 도메인 내 64개 GPU를 요구한다.
평가의 함정: Sparse Frontier의 「거의 모든 구성이 최소한 1개 작업에서 성능을 잃는다」는 발견. V3.1은 벤더 벤치마크에서는 프론티어와 맞먹지만, 독립적 종합 지표에서는 약 10포인트 뒤진다.
SAE의 한계: 「해석 가능성의 스파스성」절을 참조.
가중치 스파스성은 여전히 효율에서 진다: 기존 방법은 50%~60%의 스파스성 벽을 넘지 못하고 있다.
대표적 견해(출처에서 인용)
| 입장 | 출처 | 견해 |
|---|---|---|
| 지지: 승자는 하드웨어가 결정한다 | Hooker 2021 | 아이디어가 이기는 것은 「우월하기 때문이 아니라 손에 들어오는 소프트웨어와 하드웨어에 맞기 때문이다」 |
| 지지: 스파스성의 새로운 축 | DeepSeek, Engram 2026 | 「조건부 메모리는 차세대 스파스 모델에 필수적인 모델링 프리미티브가 될 것이라고 믿는다」 |
| 신중 | Nawrot et al. 2026 | 「스파스 어텐션은 만능 해결책이 아니다」 |
| 부정적 | Google DeepMind 2025 | 「SAE가 해석 가능성의 게임 체인저가 될 것이라고 생각하지 않으며, 이 분야가 SAE에 과잉 투자해왔다고 의심한다」 |
| 중도 | arXiv:2506.23845 | SAE는 알려진 개념에 대한 작업은 서투르지만 미지의 개념 발견에는 강력한 도구이다 |
5가지 스파스성 각각에 대한 평결(2026년 9월)
「스파스성은 과대평가인가?」에 단일 답변은 없다. 이 문제는 종류별로 답해야 한다.
| 스파스성의 종류 | 2026년의 상황 | 평결 | 주요 근거 |
|---|---|---|---|
| 가중치 스파스성(비구조화 프루닝) | 연구는 활발, 산업 채택은 극소수 | LLM 시대에는 과대평가. 양자화가 이겼다 | 50%~60%의 스파스성 벽. 효율적인 GPU 커널의 부재. MXFP4가 사실상 표준 |
| 구조화 스파스성(2:4, 블록) | 하드웨어 지원이 있지만 엔드투엔드 고속화는 제한적 | 부분적으로 실현. 블록 스파스는 MoE라는 형태로 이겼다 | 2:4는 실측에서 2배에 미치는 경우가 드물다. MegaBlocks의 블록 스파스 GEMM은 MoE의 기초가 되었다 |
| 활성화 스파스성(ReLU, top-k 활성화) | 엣지와 연구에서 주목. 클라우드에서는 MoE에 흡수 | 잠재력은 과소평가. 다만 주전장은 엣지 | Q-Sparse는 약 40%의 스파스율에서 밀집 모델에 필적한다. TEAL과 PowerInfer는 메모리 제약이 있는 디바이스를 겨냥한다 |
| 조건부 계산(MoE) | 프론티어의 표준 아키텍처 | 평판대로. 더욱 심화 중 | 활성화율은 2년 만에 25%에서 1.5%~4.5%로. 2025~2026년의 플래그십급 오픈 모델 모두 채택 |
| 어텐션 스파스성 | 네이티브로 학습 가능한 버전이 제품화 | 확립. 다만 작업별 성능 저하 위험 있음 | NSA가 ACL Best Paper 수상. V3.1은 처음부터 스파스하게 학습. Sparse Frontier의 「최소 1개 작업에서의 저하」 |
| (병행하는 계보) 저랭크 | MLA와 LoRA가 광범위하게 사용됨 | 확립. 다만 스파스성과 혼동해서는 안 됨 | 최대 약 93%의 저랭크 KV 압축(V2). LoRA는 파인튜닝의 표준 |
| (도구) 스파스 사전 / SAE | 논의 계속 중 | 발견의 도구로서는 확립. 검출기·제어기로서는 과대평가 | GDM이 우선순위를 낮췄다. 113개 데이터셋에서 선형 프로브에 못 미친다. Anthropic은 트랜스코더와 귀속 그래프로 이동 |
한 문장으로 말하면: 스파스성은 「활성화」와 「어텐션」에서 이겼고, 「가중치」에서 졌다. 이긴 것은 이론이 우월했기 때문이 아니라 0의 위치에 하드웨어가 활용할 수 있는 구조가 있었기 때문이다.
미래(2026~2030년)
스파스성의 다음 축은 더 이상 「어떤 파라미터를 계산하는가」가 아니라 「어떤 지식을 저장하고 어떤 히스토리를 읽을 것인가」이다. 다음에 연구의 프론티어, 하드웨어의 트렌드, 그리고 반박 가능한 5가지 예측을 보인다.
연구 프론티어
다중축 희소성과 예산 할당. Engram 논문이 발견한 U자형 법칙은 순수 MoE가 최적이 아니며 희소성 예산을 "전문가"와 "조건부 메모리"로 분할해야 함을 보여줍니다. 27B의 Engram 모델은 동일한 파라미터 수와 동일한 FLOPs의 MoE 기준선에 대해 MMLU +3.4, BBH +5.0, HumanEval +3.0을 달성했습니다. 메커니즘 분석에 따르면 조건부 메모리는 초기 레이어를 정적 지식 재조립에서 해방합니다.
기본적으로 학습 가능한 희소성이 표준이 된다. V4.1은 밀도 있는 준비 단계 없이 처음부터 64K에서 희소 어텐션을 학습합니다. 희소 어텐션이 추론 시간 근사에서 학습 시간의 일급 시민으로 변했음을 보여줍니다.
희소성 × 추론 시간 계산. 추론 모델은 긴 출력을 생성하므로 프리필과 디코드 모두 계산량이 많습니다. MoE는 지식의 용량을, 긴 사고 연쇄는 추론의 깊이를 제공합니다. CED의 비대칭 활성화는 읽기-쓰기 비율이 다른 워크로드에 대한 트레이드오프입니다.
모듈성과 지속적 학습. 전문가와 메모리 테이블은 국소적으로 편집할 수 있습니다. 예를 들어, 사용자 메모리를 국소 파라미터 편집으로 기록하는 연구가 있습니다(User as Engram, arXiv:2606.19172).
희소성과 양자화의 조합. MXFP4 전문가, FP4 KV, FP8 Engram은 V4.1과 K3에서 이미 함께 사용되고 있습니다. Q-Sparse의 결론은 양자화가 적극적일수록 최적의 희소성 정도가 높아진다는 것입니다.
하드웨어와의 협력 설계. Blackwell은 기본적으로 FP4를 지원하며, CXL 메모리 풀과 SSD를 사용한 계층화된 KV 저장소가 진행 중입니다. LLM 규모의 뉴로모르픽 컴퓨팅은 아직 먼 전망입니다.
반박 가능한 5가지 예측(근거 포함)
| 예측 | 마감일 | 근거 |
|---|---|---|
| 주요 오픈 모델 중 최소 1개에서 토큰당 글로벌 KV가 500바이트 이하로 내려감 | 2027년 말 | V1에서 V4.1로 437분의 1, V4에서 V4.1로 단 1세대에서 4분의 1, FP4는 이미 사용 중 |
| 오픈 모델 상위 5개 중 최소 3개에서 토큰당 활성화율이 3% 미만으로 내려감 | 2027년 말 | 2026년 기준 이미 V4.1 (2.9%), K3 (3.7%), Qwen3.5 (4.3%)가 있으며, 전문가 수는 세대마다 배증 |
| DeepSeek 이외의 최소 2개 주요 연구 기관이 플래그십 오픈 모델에 룩업 테이블 형식의 조건부 메모리 도입 | 2028년 | Engram에는 이미 CXL, SSD, 학습 불필요 파생 연구가 있으며, NeMo에도 탑재됨 |
| SAE는 어떤 프론티어 연구 기관에서도 공식 발표되는 프로덕션 안전 모니터링의 주요 방법이 되지 않음 | 2028년 | GDM의 우선순위 하향 조정. 다운스트림 태스크에서의 부정적 결과 |
| 동일 능력 수준의 API 단가는 연간 10배 이상의 속도로 계속 하락하지만, 기업의 태스크당 에이전트 지출은 증가 | 진행 중 | Epoch의 가격 추세. 에이전트 호출 횟수의 배증 |
우리에게 의미하는 바
심사는 본질적으로 방대한 조문과 페이지에서 상위 K개를 선택하는 태스크이며, 희소화 추세가 억누르는 것은 정확히 이런 종류의 태스크 단가입니다. 장문 문서·도면 심사 에이전트를 개발하는 기업에게는 실행 가능한 시사점이 4가지 있습니다.
비용 곡선. "캐시 히트율"과 "비피크 배치 처리 비율"을 일급 지표로 취급하십시오. 심사 태스크는 본질적으로 배치 처리 가능하고 오프라인으로 실행할 수 있습니다. 안정적인 법령·조례를 프롬프트 맨 앞에 배치하여 프리픽스 캐시 히트를 최대화하십시오. V4.1의 캐시된 입력 가격은 캐시 미스의 1/50이고, 비피크는 추가로 반값입니다.
모델 선택. "페이지 간 조회와 조문 인용"에 대한 자체 평가 집합으로 모델을 선택하고, 평균이 아닌 가장 어려운 서브태스크의 점수로 판단하십시오. 고도로 희소한 오픈 MoE를 주력 작업 모델로 하고, 어려운 사례의 이중 검증에는 폐쇄형 프론티어 모델을 사용하십시오.
긴 맥락 전략. "상위 K개 페이지 검색(감사 가능하고 인용 포함) + 1M 맥락에서의 재검증(페이지 간 관계 놓침 방지)"의 하이브리드를 채택하십시오. Sparse Frontier의 결론은 여기에 직접 적용됩니다. 희소 어텐션만으로 베팅하면 일부 태스크에서 성능이 저하되며, 심사는 정확히 "하나 놓치면 전체 답이 오류가 되는" 태스크입니다.
자체 호스팅 결정. MoE의 메모리는 총 파라미터로 결정됩니다. V4.1의 라우팅 전문가와 Engram 테이블은 총 440 GiB를 초과하며, 공식 파인튜닝 절차는 단일 NVLink 도메인 내 64개 GPU를 요구합니다. 수십 GPU 미만 규모에서는 먼저 수익성이 없으므로 API를 선택하십시오.
연구 기회. 기존 연구는 "예산 내에서 어느 페이지를 확인할지"를 검색 문제로 취급합니다. 그러나 페이지 간 일관성 검증에서 정말 희소해야 할 대상은 "페이지"가 아니라 "페이지의 쌍"입니다. P개 페이지에는 P(P−1)/2개의 쌍이 있으며, 그 중에서 교차 검증할 k개 쌍을 선택합니다. 이는 멀티에이전트 시스템의 희소한 협력 그래프와 정확히 대응되며, 모든 (쿼리, 키) 쌍을 경량 인덱서로 점수 매기고 상위 k개를 취하는 DSA의 발상과 동형입니다. 우리가 차별화되어 진출할 수 있는 방향입니다.
부록
A. 연표(1948년~2026년 9월)
| 연도 | 사건 | 신뢰도 |
|---|---|---|
| 1948 | Shannon, A Mathematical Theory of Communication: 중복성과 엔트로피의 정식화 | 일차 논문 |
| 1961 | Barlow의 중복성 감소 가설 | 일차 논문 |
| 1967 | Tinney & Walker의 희소 행렬 순서 지정(전력망 계산) | 일차 논문 |
| 1978 | Rissanen의 최소 기술 길이(MDL) | 일차 논문 |
| 1987 | Field: 자연 화상 통계와 피질 수용장 | 일차 논문 |
| 1988–89 | Daubechies의 컴팩트 지지 직교 웨이블릿. Mallat의 다중 해상도 분석 | 일차 논문 |
| 1990–93 | OBD / OBS에 의한 프루닝. Matching Pursuit | 일차 논문 |
| 1991 | Jacobs–Jordan–Nowlan–Hinton의 국소 전문가 혼합 | 일차 논문 |
| 1992 / 2000 | JPEG / JPEG2000 | 표준 규격 |
| 1994–96 | 웨이블릿 임계값 노이즈 제거. Breiman의 garotte. LASSO. Olshausen & Field의 희소 부호화 | 일차 논문 |
| 1998 | Basis Pursuit. DeVore의 비선형 근사 | 일차 논문 |
| 2001–03 | Attwell & Laughlin의 에너지 수지. Lennie의 "아마도 1% 미만" | 일차 논문(검증됨) |
| 2004–05 | LARS。Elastic Net | 일차 논문 |
| 2006–07 | 압축 센싱. K-SVD. Lustig의 CS-MRI | 일차 논문 |
| 2009 | Donoho–Tanner 상전이 | 일차 논문 |
| 2011 | Glorot의 ReLU(50~85%의 엄격한 영점). Robust PCA | 일차 논문(검증됨) |
| 2012 | Google의 고양이 얼굴 뉴런 | 일차 논문(검증됨) |
| 2013–14 | Bengio의 조건부 계산과 STE. Gavish–Donoho의 최적 하드 임계값 | 일차 논문 |
| 2016 | Deep Compression | 일차 논문 |
| 2017 | Shazeer의 희소 게이트 MoE(137B의 MoE 레이어) | 일차 논문(검증됨) |
| 2019 | 복권 가설. EHT M87*. Sartoetti의 CS-MRI 임상 연구 | 일차 논문 |
| 2020 | GShard. Hooker의 Hardware Lottery. Ampere의 2:4 | 일차 논문 |
| 2021–22 | Switch Transformer. GLaM. ST-MoE. Expert Choice. Clark의 MoE 스케일링 | 일차 논문 |
| 2023 | Mixtral。SparseGPT / Wanda。StreamingLLM / H2O。Towards Monosemanticity | 일차 논문 |
| 2024년 1~2월 | DeepSeekMoE. Gemini 1.5가 MoE임을 공식 확인 | 기술 레포트 |
| 2024년 5월 | DeepSeek-V2 (MLA)。Scaling Monosemanticity。Golden Gate Claude | 기술 레포트 |
| 2024년 6~7월 | Gao의 TopK SAE. Q-Sparse | 일차 논문(검증됨) |
| 2024년 12월 | DeepSeek-V3 (671B/37B) | 기술 레포트 |
| 2025년 1월 27일 | DeepSeek 충격: Nvidia의 시가총액이 하루에 약 589억 달러 감소 | 신뢰할 수 있는 보도 |
| 2025년 2~3월 | NSA, MoBA. 추론 시스템의 이론적 이익률 545%. GDM이 SAE의 우선순위를 하향 조정 | 일차 논문 / 공식 |
| 2025년 4월 | Qwen3 MoE. Sparse Frontier 프리프린트. Llama 4 | 공식 / 일차 논문 |
| 2025년 7~8월 | NSA가 ACL 최우수 논문상 수상. Kimi K2. gpt-oss | 공식 |
| 2025년 9~12월 | DeepSeek-V3.2、DSA | 기술 레포트 |
| 2026년 1월 | Engram: 조건부 메모리와 희소성 예산의 U자형 할당 | 일차 논문 |
| 2026년 2월 | Qwen3.5-397B-A17B | 공식 모델 카드 |
| 2026년 4월 24일 | DeepSeek-V4 (Pro 1.6T/49B、Flash 284B/13B) | 기술 레포트 |
| 2026년 7월 | Kimi K3 (2.8T/104B). Sparse Frontier가 ACL 2026 회의록에 게재 | 공식 |
| 2026년 9월 10일 | DeepSeek-V4.1-Flash (CED, CSA2, 890 B/토큰, Engram) | 공식 + 기술 레포트(검증됨) |
B. 그래프로 나타낼 수 있는 데이터 계열
DeepSeek의 글로벌 KV 캐시(토큰당): V1 ≈ 389 KB(추정) → V3.2 ≈ 48 KB → V4-Flash ≈ 3.5 KB → V4.1-Flash 890 B. 로그 스케일.
토큰당 활성화율: Mixtral 28% → Qwen3 9.4% → gpt-oss 4.4% → Qwen3.5 4.3% → Kimi K3 3.7% → V4.1 디코드 2.9% / 프리필 1.4%.
전문가 수(선택 / 총수): 2/8 → 4/128 → 8/256 → 6/384 → 10/512 → 16/896.
DeepSeek API 가격($/M, 입력 / 출력): V4-Flash 0.14 / 0.28. V4-Pro 1.74 / 3.48(8월 이후 피크 시간 출력은 3.96). V4.1-Flash는 피크 0.30 / 1.20, 비피크 0.15 / 0.60, 캐시 0.006.
Sparse Frontier: 프리필의 최적 스파스율 0.80~0.93. 디코드는 0.95에서도 실용적이다. 교차점은 32~64K.
Glorot 2011의 스파스율: MNIST 83.4%, CIFAR10 72.0%, NISTP 68.0%, NORB 73.8%.
Q-Sparse: 최적 스파스율 45.58%(전체 정밀도) / 61.25%(1.58비트). 40% 전후에서 밀집 모델과 동등.
Engram-27B의 MoE 기준선에 대한 차이: MMLU +3.4, CMMLU +4.0, BBH +5.0, ARC-C +3.7, HumanEval +3.0, MATH +2.4.
CS-MRI: 스캔 시간 −20.2%, 검사 시간 −16%, 단일 시퀀스 −23% ~ −43%, 검사 건수 +27%.
GPU의 계산 성능과 대역폭: "뉴럴 네트워크 시대" GPU 표를 참조하십시오.
C. 일화와 스토리 소재
「Lennie의 1%」가 어떻게 「1~4%」가 되었나: 오해를 바로잡는 도입부로 사용할 수 있습니다.
고양이 얼굴 뉴런(2012): 1,000대의 머신이 3일에 걸쳐 YouTube 프레임에서 독학으로 「고양이」를 학습한 이야기.
Outrageously (2017): LSTM 시대의 137B MoE 계층이 2026년의 풍경을 미리 알렸던 이야기. Hinton과 Dean의 공저는 「1991년의 오래된 아이디어 × Google의 계산 자원」의 상징입니다.
DeepSeek 충격(2025년 1월 27일)과 545%에 붙는 「이론상의」라는 말씀.
Golden Gate Claude (2024)와 GDM의 급제동(2025년 3월).
CS-MRI: 환자가 스캐너 침대에 누워있는 시간은 20% 줄어들었고, 병원은 검사를 27% 더 많이 처리할 수 있게 된 이야기.
437분의 1: 토큰당 「기억」이 약 389 KB에서 890바이트로 축소된 이야기.
N-그램의 귀환: 역사의 저편에 묻혔어야 할 통계적 언어 모델이 Engram으로 프론티어에 돌아온 이야기.
D. 자주 있는 오해와 그 정정
| 자주 있는 표현 | 정확한 기술 |
|---|---|
| 뇌는 뉴런의 1~4%만 사용한다 | Lennie 2003의 실제 기술은 「아마도 1% 미만」이며 에너지 기반 상한의 추정. 1~4%는 Glorot 2011을 거친 손자 인용 |
| ReLU 네트워크는 90% 스파스 | Glorot 2011: 초기화 시 약 50%, 학습 후 50%~85% |
| GPT-4는 16명의 전문가의 1.8T MoE | OpenAI가 한 번도 확인하지 않은 2023년 소문. GPT-5.x와 Claude의 구성도 마찬가지로 비공개 |
| CS-MRI는 스캔을 30~60% 고속화한다 | Sartoretti 2019: 평균 스캔 시간 −20.2%, 단일 시퀀스 −23% ~ −43% |
| Shazeer 2017: 「최대 1000배」 | 원문은 「greater than 1000x(1000배 초과)」. 137B는 MoE 계층의 파라미터 수 |
| Sparse Frontier는 ICML 2025에서 발표되었다 | 정식으로는 Findings of ACL 2026에 게재됨 |
| DeepSeek의 이익률은 545% | 자체 신고의 이론상 비용 이익률. 실제로는 훨씬 낮으며, 연구개발비와 학습 비용을 제외하고 있음 |
| MLA는 스파스 어텐션이다 | MLA는 저랭크 압축. 실제로 스파스인 것은 DSA / CSA2 |
| 스파스 어텐션은 무제한으로 압축할 수 있다 | 거의 모든 구성이 적어도 하나의 작업에서 큰 성능 손실을 입는다 |
E. 참고 문헌
고전적 기초: Shannon 1948; Barlow 1961; Tinney & Walker 1967; Rissanen 1978; Field 1987; Mallat 1989; LeCun, Denker & Solla 1990; Jacobs, Jordan, Nowlan & Hinton 1991; Mallat & Zhang 1993; Donoho & Johnstone 1994 (Biometrika); Breiman 1995; Tibshirani 1996 (JRSS-B); Olshausen & Field 1996 (Nature); Chen, Donoho & Saunders 1998; DeVore 1998; Attwell & Laughlin 2001; Lennie 2003 (Curr. Biol.); Efron et al. 2004; Zou & Hastie 2005; Candès, Romberg & Tao 2006; Donoho 2006; Aharon, Elad & Bruckstein 2006; Lustig, Donoho & Pauly 2007; Lee, Battle, Raina & Ng 2007; Donoho & Tanner 2009; Glorot, Bordes & Bengio 2011; Candès, Li, Ma & Wright 2011; Le et al. 2012; Bengio et al. 2013; Gavish & Donoho 2014; Han, Mao & Dally 2016; Shazeer et al. 2017; Frankle & Carbin 2019; Sartoretti et al. 2019; Vranic et al. 2019; Hooker 2021 (CACM); Fedus, Zoph & Shazeer 2021; Clark et al. 2022.
2023~2026년: Frantar & Alistarh 2023 (SparseGPT); Sun et al. 2023 (Wanda); Xiao et al. 2023 (StreamingLLM); Bricken et al. 2023; Jiang et al. 2024 (Mixtral); Dai et al. 2024 (DeepSeekMoE); DeepSeek-AI 2024 (V2, V3); Templeton et al. 2024; Gao et al. 2024; Wang et al. 2024 (Q-Sparse); Krajewski et al. 2024; Yuan et al. 2025 (NSA); Nawrot et al. 2025/2026 (Sparse Frontier); Kantamneni et al. 2025; OpenAI 2025 (gpt-oss); Google DeepMind 2025 (Gemini 2.5 기술 보고서, arXiv:2507.06261); Moonshot 2025/2026 (Kimi K2, K3); Alibaba 2026 (Qwen3.5); Cheng et al. 2026 (Engram, arXiv:2601.07372); DeepSeek-AI 2026 (V4, arXiv:2606.19348); DeepSeek-AI 2026 (V4.1-Flash, arXiv:2609.19969); Ma et al. 2024 (MMLongBench-Doc).
교과서 및 서베이: Elad, Sparse and Redundant Representations (2010); Hastie, Tibshirani & Wainwright, Statistical Learning with Sparsity (2015); Mallat, A Wavelet Tour of Signal Processing (3rd ed.); Foucart & Rauhut, A Mathematical Introduction to Compressive Sensing (2013); Hoefler et al. 2021, Sparsity in Deep Learning; Cai et al. 2024, A Survey on Mixture of Experts.
읽음
다음 읽을 글 ↓