Research
最新の研究・実務による良いプロダクトとはなにか
Product
Career
Overview
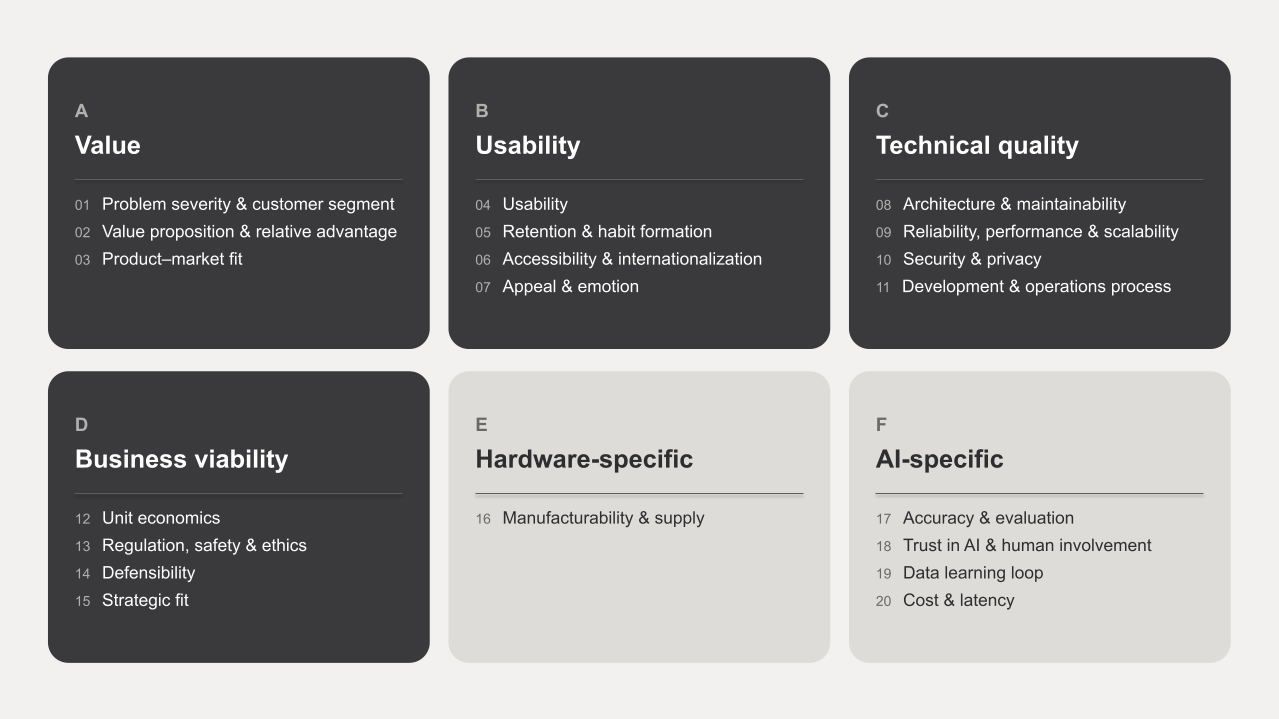
良いプロダクトとは何でしょうか。品質管理、人間工学、経営学、イノベーション研究といった学術分野と、Apple、Amazon、Nest などで製品を作ってきた実務家は、それぞれ異なる言葉で「良さ」を定義してきました。本稿はそれらを横断して整理し、良いプロダクトを「価値」「使いやすさ」「技術的な質」「事業性」「ハードウェア特有の条件」「AI プロダクト特有の条件」の6つの条件と20の要素に分解します。
さらに、プロダクトマネージャー、デザイナー、各エンジニア、顧客といったステークホルダーの役割を7つの系統で整理し、顧客課題の発見から振り返りまでの6つの Phase で、どの要素を誰がどの検証方法と達成水準で確かめるかを時系列で示します。
はじめに
「良いプロダクト」の条件は、品質管理、人間とコンピュータの相互作用、経営学といった学術分野と、製品を作ってきた実務家の間で、それぞれ別の言葉で語られてきました。基本的な安全性や安定性に加えて、革新的な機能や使いやすさ、事業として続くことまで含めると、何を満たせば良いと言えるのかは包括的には十分に整理されていません。本稿では、ソフトウェアとハードウェアの双方を想定し、良いプロダクトが備えるべき条件と、それを開発の過程で誰がいつ何で確かめるかを整理します。
本稿の新規性は次の3点にあります。
学術と実務の「良いプロダクト」の定義を6条件・20要素に統合した:Garvin(1987)の品質の8次元、Kano モデル(狩野ほか, 1984)、ISO/IEC 25010(ISO/IEC, 2023)といった学術的な定義と、Cagan(2017)の4つのリスクのような実務家の定義を一つの枠組みに置き、ソフトウェアとハードウェアの相違点も要素ごとに明示しています。例えば、Kano の「魅力的品質」と Norman(2004)の「感情のデザイン」は、同じ「魅力と感情」という要素として扱います。
6つの Phase で「誰がいつ何で確かめるか」に落とし込んだ:多くの文献は「何が良いか」を論じますが、担当と基準値までは示しません。例えば、プロダクトマーケットフィットは「なくなったら非常に残念」と答える利用者が40%以上(Ellis & Brown, 2017)という水準を、プロダクトマネージャーが四半期ごとに測る、と対応付けます。
最新の研究や実務の動向を整理した:X新製品研究、HCI、ソフトウェア工学、組織論から人間と AI の協働まで、製品の優位性が成功要因の第1位であること、機能の多さがかえって満足を下げること、心理的安全性やアジャイルの効果、生成 AI が生産性に与える差といった19の研究と、Y Combinator、Jobs、Bezos、Musk、Cagan、Fadell らの15の実務的な主張を、価値・使いやすさ・技術・事業性・AI の順に整理しています。例えば、「顧客の声か、ビジョンか」「早く出すか、作り込んでから出すか」のように実務家の間で意見が分かれる論点は、両論を併記しています。
良いプロダクトとは
良いプロダクトの定義
「良いプロダクト」の定義は、どのようなものでしょうか。各分野でプロダクトの良し悪しに関する定義を整理します。
品質管理の定義:Garvin(1987)は製品の品質を、性能、付加機能、信頼性、適合性、耐久性、保守性、美しさ、知覚品質の8次元に分けました。品質は一つの軸ではなく、顧客が重視する次元を選んで競争するものだと論じています。例えば、日本の自動車メーカーは1980年代に信頼性と適合性の次元で米国メーカーに差をつけました。
魅力的品質の定義:狩野ほか(1984)は、充足されて当然とみなされる「当たり前品質」、充足度に比例して満足が上がる「一元的品質」、なくても不満にならないが充足すると喜ばれる「魅力的品質」を区別しました。例えば、スマートフォンの通話品質は当たり前品質、バッテリーの持ちは一元的品質、初期の指紋認証は魅力的品質でした。
ソフトウェア工学の定義:ISO/IEC 25010(ISO/IEC, 2023)は、ソフトウェア製品の品質を、機能適合性、性能効率性、互換性、相互作用性、信頼性、セキュリティ、保守性、柔軟性、安全性の9特性で定義しています。例えば、同じ機能を持つ2つのアプリでも、保守性が低い方は2年後の改修費用が数倍になります。
人間中心設計の定義:ISO 9241-210(ISO, 2019)は、利用者のニーズと文脈を理解し、利用者を設計に参加させ、評価を繰り返す「人間中心設計」を規定し、Norman(2013)は、使い方が見て分かる「アフォーダンス」と「シグニファイア」を良いデザインの条件としました。例えば、押すべきか引くべきか分からないドアは、機能は満たしていても良いデザインではありません。
イノベーション研究の定義:Rogers(2003)は、新しいものが普及する速さを決める属性として、相対的優位性、既存の習慣との両立性、複雑さの低さ、試用可能性、観察可能性の5つを挙げました。Davis(1989)は、利用者が技術を受け入れるかどうかを「知覚された有用性」と「知覚された使いやすさ」で説明しています。例えば、QR コード決済は、既存の習慣(スマートフォンの携帯)と両立し、試しやすく、使っている人が見えるため急速に普及しました。
Jobs to be Done の定義:Christensen et al.(2016)は、顧客は製品を「買う」のではなく、生活の中の特定の進歩(ジョブ)を成し遂げるために「雇う」と考え、良いプロダクトをジョブを最もうまく片付けるものと定義しました。例えば、朝の通勤中に飲まれるミルクシェイクは、「退屈な運転を紛らわせ、昼まで空腹を抑える」というジョブのために雇われています。
実務家の定義:Cagan(2017)は、良いプロダクトを、価値(顧客が買うか)、使いやすさ(使い方が分かるか)、実現可能性(作れるか)、事業性(事業として成り立つか)の4つのリスクをすべて乗り越えたものと定義しました。Rams(Vitsœ, n.d.)は、良いデザインの10原則として、革新的、有用、美しい、理解しやすい、控えめ、誠実、長持ち、細部まで一貫、環境に配慮、できる限り少ないデザイン、を挙げています。例えば、Apple の初代 iPod は、4つのリスクをすべて乗り越え、かつ Rams の原則に忠実だったことで、良いプロダクトの代表例として語られます。
プロダクトマーケットフィットの定義:Andreessen(2007)は、「良い市場にいて、その市場を満足させられるプロダクトを持っている状態」をプロダクトマーケットフィット(PMF)と呼び、スタートアップにとって唯一重要なことだと述べました。Ellis & Brown(2017)は、「このプロダクトが使えなくなったらどう感じるか」という問いに「非常に残念」と答える利用者が40%以上であることを目安としました。例えば、Superhuman は、この指標を22%から58%まで引き上げる過程を公開しています(Vohra, 2018)。
以下では、これらの定義を踏まえ、良いプロダクトを6つの条件と20の要素に分解しています。
A. 価値:顧客の課題を解決しているか
価値は、顧客が対価を払ってでも解決したい課題があり、プロダクトがそれを他の手段より良く解決することで生まれます。Cooper & Kleinschmidt(1987)以来の新製品研究では、製品の優位性が成功要因の第1位であり続けています(Henard & Szymanski, 2001; Evanschitzky et al., 2012)。
① 課題の深刻さと顧客セグメント
定義:特定の顧客セグメントが、対価を払ってでも解決したいほど深刻で、頻繁に起きる課題を抱えていることです。課題は機能の要望ではなく、顧客が成し遂げたい進歩(ジョブ)として定義します(Christensen et al., 2016)。例えば、「もっと速いドリルが欲しい」ではなく「壁に穴を開けて棚を付けたい」がジョブであり、穴を開けずに棚を付ける製品も競合になります。
評価方法:課題の発生頻度、深刻さ(失われる時間や費用)、現在の代替手段とそれへの支払額、そして同じ課題を抱える顧客の数(セグメントの大きさ)で評価します。例えば、「月に何回起き、1回あたり何時間を失い、いま何に払っているか」が答えられれば、課題の深刻さは定量化できています。
概要:Blank(2013)は、製品を作る前に顧客を発見し課題の存在を確かめる「顧客開発」を提唱し、Fitzpatrick(2013)は、意見ではなく過去の行動を聞く質問の原則を示しました。ハードウェアは試作に時間と費用がかかるため、課題の確認はモックアップや既存製品の改造で先に行います(Fadell, 2022)。例えば、Airbnb の創業者は自宅にゲストを泊めて「宿泊費を抑えたいが安宿は嫌だ」という課題を自分で確かめ、Nest は既存のサーモスタットの不満点(設定の面倒さ)を調べることから始めました。
② 価値提案と相対的優位性
定義:既存の代替手段と比べて、顧客にとって明らかに優れている点(相対的優位性)を、一言で言える形で持っていることです(Rogers, 2003)。価値は中核の機能だけでなく、サポート、互換性、周辺サービスを含む「ホールプロダクト」として捉えます(Levitt, 1980; Moore, 1991)。例えば、電気自動車の価値は車両そのものに加えて充電網の整備で決まります。
評価方法:代替手段と比べた改善幅(時間、費用、品質)、顧客が「他の手段ではなくこれを使う理由」を自分の言葉で言えるか、Kano モデルでの分類(魅力的品質か当たり前品質か;Witell et al., 2013)で評価します。例えば、Kano アンケートで「なくても構わない」が多数の機能は、差別化になりません。
概要:Cooper & Kleinschmidt(1987)以来、独自の便益を持つ優れた製品は、成功と失敗を最も強く分ける要因であり続けています。ソフトウェアは機能追加が容易なため優位性が模倣されやすく、ハードウェアは物理的な設計や製造ノウハウが優位性を長く保ちます。例えば、Dyson の掃除機は「吸引力が落ちない」という一点で差を明確にし、5,127個の試作を経た技術で長期にわたり優位性を維持しました(Dyson, 2021)。
③ プロダクトマーケットフィット
定義:顧客がプロダクトなしでは困るほど価値を感じ、使い続け、他者に勧めている状態です。Andreessen(2007)は、PMF があれば顧客が製品を「引っ張っていく」のが分かると述べました。例えば、PMF 後のプロダクトは、営業をしなくても問い合わせが増え、サーバーの増設が追いつかなくなります。
評価方法:「使えなくなったらどう感じるか」を問う PMF 調査(Ellis & Brown, 2017)、コホート別のリテンション曲線が平らになるか、NPS(Reichheld, 2003)、有料プランへの転換率で評価します。ハードウェアでは、予約注文、返品率、レビュー、接続機器であれば稼働率で代替します。例えば、接続型のフィットネス機器では、販売台数より購入者の月間の利用回数とサブスクリプションの解約率が指標になります。
概要:PMF は一度きりではありません。Olsen(2015)は、PMF を市場(顧客と課題)とプロダクト(価値提案、機能、UX)の5層のピラミッドで捉え、市場が変わればフィットも崩れると論じ、Vohra(2018)は、「非常に残念」と答えた利用者が最も評価する点を強め、「やや残念」と答えた利用者の不満を解消する手順で指標を改善しました。例えば、スマートフォンの普及で、PC 向けに PMF していた多くのサービスがフィットを失いました。
B. 使いやすさ:使えるか、使い続けられるか
使いやすさは、価値があるプロダクトが実際に使われ、使い続けられるための条件です。Davis(1989)の技術受容モデルでは、使いやすさは有用性と並んで利用意図を決める2つの要因の一つです。
④ ユーザビリティ
定義:特定の利用者が特定の目的を、有効に、効率的に、満足して達成できる度合いです(ISO 9241-11;ISO, 2018)。Nielsen(1994)の10のヒューリスティクス(システム状態の可視化、現実世界との一致、エラーの防止、認識による想起の代替など)が、設計を判定する基準になります。例えば、保存したかどうかが画面から分からない編集画面は「システム状態の可視化」に反しています。
評価方法:少人数のユーザビリティテスト(Nielsen, 2000)でのタスク完了率と完了時間、System Usability Scale(SUS;Brooke, 1996; Sauro & Lewis, 2016)、同じ箇所で複数人が迷うかどうかで評価します。例えば、新しい申請画面を5人に触ってもらい、3人が同じ箇所で迷えば、その箇所は設計の問題です。
概要:Krug(2014)は、利用者に考えさせないことを最重要の原則とし、Norman(2013)は、間違った操作をする利用者ではなく、間違いを誘発する設計を責めるべきだと述べました。ソフトウェアはリリース後に UI を変えられますが、ハードウェアの物理的なインターフェース(ボタン、形状、重さ)は出荷後に変えられないため、試作段階のテストの重みが大きくなります。例えば、Amazon の「1-Click 注文」は購入までの判断回数を最小にした設計であり、Nest はダイヤルを回す操作感を試作の段階で何度も作り直しました(Fadell, 2022)。
⑤ 継続利用と習慣化
定義:初回の利用で中核の価値(アハ体験)に到達し、その後も繰り返し使われ、利用者の習慣や業務の一部になっている状態です。Fogg(2009)は、行動は動機、能力、きっかけの3つが同時に揃ったときに起きると説明し、Eyal(2014)は、きっかけ、行動、報酬、投資のループで習慣が作られると整理しました。例えば、Slack は、チームが2,000メッセージを交換した時点で定着すると判断し、そこへ導く設計をしました(First Round Review, 2015)。
評価方法:活性化率(登録者のうち中核価値に到達した割合)、コホート別のリテンション曲線、DAU/MAU(業務ツールでは平日の利用率)、Google の HEART フレームワーク(幸福度、エンゲージメント、定着、継続、タスク成功;Rodden et al., 2010)で評価します。ハードウェアは、接続機器でなければ利用頻度が分からないため、アンケートや消耗品の購入頻度で代替します。例えば、コーヒーメーカーの継続利用は、カプセルの再購入率で測ります。
概要:習慣化の設計は、利用者の利益と一致している場合に限って正当化されます。Eyal(2014)自身も、利用者の生活を改善しないプロダクトに習慣化の技法を使うべきではないと述べています。例えば、通知の頻度を上げて短期の利用率を稼ぐ設計は、長期の解約を増やします。
⑥ アクセシビリティと国際化
定義:視覚、聴覚、運動、認知に制約がある利用者や、異なる言語・文化・法制度の利用者が、同じように使える状態です。W3C(2023)の WCAG 2.2 は、知覚可能、操作可能、理解可能、堅牢の4原則で達成基準を定めています。例えば、色だけで状態を示すグラフは、色覚に制約がある利用者には区別できません。
評価方法:WCAG の適合レベル、支援技術(スクリーンリーダーなど)での操作可能性、対応する言語・通貨・日付形式・時間帯の範囲で評価します。例えば、英語で設計した画面は、ドイツ語に翻訳すると文字列が1.3倍程度長くなり、ボタンからはみ出すことがあります。
概要:WebAIM(2024)の調査では、上位100万サイトの95.9%に WCAG の違反が検出されており、意識して設計しなければ満たされない条件です。ソフトウェアは設定で言語や表示を切り替えられますが、ハードウェアは電源電圧、プラグ形状、無線の周波数帯、各国の認証(CE、FCC など)が地域ごとに異なり、設計段階で対応範囲を決める必要があります。例えば、日本と米国で販売する機器は、無線モジュールの認証を国ごとに取得します。
⑦ 魅力と感情
定義:機能を満たすだけでなく、使っていて心地よく、持っていたいと思える性質です。Norman(2004)は、デザインが感情に働く層を、見た目の「本能的」、使い心地の「行動的」、意味や自己像に関わる「内省的」の3つに分け、Kano モデルの魅力的品質(狩野ほか, 1984)もこの要素に当たります。例えば、Apple の製品の梱包は、開封の体験そのものを本能的な層で設計しています。
評価方法:NPS(Reichheld, 2003)、Kano アンケートでの魅力的品質の判定、デザインレビューでの一貫性(用語、色、余白、動き)で評価します。例えば、画面ごとに異なる用語(「保存」「登録」「確定」)が混在していれば、一貫性に欠けています。
概要:Rams の原則(Vitsœ, n.d.)では、良いデザインは細部まで一貫し、できる限り少ないデザインであり、Jobs は、技術から始めるのではなく顧客体験から始めて技術へ遡るべきだと述べました(Jobs, 1997)。美しさは使いやすさの知覚も高めます(Kurosu & Kashimura, 1995; Tractinsky et al., 2000)。ハードウェアでは素材、重さ、手触り、音といった物理的な質感が、ソフトウェアでは応答の速さ、動き、文言の調子が魅力を決めます。例えば、高級車のドアを閉める音は意図的に設計された魅力であり、アプリの画面遷移の滑らかさはその対応物です。
C. 技術的な質:作れるか、動き続けるか
技術的な質は、プロダクトを一度作れるかだけでなく、変化し続ける要求に合わせて作り続けられるか、そして顧客の手元で動き続けるかを決めます。ISO/IEC 25010(ISO/IEC, 2023)の品質特性と、DORA の実証研究(Forsgren et al., 2018)がこの条件の基盤です。
⑧ アーキテクチャと保守性
定義:変更が必要になったとき、影響範囲が限定され、安全に変えられる構造になっていることです。Parnas(1972)は、変わりやすい設計判断をモジュールの内側に隠す「情報隠蔽」を提唱し、Conway(1968)は、システムの構造は組織のコミュニケーション構造を写すと指摘しました。例えば、料金計算のロジックが画面、API、バッチ処理の3か所に重複していれば、料金改定のたびに3か所を直す必要があります。
評価方法:変更の影響範囲(モジュール境界、依存の方向、重複)、変更のリードタイム、テストの網羅性、技術的負債の量と返済の割合で評価します。ハードウェアでは、部品の交換可能性、モジュール化、修理のしやすさで測ります(Ulrich et al., 2020)。例えば、Framework のノート PC は、部品ごとに交換できるモジュール構造を製品の価値そのものにしています。
概要:Cunningham(1992)は、急いで書いたコードを「負債」に例え、返済しなければ利子(変更コストの増加)が膨らむと述べ、Besker et al.(2019)の調査では、開発者は作業時間の平均23%を技術的負債への対処に費やしていました。Fowler(2018)のリファクタリングは、機能を変えずに構造を改善する手順として、定期的に時間を確保する対象です。例えば、テストのないコードは、変更のたびに手動確認という利子を払い続けます。
⑨ 信頼性・性能・スケーラビリティ
定義:顧客が必要とするときに、必要な速さで、負荷が増えても動き続ける性質です。Google の SRE(Beyer et al., 2016)は、稼働率の目標を「サービスレベル目標(SLO)」として明示し、目標を超える分を「エラーバジェット」として新機能の開発に使う考え方を示しました。例えば、月間稼働率99.9%を SLO にすると、月に約43分の停止が許容され、それを超えたら新機能より安定化を優先します。
評価方法:SLO の達成率、応答時間の分布(95パーセンタイル値など)、負荷に対する応答の変化、障害からの復旧時間で評価します。ハードウェアは、故障率(MTBF)、耐久試験、保証期間内の故障コストで測ります(Garvin, 1987)。例えば、自動車では、OTA アップデートで直せるのはソフトウェア起因の不具合だけで、部品の欠陥はリコールになります。
概要:Nygard(2018)は、タイムアウト、サーキットブレーカー、隔壁(バルクヘッド)といった、障害を局所に閉じ込める設計パターンを整理しました。障害は起きるものとして設計し、起きた後は非難しないポストモーテムで学びます(Beyer et al., 2016)。例えば、外部の決済 API が遅延したときに、全画面が固まるのではなく決済だけを一時停止できる構造が必要です。
⑩ セキュリティとプライバシー
定義:顧客のデータと資産が守られ、プライバシーが設計の段階から配慮されている状態です。Cavoukian(2009)の「プライバシー・バイ・デザイン」は、事後の対策ではなく初期設定で守ることを原則とし、OWASP(2021)の Top 10 は、アクセス制御の不備、暗号化の失敗、インジェクションといった典型的な脆弱性を整理しています。例えば、利用者の ID を URL に含める設計は、アクセス制御の不備の典型です。
評価方法:脅威モデリングで特定した脅威への対策の有無、脆弱性診断・侵入テストで見つかる脆弱性の重大度と件数、依存ライブラリの既知の脆弱性、個人データの保持期間と削除手順の有無で評価します。例えば、重大度の高い脆弱性が未対応のまま残っていれば、他の条件を満たしていても出荷できません。
概要:NIST(2022)の Secure Software Development Framework は、これらの活動を開発工程に組み込む標準です。ソフトウェアは脆弱性を修正版の配布で直せますが、ハードウェアはファームウェアの更新手段がなければ出荷後に直せません。EU のサイバーレジリエンス法(European Parliament and Council, 2024b)は、デジタル要素を持つ製品に、販売後のセキュリティ更新の提供を義務づけました。例えば、安全な更新手段を持たない IoT 機器は、販売そのものが制限される方向にあります。
⑪ 開発・運用プロセス
定義:小さく頻繁に、安全に顧客へ届け、結果から学ぶ仕組みが回っている状態です。Forsgren et al.(2018)は、デプロイ頻度、変更のリードタイム、変更失敗率、復旧時間の4指標が組織の業績と相関することを実証しました。例えば、高パフォーマンスの組織は、1日に複数回デプロイし、失敗率が低く、復旧が1時間以内です。
評価方法:DORA の4指標、CI/CD の自動化率、リリースの振り返りの実施で評価します。ハードウェアでは、技術検証(EVT)、設計検証(DVT)、量産検証(PVT)の各段階の通過と、段階ごとの継続・中止の判断(Cooper, 1990 のステージゲート)で評価します。例えば、金型を発注した後に筐体の形を変えると、数か月の遅れと数千万円の追加費用が発生します(Fadell, 2022)。
概要:Brooks(1995)は、遅れたプロジェクトに人を足すとさらに遅れると述べ、Singer(2019)の Shape Up は、6週間の固定期間に収まるよう仕事の範囲を削る方法を示しました。Ries(2011)の「構築・計測・学習」のループと、開発の前にプレスリリースと FAQ を書く Amazon の「Working Backwards」(Bryar & Carr, 2021)は、学習までの時間と無駄な開発を最小にする原則です。DORA(2025)は、AI の利用がスループットを上げる一方で不安定性も増やし、その効果は小さなバッチや厳格なバージョン管理といった基盤を持つ組織で増幅されると報告しています。例えば、AI でコードの生成が速くなっても、レビューとテストが追いつかなければ変更失敗率が上がります。
D. 事業性:事業として成り立つか
事業性は、顧客にとって良いプロダクトが、作り手にとっても続けられるかを決めます。Cagan(2017)の4つのリスクの最後であり、法規制や倫理も、ここでは事業が存続するための条件として扱います。
⑫ ユニットエコノミクス
定義:顧客1人(1社、1台)あたりの収益が、その顧客を獲得し、提供し続ける費用を上回っている状態です。Skok(2013)は、SaaS では顧客生涯価値(LTV)と顧客獲得費用(CAC)の比率、CAC の回収期間を中心の指標としました。例えば、月額1万円で粗利率80%、平均継続30か月の顧客は LTV が24万円であり、CAC がそれを十分に下回れば成り立ちます。
評価方法:LTV/CAC、CAC 回収期間、粗利率、解約率、純収益維持率(NRR)で評価します。ハードウェアでは、部品表(BOM)の原価、製造費、物流費、在庫、返品、保証費用を含めた粗利率で評価します。例えば、NRR が110%なら、新規顧客がゼロでも既存顧客からの収益が年10%伸びます。
概要:ソフトウェアの限界費用はほぼゼロでクラウド費用が主な変動費ですが、ハードウェアは物理的な費用が加わり、粗利率は一般に低くなります。AI プロダクトは利用のたびに推論費用がかかるため、⑳ と合わせて見る必要があります。例えば、ハードウェアでは、販売価格の設定に BOM 原価の数倍という目安があり、そこに保証と返品の費用を織り込みます。
⑬ 法規制・安全・倫理
定義:プロダクトが、適用される法規制を満たし、利用者と第三者に危害を与えず、社会的に受け入れられる状態です。EU の AI 法(European Parliament and Council, 2024a)はリスクの程度に応じて AI システムに義務を課し、改正された製造物責任指令(European Parliament and Council, 2024c)は、責任の対象をソフトウェアと AI にも広げました。例えば、採用や与信に使う AI は高リスクに分類され、文書化、人間による監視、精度の確保が義務になります。
評価方法:適用法規(個人情報、消費者保護、業法、製品安全、輸出管理)の棚卸しの網羅性、リスクアセスメントの結果、外部監査や認証の取得状況で評価します。NIST(2023)の AI リスクマネジメントフレームワークは、AI のリスクを自己点検する枠組みです。例えば、新しい市場に参入する前に、その国の個人情報保護法とデータの越境移転の制限を確認します。
概要:ハードウェアは、製品安全(電気用品、無線、化学物質)の認証が出荷の前提であり、ソフトウェアは個人情報とサイバーセキュリティの規制が中心でしたが、サイバーレジリエンス法と製造物責任指令の改正で、ソフトウェアにも製品としての責任が課されるようになっています。倫理は法規制より広く、Mathur et al.(2019)が示したダークパターンのように、合法でも利用者を欺く設計は信頼を損ないます。例えば、2024年以降の EU では、ソフトウェアの欠陥による損害も製造物責任の対象になります。
⑭ 防御性
定義:良いプロダクトが模倣されたときに、顧客を保ち続けられる理由があることです。防御性(Moat)には、コスト構造、顧客のロックイン、ネットワーク効果、無形資産、市場構造の5つの分類があります。例えば、顧客の業務フローに深く組み込まれたプロダクトは、乗り換えの費用が高く、機能が模倣されても解約されにくくなります。
評価方法:乗り換え費用の大きさ、顧客あたりの蓄積データ量、ネットワーク効果の有無(利用者が増えると価値が上がるか)、競合が同等機能を出したときの解約率の変化で評価します。例えば、競合の同等機能のリリース後に解約率が変わらなければ、防御性は機能以外のところにあります。
概要:ソフトウェアはデータとネットワーク効果が主な防御性で、ハードウェアは製造ノウハウ、特許、流通網、補完財(消耗品、アクセサリー)が主な防御性です。防御性は最初から存在するものではなく、PMF の後に意図して積み上げるものです。例えば、カメラのレンズマウントは、互換レンズの資産が乗り換えを妨げる補完財によるロックインです。
⑮ 戦略との整合
定義:個々の機能やプロダクトが、プロダクトのビジョンと戦略、そして会社の目標に沿っていることです。Cagan & Jones(2020)は、機能の要望をこなす「機能チーム」ではなく、成果に責任を持ち解決策を自ら決める「プロダクトチーム」を提唱しました。例えば、売上目標だけが与えられたチームは値引きに走り、「顧客の継続率を上げる」という成果を与えられたチームは、プロダクトの改善に向かいます。
評価方法:プロダクトビジョンと戦略が文書化されているか、ロードマップ上の各項目が戦略のどの仮説を検証するかを明示できるか、四半期ごとの成果目標(OKR)の達成で評価します。例えば、ロードマップの各項目に「この項目で検証する仮説」を書き、書けない項目は外します。
概要:Jobs は、何をしないかを決めることが集中だと述べ、Bezos(2017)は、顧客への執着と、プロセスが目的化することへの警戒を「Day 1」の条件として挙げました。Horowitz(2014)は、良いプロダクトマネージャーを「製品の CEO」と呼び、結果に責任を持つ役割として定義しました。例えば、要望の多い機能でも、プロダクトの中核の価値を薄めるなら断る判断が戦略です。
E. ハードウェア特有の条件
⑯ 製造性・供給・物理的品質
定義:設計どおりに、目標の原価で、安定した品質で量産でき、部品を安定して調達できる状態です。Boothroyd et al.(2011)の「製造と組立のための設計(DFMA)」は、部品点数の削減と組立の単純化を設計段階で行う方法であり、Taguchi(1986)は、製造のばらつきに対して性能が変わらない「ロバスト設計」を提唱しました。例えば、ネジの種類を3種類から1種類に減らすだけで、組立の時間と誤りが減ります。
評価方法:試作の各段階(EVT、DVT、PVT)での歩留まりや直行率、耐久・環境試験(温度、湿度、落下、振動)の結果、各国の安全・電波認証(CE、FCC、UL など)の取得、量産初期の不良率と返品率、単一供給元の部品の割合で評価します。例えば、PVT で歩留まりが目標に達しなければ、量産開始を遅らせる判断が必要です。
概要:部品の調達先、リードタイム、単一供給元のリスク、在庫の量は、設計と同時に決まります(Ulrich et al., 2020)。Fadell(2022)は、ハードウェアは第1世代で学び、第2世代で直し、第3世代で完成すると述べ、初代で完璧を目指さないことを勧めています。ソフトウェアでこの要素に相当するのは、ビルドとデプロイの再現性、クラウドの供給元依存、実行環境の多様性(OS、ブラウザ、端末)への対応です。例えば、特定の半導体に依存した設計は供給が止まると製品全体の出荷が止まり、単一のクラウド事業者に依存する設計はその対応物です。
F. AI プロダクト特有の条件
AI を中核に置くプロダクトには、出力が確率的で、誤りを含み、利用とともに変化するという、従来のソフトウェアにない性質があります。これまでの要素に加えて、以下の4つの要素が必要です。
⑰ 精度と評価
定義:AI の出力が、実際の利用場面で求められる正確さに達しており、それを再現可能な方法で測れている状態です。Stanford HAI(2025)の AI Index は、公開ベンチマークの多くが飽和し、実際の課題との乖離が広がっていることを指摘しています。例えば、一般的な質問応答の正答率が高いモデルでも、特定の業務文書の読み取りでは誤りが多いことがあります。
評価方法:実データから作った評価用データセット(想定する入力の分布を反映したもの)での精度・再現率・誤りの種類別の集計、人手評価との一致率、リリースごとの回帰テストで評価します(Husain, 2024; Zheng et al., 2023)。例えば、過去の実案件100件を評価セットにし、モデルや指示文を変えるたびに同じセットで比較します。
概要:Karpathy(2017)が「Software 2.0」と呼んだように、AI プロダクトの品質はコードではなくデータと評価で決まります。AI を組み込んだハードウェア(ロボット、車両、医療機器)では、誤りが物理的な危害につながるため、安全側に倒れる設計(フェイルセーフ)と、実環境での検証が追加で必要です。例えば、自動運転では、シミュレーションの走行距離に加えて、実走行での介入回数が評価指標になります。
⑱ AIへの信頼と人間の関与
定義:利用者が、AI を信頼しすぎず、疑いすぎず、適切に頼れている状態です。Amershi et al.(2019)は、AI に何ができるか・どの程度できるかを明示する、間違いを効率的に訂正できる、といった人間と AI の相互作用の18のガイドラインを提示しました。例えば、AI の確信度を表示し、低いときには人間の確認を促す設計がこれに当たります。
評価方法:AI が正しいときと間違っているときの利用者の受け入れ率(較正の度合い)、人間による修正率、修正に要する時間、Google の People + AI Guidebook(PAIR, 2019)のような設計指針への適合で評価します。例えば、AI の誤りを利用者が見つけた割合が低ければ、過信が起きています。
概要:Bansal et al.(2021)は、AI の判断に説明を添えると、AI が間違っているときでも利用者がそれに従いやすくなることを示し、Buçinca et al.(2021)は、利用者に考えることを促す「認知的な強制」が過信を減らすことを示しました。Dell'Acqua et al.(2023)は、AI が得意な課題では品質が上がる一方、不得意な課題では正答率が下がる「ギザギザの境界」を示しており、どこで人間が関与すべきかの設計が成果を分けます。例えば、AI の提案をそのまま承認するボタンだけでなく、根拠の確認を経てから承認する流れが、誤りの見逃しを減らします。
⑲ データの学習ループ
定義:利用から得られるデータが、プロダクトの改善に戻る仕組みがある状態です。DORA(2025)は、AI の効果を左右する能力として、健全なデータのエコシステムと内部データへのアクセスを挙げています。例えば、利用者が AI の出力を修正した履歴が、次の評価データと改善の材料になる設計です。
評価方法:修正データの収集率、収集から改善までの期間、改善後の精度の変化、データの品質とバイアスの監査で評価します。例えば、修正履歴を月ごとに集計し、同じ種類の誤りが減っているかを確認します。
概要:学習ループは、⑭ 防御性のうち蓄積データによるロックインの源泉でもあります。ハードウェアに組み込まれた AI は、現場のデータを回収する通信と、更新を配布する仕組み(OTA)がなければ学習ループが閉じません。例えば、工場に設置した検査機器は、誤検知の記録を回収する経路を設計段階で用意する必要があります。
⑳ コストと応答速度
定義:AI の推論費用と応答時間が、価格と利用体験に見合っている状態です。従来のソフトウェアと異なり、AI プロダクトは利用のたびに推論費用がかかるため、ユニットエコノミクスに直接影響します。例えば、1回の処理に数十円かかる機能を無制限に提供すると、利用が増えるほど赤字になります。
評価方法:1利用あたりの推論費用とその売上に対する比率、応答時間の分布、モデルの軽量化やキャッシュによる費用の低減の効果で評価します。応答時間の許容範囲は、Nielsen(1993)の3つの限界(0.1秒、1秒、10秒)が目安になります。例えば、処理の種類ごとに小さなモデルと大きなモデルを使い分け、費用と精度の均衡点を測ります。
概要:AI は作る側の速さも変えますが、効果は一様ではありません。Peng et al.(2023)の実験では AI 補完の利用者が55.8%速く課題を完了した一方、METR(2025)の無作為化比較試験では、経験豊富な開発者が自分のよく知るコードベースで AI ツールを使うと作業時間が平均19%長くなり、しかも開発者自身は速くなったと感じていました。例えば、AI の効果は体感ではなく、リードタイムと変更失敗率で測る必要があります。
プロダクト開発のプロセス
ステークホルダー
以下では、プロダクト開発に関わる職種を7つの系統に分け、系統ごとに概要と主要なステークホルダーの役割(担う条件・要素、判断の権限、確認すべき指標)を整理します。
プロダクト系
概要:プロダクトマネージャー(何を作るかと成果に責任を持つ)、プロダクトオーナー(スクラムでのバックログの責任者)、プログラムマネージャー・スクラムマスター(進行と障害の除去)。主に A(価値)、D(事業性)、⑪(開発・運用プロセス)に関わります。例えば、小さな組織ではプロダクトマネージャーがプロダクトオーナーと進行管理を兼ねます。
プロダクトマネージャー:A(価値)と D(事業性)の責任者であり、顧客の課題、価値提案、PMF、ユニットエコノミクス、戦略との整合を担います。Horowitz(2014)は、良いプロダクトマネージャーを「製品の CEO」と呼び、言い訳をせず結果に責任を持つ人と定義しました。確認する指標は、PMF 調査、継続率、LTV/CAC、OKR の達成です。例えば、新機能の提案には、検証する仮説と期待する指標の変化を必ず添えます。
デザイン系
概要:UX・UI デザイナー(画面と操作の設計)、UX リサーチャー(利用者調査)、テクニカルライター(文言、ヘルプ、ドキュメント)。主に B(使いやすさ)と⑱(信頼の較正)に関わります。例えば、AI の確信度をどう表示するかは、デザイナーとデータ・機械学習エンジニアの共同の設計です。
デザイナー:B(使いやすさ)の責任者であり、ユーザビリティ、継続利用の導線、アクセシビリティ、魅力と一貫性を担います。確認する指標は、タスク完了率、SUS、WCAG 適合、デザインシステムへの準拠です。例えば、リリース前に5人のユーザビリティテストを実施し、結果をトリオで共有します。
ソフトウェアエンジニアリング系
概要:バックエンド、フロントエンド、モバイル、インフラ・SRE、セキュリティ、データ・機械学習、品質保証(QA)・テストの各エンジニア。主に C(技術的な質)と F(AI プロダクト特有の条件)に関わります。例えば、SLO はバックエンドと SRE が共同で定義し、QA が達成の証拠を独立に確認します。
バックエンドエンジニア:⑧(アーキテクチャと保守性)、⑨(信頼性・性能)、⑩(セキュリティ)を担い、データモデルと API の設計、技術的負債の管理、SLO の達成に責任を持ちます。確認する指標は、変更リードタイム、変更失敗率、テストカバレッジ、脆弱性の件数です。例えば、設計レビューで、変更の影響範囲が一つのモジュールに閉じているかを確認します。
フロントエンドエンジニア:④(ユーザビリティ)と⑥(アクセシビリティ)の技術的な実現、⑨のうち体感の性能(表示速度、応答性)、デザインシステムの実装を担います。確認する指標は、表示速度(Core Web Vitals など)、アクセシビリティの自動検査、UI の不具合率です。例えば、主要画面の表示が目標時間内に収まるかを、リリースごとに自動計測します。
インフラ・SRE エンジニア:⑨(信頼性・性能・スケーラビリティ)、⑩(セキュリティ)、⑪(開発・運用プロセス)を担い、SLO とエラーバジェットの運用、CI/CD と内部プラットフォームの整備、障害対応とポストモーテムに責任を持ちます(Beyer et al., 2016)。DORA(2025)は、高品質な内部プラットフォームを、AI の効果を増幅する能力の一つに挙げています。確認する指標は、SLO 達成率、復旧時間、デプロイ頻度、クラウド費用です。例えば、エラーバジェットを使い切ったら、新機能の開発を止めて安定化に回す権限を持ちます。
データ・機械学習エンジニア:F(AI プロダクト特有の条件)を担い、評価データセットの整備、精度の計測、学習ループの設計、推論費用の管理に責任を持ちます。確認する指標は、評価セットでの精度、人間による修正率、1利用あたりの推論費用です。例えば、モデルや指示文の変更は、評価セットでの比較結果なしにリリースしません。
品質保証(QA):すべての条件について、達成水準が満たされているかを独立に確認し、各段階の判断材料を提供します。確認する指標は、テストの合格率、重大な不具合の件数、回帰テストの結果です。例えば、Phase 4 の終了時に、各要素の達成水準の証拠を提示します。
ハードウェアエンジニアリング系
概要:機構設計、電気・電子設計、ファームウェア・組込みソフトウェア、製造・生産技術、調達・サプライチェーン、認証・規制対応の各担当。主に E(ハードウェア特有の条件)と⑨(信頼性)、⑬(法規制・安全)に関わります。例えば、無線モジュールの各国認証は、電気設計と認証担当が設計段階から計画します。
ハードウェアエンジニア(機構・電気・製造):⑯(製造性・供給・物理的品質)を担い、DFMA、部品の調達、試作の各段階の検証、認証の取得に責任を持ちます。確認する指標は、歩留まり、BOM 原価、故障率、認証の取得状況です。例えば、DVT の終了時に、量産の形状と部品表を凍結する判断を行います。
ビジネス系
概要:セールス、カスタマーサクセス・サポート、マーケティング、法務・コンプライアンス、ファイナンス。主に A(価値)、⑫(ユニットエコノミクス)、⑬(法規制・安全・倫理)に関わります。例えば、解約の理由はカスタマーサクセスからプロダクトマネージャーへ毎月戻します。
セールス・カスタマーサクセス:顧客の課題と不満をプロダクトに戻す経路であり、A(価値)と⑫(ユニットエコノミクス)の情報源です。確認する指標は、解約の理由、導入期間、問い合わせの種類別の件数です。例えば、解約した顧客の理由を毎月トリオに報告します。
外部のステークホルダー
概要:顧客(購買の決定者と現場の利用者は分けて扱います)、デザインパートナー(初期に評価に協力する顧客)、パートナー・サプライヤー、規制当局・認証機関。主に A(価値)の情報源であり、⑬と⑯の制約条件でもあります。例えば、B2B では、購買の決定者が重視する⑫や⑬と、現場の利用者が重視する④や⑤が異なるため、両方を聞く必要があります。
顧客(デザインパートナー):課題の情報源であり、解決策の検証者です。初期の顧客には、定期的なインタビューと試作の評価に協力する「デザインパートナー」としての役割を明示します(Blank, 2013)。例えば、初期の5社と月1回の評価会を設け、試作の段階から意見を得ます。
経営
概要:経営者・創業者、取締役・投資家。主に⑮(戦略との整合)、⑫(ユニットエコノミクス)、⑭(防御性)、資源配分に関わります。例えば、経営者は四半期ごとに成果目標を与え、個々の解決策はトリオに委ねます(Cagan & Jones, 2020)。
経営者・創業者:プロダクトのビジョンと戦略、成果目標の設定、資源の配分を担い、個々の解決策の判断はトリオに委ねます(Cagan & Jones, 2020)。確認する指標は、OKR の達成、PMF、ユニットエコノミクス、法規制のリスクです。例えば、四半期ごとに成果目標を与え、機能の指示は出しません。
開発のプロセス
20の要素は、一度に満たすものではなく、発見と検証を繰り返す過程で順に満たしていくものです。以下では、開発の流れを6つの段階に分け、各段階で確認する要素を、担当するステークホルダー、検証方法、達成水準とともに時系列で列挙します。
Phase 1:顧客課題の発見
Blank(2013)の顧客開発と Torres(2021)の継続的な発見にあたる段階で、作る前に課題の存在と深刻さを確かめます。
① 課題の深刻さと顧客セグメント
ステークホルダー:プロダクトマネージャーと顧客(デザインパートナー)、セールス・カスタマーサクセス。
検証方法:過去の行動を聞く顧客インタビュー(Fitzpatrick, 2013)を週1件以上の頻度で継続し(Torres, 2021)、課題の発生頻度、所要時間、支払額を定量化します。
達成水準:対象セグメントのインタビュー件数が20件以上。同じ課題を自発的に語った顧客の割合が60%以上。課題の発生頻度が週1回以上。現在の代替手段(人手、既存ツール)への支払額または作業時間を把握できた顧客の割合が80%以上。
⑮ 戦略との整合
ステークホルダー:プロダクトマネージャーと経営者。
検証方法:戦略文書と成果目標(OKR)との照合(Cagan & Jones, 2020)。
達成水準:この取り組みが検証する戦略上の仮説が1文で記述されていること。寄与する四半期の成果目標が1つ以上特定され、目標指標の期待される変化量(例:継続率を5ポイント改善)が数値で書かれていること。
⑬ 法規制・安全・倫理
ステークホルダー:プロダクトマネージャーと経営者(ハードウェアでは認証・規制対応の担当者)。
検証方法:適用法規の棚卸しとリスクアセスメント(NIST, 2023)。
達成水準:適用法規(個人情報、消費者保護、業法、製品安全、AI 規制)の棚卸し表が完成し、責任者が未割当の法規がゼロであること。EU AI 法(European Parliament and Council, 2024a)などのリスク分類で、高リスクに該当するかの判定が完了していること。リスクアセスメントで高リスクと判定された項目の対策案の記述率が100%であること。
⑭ 防御性
ステークホルダー:プロダクトマネージャーと経営者。
検証方法:乗り換え費用の見積もりと競合の分析。
達成水準:模倣されたときに顧客を保てる理由(乗り換え費用、蓄積データ、ネットワーク効果、補完財)が1つ以上定義され、その強さを測る先行指標(例:顧客ごとの蓄積データ量、連携済みシステムの数)が1つ以上設定されていること。主要な競合3社以上について、同等機能の有無と価格の比較表があること。
Phase 2:プロダクトの構想
Cagan(2017)の4つのリスクを、作る前に試作で検証する段階です。ハードウェアでは、金型の前にモックアップと並行試作(Dow et al., 2010)で検証します。
② 価値提案と相対的優位性
ステークホルダー:プロダクトマネージャーとデザイナー。
検証方法:代替手段との比較表、Kano アンケート(Witell et al., 2013)、試作を使ったインタビュー。製品の優位性は成功要因の中で最も影響が大きいため(Cooper & Kleinschmidt, 1987)、改善幅を数値で示します。
達成水準:試作を見た顧客のうち「他の手段ではなくこれを使う理由」を自分の言葉で言えた割合が70%以上。Kano アンケートで中核機能が魅力的品質または一元的品質に分類されること。代替手段と比べた改善幅が主要指標で明確であること(例:作業時間を50%以上短縮)。
④ ユーザビリティ
ステークホルダー:デザイナーとプロダクトマネージャー。
検証方法:5人程度のユーザビリティテスト(Nielsen, 2000)を、試作を改良しながら複数回実施します。
達成水準:主要タスクの完了率が80%以上(Sauro & Lewis, 2016 が報告する平均値は78%)。同じ箇所で2人以上がつまずく問題がゼロになるまで修正を繰り返すこと。主要タスクの所要時間が現在の代替手段より短いこと。
⑫ ユニットエコノミクス
ステークホルダー:プロダクトマネージャーと経営者。
検証方法:価格の受容性のインタビューと、コホートを想定した収益と費用の試算。
達成水準:想定価格と費用で LTV/CAC が3以上、CAC の回収期間が12か月以内(Skok, 2013)。価格の受容性のインタビューで、想定価格を「高すぎる」と答えた割合が30%未満。ハードウェアでは、BOM 原価、製造費、物流費を含めた粗利率が目標(例:40%以上)を満たすこと。
⑯ 製造性・供給
ステークホルダー:ハードウェアエンジニア(機構・電気・製造)と調達担当。
検証方法:DFMA レビュー(Boothroyd et al., 2011)と部品の調達リードタイムの確認。
達成水準:部品点数と組立時間の目標値が設定され、初期案から部品点数を20%以上削減する案が出ていること。単一供給元の部品がすべて特定され、その100%に代替品または在庫の方針があること。主要部品の調達リードタイムが量産計画の余裕(例:4週間)に収まること。
⑰ 精度と評価
ステークホルダー:データ・機械学習エンジニアとプロダクトマネージャー。
検証方法:過去の実案件からの評価セットの作成と、人手評価の評価者間の一致率の確認。自動評価を使う場合は、人手評価との一致率を確認します(Zheng et al., 2023)。
達成水準:実データの分布を反映した評価セットが、主要な誤りの種類ごとに30件以上あること。人手評価の評価者間の一致率が80%以上。求める精度の水準(例:重大な誤りの率1%未満)と、下回った場合の対応が文書化されていること。
Phase 3:プロダクトの設計
作る前に、変更可能性、信頼性、セキュリティ、アクセシビリティを設計で確保する段階です。問題の発見を前倒しするほど、開発期間と品質が改善します(Thomke & Fujimoto, 2000)。
⑧ アーキテクチャと保守性
ステークホルダー:バックエンドエンジニア。
検証方法:設計レビュー(モジュール境界、依存の方向、重複)(Parnas, 1972)。
達成水準:想定する変更シナリオ(5件程度)のうち、影響範囲が1つのモジュールに閉じる割合が80%以上。モジュール間の循環依存がゼロ。技術的負債の返済に開発時間の10〜20%を確保する計画があること(Besker et al., 2019 は、負債による損失を開発時間の約23%と報告)。
⑨ 信頼性・性能・スケーラビリティ
ステークホルダー:バックエンドエンジニア、インフラ・SRE エンジニア、ハードウェアエンジニア。
検証方法:SLO の文書化、障害を前提とした設計のレビュー(Nygard, 2018)、負荷試験の計画。
達成水準:主要機能ごとに SLO(例:可用性99.9%、応答時間の95パーセンタイル値1秒以内)とエラーバジェット(可用性99.9%なら月約43分)が文書化されていること(Beyer et al., 2016)。ハードウェアでは、目標の年間故障率(例:1%未満)と、耐久・環境試験の条件(温度、湿度、落下、振動)および試験数が決まっていること。
⑩ セキュリティとプライバシー
ステークホルダー:バックエンドエンジニアとインフラ・SRE エンジニア(セキュリティ担当がいればその担当者)。
検証方法:脅威モデリングと OWASP Top 10 に基づく設計レビュー(OWASP, 2021; Cavoukian, 2009)。
達成水準:脅威モデリングで特定した高リスクの脅威のうち、対策が設計に反映された割合が100%。個人データの項目ごとに保持期間と削除手順が定義された割合が100%。OWASP Top 10 の各項目に対する設計上の対策が記述されていること。
⑥ アクセシビリティと国際化
ステークホルダー:デザイナーとフロントエンドエンジニア(ハードウェアでは認証・規制対応の担当者)。
検証方法:デザインのアクセシビリティチェックと地域要件の棚卸し(W3C, 2023)。
達成水準:デザイン段階で WCAG 2.2 の AA の達成基準(例:文字のコントラスト比4.5:1以上)をすべて満たすこと(W3C, 2023)。対象地域ごとに、言語、通貨、日付の形式、電源、無線認証の要件表が完成していること。
⑱ AIへの信頼と人間の関与
ステークホルダー:データ・機械学習エンジニアとデザイナー。
検証方法:Amershi et al.(2019)のガイドラインと PAIR(2019)の指針への適合確認。
達成水準:AI の出力に確信度または根拠を表示する設計があり、Amershi et al.(2019)の18のガイドラインのうち該当する項目の適合率が100%。人間の確認が必要な処理が特定され、確認と訂正の所要時間の目標(例:1件30秒以内)が設定されていること。
⑳ コストと応答速度
ステークホルダー:データ・機械学習エンジニアとインフラ・SRE エンジニア。
検証方法:処理の種類ごとの費用と応答時間の試算、モデルの使い分けの設計。
達成水準:処理の種類ごとの1利用あたりの推論費用が試算され、売上に対する推論費用の比率が目標(例:20%未満)に収まること。応答時間の目標が、Nielsen(1993)の3つの限界(0.1秒、1秒、10秒)に基づいて処理ごとに定義されていること(例:対話型の処理は10秒以内、それを超える処理は途中経過を表示)。
Phase 4:プロダクトの実装と検証
小さく頻繁に作り、各段階で検証する段階です。ハードウェアでは、技術検証(EVT)、設計検証(DVT)、量産検証(PVT)の各段階で金型と部品の発注が確定するため、Cooper(1990)のステージゲートのように段階ごとに継続か中止かを判断します(Fadell, 2022)。
⑪ 開発・運用プロセス
ステークホルダー:インフラ・SRE エンジニアと全エンジニア。
検証方法:デプロイ頻度、変更のリードタイム、変更失敗率、復旧時間の4指標の継続計測(Forsgren et al., 2018; DORA, 2025)。
達成水準:DORA(2024)の上位グループの水準、すなわちデプロイ頻度がオンデマンド(1日に複数回)、変更のリードタイムが1日未満、変更失敗率が5%以下、失敗したデプロイの復旧時間が1時間未満。AI の利用後も変更失敗率が悪化していないこと(DORA, 2025)。
④ ユーザビリティ
ステークホルダー:フロントエンドエンジニアとデザイナー。
検証方法:実装後のユーザビリティテスト(Nielsen, 2000)と SUS の計測(Sauro & Lewis, 2016)、Core Web Vitals の自動計測の CI への組み込み(Walton, 2020)。
達成水準:主要タスクの完了率が90%以上。SUS が68以上(平均値。Sauro & Lewis, 2016)、できれば80以上。Core Web Vitals が LCP 2.5秒以内、INP 200ミリ秒以内、CLS 0.1以下(Walton, 2020)。
⑥ アクセシビリティと国際化
ステークホルダー:フロントエンドエンジニアとデザイナー(ハードウェアでは認証・規制対応の担当者)。
検証方法:アクセシビリティの自動検査(WCAG 準拠の検査ツール)の CI への組み込みと、支援技術(スクリーンリーダー、キーボードのみの操作)での操作確認、対象地域ごとの表示(言語、通貨、日付の形式)の確認。ハードウェアでは、対象地域の電源仕様と無線認証の要件を試作で確認します。
達成水準:自動検査での WCAG 2.2 AA の違反がゼロ(W3C, 2023)。スクリーンリーダーとキーボードのみの操作で、主要タスクの完了率が100%。Phase 3 で作成した地域ごとの要件表の項目のうち、実装で確認された割合が100%。
⑨ 信頼性・性能
ステークホルダー:バックエンドエンジニア、インフラ・SRE エンジニア、ハードウェアエンジニア。
検証方法:負荷試験と障害注入(依存先の停止)の試験(Nygard, 2018)。ハードウェアでは耐久・環境試験(温度、湿度、落下、振動)と加速寿命試験。
達成水準:想定ピークの2倍の負荷で、応答時間の95パーセンタイル値が SLO 内、エラー率が0.1%未満。依存先の停止時に自動で縮退・復旧すること。ハードウェアでは、耐久・環境試験の合格率が100%で、加速寿命試験の推定故障率が目標(例:年1%未満)を下回ること。
⑩ セキュリティ
ステークホルダー:バックエンドエンジニアとインフラ・SRE エンジニア。
検証方法:脆弱性診断、侵入テスト、依存ライブラリの自動検査(NIST, 2022)。
達成水準:脆弱性診断と侵入テストで、重大度「高」以上の未対応の脆弱性がゼロ。依存ライブラリの既知の脆弱性の未対応件数がゼロ(重大度「中」以下は対応期限を設定)。CI でのセキュリティ検査の実施率が100%。
⑯ 製造性・供給
ステークホルダー:ハードウェアエンジニアと製造・調達担当。
検証方法:EVT・DVT・PVT の各段階の試作の評価と、直行率(一度で合格する割合)の計測。
達成水準:EVT で主要機能の動作が仕様の100%で確認されること。DVT で量産形状と部品表が凍結され、以後の設計変更がゼロに収束すること。PVT で量産ラインの直行率が目標(例:95%以上)に達し、組立時間が目標時間内で、認証(安全、電磁両立性、無線)の取得が完了していること。
⑰ 精度と評価
ステークホルダー:データ・機械学習エンジニアと QA。
検証方法:評価セットでの自動評価を毎リリースで実行し、人手評価と定期的に突き合わせること(Zheng et al., 2023)。
達成水準:評価セットでの精度が目標以上で、モデルや指示文の変更前後で主要指標の低下が1ポイント以内。自動評価と人手評価の一致率が80%以上(Zheng et al., 2023 が報告する水準)。毎リリースでの評価の実施率が100%。
⑲ データの学習ループ
ステークホルダー:データ・機械学習エンジニア。
検証方法:修正データの収集率の計測。
達成水準:主要な出力の種類ごとに、利用者の修正を記録する仕組みの実装率が100%。修正データの収集率(修正が起きた件数のうち記録された割合)が90%以上。収集したデータが評価セットに追加されるまでの期間が1か月以内。
Phase 5:プロダクトの運用と計測
リリース後に、価値が実際に生まれているかを測る段階です。計測の枠組みには AARRR(McClure, 2007)と HEART(Rodden et al., 2010)を使い、施策の効果は A/B テストで確かめます(Kohavi et al., 2020)。成長段階ごとの最重要指標(OMTM)は別稿「スタートアップ・新規事業が各ステージで達成すべき OMTM と KPI」を参照してください。
③ プロダクトマーケットフィット
ステークホルダー:プロダクトマネージャー。
検証方法:PMF 調査、コホート分析、NPS(Reichheld, 2003)。ハードウェアでは、返品率とレビュー、接続機器であれば稼働率で代替します。
達成水準:「使えなくなったら非常に残念」と答える利用者の割合が40%以上(Ellis & Brown, 2017)。コホートの継続率曲線が3〜6か月で平らになること。NPS がプラスであること(ただし NPS 単独の予測力には限界があるため、継続率と併用する。Keiningham et al., 2007)。ハードウェアでは、返品率が目標(例:3%未満)以内で、レビューの平均評価が5点満点で4以上。
⑤ 継続利用と習慣化
ステークホルダー:プロダクトマネージャーとデザイナー。
検証方法:活性化率、リテンション曲線、HEART の5指標の計測。
達成水準:活性化率(登録から主要な価値の体験までの到達率)が目標(例:40%以上)。月次の継続率が直前のコホートと同じか改善していること。HEART の5指標のうち、タスク成功率と再訪率が目標を達成していること(Rodden et al., 2010)。
⑨ 信頼性・性能
ステークホルダー:インフラ・SRE エンジニア。
検証方法:SLO の監視と、障害のポストモーテム(Beyer et al., 2016)。
達成水準:月次の SLO 達成率が目標以上(例:可用性99.9%)で、エラーバジェットの消費が100%未満。重大障害のポストモーテムの実施率が100%で、再発防止策の期限内の完了率が90%以上。
⑫ ユニットエコノミクス
ステークホルダー:プロダクトマネージャーと経営者、セールス・カスタマーサクセス。
検証方法:コホート別の収益と費用の集計。
達成水準:実績の LTV/CAC が3以上、CAC の回収期間が12か月以内、純収益維持率が100%以上(Skok, 2013)。ハードウェアでは、保証と返品の費用を含めた粗利率が目標(例:40%以上)を満たすこと。
⑲ データの学習ループ
ステークホルダー:データ・機械学習エンジニア。
検証方法:修正履歴の集計と、改善前後の精度の比較、データのバイアスの監査。
達成水準:修正データの収集率が90%以上。同じ種類の誤りの発生率が月次で減少していること(例:四半期で30%減)。改善前後の精度の比較が毎回記録され、データのバイアスの監査が四半期に1回以上行われていること。
⑳ コストと応答速度
ステークホルダー:インフラ・SRE エンジニアとデータ・機械学習エンジニア。
検証方法:費用と応答時間の継続計測と、モデルの使い分けの効果の測定。
達成水準:売上に対する推論費用の比率が目標(例:20%未満)以内。応答時間の95パーセンタイル値が処理ごとの目標内。モデルの使い分けによる費用の削減幅が計測されていること。
Phase 6:振り返りと改善
計測の結果を次の計画に戻す段階です。ソフトウェアでは週や四半期の単位で、ハードウェアでは世代の単位で回ります(Fadell, 2022)。
⑪ 開発・運用プロセス
ステークホルダー:インフラ・SRE エンジニアと全エンジニア。
検証方法:リリースの振り返りと4指標の定期計測。
達成水準:4指標の四半期の推移が横ばいまたは改善していること(DORA, 2024 の上位グループの水準に向かう)。振り返りで決めた改善策の実施率が80%以上。
⑧ アーキテクチャと保守性
ステークホルダー:バックエンドエンジニア。
検証方法:負債の棚卸しと変更リードタイムの推移(Besker et al., 2019)。
達成水準:技術的負債の棚卸し表が四半期に1回以上更新されていること。返済に開発時間の10〜20%が実際に使われていること(計画比80%以上)。変更のリードタイムが前四半期より悪化していないこと。
⑭ 防御性
ステークホルダー:プロダクトマネージャーと経営者。
検証方法:競合の動向の追跡と解約率の比較。
達成水準:競合が同等機能を出した後の四半期で、解約率の上昇が1ポイント以内。防御性の先行指標(蓄積データ量、連携済みシステムの数)が前四半期より増加していること。
⑮ 戦略との整合
ステークホルダー:プロダクトマネージャーと経営者。
検証方法:OKR の振り返り(Camuffo et al., 2020 の科学的アプローチのように、仮説と結果を照合する)。
達成水準:四半期の成果目標の達成率が目標(例:70%以上。野心的な目標を置くため100%は求めない)に達していること。達成できなかった仮説について、棄却または修正の記録率が100%であること。
⑬ 法規制・安全・倫理
ステークホルダー:プロダクトマネージャーと経営者。
検証方法:法規の棚卸しの定期更新と外部監査。
達成水準:法規の棚卸しの更新が年1回以上、かつ新しい市場や用途への展開前に100%行われていること。外部監査の指摘事項の期限内の対応率が100%。
⑯ 製造性・供給
ステークホルダー:ハードウェアエンジニアとプロダクトマネージャー。
検証方法:量産初期の不良率と返品率の分析(Fadell, 2022)。
達成水準:量産開始から3か月の不良率と返品率が目標内であること。不良と返品の上位3つの要因が、第2世代の設計変更に反映されていること。
③ プロダクトマーケットフィット
ステークホルダー:プロダクトマネージャー。
検証方法:PMF 調査とコホート分析の定期実施(Olsen, 2015)。
達成水準:PMF 調査を四半期に1回以上実施し、「非常に残念」の割合が40%以上を維持していること。継続率が前年同期と比べて悪化していないこと。
最新の研究・実務家の動向
最新の研究の動向
製品の優位性が第1位:Cooper & Kleinschmidt(1987)は約200の新製品を分析し、独自の便益を持つ優れた製品が成功と失敗を最も強く分けると示しました。Henard & Szymanski(2001)は60の研究のメタ分析で、製品の優位性、市場の潜在性、顧客ニーズの充足、開発前の計画の質、開発資源の投入が、一貫して成功と結びつく要因だと報告し、Evanschitzky et al.(2012)の更新されたメタ分析でも、製品の優位性と市場志向の効果が確認されました。例えば、営業力や広告は、優れた製品の効果を補うことはできても代替できません。
機能は多いほど良いわけではない:Thompson et al.(2005)は、消費者は購入前には機能の多い製品を選ぶが、使い始めると多機能な製品ほど満足度が下がり、再購入意向も下がる「機能疲れ」を実験で示しました。例えば、比較表で機能数を競って勝った製品が、発売後の評価では「使いにくい」と言われる現象は、この研究で説明できます。
魅力的品質は時間とともに当たり前になる:Witell et al.(2013)は Kano モデルの30年の研究を総括し、魅力的品質が時間とともに一元的品質、当たり前品質へ移る「品質の経年変化」が繰り返し確認されていると述べています。例えば、スマートフォンのカメラは魅力的品質から当たり前品質へ移り、今は画質が一元的品質として競われています。
美しさは使いやすさの知覚を高める:Kurosu & Kashimura(1995)は ATM の画面で、見た目の美しさの評価と使いやすさの評価が強く相関することを見いだし、Tractinsky et al.(2000)はこれを追試して、実際の使いやすさが同じでも美しい画面は使いやすいと知覚されることを確認しました。例えば、同じ機能の2つの申請画面でも、整った方が「分かりやすい」と評価され、利用者の忍耐も長くなります。
利用者の参加はシステムの成功と結びつく:Bano & Zowghi(2015)は、利用者の参加とシステム開発の成功の関係を扱った87の研究を系統的に検討し、大半の研究で正の関係が確認されたと報告しました。例えば、要件定義の段階から利用者が参加したプロジェクトは、受け入れテストでの手戻りが少なくなります。
技術受容を説明する要因:Davis(1989)の技術受容モデルを統合した Venkatesh et al.(2003)の UTAUT は、成果期待、努力期待、社会的影響、促進条件の4つが利用意図と利用行動の分散の約70%を説明すると報告しました。例えば、業務システムの導入では、使いやすさだけでなく、上司や同僚が使っているという社会的影響と、サポート体制という促進条件が定着を左右します。
ソフトウェア開発の実証:Forsgren et al.(2018)は、数年にわたる調査で、デプロイ頻度、リードタイム、変更失敗率、復旧時間の4指標が組織の業績と結びつくことを示しました。DORA(2024)は、AI の利用の増加が、スループットの1.5%の低下と安定性の7.2%の低下と関連していたという結果を報告し、DORA(2025)は、スループットは改善に転じたが不安定性は増え続けていると報告しています。例えば、AI の導入は、まず小さなバッチとバージョン管理という基盤を整えてから進めるのが研究の示唆です。
アジャイルの効果:Serrador & Pinto(2015)は1,002件のプロジェクトを分析し、アジャイルの採用度が高いほど、効率と関係者の満足度の両面でプロジェクトの成功度が高いことを示しました。一方で Shepherd & Gruber(2021)は、リーンスタートアップの各要素のうち実証されている点と未検証の点を整理し、手法の名前ではなく個々の実践の効果を問うべきだと論じています。例えば、スプリントの儀式だけを導入して顧客との接点を増やさないチームは、研究が示す効果を得られません。
技術的負債の費用:Besker et al.(2019)は、開発者が作業時間の平均23%を技術的負債への対処に費やしていると報告しました。例えば、5人のチームでは、常に1人分以上の工数が負債の利子に消えている計算になります。
心理的安全性とチームの成果:Edmondson(1999)は、失敗を報告しても罰せられないという「心理的安全性」が、チームの学習行動と成果を高めることを示し、Google の社内研究(Rozovsky, 2015)は、180のチームを分析して、心理的安全性がチームの効果を最も強く予測する要因だったと報告しました。例えば、障害のポストモーテムで個人を責めないという SRE の原則(Beyer et al., 2016)は、この研究と整合します。
生産性は一つの指標では測れない:Forsgren et al.(2021)の SPACE フレームワークは、開発者の生産性を、満足度、成果、活動量、コミュニケーション、効率の5つの側面で捉え、コミット数のような単一の活動指標で測ることの危険を指摘しました。例えば、AI でコードの行数が増えても、レビュー待ちの時間が伸びていれば生産性は上がっていません。
科学的アプローチの効果:Camuffo et al.(2020)の無作為化比較試験と、Camuffo et al.(2024)の大規模な追試は、仮説を明示して検証する訓練が、見込みのない事業からの早い撤退と収益の向上をもたらすことを示しました。例えば、同じリーンスタートアップでも、仮説を書いて検証するチームと、ただ試作を繰り返すチームでは成果が異なります。
前倒しの問題解決と並行試作:Thomke & Fujimoto(2000)は、トヨタの開発データから、問題の発見と解決を開発の早い段階に前倒しすることが開発期間と品質を改善することを示し、Dow et al.(2010)は、複数の案を並行して試作する方が、一つの案を順に改良するより良い設計と多様な探索につながることを実験で示しました。例えば、ハードウェアの筐体は、金型の前に3案を同時に試作して比較する方が、1案を5回直すより良い結果になります。
オンライン実験の現実:Kohavi et al.(2020)は、Microsoft や Bing で行われた大量の A/B テストの経験から、改善を狙った施策のうち主要指標を実際に改善したものは3分の1程度にとどまると報告し、信頼できる実験の設計方法を整理しました。例えば、「この変更は良くなるに決まっている」という案でも、半数以上は効果がないか悪化するため、測ってから広げる規律が必要です。
人間と AI の協働:Bansal et al.(2021)は、AI の説明が利用者の過信を強めうることを、Buçinca et al.(2021)は、考えることを促す介入が過信を減らすことを示しました。例えば、AI プロダクトの UI は、説明を増やすだけでは安全にならず、利用者の確認を引き出す設計が必要です。
生成 AI と生産性:Brynjolfsson et al.(2025)は、顧客サポートの現場で生成 AI の支援が処理件数を平均14%増やし、経験の浅い担当者では34%増えた一方、熟練者ではほとんど変わらなかったと報告しました。Peng et al.(2023)はプログラミング課題で AI 補完の利用者が55.8%速く完了したことを、Dell'Acqua et al.(2023)はコンサルタントの実験で、AI が得意な課題では品質が40%上がる一方、不得意な課題では正答率が19ポイント下がる「ギザギザの境界」を報告しました。METR(2025)は、経験豊富な開発者が自分のよく知るコードベースで AI を使うと作業時間が19%長くなったと報告しています。例えば、AI の効果は、作業の種類と使い手の熟練度によって正にも負にもなるため、自社の業務で測る必要があります。
AI の評価手法:Zheng et al.(2023)は、強力な言語モデルを評価者として使う方法が、人間の評価者と約80%一致し、人間同士の一致率と同程度であることを示しました。Stanford HAI(2025)は、公開ベンチマークの多くが飽和し、実際の課題との乖離が広がっていると指摘しています。例えば、自社の評価セットでの自動評価を回帰テストとして毎リリースで走らせ、定期的に人手評価と突き合わせる運用が、この2つの研究の示唆です。
ダークパターンとアクセシビリティの実態:Mathur et al.(2019)は約11,000のショッピングサイトを自動分析し、約11%に利用者を欺く「ダークパターン」が含まれていたと報告しました。WebAIM(2024)は上位100万サイトのトップページの95.9%に自動検出できる WCAG の違反があったと報告しています。例えば、継続率を上げるための設計は、ダークパターンに当たらないかを公開された分類で確認し、アクセシビリティは自動検査を CI に組み込むことが最低線になります。
NPS の限界:Keiningham et al.(2007)は、NPS(Net Promoter Score)が企業の成長を予測する力において他の顧客満足指標より優れているという主張を検証し、優位性を確認できなかったと報告しました。例えば、NPS は単独の成長予測指標としてではなく、継続率と解約理由と組み合わせて使うのが研究の示唆です。
最新の実務家の動向
価値について:Y Combinator の標語「人々が欲しがるものを作れ」(Graham, 2013)、Bezos(2017)の「顧客への執着」、Jobs(1997)の「顧客体験から始めて技術へ遡る」は、いずれも A(価値)を最上位に置いています。例えば、Amazon は、会議で空席の椅子を顧客の席として置く慣行で、顧客の視点を強制しました(Bryar & Carr, 2021)。
顧客の声か、ビジョンか:Blank(2013)と Torres(2021)は顧客から学ぶことを重視し、Jobs は、人は見せられるまで何が欲しいか分からないことが多いと述べました(Jobs, 1998)。両者の分担は、課題は顧客から学び、解決策は作り手が構想して検証する、というものです。例えば、顧客は「もっと速い馬」を求めますが、「移動を速くしたい」という課題は正しく、解決策(自動車)は作り手が構想します。
使いやすさと魅力について:Krug(2014)の「考えさせない」、Rams(Vitsœ, n.d.)の「できる限り少ないデザイン」、Google(n.d.)の「利用者に集中すれば、他のすべては後からついてくる」は、B(使いやすさ)の原則です。例えば、Google の検索画面の空白は、この原則の物理的な表現です。
機能の追加か、引き算か:Kano モデルは魅力的品質の追加を、Rams と Musk は引き算を重視します。Musk は、要件を疑う、部品や工程を削る、単純化する、速くする、自動化する、という順序を示し、削る前に自動化してはならないと述べました(Everyday Astronaut, 2021)。両者は矛盾せず、追加する機能は魅力的品質に限り、当たり前品質になった機能は単純化する、という時間軸の問題です。例えば、新機能の提案には「代わりに何を削るか」を添え、使われていない機能の廃止を定期的に判断します。
技術的な質について:Brooks(1995)の「遅れたプロジェクトに人を足すとさらに遅れる」、Beyer et al.(2016)のエラーバジェット、Fadell(2022)の「3世代で完成する」は、C(技術的な質)を、理想の追求ではなく制約の管理として扱っています。例えば、エラーバジェットは、安定性と新機能の対立を、数値で決着させる仕組みです。
速さと品質を両立する運用:Singer(2019)の Shape Up は6週間の固定期間に仕事を収め、Bryar & Carr(2021)の Working Backwards はプレスリリースから逆算し、Beyer et al.(2016)の SRE はエラーバジェットで新機能と安定性の均衡を決めます。Forsgren et al.(2018)の研究が示すとおり、速さと安定性はトレードオフではなく、同じ投資(小さなバッチ、自動化)で両方が上がります。例えば、3か月分の機能を一度に出すより、2週間ごとに出して反応を見る方が、間違った方向に進む期間が短くなります。
早く出すか、作り込んでから出すか:Hoffman & Yeh(2018)は、最初の版を恥ずかしいと思わないなら出すのが遅すぎると述べ、Graham(2013)は、初期には手作業で顧客を獲得し支援するなど「スケールしないこと」を勧めました。一方で、Dyson(2021)が5,127個の試作を経て発売したように、物理的な製品は出す前の反復が必要です。例えば、ソフトウェアは限定公開で早く出し、ハードウェアは試作の反復を早く多く回す、と使い分けます。
現場を見る:Toyota の「現地現物」(Liker, 2004)は、報告ではなく現場で事実を確かめることを原則とし、Torres(2021)の継続的な発見は、週に数件の顧客インタビューを固定の習慣にすることを求めます。Vohra(2018)は、PMF 調査の自由回答を分類して改善の優先順位を決める手順を公開しました。例えば、初期の顧客には、創業者自身が導入作業を行い、その過程で課題を学びます。
事業性と戦略について:Horowitz(2014)の「良いプロダクトマネージャーは製品の CEO として結果に責任を持つ」、Cagan & Jones(2020)の「機能チームではなくプロダクトチーム」、Bezos(2017)の「プロセスが目的化することへの警戒」は、D(事業性)を、個々の機能ではなく成果の問題として扱っています。例えば、成果(継続率)を与えられたチームは、機能の数ではなく継続率で評価されます。
プロダクト運営モデルへの転換:Cagan(2024)は、機能の要望を順にこなす「機能チーム」から、成果に責任を持つ「プロダクトチーム」への移行を「プロダクト運営モデル」として体系化し、経営者、プロダクトリーダー、チームのそれぞれが変えるべき行動を整理しました。例えば、ロードマップを機能の一覧から、四半期ごとの成果目標と検証する仮説の一覧に置き換えることが、その最初の一歩です。
創業者の関与の仕方:Graham(2024)は、Airbnb の Chesky の経験をもとに、権限委譲を重視する「マネージャーモード」に対して、創業者が細部に直接関わる「ファウンダーモード」を提起し、実務家の間で議論を呼びました。Cagan & Jones(2020)の「解決策はチームに委ねる」という原則との緊張関係が論点です。例えば、創業者がプロダクトの細部に関わるとしても、成果目標と検証の規律を壊さない形で関わるかどうかが分かれ目になります。
AI による開発の変化:Karpathy(2017)は、人が書くコードが学習されたモデルに置き換わる「Software 2.0」を提起し、開発者の仕事はコードを書くことからデータを整えることへ移ると述べました。DORA(2025)は、AI は組織の強みと弱みを増幅すると報告しています。例えば、AI でコードの生成が速くなっても、レビューとテストが追いつかなければ変更失敗率が上がります。
AI プロダクトの評価を中心に据える:Husain(2024)は、AI プロダクトの成否は、実データに基づく評価の仕組みを作れるかで決まると述べ、評価を要件定義に相当するものとして扱うことを勧めました。これは Zheng et al.(2023)や Stanford HAI(2025)の研究と整合します。例えば、モデルや指示文の変更を、自社の評価セットでの比較なしにリリースしない運用がその実践です。
ハードウェアの実務家の共通点:Fadell(2022)の「3世代で完成する」、Dyson(2021)の試作の反復、Musk の引き算の工程(Everyday Astronaut, 2021)、Toyota の現地現物(Liker, 2004)は、いずれも、物理的な製品では試作の回数と早さ、そして部品と工程の削減が品質を決めるという点で一致しています。例えば、初代の機器では機能を絞り、学んだことを第2世代に反映する計画を最初から持ちます。
習慣化と倫理の線引き:Eyal(2014)は、作り手自身が使うか、利用者の生活を改善するか、という2つの問いで習慣化の設計を正当化できるかを判断する枠組みを示し、Google(PAIR, 2019)と Microsoft(Amershi et al., 2019)は、AI プロダクトの設計指針を公開しました。Mathur et al.(2019)の研究が示すダークパターンの広がりに対して、EU の AI 法(European Parliament and Council, 2024a)のような規制が設計の制約として加わっています。例えば、継続率を上げる施策は、利用者に説明できるかどうかを基準に判断します。
おわりに
本稿では、良いプロダクトの条件を6つの条件と20の要素に分解し、開発の各 Phase で誰が何をどの水準まで確かめるかを整理しました。達成水準の数値は目安であり、各社の実績に合わせて置き換えることを前提としています。新しいプロダクトを構想するとき、あるいは既存のプロダクトを点検するときの、網羅的な視点として役立てば幸いです。
参考文献
Amershi, S., Weld, D., Vorvoreanu, M., Fourney, A., Nushi, B., Collisson, P., Suh, J., Iqbal, S., Bennett, P. N., Inkpen, K., Teevan, J., Kikin-Gil, R., & Horvitz, E. (2019). Guidelines for human-AI interaction. Proceedings of the 2019 CHI Conference on Human Factors in Computing Systems, Paper 3. 概要:Microsoft の研究者が、150以上の設計指針を整理して18のガイドラインに集約し、利用者調査で妥当性を検証した。AI に何ができるかを明示する、誤りの訂正を効率化する、などを含む。
Andreessen, M. (2007). The only thing that matters. pmarchive. https://pmarchive.com/guide_to_startups_part4.html 概要:スタートアップの成否を分ける唯一の要因としてプロダクトマーケットフィットを定義し、「良い市場にいて、その市場を満足させるプロダクトを持つこと」と説明したエッセイ。
Bano, M., & Zowghi, D. (2015). A systematic review on the relationship between user involvement and system success. Information and Software Technology, 58, 148–169. 概要:利用者の参加とシステム開発の成功の関係を扱った87の研究を系統的に検討し、大半で正の関係が確認されたと報告した。
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, Article 81. 概要:AI の判断に説明を添えると、AI が誤っているときにも利用者がそれに従いやすくなり、人間と AI の協働の成果が必ずしも上がらないことを実験で示した。
Besker, T., Martini, A., & Bosch, J. (2019). Software developer productivity loss due to technical debt: A replication and extension study examining developers' development work. Journal of Systems and Software, 156, 41–61. 概要:43人の開発者の作業記録をもとに、作業時間の平均23%が技術的負債への対処に費やされていることを示した。
Beyer, B., Jones, C., Petoff, J., & Murphy, N. R. (Eds.). (2016). Site reliability engineering: How Google runs production systems. O'Reilly Media. 概要:Google の SRE の実践をまとめた書籍。サービスレベル目標(SLO)とエラーバジェットによって、信頼性と新機能開発の均衡を数値で決める考え方を示した。
Bezos, J. (2017). 2016 letter to shareholders. Amazon. 概要:「Day 1」を保つ条件として、顧客への執着、プロセスの目的化への抵抗、外部トレンドの受容、迅速な意思決定を挙げた株主への手紙。
Blank, S. (2013). The four steps to the epiphany: Successful strategies for products that win (2nd ed.). K&S Ranch. 概要:製品開発と並行して顧客を発見し検証する「顧客開発」のモデルを提唱し、リーンスタートアップの基礎となった書籍。
Boothroyd, G., Dewhurst, P., & Knight, W. A. (2011). Product design for manufacture and assembly (3rd ed.). CRC Press. 概要:部品点数の削減と組立の単純化を設計段階で行う DFMA の手法を体系化した教科書。
Brooke, J. (1996). SUS: A "quick and dirty" usability scale. In P. W. Jordan, B. Thomas, B. A. Weerdmeester, & I. L. McClelland (Eds.), Usability evaluation in industry (pp. 189–194). Taylor & Francis. 概要:10項目の質問でユーザビリティを0〜100点で評価する System Usability Scale(SUS)を提案した。
Brooks, F. P. (1995). The mythical man-month: Essays on software engineering (Anniversary ed.). Addison-Wesley. 概要:「遅れたソフトウェアプロジェクトに人を追加するとさらに遅れる」というブルックスの法則を含む、ソフトウェア開発の管理に関する古典。
Bryar, C., & Carr, B. (2021). Working backwards: Insights, stories, and secrets from inside Amazon. St. Martin's Press. 概要:Amazon の元幹部が、プレスリリースと FAQ から始める Working Backwards、シングルスレッドリーダー、顧客の空席などの仕組みを解説した。
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889–942. 概要:顧客サポートの現場で生成 AI の支援が処理件数を平均14%増やし、経験の浅い担当者ほど効果が大きかったことを示した実証研究。
Buçinca, Z., Malaya, M. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), Article 188. 概要:AI の提案を見る前に自分で考えさせるなどの「認知的な強制」が、AI への過信を減らすことを実験で示した。
Cagan, M. (2017). Inspired: How to create tech products customers love (2nd ed.). Wiley. 概要:良いプロダクトの条件を価値・使いやすさ・実現可能性・事業性の4つのリスクとして整理し、作る前に検証するプロダクトディスカバリーを提唱した。
Cagan, M. (2024). Transformed: Moving to the product operating model. Wiley. 概要:機能チームから成果に責任を持つプロダクトチームへの移行を「プロダクト運営モデル」として体系化し、変革の手順を解説した。
Cagan, M., & Jones, C. (2020). Empowered: Ordinary people, extraordinary products. Wiley. 概要:機能の要望をこなす「機能チーム」と、成果に責任を持ち解決策を自ら決める「プロダクトチーム」を対比し、後者を実現するリーダーシップを論じた。
Camuffo, A., Cordova, A., Gambardella, A., & Spina, C. (2020). A scientific approach to entrepreneurial decision making: Evidence from a randomized control trial. Management Science, 66(2), 564–586. 概要:116社のスタートアップを無作為に分け、仮説を明示して検証する科学的アプローチを学んだ創業者が、見込みのない事業をより早く中止し、より高い収益を得たことを示した。
Camuffo, A., Gambardella, A., Messinese, D., Novelli, E., Paolucci, E., & Spina, C. (2024). A scientific approach to entrepreneurial decision-making: Large-scale replication and extension. Strategic Management Journal, 45(6), 1209–1237. 概要:2020年の実験を759社に拡大して追試し、科学的アプローチの効果が再現されることを確認した。
Cavoukian, A. (2009). Privacy by design: The 7 foundational principles. Information and Privacy Commissioner of Ontario. 概要:事後対応ではなく予防的に、初期設定でプライバシーを保護するなど、設計段階からプライバシーを組み込む7原則を示した。
Christensen, C. M., Hall, T., Dillon, K., & Duncan, D. S. (2016). Competing against luck: The story of innovation and customer choice. HarperBusiness. 概要:顧客は製品を特定の「ジョブ」を片付けるために雇うという Jobs to be Done の理論を、ミルクシェイクなどの事例で解説した。
Conway, M. E. (1968). How do committees invent? Datamation, 14(4), 28–31. 概要:システムの構造は、それを設計する組織のコミュニケーション構造を写すという「コンウェイの法則」を示した論文。
Cooper, R. G. (1990). Stage-gate systems: A new tool for managing new products. Business Horizons, 33(3), 44–54. 概要:新製品開発を段階(ステージ)と関門(ゲート)に分け、各関門で継続か中止かを判断するステージゲート法を提案した。
Cooper, R. G., & Kleinschmidt, E. J. (1987). New products: What separates winners from losers? Journal of Product Innovation Management, 4(3), 169–184. 概要:約200の新製品を分析し、独自の便益を持つ優れた製品が成功と失敗を最も強く分ける要因であることを示した。
Cunningham, W. (1992). The WyCash portfolio management system. OOPSLA '92 Addendum to the Proceedings, 29–30. 概要:急いで書いたコードを借金に例え、返済しなければ利子が膨らむという「技術的負債」の比喩を初めて示した報告。
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. 概要:利用者が技術を受け入れるかどうかを、知覚された有用性と知覚された使いやすさで説明する技術受容モデル(TAM)を提案した。
Dell'Acqua, F., McFowland, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2023). Navigating the jagged technological frontier: Field experimental evidence of the effects of AI on knowledge worker productivity and quality (Harvard Business School Working Paper 24-013). 概要:コンサルタント758人の実験で、AI が得意な課題では品質が上がる一方、不得意な課題では正答率が下がる「ギザギザの境界」を示した。
DORA. (2024). Accelerate State of DevOps Report 2024. Google Cloud. 概要:約39,000人の調査から、AI の利用の増加がスループットの1.5%の低下と安定性の7.2%の低下と関連していたことを報告した。
DORA. (2025). 2025 DORA Report: State of AI-assisted software development. Google Cloud. 概要:約5,000人の調査から、AI がスループットを改善する一方で不安定性を増やすこと、AI は組織の強みと弱みを増幅すること、効果を左右する7つの能力を報告した。
Dow, S. P., Glassco, A., Kass, J., Schwarz, M., Schwartz, D. L., & Klemmer, S. R. (2010). Parallel prototyping leads to better design results, more divergence, and increased self-efficacy. ACM Transactions on Computer-Human Interaction, 17(4), Article 18. 概要:複数の案を並行して試作する方が、一つの案を順に改良するより良い設計と多様な探索につながることを実験で示した。
Dyson, J. (2021). Invention: A life. Simon & Schuster. 概要:5,127個の試作を経てサイクロン式掃除機を完成させた過程を含む、ダイソン創業者の自伝。
Edmondson, A. (1999). Psychological safety and learning behavior in work teams. Administrative Science Quarterly, 44(2), 350–383. 概要:失敗を報告しても罰せられないという心理的安全性が、チームの学習行動と成果を高めることを示した。
Ellis, S., & Brown, M. (2017). Hacking growth: How today's fastest-growing companies drive breakout success. Crown Business. 概要:「このプロダクトが使えなくなったらどう感じるか」に「非常に残念」と答える利用者が40%以上であることを PMF の目安とし、成長のための実験の進め方を解説した。
European Parliament and Council. (2024a). Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union. 概要:AI システムをリスクの程度で分類し、高リスクの用途に文書化、人間による監視、精度と頑健性の確保などを義務づけた EU の規則。
European Parliament and Council. (2024b). Regulation (EU) 2024/2847 on horizontal cybersecurity requirements for products with digital elements (Cyber Resilience Act). Official Journal of the European Union. 概要:デジタル要素を持つ製品に、設計段階からのセキュリティ確保と、販売後のセキュリティ更新の提供を義務づけた EU の規則。
European Parliament and Council. (2024c). Directive (EU) 2024/2853 on liability for defective products. Official Journal of the European Union. 概要:製造物責任の対象をソフトウェアと AI システムに広げ、デジタル製品の欠陥による損害の賠償を容易にした EU の改正指令。
Evanschitzky, H., Eisend, M., Calantone, R. J., & Jiang, Y. (2012). Success factors of product innovation: An updated meta-analysis. Journal of Product Innovation Management, 29(S1), 21–37. 概要:Henard & Szymanski(2001)のメタ分析を更新し、製品の優位性と市場志向が引き続き新製品の成功と強く結びつくことを確認した。
Everyday Astronaut. (2021). Starbase tour with Elon Musk [Part 1] [Video]. YouTube. 概要:Musk が、要件を疑う、削る、単純化する、速くする、自動化する、という設計と製造の5段階の手順を説明したインタビュー。
Eyal, N. (2014). Hooked: How to build habit-forming products. Portfolio. 概要:きっかけ、行動、報酬、投資の4段階のループで習慣が形成されるモデルを示し、その倫理的な使い方にも触れた。
Fadell, T. (2022). Build: An unorthodox guide to making things worth making. Harper Business. 概要:iPod と Nest を作った著者が、ハードウェアは3世代で完成すること、試作と段階的検証(EVT・DVT・PVT)の進め方、チーム作りを解説した。
First Round Review. (2015). From 0 to $1B: Slack's founder shares their epic launch strategy. First Round Review. 概要:Slack の創業者 Butterfield が、チームが2,000メッセージを交換すると定着するという基準と、初期の立ち上げの進め方を語った記事。
Fitzpatrick, R. (2013). The mom test: How to talk to customers and learn if your business is a good idea when everyone is lying to you. CreateSpace. 概要:顧客インタビューで意見や将来の約束ではなく過去の具体的な行動を聞く、という原則を示した実務書。
Fogg, B. J. (2009). A behavior model for persuasive design. Proceedings of the 4th International Conference on Persuasive Technology, Article 40. 概要:行動は動機、能力、きっかけの3つが同時に揃ったときに起きるという Fogg 行動モデルを提案した。
Forsgren, N., Humble, J., & Kim, G. (2018). Accelerate: The science of lean software and DevOps. IT Revolution. 概要:数年間の調査から、デプロイ頻度、変更のリードタイム、変更失敗率、復旧時間の4指標がソフトウェア開発の成果と組織の業績に結びつくことを示した。
Forsgren, N., Storey, M.-A., Maddila, C., Zimmermann, T., Houck, B., & Butler, J. (2021). The SPACE of developer productivity: There's more to it than you think. ACM Queue, 19(1), 20–48. 概要:開発者の生産性を満足度、成果、活動量、コミュニケーション、効率の5つの側面で捉える SPACE フレームワークを提案した。
Fowler, M. (2018). Refactoring: Improving the design of existing code (2nd ed.). Addison-Wesley. 概要:外部から見た振る舞いを変えずに内部構造を改善するリファクタリングの手法をカタログ化した書籍。
Garvin, D. A. (1987). Competing on the eight dimensions of quality. Harvard Business Review, 65(6), 101–109. 概要:製品の品質を性能、付加機能、信頼性、適合性、耐久性、保守性、美しさ、知覚品質の8次元に分け、どの次元で競争するかを選ぶべきだと論じた。
Google. (n.d.). Ten things we know to be true. https://about.google/philosophy/ 概要:「利用者に集中すれば、他のすべては後からついてくる」を筆頭とする Google の10の理念。
Graham, P. (2013). Do things that don't scale. http://paulgraham.com/ds.html 概要:初期のスタートアップは、手作業で顧客を獲得し支援するなど、スケールしないことを意図的に行うべきだと論じたエッセイ。
Graham, P. (2024). Founder mode. http://paulgraham.com/foundermode.html 概要:権限委譲を重視するマネージャーモードに対して、創業者が細部に直接関わるファウンダーモードを提起したエッセイ。
Henard, D. H., & Szymanski, D. M. (2001). Why some new products are more successful than others. Journal of Marketing Research, 38(3), 362–375. 概要:60の実証研究のメタ分析で、製品の優位性、市場の潜在性、顧客ニーズの充足、開発前の計画、開発資源の投入が新製品の成功と一貫して結びつくことを示した。
Hoffman, R., & Yeh, C. (2018). Blitzscaling: The lightning-fast path to building massively valuable companies. Currency. 概要:「最初の版を恥ずかしいと思わないなら出すのが遅すぎる」という言葉を含む、急成長の戦略と不完全な製品を早く出す考え方を解説した。
Horowitz, B. (2014). The hard thing about hard things: Building a business when there are no easy answers. HarperBusiness. 概要:1996年の社内文書「良いプロダクトマネージャー・悪いプロダクトマネージャー」を収録し、プロダクトマネージャーを製品の CEO と位置づけた。
Husain, H. (2024). Your AI product needs evals. https://hamel.dev/blog/posts/evals/ 概要:AI プロダクトの改善には実データに基づく評価の仕組みが不可欠だと論じ、評価システムの作り方を解説した実務家の記事。
ISO. (2018). ISO 9241-11:2018 Ergonomics of human-system interaction — Part 11: Usability: Definitions and concepts. International Organization for Standardization. 概要:ユーザビリティを、特定の利用者が特定の目的を有効に、効率的に、満足して達成できる度合いと定義した国際規格。
ISO. (2019). ISO 9241-210:2019 Ergonomics of human-system interaction — Part 210: Human-centred design for interactive systems. International Organization for Standardization. 概要:利用者と文脈の理解、利用者の参加、評価の反復を原則とする人間中心設計の工程を規定した国際規格。
ISO/IEC. (2023). ISO/IEC 25010:2023 Systems and software engineering — Systems and software Quality Requirements and Evaluation (SQuaRE) — Product quality model. International Organization for Standardization. 概要:ソフトウェア製品の品質を機能適合性、性能効率性、互換性、相互作用性、信頼性、セキュリティ、保守性、柔軟性、安全性の9特性で定義した国際規格。
Jobs, S. (1997). Closing keynote Q&A at the 1997 Worldwide Developers Conference. Apple. 概要:「顧客体験から始めて技術へ遡らなければならない」と述べた質疑応答。
Jobs, S. (1998). Steve Jobs: "There's sanity returning" [Interview]. BusinessWeek. 概要:「人は見せられるまで何が欲しいか分からないことが多い」と述べ、顧客調査に頼らない製品開発の姿勢を語ったインタビュー。
Karpathy, A. (2017). Software 2.0. Medium. 概要:人が書くコードが学習されたモデルの重みに置き換わる「Software 2.0」を提起し、開発者の仕事がデータの整備へ移ると論じた。
Keiningham, T. L., Cooil, B., Andreassen, T. W., & Aksoy, L. (2007). A longitudinal examination of net promoter and firm revenue growth. Journal of Marketing, 71(3), 39–51. 概要:NPS が成長の予測において他の顧客指標より優れているという主張を検証し、優位性を確認できなかったと報告した。
Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. 概要:大規模な A/B テストの設計と落とし穴を解説し、改善を狙った施策のうち実際に効果があるものは一部にとどまることを報告した。
Krug, S. (2014). Don't make me think, revisited: A common sense approach to web usability (3rd ed.). New Riders. 概要:利用者に考えさせないことを最重要の原則とする、ウェブとアプリのユーザビリティの実務書。
Kurosu, M., & Kashimura, K. (1995). Apparent usability vs. inherent usability: Experimental analysis on the determinants of the apparent usability. CHI '95 Conference Companion on Human Factors in Computing Systems, 292–293. 概要:ATM の画面で、見た目の美しさの評価と使いやすさの評価が強く相関することを示した。
Levitt, T. (1980). Marketing success through differentiation—of anything. Harvard Business Review, 58(1), 83–91. 概要:製品の価値を中核製品、期待製品、拡張製品、潜在製品の層で捉え、差別化は拡張製品で起きると論じた。
Liker, J. K. (2004). The Toyota way: 14 management principles from the world's greatest manufacturer. McGraw-Hill. 概要:現地現物(現場で事実を確かめる)を含む、トヨタの14の経営原則を解説した。
Mathur, A., Acar, G., Friedman, M. J., Lucherini, E., Mayer, J., Chetty, M., & Narayanan, A. (2019). Dark patterns at scale: Findings from a crawl of 11K shopping websites. Proceedings of the ACM on Human-Computer Interaction, 3(CSCW), Article 81. 概要:約11,000のショッピングサイトを自動分析し、約11%に利用者を欺くダークパターンが含まれていたと報告した。
McClure, D. (2007). Startup metrics for pirates: AARRR! 500 Hats. 概要:獲得、活性化、継続、紹介、収益の5段階でスタートアップの指標を整理する AARRR の枠組みを提案したプレゼンテーション。
METR. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. Model Evaluation & Threat Research. 概要:経験豊富なオープンソース開発者16人による無作為化比較試験で、AI ツールの利用により作業時間が平均19%長くなった一方、開発者は速くなったと感じていたことを報告した。
Moore, G. A. (1991). Crossing the chasm: Marketing and selling high-tech products to mainstream customers. HarperBusiness. 概要:初期採用者と主流市場の間の溝を越えるには、顧客が期待するすべてを揃えた「ホールプロダクト」が必要だと論じた。
Nielsen, J. (1993). Response times: The 3 important limits. Nielsen Norman Group. https://www.nngroup.com/articles/response-times-3-important-limits/ 概要:応答時間の知覚には0.1秒(即時と感じる)、1秒(思考の流れが途切れない)、10秒(注意を保てる限界)の3つの限界があると整理した。
Nielsen, J. (1994). Enhancing the explanatory power of usability heuristics. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 152–158. 概要:システム状態の可視化、エラーの防止など、ユーザビリティ評価のための10のヒューリスティクスを整理した。
Nielsen, J. (2000). Why you only need to test with 5 users. Nielsen Norman Group. 概要:5人の利用者でユーザビリティ問題の大半が見つかるため、少人数のテストを繰り返す方が効率的だと論じた記事。
NIST. (2022). Secure Software Development Framework (SSDF) version 1.1 (NIST SP 800-218). National Institute of Standards and Technology. 概要:ソフトウェア開発の各工程にセキュリティの実践を組み込むための枠組み。
NIST. (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0). National Institute of Standards and Technology. 概要:AI のリスクを統治、対応付け、計測、管理の4機能で扱う任意の枠組み。
Norman, D. A. (2004). Emotional design: Why we love (or hate) everyday things. Basic Books. 概要:デザインが感情に働く層を、本能的、行動的、内省的の3つに分けて論じた。
Norman, D. A. (2013). The design of everyday things (Revised and expanded ed.). Basic Books. 概要:アフォーダンス、シグニファイア、フィードバックなど、使い方が見て分かるデザインの原則を示した古典の改訂版。
Nygard, M. T. (2018). Release it! Design and deploy production-ready software (2nd ed.). Pragmatic Bookshelf. 概要:タイムアウト、サーキットブレーカー、隔壁など、障害を局所に閉じ込めて本番環境で動き続けるための設計パターンを整理した。
Olsen, D. (2015). The lean product playbook: How to innovate with minimum viable products and rapid customer feedback. Wiley. 概要:市場(顧客、課題)とプロダクト(価値提案、機能、UX)の5層のピラミッドで PMF を捉え、その達成手順を解説した。
OWASP. (2021). OWASP Top 10: 2021. Open Worldwide Application Security Project. 概要:アクセス制御の不備、暗号化の失敗、インジェクションなど、ウェブアプリケーションの最も重大な10のセキュリティリスクをまとめた。
PAIR. (2019). People + AI guidebook. Google. 概要:利用者のニーズの定義、データの収集、信頼の較正、誤りへの対処など、人間中心の AI プロダクトを設計するための Google の指針。
Parnas, D. L. (1972). On the criteria to be used in decomposing systems into modules. Communications of the ACM, 15(12), 1053–1058. 概要:変わりやすい設計判断をモジュールの内側に隠す「情報隠蔽」をモジュール分割の基準として提案した。
Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The impact of AI on developer productivity: Evidence from GitHub Copilot. arXiv. https://arxiv.org/abs/2302.06590 概要:プログラミング課題の無作為化実験で、AI 補完の利用者が55.8%速く完了したことを報告した。
Reichheld, F. F. (2003). The one number you need to grow. Harvard Business Review, 81(12), 46–54. 概要:「この製品を友人や同僚に勧める可能性」の一問で測る Net Promoter Score(NPS)を提案し、成長との相関を示した。
Ries, E. (2011). The lean startup: How today's entrepreneurs use continuous innovation to create radically successful businesses. Crown Business. 概要:仮説を最小の試作(MVP)で検証する「構築・計測・学習」のループを提唱した。
Rodden, K., Hutchinson, H., & Fu, X. (2010). Measuring the user experience on a large scale: User-centered metrics for web applications. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 2395–2398. 概要:幸福度、エンゲージメント、定着、継続、タスク成功の5つで利用体験を測る Google の HEART フレームワークを提案した。
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. 概要:イノベーションの普及速度を決める属性として、相対的優位性、両立性、複雑さ、試用可能性、観察可能性の5つを示した。
Rozovsky, J. (2015). The five keys to a successful Google team. Google re:Work. 概要:Google の180チームの分析で、心理的安全性がチームの効果を最も強く予測する要因だったと報告した社内研究の解説。
Sauro, J., & Lewis, J. R. (2016). Quantifying the user experience: Practical statistics for user research (2nd ed.). Morgan Kaufmann. 概要:SUS の平均が68点であることを含む、利用者調査の統計的な扱い方をまとめた。
Serrador, P., & Pinto, J. K. (2015). Does Agile work? A quantitative analysis of agile project success. International Journal of Project Management, 33(5), 1040–1051. 概要:1,002件のプロジェクトを分析し、アジャイルの採用度がプロジェクトの効率と関係者の満足度と正に関係することを示した。
Shepherd, D. A., & Gruber, M. (2021). The lean startup framework: Closing the academic–practitioner gap. Entrepreneurship Theory and Practice, 45(5), 967–998. 概要:リーンスタートアップの各要素を既存の研究と対応付け、実証されている点と未検証の点を整理した総説。
Singer, R. (2019). Shape Up: Stop running in circles and ship work that matters. Basecamp. 概要:6週間の固定期間に収まるよう仕事の範囲を削り、専任チームに任せる Basecamp の開発手法を解説した。
Skok, D. (2013). SaaS metrics 2.0: A guide to measuring and improving what matters. For Entrepreneurs. 概要:LTV/CAC が3以上、CAC の回収期間が12か月以内などの SaaS の指標の目安を示した実務家の指針。
Stanford HAI. (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence. 概要:AI の技術、経済、政策の年次動向をまとめた報告書。公開ベンチマークの多くが飽和し、実際の課題との乖離が広がっていることを指摘した。
Taguchi, G. (1986). Introduction to quality engineering: Designing quality into products and processes. Asian Productivity Organization. 概要:製造のばらつきに対して性能が変わらないロバスト設計と、品質を損失関数で捉える品質工学を解説した。
Thomke, S., & Fujimoto, T. (2000). The effect of "front-loading" problem-solving on product development performance. Journal of Product Innovation Management, 17(2), 128–142. 概要:問題の発見と解決を開発の早い段階に前倒しすることが開発期間と品質を改善することを、トヨタの事例で示した。
Thompson, D. V., Hamilton, R. W., & Rust, R. T. (2005). Feature fatigue: When product capabilities become too much of a good thing. Journal of Marketing Research, 42(4), 431–442. 概要:消費者は購入前には多機能な製品を選ぶが、使用後の満足度は下がる「機能疲れ」を実験で示した。
Torres, T. (2021). Continuous discovery habits: Discover products that create customer value and business value. Product Talk. 概要:プロダクトトリオが毎週顧客と接し、機会・解決策ツリーで仮説を整理する継続的な発見の習慣を提唱した。
Tractinsky, N., Katz, A. S., & Ikar, D. (2000). What is beautiful is usable. Interacting with Computers, 13(2), 127–145. 概要:Kurosu & Kashimura(1995)を追試し、美しい画面は実際の使いやすさが同じでも使いやすいと知覚されることを確認した。
Ulrich, K. T., Eppinger, S. D., & Yang, M. C. (2020). Product design and development (7th ed.). McGraw-Hill. 概要:ハードウェアを中心とする製品開発の工程を、コンセプト開発から製造まで体系化した標準的な教科書。
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425–478. 概要:技術受容の諸理論を統合した UTAUT を提案し、成果期待、努力期待、社会的影響、促進条件が利用意図の分散の約70%を説明すると報告した。
Vitsœ. (n.d.). The power of good design: Dieter Rams's ideology, engrained within Vitsœ. https://www.vitsoe.com/gb/about/good-design 概要:Dieter Rams の「良いデザインの10原則」の公式な解説。
Vohra, R. (2018). How Superhuman built an engine to find product market fit. First Round Review. 概要:「非常に残念」の割合を22%から58%へ引き上げた Superhuman の手順を公開した記事。
W3C. (2023). Web Content Accessibility Guidelines (WCAG) 2.2. World Wide Web Consortium. 概要:知覚可能、操作可能、理解可能、堅牢の4原則のもとに、ウェブコンテンツのアクセシビリティの達成基準を定めた勧告。
Walton, P. (2020). Web Vitals. web.dev. https://web.dev/articles/vitals 概要:Web の利用体験を測る中核指標として LCP、INP、CLS を定義し、それぞれ2.5秒、200ミリ秒、0.1以下を「良好」の基準とした。
WebAIM. (2024). The WebAIM Million: The 2024 report on the accessibility of the top 1,000,000 home pages. https://webaim.org/projects/million/ 概要:上位100万サイトのトップページを自動検査し、95.9%に WCAG の違反が検出されたと報告した。
Witell, L., Löfgren, M., & Dahlgaard, J. J. (2013). Theory of attractive quality and the Kano methodology – the past, present, and future. Total Quality Management & Business Excellence, 24(11–12), 1241–1252. 概要:Kano モデルの30年の研究を総括し、魅力的品質が時間とともに当たり前品質へ移る経年変化などの知見を整理した。
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, 36. 概要:強力な言語モデルを評価者として使う方法が人間の評価者と約80%一致し、人間同士の一致率と同程度であることを示した。
狩野紀昭・瀬楽信彦・高橋文夫・辻新一(1984).魅力的品質と当り前品質.品質, 14(2),147–156.概要:当たり前品質、一元的品質、魅力的品質などを区別する Kano モデルを提案した原論文。
읽음
다음 읽을 글 ↓