Research
Ce qui constitue un bon produit selon la recherche et la pratique contemporaines
Product
Career
Traduction automatique du texte original en japonais
Overview
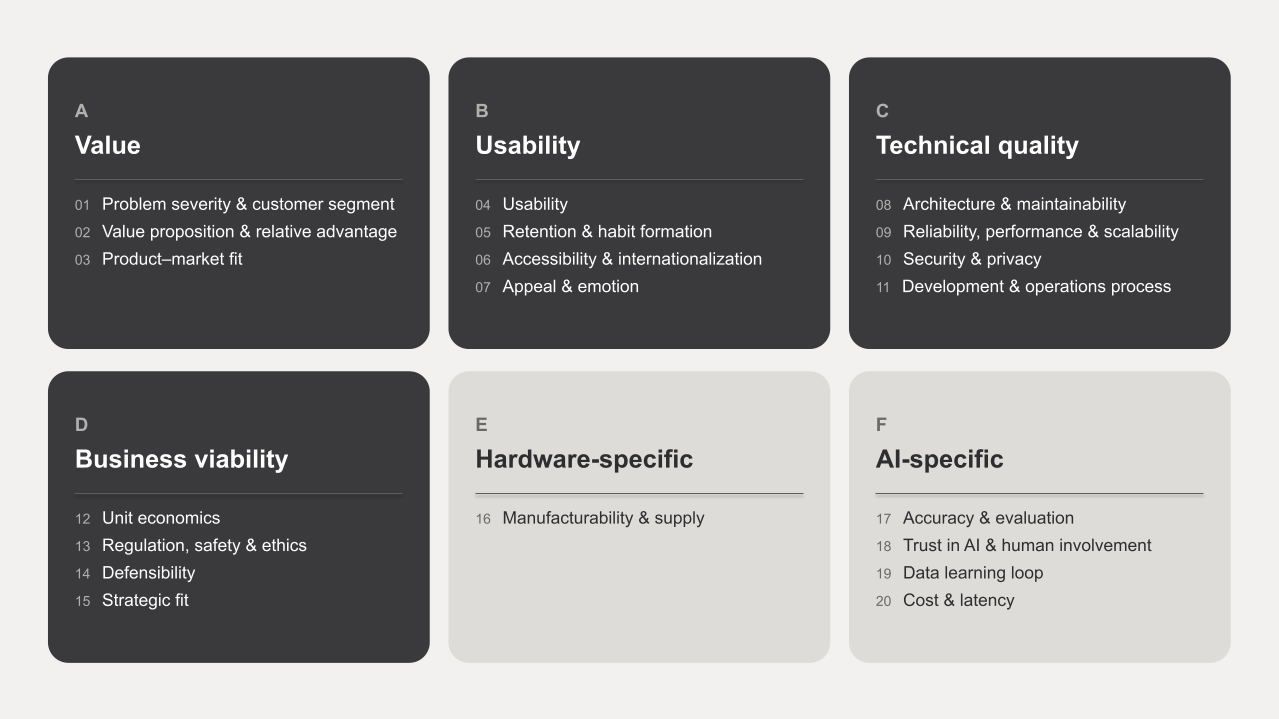
Qu'est-ce qu'un bon produit ? Les domaines académiques tels que la gestion de la qualité, l'ergonomie, la gestion d'entreprise et la recherche en innovation, ainsi que les praticiens qui ont créé des produits chez Apple, Amazon et Nest, ont chacun défini la « qualité » avec des termes différents. Cet article traverse ces approches et décompose le bon produit en 6 conditions et 20 éléments : « valeur », « facilité d'utilisation », « qualité technique », « viabilité commerciale », « conditions propres au matériel » et « conditions propres aux produits d'IA ».
De plus, nous organisons les rôles des parties prenantes telles que les chefs de produit, les concepteurs, les ingénieurs et les clients selon 7 systèmes, et présentons de manière chronologique, au cours des 6 phases allant de la découverte du problème client à son examen rétrospectif, quels éléments sont vérifiés par qui, avec quelles méthodes de validation et quels niveaux de réussite.
Introduction
Les conditions d'un « bon produit » ont été débattues avec des termes différents entre les domaines académiques tels que la gestion de la qualité, l'interaction homme-ordinateur et la gestion d'entreprise, d'une part, et les praticiens qui créent des produits, d'autre part. Au-delà de la sécurité et de la stabilité fondamentales, lorsqu'on considère les fonctionnalités innovantes, la facilité d'utilisation et la viabilité commerciale, ce qu'il faut satisfaire n'a pas été organisé de manière suffisamment exhaustive. Cet article vise à organiser les conditions qu'un bon produit doit remplir, en considérant à la fois les logiciels et les matériels, et à clarifier qui doit vérifier quoi, quand et comment au cours du processus de développement.
La nouveauté de cet article réside dans les trois points suivants :
Nous avons intégré les définitions académiques et pratiques du « bon produit » en 6 conditions et 20 éléments : Nous plaçons les définitions académiques telles que les 8 dimensions de la qualité de Garvin (1987), le modèle de Kano (Kano et al., 1984), ISO/IEC 25010 (ISO/IEC, 2023), et les définitions pratiques comme les 4 risques de Cagan (2017) dans un seul cadre, en mettant explicitement en évidence les différences entre les logiciels et les matériels pour chaque élément. Par exemple, la « qualité attrayante » de Kano et le « design émotionnel » de Norman (2004) sont traités comme un seul élément appelé « attrait et émotion ».
Nous avons concrétisé « qui vérifie quoi, quand et comment » selon 6 phases : De nombreux articles de recherche discutent de « ce qui est bon », mais ne précisent pas la responsabilité et les seuils. Par exemple, nous associons le product-market fit – où plus de 40 % des utilisateurs répondent « très déçu » à la question « comment vous sentiriez-vous si ce produit disparaissait ? » (Ellis & Brown, 2017) – à sa mesure trimestrielle par le chef de produit.
Nous avons organisé les dernières tendances en recherche et dans la pratique : Couvrant la recherche en nouveaux produits, l'interaction homme-machine, l'ingénierie logicielle, la théorie organisationnelle jusqu'à la collaboration homme-IA, nous organisons 19 études de recherche et 15 positions pratiques de Y Combinator, Jobs, Bezos, Musk, Cagan et Fadell, montrant que l'avantage concurrentiel du produit est le premier facteur de succès, que la multiplication des fonctionnalités réduit en réalité la satisfaction, et les effets de la sécurité psychologique, de l'agilité et de l'impact de l'IA générative sur la productivité, dans l'ordre valeur, facilité d'utilisation, technologie, viabilité commerciale et IA. Par exemple, pour les points où les praticiens sont en désaccord – comme « la voix du client ou la vision ? » et « sortir rapidement ou affiner avant le lancement ? » – nous présentons les deux points de vue.
Qu'est-ce qu'un bon produit ?
Définition d'un bon produit
Quelle est la définition d'un « bon produit » ? Nous organisons les définitions de la qualité des produits dans chaque domaine.
Définition de la gestion de la qualité : Garvin (1987) a divisé la qualité d'un produit en 8 dimensions : la performance, les fonctionnalités supplémentaires, la fiabilité, la conformité, la durabilité, la maintenabilité, l'esthétique et la qualité perçue. Il soutient que la qualité n'est pas un seul axe, mais que les clients choisissent la dimension qu'ils valorisent pour concurrencer. Par exemple, les constructeurs automobiles japonais ont distancé les fabricants américains dans les années 1980 selon les dimensions de la fiabilité et de la conformité.
Définition de la qualité attrayante : Kano et al. (1984) ont fait la distinction entre la « qualité attendue » (supposée être satisfaite), la « qualité monotone » (la satisfaction augmente proportionnellement au degré de satisfaction), et la « qualité attrayante » (non satisfaite ne crée pas d'insatisfaction, mais satisfaite crée de la joie). Par exemple, la qualité d'appel d'un smartphone est une qualité attendue, l'autonomie de la batterie est une qualité monotone, et la reconnaissance d'empreinte digitale initiale était une qualité attrayante.
Définition de l'ingénierie logicielle : ISO/IEC 25010 (ISO/IEC, 2023) définit la qualité d'un produit logiciel selon 9 caractéristiques : adéquation fonctionnelle, efficacité des performances, compatibilité, interopérabilité, fiabilité, sécurité, maintenabilité, flexibilité et sécurité. Par exemple, deux applications ayant la même fonctionnalité, celle avec une faible maintenabilité verra ses coûts de modification multipliés par plusieurs fois deux ans plus tard.
Définition du design centré sur l'utilisateur : ISO 9241-210 (ISO, 2019) prescrit le « design centré sur l'utilisateur », qui comprend la compréhension des besoins et du contexte des utilisateurs, leur implication dans la conception et l'évaluation itérative, et Norman (2013) a identifié l'« affordance » (ce qu'on voit qu'on peut faire) et le « signifiant » comme conditions d'un bon design. Par exemple, une porte dont on ne sait pas s'il faut la pousser ou la tirer n'est pas bien conçue, même si elle remplit sa fonction.
Définition de la recherche en innovation : Rogers (2003) a énuméré 5 attributs qui déterminent la vitesse de diffusion de ce qui est nouveau : l'avantage relatif, la compatibilité avec les habitudes existantes, la faible complexité, l'essayabilité et l'observabilité. Davis (1989) explique l'acceptation des technologies par les utilisateurs par l'« utilité perçue » et la « facilité d'utilisation perçue ». Par exemple, le paiement par code QR s'est rapidement répandu car il est compatible avec les habitudes existantes (porter un smartphone), facile à essayer et visible chez les utilisateurs.
Définition de Jobs to be Done : Christensen et al. (2016) considèrent que les clients ne « achètent » pas un produit mais le « recrutent » pour accomplir un progrès spécifique dans leur vie (un travail), et définissent un bon produit comme celui qui accomplit le mieux ce travail. Par exemple, un milkshake bu pendant le trajet matinal est recruté pour le travail « distraire le conducteur pendant son ennui et satisfaire la faim jusqu'à midi ».
Définition des praticiens : Cagan (2017) définit un bon produit comme ayant dépassé 4 risques : la valeur (les clients l'achètent-ils ?), la facilité d'utilisation (peuvent-ils l'utiliser ?), la faisabilité (peut-on le créer ?) et la viabilité commerciale (peut-on en vivre ?). Rams (Vitsœ, n.d.) énumère 10 principes de bon design : innovant, utile, beau, facile à comprendre, discret, sincère, durable, cohérent dans les détails, respectueux de l'environnement et utilisant le moins de design possible. Par exemple, l'iPod original d'Apple a surmonté les 4 risques et suivi fidèlement les principes de Rams, ce qui l'a établi comme exemple représentatif d'un bon produit.
Définition du product-market fit : Andreessen (2007) appelle « product-market fit » (PMF) l'état où « on est dans un bon marché avec un produit qui satisfait ce marché » et affirme que c'est la seule chose qui importe pour les startups. Ellis & Brown (2017) suggèrent comme indication que plus de 40 % des utilisateurs répondent « très déçu » à la question « comment vous sentiriez-vous si ce produit disparaissait ? ». Par exemple, Superhuman a publiquement documenté le processus d'amélioration de cet indicateur de 22 % à 58 % (Vohra, 2018).
Ci-dessous, en nous appuyant sur ces définitions, nous décomposons le bon produit en 6 conditions et 20 éléments.
A. Valeur : le produit résout-il le problème du client ?
La valeur naît du fait que le client a un problème qu'il est disposé à payer pour résoudre et que le produit le résout mieux que d'autres moyens. Dans la recherche sur les nouveaux produits depuis Cooper & Kleinschmidt (1987), l'avantage concurrentiel du produit reste le premier facteur de succès (Henard & Szymanski, 2001 ; Evanschitzky et al., 2012).
① Gravité du problème et segment de clientèle
Définition : Un segment de clients particulier possède un problème si grave et fréquent qu'il est disposé à payer pour le résoudre. Le problème est défini non pas comme une demande de fonctionnalité, mais comme un progrès que le client souhaite réaliser (un travail) (Christensen et al., 2016). Par exemple, le travail n'est pas « je veux une perceuse plus rapide » mais « je veux accrocher une étagère au mur en perçant un trou », et un produit qui fixe une étagère sans percer un trou devient une concurrence.
Méthode d'évaluation : Évaluer selon la fréquence du problème, sa gravité (temps ou coûts perdus), les solutions alternatives actuelles et le montant payé pour elles, ainsi que le nombre de clients ayant le même problème (taille du segment). Par exemple, si on peut répondre à « combien de fois par mois cela se produit, combien d'heures sont perdues à chaque fois, et sur quoi paie-t-on maintenant », la gravité du problème est quantifiée.
Aperçu : Blank (2013) a proposé la « customer development » pour découvrir des clients et confirmer l'existence de problèmes avant de créer un produit, et Fitzpatrick (2013) a exposé les principes pour poser des questions sur les comportements passés plutôt que sur les opinions. Le matériel prenant du temps et des coûts pour le prototypage, la confirmation du problème se fait généralement d'abord avec des maquettes ou des modifications de produits existants (Fadell, 2022). Par exemple, les fondateurs d'Airbnb ont hébergé des invités chez eux pour confirmer eux-mêmes le problème « je veux réduire les frais d'hébergement mais je n'aime pas les petits hôtels », et Nest a commencé par enquêter sur les frustrations avec les thermostats existants (la complexité des réglages).
② Proposition de valeur et avantage relatif
Définition : Avoir un avantage clairement supérieur pour le client par rapport aux solutions alternatives existantes (avantage relatif), exprimable en une phrase (Rogers, 2003). La valeur ne se limite pas à la fonction centrale, mais inclut le support, la compatibilité et les services périphériques, à considérer comme un « produit complet » (Levitt, 1980 ; Moore, 1991). Par exemple, la valeur d'une voiture électrique dépend non seulement du véhicule lui-même mais aussi de l'infrastructure de recharge.
Méthode d'évaluation : Évaluer selon l'ampleur de l'amélioration par rapport aux solutions alternatives (temps, coûts, qualité), si le client peut expliquer avec ses propres mots « pourquoi j'utilise ceci plutôt qu'une autre solution », et la classification selon le modèle de Kano (est-ce une qualité attrayante ou attendue ? ; Witell et al., 2013). Par exemple, une fonctionnalité pour laquelle « ce n'est pas grave de ne pas l'avoir » est la réponse majoritaire dans un questionnaire Kano ne constitue pas une différenciation.
Aperçu : Depuis Cooper & Kleinschmidt (1987), un produit supérieur avec un avantage unique reste le facteur qui distingue le plus fortement le succès de l'échec. Le logiciel imite facilement les fonctionnalités et perd rapidement son avantage, tandis que le matériel préserve longtemps son avantage concurrentiel grâce à la conception physique et au savoir-faire de fabrication. Par exemple, l'aspirateur Dyson a clairement différencié « la puissance d'aspiration ne faiblit pas » et a maintenu son avantage longtemps grâce à sa technologie issue de 5 127 prototypes (Dyson, 2021).
③ Product-market fit
Définition : L'état où le client trouve la valeur du produit indispensable, continue à l'utiliser et le recommande à d'autres. Andreessen (2007) affirme que lorsqu'il y a PMF, on sent que les clients « tirent » le produit. Par exemple, après le PMF, le produit génère des demandes sans effort commercial et le développement des serveurs ne suffit pas à suivre la croissance.
Méthode d'évaluation : On évalue par une enquête PMF posant « comment se sentiriez-vous si vous ne pouviez plus utiliser ce produit ? » (Ellis & Brown, 2017), par des courbes de rétention aplaties par cohorte, par le NPS (Reichheld, 2003), et par le taux de conversion vers un plan payant. Pour le matériel, on substitue les précommandes, les taux de retour, les avis, ou pour les appareils connectés, le taux d'utilisation. Par exemple, pour un équipement de fitness connecté, le nombre mensuel d'utilisations par acheteur et le taux de résiliation de l'abonnement deviennent des indicateurs plus pertinents que le nombre d'unités vendues.
Aperçu : Le PMF n'est pas une réussite unique. Olsen (2015) envisage le PMF comme une pyramide à 5 niveaux intégrant le marché (clients et défis) et le produit (proposition de valeur, fonctionnalités, UX), et affirme que si le marché change, l'adéquation s'effondre. Vohra (2018) a amélioré les indicateurs en renforçant les points appréciés par les utilisateurs ayant répondu « très déçu » et en éliminant les frustrations de ceux ayant répondu « un peu déçu ». Par exemple, la prolifération des smartphones a fait perdre à de nombreux services conçus pour les PC leur adéquation initiale.
B. Facilité d'utilisation : peut-on l'utiliser, continue-t-on à l'utiliser ?
La facilité d'utilisation est la condition pour qu'un produit de valeur soit réellement utilisé et continué. Le modèle d'acceptation technologique de Davis (1989) identifie la facilité d'utilisation comme l'un des deux facteurs clés, avec l'utilité, qui détermine l'intention d'utilisation.
④ Utilisabilité
Définition : C'est le degré auquel des utilisateurs spécifiques peuvent accomplir des objectifs spécifiques de manière efficace, efficiente et satisfaisante (ISO 9241-11 ; ISO, 2018). Les 10 heuristiques de Nielsen (1994) — visibilité de l'état du système, conformité avec le monde réel, prévention des erreurs, reconnaissance plutôt que mémorisation, etc. — deviennent des critères pour juger la conception. Par exemple, un écran d'édition où l'on ne voit pas si les modifications sont sauvegardées viole le principe de « visibilité de l'état du système ».
Méthode d'évaluation : On évalue par le taux de complétude et le temps de complétude des tâches dans des tests d'utilisabilité menés auprès d'un petit nombre d'utilisateurs (Nielsen, 2000), par l'échelle System Usability Scale (SUS ; Brooke, 1996 ; Sauro & Lewis, 2016), et par le fait que plusieurs personnes se perdent au même endroit. Par exemple, si on observe 5 personnes interagir avec un nouvel écran de demande et que 3 se perdent au même endroit, cet endroit révèle un problème de conception.
Aperçu : Krug (2014) énonce comme principe primordial de ne pas faire réfléchir l'utilisateur, et Norman (2013) affirme qu'on ne doit pas blâmer l'utilisateur qui se trompe, mais plutôt la conception qui incite à l'erreur. Le logiciel peut modifier l'interface après la sortie, mais l'interface physique du matériel (boutons, forme, poids) ne peut pas être changée après la commercialisation, ce qui donne plus de poids aux tests en phase de prototype. Par exemple, le « 1-Click Ordering » d'Amazon réduit au minimum le nombre de décisions avant l'achat, et Nest a réitérativement refondu la sensation de tourner le cadran au stade du prototype (Fadell, 2022).
⑤ Utilisation continue et formation d'habitudes
Définition : C'est l'état où l'utilisateur atteint la valeur centrale (moment d'illumination) dès la première utilisation, puis l'utilise régulièrement et le produit devient part de ses habitudes ou de ses processus métier. Fogg (2009) explique que le comportement émerge quand trois éléments coïncident : la motivation, la capacité et un déclencheur. Eyal (2014) organise la formation d'habitudes en une boucle : déclencheur, action, récompense, investissement. Par exemple, Slack estime que l'adoption est acquise quand une équipe a échangé 2 000 messages, et conçoit le produit pour y conduire (First Round Review, 2015).
Méthode d'évaluation : On évalue par le taux d'activation (part des utilisateurs inscrits ayant atteint la valeur centrale), par les courbes de rétention par cohorte, par le ratio DAU/MAU (pour les outils métier, le taux d'utilisation en jours ouvrables), et par le cadre HEART de Google (bonheur, engagement, rétention, continuité, succès des tâches ; Rodden et al., 2010). Pour le matériel non connecté, la fréquence d'utilisation est invisible ; on la substitue par des enquêtes ou par la fréquence d'achat de consommables. Par exemple, pour une cafetière, l'utilisation continue se mesure par le taux de rachat de capsules.
Aperçu : La conception pour former des habitudes n'est justifiable que si elle s'aligne avec l'intérêt de l'utilisateur. Eyal (2014) lui-même affirme qu'on ne doit pas appliquer des techniques de formation d'habitudes à un produit qui n'améliore pas la vie de l'utilisateur. Par exemple, augmenter la fréquence des notifications pour gonfler l'utilisation à court terme ne fait qu'accroître les résiliations à long terme.
⑥ Accessibilité et internationalisation
Définition : C'est l'état où les utilisateurs ayant des contraintes visuelles, auditives, motrices ou cognitives, ainsi que ceux parlant d'autres langues ou vivant dans d'autres cultures et systèmes juridiques, peuvent utiliser le produit de la même manière. Le WCAG 2.2 du W3C (2023) définit les critères de conformité selon quatre principes : perceptible, utilisable, compréhensible, robuste. Par exemple, un graphique qui communique l'état uniquement par la couleur est indistinct pour un utilisateur ayant une vision des couleurs restreinte.
Méthode d'évaluation : On évalue par le niveau de conformité WCAG, par l'opérabilité avec les technologies d'assistance (lecteurs d'écran, etc.), et par la portée des langues, devises, formats de date et fuseaux horaires supportés. Par exemple, un écran conçu en anglais devient environ 1,3 fois plus long lorsqu'on le traduit en allemand, et le texte peut déborder d'un bouton.
Aperçu : L'enquête de WebAIM (2024) révèle que 95,9 % des 1 million de sites les plus visités contiennent des violations WCAG — c'est une condition qui ne s'atteint que par une intention délibérée. Le logiciel peut changer de langue ou d'affichage par paramètres, mais le matériel diffère selon la région : tension d'alimentation, forme de prise, bande de fréquence sans fil, certifications locales (CE, FCC, etc.). La plage de conformité doit être déterminée au stade de la conception. Par exemple, un appareil vendu au Japon et aux États-Unis doit obtenir la certification du module sans fil dans chaque pays.
⑦ Attrait et émotion
Définition : Au-delà des fonctionnalités, c'est la qualité d'être agréable à utiliser et de donner envie de posséder le produit. Norman (2004) divise les couches par lesquelles le design affecte l'émotion en trois : l'« instinctif » (apparence visuelle), le « comportemental » (sensation d'utilisation) et le « réflexif » (sens et image de soi). La qualité « attrayante » du modèle Kano (Kano et al., 1984) appartient à cet élément. Par exemple, l'emballage des produits Apple est conçu pour que l'expérience même du déballage soit gratifiante au niveau instinctif.
Méthode d'évaluation : On évalue par le NPS (Reichheld, 2003), par le questionnaire Kano pour identifier la qualité attrayante, et par les revues de conception mesurant la cohérence (terminologie, couleurs, espaces, mouvements). Par exemple, si la même action est appelée « Enregistrer », « Valider » ou « Confirmer » selon l'écran, c'est un manque de cohérence.
Aperçu : Les principes de Rams (Vitsœ, n.d.) énoncent qu'un bon design est cohérent jusqu'aux détails et aussi minimaliste que possible. Jobs affirmait qu'il faut commencer par l'expérience client plutôt que par la technologie, puis remonter vers la technologie (Jobs, 1997). La beauté améliore aussi la perception d'utilisabilité (Kurosu & Kashimura, 1995 ; Tractinsky et al., 2000). Pour le matériel, la qualité tactile — matière, poids, sensation au toucher, son — détermine l'attrait ; pour le logiciel, c'est la vitesse de réponse, les animations et le ton du texte. Par exemple, le bruit du claquement de portière d'une voiture de luxe est un attrait conçu intentionnellement, et la fluidité d'une transition d'écran dans une application en est l'équivalent.
C. Qualité technique : peut-on le construire, continuera-t-il de fonctionner ?
La qualité technique détermine non seulement si l'on peut construire le produit une fois, mais aussi si on peut continuer à l'adapter à des exigences en constante évolution, et s'il continue de fonctionner chez le client. Les caractéristiques de qualité d'ISO/IEC 25010 (ISO/IEC, 2023) et la recherche empirique de DORA (Forsgren et al., 2018) forment la base de cette condition.
⑧ Architecture et maintenabilité
Définition : C'est une structure où, lorsque des modifications deviennent nécessaires, leur portée est limitée et peut être effectuée en toute sécurité. Parnas (1972) a proposé le « masquage d'information » : cacher les décisions de conception susceptibles de changer à l'intérieur d'un module. Conway (1968) a observé que la structure d'un système reflète la structure de communication de l'organisation. Par exemple, si la logique de calcul des tarifs est dupliquée dans l'écran, l'API et le traitement par lot, chaque modification tarifaire nécessite des corrections à trois endroits.
Méthode d'évaluation : On évalue par la portée des changements (frontières des modules, direction des dépendances, duplication), par le délai d'impact des changements, par la couverture des tests, et par le volume et le taux de remboursement de la dette technique. Pour le matériel, on mesure l'interchangeabilité des pièces, la modularité et la facilité de réparation (Ulrich et al., 2020). Par exemple, le notebook Framework valorise la modularité de ses pièces au point que c'est la valeur du produit elle-même.
Aperçu : Cunningham (1992) compare le code écrit à la hâte à une « dette » dont les intérêts (augmentation des coûts de modification) s'accumulent si elle n'est pas remboursée. Une enquête de Besker et al. (2019) montre que les développeurs consacrent en moyenne 23 % de leur temps de travail à gérer la dette technique. Le refactoring de Fowler (2018) — améliorer la structure sans modifier les fonctionnalités — mérite qu'on lui consacre du temps régulièrement. Par exemple, un code sans tests paye continuellement des intérêts en vérifications manuelles lors de chaque modification.
⑨ Fiabilité, performance et scalabilité
Définition : C'est la qualité de fonctionner quand le client en a besoin, à la vitesse requise, et de continuer à fonctionner à mesure que la charge augmente. Les SRE de Google (Beyer et al., 2016) explicitent les objectifs de disponibilité comme « Objectifs de niveau de service (SLO) » et proposent d'utiliser tout dépassement comme « budget d'erreur » pour le développement de nouvelles fonctionnalités. Par exemple, si le SLO fixe une disponibilité mensuelle de 99,9 %, environ 43 minutes d'arrêt sont tolérées ; au-delà, on priorise la stabilité sur les nouvelles fonctionnalités.
Méthode d'évaluation : On évalue par le taux d'atteinte des SLO, par la distribution des temps de réponse (par exemple, le 95e percentile), par les variations de réponse face à la charge, et par le temps de récupération après une défaillance. Pour le matériel, on mesure par le taux de défaillance (MTBF), les tests de durabilité et le coût des défaillances pendant la période de garantie (Garvin, 1987). Par exemple, dans l'automobile, une mise à jour OTA ne peut corriger que les défauts d'origine logicielle ; les défauts de pièces entraînent un rappel.
Aperçu : Nygard (2018) a formalisé des modèles de conception pour contenir les défaillances : timeouts, disjoncteurs, cloisonnement (bulkheads). Les défaillances sont supposées se produire, et on apprend après coup par des post-mortems sans blâmer (Beyer et al., 2016). Par exemple, si une API de paiement externe ralentit, seule la transaction doit être suspendue temporairement, pas tout l'écran.
⑩ Sécurité et confidentialité
Définition : C'est l'état où les données et les actifs du client sont protégés et où la confidentialité est prise en compte dès la phase de conception. Le principe de « Confidentialité par conception » de Cavoukian (2009) privilégie la protection par les paramètres par défaut plutôt que par des corrections après coup. Le Top 10 de l'OWASP (2021) énumère les vulnérabilités typiques : défaut de contrôle d'accès, échec du chiffrement, injection, etc. Par exemple, inclure l'ID de l'utilisateur dans l'URL est une illustration typique d'un défaut de contrôle d'accès.
Méthode d'évaluation : L'existence de mesures contre les menaces identifiées par la modélisation des menaces, la gravité et le nombre de vulnérabilités trouvées lors des diagnostics de vulnérabilité et des tests de pénétration, les vulnérabilités connues des bibliothèques dépendantes, et l'existence de périodes de rétention des données personnelles et de procédures de suppression. Par exemple, si une vulnérabilité de gravité élevée reste non traitée, le produit ne peut pas être expédié, quelles que soient les autres conditions.
Aperçu : Le Secure Software Development Framework du NIST (2022) est une norme qui intègre ces activités dans le processus de développement. Les vulnérabilités logicielles peuvent être corrigées par la distribution de versions corrigées, mais le matériel ne peut pas être corrigé après expédition s'il n'existe pas de moyen de mise à jour du firmware. La loi sur la résilience aux cyberattaques de l'UE (Parlement européen et Conseil, 2024b) a imposé aux produits contenant des éléments numériques de fournir des mises à jour de sécurité après la vente. Par exemple, les appareils IoT sans moyen de mise à jour sécurisé risquent de faire l'objet de restrictions de vente.
⑪ Processus de développement et d'exploitation
Définition : Un état où le système fonctionne pour livrer de petites choses fréquemment, en toute sécurité, aux clients, et pour apprendre des résultats. Forsgren et al. (2018) ont démontré que quatre indicateurs—la fréquence de déploiement, le délai de réalisation des changements, le taux d'échec des changements et le temps de récupération—sont en corrélation avec la performance organisationnelle. Par exemple, les organisations hautement performantes déploient plusieurs fois par jour, ont un faible taux d'échec et se remettent en moins d'une heure.
Méthode d'évaluation : L'évaluation se fait selon les 4 indicateurs du DORA, le taux d'automatisation du CI/CD, et la mise en œuvre d'examens des mises en production. Pour le matériel, l'évaluation porte sur le passage de chaque étape—validation technique (EVT), validation de conception (DVT), validation de production (PVT)—et sur les décisions de continuation ou d'arrêt à chaque étape (le stage-gate de Cooper, 1990). Par exemple, si la forme du boîtier change après la commande des moules, cela entraîne un retard de plusieurs mois et des coûts supplémentaires de dizaines de millions de yen (Fadell, 2022).
Aperçu : Brooks (1995) a déclaré qu'ajouter du personnel à un projet retardé l'aggrave davantage, et Shape Up de Singer (2019) montre comment réduire le scope du travail pour l'adapter à une période fixe de 6 semaines. La boucle « construire, mesurer, apprendre » de Ries (2011) et la méthode « Working Backwards » d'Amazon (Bryar & Carr, 2021)—où les communiqués de presse et les FAQ sont rédigés avant le développement—sont des principes pour minimiser le temps jusqu'à l'apprentissage et les développements inutiles. Le DORA (2025) rapporte que l'utilisation de l'IA augmente le débit mais augmente également l'instabilité, et cet effet est amplifié dans les organisations ayant des fondations telles que les petits lots et la gestion des versions stricte. Par exemple, même si la génération de code par IA s'accélère, si les examens et les tests ne suivent pas, le taux d'échec des changements augmente.
D. Viabilité commerciale : Le produit peut-il être viable commercialement ?
La viabilité commerciale détermine si un bon produit pour les clients peut être soutenu par ses créateurs. C'est le dernier des quatre risques de Cagan (2017), et ici, la conformité réglementaire et l'éthique sont traitées comme des conditions pour la continuité de l'activité.
⑫ Économie unitaire
Définition : Le revenu par client (par entreprise, par unité) dépasse les coûts d'acquisition et de fourniture continue de ce client. Skok (2013) a identifié les indicateurs clés pour les SaaS : le ratio entre la valeur à vie du client (LTV) et le coût d'acquisition du client (CAC), ainsi que la période de récupération du CAC. Par exemple, un client avec un revenu mensuel de 10 000 ¥, une marge brute de 80% et une durée moyenne de 30 mois a une LTV de 240 000 ¥. Si le CAC est suffisamment inférieur, le modèle fonctionne.
Méthode d'évaluation : L'évaluation se fait selon le ratio LTV/CAC, la période de récupération du CAC, la marge brute, le taux de désabonnement et le taux de rétention de revenu net (NRR). Pour le matériel, l'évaluation porte sur la marge brute incluant le coût du matériel (nomenclature), les frais de fabrication, les frais de logistique, l'inventaire, les retours et les frais de garantie. Par exemple, un NRR de 110% signifie que même sans nouveaux clients, les revenus des clients existants croissent de 10% par an.
Aperçu : Le coût marginal des logiciels est quasi nul et les frais cloud sont le principal coût variable, mais le matériel encourt des frais physiques et la marge brute est généralement plus faible. Les produits IA engendrent des coûts d'inférence à chaque utilisation et doivent être vus en conjonction avec ⑳. Par exemple, pour le matériel, il existe une règle de base selon laquelle le prix de vente est un multiple du coût du matériel, et les coûts de garantie et de retour sont intégrés.
⑬ Conformité réglementaire, sécurité et éthique
Définition : L'état où le produit respecte la réglementation applicable, ne cause aucun dommage aux utilisateurs et aux tiers, et est socialement acceptable. La loi sur l'IA de l'UE (Parlement européen et Conseil, 2024a) impose des obligations aux systèmes d'IA en fonction du degré de risque, et la directive révisée sur la responsabilité du fait des produits (Parlement européen et Conseil, 2024c) étend la responsabilité aux logiciels et à l'IA. Par exemple, l'IA utilisée pour l'embauche ou le crédit est classée comme à haut risque, ce qui impose la documentation, la surveillance humaine et l'assurance de la précision.
Méthode d'évaluation : L'évaluation porte sur l'exhaustivité de l'inventaire des lois applicables (données personnelles, protection des consommateurs, lois professionnelles, sécurité des produits, contrôle des exportations), les résultats de l'évaluation des risques, et l'état des audits externes ou des certifications. Le cadre de gestion des risques de l'IA du NIST (2023) fournit un cadre pour l'auto-évaluation des risques liés à l'IA. Par exemple, avant d'entrer dans un nouveau marché, il faut vérifier la loi sur la protection des données personnelles du pays et les restrictions sur les transferts transfrontaliers de données.
Aperçu : Pour le matériel, les certifications de sécurité (produits électriques, radiofréquences, substances chimiques) sont un préalable à l'expédition, et pour les logiciels, la réglementation porte principalement sur les données personnelles et la cybersécurité. Cependant, avec la loi sur la résilience aux cyberattaques et la révision de la directive sur la responsabilité du fait des produits, le logiciel encourt désormais des responsabilités en tant que produit. L'éthique est plus large que la conformité réglementaire, et comme l'a montré Mathur et al. (2019), les dark patterns—même s'ils sont légaux—trompent les utilisateurs et endommagent la confiance. Par exemple, depuis 2024 en UE, les dommages causés par les défauts de logiciel relèvent de la responsabilité du fait des produits.
⑭ Défensibilité
Définition : Lorsqu'un bon produit est imité, il existe une raison de conserver les clients. La défensibilité (Moat) se divise en cinq catégories : structure des coûts, verrouillage des clients, effets de réseau, actifs incorporels et structure du marché. Par exemple, un produit profondément intégré au flux de travail des clients aura des coûts de commutation élevés et sera moins susceptible d'être annulé même si des fonctionnalités sont imitées.
Méthode d'évaluation : L'évaluation porte sur l'importance des coûts de commutation, le volume de données accumulées par client, la présence ou l'absence d'effets de réseau (la valeur augmente-t-elle avec le nombre d'utilisateurs), et les changements dans le taux de désabonnement lorsque les concurrents lancent une fonctionnalité équivalente. Par exemple, si le taux de désabonnement ne change pas après le lancement d'une fonctionnalité équivalente par un concurrent, la défensibilité réside ailleurs que dans la fonctionnalité.
Aperçu : Pour les logiciels, les données et les effets de réseau sont la principale défensibilité, tandis que pour le matériel, ce sont le savoir-faire de fabrication, les brevets, le réseau de distribution et les biens complémentaires (consommables, accessoires). La défensibilité n'existe pas initialement ; elle s'accumule intentionnellement après le PMF. Par exemple, la monture de lentille de caméra est un verrouillage par bien complémentaire, où la base de lentilles compatibles entrave la commutation.
⑮ Alignement avec la stratégie
Définition : Chaque fonctionnalité et produit individuel s'aligne avec la vision et la stratégie du produit, ainsi qu'avec les objectifs de l'entreprise. Cagan & Jones (2020) préconisent non pas des « équipes fonctionnelles » qui répondent aux demandes de fonctionnalités, mais des « équipes produit » qui sont responsables des résultats et décident de leurs propres solutions. Par exemple, une équipe à laquelle on donne un seul objectif de chiffre d'affaires a tendance à faire des remises, tandis qu'une équipe à laquelle on demande d'augmenter le taux de rétention des clients se concentre sur l'amélioration du produit.
Méthode d'évaluation : L'évaluation porte sur la documentation de la vision et de la stratégie du produit, la capacité à clarifier quelle hypothèse chaque élément de la feuille de route valide, et la réalisation des objectifs de résultats trimestriels (OKR). Par exemple, écrivez pour chaque élément de la feuille de route « l'hypothèse validée par cet élément », et supprimez les éléments pour lesquels vous ne pouvez pas l'écrire.
Aperçu : Jobs a dit que décider ce qu'il ne faut pas faire c'est la concentration, et Bezos (2017) a cité l'obsession du client et la vigilance contre la transformation du processus en objectif comme conditions du « Day 1 ». Horowitz (2014) a qualifié un bon gestionnaire de produit de « PDG du produit » et l'a défini comme un rôle responsable des résultats. Par exemple, même si une fonctionnalité est très demandée, refuser d'ajouter ce qui affaiblirait la valeur centrale du produit est une question de stratégie.
E. Conditions spécifiques au matériel
⑯ Manufacturabilité, approvisionnement et qualité physique
Définition : L'état où la production en masse peut être réalisée selon la conception, au coût cible, avec une qualité stable, et où les composants peuvent être approvisionnés de manière stable. La « conception pour la fabrication et l'assemblage (DFMA) » de Boothroyd et al. (2011) est une méthode pour réduire le nombre de pièces et simplifier l'assemblage au stade de la conception, et Taguchi (1986) a proposé la « conception robuste », où les performances ne changent pas face aux variations de fabrication. Par exemple, réduire les types de vis de 3 à 1 seul réduit le temps et les erreurs d'assemblage.
Méthode d'évaluation : L'évaluation porte sur le rendement et le taux de passage direct à chaque étape du prototypage (EVT, DVT, PVT), les résultats des essais de durabilité et d'environnement (température, humidité, chute, vibration), l'obtention des certifications de sécurité et de fréquence radio pour chaque pays (CE, FCC, UL, etc.), le taux de défauts et le taux de retour au début de la production de masse, et la proportion de pièces ayant une source d'approvisionnement unique. Par exemple, si le rendement à la phase PVT n'atteint pas l'objectif, il faut retarder le démarrage de la production de masse.
Aperçu : Les fournisseurs de composants, les délais, le risque de source unique, et la quantité d'inventaire sont déterminés simultanément avec la conception (Ulrich et al., 2020). Fadell (2022) affirme que le matériel s'améliore à la première génération, se corrige à la seconde et se perfectionne à la troisième, et recommande de ne pas viser la perfection dès la première. L'équivalent de cet élément dans les logiciels est la reproductibilité de la construction et du déploiement, la dépendance vis-à-vis des fournisseurs de cloud, et l'adaptation à la diversité des environnements d'exécution (OS, navigateurs, appareils). Par exemple, une conception dépendant d'un semi-conducteur spécifique arrête l'expédition de l'ensemble du produit si l'approvisionnement s'arrête, ce qui est l'équivalent d'une conception dépendant d'un seul fournisseur de cloud.
F. Conditions spécifiques aux produits IA
Les produits où l'IA joue un rôle central ont des propriétés que les logiciels conventionnels n'ont pas : les résultats sont probabilistes, contiennent des erreurs et changent avec l'utilisation. En plus des éléments précédents, les 4 éléments suivants sont nécessaires.
⑰ Précision et évaluation
Définition : L'état où les résultats de l'IA atteignent la précision requise dans les scénarios d'utilisation réels et peuvent être mesurés de manière reproductible. L'AI Index du Stanford HAI (2025) note que de nombreux repères publics sont saturés et que l'écart avec les problèmes réels s'élargit. Par exemple, un modèle avec un taux de réponse correcte élevé sur les questions générales peut avoir de nombreuses erreurs dans la lecture de documents métier spécifiques.
Méthode d'évaluation : L'évaluation porte sur la précision, le rappel et l'agrégation par type d'erreur sur un ensemble de données d'évaluation créé à partir de données réelles (reflétant la distribution d'entrée supposée), le taux d'accord avec l'évaluation manuelle, et le test de régression à chaque mise en production (Husain, 2024 ; Zheng et al., 2023). Par exemple, utilisez les 100 cas réels passés comme ensemble d'évaluation et comparez avec le même ensemble chaque fois que vous modifiez le modèle ou les instructions.
Aperçu :Comme l'a appelé Karpathy (2017) « Software 2.0 », la qualité des produits IA est déterminée par les données et l'évaluation plutôt que par le code. Pour les matériels dotés d'IA (robots, véhicules, dispositifs médicaux), où les erreurs peuvent entraîner des dommages physiques, une conception sûre (fail-safe) et une validation en environnement réel sont nécessaires en supplément. Par exemple, dans la conduite autonome, en plus de la distance parcourue en simulation, le nombre d'interventions en conduite réelle devient un indicateur d'évaluation.
⑱ Confiance envers l'IA et implication humaine
Définition :L'état où les utilisateurs font confiance à l'IA de manière appropriée, sans excès ni doute excessif. Amershi et al. (2019) ont présenté 18 lignes directrices pour l'interaction homme-IA, notamment rendre explicites les capacités de l'IA et le niveau de performance, ainsi que permettre une correction efficace des erreurs. Par exemple, afficher le degré de confiance de l'IA et inciter à la vérification humaine lorsqu'il est faible correspond à cette approche.
Méthode d'évaluation :Évaluation par le taux d'acceptation de l'utilisateur lorsque l'IA a raison et lorsqu'elle a tort (degré d'étalonnage), taux de correction par l'humain, temps requis pour la correction, et conformité aux directives de conception comme le People + AI Guidebook de Google (PAIR, 2019). Par exemple, si le pourcentage d'erreurs détectées par l'utilisateur est faible, cela indique une sur-confiance.
Aperçu :Bansal et al. (2021) ont montré qu'ajouter une explication au jugement de l'IA rend les utilisateurs plus susceptibles de la suivre même quand elle se trompe, et Buçinca et al. (2021) ont montré que la « contrainte cognitive » incitant les utilisateurs à réfléchir réduit la sur-confiance. Dell'Acqua et al. (2023) ont montré une « frontière dentelée » où la qualité augmente sur les tâches où l'IA excelle mais diminue sur celles où elle échoue, et le design de quand l'humain doit intervenir fait la différence dans les résultats. Par exemple, au lieu d'avoir seulement un bouton pour approuver directement la proposition de l'IA, une workflow qui passe par la vérification des justifications avant approbation réduit les omissions d'erreurs.
⑲ Boucle d'apprentissage des données
Définition :L'existence d'un mécanisme où les données obtenues de l'utilisation reviennent pour améliorer le produit. DORA (2025) cite un écosystème de données sain et l'accès aux données internes comme des capacités déterminantes pour l'impact de l'IA. Par exemple, l'historique des corrections que les utilisateurs apportent aux résultats de l'IA devient les données d'évaluation suivantes et le matériel pour l'amélioration.
Méthode d'évaluation :Évaluation par le taux de collecte des données corrigées, la période du dépôt à l'amélioration, le changement de précision après amélioration, et l'audit de la qualité des données et des biais. Par exemple, compiler les historiques de correction mensuellement et vérifier si les mêmes types d'erreurs diminuent.
Aperçu :La boucle d'apprentissage est aussi la source du verrouillage par les données accumulées dans ⑭ Défensibilité. Pour l'IA intégrée dans du matériel, la boucle d'apprentissage ne se ferme pas sans les communications pour récupérer les données du terrain et le mécanisme de distribution des mises à jour (OTA). Par exemple, l'équipement d'inspection installé en usine doit avoir un chemin de collecte des enregistrements de faux positifs conçu au stade de la conception.
⑳ Coût et vitesse de réponse
Définition :L'état où le coût d'inférence de l'IA et le temps de réponse correspondent au prix et à l'expérience utilisateur. Contrairement aux logiciels traditionnels, les produits IA encourent des frais d'inférence à chaque utilisation, ce qui affecte directement l'économie unitaire. Par exemple, si une fonction coûtant plusieurs centaines de yens par traitement est fournie sans limite, plus l'utilisation augmente, plus les pertes augmentent.
Méthode d'évaluation :Évaluation par le coût d'inférence par utilisation et son ratio par rapport au chiffre d'affaires, la distribution du temps de réponse, et l'effet de la réduction des coûts par allégement du modèle ou mise en cache. Les limites de temps de réponse acceptables suivent les trois seuils de Nielsen (1993) : 0,1 seconde, 1 seconde, 10 secondes. Par exemple, utiliser un petit modèle et un grand modèle différemment selon le type de traitement pour mesurer le point d'équilibre entre coût et précision.
Aperçu :L'IA change aussi la rapidité du côté développeur, mais l'effet n'est pas uniforme. Dans l'expérience de Peng et al. (2023), les utilisateurs avec complément IA ont complété les tâches 55,8 % plus rapidement, tandis que l'essai contrôlé randomisé de METR (2025) a montré que les développeurs expérimentés utilisant les outils IA sur leur base de code bien connue ont pris en moyenne 19 % plus longtemps, et pourtant ils ont le sentiment d'avoir été plus rapides. Par exemple, l'effet de l'IA doit être mesuré par le lead time et le taux d'échec des changements, non par la sensation.
Processus de développement de produit
Parties prenantes
Ci-dessous, les rôles impliqués dans le développement de produits sont divisés en 7 domaines, et pour chaque domaine, nous organisons l'aperçu et les rôles des parties prenantes principales (conditions et éléments à maîtriser, autorité de décision, indicateurs à vérifier).
Domaine Produit
Aperçu :Chef de produit (responsable de ce qui est créé et des résultats), propriétaire de produit (responsable du backlog en Scrum), gestionnaire de programme et maître Scrum (progression et suppression des obstacles). Concerne principalement A (Valeur), D (Viabilité commerciale), ⑪ (Processus de développement et d'exploitation). Par exemple, dans les petites organisations, le chef de produit cumule les rôles de propriétaire de produit et de gestion de la progression.
Chef de produit :Responsable de A (Valeur) et D (Viabilité commerciale), maîtrisant le problème du client, la proposition de valeur, la PMF, l'économie unitaire, et l'alignement stratégique. Horowitz (2014) a appelé un bon chef de produit le « PDG du produit », défini comme quelqu'un qui ne cherche pas d'excuses et prend la responsabilité des résultats. Les indicateurs à vérifier sont l'enquête PMF, le taux de rétention, LTV/CAC, et l'atteinte des OKR. Par exemple, toute proposition de nouvelle fonctionnalité doit inclure l'hypothèse à valider et le changement attendu dans les indicateurs.
Domaine Design
Aperçu :Concepteur UX/UI (conception d'écrans et d'opérations), chercheur UX (étude utilisateur), rédacteur technique (libellés, aide, documentation). Concerne principalement B (Facilité d'utilisation) et ⑱ (Étalonnage de la confiance). Par exemple, la façon d'afficher le degré de confiance de l'IA est une conception commune des concepteurs et des ingénieurs en données et apprentissage automatique.
Concepteur :Responsable de B (Facilité d'utilisation), maîtrisant l'utilisabilité, le parcours de fidélisation, l'accessibilité, l'attrait et la cohérence. Les indicateurs à vérifier sont le taux d'achèvement de tâche, SUS, conformité WCAG, respect du système de design. Par exemple, avant le lancement, réaliser un test d'utilisabilité avec 5 utilisateurs et partager les résultats avec le trio.
Domaine d'ingénierie logicielle
Aperçu :Ingénieurs backend, frontend, mobile, infrastructure/SRE, sécurité, données/apprentissage automatique, assurance qualité (QA)/test. Concernent principalement C (Qualité technique) et F (Conditions spécifiques aux produits IA). Par exemple, l'OLS est défini conjointement par backend et SRE, et l'atteinte est vérifiée indépendamment par l'AQ.
Ingénieur backend :Responsable de ⑧ (Architecture et maintenabilité), ⑨ (Fiabilité, performance), ⑩ (Sécurité), maîtrisant la conception du modèle de données et des API, la gestion de la dette technique, et l'atteinte des OLS. Les indicateurs à vérifier sont le lead time de changement, le taux d'échec de changement, la couverture de test, le nombre de vulnérabilités. Par exemple, lors de la revue de conception, vérifier que la portée d'impact du changement reste confinée à un seul module.
Ingénieur frontend :Responsable de la réalisation technique de ④ (Utilisabilité) et ⑥ (Accessibilité), de la performance perçue dans ⑨ (vitesse d'affichage, réactivité), et de l'implémentation du système de design. Les indicateurs à vérifier sont la vitesse d'affichage (Core Web Vitals, etc.), l'inspection automatique de l'accessibilité, le taux de défauts d'interface. Par exemple, vérifier automatiquement à chaque lancement que l'affichage des écrans principaux se fait dans les délais impartis.
Ingénieur infrastructure/SRE :Responsable de ⑨ (Fiabilité, performance, scalabilité), ⑩ (Sécurité), ⑪ (Processus de développement et d'exploitation), maîtrisant l'exploitation des OLS et du budget d'erreur, l'intégration continue/déploiement continu et la plateforme interne, et la réponse aux incidents et rétrospectives (Beyer et al., 2016). DORA (2025) cite une plateforme interne de haute qualité comme l'une des capacités qui amplifie l'impact de l'IA. Les indicateurs à vérifier sont le taux d'atteinte de l'OLS, le temps de récupération, la fréquence de déploiement, les coûts cloud. Par exemple, lorsque le budget d'erreur est épuisé, l'ingénieur a l'autorité de cesser le développement de nouvelles fonctionnalités pour se concentrer sur la stabilisation.
Ingénieur données/apprentissage automatique :Responsable de F (Conditions spécifiques aux produits IA), maîtrisant la préparation de l'ensemble de données d'évaluation, la mesure de la précision, la conception de la boucle d'apprentissage, et la gestion des coûts d'inférence. Les indicateurs à vérifier sont la précision sur l'ensemble d'évaluation, le taux de correction humain, le coût d'inférence par utilisation. Par exemple, aucun changement de modèle ou d'instruction n'est lancé sans résultats de comparaison sur l'ensemble d'évaluation.
Assurance qualité (AQ) :Vérifier indépendamment que les niveaux d'atteinte sont satisfaits pour toutes les conditions, en fournissant les données pour les jugements à chaque étape. Les indicateurs à vérifier sont le taux de réussite des tests, le nombre de défauts critiques, les résultats des tests de régression. Par exemple, à la fin de la Phase 4, présenter les preuves d'atteinte pour chaque élément.
Domaine d'ingénierie matérielle
Aperçu :Conception mécanique, conception électrique/électronique, firmware/logiciel embarqué, fabrication et technologie de production, approvisionnement/chaîne d'approvisionnement, certification et conformité réglementaire. Concerne principalement E (Conditions spécifiques au matériel), ⑨ (Fiabilité), ⑬ (Conformité légale, sécurité). Par exemple, les certifications de chaque pays du module sans fil sont planifiées dès la phase de conception par l'équipe de conception électrique et de certification.
Ingénieur matériel (mécanique, électrique, fabrication) :Responsable de ⑯ (Fabricabilité, approvisionnement, qualité physique), maîtrisant la conception pour fabrication et assemblage (DFMA), l'approvisionnement en composants, la vérification à chaque étape de prototypage, et l'obtention des certifications. Les indicateurs à vérifier sont le rendement, le coût de la nomenclature, le taux de défaillance, le statut d'obtention des certifications. Par exemple, à la fin du DVT, prendre la décision de geler la forme pour la production de masse et la liste des composants.
Domaine Affaires
Aperçu :Ventes, réussite client/support, marketing, juridique/conformité, finances. Concerne principalement A (Valeur), ⑫ (Économie unitaire), ⑬ (Conformité légale, sécurité, éthique). Par exemple, les raisons des résiliations sont renvoyées mensuellement de la réussite client au chef de produit.
Ventes et réussite client :Chemin de retour des problèmes et insatisfactions du client vers le produit, sources d'information pour A (Valeur) et ⑫ (Économie unitaire). Les indicateurs à vérifier sont les raisons de résiliation, la durée d'implémentation, le nombre d'enquêtes par type. Par exemple, signaler mensuellement au trio les raisons de résiliation des clients.
Parties prenantes externes
Aperçu :Clients (les décideurs d'achat et les utilisateurs du terrain doivent être traités séparément), partenaires de conception (clients qui aident à l'évaluation en phase initiale), partenaires/fournisseurs, autorités de régulation/organismes de certification. Principalement sources d'information pour A (Valeur), et aussi contraintes de ⑬ et ⑯. Par exemple, en B2B, les décideurs d'achat privilégient ⑫ et ⑬ tandis que les utilisateurs du terrain privilégient ④ et ⑤, il est donc nécessaire d'écouter les deux.
Client (design partner): The information source for challenges and validator of solutions. With early clients, the role as a "design partner" who will cooperate in regular interviews and prototype evaluations is made explicit (Blank, 2013). For example, evaluation meetings are held monthly with the first 5 companies to gather feedback from the prototyping stage.
Management
Overview: Executives/founders, board members and investors. Primarily involved in ⑮ (alignment with strategy), ⑫ (unit economics), ⑭ (defensibility), and resource allocation. For example, the executive sets quarterly performance targets and delegates individual solution decisions to the trio (Cagan & Jones, 2020).
Executive/Founder: Responsible for product vision and strategy, setting performance targets, and allocating resources, while delegating individual solution decisions to the trio (Cagan & Jones, 2020). Key metrics to confirm are OKR achievement, PMF, unit economics, and regulatory risk. For example, performance targets are set quarterly without instructing specific features.
Development Process
The 20 elements are not met all at once, but are progressively fulfilled through repeated cycles of discovery and validation. Below, the development flow is divided into 6 phases, with elements confirmed in each phase listed chronologically along with the responsible stakeholders, validation methods, and achievement levels.
Phase 1: Discovery of Customer Challenges
This phase corresponds to Blank (2013)'s customer development and Torres (2021)'s continuous discovery, confirming the existence and severity of challenges before building.
① Challenge Severity and Customer Segment
Stakeholders: Product manager and customer (design partner), sales and customer success.
Validation method: Conduct customer interviews asking about past behavior (Fitzpatrick, 2013) at least weekly (Torres, 2021), and quantify the frequency of challenge occurrence, time required, and payment amount.
Achievement level: Interview count for target segment of 20 or more. Proportion of customers who voluntarily mentioned the same challenge at 60% or above. Challenge occurrence frequency at least weekly. Proportion of customers who could identify payment amount or work time for current alternatives (manual work, existing tools) at 80% or above.
⑮ Alignment with Strategy
Stakeholders: Product manager and executive.
Validation method: Comparison with strategy document and performance targets (OKR) (Cagan & Jones, 2020).
Achievement level: The strategic hypothesis verified by this initiative is written in one sentence. One or more contributing quarterly performance targets are identified and expected change amounts in target metrics (e.g., improving retention rate by 5 percentage points) are written numerically.
⑬ Regulatory, Safety and Ethics
Stakeholders: Product manager and executive (for hardware, responsible parties for certification and regulatory compliance).
Validation method: Inventory of applicable regulations and risk assessment (NIST, 2023).
Achievement level: Inventory table of applicable regulations (personal information, consumer protection, industry laws, product safety, AI regulation) is completed with zero unassigned regulations. Risk classification determination under the EU AI Act (European Parliament and Council, 2024a) and similar frameworks for high-risk designation is completed. Documentation rate of countermeasures for items classified as high-risk in risk assessment is 100%.
⑭ Defensibility
Stakeholders: Product manager and executive.
Validation method: Estimation of switching costs and competitive analysis.
Achievement level: One or more reasons for retaining customers if imitated (switching costs, accumulated data, network effects, complementary goods) are defined, with one or more leading indicators to measure its strength (e.g., accumulated data volume per customer, number of integrated systems). Comparison table of primary 3 or more competitors showing presence/absence of equivalent features and pricing.
Phase 2: Product Conception
This is the stage where Cagan (2017)'s four risks are validated through prototypes before building. For hardware, risks are validated through mockups and parallel prototyping (Dow et al., 2010) before tooling.
② Value Proposition and Relative Advantage
Stakeholders: Product manager and designer.
Validation method: Comparison table with alternatives, Kano questionnaire (Witell et al., 2013), interviews using prototypes. As product advantage has the largest impact among success factors (Cooper & Kleinschmidt, 1987), improvement magnitude is shown numerically.
Achievement level: Proportion of customers who saw the prototype and could articulate in their own words "why to use this rather than other means" is 70% or above. In Kano questionnaire, core features are classified as attractive or one-dimensional quality. Improvement magnitude compared to alternatives is clear in key metrics (e.g., work time reduction of 50% or more).
④ Usability
Stakeholders: Designer and product manager.
Validation method: Usability testing with approximately 5 users (Nielsen, 2000) conducted multiple times while refining the prototype.
Achievement level: Completion rate of primary tasks is 80% or above (Sauro & Lewis, 2016 report an average of 78%). Corrections repeated until zero problems where 2 or more people stumble at the same point. Time required for primary tasks is shorter than current alternatives.
⑫ Unit Economics
Stakeholders: Product manager and executive.
Validation method: Price acceptance interviews and revenue and cost estimates for assumed cohorts.
Achievement level: LTV/CAC of 3 or above and CAC payback period of 12 months or less with assumed price and cost (Skok, 2013). In price acceptance interviews, proportion answering assumed price is "too high" is below 30%. For hardware, gross margin including BOM cost, manufacturing cost, and logistics cost meets target (e.g., 40% or above).
⑯ Manufacturability and Supply
Stakeholders: Hardware engineers (mechanical, electrical, manufacturing) and procurement.
Validation method: DFMA review (Boothroyd et al., 2011) and part procurement lead time confirmation.
Achievement level: Target values for part count and assembly time are set with at least 20% reduction in part count from initial design. All single-source parts are identified with 100% having alternative parts or inventory policies. Procurement lead time for key parts fits within schedule margins (e.g., 4 weeks).
⑰ Accuracy and Evaluation
Stakeholders: Data and machine learning engineer and product manager.
Validation method: Creation of evaluation set from past actual cases and confirmation of inter-rater agreement rate for manual evaluation. When using automated evaluation, agreement rate with manual evaluation is confirmed (Zheng et al., 2023).
Achievement level: Evaluation set reflecting actual data distribution has 30 or more cases for each major error type. Inter-rater agreement rate for manual evaluation is 80% or above. Desired accuracy level (e.g., critical error rate below 1%) and response when it falls short are documented.
Phase 3: Product Design
This is the stage where changeability, reliability, security, and accessibility are assured through design before building. The earlier problems are discovered, the better development time and quality improve (Thomke & Fujimoto, 2000).
⑧ Architecture and Maintainability
Stakeholders: Backend engineer.
Validation method: Design review (module boundaries, dependency direction, duplication) (Parnas, 1972).
Achievement level: Among assumed change scenarios (approximately 5), proportion where impact scope is confined to one module is 80% or above. Zero circular dependencies between modules. Plan exists to allocate 10–20% of development time to repaying technical debt (Besker et al., 2019 report debt-induced losses at approximately 23% of development time).
⑨ Reliability, Performance and Scalability
Stakeholders: Backend engineer, infrastructure and SRE engineer, hardware engineer.
Validation method: SLO documentation, design review for failure assumptions (Nygard, 2018), load testing plan.
Achievement level: SLO (e.g., 99.9% availability, 95th percentile response time within 1 second) and error budget (approximately 43 minutes per month for 99.9% availability) are documented for each major function (Beyer et al., 2016). For hardware, target annual failure rate (e.g., below 1%) and durability and environmental test conditions (temperature, humidity, drop, vibration) and test count are determined.
⑩ Security and Privacy
Stakeholders: Backend engineer and infrastructure and SRE engineer (security specialist if available).
Validation method: Threat modeling and design review based on OWASP Top 10 (OWASP, 2021; Cavoukian, 2009).
Achievement level: Proportion of high-risk threats identified in threat modeling with countermeasures reflected in design is 100%. Proportion of personal data items with defined retention period and deletion procedure is 100%. Design countermeasures for each OWASP Top 10 item are documented.
⑥ Accessibility and Internationalization
Stakeholders: Designer and frontend engineer (for hardware, responsible party for certification and regulatory compliance).
Validation method: Design accessibility check and inventory of regional requirements (W3C, 2023).
Achievement level: All WCAG 2.2 AA conformance criteria (e.g., character contrast ratio 4.5:1 or higher) are met at design stage (W3C, 2023). Requirements table for language, currency, date format, power supply, and wireless authentication is completed for each target region.
⑱ Trust in AI and Human Involvement
Stakeholders: Data and machine learning engineer and designer.
Méthode de vérification : Conformité aux lignes directrices d'Amershi et al. (2019) et aux directives de PAIR (2019).
Niveau de réalisation : La conception affiche le degré de confiance ou la justification de la sortie de l'IA, avec un taux de conformité de 100 % pour les éléments applicables parmi les 18 lignes directrices d'Amershi et al. (2019). Les traitements nécessitant une vérification humaine sont identifiés, avec des objectifs de temps pour la vérification et la correction (par exemple, 30 secondes par élément maximum).
⑳ Coût et temps de réponse
Parties prenantes : Ingénieurs en données et machine learning, et ingénieurs d'infrastructure et SRE.
Méthode de vérification : Estimation des frais et du temps de réponse par type de traitement, conception de la sélection des modèles.
Niveau de réalisation : Le coût d'inférence par utilisation est estimé pour chaque type de traitement, et le ratio des frais d'inférence par rapport au chiffre d'affaires respecte l'objectif (par exemple, moins de 20 %). L'objectif de temps de réponse est défini pour chaque traitement en fonction des trois seuils de Nielsen (1993) : 0,1 seconde, 1 seconde, 10 secondes (par exemple, les traitements interactifs en moins de 10 secondes, les traitements au-delà affichent la progression).
Phase 4 : Implémentation et vérification du produit
C'est l'étape où l'on construit fréquemment en petit et on effectue des vérifications à chaque étape. Pour le matériel, les commandes de moules et de pièces sont confirmées aux étapes de vérification technique (EVT), vérification de conception (DVT) et vérification de production (PVT), de sorte que la continuation ou l'arrêt est décidé à chaque étape comme dans le modèle de porte d'étape de Cooper (1990) (Fadell, 2022).
⑪ Processus de développement et d'exploitation
Parties prenantes : Ingénieurs d'infrastructure et SRE, et tous les ingénieurs.
Méthode de vérification : Mesure continue des quatre indicateurs : fréquence de déploiement, délai de changement, taux d'échec des changements et temps de récupération (Forsgren et al., 2018 ; DORA, 2025).
Niveau de réalisation : Niveau du groupe supérieur de DORA (2024) : fréquence de déploiement à la demande (plusieurs fois par jour), délai de changement inférieur à 1 jour, taux d'échec des changements de 5 % ou moins, temps de récupération des déploiements échoués inférieur à 1 heure. Le taux d'échec des changements ne s'est pas dégradé après l'utilisation de l'IA (DORA, 2025).
④ Utilisabilité
Parties prenantes : Ingénieurs frontend et designers.
Méthode de vérification : Test d'utilisabilité après implémentation (Nielsen, 2000), mesure du SUS (Sauro & Lewis, 2016), intégration à l'IC de la mesure automatique de Core Web Vitals (Walton, 2020).
Niveau de réalisation : Taux de réussite des tâches principales de 90 % ou plus. SUS de 68 ou plus (valeur moyenne ; Sauro & Lewis, 2016), idéalement 80 ou plus. Core Web Vitals : LCP en 2,5 secondes maximum, INP en 200 millisecondes maximum, CLS de 0,1 ou moins (Walton, 2020).
⑥ Accessibilité et internationalisation
Parties prenantes : Ingénieurs frontend et designers (pour le matériel, responsables de la conformité et de la réglementation).
Méthode de vérification : Intégration à l'IC des contrôles automatiques d'accessibilité (outils de vérification conformes aux WCAG), vérification du fonctionnement avec les technologies d'assistance (lecteurs d'écran, opération au clavier uniquement), vérification de l'affichage par région cible (langue, devise, format de date). Pour le matériel, les spécifications d'alimentation et les exigences d'authentification sans fil de la région cible sont confirmées sur le prototype.
Niveau de réalisation : Zéro violation de WCAG 2.2 AA lors des contrôles automatiques (W3C, 2023). Taux de réussite des tâches principales de 100 % avec lecteur d'écran et opération au clavier uniquement. Pourcentage d'éléments du tableau des exigences régionales créé en Phase 3 qui sont vérifiés dans l'implémentation : 100 %.
⑨ Fiabilité et performance
Parties prenantes : Ingénieurs backend, ingénieurs d'infrastructure et SRE, ingénieurs matériel.
Méthode de vérification : Tests de charge et injection de pannes (arrêt des dépendances) (Nygard, 2018). Pour le matériel, essais de durabilité et d'environnement (température, humidité, chute, vibration) et essais de vie accélérée.
Niveau de réalisation : Sous une charge deux fois supérieure au pic prévu, le 95e percentile du temps de réponse est dans l'objectif de niveau de service (SLO) et le taux d'erreur est inférieur à 0,1 %. Récupération et rétrogradation automatiques en cas d'arrêt des dépendances. Pour le matériel, taux de réussite des essais de durabilité et d'environnement de 100 % et taux de défaillance estimé par essai de vie accélérée inférieur à l'objectif (par exemple, moins de 1 % par an).
⑩ Sécurité
Parties prenantes : Ingénieurs backend et ingénieurs d'infrastructure et SRE.
Méthode de vérification : Audit de vulnérabilité, test de pénétration, inspection automatique des bibliothèques dépendantes (NIST, 2022).
Niveau de réalisation : Zéro vulnérabilité non corrigée de sévérité « élevée » ou supérieure dans l'audit et le test de pénétration. Zéro vulnérabilité connue non corrigée dans les bibliothèques dépendantes (un délai de correction est défini pour la sévérité « moyenne » ou inférieure). Taux de réalisation de 100 % pour les contrôles de sécurité en IC.
⑯ Fabricabilité et approvisionnement
Parties prenantes : Ingénieurs matériel et responsables de la fabrication et de l'approvisionnement.
Méthode de vérification : Évaluation des prototypes à chaque étape (EVT, DVT, PVT) et mesure du taux de passage direct (proportion d'approvisionnements réussis du premier coup).
Niveau de réalisation : À l'EVT, fonctionnement de 100 % des fonctions principales confirmé selon les spécifications. À la DVT, forme de production et nomenclature (BOM) figées, avec convergence des modifications de conception à zéro. À la PVT, taux de passage direct de la ligne de production atteint l'objectif (par exemple, 95 % ou plus), temps d'assemblage conforme à l'objectif, et certifications (sécurité, compatibilité électromagnétique, sans fil) obtenues.
⑰ Précision et évaluation
Parties prenantes : Ingénieurs en données et machine learning, et QA.
Méthode de vérification : Évaluation automatique sur l'ensemble d'évaluation à chaque version, rapprochement régulier avec l'évaluation manuelle (Zheng et al., 2023).
Niveau de réalisation : Précision sur l'ensemble d'évaluation égale ou supérieure à l'objectif, avec variation des indicateurs clés avant et après modification du modèle ou des instructions de moins de 1 point. Taux de concordance entre évaluation automatique et évaluation manuelle de 80 % ou plus (niveau rapporté par Zheng et al., 2023). Taux de réalisation de 100 % pour l'évaluation à chaque version.
⑲ Boucle d'apprentissage des données
Parties prenantes : Ingénieurs en données et machine learning.
Méthode de vérification : Mesure du taux de collecte des données corrigées.
Niveau de réalisation : Taux d'implémentation de 100 % d'un mécanisme d'enregistrement des corrections des utilisateurs pour chaque type de sortie principal. Taux de collecte des données corrigées (proportion d'éléments corrigés enregistrés parmi tous les éléments corrigés) de 90 % ou plus. Délai d'ajout des données collectées à l'ensemble d'évaluation de 1 mois maximum.
Phase 5 : Exploitation et mesure du produit
C'est l'étape, après le lancement, de mesurer si la valeur est réellement créée. Pour le cadre de mesure, on utilise AARRR (McClure, 2007) et HEART (Rodden et al., 2010), et l'effet des initiatives est confirmé par les tests A/B (Kohavi et al., 2020). Pour l'indicateur métier clé par étape de croissance (OMTM), veuillez consulter l'article séparé « OMTM et KPI que les startups et les nouveaux projets commerciaux doivent atteindre à chaque stade ».
③ Adéquation produit-marché
Parties prenantes : Responsable produit.
Méthode de vérification : Enquête PMF, analyse de cohorte, NPS (Reichheld, 2003). Pour le matériel, remplacée par le taux de retour et les avis, ou le taux de fonctionnement pour les appareils connectés.
Niveau de réalisation : Proportion d'utilisateurs répondant « je serais très déçu » d'au moins 40 % (Ellis & Brown, 2017). Courbe de rétention des cohortes s'aplatissant après 3 à 6 mois. NPS positif (bien que le pouvoir prédictif du NPS seul soit limité, il est utilisé en conjonction avec le taux de rétention ; Keiningham et al., 2007). Pour le matériel, taux de retour dans l'objectif (par exemple, moins de 3 %) et note moyenne des avis de 4 ou plus sur 5.
⑤ Utilisation continue et formation d'habitudes
Parties prenantes : Responsable produit et designer.
Méthode de vérification : Mesure du taux d'activation, courbe de rétention, et cinq indicateurs de HEART.
Niveau de réalisation : Taux d'activation (taux d'accès à la valeur principale depuis l'inscription) égal à l'objectif (par exemple, 40 % ou plus). Taux de rétention mensuel égal ou amélioré par rapport à la cohorte précédente. Parmi les cinq indicateurs de HEART, taux de réussite des tâches et taux de revisites atteignent les objectifs (Rodden et al., 2010).
⑨ Fiabilité et performance
Parties prenantes : Ingénieurs d'infrastructure et SRE.
Méthode de vérification : Surveillance du SLO et post-mortem des incidents (Beyer et al., 2016).
Niveau de réalisation : Taux de réalisation du SLO mensuel égal ou supérieur à l'objectif (par exemple, disponibilité de 99,9 %), avec consommation du budget d'erreur inférieure à 100 %. Taux de réalisation de 100 % des post-mortem d'incidents majeurs, avec taux de réalisation à temps de 90 % ou plus des mesures de prévention des récidives.
⑫ Économie par unité
Parties prenantes : Responsable produit et direction, Sales et Customer Success.
Méthode de vérification : Consolidation des revenus et frais par cohorte.
Niveau de réalisation : Ratio LTV/CAC réalisé de 3 ou plus, délai de récupération du CAC de 12 mois maximum, taux de rétention du revenu net de 100 % ou plus (Skok, 2013). Pour le matériel, marge brute incluant les frais de garantie et de retour égale à l'objectif (par exemple, 40 % ou plus).
⑲ Boucle d'apprentissage des données
Parties prenantes : Ingénieurs en données et machine learning.
Méthode de vérification : Consolidation de l'historique des corrections, comparaison de la précision avant et après amélioration, audit des biais de données.
Niveau de réalisation : Taux de collecte des données corrigées de 90 % ou plus. Taux d'occurrence du même type d'erreur en baisse mensuelle (par exemple, réduction de 30 % par trimestre). Comparaison de la précision avant et après amélioration enregistrée à chaque fois, et audit des biais de données réalisé au moins une fois par trimestre.
⑳ Coût et temps de réponse
Parties prenantes : Ingénieurs d'infrastructure et SRE, et ingénieurs en données et machine learning.
Méthode de vérification : Mesure continue du coût et du temps de réponse, mesure de l'effet de la sélection des modèles.
Niveau de réalisation : Ratio des frais d'inférence par rapport au chiffre d'affaires dans l'objectif (par exemple, moins de 20 %). 95e percentile du temps de réponse dans l'objectif pour chaque traitement. Ampleur de la réduction des frais par sélection des modèles mesurée.
Phase 6 : Retour d'expérience et amélioration
Cette étape consiste à réintégrer les résultats de la mesure dans la planification suivante. Pour les logiciels, les cycles se déroulent sur des semaines ou des trimestres, tandis que pour le matériel, ils se font par génération (Fadell, 2022).
⑪ Processus de développement et d'exploitation
Parties prenantes : Ingénieurs en infrastructure et SRE, ainsi que tous les ingénieurs.
Méthode de vérification : Retour d'expérience des versions et mesures régulières des 4 indicateurs.
Niveau de réalisation : L'évolution trimestrielle des 4 indicateurs est stable ou améliorée (en direction du niveau du groupe supérieur selon DORA, 2024). Le taux de mise en œuvre des mesures d'amélioration décidées lors du retour d'expérience est d'au moins 80%.
⑧ Architecture et maintenabilité
Parties prenantes : Ingénieurs backend.
Méthode de vérification : Inventaire de la dette et évolution du délai de changement (Besker et al., 2019).
Niveau de réalisation : Le tableau d'inventaire de la dette technique est mis à jour au moins une fois par trimestre. 10 à 20% du temps de développement est réellement utilisé pour le remboursement (au moins 80% par rapport au plan). Le délai de changement n'est pas pire qu'au trimestre précédent.
⑭ Capacité défensive
Parties prenantes : Chef de produit et direction générale.
Méthode de vérification : Suivi de la concurrence et comparaison des taux de résiliation.
Niveau de réalisation : Dans le trimestre suivant le lancement par les concurrents de fonctionnalités équivalentes, l'augmentation du taux de résiliation reste dans la limite d'1 point. Les indicateurs avancés de capacité défensive (volume de données accumulées, nombre de systèmes intégrés) augmentent par rapport au trimestre précédent.
⑮ Alignement stratégique
Parties prenantes : Chef de produit et direction générale.
Méthode de vérification : Retour d'expérience des OKR (en confrontant hypothèses et résultats selon l'approche scientifique de Camuffo et al., 2020).
Niveau de réalisation : Le taux de réalisation des objectifs de performance du trimestre atteint la cible (par exemple, 70% ou plus ; 100% n'est pas exigé car les objectifs sont ambitieux). Le taux d'enregistrement du rejet ou de la révision des hypothèses qui n'ont pas été atteintes est de 100%.
⑬ Conformité, sécurité et éthique
Parties prenantes : Chef de produit et direction générale.
Méthode de vérification : Mise à jour régulière de l'inventaire réglementaire et audit externe.
Niveau de réalisation : L'inventaire réglementaire est mis à jour au moins une fois par an et à 100% avant tout développement vers de nouveaux marchés ou usages. Le taux de respect dans les délais des recommandations d'audit externe est de 100%.
⑯ Manufacturabilité et approvisionnement
Parties prenantes : Ingénieurs matériel et chef de produit.
Méthode de vérification : Analyse des taux de défauts et de retours au début de la production de masse (Fadell, 2022).
Niveau de réalisation : Le taux de défauts et le taux de retours dans les 3 mois suivant le lancement de la production sont conformes aux objectifs. Les 3 principales causes de défauts et de retours sont reflétées dans les modifications de conception de la deuxième génération.
③ Adéquation produit-marché
Parties prenantes : Chef de produit.
Méthode de vérification : Enquête PMF régulière et analyse de cohorte (Olsen, 2015).
Niveau de réalisation : L'enquête PMF est menée au moins une fois par trimestre et la proportion de réponses « très déçu » est maintenue à 40% ou plus. Le taux de rétention ne s'est pas dégradé par rapport à la même période de l'année précédente.
Tendances actuelles de la recherche et de la pratique
Tendances actuelles de la recherche
La supériorité du produit arrive en première position : Cooper & Kleinschmidt (1987) ont analysé environ 200 nouveaux produits et montré que les produits de qualité possédant des bénéfices uniques sont les plus forts discriminants entre succès et échec. Henard & Szymanski (2001) ont réalisé une méta-analyse de 60 études confirmant que la supériorité du produit, le potentiel du marché, la satisfaction des besoins clients, la qualité de la planification avant le développement et l'investissement en ressources de développement sont des facteurs qui se lient de manière cohérente au succès, résultat confirmé par la méta-analyse actualisée d'Evanschitzky et al. (2012) qui a également confirmé les effets de la supériorité du produit et de l'orientation marché. Par exemple, la force de vente ou la publicité peuvent compléter l'effet d'un excellent produit, mais ne peuvent pas le remplacer.
Plus de fonctionnalités n'est pas nécessairement mieux : Thompson et al. (2005) ont démontré expérimentalement que bien que les consommateurs choisissent des produits avec davantage de fonctionnalités avant l'achat, leur satisfaction diminue à mesure qu'ils commencent à utiliser le produit, et leur intention de réachat décline également avec les produits multifonctionnels – un phénomène appelé « surcharge fonctionnelle ». Par exemple, le phénomène où un produit remporte une comparaison de tableau de fonctionnalités mais est décrit comme « difficile à utiliser » après son lancement peut être expliqué par cette recherche.
La qualité attrayante devient ordinaire avec le temps : Witell et al. (2013) ont synthétisé 30 ans de recherche sur le modèle de Kano et ont indiqué que la « transition de la qualité au fil du temps », où la qualité attrayante se déplace vers la qualité de base, puis vers la qualité évidemment requise, a été confirmée de manière répétée. Par exemple, l'appareil photo du smartphone s'est déplacé de la qualité attrayante vers la qualité évidemment requise, et maintenant la qualité d'image est concurrencée en tant que qualité de base.
La beauté améliore la perception de la facilité d'utilisation : Kurosu & Kashimura (1995) ont découvert une forte corrélation entre l'évaluation de l'esthétique et celle de la convivialité sur l'écran d'un distributeur automatique, et Tractinsky et al. (2000) ont reproduit ce résultat en confirmant que même lorsque la facilité d'utilisation réelle est identique, un écran plus beau est perçu comme plus facile à utiliser. Par exemple, même avec deux écrans de demande possédant les mêmes fonctionnalités, celui qui est mieux organisé est évalué comme « plus clair » et les utilisateurs montrent plus de patience.
La participation des utilisateurs est liée au succès du système : Bano & Zowghi (2015) ont examiné systématiquement 87 études traitant de la relation entre participation des utilisateurs et succès du développement de système, et ont rapporté que la plupart des études confirmaient une relation positive. Par exemple, les projets où les utilisateurs participent dès la phase de définition des exigences rencontrent moins de problèmes lors des tests d'acceptation.
Les facteurs expliquant l'acceptation technologique : UTAUT de Venkatesh et al. (2003), qui intègre le modèle d'acceptation technologique de Davis (1989), rapporte que quatre facteurs – attente de performance, attente d'effort, influence sociale et conditions facilitantes – expliquent environ 70% de la variance de l'intention d'utilisation et du comportement d'utilisation. Par exemple, dans le déploiement de systèmes métier, ce ne sont pas seulement la facilité d'utilisation, mais aussi l'influence sociale (le fait que les superviseurs et collègues l'utilisent) et les conditions facilitantes (le support) qui déterminent l'adoption.
Preuves empiriques du développement logiciel : Forsgren et al. (2018) ont montré dans une étude menée sur plusieurs années que quatre indicateurs – fréquence de déploiement, délai d'exécution, taux d'échec des changements et temps de récupération – sont liés à la performance organisationnelle. DORA (2024) rapporte que l'augmentation de l'utilisation de l'IA était associée à une baisse de 1,5% du débit et une baisse de 7,2% de la stabilité, et DORA (2025) rapporte que le débit s'est amélioré mais l'instabilité continue d'augmenter. Par exemple, les suggestions de la recherche indiquent que le déploiement de l'IA devrait d'abord établir les fondements comme les petits lots et la gestion des versions.
L'effet de l'Agile : Serrador & Pinto (2015) ont analysé 1 002 projets et montré que plus le degré d'adoption de l'Agile est élevé, plus le succès du projet est élevé à la fois en termes d'efficacité et de satisfaction des parties prenantes. D'autre part, Shepherd & Gruber (2021) ont classé les points validés et non validés parmi les éléments du Lean Startup, arguant qu'on devrait évaluer l'effet des pratiques individuelles plutôt que le nom de la méthode. Par exemple, une équipe qui n'implémente que les cérémonies de sprint sans augmenter les points de contact avec les clients n'obtiendra pas les effets que la recherche démontre.
Le coût de la dette technique : Besker et al. (2019) rapportent que les développeurs dépensent en moyenne 23% de leur temps de travail à gérer la dette technique. Par exemple, pour une équipe de 5 personnes, cela revient à perdre constamment plus que l'équivalent d'une personne à plein temps aux intérêts de la dette.
Sécurité psychologique et performance de l'équipe : Edmondson (1999) a montré que la « sécurité psychologique » – la conviction que l'on ne sera pas puni pour avoir signalé un échec – améliore les comportements d'apprentissage et la performance de l'équipe, et la recherche interne de Google (Rozovsky, 2015) a analysé 180 équipes et rapporté que la sécurité psychologique était le facteur prédictif le plus fort de l'efficacité de l'équipe. Par exemple, le principe SRE (Beyer et al., 2016) de ne pas blâmer les individus dans les analyses post-mortem des incidents s'aligne avec cette recherche.
La productivité ne peut pas être mesurée par un seul indicateur : Le cadre SPACE de Forsgren et al. (2021) considère la productivité des développeurs selon cinq aspects – satisfaction, performance, volume d'activité, communication et efficacité – et souligne le danger de mesurer avec un seul indicateur d'activité comme le nombre de commits. Par exemple, même si l'IA augmente le nombre de lignes de code, si le temps d'attente d'examen augmente, la productivité n'a pas augmenté.
L'effet de l'approche scientifique : L'essai comparatif aléatoire de Camuffo et al. (2020) et la large réplication de Camuffo et al. (2024) montrent que l'entraînement à formuler et valider des hypothèses conduit à une sortie précoce des entreprises sans perspective et à une amélioration des revenus. Par exemple, même avec le Lean Startup identique, les équipes qui écrivent et valident des hypothèses obtiennent des résultats différents de celles qui se contentent de répéter les prototypes.
Résolution précoce des problèmes et prototypage parallèle : Thomke & Fujimoto (2000) ont montré à partir des données de développement de Toyota que la détection et la résolution des problèmes à un stade précoce du développement améliorent la durée de développement et la qualité, et Dow et al. (2010) ont démontré expérimentalement que le prototypage parallèle de plusieurs concepts conduit à une meilleure conception et à une exploration plus diversifiée qu'une amélioration séquentielle d'un concept unique. Par exemple, pour le boîtier d'un produit électronique, le prototypage simultané de 3 concepts pour comparaison produit de meilleurs résultats que 5 révisions séquentielles d'un seul concept.
La réalité des expériences en ligne : Kohavi et al. (2020) rapportent que parmi la large quantité de tests A/B menés chez Microsoft et Bing, seul environ un tiers des initiatives destinées à l'amélioration ont effectivement amélioré les indicateurs clés, et ont organisé les méthodes de conception d'expériences fiables. Par exemple, même pour une proposition « qui doit clairement s'améliorer », plus de la moitié n'ont aucun effet ou se dégradent, ce qui rend nécessaire la discipline de mesurer avant de généraliser.
Collaboration entre humain et IA : Bansal et al. (2021) montrent que l'explication de l'IA peut renforcer la confiance excessive des utilisateurs, et Buçinca et al. (2021) montrent qu'une intervention qui encourage la réflexion réduit cette confiance excessive. Par exemple, l'interface utilisateur des produits IA ne devient pas sûre simplement en augmentant les explications ; une conception qui encourage la vérification de l'utilisateur est nécessaire.
IA générative et productivité : Brynjolfsson et al.(2025)rapportent que l'assistance par IA générative augmente le nombre de cas traités en support client de 14 % en moyenne, de 34 % pour les agents inexpérimentés, tandis que pour les experts, l'effet est quasi nul. Peng et al.(2023)montrent que les utilisateurs d'autocomplétion IA terminent les tâches de programmation 55,8 % plus vite. Dell'Acqua et al.(2023)rapportent une « frontière dentelée » dans une expérience avec des consultants : la qualité augmente de 40 % pour les tâches où l'IA excelle, mais le taux de réussite baisse de 19 points pour celles où elle échoue. METR(2025)rapporte que les développeurs expérimentés prennent 19 % plus de temps quand ils utilisent l'IA sur des bases de code qu'ils connaissent bien. Par exemple, puisque l'efficacité de l'IA dépend du type de travail et du niveau d'expérience de l'utilisateur, il faut la mesurer dans ses propres processus métier.
Méthodes d'évaluation de l'IA : Zheng et al.(2023)montrent qu'utiliser un modèle de langage puissant comme évaluateur concorde avec les évaluateurs humains à environ 80 %, équivalent au taux d'accord entre humains. Stanford HAI(2025)note que beaucoup de benchmarks publics sont saturés et que l'écart avec les problèmes réels s'élargit. Par exemple, une pratique recommandée par ces deux études consiste à exécuter l'évaluation automatisée sur un ensemble d'évaluation maison comme test de régression à chaque version, et de régulièrement la confronter avec l'évaluation manuelle.
Pratiques des dark patterns et accessibilité : Mathur et al.(2019)rapportent qu'après analyse automatisée d'environ 11 000 sites marchands, environ 11 % contenaient des « dark patterns » trompant les utilisateurs. WebAIM(2024)rapporte que 95,9 % des pages d'accueil du million de sites les plus visités présentaient des violations WCAG détectables automatiquement. Par exemple, pour augmenter la rétention sans recourir aux dark patterns, il faut vérifier les conceptions par rapport aux classifications publiées, et l'accessibilité doit au minimum intégrer les contrôles automatisés dans l'IC.
Limites du NPS : Keiningham et al.(2007)vérifient l'affirmation que l'NPS (Net Promoter Score) prédit mieux la croissance de l'entreprise que d'autres indicateurs de satisfaction client, et rapportent n'avoir trouvé aucune supériorité. Par exemple, la recherche suggère d'utiliser l'NPS non pas seul comme indicateur de croissance, mais en combinaison avec le taux de rétention et les raisons d'attrition.
Tendances récentes des praticiens
Sur la valeur : La devise de Y Combinator « Build something people want » (Graham, 2013), « Customer obsession » de Bezos (2017), et « Start with customer experience and work backward to the technology » de Jobs (1997) placent tous A (valeur) au sommet. Par exemple, Amazon pratique de placer une chaise vide pour le client à table lors des réunions, imposant la perspective du client (Bryar & Carr, 2021).
Voix du client ou vision : Blank (2013) et Torres (2021) mettent l'accent sur apprendre des clients, tandis que Jobs affirmait que les gens ne savent souvent pas ce qu'ils veulent tant qu'on ne le leur montre pas (Jobs, 1998). Le partage entre les deux est que le problème s'apprend chez les clients, tandis que la solution est conçue et validée par les créateurs. Par exemple, les clients demandent « des chevaux plus rapides », mais le problème « vouloir se déplacer plus vite » est valide, et la solution (l'automobile) est conçue par les créateurs.
Sur l'utilisabilité et l'attrait : « Don't make me think » de Krug (2014), « Less but better » de Rams (Vitsœ, n.d.), et « If you focus on the users, everything else will follow » de Google (n.d.) sont les principes de B (utilisabilité). Par exemple, l'espace blanc de la page de recherche Google en est l'expression physique.
Ajouter des fonctionnalités ou retrancher : Le modèle Kano met l'accent sur l'ajout de qualités attractives, tandis que Rams et Musk mettent l'accent sur la soustraction. Musk énumère l'ordre : remettre en question les exigences, supprimer les pièces et processus, simplifier, accélérer, automatiser, et affirme qu'on ne doit pas automatiser avant de supprimer (Everyday Astronaut, 2021). Les deux ne se contredisent pas : ajouter uniquement les fonctionnalités qui sont des qualités attractives, et simplifier celles qui sont devenues des attentes de base — c'est une question d'échelle temporelle. Par exemple, chaque proposition de nouvelle fonctionnalité doit être accompagnée de « qu'allez-vous supprimer à la place », et supprimer régulièrement les fonctionnalités inutilisées.
Sur la qualité technique : « Ajouter de la main-d'œuvre à un projet en retard ne fait que l'accélérer davantage » de Brooks (1995), le budget d'erreur de Beyer et al. (2016), et « 3 générations pour être terminé » de Fadell (2022) traitent C (qualité technique) non comme la poursuite de l'idéal, mais comme la gestion des contraintes. Par exemple, le budget d'erreur est un mécanisme qui résout le conflit entre stabilité et nouvelles fonctionnalités par des chiffres.
Opérations conciliant rapidité et qualité : Shape Up de Singer (2019) contient le travail dans une période fixe de 6 semaines, Working Backwards de Bryar & Carr (2021) travaille à rebours à partir du communiqué de presse, et SRE de Beyer et al. (2016) équilibre les nouvelles fonctionnalités et la stabilité via le budget d'erreur. Comme l'a montré la recherche de Forsgren et al. (2018), la rapidité et la stabilité ne sont pas un compromis, mais tous deux augmentent avec le même investissement (petits lots, automatisation). Par exemple, sortir 3 mois de fonctionnalités à la fois plutôt que tous les 2 semaines et voir les réactions raccourcit la période de progression dans une mauvaise direction.
Sortir tôt ou construire et sortir ensuite : Hoffman & Yeh (2018) affirment que si vous n'avez pas honte de la première version, vous l'avez lancée trop tard, et Graham (2013) recommandait au stade initial de faire des « choses qui ne sont pas à l'échelle » comme acquérir et supporter les clients manuellement. D'autre part, Dyson (2021) a connu 5 127 itérations de prototypes avant la commercialisation pour les produits physiques qui nécessitent des itérations avant le lancement. Par exemple, les logiciels se lancent tôt en version limitée, tandis que le matériel itère rapidement et nombreuses fois sur les prototypes.
Voir le terrain : Le « Genba Genbutsu » de Toyota (Liker, 2004) établit en principe de vérifier les faits sur le terrain plutôt que par rapport, et la Continuous Discovery de Torres (2021) exige de fixer l'habitude de quelques entretiens clients par semaine. Vohra (2018) a publié une procédure pour catégoriser les réponses ouvertes à des enquêtes PMF et établir les priorités d'amélioration. Par exemple, avec les premiers clients, le fondateur lui-même effectue l'intégration et en apprend les problèmes en cours de route.
Sur la viabilité commerciale et la stratégie : « Le bon directeur de produit est le PDG du produit et assume les résultats » de Horowitz (2014), « Équipe produit plutôt qu'équipe de fonctionnalités » de Cagan & Jones (2020), et « Vigilance contre la confusion du processus avec l'objectif » de Bezos (2017) traitent D (viabilité) non comme une affaire de fonctionnalités individuelles, mais comme une affaire de résultats. Par exemple, une équipe à qui on confie un résultat (taux de rétention) est évaluée sur le taux de rétention, non sur le nombre de fonctionnalités.
Transition vers un modèle d'opération produit : Cagan (2024) systématise la transition d'une « équipe de fonctionnalités » qui exécute les demandes de fonctionnalités dans l'ordre à une « équipe produit » responsable des résultats en tant que « modèle d'opération produit », en clarifiant les comportements que les dirigeants, les responsables produit et les équipes doivent changer. Par exemple, le remplacement de la feuille de route d'une liste de fonctionnalités par une liste d'objectifs de résultats trimestriels et d'hypothèses à tester en est le premier pas.
Comment les fondateurs s'impliquent : Graham (2024), s'appuyant sur l'expérience de Chesky d'Airbnb, propose le « Founder Mode » où le fondateur s'implique directement dans les détails, en contraste avec le « Manager Mode » qui met l'accent sur la délégation, ce qui a suscité un débat parmi les praticiens. C'est une tension avec le principe « Déléguer la solution aux équipes » de Cagan & Jones (2020). Par exemple, même si le fondateur s'implique dans les détails du produit, le point de basculement dépend de la question de savoir s'il le fait sans briser la discipline des objectifs de résultats et de la validation.
Changements du développement par l'IA : Karpathy (2017) propose le « Software 2.0 » où le code écrit par l'homme est remplacé par des modèles appris, et le travail des développeurs passe de l'écriture de code à la préparation des données. DORA (2025) rapporte que l'IA amplifie les forces et les faiblesses de l'organisation. Par exemple, même si la génération de code s'accélère avec l'IA, si l'examen et les tests ne suivent pas, le taux d'échec des modifications augmente.
Centrer l'évaluation des produits IA : Husain (2024) affirme que le succès d'un produit IA dépend de la création d'un mécanisme d'évaluation fondé sur les données réelles, et recommande de traiter l'évaluation comme l'équivalent de la définition des exigences. Cela s'aligne avec les recherches de Zheng et al. (2023) et Stanford HAI (2025). Par exemple, ne pas lancer les modifications de modèle ou de prompt sans les comparer sur son propre ensemble d'évaluation est la pratique correspondante.
Points communs des praticiens du matériel : « 3 générations pour être terminé » de Fadell (2022), les itérations de prototypes de Dyson (2021), le processus de soustraction de Musk (Everyday Astronaut, 2021), et le Genba Genbutsu de Toyota (Liker, 2004) s'accordent tous sur le fait que pour les produits physiques, le nombre et la vitesse des prototypes, ainsi que la suppression des pièces et processus, déterminent la qualité. Par exemple, la première génération restreint les fonctionnalités et prévoit d'incorporer les apprentissages dans la deuxième génération dès le départ.
Habituation et ligne de démarcation éthique : Eyal (2014) propose un cadre pour juger si la conception de l'habituation est justifiée en posant deux questions : est-ce que vous l'utiliseriez vous-même, et améliore-t-il la vie de l'utilisateur. Google (PAIR, 2019) et Microsoft (Amershi et al., 2019) ont publié des directives de conception pour les produits IA. Face à la généralisation des dark patterns que montre la recherche de Mathur et al. (2019), des réglementations comme la Loi IA de l'UE (European Parliament and Council, 2024a) ajoutent des contraintes à la conception. Par exemple, les initiatives pour augmenter la rétention doivent être jugées selon qu'elles peuvent être expliquées aux utilisateurs.
Conclusion
Cet article a décomposé les conditions d'un bon produit en 6 conditions et 20 éléments, et a clarifié qui doit vérifier quoi et à quel niveau à chaque phase du développement. Les valeurs de niveau d'accomplissement sont des points de référence et sont supposées être ajustées en fonction des résultats de chaque organisation. Nous espérons qu'il servira de perspective exhaustive lors de la conception d'un nouveau produit ou de l'inspection d'un produit existant.
Références
Amershi, S., Weld, D., Vorvoreanu, M., Fourney, A., Nushi, B., Collisson, P., Suh, J., Iqbal, S., Bennett, P. N., Inkpen, K., Teevan, J., Kikin-Gil, R., & Horvitz, E. (2019). Guidelines for human-AI interaction. Proceedings of the 2019 CHI Conference on Human Factors in Computing Systems, Paper 3. Résumé : Des chercheurs de Microsoft ont synthétisé plus de 150 principes de conception en 18 lignes directrices et en ont validé la pertinence par étude utilisateur. Cela comprend la clarification des capacités de l'IA et l'efficacité de la correction des erreurs.
Andreessen, M. (2007). The only thing that matters. pmarchive. https://pmarchive.com/guide_to_startups_part4.html Résumé : Essai définissant le product-market fit comme le facteur unique déterminant le succès des startups, expliquant qu'il s'agit d'« être sur un bon marché avec un produit qui satisfait ce marché ».
Bano, M., & Zowghi, D. (2015). A systematic review on the relationship between user involvement and system success. Information and Software Technology, 58, 148–169. Résumé : Examen systématique de 87 études portant sur la relation entre implication des utilisateurs et succès du système, montrant qu'une relation positive a été confirmée dans la majorité des cas.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, Article 81. Résumé : Une expérience a montré que l'ajout d'explications aux décisions de l'IA incite les utilisateurs à les suivre même quand l'IA se trompe, ce qui ne garantit pas une amélioration de la performance de la collaboration homme-IA.
Besker, T., Martini, A., & Bosch, J. (2019). Software developer productivity loss due to technical debt: A replication and extension study examining developers' development work. Journal of Systems and Software, 156, 41–61. Résumé : Sur la base des enregistrements de travail de 43 développeurs, l'étude montre qu'en moyenne 23 % du temps de travail est consacré à la gestion de la dette technique.
Beyer, B., Jones, C., Petoff, J., & Murphy, N. R. (Eds.). (2016). Site reliability engineering: How Google runs production systems. O'Reilly Media. Résumé : Ouvrage synthétisant les pratiques SRE de Google. Il démontre une approche où les objectifs de niveau de service (SLO) et le budget d'erreur permettent de déterminer numériquement l'équilibre entre fiabilité et développement de nouvelles fonctionnalités.
Bezos, J. (2017). 2016 letter to shareholders. Amazon. Résumé : Lettre aux actionnaires énumérant les conditions pour maintenir l'« Jour 1 » : obsession client, résistance à l'instrumentalisation des processus, acceptation des tendances externes et prise de décision rapide.
Blank, S. (2013). The four steps to the epiphany: Successful strategies for products that win (2nd ed.). K&S Ranch. Résumé : Ouvrage proposant le modèle du « customer development » qui découvre et valide les clients en parallèle du développement produit, formant la base du lean startup.
Boothroyd, G., Dewhurst, P., & Knight, W. A. (2011). Product design for manufacture and assembly (3rd ed.). CRC Press. Résumé : Manuel systématisant les méthodes DFMA (Design For Manufacture and Assembly) visant à réduire le nombre de pièces et simplifier l'assemblage lors de la phase de conception.
Brooke, J. (1996). SUS: A \"quick and dirty\" usability scale. In P. W. Jordan, B. Thomas, B. A. Weerdmeester, & I. L. McClelland (Eds.), Usability evaluation in industry (pp. 189–194). Taylor & Francis. Résumé : Proposition d'une System Usability Scale (SUS) évaluant l'utilisabilité sur une échelle de 0 à 100 points via 10 questions.
Brooks, F. P. (1995). The mythical man-month: Essays on software engineering (Anniversary ed.). Addison-Wesley. Résumé : Classique sur la gestion des projets de développement logiciel, incluant la loi de Brooks selon laquelle ajouter du personnel à un projet logiciel en retard le retarde davantage.
Bryar, C., & Carr, B. (2021). Working backwards: Insights, stories, and secrets from inside Amazon. St. Martin's Press. Résumé : Des anciens cadres d'Amazon expliquent les mécanismes tels que Working Backwards commençant par un communiqué de presse et une FAQ, le leader à fil unique, et le siège du client vide.
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889–942. Résumé : Étude empirique montrant que le soutien de l'IA générative au service client augmente en moyenne le volume de traitement de 14 %, avec des effets plus importants pour les agents moins expérimentés.
Buçinca, Z., Malaya, M. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), Article 188. Résumé : Une expérience démontre que les « fonctions de contrainte cognitive », comme faire réfléchir l'utilisateur avant de consulter la proposition de l'IA, réduisent la sur-confiance envers l'IA.
Cagan, M. (2017). Inspired: How to create tech products customers love (2nd ed.). Wiley. Résumé : Ouvrage organisant les conditions d'un bon produit en quatre risques (valeur, facilité d'utilisation, réalisabilité, viabilité commerciale) et promouvant la découverte produit qui valide avant de construire.
Cagan, M. (2024). Transformed: Moving to the product operating model. Wiley. Résumé : Systématisation du passage des équipes fonctionnelles aux équipes produit responsables des résultats sous le nom de « product operating model », expliquant les étapes de la transformation.
Cagan, M., & Jones, C. (2020). Empowered: Ordinary people, extraordinary products. Wiley. Résumé : Ouvrage contrastant les « équipes fonctionnelles » qui exécutent des demandes de fonctionnalités avec les « équipes produit » responsables des résultats et autonomes dans leurs choix de solution, analysant le leadership nécessaire pour réaliser cette dernière.
Camuffo, A., Cordova, A., Gambardella, A., & Spina, C. (2020). A scientific approach to entrepreneurial decision making: Evidence from a randomized control trial. Management Science, 66(2), 564–586. Résumé : En divisant aléatoirement 116 startups, l'étude montre que les fondateurs formés à une approche scientifique articulant et testant les hypothèses cessent plus tôt les activités sans perspective et génèrent des revenus plus élevés.
Camuffo, A., Gambardella, A., Messinese, D., Novelli, E., Paolucci, E., & Spina, C. (2024). A scientific approach to entrepreneurial decision-making: Large-scale replication and extension. Strategic Management Journal, 45(6), 1209–1237. Résumé : Réplication et extension de l'étude 2020 auprès de 759 entreprises, confirmant que l'effet de l'approche scientifique se reproduit.
Cavoukian, A. (2009). Privacy by design: The 7 foundational principles. Information and Privacy Commissioner of Ontario. Résumé : Présentation de sept principes intégrant le respect de la vie privée à la conception, par des mesures préventives plutôt que réactives, comme la protection par défaut.
Christensen, C. M., Hall, T., Dillon, K., & Duncan, D. S. (2016). Competing against luck: The story of innovation and customer choice. HarperBusiness. Résumé : Explication de la théorie Jobs to be Done selon laquelle les clients « recrutent » un produit pour accomplir une tâche spécifique, illustrée par des exemples tels que les milk-shakes.
Conway, M. E. (1968). How do committees invent? Datamation, 14(4), 28–31. Résumé : Article présentant la « loi de Conway » selon laquelle la structure d'un système reflète la structure de communication de l'organisation qui l'a conçu.
Cooper, R. G. (1990). Stage-gate systems: A new tool for managing new products. Business Horizons, 33(3), 44–54. Résumé : L'auteur a proposé la méthode stage-gate, qui divise le développement de nouveaux produits en étapes (stages) et en portes de décision (gates), où l'on décide à chaque porte de poursuivre ou d'arrêter le projet.
Cooper, R. G., & Kleinschmidt, E. J. (1987). New products: What separates winners from losers? Journal of Product Innovation Management, 4(3), 169–184. Résumé : En analysant environ 200 nouveaux produits, les auteurs ont montré que la possession d'avantages distinctifs est le facteur qui distingue le plus fortement les succès des échecs.
Cunningham, W. (1992). The WyCash portfolio management system. OOPSLA '92 Addendum to the Proceedings, 29–30. Résumé : Cet article introduit pour la première fois la métaphore de la « dette technique », comparant le code écrit à la hâte à une dette dont les intérêts augmentent si elle n'est pas remboursée.
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. Résumé : L'auteur a proposé le modèle d'acceptation technologique (TAM), qui explique l'acceptation des technologies par les utilisateurs en fonction de l'utilité perçue et de la facilité d'utilisation perçue.
Dell'Acqua, F., McFowland, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2023). Navigating the jagged technological frontier: Field experimental evidence of the effects of AI on knowledge worker productivity and quality (Harvard Business School Working Paper 24-013). Résumé : Une expérience menée avec 758 consultants a révélé une « frontière dentée » : l'IA améliore la qualité sur les tâches qu'elle maîtrise, mais réduit le taux de bonnes réponses sur les tâches qu'elle ne maîtrise pas.
DORA. (2024). Accelerate State of DevOps Report 2024. Google Cloud. Résumé : Une enquête auprès d'environ 39 000 personnes a révélé que l'augmentation de l'utilisation de l'IA était associée à une diminution du débit de 1,5 % et à une diminution de la stabilité de 7,2 %.
DORA. (2025). 2025 DORA Report: State of AI-assisted software development. Google Cloud. Résumé : Une enquête auprès d'environ 5 000 personnes a montré que l'IA améliore le débit tout en augmentant l'instabilité, que l'IA amplifie les forces et les faiblesses organisationnelles, et a identifié sept compétences clés qui déterminent l'efficacité.
Dow, S. P., Glassco, A., Kass, J., Schwarz, M., Schwartz, D. L., & Klemmer, S. R. (2010). Parallel prototyping leads to better design results, more divergence, and increased self-efficacy. ACM Transactions on Computer-Human Interaction, 17(4), Article 18. Résumé : Une expérience a montré que le prototypage parallèle de plusieurs propositions conduit à de meilleurs résultats de conception, à une plus grande diversité d'exploration et à une plus grande confiance en soi qu'une amélioration séquentielle d'une seule proposition.
Dyson, J. (2021). Invention: A life. Simon & Schuster. Résumé : L'autobiographie du fondateur de Dyson, notamment le processus d'achèvement de l'aspirateur cyclonique après 5 127 prototypes.
Edmondson, A. (1999). Psychological safety and learning behavior in work teams. Administrative Science Quarterly, 44(2), 350–383. Résumé : L'auteure a montré que la sécurité psychologique — le fait de ne pas être puni pour avoir signalé des échecs — améliore les comportements d'apprentissage et les performances des équipes.
Ellis, S., & Brown, M. (2017). Hacking growth: How today's fastest-growing companies drive breakout success. Crown Business. Résumé : Cet ouvrage propose qu'un indicateur du PMF soit que plus de 40 % des utilisateurs répondent « très déçu » à la question « Comment vous sentiriez-vous si vous ne pouviez plus utiliser ce produit ? », et explique comment mener les expériences de croissance.
European Parliament and Council. (2024a). Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union. Résumé : Le règlement de l'UE qui classe les systèmes d'IA en fonction de leur degré de risque et impose aux usages à haut risque la documentation, la surveillance humaine et l'assurance de la précision et de la robustesse.
European Parliament and Council. (2024b). Regulation (EU) 2024/2847 on horizontal cybersecurity requirements for products with digital elements (Cyber Resilience Act). Official Journal of the European Union. Résumé : Le règlement de l'UE qui impose aux produits contenant des éléments numériques d'assurer la sécurité dès la phase de conception et de fournir des mises à jour de sécurité après la mise en vente.
European Parliament and Council. (2024c). Directive (EU) 2024/2853 on liability for defective products. Official Journal of the European Union. Résumé : La directive modifiée de l'UE qui étend la responsabilité du fait des produits défectueux aux logiciels et systèmes d'IA, facilitant l'indemnisation des dommages causés par les défauts de produits numériques.
Evanschitzky, H., Eisend, M., Calantone, R. J., & Jiang, Y. (2012). Success factors of product innovation: An updated meta-analysis. Journal of Product Innovation Management, 29(S1), 21–37. Résumé : Les auteurs ont actualisé la méta-analyse de Henard & Szymanski (2001) et confirmé que la supériorité du produit et l'orientation vers le marché restent fortement liées au succès des nouveaux produits.
Everyday Astronaut. (2021). Starbase tour with Elon Musk [Part 1] [Video]. YouTube. Résumé : Entretien dans lequel Musk explique les cinq étapes du processus de conception et de fabrication : remettre en question les exigences, éliminer, simplifier, accélérer et automatiser.
Eyal, N. (2014). Hooked: How to build habit-forming products. Portfolio. Résumé : L'ouvrage présente un modèle montrant que les habitudes se forment dans une boucle en quatre étapes — déclencheur, action, récompense et investissement — et aborde aussi son utilisation éthique.
Fadell, T. (2022). Build: An unorthodox guide to making things worth making. Harper Business. Résumé : L'auteur, qui a créé l'iPod et Nest, explique que le matériel se perfectionne en trois générations, détaille le processus de prototypage et de validation par étapes (EVT, DVT, PVT) et la constitution des équipes.
First Round Review. (2015). From 0 to $1B: Slack's founder shares their epic launch strategy. First Round Review. Résumé : Article où le fondateur de Slack, Butterfield, explique le critère selon lequel le produit s'enracine lorsque l'équipe échange 2 000 messages, et décrit la stratégie de lancement initiale.
Fitzpatrick, R. (2013). The mom test: How to talk to customers and learn if your business is a good idea when everyone is lying to you. CreateSpace. Résumé : Ouvrage pratique établissant le principe de poser aux clients des questions sur des comportements passés concrets plutôt que sur leurs opinions ou promesses futures.
Fogg, B. J. (2009). A behavior model for persuasive design. Proceedings of the 4th International Conference on Persuasive Technology, Article 40. Résumé : L'auteur propose le modèle comportemental de Fogg, selon lequel le comportement se produit quand trois éléments sont simultanément réunis : la motivation, la capacité et le déclencheur.
Forsgren, N., Humble, J., & Kim, G. (2018). Accelerate: The science of lean software and DevOps. IT Revolution. Résumé : Les auteurs montrent, sur la base d'années de recherche, que quatre indicateurs — la fréquence de déploiement, le délai de mise en œuvre des changements, le taux d'échec des changements et le temps de récupération — sont liés à la performance du développement logiciel et aux résultats organisationnels.
Forsgren, N., Storey, M.-A., Maddila, C., Zimmermann, T., Houck, B., & Butler, J. (2021). The SPACE of developer productivity: There's more to it than you think. ACM Queue, 19(1), 20–48. Résumé : Les auteurs proposent le cadre SPACE, qui appréhende la productivité des développeurs selon cinq dimensions : satisfaction, performance, activité, communication et efficacité.
Fowler, M. (2018). Refactoring: Improving the design of existing code (2nd ed.). Addison-Wesley. Résumé : Ouvrage qui catalogue les techniques de refactorisation, c'est-à-dire l'amélioration de la structure interne du code sans modifier son comportement observable de l'extérieur.
Garvin, D. A. (1987). Competing on the eight dimensions of quality. Harvard Business Review, 65(6), 101–109. Résumé : L'auteur divise la qualité des produits en huit dimensions (performance, fonctionnalités additionnelles, fiabilité, conformité, durabilité, maintenabilité, esthétique, qualité perçue) et soutient qu'il faut choisir sur lesquelles concourir.
Google. (n.d.). Ten things we know to be true. https://about.google/philosophy/ Résumé : Les dix principes de Google, dont le premier est « concentrez-vous sur l'utilisateur et le reste suivra naturellement ».
Graham, P. (2013). Do things that don't scale. http://paulgraham.com/ds.html Résumé : Un essai arguant que les startups à leurs débuts devraient intentionnellement faire des choses qui ne sont pas à l'échelle, comme acquérir et soutenir manuellement les clients.
Graham, P. (2024). Founder mode. http://paulgraham.com/foundermode.html Résumé : Un essai présentant le « founder mode » où le fondateur s'implique directement dans les détails, par opposition au « manager mode » qui valorise la délégation.
Henard, D. H., & Szymanski, D. M. (2001). Why some new products are more successful than others. Journal of Marketing Research, 38(3), 362–375. Résumé : Une méta-analyse de soixante études empiriques montrant que la supériorité du produit, le potentiel du marché, la satisfaction des besoins des clients, la planification préalable au développement et l'allocation de ressources de développement sont systématiquement liés au succès des nouveaux produits.
Hoffman, R., & Yeh, C. (2018). Blitzscaling: The lightning-fast path to building massively valuable companies. Currency. Résumé : Un ouvrage exposant la stratégie de croissance rapide et l'approche consistant à lancer rapidement un produit imparfait, contenant la formule « si vous ne trouvez pas honteux de votre première version, vous l'avez lancée trop tard ».
Horowitz, B. (2014). The hard thing about hard things: Building a business when there are no easy answers. HarperBusiness. Résumé : Un ouvrage qui reproduit le mémorandum interne de 1996 « Good Product Manager/Bad Product Manager » et positionne le gestionnaire de produit comme le PDG du produit.
Husain, H. (2024). Your AI product needs evals. https://hamel.dev/blog/posts/evals/ Résumé : Un article de praticien arguant que l'amélioration des produits d'IA nécessite un système d'évaluation fondé sur des données réelles et expliquant comment construire ce système d'évaluation.
ISO. (2018). ISO 9241-11:2018 Ergonomics of human-system interaction — Part 11: Usability: Definitions and concepts. International Organization for Standardization. Résumé : Une norme internationale définissant l'utilisabilité comme le degré auquel des utilisateurs spécifiques peuvent atteindre des objectifs spécifiques de manière efficace, efficiente et satisfaisante.
ISO. (2019). ISO 9241-210:2019 Ergonomics of human-system interaction — Part 210: Human-centred design for interactive systems. International Organization for Standardization. Résumé : Une norme internationale prescrivant un processus de conception centrée sur l'humain fondé sur les principes suivants : compréhension des utilisateurs et du contexte, participation des utilisateurs et évaluation itérative.
ISO/IEC. (2023). ISO/IEC 25010:2023 Systems and software engineering — Systems and software Quality Requirements and Evaluation (SQuaRE) — Product quality model. International Organization for Standardization. Résumé : Une norme internationale définissant la qualité des produits logiciels par neuf caractéristiques : aptitude fonctionnelle, efficacité des performances, compatibilité, interopérabilité, fiabilité, sécurité, maintenabilité, flexibilité et sûreté.
Jobs, S. (1997). Closing keynote Q&A at the 1997 Worldwide Developers Conference. Apple. Résumé : Une session de questions-réponses où l'orateur a déclaré « il faut commencer par l'expérience du client et remonter jusqu'à la technologie ».
Jobs, S. (1998). Steve Jobs: "There's sanity returning" [Interview]. BusinessWeek. Résumé : Une interview où l'orateur a affirmé « souvent, les gens ne savent pas ce qu'ils veulent avant qu'on le leur montre » et a discuté d'une approche au développement de produits qui ne repose pas sur les études clients.
Karpathy, A. (2017). Software 2.0. Medium. Résumé : Un article proposant le concept de « Software 2.0 » où le code écrit par l'humain est remplacé par les poids des modèles appris, arguant que le travail des développeurs se déplace vers la préparation des données.
Keiningham, T. L., Cooil, B., Andreassen, T. W., & Aksoy, L. (2007). A longitudinal examination of net promoter and firm revenue growth. Journal of Marketing, 71(3), 39–51. Résumé : Une étude qui teste l'affirmation selon laquelle le NPS surpasse les autres indicateurs clients pour prédire la croissance et rapporte qu'aucune supériorité n'a pu être établie.
Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. Résumé : Un ouvrage expliquant la conception des tests A/B à grande échelle et leurs pièges, rapportant que seule une fraction des initiatives d'amélioration produisent des résultats positifs.
Krug, S. (2014). Don't make me think, revisited: A common sense approach to web usability (3rd ed.). New Riders. Résumé : Un manuel pratique d'utilisabilité du web et des applications établissant comme principe premier de ne pas faire penser l'utilisateur.
Kurosu, M., & Kashimura, K. (1995). Apparent usability vs. inherent usability: Experimental analysis on the determinants of the apparent usability. CHI '95 Conference Companion on Human Factors in Computing Systems, 292–293. Résumé : Une étude montrant que, dans des écrans de distributeur automatique de billets, l'évaluation de l'esthétique et celle de la facilité d'utilisation sont fortement corrélées.
Levitt, T. (1980). Marketing success through differentiation—of anything. Harvard Business Review, 58(1), 83–91. Résumé : L'auteur conçoit la valeur d'un produit en couches (produit essentiel, produit attendu, produit augmenté, produit potentiel) et soutient que la différenciation se produit au niveau du produit augmenté.
Liker, J. K. (2004). The Toyota way: 14 management principles from the world's greatest manufacturer. McGraw-Hill. Résumé : Un ouvrage expliquant les quatorze principes de gestion de Toyota, dont la pratique du genba (vérifier les faits sur le terrain).
Mathur, A., Acar, G., Friedman, M. J., Lucherini, E., Mayer, J., Chetty, M., & Narayanan, A. (2019). Dark patterns at scale: Findings from a crawl of 11K shopping websites. Proceedings of the ACM on Human-Computer Interaction, 3(CSCW), Article 81. Résumé : Une analyse automatisée d'environ onze mille sites marchands rapportant que quelque 11% contiennent des motifs trompeurs destinés à induire l'utilisateur en erreur.
McClure, D. (2007). Startup metrics for pirates: AARRR! 500 Hats. Résumé : Une présentation proposant le cadre AARRR qui organise les indicateurs des startups en cinq étapes : acquisition, activation, rétention, recommandation et revenu.
METR. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. Model Evaluation & Threat Research. Résumé : Un essai randomisé contrôlé auprès de seize développeurs open-source expérimentés rapportant que l'utilisation d'outils d'IA a augmenté le temps de travail de 19% en moyenne, tandis que les développeurs percevaient une amélioration de la vitesse.
Moore, G. A. (1991). Crossing the chasm: Marketing and selling high-tech products to mainstream customers. HarperBusiness. Résumé : Un ouvrage soutenant que pour franchir le fossé entre les adopteurs précoces et le marché grand public, il faut proposer un « produit complet » comportant tous les éléments attendus par les clients.
Nielsen, J. (1993). Response times: The 3 important limits. Nielsen Norman Group. https://www.nngroup.com/articles/response-times-3-important-limits/ Résumé : L'auteur identifie trois seuils critiques de perception du temps de réponse : 0,1 seconde (ressenti comme instantané), 1 seconde (le flux de pensée n'est pas interrompu) et 10 secondes (limite de maintien de l'attention).
Nielsen, J. (1994). Enhancing the explanatory power of usability heuristics. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 152–158. Résumé : L'auteur organise dix heuristiques (visibilité de l'état du système, prévention des erreurs, etc.) pour l'évaluation de l'utilisabilité.
Nielsen, J. (2000). Why you only need to test with 5 users. Nielsen Norman Group. Résumé : Article arguant que la majorité des problèmes d'utilisabilité peuvent être identifiés avec 5 utilisateurs, et qu'il est plus efficace de répéter les tests avec un petit nombre de participants.
NIST. (2022). Secure Software Development Framework (SSDF) version 1.1 (NIST SP 800-218). National Institute of Standards and Technology. Résumé : Un cadre pour intégrer les pratiques de sécurité à chaque étape du développement logiciel.
NIST. (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0). National Institute of Standards and Technology. Résumé : Cadre facultatif traitant les risques de l'IA par quatre fonctions : gouvernance, cartographie, mesure et gestion.
Norman, D. A. (2004). Emotional design: Why we love (or hate) everyday things. Basic Books. Résumé : Ouvrage analysant comment le design affecte les émotions selon trois niveaux : instinctif, comportemental et réflexif.
Norman, D. A. (2013). The design of everyday things (Revised and expanded ed.). Basic Books. Résumé : Édition révisée de ce classique présentant les principes du design où l'utilisation est évidente, incluant l'affordance, les signifiants et le feedback.
Nygard, M. T. (2018). Release it! Design and deploy production-ready software (2nd ed.). Pragmatic Bookshelf. Résumé : Ouvrage synthétisant les modèles de conception qui permettent au logiciel de rester fonctionnel en production en confinant les défaillances, comme les timeouts, les disjoncteurs et les cloisons.
Olsen, D. (2015). The lean product playbook: How to innovate with minimum viable products and rapid customer feedback. Wiley. Résumé : Ouvrage présentant le PMF à travers une pyramide en cinq couches (marché, clients, problèmes, proposition de valeur, fonctionnalités, UX) et expliquant comment l'atteindre.
OWASP. (2021). OWASP Top 10: 2021. Open Worldwide Application Security Project. Résumé : Recueil des dix risques de sécurité les plus critiques pour les applications web, incluant les défauts de contrôle d'accès, les défaillances cryptographiques et les injections.
PAIR. (2019). People + AI guidebook. Google. Résumé : Guide de Google pour concevoir des produits IA centrés sur l'humain, couvrant la définition des besoins des utilisateurs, la collecte de données, l'étalonnage de la confiance et la gestion des erreurs.
Parnas, D. L. (1972). On the criteria to be used in decomposing systems into modules. Communications of the ACM, 15(12), 1053–1058. Résumé : Article proposant le « masquage de l'information » comme critère de décomposition modulaire, en dissimulant les décisions de conception susceptibles de changer à l'intérieur des modules.
Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The impact of AI on developer productivity: Evidence from GitHub Copilot. arXiv. https://arxiv.org/abs/2302.06590 Résumé : Expérience randomisée sur des tâches de programmation montrant que les utilisateurs d'assistance IA les complètent 55,8 % plus rapidement.
Reichheld, F. F. (2003). The one number you need to grow. Harvard Business Review, 81(12), 46–54. Résumé : Article présentant le Net Promoter Score (NPS), mesuré par une seule question sur la probabilité de recommander un produit à des amis ou collègues, et démontrant sa corrélation avec la croissance.
Ries, E. (2011). The lean startup: How today's entrepreneurs use continuous innovation to create radically successful businesses. Crown Business. Résumé : Ouvrage présentant la boucle « construire, mesurer, apprendre » pour valider les hypothèses avec des prototypes minimaux (MVP).
Rodden, K., Hutchinson, H., & Fu, X. (2010). Measuring the user experience on a large scale: User-centered metrics for web applications. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 2395–2398. Résumé : Article introduisant le cadre HEART de Google pour mesurer l'expérience utilisateur selon cinq dimensions : bonheur, engagement, rétention, accomplissement des tâches et croissance.
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. Résumé : Ouvrage présentant cinq attributs déterminant la vitesse de diffusion d'une innovation : l'avantage relatif, la compatibilité, la complexité, l'essayabilité et l'observabilité.
Rozovsky, J. (2015). The five keys to a successful Google team. Google re:Work. Résumé : Explication d'une recherche interne montrant que parmi 180 équipes chez Google, la sécurité psychologique était le facteur prédisant le plus fortement l'efficacité d'une équipe.
Sauro, J., & Lewis, J. R. (2016). Quantifying the user experience: Practical statistics for user research (2nd ed.). Morgan Kaufmann. Résumé : Ouvrage synthétisant le traitement statistique des enquêtes utilisateur, incluant le fait que la moyenne du SUS est de 68 points.
Serrador, P., & Pinto, J. K. (2015). Does Agile work? A quantitative analysis of agile project success. International Journal of Project Management, 33(5), 1040–1051. Résumé : Analyse de 1 002 projets montrant que le degré d'adoption agile est positivement corrélé à l'efficacité du projet et à la satisfaction des parties prenantes.
Shepherd, D. A., & Gruber, M. (2021). The lean startup framework: Closing the academic–practitioner gap. Entrepreneurship Theory and Practice, 45(5), 967–998. Résumé : Revue synthétique mettant en correspondance les éléments du cadre du lean startup avec la recherche existante et clarifiaut ce qui est empiriquement prouvé et ce qui reste à valider.
Singer, R. (2019). Shape Up: Stop running in circles and ship work that matters. Basecamp. Résumé : Ouvrage décrivant la méthode de développement de Basecamp, qui délimite le travail pour tenir dans des cycles fixes de 6 semaines et le confie à des équipes dédiées.
Skok, D. (2013). SaaS metrics 2.0: A guide to measuring and improving what matters. For Entrepreneurs. Résumé : Guide pratique présentant les repères pour les indicateurs SaaS, comme un ratio LTV/CAC supérieur à 3 et une période de récupération du CAC inférieure à 12 mois.
Stanford HAI. (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence. Résumé : Rapport annuel synthétisant les tendances technologiques, économiques et politiques de l'IA, pointant que de nombreux benchmarks publics saturent et que le fossé avec les problèmes réels s'élargit.
Taguchi, G. (1986). Introduction to quality engineering: Designing quality into products and processes. Asian Productivity Organization. Résumé : Ouvrage exposant le design robuste, où la performance reste inchangée face aux variations de fabrication, et l'ingénierie de la qualité basée sur une fonction de perte.
Thomke, S., & Fujimoto, T. (2000). The effect of "front-loading" problem-solving on product development performance. Journal of Product Innovation Management, 17(2), 128–142. Résumé : Article démontrant sur l'exemple de Toyota que l'avancement de la découverte et de la résolution de problèmes au début du développement améliore le délai et la qualité.
Thompson, D. V., Hamilton, R. W., & Rust, R. T. (2005). Feature fatigue: When product capabilities become too much of a good thing. Journal of Marketing Research, 42(4), 431–442. Résumé : Article montrant expérimentalement que bien que les consommateurs choisissent des produits plus riches en fonctionnalités avant l'achat, leur satisfaction diminue après l'utilisation (« fatigue fonctionnelle »).
Torres, T. (2021). Continuous discovery habits: Discover products that create customer value and business value. Product Talk. Résumé : Ouvrage proposant que le trio produit rencontre les clients chaque semaine et organise les hypothèses avec un arbre des opportunités et des solutions pour maintenir une découverte continue.
Tractinsky, N., Katz, A. S., & Ikar, D. (2000). What is beautiful is usable. Interacting with Computers, 13(2), 127–145. Résumé : Réplication de Kurosu & Kashimura (1995) confirmant que les écrans beaux sont perçus comme plus faciles à utiliser même quand la facilité d'utilisation réelle est identique.
Ulrich, K. T., Eppinger, S. D., & Yang, M. C. (2020). Product design and development (7th ed.). McGraw-Hill. Aperçu : Manuel de référence qui systématise le processus de développement de produits, en particulier matériels, du développement conceptuel à la fabrication.
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425–478. Aperçu : Propose l'UTAUT qui unifie les théories de l'acceptation technologique et rapporte que l'espérance de performance, l'espérance d'effort, l'influence sociale et les conditions facilitantes expliquent environ 70 % de la variance des intentions d'utilisation.
Vitsœ. (n.d.). The power of good design: Dieter Rams's ideology, engrained within Vitsœ. https://www.vitsoe.com/gb/about/good-design Aperçu : Explication officielle des « 10 principes du bon design » de Dieter Rams.
Vohra, R. (2018). How Superhuman built an engine to find product market fit. First Round Review. Aperçu : Article révélant la procédure de Superhuman qui a augmenté la proportion « extrêmement décevant » de 22 % à 58 %.
W3C. (2023). Web Content Accessibility Guidelines (WCAG) 2.2. World Wide Web Consortium. Aperçu : Recommandation établissant les critères d'accessibilité du contenu web selon quatre principes : perceptible, utilisable, compréhensible et robuste.
Walton, P. (2020). Web Vitals. web.dev. https://web.dev/articles/vitals Aperçu : Définit LCP, INP et CLS comme métriques essentielles pour mesurer l'expérience utilisateur sur le web, avec pour critères de « bon » respectivement 2,5 secondes, 200 millisecondes et 0,1 ou moins.
WebAIM. (2024). The WebAIM Million: The 2024 report on the accessibility of the top 1,000,000 home pages. https://webaim.org/projects/million/ Aperçu : Rapport d'inspection automatisée des pages d'accueil des 1 million de sites les plus visités, révélant que 95,9 % présentent des violations des WCAG.
Witell, L., Löfgren, M., & Dahlgaard, J. J. (2013). Theory of attractive quality and the Kano methodology – the past, present, and future. Total Quality Management & Business Excellence, 24(11–12), 1241–1252. Aperçu : Synthèse de 30 ans de recherche sur le modèle de Kano, documentant notamment la transition temporelle des qualités attractives vers les qualités indifférentes.
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, 36. Aperçu : Démontre que l'utilisation de puissants modèles de langage comme évaluateurs concorde avec les évaluateurs humains dans environ 80 % des cas, un taux équivalent à l'accord entre humains.
狩野紀昭・瀬楽信彦・高橋文夫・辻新一(1984).魅力的品質と当り前品質.品質, 14(2),147–156.Aperçu : Article fondateur proposant le modèle de Kano distinguant les qualités indifférentes, les qualités linéaires et les qualités attractives.