
Articles
AI的可解释性:历史、方法及其在建筑图纸审查中的应用
Product
Career
本文由日语原文自动翻译而成
引言 ── AI真的在"理解"吗
在现代AI发展中,深度学习的突飞猛进并非源于单一因素。模型、数据和计算能力等多个要素同时成熟,才形成了重大转折点。
在1990年代,由Yann LeCun等人提出的卷积神经网络(即LeNet)在手写数字识别和文档识别领域展现了出色性能。随后,Geoffrey Hinton等研究人员进一步推进了深度学习研究。同时,GPU并行计算的发展使大规模矩阵运算得以实际执行。此外,由Fei-Fei Li团队推动的ImageNet大规模图像数据集,使AI能够利用大量真实图像进行学习,并进行性能比较和竞争。2012年,由Alex Krizhevsky、Ilya Sutskever和Geoffrey Hinton开发的AlexNet在ImageNet图像识别任务中取得重大成就,现代深度学习从此获得广泛关注。
但这里产生了一个重要问题。向模型输入图像,它会以高精度输出识别结果。表面上看,AI确实"得到了正确答案"。然而,我们是否真正理解AI为什么给出这个答案呢?
当AI识别一只猫时,它是否真的理解了猫的眼睛、耳朵、轮廓和身体结构?还是只是记住了训练数据中存在的统计规律?在医疗图像风险判断中,AI是否真的在观察病变?还是对图像中的水印、设备特性、医院标记等本不应注意的信息作出反应?这类似于一个人看过一万次苹果从树上掉落,因而能够正确预测"苹果会向下掉落",但这不代表他真正理解了重力的情况。
在自动驾驶、医疗诊断、建筑图纸审查、金融风险管理等高风险领域,这个问题尤为重要。这些领域中AI的错误不仅仅是练习题答错一题,而是直接关系到安全、责任、成本和信任。因此,可解释性不仅仅是"有就更方便的技术"。它是AI从"能输出结果的存在"进化为"人类能理解、验证、信任和管理的存在"所必需的关键要素。
执行摘要
AI可解释性简单地说,不是让AI"说得更好"。而是让人类能够理解AI为什么做出该判断、看到了什么、忽略了什么、存在哪些不确定性,以及问题出现时如何追踪。
近年这个话题变得重要的原因,不仅仅是"讨厌黑箱"。法规要求、客户信任、质量审计、安全责任、跨部门协作等,都在强烈要求AI从"仅输出答案"阶段过渡到"同时输出答案和依据"阶段。欧盟AI法案要求高风险AI系统提供技术文档、自动日志、透明度和人工监督。中国的算法推荐服务管理规定和生成式AI服务管理暂行办法也要求公开和说明算法的基本原理、目的和主要运作机制。NIST也将"不可见性·难以把握"列为AI风险的重要原因之一。
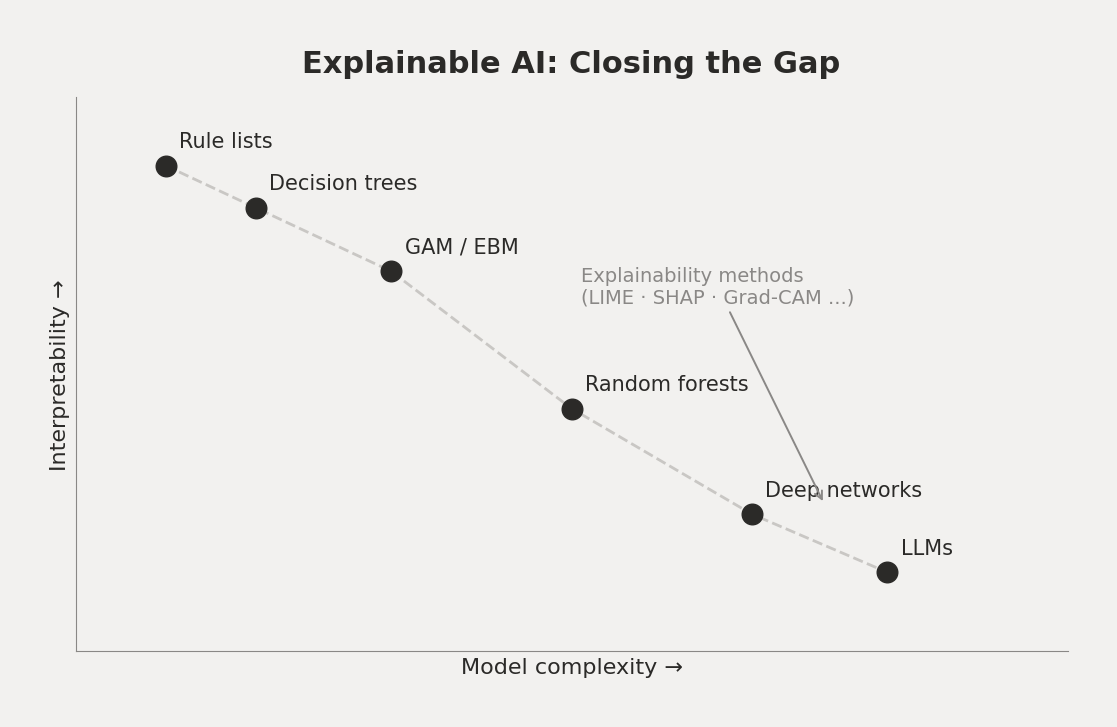
从研究历史来看,早期AI以规则、决策树和专家系统为中心,模型本身相对容易理解。但深度学习的兴起在迅速提高精度的同时,大大降低了模型的可读性。结果在2010年代后期出现了热力图、LIME、SHAP、Grad-CAM、反事实解释等"给黑箱附上说明书"的方法。进入大语言模型时代后,研究分为两个方向:外部解释方向(提供依据、检索证据、结构化输出)和内部解释方向(神经元解释、稀疏特征、电路追踪、机械可解释性)。
对于建筑图纸审查AI代理而言,可解释性不仅是学术附加价值,更是实实在在的生产力提升工具。建筑审查规则众多、责任范围明确、对误检和漏检都很敏感。将AI输出从单纯的风险评分变为结论+图纸位置+条文依据+审计日志+人工确认入口的多层证据包,更适合实际运营。
为什么公司全体都需要理解AI可解释性
从最现实的角度来说,解释不是装饰,而是风险管理。DARPA的XAI项目将"使人类能理解AI、恰当地信任AI、有效地管理AI"列为主要目标。美国国家标准与技术研究院(NIST)也指出,AI的"难以把握"使风险测量和风险管理变得困难。换句话说,解释"不是为了好看",而是让组织能够真正管理AI、履行问责责任所必需的流程组成部分。
从信任的角度看,真正重要的不是"让人更相信AI",而是"让人恰当地相信AI"。缺乏解释时,人们容易陷入两个极端:一是因为AI看起来聪明就过度依赖;二是因为不理解AI的运作原理就完全不使用。XAI研究和人机协作文献中经常强调"appropriate reliance",即在应该信任的时候信任,在应该怀疑的时候怀疑的状态。但是,添加解释不一定能改善决策。因此,企业需要将解释设计为"调整信任的机制",而非"让人相信AI的说辞"。
从安全角度看,解释有助于发现模型学到的"奇怪捷径"。许多模型在训练中会学到水印、标题栏、扫描噪声、页框等与任务本无关但恰好相关的信号。在建筑图纸中,存在布局差异、扫描质量、印章、修正云、比例标注、多页拼接等容易让模型混淆的要素,这个问题尤为重要。
从生产力角度看,可解释性也常被低估。如果AI图纸审查结果能同时显示热力图、条文、尺寸依据和"为什么判断符合该规则",那它就不仅是判定器,还成了对新手的OJT教材。在审计或跨部门协作中,如果一个结论能展开成"相关位置、提取尺寸、对应条文、类似历史案例、模型版本、人工确认建议",讨论就能从抽象担忧转向具体证据。
历史与发展脉络
AI可解释性的历史,可以理解为随着模型变得更强大,解释手段随后被加强的历史。
| 时期 | 发生了什么 | 对可解释性的意义 |
|---|---|---|
| 早期规则·树模型时代 | 以专家系统、基于规则、决策树等为中心。具有if-then结构,模型本身可读 | 解释主要是"阅读模型本身" |
| 深度学习导致的黑箱化 | 深层网络在视觉任务中大幅发展,出现了梯度显著图、特征可视化等理解CNN的研究 | 解释从"阅读规则"转向"对黑箱进行可视化健康诊断" |
| XAI的体系化 | DARPA XAI提出在保持高性能的同时创建可解释模型,LIME、SHAP、Integrated Gradients、Grad-CAM等成为主流 | 可解释性成为独立研究领域 |
| 忠实性与评估时代 | 意识到"看起来像解释"和"真正在解释"是不同的,提出了sanity check、infidelity、sensitivity等评估方法 | 解释本身也成为需要检查的对象 |
| LLM与机械可解释性时代 | 随着Transformer和LLM的发展,追踪注意、神经元、稀疏特征、内部电路的研究不断进展(Anthropic、OpenAI) | 解释扩展到"模型内部发生了什么" |
简言之,早期AI是透明的机器,深度学习是高性能的黑箱,随后是给黑箱装上仪表板和行车记录仪的阶段,而今天的前沿是试图打开引擎内部的阶段。理解这个流程后,企业实施中最现实的方针也就浮现出来了。与其试图一下子完全看透大型模型,不如先从装好仪表板、证据链和人工确认界面入手,这样更容易直接产生商业价值。
方法全景
严格来说,interpretability(可解释性)接近于"模型本身容易理解",explainability(说明性)接近于"即使模型本身复杂,也能通过附加手段向人类说明"。在实务中,与其纠缠于用语,不如明确是想让模型本体透明,还是想让结果可验证更重要。
事前可解释性
事前可解释性也称"内在可解释性"或"白箱方法",是指在设计模型阶段就选择人类容易理解的结构。决策树、规则列表、线性模型是典型例子。之后,作为在保持性能的同时保留可读性的方法,还提出了广义加法模型、GA2M、可解释增强机(EBM)等。决策树特别易于解释,诸如"楼梯有效宽度低于一定值,且该区域为疏散通道,则检测风险"这样的规则,建筑实务人员能直观理解。
另一个重要方向是约束学习。在训练时加入稀疏性、单调性、稳定性等约束,或采用自解释神经网络的方法,在模型结构中明确体现"概念·贡献·结论"的关系。此时解释不是事后附加,而成为学习过程本身的一部分。
事后可解释性
事后可解释性是指直接使用已训练的模型,在其输出周围构建解释支架的方法。局部解释回答"为什么这张图纸得到这个结果",全局解释回答"该模型通常根据什么线索做判断"。
| 方法 | 举例 | 优势 | 局限 | 在建筑图纸审查中的直接价值 |
|---|---|---|---|---|
| 决策树/规则列表 | 透明流程图 | 易于审计,适合教育和合规讨论 | 对复杂模式表达能力弱 | 明示规则审查、高频简单条文检查 |
| EBM/GA2M | 可读的分项评分 | 部分任务中性能与易理解性并存 | 不适合所有复杂任务 | 表格式、结构化审查特征 |
| LIME | 邻域小教师 | 模型无关,便于单结果解释 | 采样可能导致不稳定 | 特定图纸误检解释 |
| SHAP | 公平的贡献度分配 | 能同时查看局部和全局 | 计算和解释需要经验 | 特征贡献分析、版本比较 |
| 反事实 | 修改建议书 | 易与行动挂钩 | 需考虑实际是否可改 | "如何修改才能通过"的建议 |
| Deep Unrolling | 工匠迭代步骤固定为工程流程 | 强大快速,比纯黑箱更易解释 | 不是所有任务都适用 | 图像复原、图纸矢量化、测量类子模块 |
LIME通过在某个样本附近创建许多类似的样本,训练一个小型代理模型来解释该邻域,就像一个"只教你该样本附近情况的小老师"。SHAP使用博弈论中的Shapley值概念来分配每个特征对结果的贡献度。但由于贡献值本身并非因果关系,解释时需要谨慎。反事实解释展示了"如果情况略有不同,会发生什么",在图纸审查中可以表现为类似改进建议的形式,例如"如果这扇门的宽度是900毫米而不是850毫米,且疏散方向箭头得到补全,则该项目很可能通过"。
图像模型中的可解释性
热力图是最容易解释的概念。本质上是"影响度地图",就像在原始图像上叠加半透明的温度膜,显示模型关注的位置。显著图、Grad-CAM、Integrated Gradients和LRP等虽然计算方法不同,但通常以这种形式进行可视化。
但热力图既容易解释,也容易被误解。热力图既不是法律依据,也不是因果证明,更不是模型思维过程的直接录像。它只是显示在本次判断中哪些区域可能成为关键线索的指示。如果模型说"这里有疏散相关的问题",热力图应集中在楼梯间、门、尺寸注记和轴线关系等处。反之,如果标题栏、图框和水印等亮度很高,可能表明模型学到了不应该学习的捷径。
图像解释中非常重要的一个角度是对抗样本。仅在输入中添加人眼几乎看不见的微小扰动,模型就可能以高确信度进行误分类。这表明模型可能学到了对人类来说不自然但有助于预测的"非鲁棒特征"。图纸扫描、缩放、压缩、局部遮挡、印章和修订符号等对模型来说可能是微小但致命的输入变化,因此在图纸AI中必须同时考虑可解释性和鲁棒性。
大规模语言模型(LLM)中的可解释性
Transformer核心的注意机制是考虑LLM可解释性的最自然入口之一。BertViz等工具可以可视化不同层、不同头和不同令牌之间的注意关系。但注意本身并不是解释。注意分布并不总是忠实地显示模型真正依赖的依据。
大规模语言模型时代最常见的"解释"之一是思维链,即让模型写出推理步骤。但模型写出的步骤不一定与模型内部实际发挥作用的推理链相符。因此,在企业实施中不应仅仅依赖于让LLM"写出更详细的原因"来实现可解释性。更稳妥的方法是将可解释性与外部证据结合起来,例如RAG、结构化输出、工具调用、来源引用、页码和条款编号等。图纸审查中大规模语言模型最好的解释不是"为什么我这样认为"的独白,而是"引用了哪些规范、查看了图纸上的什么位置、提取了什么数值、应该如何验证"。
近年来,LLM可解释性的前沿正在向机械可解释性发展。Anthropic发布了使用稀疏自编码器从Claude 3 Sonnet的激活中提取更单义特征的研究。OpenAI也进行了使用GPT-4为GPT-2神经元自动添加解释的研究。LLM可解释性正从"使结果可读"的阶段发展到"检查机制、控制行为、定位问题"的阶段。
评估、权衡和局限
可解释性中最难的问题是如何定义什么是好的解释。从实践角度看,将解释评估分解为以下观点会更容易理解。
| 评估维度 | 常见问题 | 代表性方法 |
|---|---|---|
| 忠实性 | 解释是否反映了模型真正依赖的依据 | Infidelity、Sensitivity、Deletion/Insertion、Sanity Checks |
| 有用性 | 人查看时是否能更快、更准确地理解、确认和修正 | 用户实验、决策精度、确认时间 |
| 鲁棒性 | 输入略有变化时解释是否会改变 | 扰动测试、随机化测试、版本比较 |
| 可行动性 | 能否将解释转化为具体的修改建议 | 反事实解释、规则对齐、证据卡片 |
| 合规性 | 解释是否可用于记录、回顾和问责 | 日志完整性、来源追踪、人工确认流程 |
人们经常说"精度和可解释性必然存在权衡",但严格来说并不总是如此。EBM和GA2M的研究表明,在某些任务中可解释模型可以实现非常高的性能。现实中真正重要的是,哪种解释对哪个用户在哪个任务中有用。成熟的业务级可解释性系统至少需要遵守三个原则:"忠实(不误导)""有用(有助于判断、确认和改进)"和"可追踪(能追溯责任和依据)"。
建筑图纸审查AI的实施建议与未来展望
最想推荐的是从一开始不是制作"华丽的解释",而是建立图纸审查的证据链。换句话说,确保每次AI输出至少包含以下五层。
结论
图纸上的位置
规范和条款依据
不确定性
日志和人工确认路径
例如,AI在平面图上提示"疏散门有效宽度可能不足"。有用的解释不仅需要显示一句话。应同时显示门的位置、模型关注的尺寸注记、通过OCR或图形分析提取的有效宽度、相关规范条款、条款版本和页码,以及"如果将该宽度调整到一定值以上,可能会通过"这样的反事实修改建议。这样的输出对审查者来说是确认卡,对客户来说是解释卡,对产品和算法团队来说是学习数据。
相反,如果模型误认标题栏中的过去修改说明为当前页的规范描述,或将印章、水印和修正云误认为结构构件,系统不应该无声地得出结论,而应该检测到"解释异常"。监测热力图集中在非设计区域而不是设计区域、视觉证据与条款证据不一致、重要尺寸缺失但置信度过高等"解释与结论的不一致",可能比简单的精度监测更早发现问题。
在今后数年,AI可解释性可能将同时朝四个方向发展。第一是可验证AI(对关键属性的形式化保证);第二是可解释性标准化(模型卡、解释卡、日志规范);第三是可解释性自动化(条款证据卡的自动生成、不自然的高置信度自动检测);第四是可解释性与隐私安全的相互作用(分层解释)。
最明确的建议是将可解释性定义为产品能力而不是算法的附属品。在建筑图纸审查的场景中,最终获胜的不是最擅长出分的模型,而是最能有效组织结论、证据、规范和人工确认的系统。从这个意义上讲,可解释性不是额外成本,而是产品的竞争壁垒。
已读
接下来阅读 ↓