
Articles
Explicabilidad de IA: historia, métodos e implementación en auditoría de planos arquitectónicos
Product
Career
Esta es una traducción automática del texto original en japonés
Introducción ── ¿Realmente "entiende" la IA?
En el desarrollo de la IA moderna, el rápido avance del aprendizaje profundo no se produjo por una única causa. El cambio significativo surgió cuando múltiples elementos —modelo, datos y capacidad computacional— maduraron simultáneamente.
En la década de 1990, la red neuronal convolucional propuesta por Yann LeCun y otros, conocida como LeNet, demostró un alto rendimiento en reconocimiento de dígitos manuscritos y reconocimiento de documentos. Posteriormente, investigadores como Geoffrey Hinton impulsaron aún más el desarrollo de la investigación en aprendizaje profundo. Además, con el avance del cálculo paralelo mediante GPU, la realización de operaciones matriciales a gran escala se volvió prácticamente viable. Adicionalmente, ImageNet, un gran conjunto de datos de imágenes impulsado por el equipo de Fei-Fei Li, permitió a la IA aprender utilizando una gran cantidad de imágenes reales y comparar y competir en rendimiento. Entonces, en 2012, AlexNet de Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton logró grandes resultados en la tarea de reconocimiento de imágenes de ImageNet, y el aprendizaje profundo moderno comenzó a recibir una atención seria.
Sin embargo, aquí surge una pregunta importante. Cuando ingresamos una imagen en el modelo, produce resultados de reconocimiento con alta precisión. A primera vista, parece que la IA realmente "tiene la respuesta correcta". Pero, ¿realmente entendemos por qué la IA llegó a esa conclusión?
Cuando la IA reconoce un gato, ¿realmente entiende los ojos, las orejas, el contorno y la estructura corporal del gato? ¿O simplemente está memorizando patrones estadísticos en los datos de entrenamiento? Cuando determina el riesgo en imágenes médicas, ¿la IA realmente está viendo la lesión? ¿O podría estar reaccionando a información que no debería ver, como marcas de agua, peculiaridades del equipo de imagen, marcas específicas del hospital? Esto es similar a una situación donde una persona ve caer una manzana de un árbol diez mil veces y logra predecir correctamente que "la manzana cae hacia abajo", pero eso no significa que realmente entienda la gravedad.
En dominios de alto riesgo como conducción autónoma, diagnóstico médico, revisión de planos de arquitectura y gestión de riesgos financieros, este problema es especialmente crítico. En estos campos, un error de la IA no es simplemente responder incorrectamente a un problema de práctica, sino que afecta directamente a la seguridad, la responsabilidad, los costos y la confianza. Por lo tanto, la explicabilidad no es meramente "una tecnología útil de tener". Es un elemento crucial necesario para que la IA evolucione desde "una entidad que produce resultados" a "una entidad que los humanos pueden entender, verificar, confiar y gestionar".
Resumen Ejecutivo
La explicabilidad de la IA, dicho simplemente, no es hacer que la IA "hable mejor". Se trata de permitir que los humanos entiendan por qué la IA tomó una decisión, qué observó, qué pasó por alto, dónde existe incertidumbre y cómo rastrear la responsabilidad cuando surgen problemas.
La razón por la que este tema se ha vuelto importante en años recientes no es simplemente porque "se desaprueba la caja negra". Es porque la regulación legal, la confianza del cliente, la auditoría de calidad, la responsabilidad de seguridad y la colaboración entre departamentos están demandando fuertemente que la IA pase de la etapa de "solo producir respuestas" a la etapa de "producir respuestas y fundamentos juntos". La Ley de IA de la UE requiere documentación técnica, registros automáticos, transparencia y supervisión humana para sistemas de IA de alto riesgo. Las regulaciones de servicios de recomendación algorítmica de China y las disposiciones provisionales sobre servicios de IA generativa también requieren la divulgación y explicación de los principios básicos, objetivos y mecanismos operativos clave de los algoritmos. NIST también ha identificado la "invisibilidad/imperceptibilidad" como una de las causas clave del riesgo de IA.
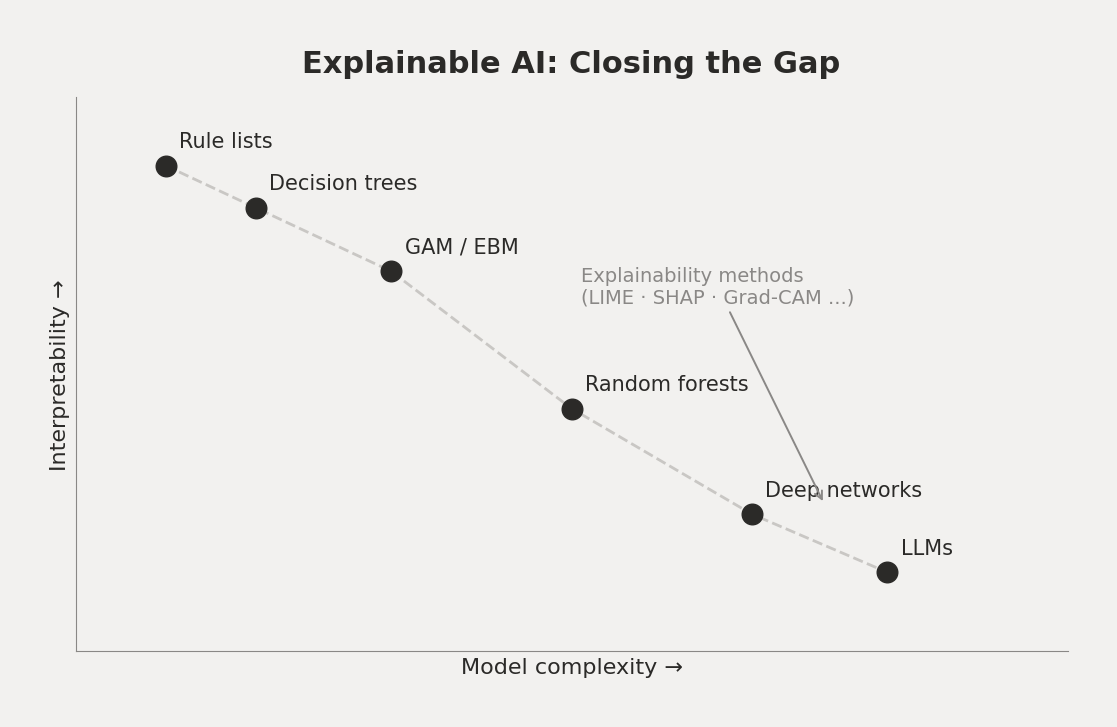
Mirando el historial de investigación, la IA temprana se centró en reglas, árboles de decisión y sistemas expertos, cuyos modelos eran relativamente fáciles de entender. Sin embargo, con el auge del aprendizaje profundo, la precisión aumentó rápidamente mientras que la legibilidad del modelo disminuyó significativamente. Como resultado, a finales de la década de 2010 surgieron métodos como mapas de calor, LIME, SHAP, Grad-CAM y explicaciones contrafácticas para "adjuntar manuales de explicación a las cajas negras". Luego, en la era de los grandes modelos de lenguaje, la investigación se dividió en dos direcciones: explicación externa (presentación de fundamentos, evidencia de búsqueda, salida estructurada) y explicación interna (interpretación de neuronas, características dispersas, rastreo de circuitos, interpretación mecánica).
Para un agente de revisión de planos de arquitectura de IA, la explicabilidad no es meramente un valor añadido académico, sino una herramienta práctica de mejora de productividad. La revisión de arquitectura es un campo con muchas normas, responsabilidades claras y sensibilidad tanto a falsos positivos como a falsos negativos. Hacer que la salida de la IA no sea simplemente una puntuación de riesgo, sino un paquete de evidencia multicapa que incluya conclusión + ubicación en plano + fundamentación normativa + registro de auditoría + interfaz de confirmación humana es más adecuado para la operación práctica.
Por qué toda la empresa debe entender la explicabilidad de la IA
En primer lugar, desde el punto de vista más práctico, la explicación no es un adorno sino una gestión de riesgos. El proyecto XAI de DARPA estableció como objetivo principal "permitir que los humanos entiendan la IA, le tengan una confianza apropiada y la gestionen de manera efectiva". El Instituto Nacional de Estándares y Tecnología de EE. UU. (NIST) también señala que la "imperceptibilidad" de la IA dificulta la medición y gestión de riesgos. En otras palabras, la explicación no es "para parecer mejor", sino que es necesaria para incorporar la gestión de la IA en procesos que la hagan verdaderamente manejable y cumplan con la responsabilidad de la organización.
Desde la perspectiva de la confianza, lo verdaderamente importante no es "hacer que la gente confíe más en la IA", sino "permitir que la IA se confíe apropiadamente". Sin explicación, las personas tienden a caer en dos extremos: uno es depender excesivamente porque la IA parece inteligente; el otro es no usarla en absoluto porque no se entiende cómo funciona. La investigación en XAI y literatura sobre colaboración humano-IA a menudo enfatiza la "confianza apropiada" —la capacidad de confiar cuando es apropiado y dudar cuando es apropiado. Sin embargo, agregar explicaciones no garantiza que la toma de decisiones mejore. Por eso, las empresas deben diseñar la explicación no como "una técnica para hacer que la gente confíe en la IA", sino como un mecanismo para calibrar la confianza.
Desde la perspectiva de la seguridad, la explicación ayuda a identificar qué "atajos raros" ha aprendido el modelo. Muchos modelos aprenden durante el entrenamiento señales que, aunque están correlacionadas accidentalmente, no tienen relación con la tarea real, como marcas de agua, campos de título, ruido de escaneo y bordes de página. En planos de arquitectura, existen muchos elementos confusos para el modelo, como variaciones de diseño, calidad de escaneo, sellos, nubes de revisión, anotaciones de escala y fusiones de múltiples páginas, por lo que este problema es especialmente importante.
Desde la perspectiva de la productividad, la explicabilidad también se subestima comúnmente. Si el resultado de la revisión de planos por IA puede mostrar simultáneamente un mapa de calor, normativa, fundamento de dimensiones y "por qué se determinó que se aplica esta regla", se convierte no solo en un clasificador sino también en material de formación práctica para nuevos empleados. Desde la perspectiva de auditoría y colaboración interdepartamental, si una conclusión se puede desplegar como "ubicación relevante, dimensiones extraídas, normativa aplicable, casos históricos similares, versión del modelo, propuesta de confirmación humana", la discusión se desplaza de ansiedades abstractas a evidencia concreta.
Historia y desarrollo
La historia de la explicabilidad de la IA es fácil de entender si la vemos como la historia de cómo los medios de explicación se refuerzan a medida que los modelos se vuelven más poderosos.
| Período | Qué sucedió | Significado para la explicabilidad |
|---|---|---|
| Era temprana de modelos de reglas y árboles | Se enfatizaba en sistemas expertos, modelos basados en reglas y árboles de decisión. Con estructura if-then, los modelos mismos eran legibles. | La explicación era principalmente "leer el modelo mismo" |
| Caja negra por aprendizaje profundo | Las redes profundas se desarrollaron significativamente en tareas de visión, y la investigación avanzó intentando entender las CNN mediante mapas de saliencia de gradientes y visualización de características. | La explicación pasó de "leer reglas" a "realizar diagnósticos de salud mediante visualización en cajas negras" |
| Sistematización de XAI | DARPA XAI se propuso crear modelos que mantuvieran alto rendimiento mientras fueran explicables, y métodos como LIME, SHAP, Integrated Gradients y Grad-CAM se convirtieron en la corriente principal. | La explicabilidad se convirtió en un campo de investigación independiente |
| Era de fidelidad y evaluación | Se reconoció que "parecer explicable" es diferente a "realmente explicar", y se propusieron evaluaciones como sanity check, infidelidad y sensibilidad. | La explicación misma se convirtió en un objeto a inspeccionar |
| Era de LLM e interpretación mecánica | Con el desarrollo de Transformer y LLM, ha avanzado la investigación en rastreo de atención, neuronas, características dispersas y circuitos internos (Anthropic, OpenAI). | La explicación se extendió a "qué sucede dentro del modelo" |
En pocas palabras, la IA temprana era una máquina transparente, el aprendizaje profundo es una caja negra de alto rendimiento, luego sigue la etapa de agregar paneles de instrumentos y grabadores de conducción a la caja negra, y hoy en día la frontera está intentando abrir el interior del motor. Entender este flujo también aclara la política más práctica para la implementación empresarial. En lugar de intentar ver completamente a través de modelos grandes de inmediato, es más directo en términos de valor comercial establecer primero paneles de instrumentos, cadenas de evidencia e interfaces de confirmación humana.
Panorama general de métodos
Hablando con precisión, interpretability (interpretabilidad) se acerca más a "el modelo mismo es fácil de entender", mientras que explainability (explicabilidad) se acerca más al concepto de "incluso si el modelo es complejo, se puede explicar a los humanos por medios adicionales". En la práctica, es más importante dejar de obsesionarse con la terminología y aclarar si se desea hacer el modelo transparente o si se desea hacer verificables los resultados.
Interpretabilidad prospectiva
La interpretabilidad prospectiva, también llamada "interpretabilidad intrínseca" o "método de caja blanca", es el enfoque de elegir estructuras fáciles de entender para los humanos desde la etapa de diseño del modelo. Los árboles de decisión, listas de reglas y modelos lineales son ejemplos típicos. Posteriormente, como métodos para mantener la legibilidad mientras se mejora el rendimiento, también se propusieron modelos aditivos generalizados, GA2M y Explainable Boosting Machine (EBM). Los árboles de decisión son particularmente fáciles de explicar; una regla como "si el ancho efectivo de la escalera es inferior a un cierto valor y esa zona es una ruta de evacuación, detectar riesgo" es algo que los profesionales de arquitectura pueden entender intuitivamente.
Otra dirección importante es el aprendizaje restringido. Hay métodos que introducen restricciones como escasez, monotonicidad y estabilidad durante el entrenamiento, o como las redes neuronales autoexplicativas que tienen explícitamente la relación de "concepto, contribución, conclusión" en la estructura del modelo. En este caso, la explicación no se añade después, sino que se convierte en parte del aprendizaje mismo.
Explicabilidad prospectiva
La explicabilidad prospectiva es un método que usa un modelo ya entrenado como está y construye un andamiaje de explicación alrededor de la salida. La explicación local responde "¿por qué este plano produjo este resultado?", mientras que la explicación global responde "¿en qué se basa normalmente este modelo para juzgar en general?".
| Método | Ejemplo | Ventajas | Limitaciones | Valor directo en revisión de planos de arquitectura |
|---|---|---|---|---|
| Árbol de decisión/Lista de reglas | Diagrama de flujo transparente | Fácil de auditar, adecuado para educación y discusión de cumplimiento | Débil para expresar patrones complejos | Auditoría de reglas explícitas, verificación frecuente de normativa simple |
| EBM/GA2M | Puntuación de subítems legible | Logra rendimiento y facilidad de comprensión en algunas tareas | No es adecuado para todas las tareas complejas | Características de auditoría estructuradas y tabulares |
| LIME | Pequeño profesor del vecindario | Independiente del modelo, conveniente para explicar un solo resultado | Puede volverse inestable debido al muestreo | Explicación de falsos positivos en planos específicos |
| SHAP | Asignación justa de contribución | Puede ver tanto local como global | Requiere experiencia en cálculo e interpretación | Análisis de contribución de características, comparación de versiones |
| Contrafáctico | Documento de propuesta de modificación | Fácil de vincular a la acción | Necesita considerar si es realmente modificable | Propuesta de "cómo corregirlo para pasar" |
| Deep Unrolling | Descomponer el procedimiento iterativo del artesano en proceso fijo | Poderoso y rápido, más explicable que pura caja negra | No es adecuado para todas las tareas | Restauración de imagen, vectorización de planos, submódulos de sistemas de medición |
LIME es como un "pequeño profesor que solo enseña el vecindario de esa muestra": crea muchas muestras similares cerca de una muestra determinada y entrena un pequeño modelo sustituto que puede explicar solo en esa vecindad. SHAP distribuye cuánto contribuyó cada característica al resultado utilizando el concepto de teoría de juegos del valor de Shapley. Sin embargo, dado que los valores de contribución no son relaciones causales en sí mismos, se requiere precaución en la interpretación. Las explicaciones contrafácticas muestran "qué hubiera pasado si las cosas hubieran sido un poco diferentes"; en la revisión de planos, pueden explicarse de manera cercana a propuestas de mejora, como "si este ancho de puerta fuera de 900 mm en lugar de 850 mm, y las flechas de dirección de evacuación se completaran, este elemento probablemente pasaría".
Explicabilidad en modelos de imagen
Los mapas de calor son el concepto más fácil de explicar. En esencia son "mapas de grado de influencia": la imagen representa superponer una película de temperatura semitransparente sobre la imagen original para mostrar dónde estaba enfocado el modelo. Mapas de saliencia, Grad-CAM, Integrated Gradients, LRP y otros tienen métodos de cálculo diferentes, pero a menudo se visualizan en este formato.
Sin embargo, aunque los mapas de calor son extremadamente fáciles de explicar, también son extremadamente propensos a malinterpretarse. Los mapas de calor no son bases legales, ni pruebas de causalidad, ni grabaciones directas del proceso de pensamiento del modelo. Solo muestran pistas sobre qué región podría haber sido una clave importante en esta decisión. Si el modelo dice "hay un problema relacionado con la evacuación aquí", el mapa de calor debe concentrarse en escaleras, puertas, anotaciones de dimensiones y relaciones de ejes. Por el contrario, si casillas de título, marcos de dibujo, marcas de agua y similares brillan intensamente, es posible que el modelo haya aprendido atajos que no debería haber aprendido.
Un enfoque muy importante en la explicación de imágenes son las muestras adversariales. A veces, simplemente agregando pequeñas perturbaciones apenas visibles para el ojo humano a la entrada, el modelo puede cometer una clasificación errónea con alto grado de confianza. Esto sugiere que el modelo está aprendiendo "características no robustas" que no son naturales para los humanos pero que son útiles para la predicción. Dado que el escaneo de planos, la reducción/ampliación, la compresión, la oclusión local, los sellos y los símbolos de revisión pueden ser cambios de entrada pequeños pero fatales para el modelo, es importante considerar la explicabilidad y la robustez juntas en los sistemas de IA para planos.
Explicabilidad en modelos de lenguaje grande (LLM)
El mecanismo de atención en el centro del Transformer es una de las entradas más naturales para pensar en la explicabilidad de los LLM. Herramientas como BertViz visualizan relaciones de atención entre diferentes capas, diferentes cabezas y diferentes tokens. Sin embargo, la atención no es una explicación en sí misma. La distribución de atención no siempre refleja fielmente los fundamentos en los que el modelo realmente se basa.
Una de las "explicaciones" más familiares en la era de los modelos de lenguaje grande es Chain-of-Thought, es decir, hacer que el modelo escriba los pasos. Sin embargo, los pasos que escribe el modelo no son necesariamente la cadena de razones que realmente actuó dentro del modelo. Por lo tanto, en la implementación empresarial, la explicabilidad de los LLM no debe depender únicamente de "hacer que escriba razones más detalladas". Un método más sólido es vincular la explicabilidad con la evidencia externa: RAG, salida estructurada, llamadas a herramientas, citas de fuentes, números de página, números de artículos, etc. La mejor explicación de un modelo de lenguaje grande en la revisión de planos arquitectónicos no es un monólogo de "por qué lo pensé", sino mostrar "qué norma cité, dónde miré en el plano, qué valores extraje y cómo debo confirmar".
Recientemente, la vanguardia de la explicabilidad de los LLM ha avanzado hacia la interpretabilidad mecánica. Anthropic publicó investigación que extrae características más unívocas de activaciones de Claude 3 Sonnet utilizando autoencoders dispersos. OpenAI también realizó investigación utilizando GPT-4 para explicar automáticamente neuronas en GPT-2. La explicabilidad de los LLM está evolucionando desde la etapa de "hacer que los resultados sean legibles" a la etapa de "investigar los mecanismos, controlar el comportamiento y localizar problemas".
Evaluación, compensaciones y limitaciones
Lo realmente difícil en explicabilidad es qué se considera una buena explicación. En la práctica, es más fácil de entender si se divide la evaluación de explicaciones en las siguientes perspectivas.
| Eje de evaluación | Preguntas comunes | Métodos típicos |
|---|---|---|
| Fidelidad | ¿Refleja la explicación los fundamentos en los que el modelo realmente se basa? | Infidelity、Sensitivity、Deletion/Insertion、Sanity Checks |
| Utilidad | ¿Se hace más rápida y precisa la comprensión, verificación y corrección cuando la persona la ve? | Experimentos con usuarios, precisión de toma de decisiones, tiempo de verificación |
| Robustez | ¿Se altera la explicación cuando la entrada cambia un poco? | Pruebas de perturbación, pruebas de aleatorización, comparación de versiones |
| Capacidad de acción | ¿Se puede convertir la explicación en una propuesta de corrección concreta? | Explicaciones contrafácticas, alineación de reglas, tarjetas de evidencia |
| Conformidad | ¿Se puede usar la explicación para registro, retrospectiva y rendición de cuentas? | Integridad de registros, rastreo de fuentes, flujo de confirmación humana |
A menudo se dice que "la precisión y la explicabilidad siempre tienen una compensación inevitable", pero estrictamente hablando no siempre es así. Las investigaciones sobre EBM y GA2M muestran que en algunas tareas los modelos explicables pueden lograr un rendimiento muy alto. Lo realmente importante en la práctica es qué explicación, para qué usuario y en qué tarea es útil. Un sistema de explicabilidad maduro orientado a negocios debe cumplir al menos tres principios: "ser fiel (no engañoso)", "ser útil (útil para juicio, verificación y mejora)" y "ser trazable (poder rastrear responsabilidad y fundamento)".
Propuestas de implementación y perspectivas futuras para la IA de revisión de planos arquitectónicos
Lo que más recomiendo no es crear "explicaciones vistosas" desde el principio, sino construir una cadena de evidencia para la revisión de planos. Es decir, garantizar que cada salida de IA tenga al menos estas cinco capas:
Conclusión
Ubicación en el plano
Base normativa y de artículos
Incertidumbre
Ruta de registro y confirmación humana
Por ejemplo, si la IA presenta en un plano de planta "es posible que el ancho efectivo de la puerta de evacuación sea insuficiente". Una explicación útil no basta con mostrar solo una oración. Debe mostrar simultáneamente la ubicación de la puerta, la anotación de dimensión en la que se enfocó el modelo, el ancho efectivo extraído por OCR o análisis de figuras, la norma y artículos relevantes, la versión y página del artículo, y también una propuesta de modificación contrafáctica como "si este ancho se ajusta a un valor determinado o superior, es posible que pase". Tal salida se convierte en tarjeta de verificación para el revisor, tarjeta de explicación para el cliente, y datos de entrenamiento para los equipos de producto y algoritmo.
Por el contrario, si el modelo confunde la descripción de correcciones pasadas en la casilla de título con descripciones normativas de la página actual, o confunde sellos, marcas de agua y nubes de revisión con miembros estructurales, el sistema debe detectar una "anomalía de explicación" en lugar de emitir silenciosamente una conclusión. Monitorear la "inconsistencia entre explicación y conclusión" como que el mapa de calor se concentra en áreas no de diseño en lugar de áreas de diseño, la evidencia visual y la evidencia de artículos no coinciden, o la confianza es demasiado alta a pesar de que faltan dimensiones importantes, puede detectar problemas más temprano que la simple monitoreo de precisión.
En los próximos años, la explicabilidad de la IA probablemente se desarrollará simultáneamente en cuatro direcciones. La primera es IA verificable (garantías formales para propiedades importantes), la segunda es estandarización de la explicabilidad (tarjetas de modelo, tarjetas de explicación, especificaciones de registro), la tercera es automatización de la explicabilidad (generación automática de tarjetas de evidencia normativa, detección automática de confianza anormalmente alta), y la cuarta es la interacción entre explicabilidad y privacidad/seguridad (explicaciones estratificadas).
La recomendación más clara es definir la explicabilidad no como un accesorio del algoritmo, sino como una capacidad del producto. En el escenario de revisión de planos arquitectónicos, lo que finalmente triunfa no es el modelo que mejor puntúa, sino el sistema que mejor organiza conclusiones, evidencia, normas y confirmación humana. En este sentido, la explicabilidad no es un costo adicional sino una barrera de entrada del producto.
Leído
Siguiente lectura ↓