Research
¿Qué es un buen producto según la investigación y la práctica actual?
Product
Career
Esta es una traducción automática del texto original en japonés
Overview
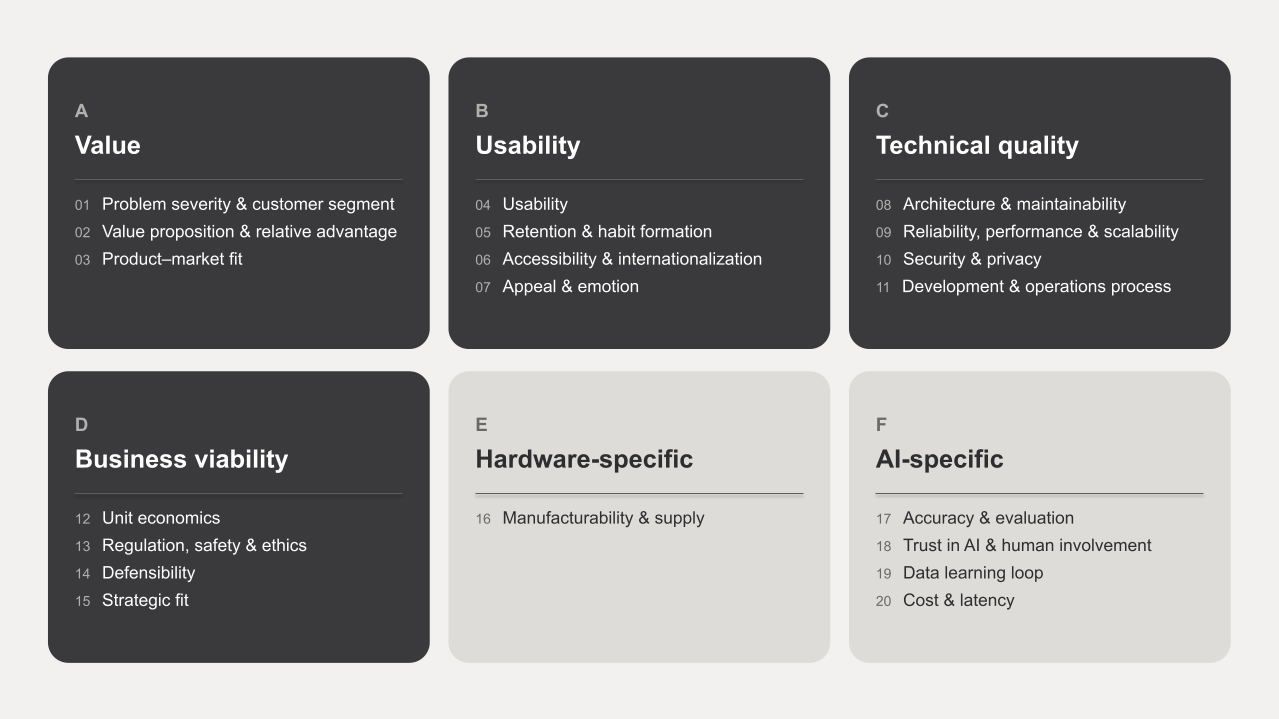
¿Qué es un buen producto? Los académicos en gestión de calidad, ergonomía, administración e investigación en innovación, así como profesionales que han desarrollado productos en Apple, Amazon, Nest y otros, han definido la "calidad" con palabras diferentes. Este artículo integra estas perspectivas y descompone los buenos productos en 6 condiciones y 20 elementos: "valor", "usabilidad", "calidad técnica", "viabilidad empresarial", "condiciones específicas del hardware" y "condiciones específicas de productos con IA".
Además, organiza el papel de los stakeholders —gerentes de producto, diseñadores, ingenieros y clientes— en 7 sistemas, y muestra cronológicamente qué elementos, quién y con qué método de validación y estándar de logro confirma en las 6 fases, desde el descubrimiento de los desafíos del cliente hasta la revisión retrospectiva.
Introducción
Las condiciones de un "buen producto" se han expresado con palabras distintas en los campos académicos como la gestión de calidad, la interacción humano-computadora y la administración, así como entre profesionales que han desarrollado productos. Más allá de la seguridad y estabilidad básicas, cuando se incluyen funciones innovadoras, usabilidad y la continuidad comercial, no existe una integración lo suficientemente completa de qué requisitos deben satisfacerse. Este artículo, considerando tanto software como hardware, organiza las condiciones que debe cumplir un buen producto y quién, cuándo y cómo verifica esto durante el proceso de desarrollo.
La novedad de este artículo reside en los siguientes 3 puntos:
Integré la definición académica y profesional de "buen producto" en 6 condiciones y 20 elementos: Coloco definiciones académicas como las 8 dimensiones de calidad de Garvin (1987), el modelo Kano (Kano et al., 1984), ISO/IEC 25010 (ISO/IEC, 2023) y definiciones de profesionales como los 4 riesgos de Cagan (2017) en un único marco, aclarando también las diferencias entre software y hardware por elemento. Por ejemplo, la "calidad atractiva" de Kano y el "diseño emocional" de Norman (2004) se tratan como el mismo elemento: "atractivo y emoción".
Traduje "quién verifica qué y cuándo" a 6 fases: Muchos trabajos académicos discuten "qué es bueno", pero no especifican responsables ni valores de referencia. Por ejemplo, establezco una correspondencia donde el gerente de producto mide trimestralmente el product-market fit con el criterio de que más del 40% de usuarios respondan "estaría muy decepcionado" si no pudiera usar el producto (Ellis & Brown, 2017).
Organicé tendencias de investigación y práctica recientes: Desde investigación de nuevos productos, HCI, ingeniería de software, teoría organizacional hasta colaboración humano-IA, integro 19 investigaciones que muestran que la superioridad del producto es el factor de éxito número uno, que más funciones disminuyen la satisfacción, que la seguridad psicológica y Agile son efectivos, y que la IA generativa tiene efectos variables en la productividad, junto con 15 argumentos prácticos de Y Combinator, Jobs, Bezos, Musk, Cagan, Fadell y otros, ordenados por valor, usabilidad, tecnología, viabilidad empresarial e IA. Por ejemplo, en temas donde los profesionales divergen —como "¿voz del cliente o visión?" o "¿lanzar rápido o pulir antes de lanzar?"— presento ambas posturas.
Qué es un buen producto
Definición de buen producto
¿Cuál es la definición de "buen producto"? Aquí organizo definiciones sobre la calidad de productos de diversos campos.
Definición en gestión de calidad: Garvin (1987) dividió la calidad del producto en 8 dimensiones: desempeño, características adicionales, confiabilidad, conformidad, durabilidad, mantenibilidad, estética y calidad percibida. Argumenta que la calidad no es un único eje, sino que los clientes compiten eligiendo la dimensión que priorizan. Por ejemplo, en los años 80, los fabricantes de automóviles japoneses diferenciaron sus productos de los estadounidenses en las dimensiones de confiabilidad y conformidad.
Definición de calidad atractiva: Kano et al. (1984) distinguieron entre "calidad obligatoria" (cuya satisfacción se da por sentada), "calidad unidimensional" (donde la satisfacción aumenta proporcionalmente con la satisfacción), y "calidad atractiva" (que no causa insatisfacción si falta, pero complace si se proporciona). Por ejemplo, en los smartphones, la calidad de las llamadas es obligatoria, la duración de la batería es unidimensional, y la autenticación por huella digital inicial era atractiva.
Definición en ingeniería de software: ISO/IEC 25010 (ISO/IEC, 2023) define la calidad de productos de software mediante 9 características: idoneidad funcional, eficiencia del desempeño, compatibilidad, capacidad de interacción, confiabilidad, seguridad, mantenibilidad, flexibilidad y seguridad. Por ejemplo, dos aplicaciones con la misma funcionalidad pero con baja mantenibilidad pueden tener costos de modificación años después que duplican o triplican los de la otra.
Definición en diseño centrado en el usuario: ISO 9241-210 (ISO, 2019) establece el "diseño centrado en el usuario", que comprende entender las necesidades y contexto del usuario, incluirlo en el diseño e iterar la evaluación, mientras que Norman (2013) propone el "affordance" (capacidad de acción percibida) y "signifier" (indicador) como condiciones del buen diseño. Por ejemplo, una puerta donde no está claro si debe empujarse o jalarse no es un buen diseño, aunque cumpla la función.
Definición en investigación de innovación: Rogers (2003) identifica 5 atributos que determinan la velocidad de adopción de algo nuevo: ventaja relativa, compatibilidad con hábitos existentes, baja complejidad, posibilidad de prueba y observabilidad. Davis (1989) explica si los usuarios aceptan una tecnología mediante "utilidad percibida" y "facilidad de uso percibida". Por ejemplo, los pagos con código QR se adoptaron rápidamente porque son compatibles con el hábito existente (llevar smartphone), fáciles de probar y visibles en otros usuarios.
Definición en Jobs to be Done: Christensen et al. (2016) argumentan que los clientes no "compran" un producto sino que lo "contratan" para lograr un progreso específico en la vida (un trabajo), y definen un buen producto como aquel que cumple mejor ese trabajo. Por ejemplo, el batido de leche que se bebe durante el viaje matutino es "contratado" para el trabajo de "pasar el tiempo durante un viaje aburrido y suprimir el hambre hasta el mediodía".
Definición de profesionales: Cagan (2017) define un buen producto como aquel que supera los 4 riesgos: valor (¿lo compran los clientes?), usabilidad (¿saben cómo usarlo?), viabilidad técnica (¿se puede hacer?) y viabilidad empresarial (¿funciona como negocio?). Rams (Vitsœ, n.d.) enumera 10 principios de buen diseño: innovador, útil, hermoso, comprensible, discreto, honesto, duradero, consistente hasta los detalles, considerado con el medio ambiente y de diseño mínimo. Por ejemplo, el iPod original de Apple se describe como un buen producto paradigmático porque superó todos los 4 riesgos y fue fiel a los principios de Rams.
Definición de product-market fit: Andreessen (2007) llama "product-market fit" (PMF) al estado de "estar en un buen mercado y tener un producto que satisface ese mercado", afirmando que es lo único importante para startups. Ellis & Brown (2017) sugieren como indicador que más del 40% de usuarios respondan "estaría muy decepcionado" a la pregunta "¿cómo te sentirías si no pudieras usar este producto?". Por ejemplo, Superhuman publicó su proceso de aumentar este indicador del 22% al 58% (Vohra, 2018).
A continuación, basándome en estas definiciones, descompongo los buenos productos en 6 condiciones y 20 elementos.
A. Valor: ¿Resuelve los desafíos del cliente?
El valor surge cuando un cliente tiene un desafío que desea resolver incluso pagando por ello, y el producto lo resuelve mejor que otras alternativas. Desde Cooper & Kleinschmidt (1987), la investigación en nuevos productos ha mantenido que la superioridad del producto es el factor número uno para el éxito (Henard & Szymanski, 2001; Evanschitzky et al., 2012).
① Severidad del desafío y segmento de clientes
Definición: Un segmento específico de clientes enfrenta un desafío tan grave y frecuente que desearía resolverlo incluso pagando por ello. El desafío no se define como una demanda de funciones, sino como el progreso que el cliente desea lograr (un trabajo) (Christensen et al., 2016). Por ejemplo, el trabajo no es "quiero un taladro más rápido" sino "quiero colgar un estante en la pared", y un producto que cuelga estantes sin taladrar también es competencia.
Método de evaluación: Se evalúa por la frecuencia del desafío, su severidad (tiempo o costo perdido), la alternativa actual y cuánto pagan por ella, y el número de clientes con el mismo desafío (tamaño del segmento). Por ejemplo, si puedes responder "ocurre X veces al mes, pierde Y horas cada vez, y ahora pagan Z por la alternativa", entonces has cuantificado la severidad del desafío.
Resumen: Blank (2013) propuso el "customer development" para descubrir clientes y confirmar la existencia del desafío antes de hacer el producto, y Fitzpatrick (2013) mostró principios de preguntas que investigan comportamiento pasado en lugar de opiniones. El hardware requiere tiempo y costo para prototipos, así que la confirmación del desafío se hace primero con maquetas o modificaciones de productos existentes (Fadell, 2022). Por ejemplo, los fundadores de Airbnb alojaron huéspedes en casa propia para confirmar el desafío "quiero ahorrar en hospedaje pero no quiero hoteles baratos", y Nest comenzó investigando insatisfacciones con termostatos existentes (la molestia de configurarlos).
② Propuesta de valor y ventaja relativa
Definición: Poseer un punto claramente superior (ventaja relativa) comparado con alternativas existentes, expresable en una sola frase (Rogers, 2003). El valor debe entenderse como "producto completo" que incluye función central, soporte, compatibilidad y servicios periféricos (Levitt, 1980; Moore, 1991). Por ejemplo, el valor de vehículos eléctricos se define tanto por el vehículo en sí como por la infraestructura de carga.
Método de evaluación: Se evalúa por la magnitud de mejora respecto a alternativas (tiempo, costo, calidad), si el cliente puede explicar con sus propias palabras "por qué usar esto en lugar de otra cosa", y clasificación en el modelo Kano (¿es calidad atractiva u obligatoria?; Witell et al., 2013). Por ejemplo, si muchos responden en la encuesta Kano "está bien sin esto", esa función no diferencia el producto.
Resumen: Desde Cooper & Kleinschmidt (1987), un producto superior con beneficio único ha sido consistentemente el factor que más diferencia éxito de fracaso. El software pierde fácilmente su ventaja por imitación de funciones, mientras que el hardware mantiene la ventaja mediante diseño físico y know-how de fabricación. Por ejemplo, la aspiradora Dyson se diferencia claramente en un punto: "succión que no disminuye", manteniéndolo mediante tecnología lograda tras 5,127 prototipos (Dyson, 2021).
③ Product-Market Fit
Definición: El cliente siente el valor tan intensamente que no puede prescindir del producto, lo usa continuamente y lo recomienda a otros. Andreessen (2007) señala que con PMF se puede ver cómo los clientes "tiran" del producto. Por ejemplo, después de PMF, el producto recibe consultas incluso sin ventas activas, y se requieren aumentos constantes de servidores.
Método de evaluación: Se evalúa mediante la encuesta de PMF que pregunta "¿cómo se sentiría si no pudiera usar esto?" (Ellis & Brown, 2017), curvas de retención aplanadas por cohorte, NPS (Reichheld, 2003) y tasas de conversión a planes pagos. Para hardware, se utilizan órdenes anticipadas, tasas de devolución, reseñas, y para dispositivos conectados, tasas de operación como sustituto. Por ejemplo, en dispositivos de fitness conectados, la frecuencia de uso mensual del comprador y la tasa de cancelación de suscripción son indicadores más relevantes que el volumen de ventas.
Descripción general: El PMF no es un evento único. Olsen (2015) conceptualiza el PMF como una pirámide de 5 capas que conecta el mercado (clientes y problemas) con el producto (propuesta de valor, características, UX), y argumenta que cuando cambia el mercado, el ajuste se pierde. Vohra (2018) mejoró los indicadores fortaleciendo los aspectos más valorados por usuarios que respondieron "muy insatisfecho" y eliminando las frustraciones de quienes respondieron "algo insatisfecho". Por ejemplo, muchos servicios diseñados para PC perdieron su ajuste con la proliferación de smartphones.
B. Facilidad de uso: ¿Se puede usar? ¿Se puede seguir usando?
La facilidad de uso es una condición para que un producto valioso se use realmente y se siga usando. En el Modelo de Aceptación Tecnológica de Davis (1989), la facilidad de uso es uno de los dos factores, junto con la utilidad, que determina la intención de uso.
④ Usabilidad
Definición: El grado en que usuarios específicos pueden lograr objetivos específicos de manera efectiva, eficiente y satisfactoria (ISO 9241-11; ISO, 2018). Los 10 heurísticos de Nielsen (1994) —visibilidad del estado del sistema, coincidencia entre el sistema y el mundo real, prevención de errores, reconocimiento en lugar de recuerdo, entre otros— se convierten en criterios para evaluar el diseño. Por ejemplo, una pantalla de edición donde no se puede ver si se guardó viola el principio de "visibilidad del estado del sistema".
Método de evaluación: Se evalúa mediante pruebas de usabilidad con pocos usuarios (Nielsen, 2000) midiendo la tasa de finalización de tareas y tiempo de finalización, la Escala de Usabilidad del Sistema (SUS; Brooke, 1996; Sauro & Lewis, 2016), y si múltiples personas se pierden en el mismo punto. Por ejemplo, si 5 personas prueban una nueva pantalla de solicitud y 3 se pierden en el mismo lugar, ese punto es un problema de diseño.
Descripción general: Krug (2014) establece como principio fundamental que no se debe hacer pensar al usuario, y Norman (2013) argumenta que debemos culpar al diseño que induce errores, no al usuario que los comete. El software puede cambiar su interfaz después del lanzamiento, pero la interfaz física del hardware (botones, forma, peso) no se puede cambiar después del envío, por lo que las pruebas en la fase de prototipado son más críticas. Por ejemplo, el pedido de "1 clic" de Amazon minimiza el número de decisiones hasta la compra, y Nest rediseñó repetidamente la sensación operativa del dial en la fase de prototipado (Fadell, 2022).
⑤ Uso continuo y formación de hábitos
Definición: El estado en el que los usuarios alcanzan el valor central (momento "aha") en el primer uso, se sigue usando repetidamente, y se convierte en parte de los hábitos o procesos de trabajo del usuario. Fogg (2009) explica que el comportamiento ocurre cuando coinciden simultáneamente la motivación, la capacidad y el disparador, y Eyal (2014) sistematiza la formación de hábitos como un ciclo de disparador, acción, recompensa e inversión. Por ejemplo, Slack determinó que la adopción se produce cuando un equipo ha intercambiado 2,000 mensajes, y diseñó para guiar hacia ese punto (First Round Review, 2015).
Método de evaluación: Se evalúa mediante tasa de activación (porcentaje de usuarios registrados que alcanzan el valor central), curvas de retención por cohorte, DAU/MAU (tasa de uso en días laborables para herramientas empresariales), y el marco HEART de Google (felicidad, engagement, retención, tarea completada; Rodden et al., 2010). Para hardware no conectado, la frecuencia de uso es desconocida, por lo que se utilizan encuestas o la frecuencia de compra de consumibles como sustituto. Por ejemplo, el uso continuo de una cafetera se mide por la tasa de recompra de cápsulas.
Descripción general: El diseño para formar hábitos solo se justifica cuando está alineado con los intereses del usuario. Eyal (2014) mismo afirma que no debería usarse la técnica de formación de hábitos en productos que no mejoren la vida del usuario. Por ejemplo, el diseño que aumenta la frecuencia de notificaciones para ganar tasa de uso a corto plazo aumenta las cancelaciones a largo plazo.
⑥ Accesibilidad e internacionalización
Definición: El estado en el que usuarios con limitaciones visuales, auditivas, motoras o cognitivas, así como usuarios de diferentes idiomas, culturas y marcos legales, pueden usar el producto de la misma manera. WCAG 2.2 de W3C (2023) establece criterios de conformidad basados en cuatro principios: perceptible, operable, comprensible y robusto. Por ejemplo, un gráfico que indica estado solo con color es indistinguible para usuarios con daltonismo.
Método de evaluación: Se evalúa mediante el nivel de conformidad WCAG, la operabilidad con tecnologías de asistencia (lectores de pantalla, etc.), y el rango de idiomas, monedas, formatos de fecha y zonas horarias soportadas. Por ejemplo, una pantalla diseñada en inglés puede ocupar aproximadamente 1.3 veces más espacio cuando se traduce al alemán, causando que desborde los botones.
Descripción general: Según la encuesta de WebAIM (2024), el 95.9% de los 1 millón de sitios principales tienen violaciones de WCAG, por lo que es una condición que no se cumple a menos que se diseñe conscientemente. El software puede cambiar el idioma y la pantalla mediante configuración, pero el hardware requiere diferentes voltajes de alimentación, formas de enchufe, bandas de frecuencia inalámbrica y certificaciones nacionales (CE, FCC, etc.) para cada región, por lo que el rango de compatibilidad debe determinarse en la fase de diseño. Por ejemplo, un dispositivo vendido en Japón y Estados Unidos debe obtener certificación del módulo inalámbrico para cada país.
⑦ Atractivo y emoción
Definición: La cualidad de no solo cumplir funciones, sino de ser agradable al usar y deseado de poseer. Norman (2004) divide las capas en las que el diseño afecta la emoción en tres: "instintiva" (apariencia), "comportamental" (experiencia de uso), e "reflexiva" (significado e imagen de uno mismo), y la "calidad de atractivo" del modelo de Kano (Kano et al., 1984) corresponde a este elemento. Por ejemplo, el empaque de los productos Apple diseña la experiencia misma de desempaquetamiento en la capa instintiva.
Método de evaluación: Se evalúa mediante NPS (Reichheld, 2003), la determinación de calidad de atractivo mediante encuesta Kano, y la consistencia en revisiones de diseño (terminología, color, espaciado, movimiento). Por ejemplo, si la terminología varía de pantalla en pantalla ("guardar", "registrar", "confirmar"), hay falta de consistencia.
Descripción general: Los Principios de Rams (Vitsœ, n.d.) afirman que el buen diseño es consistente hasta en los detalles y es lo más minimalista posible, y Jobs argumentó que se debe comenzar desde la experiencia del cliente y luego retroceder hacia la tecnología, no al revés (Jobs, 1997). La belleza también mejora la percepción de facilidad de uso (Kurosu & Kashimura, 1995; Tractinsky et al., 2000). En hardware, la textura física —materiales, peso, tacto, sonido— define el atractivo; en software, la velocidad de respuesta, movimiento y tono de la redacción. Por ejemplo, el sonido de cerrar la puerta de un auto de lujo es un atractivo diseñado deliberadamente, y la suavidad de la transición de pantalla en una aplicación es su equivalente.
C. Calidad técnica: ¿Se puede construir? ¿Puede seguir funcionando?
La calidad técnica determina no solo si el producto se puede construir una vez, sino si se puede seguir construyendo para adaptarse a requisitos cambiantes, y si seguirá funcionando en manos del cliente. Las características de calidad de ISO/IEC 25010 (ISO/IEC, 2023) y la investigación empírica de DORA (Forsgren et al., 2018) son la base de estas condiciones.
⑧ Arquitectura y mantenibilidad
Definición: Cuando surge la necesidad de cambio, el impacto está limitado y la estructura permite cambiar de manera segura. Parnas (1972) propuso la "ocultación de información" para esconder decisiones de diseño que cambian dentro de módulos, y Conway (1968) señaló que la estructura de un sistema refleja la estructura de comunicación de la organización. Por ejemplo, si la lógica de cálculo de tarifa está duplicada en tres lugares —pantalla, API, procesamiento por lotes—, cada cambio de tarifa requiere modificar tres lugares.
Método de evaluación: Se evalúa mediante el rango de impacto del cambio (límites de módulos, dirección de dependencias, duplicación), tiempo de entrega del cambio, cobertura de pruebas, cantidad de deuda técnica y proporción de reembolso. Para hardware, se mide por la intercambiabilidad de componentes, modularización y facilidad de reparación (Ulrich et al., 2020). Por ejemplo, el portátil Framework utiliza una estructura modular donde cada componente se puede reemplazar, convirtiéndolo en el valor mismo del producto.
Descripción general: Cunningham (1992) comparó el código escrito apresuradamente con "deuda" y argumentó que sin pagarla, los intereses (incremento del costo de cambio) se acumulan. La encuesta de Besker et al. (2019) encontró que los desarrolladores gastan en promedio el 23% de su tiempo de trabajo en abordar deuda técnica. El refactoring de Fowler (2018) es un procedimiento para mejorar la estructura sin cambiar funcionalidad, por lo que debe asignarse tiempo regularmente. Por ejemplo, el código sin pruebas continúa pagando intereses en forma de confirmación manual con cada cambio.
⑨ Confiabilidad, rendimiento y escalabilidad
Definición: La cualidad de funcionar cuando el cliente lo necesita, a la velocidad requerida, y continuar funcionando incluso con aumento de carga. El SRE de Google (Beyer et al., 2016) muestra el concepto de "Objetivo de Nivel de Servicio (SLO)" para especificar metas de disponibilidad, y usar cualquier excedente sobre la meta como "presupuesto de errores" para desarrollo de nuevas características. Por ejemplo, si el SLO es 99.9% de disponibilidad mensual, se permiten aproximadamente 43 minutos de inactividad, y si se supera, la estabilización se prioriza sobre nuevas características.
Método de evaluación: Se evalúa mediante el logro del SLO, distribución del tiempo de respuesta (como el percentil 95), cambio de respuesta bajo carga, y tiempo de recuperación de fallos. Para hardware, se mide mediante tasa de fallos (MTBF), pruebas de durabilidad, y costo de fallo dentro del período de garantía (Garvin, 1987). Por ejemplo, en automóviles, solo las fallas por software se pueden solucionar con actualización OTA; los defectos de componentes resultan en retirada del mercado.
Descripción general: Nygard (2018) sistematizó patrones de diseño para contener fallos localmente, como timeouts, circuit breakers y bulkheads (mamparas). Los fallos ocurrirán, así que se diseña para ello y se aprende mediante postmortems sin culpa cuando suceden (Beyer et al., 2016). Por ejemplo, cuando una API de pago externa es lenta, no debería congelarse toda la pantalla, sino solo pausarse el pago, mostrando una estructura que aisla el fallo.
⑩ Seguridad y privacidad
Definición: El estado en el que los datos y activos del cliente están protegidos y la privacidad se considera desde la fase de diseño. "Privacy by Design" de Cavoukian (2009) establece como principio proteger mediante configuración predeterminada en lugar de medidas posteriores, y el Top 10 de OWASP (2021) sistematiza vulnerabilidades típicas como control de acceso deficiente, fallo de cifrado e inyección. Por ejemplo, incluir el ID del usuario en la URL es un caso típico de control de acceso deficiente.
Método de evaluación: Se evalúa mediante la presencia o ausencia de medidas contra las amenazas identificadas en el modelado de amenazas, la gravedad y cantidad de vulnerabilidades encontradas en diagnósticos de vulnerabilidades y pruebas de penetración, vulnerabilidades conocidas en librerías dependientes, y la existencia de períodos de retención de datos personales y procedimientos de eliminación. Por ejemplo, si quedan vulnerabilidades de gravedad alta sin resolver, el producto no puede ser enviado incluso si se cumplen otras condiciones.
Descripción general: El Marco de Desarrollo Seguro de Software (Secure Software Development Framework) del NIST (2022) es un estándar que integra estas actividades en el proceso de desarrollo. El software puede corregir vulnerabilidades mediante la distribución de versiones corregidas, pero el hardware no puede corregirse después del lanzamiento si no existe un medio de actualización de firmware. La Ley de Ciberresiliencia de la UE (European Parliament and Council, 2024b) obliga a los productos con elementos digitales a proporcionar actualizaciones de seguridad después de la venta. Por ejemplo, los dispositivos IoT sin medios de actualización segura están siendo restringidos en su comercialización.
⑪ Procesos de desarrollo y operación
Definición: Es el estado en el que funciona un sistema que entrega pequeños cambios con frecuencia, de manera segura, a los clientes y aprende de los resultados. Forsgren et al. (2018) demostraron que cuatro indicadores —frecuencia de despliegue, tiempo de entrega de cambios, tasa de fallos de cambios y tiempo de recuperación— se correlacionan con el desempeño organizacional. Por ejemplo, las organizaciones de alto desempeño despliegan múltiples veces al día, tienen una tasa de fallos baja y se recuperan en menos de una hora.
Método de evaluación: Se evalúa mediante los cuatro indicadores de DORA, la tasa de automatización de CI/CD y la implementación de retrospectivas de lanzamiento. En hardware, se evalúa mediante el paso de cada fase —verificación técnica (EVT), verificación de diseño (DVT) y verificación de producción (PVT)— y las decisiones de continuación o suspensión en cada fase (stage gate de Cooper, 1990). Por ejemplo, cambiar la forma de la carcasa después de haber ordenado moldes resulta en meses de retraso y costos adicionales de decenas de millones de yenes (Fadell, 2022).
Descripción general: Brooks (1995) señaló que agregar personas a un proyecto retrasado lo retrasa aún más, y Shape Up de Singer (2019) muestra cómo reducir el alcance del trabajo para caber en un período fijo de seis semanas. El ciclo "construir-medir-aprender" de Ries (2011) y el enfoque "Working Backwards" de Amazon, que escribe comunicados de prensa y FAQ antes del desarrollo (Bryar & Carr, 2021), son principios que minimizan el tiempo de aprendizaje y el desarrollo innecesario. DORA (2025) reporta que el uso de IA aumenta el rendimiento pero también la inestabilidad, y que este efecto se amplifica en organizaciones con bases sólidas como lotes pequeños y gestión de versiones rigurosa. Por ejemplo, aunque la generación de código con IA es más rápida, si la revisión y las pruebas no pueden seguir el ritmo, la tasa de fallos de cambios aumenta.
D. Viabilidad empresarial: ¿Funciona como negocio?
La viabilidad empresarial determina si un buen producto para el cliente también es sostenible para el creador. Es el último de los cuatro riesgos de Cagan (2017), y aquí las regulaciones y la ética se tratan como condiciones para la continuidad empresarial.
⑫ Economía unitaria
Definición: Los ingresos por cliente (por empresa, por unidad) superan los costos de adquisición, provisión y mantenimiento continuo. Skok (2013) enfatizó en SaaS la relación entre el valor de vida del cliente (LTV) y el costo de adquisición del cliente (CAC), así como el período de recuperación del CAC. Por ejemplo, un cliente con una tarifa mensual de 10,000 yenes, un margen bruto del 80% y una continuidad promedio de 30 meses tiene un LTV de 240,000 yenes; si el CAC está significativamente por debajo, es viable.
Método de evaluación: Se evalúa mediante LTV/CAC, período de recuperación del CAC, margen bruto, tasa de cancelación y tasa de ingresos netos retenidos (NRR). En hardware, se evalúa mediante el margen bruto que incluye el costo de la lista de materiales (BOM), fabricación, logística, inventario, devoluciones y costos de garantía. Por ejemplo, si el NRR es 110%, los ingresos de clientes existentes crecen un 10% anual incluso sin nuevos clientes.
Descripción general: El costo marginal del software es casi cero, siendo los costos en la nube el gasto variable principal, pero el hardware tiene costos físicos adicionales y típicamente márgenes brutos más bajos. Los productos de IA incurren en costos de inferencia con cada uso, por lo que deben verse junto con ⑳. Por ejemplo, en hardware existe una regla general de establecer el precio de venta en un múltiplo del costo de BOM, incorporando costos de garantía y devolución.
⑬ Regulación, seguridad y ética
Definición: El producto cumple con las regulaciones aplicables, no causa daño a los usuarios y terceros, y es socialmente aceptable. La Ley de IA de la UE (European Parliament and Council, 2024a) impone obligaciones a los sistemas de IA según el grado de riesgo, y la Directiva de Responsabilidad por Productos modificada (European Parliament and Council, 2024c) extendió la responsabilidad al software e IA. Por ejemplo, la IA utilizada en contratación y crédito se clasifica como alto riesgo, requiriendo documentación, supervisión humana y garantía de precisión.
Método de evaluación: Se evalúa mediante la completitud del inventario de regulaciones aplicables (datos personales, protección del consumidor, regulación sectorial, seguridad del producto, control de exportaciones), los resultados de la evaluación de riesgos y el estado de auditorías externas u obtención de certificaciones. El Marco de Gestión de Riesgos de IA del NIST (2023) es un marco para la autoevaluación de riesgos de IA. Por ejemplo, antes de entrar en un nuevo mercado, se deben verificar las leyes de protección de datos personales y las restricciones de transferencia de datos de ese país.
Descripción general: El hardware requiere certificaciones de seguridad de productos (eléctricos, inalámbricos, químicos) como prerequisito para el lanzamiento, mientras que el software se ha centrado históricamente en privacidad y ciberseguridad. Sin embargo, con la Ley de Ciberresiliencia y la modificación de la Directiva de Responsabilidad por Productos, el software ahora también tiene responsabilidades como producto. La ética es más amplia que la regulación; como muestra Mathur et al. (2019), los dark patterns son legales pero engañan a los usuarios y dañan la confianza. Por ejemplo, desde 2024 en la UE, los daños causados por defectos de software están sujetos a responsabilidad por productos.
⑭ Defensa (Moat)
Definición: Cuando un buen producto es imitado, existen razones para retener a los clientes. La defensa (Moat) se clasifica en cinco tipos: estructura de costos, bloqueo de clientes, efectos de red, activos intangibles y estructura de mercado. Por ejemplo, un producto profundamente integrado en los flujos de trabajo de los clientes tiene altos costos de cambio, lo que dificulta las cancelaciones incluso si se imitan las funciones.
Método de evaluación: Se evalúa mediante la magnitud de los costos de cambio, la cantidad de datos acumulados por cliente, la presencia de efectos de red (¿aumenta el valor al aumentar los usuarios?) y cambios en la tasa de cancelación cuando los competidores lanzan funciones equivalentes. Por ejemplo, si la tasa de cancelación no cambia después del lanzamiento de una función equivalente de un competidor, la defensa existe más allá de las características.
Descripción general: El software depende principalmente de datos y efectos de red como defensa, mientras que el hardware depende de know-how de fabricación, patentes, redes de distribución y bienes complementarios (consumibles, accesorios). La defensa no existe desde el inicio; se construye intencionalmente después de lograr PMF. Por ejemplo, el montura de lentes de cámara es un bloqueo por bien complementario, donde el patrimonio de lentes compatibles obstaculiza el cambio.
⑮ Alineación con la estrategia
Definición: Cada característica y producto se alinea con la visión y estrategia del producto, y con los objetivos de la empresa. Cagan & Jones (2020) propusieron "equipos de producto" responsables de resultados y que decidían sus propias soluciones, en lugar de "equipos de funciones" que solo cumplían solicitudes de características. Por ejemplo, un equipo al que solo se le asigna un objetivo de ingresos tiende a hacer descuentos, mientras que un equipo al que se le asigna "aumentar la tasa de retención de clientes" se enfoca en mejorar el producto.
Método de evaluación: Se evalúa mediante si la visión y estrategia del producto están documentadas, si cada elemento en la hoja de ruta puede indicar qué hipótesis de estrategia valida, y si se logran los objetivos de resultado trimestral (OKR). Por ejemplo, cada elemento del roadmap debe incluir "la hipótesis a validar con este elemento"; los que no pueden escribir esto deben ser eliminados.
Descripción general: Jobs señaló que decidir qué no hacer es concentración, y Bezos (2017) citó la obsesión por el cliente y la vigilancia contra que los procesos se conviertan en fin en sí mismos como condiciones del "Día 1". Horowitz (2014) llamó al buen gerente de producto "CEO del producto" y lo definió como un rol con responsabilidad de resultados. Por ejemplo, rechazar una característica muy solicitada si diluye el valor central del producto es una decisión estratégica.
E. Condiciones específicas de hardware
⑯ Capacidad de fabricación, suministro y calidad física
Definición: Es el estado en el que se puede producir en masa de acuerdo con el diseño, con el costo objetivo y calidad estable, y las piezas se suministran de manera estable. "Design for Manufacturing and Assembly (DFMA)" de Boothroyd et al. (2011) es un método para reducir el número de piezas y simplificar el ensamblaje en la fase de diseño, y Taguchi (1986) propuso "diseño robusto" donde el desempeño no cambia con la variabilidad de fabricación. Por ejemplo, simplemente reducir los tipos de tornillos de 3 a 1 reduce el tiempo y errores de ensamblaje.
Método de evaluación: Se evalúa mediante el rendimiento directo y la tasa de aprobación en cada fase de prototipos (EVT, DVT, PVT), resultados de pruebas de durabilidad y ambientales (temperatura, humedad, caída, vibración), obtención de certificaciones de seguridad y radio de cada país (CE, FCC, UL, etc.), tasa de defectos y devoluciones en producción inicial, y proporción de piezas de fuente única. Por ejemplo, si el rendimiento de PVT no alcanza el objetivo, es necesario retrasar el inicio de la producción.
Descripción general: El proveedor de piezas, tiempo de entrega, riesgo de fuente única e inventario se determinan simultáneamente con el diseño (Ulrich et al., 2020). Fadell (2022) afirma que el hardware se aprende en la primera generación, se corrige en la segunda y se perfecciona en la tercera, recomendando no buscar la perfección en el modelo inicial. Lo equivalente en software es la reproducibilidad de compilación y despliegue, dependencia del proveedor de nube y manejo de diversidad de entornos de ejecución (OS, navegador, dispositivo). Por ejemplo, un diseño dependiente de un semiconductor específico se detiene cuando se interrumpe el suministro, paralelo a un diseño dependiente de un único proveedor de nube.
F. Condiciones específicas de productos de IA
Los productos que colocan IA como núcleo tienen propiedades no presentes en software convencional: la salida es probabilística, contiene errores y cambia con el uso. Además de los elementos anteriores, se requieren los siguientes 4 elementos.
⑰ Precisión y evaluación
Definición: La salida de IA alcanza la precisión requerida en escenarios reales de uso y se puede medir mediante un método reproducible. El AI Index del Stanford HAI (2025) señala que muchos benchmarks públicos se han saturado, ampliando la brecha con problemas reales. Por ejemplo, un modelo con alta tasa de respuesta correcta en preguntas generales puede tener muchos errores en la lectura de documentos específicos de negocios.
Método de evaluación: Se evalúa mediante precisión, recall y agregación de tipos de errores en conjuntos de evaluación creados a partir de datos reales (reflejando la distribución de entrada esperada), tasa de concordancia con evaluación humana y pruebas de regresión por lanzamiento (Husain, 2024; Zheng et al., 2023). Por ejemplo, usar 100 casos reales anteriores como conjunto de evaluación y comparar con el mismo conjunto cada vez que se cambia un modelo o instrucción.
Resumen: Como señaló Karpathy (2017) al denominar "Software 2.0", la calidad de los productos de IA se determina por los datos y la evaluación, no por el código. En hardware con IA integrada (robots, vehículos, dispositivos médicos), donde los errores pueden causar daño físico, se requiere un diseño a prueba de fallos (fail-safe) y validación adicional en entornos reales. Por ejemplo, en vehículos autónomos, los indicadores de evaluación incluyen la distancia de conducción en simulación más el número de intervenciones en conducción real.
⑱ Confianza en la IA e implicación humana
Definición: Estado en el que el usuario confía en la IA de manera apropiada: ni excesivamente ni insuficientemente, sino que la utiliza de forma adecuada. Amershi et al. (2019) presentaron 18 directrices para la interacción humano-IA, incluyendo hacer explícito qué puede hacer la IA y en qué medida, así como permitir la corrección eficiente de errores. Por ejemplo, mostrar el nivel de confianza de la IA e impulsar la verificación humana cuando es bajo.
Método de evaluación: Se evalúa mediante la tasa de aceptación del usuario cuando la IA es correcta e incorrecta (grado de calibración), tasa de corrección por humanos, tiempo requerido para la corrección, y conformidad con directrices de diseño como la Guía People + AI de Google (PAIR, 2019). Por ejemplo, si el porcentaje de usuarios que identifican errores de IA es bajo, indica exceso de confianza.
Resumen: Bansal et al. (2021) demostraron que agregar explicaciones a los juicios de IA facilita que los usuarios los sigan incluso cuando son incorrectos, y Buçinca et al. (2021) mostraron que forzar a los usuarios a reflexionar ("fuerza cognitiva") reduce el exceso de confianza. Dell'Acqua et al. (2023) revelaron un "límite dentado" donde la IA mejora la calidad en tareas en las que es competente pero reduce la precisión en aquellas donde no lo es; el diseño de dónde debe participar el humano marca la diferencia en los resultados. Por ejemplo, proporcionar no solo un botón para aprobar directamente las propuestas de IA, sino un flujo que requiera verificar la justificación antes de aprobar, reduce los errores pasados por alto.
⑲ Ciclo de aprendizaje de datos
Definición: Existe un mecanismo mediante el cual los datos obtenidos del uso se retroalimentan en la mejora del producto. DORA (2025) identifica como capacidades cruciales para la efectividad de la IA un ecosistema de datos saludable y acceso a datos internos. Por ejemplo, un diseño en el que el historial de correcciones del usuario en las salidas de IA se convierte en datos de evaluación y material de mejora.
Método de evaluación: Se evalúa mediante la tasa de recopilación de datos corregidos, el período desde la recopilación hasta la mejora, los cambios de precisión después de la mejora, y auditoría de la calidad y sesgos de los datos. Por ejemplo, consolidar mensualmente el historial de correcciones y verificar si se están reduciendo los mismos tipos de errores.
Resumen: El ciclo de aprendizaje es también la fuente del bloqueo por datos acumulados dentro de ⑭ Defensibilidad. En la IA integrada en hardware, el ciclo de aprendizaje no se cierra sin comunicación para recuperar datos del campo y un mecanismo para distribuir actualizaciones (OTA). Por ejemplo, el equipo de inspección instalado en una fábrica debe tener diseñada una ruta para recopilar registros de falsos positivos.
⑳ Costo y velocidad de respuesta
Definición: El costo de inferencia de IA y el tiempo de respuesta son acordes con el precio y la experiencia de usuario. A diferencia del software convencional, los productos de IA incurren en costos de inferencia cada vez que se utilizan, afectando directamente la economía unitaria. Por ejemplo, si una función cuesta decenas de yenes por procesamiento y se proporciona sin límites, el servicio genera pérdidas a medida que aumenta el uso.
Método de evaluación: Se evalúa mediante el costo de inferencia por uso y su ratio respecto a los ingresos, la distribución del tiempo de respuesta, y la efectividad de reducción de costos mediante optimización del modelo y caché. Los límites de Nielsen (1993) —0.1 segundos, 1 segundo, 10 segundos— sirven como referencia para la tolerancia del tiempo de respuesta. Por ejemplo, usar modelos pequeños y grandes según el tipo de procesamiento para encontrar el punto de equilibrio entre costo y precisión.
Resumen: La IA cambia también la velocidad del lado que la crea, pero el efecto no es uniforme. En el experimento de Peng et al. (2023), los usuarios que utilizaban complemento de IA completaron tareas 55.8% más rápido, mientras que en el ensayo controlado aleatorizado de METR (2025), desarrolladores experimentados usando herramientas de IA en bases de código que conocían bien tardaban un promedio de 19% más tiempo, y aunque percibían que iban más rápido. Por ejemplo, el efecto de la IA debe medirse no por percepción sino por lead time y tasa de fallos en cambios.
Proceso de desarrollo de productos
Partes interesadas
A continuación, los roles involucrados en el desarrollo de productos se dividen en 7 líneas; para cada línea se organiza un resumen y el papel de los principales actores (condiciones y elementos que asume, autoridad para decisiones, indicadores a verificar).
Línea de productos
Resumen: Gestor de productos (responsable de qué se construye y de los resultados), propietario del producto (responsable del backlog en Scrum), gestor de programa y scrum master (progresión y eliminación de obstáculos). Se relacionan principalmente con A (valor), D (viabilidad empresarial), ⑪ (proceso de desarrollo y operación). Por ejemplo, en organizaciones pequeñas, el gestor de productos combina el rol de propietario del producto y gestión de la progresión.
Gestor de productos: Responsable de A (valor) y D (viabilidad empresarial), supervisa el problema del cliente, propuesta de valor, PMF, economía unitaria y alineación estratégica. Horowitz (2014) llamó al buen gestor de productos el "CEO del producto" y lo definió como alguien que no pone excusas y asume responsabilidad por los resultados. Los indicadores a verificar son encuesta de PMF, tasa de retención, LTV/CAC, logro de OKR. Por ejemplo, toda propuesta de nueva funcionalidad debe acompañarse de la hipótesis a validar y el cambio esperado en indicadores.
Línea de diseño
Resumen: Diseñador de UX/UI (diseño de pantalla e interacción), investigador UX (estudios de usuarios), redactor técnico (textos, ayuda, documentación). Se relacionan principalmente con B (usabilidad) y ⑱ (calibración de confianza). Por ejemplo, cómo visualizar el nivel de confianza de la IA es un diseño conjunto del diseñador y el ingeniero de datos/ML.
Diseñador: Responsable de B (usabilidad), supervisa usabilidad, flujo de uso continuado, accesibilidad, atractivo y consistencia. Los indicadores a verificar son tasa de finalización de tareas, SUS, conformidad WCAG, adherencia al sistema de diseño. Por ejemplo, realizar pruebas de usabilidad con 5 usuarios antes del lanzamiento y compartir resultados en trío.
Línea de ingeniería de software
Resumen: Ingenieros de backend, frontend, móvil, infraestructura/SRE, seguridad, datos/machine learning, y aseguramiento de calidad (QA)/testing. Se relacionan principalmente con C (calidad técnica) y F (condiciones específicas de productos de IA). Por ejemplo, el SLO es definido conjuntamente por backend y SRE, y QA verifica independientemente el cumplimiento.
Ingeniero de backend: Responsable de ⑧ (arquitectura y mantenibilidad), ⑨ (confiabilidad y rendimiento), ⑩ (seguridad), y asume diseño de modelo de datos y API, gestión de deuda técnica, cumplimiento de SLO. Los indicadores a verificar son lead time de cambios, tasa de fallos en cambios, cobertura de pruebas, número de vulnerabilidades. Por ejemplo, en revisión de diseño se verifica que el alcance del cambio esté contenido en un solo módulo.
Ingeniero de frontend: Responsable de la realización técnica de ④ (usabilidad) y ⑥ (accesibilidad), rendimiento percibido de ⑨ (velocidad de visualización, responsividad), e implementación del sistema de diseño. Los indicadores a verificar son velocidad de visualización (Core Web Vitals, etc.), inspección automática de accesibilidad, tasa de defectos en UI. Por ejemplo, medir automáticamente en cada lanzamiento si la visualización de pantallas principales se mantiene dentro del tiempo objetivo.
Ingeniero de infraestructura/SRE: Responsable de ⑨ (confiabilidad, rendimiento, escalabilidad), ⑩ (seguridad), ⑪ (proceso de desarrollo y operación), y asume operación de SLO y presupuesto de errores, establecimiento de CI/CD y plataforma interna, respuesta a incidentes y postmortem (Beyer et al., 2016). DORA (2025) identifica una plataforma interna de alta calidad como una de las capacidades que amplifican la efectividad de la IA. Los indicadores a verificar son tasa de cumplimiento de SLO, tiempo de recuperación, frecuencia de despliegue, costo en la nube. Por ejemplo, cuando se agota el presupuesto de errores, tiene autoridad para detener nuevas funcionalidades y dedicarse a la estabilización.
Ingeniero de datos/machine learning: Responsable de F (condiciones específicas de productos de IA), y asume preparación de conjunto de datos de evaluación, medición de precisión, diseño del ciclo de aprendizaje, gestión de costos de inferencia. Los indicadores a verificar son precisión en el conjunto de evaluación, tasa de corrección humana, costo de inferencia por uso. Por ejemplo, cambios de modelo o instrucciones no se lanzan sin resultados de comparación en el conjunto de evaluación.
Aseguramiento de calidad (QA): Verifica independientemente que todos los requisitos cumplen el nivel de logro establecido, proporcionando materiales de evaluación en cada etapa. Los indicadores a verificar son tasa de aprobación de pruebas, número de defectos críticos, resultados de pruebas de regresión. Por ejemplo, al finalizar Phase 4, presentar evidencia del nivel de logro de cada elemento.
Línea de ingeniería de hardware
Resumen: Cada uno de los especialistas en diseño mecánico, diseño eléctrico/electrónico, firmware/software embebido, fabricación y tecnología de producción, adquisición y cadena de suministro, certificación y conformidad regulatoria. Se relacionan principalmente con E (condiciones específicas de hardware) y ⑨ (confiabilidad), ⑬ (regulación, seguridad). Por ejemplo, las certificaciones por país del módulo inalámbrico se planifican desde la etapa de diseño por ingeniería eléctrica y el responsable de certificación.
Ingeniero de hardware (mecánica, eléctrica, fabricación): Responsable de ⑯ (manufacturabilidad, suministro, calidad física), y asume DFMA, adquisición de componentes, validación en cada etapa de prototipado, obtención de certificaciones. Los indicadores a verificar son rendimiento, costo de BOM, tasa de fallos, estado de obtención de certificaciones. Por ejemplo, al finalizar DVT se decide congelar la forma para producción y la lista de materiales.
Línea de negocios
Resumen: Ventas, éxito del cliente/soporte, marketing, legal/cumplimiento normativo, finanzas. Se relacionan principalmente con A (valor), ⑫ (economía unitaria), ⑬ (regulación, seguridad, ética). Por ejemplo, las razones de cancelación de clientes de éxito del cliente se reportan mensualmente al gestor de productos.
Ventas/Éxito del cliente: Son la ruta de retroalimentación de problemas e insatisfacción del cliente hacia el producto, y fuente de información para A (valor) y ⑫ (economía unitaria). Los indicadores a verificar son razón de cancelación, período de implementación, número de consultas por tipo. Por ejemplo, reportar mensualmente en trío la razón de cancelación de clientes que se cancelaron.
Partes interesadas externas
Resumen: Clientes (se distingue entre responsables de decisión de compra y usuarios finales), socios de diseño (clientes que colaboran en evaluación inicial), socios/proveedores, autoridades regulatorias y organismos de certificación. Son principalmente fuentes de información para A (valor), y también son restricciones en ⑬ y ⑯. Por ejemplo, en B2B, los responsables de compra priorizan ⑫ y ⑬ mientras que los usuarios finales priorizan ④ y ⑤, por lo que es necesario escuchar a ambos.
Cliente (Socio de Diseño): es la fuente de información sobre los desafíos y el validador de las soluciones. Se define explícitamente el rol de los clientes iniciales como "Socios de Diseño" que cooperan en entrevistas regulares y evaluaciones de prototipos (Blank, 2013). Por ejemplo, se establecen reuniones mensuales de evaluación con cinco empresas iniciales para obtener comentarios desde la etapa de prototipo.
Gestión
Descripción general: directivos y fundadores, consejeros e inversores. Se relacionan principalmente con ⑮ (alineación estratégica), ⑫ (economía unitaria), ⑭ (defensibilidad) y asignación de recursos. Por ejemplo, el directivo establece objetivos de desempeño trimestral y delega las decisiones individuales de soluciones al trío (Cagan & Jones, 2020).
Directivos y Fundadores: se encargan de la visión y estrategia del producto, el establecimiento de objetivos de desempeño y la asignación de recursos, delegando las decisiones sobre soluciones individuales al trío (Cagan & Jones, 2020). Los indicadores a verificar son: logro de OKR, PMF, economía unitaria y riesgos regulatorios. Por ejemplo, proporcionan objetivos de desempeño trimestral sin indicar características específicas.
Proceso de Desarrollo
Los 20 elementos no se cumplen todos a la vez, sino que se satisfacen progresivamente a través de ciclos repetidos de descubrimiento y validación. A continuación, se divide el flujo de desarrollo en 6 fases, enumerando cronológicamente los elementos a verificar en cada fase, junto con las partes interesadas responsables, los métodos de validación y los niveles de logro.
Fase 1: Descubrimiento de Desafíos del Cliente
Corresponde a la etapa de desarrollo del cliente de Blank (2013) y al descubrimiento continuo de Torres (2021), donde se verifica la existencia y gravedad del desafío antes de comenzar el desarrollo.
① Gravedad del Desafío y Segmento de Cliente
Partes Interesadas: Gerente de Producto y Cliente (Socio de Diseño), Ventas y Éxito del Cliente.
Método de Validación: Entrevistas continuas con clientes (Fitzpatrick, 2013) que cuestionen el comportamiento pasado, realizadas con una frecuencia de al menos una por semana (Torres, 2021), cuantificando la frecuencia de ocurrencia del desafío, tiempo requerido y cantidad pagada.
Nivel de Logro: Al menos 20 entrevistas completadas con el segmento objetivo. El 60% o más de clientes mencionan espontáneamente el mismo desafío. La frecuencia de ocurrencia del desafío es de al menos una vez por semana. El 80% o más de clientes pueden identificar la cantidad pagada o el tiempo dedicado a soluciones alternativas actuales (trabajo manual, herramientas existentes).
⑮ Alineación Estratégica
Partes Interesadas: Gerente de Producto y Directivos.
Método de Validación: Comparación del documento estratégico con objetivos de desempeño (OKR) (Cagan & Jones, 2020).
Nivel de Logro: La hipótesis estratégica que esta iniciativa valida está descrita en una sola oración. Se han identificado uno o más objetivos de desempeño trimestral que contribuyen, y el cambio esperado en el indicador de objetivo está escrito numéricamente (ejemplo: mejorar la tasa de retención en 5 puntos porcentuales).
⑬ Regulación, Seguridad y Ética
Partes Interesadas: Gerente de Producto y Directivos (en hardware, responsables de certificación y cumplimiento normativo).
Método de Validación: Inventario de regulaciones aplicables y evaluación de riesgos (NIST, 2023).
Nivel de Logro: Se ha completado una tabla de inventario de regulaciones aplicables (datos personales, protección del consumidor, leyes sectoriales, seguridad de productos, regulación de IA), y no hay regulaciones sin responsable asignado. Se ha completado la clasificación de riesgos según leyes como la ley de IA de la UE (European Parliament and Council, 2024a) para determinar si aplica clasificación de alto riesgo. El 100% de los elementos identificados como alto riesgo en la evaluación de riesgos cuenta con medidas de mitigación documentadas.
⑭ Defensibilidad
Partes Interesadas: Gerente de Producto y Directivos.
Método de Validación: Estimación del costo de cambio y análisis competitivo.
Nivel de Logro: Se ha definido al menos una razón por la que se retendría a los clientes si fuera imitado (costo de cambio, datos acumulados, efectos de red, bienes complementarios), y se ha establecido al menos un indicador adelantado que mida su fortaleza (ejemplo: volumen de datos acumulados por cliente, número de sistemas integrados). Existe una tabla comparativa que incluye al menos 3 competidores principales, mostrando la disponibilidad de funcionalidades equivalentes y precios.
Fase 2: Conceptualización del Producto
Es la etapa donde se validan en prototipo los 4 riesgos de Cagan (2017) antes de comenzar el desarrollo. En hardware, se valida mediante maquetas y producción paralela (Dow et al., 2010) antes del molde.
② Propuesta de Valor y Ventaja Relativa
Partes Interesadas: Gerente de Producto y Diseñador.
Método de Validación: Tabla comparativa con alternativas, encuesta de Kano (Witell et al., 2013), entrevista utilizando prototipos. Como la ventaja del producto tiene el mayor impacto entre los factores de éxito (Cooper & Kleinschmidt, 1987), se presentan mejoras en términos numéricos.
Nivel de Logro: El 70% o más de clientes que ven el prototipo pueden explicar con sus propias palabras por qué usarían esto en lugar de otras alternativas. En la encuesta de Kano, las funcionalidades principales se clasifican como cualidad atractiva o cualidad de desempeño. La mejora respecto a alternativas es evidente en indicadores clave (ejemplo: reducción de tiempo de trabajo del 50% o más).
④ Usabilidad
Partes Interesadas: Diseñador y Gerente de Producto.
Método de Validación: Pruebas de usabilidad con aproximadamente 5 usuarios (Nielsen, 2000), realizadas múltiples veces mientras se mejora el prototipo.
Nivel de Logro: La tasa de finalización de tareas principales es del 80% o superior (Nielsen, 2000) (el promedio reportado por Sauro & Lewis, 2016 es del 78%). Se repiten correcciones hasta que ya no hay problemas en los que dos o más personas tengan dificultades en el mismo lugar. El tiempo requerido para tareas principales es menor que con las alternativas actuales.
⑫ Economía Unitaria
Partes Interesadas: Gerente de Producto y Directivos.
Método de Validación: Entrevista sobre aceptación de precio y proyección de ingresos y gastos basada en cohortes supuestas.
Nivel de Logro: Con el precio y costo supuestos, LTV/CAC es 3 o superior, y el período de recuperación de CAC es de 12 meses o menos (Skok, 2013). En la entrevista sobre aceptación de precio, menos del 30% de respondientes contesta que el precio supuesto es "demasiado alto". En hardware, el margen bruto que incluye costo de BOM, gastos de fabricación y logística cumple con el objetivo (ejemplo: 40% o superior).
⑯ Manufactura y Suministro
Partes Interesadas: Ingeniero de Hardware (mecanismo, eléctrica, manufactura) y Responsable de Adquisiciones.
Método de Validación: Revisión DFMA (Boothroyd et al., 2011) y confirmación de tiempos de entrega de componentes.
Nivel de Logro: Se han establecido valores objetivo para cantidad de componentes y tiempo de ensamblaje, y se ha presentado una propuesta que reduce componentes en 20% o más respecto al diseño inicial. Se han identificado todos los componentes de proveedor único, y el 100% de ellos cuenta con una política de componentes alternativos o inventario. El tiempo de entrega de componentes principales se ajusta al margen de la plan de producción (ejemplo: 4 semanas).
⑰ Precisión y Evaluación
Partes Interesadas: Ingeniero de Datos y Machine Learning y Gerente de Producto.
Método de Validación: Creación de conjunto de evaluación a partir de casos reales anteriores y verificación de la tasa de concordancia entre evaluadores. Si se usa evaluación automática, se verifica la concordancia con evaluación manual (Zheng et al., 2023).
Nivel de Logro: Existe un conjunto de evaluación que refleja la distribución de datos reales con al menos 30 casos por tipo de error principal. La tasa de concordancia entre evaluadores es del 80% o superior. Se ha documentado el nivel de precisión deseado (ejemplo: tasa de errores graves inferior al 1%) y las acciones a tomar si no se alcanza.
Fase 3: Diseño del Producto
Es la etapa donde se asegura mediante el diseño la modificabilidad, confiabilidad, seguridad y accesibilidad antes de comenzar el desarrollo. Cuanto más anticipado sea el descubrimiento de problemas, mejor será el tiempo de desarrollo y la calidad (Thomke & Fujimoto, 2000).
⑧ Arquitectura y Mantenibilidad
Partes Interesadas: Ingeniero Backend.
Método de Validación: Revisión de diseño (límites de módulos, dirección de dependencias, duplicación) (Parnas, 1972).
Nivel de Logro: De los escenarios de cambio supuestos (aproximadamente 5), el 80% o más tienen un alcance de impacto limitado a un único módulo. No existen dependencias circulares entre módulos. Existe un plan que destina entre el 10% y el 20% del tiempo de desarrollo a la amortización de deuda técnica (Besker et al., 2019 reportan que la deuda genera pérdidas equivalentes a aproximadamente el 23% del tiempo de desarrollo).
⑨ Confiabilidad, Rendimiento y Escalabilidad
Partes Interesadas: Ingeniero Backend, Ingeniero de Infraestructura y SRE, Ingeniero de Hardware.
Método de Validación: Documentación de SLO, revisión de diseño con tolerancia a fallos (Nygard, 2018), plan de pruebas de carga.
Nivel de Logro: Para cada función principal se han documentado SLO (ejemplo: disponibilidad 99.9%, percentil 95 de tiempo de respuesta 1 segundo o menos) y presupuesto de error (disponibilidad 99.9% equivale a aproximadamente 43 minutos al mes) (Beyer et al., 2016). En hardware, se han definido la tasa de fallos anual objetivo (ejemplo: menor al 1%) y las condiciones de pruebas de durabilidad y ambientales (temperatura, humedad, caída, vibración) junto con la cantidad de pruebas.
⑩ Seguridad y Privacidad
Partes Interesadas: Ingeniero Backend e Ingeniero de Infraestructura y SRE (si existe responsable de seguridad, esa persona).
Método de Validación: Modelado de amenazas y revisión de diseño basada en OWASP Top 10 (OWASP, 2021; Cavoukian, 2009).
Nivel de Logro: El 100% de las amenazas de alto riesgo identificadas en el modelado de amenazas cuentan con medidas reflejadas en el diseño. El 100% de elementos de datos personales tienen definido período de retención y procedimiento de eliminación. Se han documentado medidas de diseño para cada elemento de OWASP Top 10.
⑥ Accesibilidad e Internacionalización
Partes Interesadas: Diseñador e Ingeniero Frontend (en hardware, responsable de certificación y cumplimiento normativo).
Método de Validación: Verificación de accesibilidad del diseño e inventario de requisitos regionales (W3C, 2023).
Nivel de Logro: El diseño cumple en la etapa de diseño con todos los criterios de conformidad AA de WCAG 2.2 (ejemplo: razón de contraste de texto 4.5:1 o superior) (W3C, 2023). Se han completado tablas de requisitos para cada región objetivo incluyendo idioma, moneda, formato de fecha, especificaciones de fuente de alimentación y autenticación inalámbrica.
⑱ Confianza en IA e Intervención Humana
Partes Interesadas: Ingeniero de Datos y Machine Learning y Diseñador.
Método de verificación: Confirmación de conformidad con las directrices de Amershi et al. (2019) y las indicaciones de PAIR (2019).
Nivel de logro: Existe un diseño que muestra el nivel de confianza o fundamento en los resultados de la IA, con una tasa de conformidad del 100% en los elementos aplicables de las 18 directrices de Amershi et al. (2019). Se identifican los procesos que requieren verificación humana y se establecen objetivos de tiempo para la confirmación y corrección (por ejemplo, 30 segundos o menos por elemento).
⑳ Costo y velocidad de respuesta
Partes interesadas: Ingenieros de datos y aprendizaje automático e ingenieros de infraestructura y SRE.
Método de verificación: Estimación de costos y tiempo de respuesta por tipo de procesamiento, diseño de estrategia de modelos.
Nivel de logro: Se estima el costo de inferencia por uso para cada tipo de procesamiento, y la proporción del costo de inferencia respecto a los ingresos se mantiene dentro del objetivo (por ejemplo, menos del 20%). El objetivo de tiempo de respuesta se define para cada procesamiento basándose en los tres límites de Nielsen (1993) (0,1 segundos, 1 segundo, 10 segundos) (por ejemplo, el procesamiento interactivo dentro de 10 segundos, y mostrar progreso para lo que supera esto).
Fase 4: Implementación y verificación del producto
Una fase en la que se construye frecuentemente en pequeña escala y se verifica en cada etapa. En hardware, como en el modelo de etapas de Cooper (1990), se decide en cada fase si continuar o interrumpir, ya que los moldes y componentes se confirman en las etapas de verificación tecnológica (EVT), verificación de diseño (DVT) y verificación de producción (PVT) (Fadell, 2022).
⑪ Proceso de desarrollo y operaciones
Partes interesadas: Ingenieros de infraestructura y SRE, e ingenieros en general.
Método de verificación: Medición continua de cuatro indicadores: frecuencia de despliegue, tiempo de entrega de cambios, tasa de fallos de cambios y tiempo de recuperación (Forsgren et al., 2018; DORA, 2025).
Nivel de logro: Nivel del grupo superior de DORA (2024): frecuencia de despliegue bajo demanda (múltiples veces al día), tiempo de entrega de cambios menor a 1 día, tasa de fallos de cambios del 5% o menos, tiempo de recuperación de despliegues fallidos menor a 1 hora. Después de usar IA, la tasa de fallos de cambios no debe empeorar (DORA, 2025).
④ Usabilidad
Partes interesadas: Ingenieros de frontend y diseñadores.
Método de verificación: Pruebas de usabilidad después de la implementación (Nielsen, 2000) y medición de SUS (Sauro & Lewis, 2016), integración de medición automática de Core Web Vitals en CI (Walton, 2020).
Nivel de logro: Tasa de finalización de tareas principales del 90% o superior. SUS de 68 o superior (valor promedio. Sauro & Lewis, 2016), idealmente 80 o superior. Core Web Vitals: LCP dentro de 2,5 segundos, INP dentro de 200 milisegundos, CLS de 0,1 o menos (Walton, 2020).
⑥ Accesibilidad e internacionalización
Partes interesadas: Ingenieros de frontend y diseñadores (en hardware, personal responsable de autenticación y cumplimiento normativo).
Método de verificación: Integración de inspección automática de accesibilidad (herramientas de inspección de conformidad con WCAG) en CI y confirmación de operación con tecnologías de asistencia (lectores de pantalla, operación únicamente con teclado), confirmación de visualización por región de destino (idioma, moneda, formato de fecha). En hardware, se confirma en prototipos las especificaciones de energía de la región de destino y requisitos de autenticación inalámbrica.
Nivel de logro: Cero violaciones de WCAG 2.2 AA en la inspección automática (W3C, 2023). Con lector de pantalla y operación únicamente con teclado, tasa de finalización de tareas principales del 100%. Porcentaje de elementos de la tabla de requisitos por región creada en Phase 3 que se confirman en la implementación del 100%.
⑨ Confiabilidad y desempeño
Partes interesadas: Ingenieros de backend, ingenieros de infraestructura y SRE, ingenieros de hardware.
Método de verificación: Pruebas de carga e inyección de fallos (interrupción de dependencias) (Nygard, 2018). En hardware, pruebas de durabilidad y ambientales (temperatura, humedad, caídas, vibración) y pruebas de vida acelerada.
Nivel de logro: Bajo carga de 2 veces el pico esperado, el percentil 95 del tiempo de respuesta está dentro del SLO y la tasa de errores es menor al 0,1%. Ante la interrupción de dependencias, el sistema se degrada y se recupera automáticamente. En hardware, la tasa de aprobación de pruebas de durabilidad y ambiente es del 100%, y la tasa de fallos estimada de la prueba de vida acelerada está por debajo del objetivo (por ejemplo, menos del 1% anual).
⑩ Seguridad
Partes interesadas: Ingenieros de backend e ingenieros de infraestructura y SRE.
Método de verificación: Diagnóstico de vulnerabilidades, pruebas de penetración, inspección automática de bibliotecas de dependencias (NIST, 2022).
Nivel de logro: Cero vulnerabilidades sin resolver con severidad "alta" o superior en diagnóstico de vulnerabilidades y pruebas de penetración. Cero vulnerabilidades conocidas sin resolver en bibliotecas de dependencias (para severidad "media" o inferior se establece un plazo de respuesta). Tasa de ejecución de inspecciones de seguridad en CI del 100%.
⑯ Manufacturabilidad y suministro
Partes interesadas: Ingenieros de hardware y personal de manufactura y adquisición.
Método de verificación: Evaluación de prototipos en cada etapa de EVT, DVT y PVT, y medición de la tasa de paso directo (proporción que aprueba a la primera).
Nivel de logro: En EVT se confirma que la operación de funciones principales se verifica al 100% contra especificaciones. En DVT se congela la forma de producción y la lista de materiales, con cambios de diseño posteriores convergiendo a cero. En PVT, la tasa de paso directo de la línea de producción alcanza el objetivo (por ejemplo, 95% o superior), el tiempo de ensamblaje está dentro del tiempo objetivo, y se ha completado la obtención de autenticaciones (seguridad, compatibilidad electromagnética, inalámbrica).
⑰ Precisión y evaluación
Partes interesadas: Ingenieros de datos y aprendizaje automático, y QA.
Método de verificación: Ejecutar evaluación automática en conjunto de evaluación en cada lanzamiento y cotejar regularmente con evaluación manual (Zheng et al., 2023).
Nivel de logro: Precisión en conjunto de evaluación en o por encima del objetivo, con variación de 1 punto o menos en indicadores principales antes y después de cambios de modelo o instrucciones. Tasa de concordancia entre evaluación automática y manual del 80% o superior (nivel reportado por Zheng et al., 2023). Tasa de ejecución de evaluación en cada lanzamiento del 100%.
⑲ Bucle de aprendizaje de datos
Partes interesadas: Ingenieros de datos y aprendizaje automático.
Método de verificación: Medición de la tasa de recopilación de datos corregidos.
Nivel de logro: Para cada tipo de salida principal, tasa de implementación de mecanismos para registrar correcciones del usuario del 100%. Tasa de recopilación de datos corregidos (proporción de correcciones registradas entre los casos donde ocurren correcciones) del 90% o superior. Período desde la recopilación de datos hasta la adición al conjunto de evaluación de 1 mes o menos.
Fase 5: Operación y medición del producto
Una fase posterior al lanzamiento en la que se mide si realmente se está generando valor. El marco de medición utiliza AARRR (McClure, 2007) y HEART (Rodden et al., 2010), y los efectos de las iniciativas se verifican mediante pruebas A/B (Kohavi et al., 2020). Consulte el artículo separado "OMTM y KPI que deben lograrse en cada etapa para startups y negocios nuevos" para la métrica más importante por etapa de crecimiento (OMTM).
③ Ajuste producto-mercado
Partes interesadas: Gerente de producto.
Método de verificación: Encuesta de PMF, análisis de cohortes, NPS (Reichheld, 2003). En hardware, se sustituye por tasa de devolución y reseñas, o para dispositivos conectados, por tasa de operatividad.
Nivel de logro: Proporción de usuarios que responden "sería muy decepcionante si no pudiera usarlo" del 40% o superior (Ellis & Brown, 2017). La curva de retención de cohortes se aplana en 3 a 6 meses. NPS es positivo (aunque el poder predictivo de NPS únicamente tiene limitaciones, se utiliza junto con tasa de retención. Keiningham et al., 2007). En hardware, la tasa de devolución está dentro del objetivo (por ejemplo, menos del 3%) y la evaluación promedio de reseñas es de 4 o superior en una escala de 5 puntos.
⑤ Uso continuado y habituación
Partes interesadas: Gerente de producto y diseñador.
Método de verificación: Medición de tasa de activación, curva de retención, y los 5 indicadores de HEART.
Nivel de logro: Tasa de activación (proporción que llega desde registro hasta experiencia del valor principal) en objetivo (por ejemplo, 40% o superior). Retención mensual igual o mejorada respecto a la cohorte anterior. De los 5 indicadores de HEART, tasa de éxito de tareas y tasa de revisitas alcanzan los objetivos (Rodden et al., 2010).
⑨ Confiabilidad y desempeño
Partes interesadas: Ingenieros de infraestructura y SRE.
Método de verificación: Monitoreo de SLO y postmortem de incidentes (Beyer et al., 2016).
Nivel de logro: Tasa de cumplimiento de SLO mensual en objetivo o superior (por ejemplo, disponibilidad del 99,9%), con consumo de presupuesto de errores inferior al 100%. Tasa de ejecución de postmortem para incidentes críticos del 100%, con tasa de finalización dentro del plazo de medidas de prevención de recurrencia del 90% o superior.
⑫ Económica unitaria
Partes interesadas: Gerente de producto, ejecutivos, ventas y éxito del cliente.
Método de verificación: Agregación de ingresos y costos por cohorte.
Nivel de logro: LTV/CAC real de 3 o superior, período de recuperación de CAC de 12 meses o menos, tasa de retención neta de ingresos del 100% o superior (Skok, 2013). En hardware, margen bruto que incluye costos de garantía y devoluciones cumple con objetivo (por ejemplo, 40% o superior).
⑲ Bucle de aprendizaje de datos
Partes interesadas: Ingenieros de datos y aprendizaje automático.
Método de verificación: Agregación de historial de correcciones, comparación de precisión antes y después de mejora, auditoría de sesgo de datos.
Nivel de logro: Tasa de recopilación de datos corregidos del 90% o superior. Tasa de ocurrencia del mismo tipo de error disminuye mensualmente (por ejemplo, 30% de reducción trimestral). Comparación de precisión antes y después de mejora se registra en cada ocasión, y auditoría de sesgo de datos se realiza una o más veces por trimestre.
⑳ Costo y velocidad de respuesta
Partes interesadas: Ingenieros de infraestructura y SRE, e ingenieros de datos y aprendizaje automático.
Método de verificación: Medición continua de costos y tiempo de respuesta, medición del efecto de la estrategia de modelos.
Nivel de logro: Proporción del costo de inferencia respecto a ingresos dentro del objetivo (por ejemplo, menos del 20%). Percentil 95 del tiempo de respuesta dentro del objetivo para cada procesamiento. Se mide la magnitud de reducción de costos por estrategia de modelos.
Fase 6: Revisión y mejora
Es la etapa en la que los resultados de la medición se retroalimentan al siguiente plan. En software funciona en ciclos semanales o trimestrales, mientras que en hardware funciona en ciclos de generaciones (Fadell, 2022).
⑪ Procesos de desarrollo y operación
Partes interesadas: Ingenieros de infraestructura y SRE, así como todos los ingenieros.
Método de verificación: Revisión de lanzamientos y medición periódica de los 4 indicadores.
Nivel de logro: La variación trimestral de los 4 indicadores está estable o mejora (dirigiéndose hacia el nivel del grupo superior de DORA, 2024). La tasa de implementación de las acciones de mejora decididas en la revisión es de 80% o superior.
⑧ Arquitectura y mantenibilidad
Partes interesadas: Ingenieros de backend.
Método de verificación: Inventario de deuda técnica y seguimiento de cambios en el tiempo de entrega (Besker et al., 2019).
Nivel de logro: La tabla de inventario de deuda técnica se actualiza al menos una vez por trimestre. Se está utilizando realmente el 10-20% del tiempo de desarrollo para la amortización (80% o más respecto al plan). El tiempo de entrega de cambios no ha empeorado respecto al trimestre anterior.
⑭ Defensibilidad
Partes interesadas: Gerente de producto y ejecutivos.
Método de verificación: Seguimiento de tendencias competitivas y comparación de tasa de cancelación.
Nivel de logro: En el trimestre después de que los competidores lancen funciones equivalentes, el aumento de la tasa de cancelación es de 1 punto o inferior. Los indicadores adelantados de defensibilidad (cantidad de datos acumulados, número de sistemas integrados) han aumentado respecto al trimestre anterior.
⑮ Alineación con la estrategia
Partes interesadas: Gerente de producto y ejecutivos.
Método de verificación: Revisión de OKR (cotejando hipótesis y resultados como en el enfoque científico de Camuffo et al., 2020).
Nivel de logro: La tasa de logro de los objetivos de resultados del trimestre cumple con el objetivo (ejemplo: 70% o superior; no se exige el 100% porque se establecen objetivos ambiciosos). La tasa de documentación de rechazo o modificación de hipótesis que no pudieron lograrse es del 100%.
⑬ Regulación, seguridad y ética
Partes interesadas: Gerente de producto y ejecutivos.
Método de verificación: Actualización periódica del inventario regulatorio y auditoría externa.
Nivel de logro: El inventario regulatorio se actualiza al menos una vez al año, y se lleva a cabo al 100% antes de la expansión a nuevos mercados o usos. La tasa de respuesta dentro del plazo a los hallazgos de auditoría externa es del 100%.
⑯ Manufacturabilidad y suministro
Partes interesadas: Ingenieros de hardware y gerente de producto.
Método de verificación: Análisis de tasas de defectos y devoluciones en las primeras etapas de producción en masa (Fadell, 2022).
Nivel de logro: La tasa de defectos y devoluciones durante los primeros 3 meses después del inicio de la producción en masa se encuentran dentro del objetivo. Las 3 principales causas de defectos y devoluciones se reflejan en los cambios de diseño de la segunda generación.
③ Product-market fit
Partes interesadas: Gerente de producto.
Método de verificación: Implementación periódica de encuesta PMF y análisis de cohortes (Olsen, 2015).
Nivel de logro: Se implementa la encuesta PMF al menos una vez por trimestre, manteniendo que la proporción de "muy decepcionado" sea de 40% o superior. La tasa de retención no ha empeorado respecto al mismo período del año anterior.
Tendencias de investigación y práctica recientes
Tendencias de investigación reciente
La superioridad del producto es el factor número uno: Cooper & Kleinschmidt (1987) analizaron aproximadamente 200 nuevos productos y demostraron que los productos superior con beneficios únicos son los que más fuertemente diferencian el éxito del fracaso. Henard & Szymanski (2001) reportaron en un metaanálisis de 60 estudios que la superioridad del producto, el potencial de mercado, la satisfacción de las necesidades del cliente, la calidad de la planificación previa al desarrollo y la inversión de recursos de desarrollo se vinculaban consistentemente con el éxito, y Evanschitzky et al. (2012) en su metaanálisis actualizado también confirmaron los efectos de la superioridad del producto y la orientación al mercado. Por ejemplo, la fuerza de ventas o la publicidad pueden complementar pero no reemplazar el efecto de un producto superior.
Más funciones no siempre es mejor: Thompson et al. (2005) demostraron experimentalmente la "sobrecarga de características", donde los consumidores eligen productos con más funciones antes de comprar, pero cuando comienzan a usarlos, la satisfacción disminuye con los productos multifuncionales, al igual que la intención de recompra. Por ejemplo, el fenómeno en el que un producto que ganó en una comparación de cantidad de funciones es calificado como "difícil de usar" después del lanzamiento puede explicarse con esta investigación.
Las cualidades atractivas se convierten en ordinarias con el tiempo: Witell et al. (2013) resumieron 30 años de investigación del modelo de Kano y afirmaron que el "envejecimiento de la calidad", en el que las cualidades atractivas se transforman en cualidades unidimensionales y luego en cualidades esperadas, ha sido confirmado repetidamente. Por ejemplo, la cámara del smartphone ha pasado de ser una cualidad atractiva a una cualidad esperada, y ahora la calidad de imagen se compite como una cualidad unidimensional.
La belleza mejora la percepción de facilidad de uso: Kurosu & Kashimura (1995) encontraron una fuerte correlación entre la evaluación de la belleza visual y la evaluación de la facilidad de uso de las pantallas de cajeros automáticos, y Tractinsky et al. (2000) replicaron esto para confirmar que incluso cuando la facilidad de uso real es la misma, una pantalla hermosa es percibida como más fácil de usar. Por ejemplo, incluso con dos pantallas de solicitud con las mismas funciones, la que está ordenada se evalúa como "más comprensible" y la paciencia del usuario es mayor.
La participación del usuario se vincula con el éxito del sistema: Bano & Zowghi (2015) examinaron sistemáticamente 87 estudios que abordan la relación entre la participación del usuario y el éxito del desarrollo de sistemas, y reportaron que una relación positiva fue confirmada en la mayoría de los estudios. Por ejemplo, los proyectos en los que los usuarios participaron desde la etapa de definición de requisitos tienen menos retrabajo en la prueba de aceptación.
Factores que explican la adopción de tecnología: El UTAUT de Venkatesh et al. (2003), que integró el modelo de aceptación de tecnología de Davis (1989), reportó que cuatro factores —expectativa de desempeño, expectativa de esfuerzo, influencia social y condiciones facilitadoras— explican aproximadamente el 70% de la varianza en la intención de uso y el comportamiento de uso. Por ejemplo, en la implementación de sistemas empresariales, no solo la facilidad de uso, sino también la influencia social (jefes y colegas usando el sistema) y las condiciones facilitadoras (soporte) determinan la adopción.
Evidencia empírica en desarrollo de software: Forsgren et al. (2018) demostraron mediante investigación durante varios años que cuatro indicadores —frecuencia de despliegue, tiempo de entrega, tasa de fallos de cambios y tiempo de recuperación— se vinculan con el desempeño organizacional. DORA (2024) reportó que el mayor uso de IA se asoció con una disminución del 1.5% en el rendimiento y una disminución del 7.2% en la estabilidad, y DORA (2025) reportó que aunque el rendimiento mejoró, la inestabilidad continuó aumentando. Por ejemplo, según lo que sugiere la investigación, la adopción de IA debe proceder después de establecer primero los fundamentos de lotes pequeños y gestión de versiones.
Efectos del Agile: Serrador & Pinto (2015) analizaron 1,002 proyectos y demostraron que cuanto mayor es el grado de adopción de Agile, mayor es el éxito del proyecto tanto en eficiencia como en satisfacción de las partes interesadas. Por otro lado, Shepherd & Gruber (2021) organizaron qué aspectos de Lean Startup están comprobados y cuáles no, argumentando que se debe cuestionar el efecto de las prácticas individuales en lugar del nombre del método. Por ejemplo, un equipo que solo implementa las ceremonias de sprint sin aumentar los puntos de contacto con los clientes no logrará los efectos que demuestra la investigación.
Costo de la deuda técnica: Besker et al. (2019) reportaron que los desarrolladores dedican un promedio del 23% del tiempo de trabajo a tratar la deuda técnica. Por ejemplo, en un equipo de 5 personas, constantemente se pierden más de 1 equivalente de tiempo completo en intereses de deuda.
Seguridad psicológica y desempeño del equipo: Edmondson (1999) demostró que la "seguridad psicológica" —la sensación de que los errores no serán penalizados— aumenta el comportamiento de aprendizaje del equipo y su desempeño, y la investigación interna de Google (Rozovsky, 2015) analizó 180 equipos y reportó que la seguridad psicológica era el factor más fuerte que predecía la efectividad del equipo. Por ejemplo, el principio de SRE de no culpar a individuos en postmortems de incidentes (Beyer et al., 2016) se alinea con esta investigación.
La productividad no puede medirse con un solo indicador: El marco SPACE de Forsgren et al. (2021) conceptualiza la productividad del desarrollador en cinco dimensiones —satisfacción, desempeño, actividad, comunicación y eficiencia— y señala el peligro de medir con un único indicador de actividad como el número de commits. Por ejemplo, si el número de líneas de código aumenta con IA pero aumenta el tiempo de espera de revisión, la productividad no ha mejorado.
Efectos del enfoque científico: El ensayo controlado aleatorizado de Camuffo et al. (2020) y la replicación a gran escala de Camuffo et al. (2024) demostraron que el entrenamiento en articular y verificar hipótesis produce retiradas tempranas de empresas sin perspectivas y mejora de ingresos. Por ejemplo, incluso con el mismo Lean Startup, un equipo que escribe y verifica hipótesis producirá resultados diferentes de uno que simplemente repite prototipos.
Resolución de problemas anticipada y prototipado paralelo: Thomke & Fujimoto (2000) demostraron a partir de datos de desarrollo de Toyota que anticipar el descubrimiento y resolución de problemas en las primeras etapas del desarrollo mejora el tiempo de desarrollo y la calidad, y Dow et al. (2010) demostraron experimentalmente que prototipar múltiples conceptos en paralelo resulta en mejor diseño y exploración más diversa que refinar secuencialmente un concepto. Por ejemplo, para una carcasa de hardware, prototipar 3 conceptos simultáneamente antes del molde produce mejores resultados que revisar 1 concepto 5 veces.
La realidad de la experimentación en línea: Kohavi et al. (2020) reportaron a partir de la experiencia de numerosas pruebas A/B en Microsoft y Bing que solo aproximadamente un tercio de las iniciativas destinadas a mejorar realmente mejoran el indicador clave, y organizaron métodos confiables de diseño experimental. Por ejemplo, incluso con la idea de que "este cambio definitivamente mejorará", más de la mitad no tienen efecto o empeoran, por lo que es necesaria la disciplina de medir antes de expandir.
Colaboración entre humanos e IA: Bansal et al. (2021) demostraron que las explicaciones de IA pueden fortalecer la excesiva confianza del usuario, y Buçinca et al. (2021) demostraron que las intervenciones que estimulan la reflexión reducen la excesiva confianza. Por ejemplo, la UI de productos con IA no se vuelve segura simplemente aumentando explicaciones; se necesita un diseño que genere confirmación del usuario.
IA generativa y productividad: Brynjolfsson et al. (2025) informaron que el apoyo de IA generativa en servicio al cliente aumentó el volumen de casos procesados en promedio 14%, con un aumento de 34% para personal menos experimentado, mientras que en profesionales experimentados apenas cambió. Peng et al. (2023) encontraron que los usuarios de complemento de IA completaron tareas de programación 55.8% más rápido, y Dell'Acqua et al. (2023) reportaron en un experimento con consultores un "límite dentado" donde la calidad mejoró 40% en tareas donde la IA es fuerte, pero la precisión disminuyó 19 puntos porcentuales en tareas donde es débil. METR (2025) reportó que cuando desarrolladores experimentados usaban IA en bases de código que conocían bien, el tiempo de trabajo aumentaba 19%. Por ejemplo, como el efecto de la IA puede ser positivo o negativo dependiendo del tipo de trabajo y el nivel de experiencia del usuario, es necesario medirlo en los procesos propios de su empresa.
Métodos de evaluación de IA: Zheng et al. (2023) demostraron que usar modelos de lenguaje potentes como evaluadores coincide aproximadamente 80% con evaluadores humanos, un nivel similar a la concordancia entre humanos. Stanford HAI (2025) señala que muchos de los benchmarks públicos están saturados y la brecha con problemas reales se está ampliando. Por ejemplo, ejecutar evaluación automática en conjuntos de evaluación propios como pruebas de regresión en cada lanzamiento, y cotejar regularmente con evaluación manual, es la implicación de ambos estudios.
Patrones oscuros y realidad de la accesibilidad: Mathur et al. (2019) analizaron automáticamente aproximadamente 11,000 sitios de compras e informaron que aproximadamente 11% contenía "patrones oscuros" que engañaban a los usuarios. WebAIM (2024) reportó que 95.9% de las páginas de inicio de los sitios más visitados tenía violaciones de WCAG detectables automáticamente. Por ejemplo, antes de implementar diseños para aumentar la retención, verificar usando clasificaciones publicadas si constituyen patrones oscuros, e integrar inspecciones de accesibilidad en CI es el estándar mínimo.
Limitaciones del NPS: Keiningham et al. (2007) verificaron la afirmación de que NPS (Net Promoter Score) es superior a otros indicadores de satisfacción del cliente para predecir el crecimiento empresarial y reportaron que no pudieron confirmar esa ventaja. Por ejemplo, la implicación de la investigación es usar NPS no como indicador único de predicción de crecimiento, sino combinado con tasa de retención y razones de cancelación.
Tendencias de profesionales actuales
Sobre el valor: El lema de Y Combinator "construye algo que la gente quiera" (Graham, 2013), la "obsesión por el cliente" de Bezos (2017) y el "empezar por la experiencia del cliente y retroceder hacia la tecnología" de Jobs (1997) todos colocan A (valor) en el nivel más alto. Por ejemplo, Amazon tiene la práctica de colocar una silla vacía para el cliente en reuniones, haciendo que la perspectiva del cliente sea obligatoria (Bryar & Carr, 2021).
Voz del cliente versus visión: Blank (2013) y Torres (2021) enfatizan aprender de los clientes, mientras que Jobs señaló que las personas a menudo no saben lo que quieren hasta que se les muestra (Jobs, 1998). La división de roles es: aprender los problemas de los clientes, mientras que los creadores conciben y verifican las soluciones. Por ejemplo, los clientes piden "caballos más rápidos", pero el problema "quiero moverme más rápido" es correcto, y la solución (el automóvil) la conciben los creadores.
Sobre usabilidad y atractivo: "No hagas pensar" de Krug (2014), "diseño minimalista" de Rams (Vitsœ, n.d.), y "si te concentras en los usuarios, todo lo demás vendrá después" de Google (n.d.) son principios de B (usabilidad). Por ejemplo, la página de búsqueda en blanco de Google es la expresión física de este principio.
Agregar funciones versus restar: El modelo Kano enfatiza agregar cualidad atractiva, mientras que Rams y Musk enfatizan restar. Musk presentó el orden: cuestionarse los requisitos, eliminar partes y procesos, simplificar, acelerar, automatizar, diciendo que no se debe automatizar antes de eliminar (Everyday Astronaut, 2021). Ambos no se contradicen; es una cuestión de eje temporal: agregar solo funciones de cualidad atractiva, y simplificar las funciones que se han convertido en cualidad esperada. Por ejemplo, al proponer una nueva función, agregue "¿qué eliminaría a cambio?", y juzgue regularmente la eliminación de funciones no utilizadas.
Sobre la calidad técnica: "Agregar personas a un proyecto atrasado lo retrasa más" de Brooks (1995), error budget de Beyer et al. (2016), y "se completa en 3 generaciones" de Fadell (2022) tratan C (calidad técnica) no como la búsqueda de ideales sino como gestión de restricciones. Por ejemplo, error budget es un mecanismo que resuelve el conflicto entre estabilidad y nuevas funciones con números.
Operación que compatibiliza velocidad y calidad: Shape Up de Singer (2019) encaja el trabajo en un período fijo de 6 semanas, Working Backwards de Bryar & Carr (2021) calcula hacia atrás desde un comunicado de prensa, y SRE de Beyer et al. (2016) usa error budget para equilibrar nuevas funciones y estabilidad. Como muestra la investigación de Forsgren et al. (2018), velocidad y estabilidad no son un dilema; ambas mejoran con la misma inversión (lotes pequeños, automatización). Por ejemplo, entregar tres meses de funciones de una vez es más lento que entregarlas cada dos semanas y observar la reacción; así se acorta el período en que avanza en la dirección equivocada.
Lanzar pronto o perfeccionar antes: Hoffman & Yeh (2018) afirman que si no te avergüenza tu primera versión, la lanzaste tarde, y Graham (2013) recomendó hacer "cosas que no escalan" en las primeras etapas, como adquirir clientes manualmente y apoyarlos. Sin embargo, como Dyson (2021) pasó por 5,127 prototipos antes del lanzamiento, los productos físicos requieren iteración antes de lanzar. Por ejemplo, el software se lanza pronto en versión limitada, mientras que el hardware acelera y amplifica la iteración de prototipos antes del lanzamiento.
Ver la realidad en el terreno: "Genba genbutsu" (lugar real, cosa real) de Toyota (Liker, 2004) hace un principio de confirmar hechos en el terreno en lugar de reportes, y el descubrimiento continuo de Torres (2021) requiere hacer entrevistas de cliente semanal como hábito fijo. Vohra (2018) publicó el procedimiento de clasificar respuestas abiertas de encuestas PMF para determinar prioridades de mejora. Por ejemplo, para clientes iniciales, el propio fundador realiza el trabajo de implementación, aprendiendo los problemas en ese proceso.
Sobre viabilidad empresarial y estrategia: "El buen gerente de producto es el CEO del producto y es responsable de los resultados" de Horowitz (2014), "equipos de producto, no equipos de funciones" de Cagan & Jones (2020), y la advertencia de Bezos (2017) sobre "el proceso convirtiéndose en el propósito" tratan D (viabilidad) no como funciones individuales sino como un problema de resultados. Por ejemplo, un equipo responsable de resultados (retención) es evaluado por retención, no por cantidad de funciones.
Transición a modelo de operación de producto: Cagan (2024) sistematizó como "modelo de operación de producto" la transición de "equipos de funciones" que completan solicitudes de funciones a "equipos de producto" responsables de resultados, y organizó qué comportamientos deben cambiar en ejecutivos, líderes de producto y equipos. Por ejemplo, reemplazar el roadmap de lista de funciones con una lista de objetivos de resultados trimestrales e hipótesis a verificar es el primer paso.
Forma de involucramiento del fundador: Graham (2024), basándose en la experiencia de Chesky de Airbnb, planteó el "Founder Mode" donde el fundador se involucra directamente en detalles, en contraste con el "Manager Mode" que enfatiza la delegación, generando debate entre profesionales. Hay una tensión con el principio de Cagan & Jones (2020) de "delegar soluciones al equipo". Por ejemplo, aunque el fundador se involucre en detalles del producto, la distinción es si lo hace sin comprometer la disciplina de objetivos de resultados y verificación.
Cambios en desarrollo por IA: Karpathy (2017) planteó "Software 2.0" donde el código escrito por humanos es reemplazado por modelos aprendidos, y dijo que el trabajo de desarrolladores se mueve de escribir código a preparar datos. DORA (2025) reporta que la IA amplifica las fortalezas y debilidades organizacionales. Por ejemplo, incluso si la generación de código con IA es más rápida, si la revisión y pruebas no acompañan, la tasa de cambios fallidos aumenta.
Centrar la evaluación en productos de IA: Husain (2024) afirma que el éxito de un producto de IA depende de construir un sistema de evaluación basado en datos reales, y recomienda tratar la evaluación como equivalente a requisitos de diseño. Esto es consistente con la investigación de Zheng et al. (2023) y Stanford HAI (2025). Por ejemplo, la práctica de no lanzar cambios de modelo o instrucciones sin comparación en el conjunto de evaluación propio es la implementación.
Puntos comunes en profesionales de hardware: "Se completa en 3 generaciones" de Fadell (2022), iteración de prototipos de Dyson (2021), el proceso de resta de Musk (Everyday Astronaut, 2021), y genba genbutsu de Toyota (Liker, 2004) coinciden en que en productos físicos, la cantidad y velocidad de prototipos, y la reducción de partes y procesos, determinan la calidad. Por ejemplo, se restringe la funcionalidad en la primera generación con un plan desde el inicio de reflejar lo aprendido en la segunda generación.
Línea entre hábito y ética: Eyal (2014) presentó un marco de dos preguntas—¿usarías tú mismo esto? ¿mejora la vida del usuario?—para juzgar si el diseño de hábito se puede justificar, y Google (PAIR, 2019) y Microsoft (Amershi et al., 2019) publicaron directrices de diseño para productos de IA. Contra la propagación de patrones oscuros mostrada por la investigación de Mathur et al. (2019), regulaciones como la Ley de IA de la UE (European Parliament and Council, 2024a) se suman como restricciones al diseño. Por ejemplo, juzgar las iniciativas para aumentar retención por si pueden explicarse a los usuarios.
Conclusión
En este artículo, descomponimos las condiciones para un buen producto en 6 condiciones y 20 elementos, y organizamos quién hace qué y a qué nivel en cada fase del desarrollo. Los valores de nivel de logro son referencias y se espera que se reemplacen según los resultados de cada empresa. Esperamos que sea útil como perspectiva integral al concebir un nuevo producto o revisar uno existente.
Referencias
Amershi, S., Weld, D., Vorvoreanu, M., Fourney, A., Nushi, B., Collisson, P., Suh, J., Iqbal, S., Bennett, P. N., Inkpen, K., Teevan, J., Kikin-Gil, R., & Horvitz, E. (2019). Guidelines for human-AI interaction. Proceedings of the 2019 CHI Conference on Human Factors in Computing Systems, Paper 3. Resumen: Investigadores de Microsoft organizaron más de 150 directrices de diseño en 18 pautas y validaron su validez mediante estudios de usuarios. Incluyen hacer explícito lo que la IA puede hacer y optimizar la corrección de errores, entre otros.
Andreessen, M. (2007). The only thing that matters. pmarchive. https://pmarchive.com/guide_to_startups_part4.html Resumen: Ensayo que define el ajuste producto-mercado como el único factor que determina el éxito de una startup, explicándolo como "estar en un buen mercado y tener un producto que lo satisfaga".
Bano, M., & Zowghi, D. (2015). A systematic review on the relationship between user involvement and system success. Information and Software Technology, 58, 148–169. Resumen: Revisión sistemática de 87 estudios sobre la relación entre la participación del usuario y el éxito del desarrollo de sistemas, informando que la mayoría confirmó una relación positiva.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, Article 81. Resumen: Experimento que demostró que cuando se añaden explicaciones a las decisiones de la IA, los usuarios tienden a seguirlas incluso cuando la IA se equivoca, y el desempeño de la colaboración humano-IA no mejora necesariamente.
Besker, T., Martini, A., & Bosch, J. (2019). Software developer productivity loss due to technical debt: A replication and extension study examining developers' development work. Journal of Systems and Software, 156, 41–61. Resumen: Basado en registros de trabajo de 43 desarrolladores, demostró que el 23% del tiempo de trabajo se dedica en promedio a abordar la deuda técnica.
Beyer, B., Jones, C., Petoff, J., & Murphy, N. R. (Eds.). (2016). Site reliability engineering: How Google runs production systems. O'Reilly Media. Resumen: Libro que resume las prácticas SRE de Google e introduce el concepto de objetivos de nivel de servicio (SLO) y presupuestos de errores, mostrando cómo equilibrar la confiabilidad y el desarrollo de nuevas funciones numéricamente.
Bezos, J. (2017). 2016 letter to shareholders. Amazon. Resumen: Carta a los accionistas que enumera como condiciones para mantener el "Day 1" la obsesión por el cliente, la resistencia a la instrumentalización de procesos, la aceptación de tendencias externas y la toma de decisiones rápida.
Blank, S. (2013). The four steps to the epiphany: Successful strategies for products that win (2nd ed.). K&S Ranch. Resumen: Libro que propone el modelo de "desarrollo del cliente" que valida a los clientes en paralelo con el desarrollo del producto, y sentó las bases para el Lean Startup.
Boothroyd, G., Dewhurst, P., & Knight, W. A. (2011). Product design for manufacture and assembly (3rd ed.). CRC Press. Resumen: Libro de texto que sistematiza la metodología DFMA para reducir el número de componentes y simplificar el ensamblaje durante la fase de diseño.
Brooke, J. (1996). SUS: A "quick and dirty" usability scale. In P. W. Jordan, B. Thomas, B. A. Weerdmeester, & I. L. McClelland (Eds.), Usability evaluation in industry (pp. 189–194). Taylor & Francis. Resumen: Propuesta de la Escala de Usabilidad del Sistema (SUS), que evalúa la usabilidad en una escala de 0 a 100 puntos mediante 10 preguntas.
Brooks, F. P. (1995). The mythical man-month: Essays on software engineering (Anniversary ed.). Addison-Wesley. Resumen: Clásico de la gestión de desarrollo de software que incluye la Ley de Brooks: "Añadir personas a un proyecto de software retrasado lo retrasa aún más".
Bryar, C., & Carr, B. (2021). Working backwards: Insights, stories, and secrets from inside Amazon. St. Martin's Press. Resumen: Libro de ex ejecutivos de Amazon que explica mecanismos como Working Backwards (comenzar con un comunicado de prensa y FAQ), el líder de un solo hilo y la silla vacía del cliente.
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889–942. Resumen: Estudio empírico que demostró que el apoyo de IA generativa en soporte al cliente aumentó el volumen procesado en promedio un 14%, con mayor efecto en personal menos experimentado.
Buçinca, Z., Malaya, M. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), Article 188. Resumen: Experimento que demostró que "funciones de forzamiento cognitivo", como hacer que los usuarios piensen por sí solos antes de ver las sugerencias de IA, reducen la confianza excesiva en la IA.
Cagan, M. (2017). Inspired: How to create tech products customers love (2nd ed.). Wiley. Resumen: Libro que estructura las condiciones para un buen producto en cuatro riesgos (valor, usabilidad, factibilidad y viabilidad comercial) y propone el Product Discovery para validarlos antes de construir.
Cagan, M. (2024). Transformed: Moving to the product operating model. Wiley. Resumen: Libro que sistematiza la transición de equipos funcionales a equipos de producto responsables de resultados como "modelo operativo de producto" y explica los pasos de la transformación.
Cagan, M., & Jones, C. (2020). Empowered: Ordinary people, extraordinary products. Wiley. Resumen: Libro que contrasta los "equipos funcionales" que cumplen solicitudes de funciones con los "equipos de producto" que se responsabilizan de los resultados y deciden sus propias soluciones, y analiza el liderazgo necesario para lograr estos últimos.
Camuffo, A., Cordova, A., Gambardella, A., & Spina, C. (2020). A scientific approach to entrepreneurial decision making: Evidence from a randomized control trial. Management Science, 66(2), 564–586. Resumen: Estudio que dividió aleatoriamente a 116 startups y demostró que los fundadores que aprendieron un enfoque científico (explicitar y verificar hipótesis) abandonaron negocios sin perspectivas más rápido y lograron mayores ganancias.
Camuffo, A., Gambardella, A., Messinese, D., Novelli, E., Paolucci, E., & Spina, C. (2024). A scientific approach to entrepreneurial decision-making: Large-scale replication and extension. Strategic Management Journal, 45(6), 1209–1237. Resumen: Replicación del experimento de 2020 en 759 empresas que confirmó que el efecto del enfoque científico se mantuvo.
Cavoukian, A. (2009). Privacy by design: The 7 foundational principles. Information and Privacy Commissioner of Ontario. Resumen: Documento que presenta 7 principios para integrar la privacidad desde la fase de diseño de manera preventiva en lugar de reactiva, como proteger la privacidad por configuración predeterminada.
Christensen, C. M., Hall, T., Dillon, K., & Duncan, D. S. (2016). Competing against luck: The story of innovation and customer choice. HarperBusiness. Resumen: Libro que explica la teoría Jobs to be Done —que los clientes contratan productos para realizar un "trabajo" específico— mediante casos como el del batido de leche.
Conway, M. E. (1968). How do committees invent? Datamation, 14(4), 28–31. Resumen: Artículo que presentó la "Ley de Conway": la estructura de un sistema refleja la estructura de comunicación de la organización que lo diseña.
Cooper, R. G. (1990). Stage-gate systems: A new tool for managing new products. Business Horizons, 33(3), 44–54. Resumen: Se propuso el método stage-gate, que divide el desarrollo de nuevos productos en etapas (stages) y puertas de decisión (gates), en las que se determina si continuar o detener el proyecto.
Cooper, R. G., & Kleinschmidt, E. J. (1987). New products: What separates winners from losers? Journal of Product Innovation Management, 4(3), 169–184. Resumen: Al analizar aproximadamente 200 nuevos productos, se demostró que los productos de alta calidad con beneficios únicos son el factor que más fuertemente separa el éxito del fracaso.
Cunningham, W. (1992). The WyCash portfolio management system. OOPSLA '92 Addendum to the Proceedings, 29–30. Resumen: Primer informe que utilizó la metáfora de la "deuda técnica", comparando el código escrito precipitadamente con una deuda cuya "tasa de interés" aumenta si no se reembolsa.
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. Resumen: Se propuso el Modelo de Aceptación Tecnológica (TAM), que explica la adopción tecnológica por parte de los usuarios mediante la utilidad percibida y la facilidad de uso percibida.
Dell'Acqua, F., McFowland, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2023). Navigating the jagged technological frontier: Field experimental evidence of the effects of AI on knowledge worker productivity and quality (Harvard Business School Working Paper 24-013). Resumen: Un experimento con 758 consultores mostró la "frontera dentada": la IA mejora la calidad en tareas donde destaca, pero disminuye la tasa de aciertos en tareas donde no.
DORA. (2024). Accelerate State of DevOps Report 2024. Google Cloud. Resumen: Una encuesta a aproximadamente 39,000 personas informó que el aumento del uso de IA estaba asociado con una disminución del 1.5% en el rendimiento y una disminución del 7.2% en la estabilidad.
DORA. (2025). 2025 DORA Report: State of AI-assisted software development. Google Cloud. Resumen: Una encuesta a aproximadamente 5,000 personas informó que la IA mejora el rendimiento pero aumenta la inestabilidad, que la IA amplifica las fortalezas y debilidades organizacionales, e identificó siete capacidades clave que determinan su efectividad.
Dow, S. P., Glassco, A., Kass, J., Schwarz, M., Schwartz, D. L., & Klemmer, S. R. (2010). Parallel prototyping leads to better design results, more divergence, and increased self-efficacy. ACM Transactions on Computer-Human Interaction, 17(4), Article 18. Resumen: Un experimento demostró que el prototipado paralelo de múltiples opciones genera mejores diseños, mayor exploración diversa y mayor autoeficacia que la mejora secuencial de una única opción.
Dyson, J. (2021). Invention: A life. Simon & Schuster. Resumen: La autobiografía del fundador de Dyson, que incluye el proceso de crear 5,127 prototipos antes de completar la aspiradora con tecnología de ciclo.
Edmondson, A. (1999). Psychological safety and learning behavior in work teams. Administrative Science Quarterly, 44(2), 350–383. Resumen: Se demostró que la seguridad psicológica —la confianza de que no será castigado por reportar fracasos— mejora el comportamiento de aprendizaje y el desempeño del equipo.
Ellis, S., & Brown, M. (2017). Hacking growth: How today's fastest-growing companies drive breakout success. Crown Business. Resumen: Se establece como referencia para PMF que al menos el 40% de los usuarios respondan "muy decepcionado" a la pregunta "¿Qué sentirías si ya no pudiera usar este producto?", y se explican métodos experimentales para el crecimiento.
European Parliament and Council. (2024a). Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union. Resumen: Una norma de la UE que clasifica los sistemas de IA según su nivel de riesgo y exige a los usos de alto riesgo documentación, supervisión humana y garantías de precisión y robustez.
European Parliament and Council. (2024b). Regulation (EU) 2024/2847 on horizontal cybersecurity requirements for products with digital elements (Cyber Resilience Act). Official Journal of the European Union. Resumen: Una norma de la UE que obliga a los productos con elementos digitales a garantizar la seguridad desde la fase de diseño y a proporcionar actualizaciones de seguridad después de la venta.
European Parliament and Council. (2024c). Directive (EU) 2024/2853 on liability for defective products. Official Journal of the European Union. Resumen: Una directiva modificada de la UE que extiende la responsabilidad por productos defectuosos al software y sistemas de IA, facilitando la indemnización por daños causados por defectos en productos digitales.
Evanschitzky, H., Eisend, M., Calantone, R. J., & Jiang, Y. (2012). Success factors of product innovation: An updated meta-analysis. Journal of Product Innovation Management, 29(S1), 21–37. Resumen: Una actualización del metaanálisis de Henard & Szymanski (2001) que confirmó que la superioridad del producto y la orientación al mercado siguen siendo factores fuertemente asociados al éxito de nuevos productos.
Everyday Astronaut. (2021). Starbase tour with Elon Musk [Part 1] [Video]. YouTube. Resumen: Una entrevista en la que Musk explica el proceso de cinco etapas del diseño y manufactura: cuestionar los requisitos, eliminar, simplificar, acelerar y automatizar.
Eyal, N. (2014). Hooked: How to build habit-forming products. Portfolio. Resumen: Se presenta un modelo que muestra que los hábitos se forman mediante un bucle de cuatro etapas —activador, acción, recompensa e inversión— y se aborda también su uso ético.
Fadell, T. (2022). Build: An unorthodox guide to making things worth making. Harper Business. Resumen: El autor de iPod y Nest explica que el hardware se perfecciona en tres generaciones, detalla el proceso de prototipado y validación progresiva (EVT, DVT, PVT) y la construcción de equipos.
First Round Review. (2015). From 0 to $1B: Slack's founder shares their epic launch strategy. First Round Review. Resumen: Butterfield, fundador de Slack, compartió que el producto se consolida cuando el equipo intercambia 2,000 mensajes, y explicó el enfoque del lanzamiento inicial.
Fitzpatrick, R. (2013). The mom test: How to talk to customers and learn if your business is a good idea when everyone is lying to you. CreateSpace. Resumen: Un libro de casos prácticos que establece el principio de que en las entrevistas con clientes se deben indagar comportamientos concretos del pasado en lugar de opiniones o promesas futuras.
Fogg, B. J. (2009). A behavior model for persuasive design. Proceedings of the 4th International Conference on Persuasive Technology, Article 40. Resumen: Se propuso el Modelo de Comportamiento de Fogg, que establece que el comportamiento ocurre cuando la motivación, la capacidad y el activador se alinean simultáneamente.
Forsgren, N., Humble, J., & Kim, G. (2018). Accelerate: The science of lean software and DevOps. IT Revolution. Resumen: Un estudio de varios años demostró que cuatro métricas —frecuencia de despliegue, tiempo de espera del cambio, tasa de fallos de cambio y tiempo de recuperación— están vinculadas al desempeño del desarrollo de software y al resultado empresarial.
Forsgren, N., Storey, M.-A., Maddila, C., Zimmermann, T., Houck, B., & Butler, J. (2021). The SPACE of developer productivity: There's more to it than you think. ACM Queue, 19(1), 20–48. Resumen: Se propuso el marco de trabajo SPACE, que captura la productividad de los desarrolladores en cinco dimensiones: satisfacción, desempeño, actividad, comunicación y eficiencia.
Fowler, M. (2018). Refactoring: Improving the design of existing code (2nd ed.). Addison-Wesley. Resumen: Un libro que cataloga técnicas de refactorización —mejora de la estructura interna sin cambiar el comportamiento externo del código.
Garvin, D. A. (1987). Competing on the eight dimensions of quality. Harvard Business Review, 65(6), 101–109. Resumen: Se divide la calidad del producto en ocho dimensiones: desempeño, características adicionales, confiabilidad, conformidad, durabilidad, mantenibilidad, estética y calidad percibida, argumentando que debe elegirse en qué dimensión competir.
Google. (n.d.). Ten things we know to be true. https://about.google/philosophy/ Resumen: Los diez principios de Google, encabezados por "Si nos enfocamos en el usuario, todo lo demás vendrá después".
Graham, P. (2013). Do things that don't scale. http://paulgraham.com/ds.html Resumen: Ensayo que argumenta que las startups tempranas deben hacer deliberadamente cosas que no escalan, como adquirir y apoyar clientes manualmente.
Graham, P. (2024). Founder mode. http://paulgraham.com/foundermode.html Resumen: Ensayo que propone el "founder mode", donde los fundadores se involucran directamente en los detalles, en contraste con el "manager mode" que enfatiza la delegación.
Henard, D. H., & Szymanski, D. M. (2001). Why some new products are more successful than others. Journal of Marketing Research, 38(3), 362–375. Resumen: Un metanálisis de 60 estudios empíricos demostró que la superioridad del producto, el potencial de mercado, la satisfacción de las necesidades del cliente, la planificación previa al desarrollo y la inversión de recursos en desarrollo se asocian consistentemente con el éxito de nuevos productos.
Hoffman, R., & Yeh, C. (2018). Blitzscaling: The lightning-fast path to building massively valuable companies. Currency. Resumen: Libro que explica estrategias de crecimiento acelerado e ideas sobre lanzar productos incompletos rápidamente, incluyendo la frase "Si no te avergüenza la primera versión, la lanzaste demasiado tarde".
Horowitz, B. (2014). The hard thing about hard things: Building a business when there are no easy answers. HarperBusiness. Resumen: Incluye el memorándum interno de 1996 "Good Product Manager / Bad Product Manager" y posiciona al product manager como el CEO del producto.
Husain, H. (2024). Your AI product needs evals. https://hamel.dev/blog/posts/evals/ Resumen: Artículo de un profesional que argumenta que la mejora de productos de IA requiere un sistema de evaluación basado en datos reales y explica cómo construir sistemas de evaluación.
ISO. (2018). ISO 9241-11:2018 Ergonomics of human-system interaction — Part 11: Usability: Definitions and concepts. International Organization for Standardization. Resumen: Norma internacional que define la usabilidad como el grado en que usuarios específicos pueden lograr objetivos específicos de manera efectiva, eficiente y satisfactoria.
ISO. (2019). ISO 9241-210:2019 Ergonomics of human-system interaction — Part 210: Human-centred design for interactive systems. International Organization for Standardization. Resumen: Norma internacional que establece el proceso de diseño centrado en el usuario, basado en los principios de comprensión del usuario y contexto, participación del usuario, e iteración evaluativa.
ISO/IEC. (2023). ISO/IEC 25010:2023 Systems and software engineering — Systems and software Quality Requirements and Evaluation (SQuaRE) — Product quality model. International Organization for Standardization. Resumen: Norma internacional que define la calidad de software mediante nueve características: adecuación funcional, eficiencia del desempeño, compatibilidad, capacidad de interacción, confiabilidad, seguridad, mantenibilidad, flexibilidad y seguridad operacional.
Jobs, S. (1997). Closing keynote Q&A at the 1997 Worldwide Developers Conference. Apple. Resumen: Sesión de preguntas y respuestas donde afirmó que "Hay que comenzar con la experiencia del cliente e ir hacia atrás hacia la tecnología".
Jobs, S. (1998). Steve Jobs: "There's sanity returning" [Interview]. BusinessWeek. Resumen: Entrevista donde afirmó que "Las personas frecuentemente no saben qué quieren hasta que se lo muestras" y expresó su postura de desarrollo de productos sin depender de estudios de mercado.
Karpathy, A. (2017). Software 2.0. Medium. Resumen: Propone el concepto de "Software 2.0", donde el código escrito por humanos es reemplazado por pesos de modelos aprendidos, argumentando que el trabajo del desarrollador se desplaza hacia la preparación de datos.
Keiningham, T. L., Cooil, B., Andreassen, T. W., & Aksoy, L. (2007). A longitudinal examination of net promoter and firm revenue growth. Journal of Marketing, 71(3), 39–51. Resumen: Examinó la afirmación de que NPS es superior a otros indicadores de cliente en la predicción del crecimiento y reportó que no se pudo confirmar su superioridad.
Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. Resumen: Explica el diseño de pruebas A/B a gran escala y sus trampa, reportando que solo una parte de las iniciativas destinadas a mejorar tienen un efecto real.
Krug, S. (2014). Don't make me think, revisited: A common sense approach to web usability (3rd ed.). New Riders. Resumen: Manual práctico de usabilidad web y aplicaciones que establece como principio fundamental no hacer que el usuario tenga que pensar.
Kurosu, M., & Kashimura, K. (1995). Apparent usability vs. inherent usability: Experimental analysis on the determinants of the apparent usability. CHI '95 Conference Companion on Human Factors in Computing Systems, 292–293. Resumen: Demostró mediante análisis experimental en pantallas de cajeros automáticos que la evaluación de la belleza estética y la evaluación de la facilidad de uso están fuertemente correlacionadas.
Levitt, T. (1980). Marketing success through differentiation—of anything. Harvard Business Review, 58(1), 83–91. Resumen: Argumenta que el valor del producto debe entenderse en capas: producto central, producto esperado, producto ampliado y producto potencial, y que la diferenciación ocurre en el producto ampliado.
Liker, J. K. (2004). The Toyota way: 14 management principles from the world's greatest manufacturer. McGraw-Hill. Resumen: Explica los 14 principios de gestión de Toyota, incluyendo "genchi genbutsu" (verificar hechos en el lugar de trabajo).
Mathur, A., Acar, G., Friedman, M. J., Lucherini, E., Mayer, J., Chetty, M., & Narayanan, A. (2019). Dark patterns at scale: Findings from a crawl of 11K shopping websites. Proceedings of the ACM on Human-Computer Interaction, 3(CSCW), Article 81. Resumen: Mediante análisis automatizado de aproximadamente 11,000 sitios web de compras, reportó que aproximadamente el 11% contenía patrones oscuros que engañaban a los usuarios.
McClure, D. (2007). Startup metrics for pirates: AARRR! 500 Hats. Resumen: Presentación que propone el marco AARRR para organizar indicadores de startups en cinco etapas: Adquisición, Activación, Retención, Referencia e Ingresos.
METR. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. Model Evaluation & Threat Research. Resumen: En un ensayo comparativo aleatorizado con 16 desarrolladores de código abierto experimentados, reportó que el uso de herramientas de IA aumentó el tiempo de trabajo en promedio un 19%, aunque los desarrolladores sintieron que trabajaban más rápido.
Moore, G. A. (1991). Crossing the chasm: Marketing and selling high-tech products to mainstream customers. HarperBusiness. Resumen: Argumenta que para cruzar la brecha entre adoptadores tempranos y el mercado principal, se necesita un "producto completo" que incluya todo lo que los clientes esperan.
Nielsen, J. (1993). Response times: The 3 important limits. Nielsen Norman Group. https://www.nngroup.com/articles/response-times-3-important-limits/ Resumen: Organiza los límites percibidos en tiempos de respuesta en tres niveles: 0.1 segundos (se siente instantáneo), 1 segundo (el flujo de pensamiento no se interrumpe) y 10 segundos (límite de mantención de atención).
Nielsen, J. (1994). Enhancing the explanatory power of usability heuristics. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 152–158. Resumen: Propone diez heurísticos de usabilidad para evaluar sistemas, incluyendo visibilidad del estado del sistema y prevención de errores.
Nielsen, J. (2000). Why you only need to test with 5 users. Nielsen Norman Group. Resumen: Artículo que argumenta que la mayoría de los problemas de usabilidad se encuentran con 5 usuarios, por lo que es más eficiente repetir pruebas con grupos pequeños.
NIST. (2022). Secure Software Development Framework (SSDF) version 1.1 (NIST SP 800-218). National Institute of Standards and Technology. Resumen: Marco para incorporar prácticas de seguridad en cada etapa del desarrollo de software.
NIST. (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0). National Institute of Standards and Technology. Resumen: Marco voluntario que trata los riesgos de IA a través de cuatro funciones: gobernanza, correspondencia, medición y gestión.
Norman, D. A. (2004). Emotional design: Why we love (or hate) everyday things. Basic Books. Resumen: Analiza tres capas en las que el diseño afecta las emociones: instintiva, conductual y reflexiva.
Norman, D. A. (2013). The design of everyday things (Revised and expanded ed.). Basic Books. Resumen: Edición revisada del clásico que presenta principios de diseño donde el modo de uso es evidente, incluyendo asequibilidad, significante y retroalimentación.
Nygard, M. T. (2018). Release it! Design and deploy production-ready software (2nd ed.). Pragmatic Bookshelf. Resumen: Sistematiza patrones de diseño para que los sistemas funcionen en producción confinando fallos localmente, como tiempos de espera, disyuntores y tabiques.
Olsen, D. (2015). The lean product playbook: How to innovate with minimum viable products and rapid customer feedback. Wiley. Resumen: Analiza el ajuste producto-mercado (PMF) mediante una pirámide de 5 capas que incluye mercado (clientes, problemas) y producto (propuesta de valor, características, UX), explicando cómo lograrlo.
OWASP. (2021). OWASP Top 10: 2021. Open Worldwide Application Security Project. Resumen: Compila los 10 riesgos de seguridad más críticos en aplicaciones web, incluyendo deficiencias en control de acceso, fallos en cifrado e inyección.
PAIR. (2019). People + AI guidebook. Google. Resumen: Directrices de Google para diseñar productos de IA centrados en el ser humano, abarcando definición de necesidades de usuarios, recopilación de datos, calibración de confianza y manejo de errores.
Parnas, D. L. (1972). On the criteria to be used in decomposing systems into modules. Communications of the ACM, 15(12), 1053–1058. Resumen: Propone la "ocultación de información" como criterio de modularización, ocultando decisiones de diseño que cambian fácilmente dentro de módulos.
Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The impact of AI on developer productivity: Evidence from GitHub Copilot. arXiv. https://arxiv.org/abs/2302.06590 Resumen: Reporta en un experimento aleatorizado de tareas de programación que los usuarios de complementos de IA las completaron 55.8% más rápido.
Reichheld, F. F. (2003). The one number you need to grow. Harvard Business Review, 81(12), 46–54. Resumen: Propone el Net Promoter Score (NPS), medido con una sola pregunta sobre la probabilidad de recomendar el producto a amigos o colegas, demostrando su correlación con el crecimiento.
Ries, E. (2011). The lean startup: How today's entrepreneurs use continuous innovation to create radically successful businesses. Crown Business. Resumen: Propone el ciclo de "construcción, medición y aprendizaje" que valida hipótesis mediante prototipos mínimos (MVP).
Rodden, K., Hutchinson, H., & Fu, X. (2010). Measuring the user experience on a large scale: User-centered metrics for web applications. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 2395–2398. Resumen: Propone el marco HEART de Google para medir la experiencia del usuario a través de cinco dimensiones: felicidad, compromiso, retención, tareas completadas y continuidad.
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. Resumen: Identifica cinco atributos que determinan la velocidad de difusión de innovaciones: ventaja relativa, compatibilidad, complejidad, posibilidad de prueba y observabilidad.
Rozovsky, J. (2015). The five keys to a successful Google team. Google re:Work. Resumen: Explicación de un estudio interno donde el análisis de 180 equipos de Google mostró que la seguridad psicológica era el factor que más predecía la efectividad del equipo.
Sauro, J., & Lewis, J. R. (2016). Quantifying the user experience: Practical statistics for user research (2nd ed.). Morgan Kaufmann. Resumen: Compila métodos estadísticos para investigación con usuarios, incluyendo que el promedio del SUS es 68 puntos.
Serrador, P., & Pinto, J. K. (2015). Does Agile work? A quantitative analysis of agile project success. International Journal of Project Management, 33(5), 1040–1051. Resumen: Analiza 1,002 proyectos demostrando que el grado de adopción ágil se correlaciona positivamente con la eficiencia del proyecto y la satisfacción de los interesados.
Shepherd, D. A., & Gruber, M. (2021). The lean startup framework: Closing the academic–practitioner gap. Entrepreneurship Theory and Practice, 45(5), 967–998. Resumen: Revisión que alinea cada elemento del marco de lean startup con investigaciones existentes, identificando aspectos validados y puntos sin verificación.
Singer, R. (2019). Shape Up: Stop running in circles and ship work that matters. Basecamp. Resumen: Explica el método de desarrollo de Basecamp que reduce el alcance de trabajo para caber en ciclos fijos de 6 semanas y lo asigna a equipos dedicados.
Skok, D. (2013). SaaS metrics 2.0: A guide to measuring and improving what matters. For Entrepreneurs. Resumen: Guía práctica que señala referentes para métricas SaaS, como LTV/CAC superior a 3 y período de recuperación de CAC inferior a 12 meses.
Stanford HAI. (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence. Resumen: Informe anual sobre tendencias en tecnología, economía y política de IA que señala que muchos benchmarks públicos se han saturado, ampliando la brecha con problemas reales.
Taguchi, G. (1986). Introduction to quality engineering: Designing quality into products and processes. Asian Productivity Organization. Resumen: Explica el diseño robusto donde el rendimiento no cambia frente a variaciones en la fabricación, y la ingeniería de calidad que mide la calidad mediante una función de pérdida.
Thomke, S., & Fujimoto, T. (2000). The effect of "front-loading" problem-solving on product development performance. Journal of Product Innovation Management, 17(2), 128–142. Resumen: Demuestra mediante casos de Toyota que adelantar la detección y resolución de problemas a etapas tempranas del desarrollo mejora el tiempo y la calidad.
Thompson, D. V., Hamilton, R. W., & Rust, R. T. (2005). Feature fatigue: When product capabilities become too much of a good thing. Journal of Marketing Research, 42(4), 431–442. Resumen: Demuestra experimentalmente la "fatiga de características": aunque los consumidores eligen productos con más funciones antes de comprar, su satisfacción disminuye al usarlos.
Torres, T. (2021). Continuous discovery habits: Discover products that create customer value and business value. Product Talk. Resumen: Propone la costumbre del descubrimiento continuo donde el trío de producto se reúne semanalmente con clientes e integra hipótesis usando el árbol de oportunidades y soluciones.
Tractinsky, N., Katz, A. S., & Ikar, D. (2000). What is beautiful is usable. Interacting with Computers, 13(2), 127–145. Resumen: Replica el estudio de Kurosu & Kashimura (1995) confirmando que las pantallas hermosas se perciben como más fáciles de usar aunque su facilidad de uso real sea equivalente.
Ulrich, K. T., Eppinger, S. D., & Yang, M. C. (2020). Product design and development (7th ed.). McGraw-Hill. Resumen: Un libro de texto estándar que sistematiza el proceso de desarrollo de productos centrados en hardware, desde el desarrollo del concepto hasta la fabricación.
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425–478. Resumen: Se propuso UTAUT, que integra teorías sobre la aceptación de tecnología, y se informó que la expectativa de desempeño, la expectativa de esfuerzo, la influencia social y las condiciones facilitadoras explican aproximadamente el 70% de la varianza en la intención de uso.
Vitsœ. (n.d.). The power of good design: Dieter Rams's ideology, engrained within Vitsœ. https://www.vitsoe.com/gb/about/good-design Resumen: Una explicación oficial de los «Diez principios del buen diseño» de Dieter Rams.
Vohra, R. (2018). How Superhuman built an engine to find product market fit. First Round Review. Resumen: Un artículo que publicó el procedimiento de Superhuman para aumentar la proporción de «muy decepcionante» del 22% al 58%.
W3C. (2023). Web Content Accessibility Guidelines (WCAG) 2.2. World Wide Web Consortium. Resumen: Una recomendación que establece los criterios de cumplimiento para la accesibilidad del contenido web bajo cuatro principios: perceptible, operable, comprensible y robusto.
Walton, P. (2020). Web Vitals. web.dev. https://web.dev/articles/vitals Resumen: Se definieron LCP, INP y CLS como indicadores principales para medir la experiencia de uso en la web, estableciendo los criterios de «buen» rendimiento en 2,5 segundos, 200 milisegundos y 0,1 o menos, respectivamente.
WebAIM. (2024). The WebAIM Million: The 2024 report on the accessibility of the top 1,000,000 home pages. https://webaim.org/projects/million/ Resumen: Se realizó una inspección automática de las páginas de inicio de los 1 millón de sitios principales y se informó que se detectaron violaciones de WCAG en el 95,9% de ellas.
Witell, L., Löfgren, M., & Dahlgaard, J. J. (2013). Theory of attractive quality and the Kano methodology – the past, present, and future. Total Quality Management & Business Excellence, 24(11–12), 1241–1252. Resumen: Se resumieron 30 años de investigación del modelo de Kano y se organizaron los hallazgos, como el cambio temporal por el cual las cualidades atractivas se convierten en cualidades obvias.
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, 36. Resumen: Se demostró que el método de utilizar modelos de lenguaje potentes como evaluadores coincide con los evaluadores humanos en aproximadamente un 80%, equivalente al nivel de acuerdo entre humanos.
狩野紀昭・瀬楽信彦・高橋文夫・辻新一(1984).魅力的品質と当り前品質.品質, 14(2),147–156.Resumen: El artículo original que propuso el modelo de Kano, que distingue entre cualidades obvias, cualidades unidimensionales y cualidades atractivas.
Leído
Siguiente lectura ↓