Research
最新研究与实践中什么是好的产品
Product
Career
本文由日语原文自动翻译而成
Overview
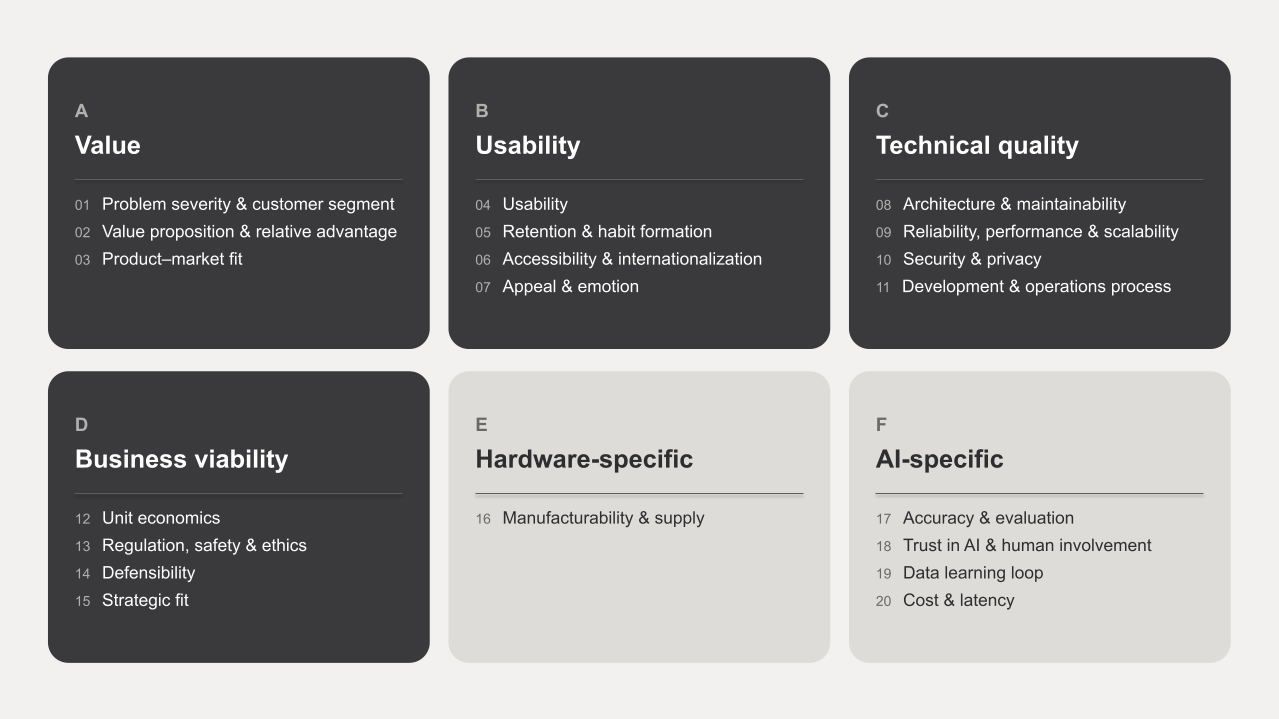
什么是好的产品?品质管理、人体工程学、经营管理学、创新研究等学术领域的研究者,以及在 Apple、Amazon、Nest 等公司从事产品开发的实践者,用不同的词汇定义了"好"。本文综合了这些定义,将好的产品分解为"价值""易用性""技术质量""商业可行性""硬件特有条件""AI 产品特有条件"6个条件和20个要素。
此外,本文整理了产品经理、设计师、各类工程师和客户等利益相关者在7个系统中的角色,并以时间轴的形式展示了从客户问题发现到回顾总结的6个阶段中,各要素由谁采用什么验证方法和达成水准来确认。
开篇
"好的产品"的条件在品质管理、人机交互、经营管理等学术领域以及从事产品开发的实践者之间,一直被用不同的词汇来阐述。除了基本的安全性和稳定性外,当涉及到创新功能、易用性以及商业持续性时,对于什么样的条件算"好"并没有得到充分全面的整理。本文同时考虑软件和硬件两个方面,整理了好的产品应当具备的条件,以及在开发过程中由谁、何时、用什么方法来确认这些条件。
本文的新颖之处在以下三点:
将学术和实践中"好的产品"的定义统一为6个条件和20个要素:Garvin(1987)的品质8个维度、Kano 模型(狩野等, 1984)、ISO/IEC 25010(ISO/IEC, 2023)等学术定义,与 Cagan(2017)的4个风险等实践者的定义被纳入一个框架中,并在各要素中明确显示了软件和硬件的区别。例如,Kano 的"魅力品质"和 Norman(2004)的"情感设计"被作为同一个"吸引力和情感"要素来对待。
用6个阶段具体落实"谁在何时用什么方式来确认":许多文献讨论"什么是好的",但并未指出责任人和基准值。例如,产品市场契合度定义为"没有这个产品会感到非常遗憾"的用户占40%以上(Ellis & Brown, 2017),由产品经理每季度测量。
整理了最新的研究和实践动向:从 X 新产品研究、人机交互、软件工程、组织理论到人与 AI 的协作,涵盖了产品优越性是成功首要因素、功能过多反而降低满意度、心理安全和敏捷的效果、生成式 AI 对生产率的影响差异等19项研究,以及 Y Combinator、Jobs、Bezos、Musk、Cagan、Fadell 等人的15项实践主张,按价值、易用性、技术、商业性、AI 的顺序进行整理。例如,对于"听取客户声音还是坚持愿景""尽快发布还是充分打磨后发布"这样在实践者间意见分歧的问题,本文采用并列两种观点的方式。
什么是好的产品
好的产品的定义
什么是"好的产品"的定义呢?本文整理各领域关于产品好坏的定义。
品质管理的定义:Garvin(1987)将产品品质分为性能、附加功能、可靠性、适合度、耐久性、可维修性、美观性、感知品质8个维度。品质不是单一轴线,而是顾客重视的维度选择竞争的对象。例如,日本汽车制造商在20世纪80年代通过可靠性和适合度维度超越美国制造商。
魅力品质的定义:狩野等(1984)区分了理所当然应该满足的"当然品质"、满足程度与满意度成正比的"一元品质"、以及不满足不会引起不满但满足会使人欣喜的"魅力品质"。例如,智能手机的通话质量是当然品质,电池续航是一元品质,早期指纹识别是魅力品质。
软件工程的定义:ISO/IEC 25010(ISO/IEC, 2023)将软件产品的品质定义为功能适合性、性能效率、兼容性、互操作性、可靠性、安全性、可维修性、灵活性、安全防护9个特性。例如,两个具有相同功能的应用程序,可维修性低的那个在两年后的改修费用可能是另一个的数倍。
以用户为中心的设计定义:ISO 9241-210(ISO, 2019)规定了"以用户为中心的设计",即理解用户需求和使用背景、让用户参与设计、反复进行评估。Norman(2013)提出"可供性"和"指示符"是良好设计的条件。例如,一扇分不出应该推还是拉的门,虽然功能满足,但不是好的设计。
创新研究的定义:Rogers(2003)列举了决定新事物普及速度的5个属性:相对优越性、与现有习惯的兼容性、低复杂性、可试用性、可观察性。Davis(1989)用"感知有用性"和"感知易用性"解释用户是否接受技术。例如,二维码支付因为与现有习惯(随身携带智能手机)兼容、易于尝试、使用者可见,所以快速普及。
Jobs to be Done 的定义:Christensen 等(2016)认为顾客不是"购买"产品,而是"雇佣"产品来完成生活中的特定任务(工作),好的产品被定义为最好地完成这个工作的产品。例如,早上通勤时喝的奶昔是被"雇佣"来"消解乏味的驾驶并抑制饥饿到中午"这个工作的。
实践者的定义:Cagan(2017)将好的产品定义为克服了价值(顾客是否购买)、易用性(使用方式是否易懂)、可实现性(是否能制造出来)、商业性(是否具有商业可行性)4个风险的产品。Rams(Vitsœ, n.d.)列举了良好设计的10项原则:创新、有用、美观、易懂、谦虚、诚实、耐用、细节一致、环保、尽可能简洁。例如,Apple 首代 iPod 克服了所有4个风险,并忠实于 Rams 原则,因此被称为良好产品的典范。
产品市场契合度的定义:Andreessen(2007)将"处于良好市场中,拥有能满足该市场需求的产品"称为产品市场契合度(PMF),并称其为初创公司唯一重要的事。Ellis & Brown(2017)以"无法使用这个产品会怎样"这个问题中选择"感到非常遗憾"的用户比例达到40%以上为参考。例如,Superhuman 公开了将这个指标从22%提升到58%的过程(Vohra, 2018)。
以下,基于这些定义,将好的产品分解为6个条件和20个要素。
A. 价值:是否解决了客户的问题
价值产生于:客户有迫切需要解决的问题,而产品能比其他手段更好地解决这个问题。自 Cooper & Kleinschmidt(1987)以来的新产品研究中,产品优越性一直是成功要因的第一位(Henard & Szymanski, 2001; Evanschitzky et al., 2012)。
① 问题的严重性和客户细分
定义:特定客户细分群体面临着一个足够严重、频繁发生,值得付费解决的问题。问题应该被定义为客户想要实现的进步(工作),而不是功能需求(Christensen et al., 2016)。例如,"想要更快的钻头"不是工作,而"想在墙上打孔后装上架子"才是工作,因此不打孔就能安装架子的产品也是竞争对手。
评估方法:以问题发生频率、严重程度(损失的时间或成本)、当前替代手段及其成本,以及面临同样问题的客户数量(细分市场规模)来评估。例如,如果能回答"每月发生多少次、每次损失多少小时、目前花多少钱",问题的严重性就能被量化。
概述:Blank(2013)提出在制造产品前发现客户和验证问题存在的"客户开发"。Fitzpatrick(2013)展示了提问原则:听取过去的行为而非观点。硬件因原型制造耗时费钱,问题验证通常先通过模型或改造现有产品进行(Fadell, 2022)。例如,Airbnb 创始人通过在自家接待客人来确认"想降低住宿费用但讨厌廉价旅馆"这个问题,Nest 从调查现有恒温器的不满点(设置繁琐)开始。
② 价值主张和相对优越性
定义:相比现有替代手段,产品对顾客有明显的优势点(相对优越性),并能用一句话清楚地表达这一优势(Rogers, 2003)。价值应该以"整体产品"的方式来看待,包括核心功能、支持、兼容性和周边服务(Levitt, 1980; Moore, 1991)。例如,电动汽车的价值由车辆本身和充电网络建设共同决定。
评估方法:用改进幅度(时间、成本、质量)与替代手段对比,看顾客是否能用自己的话说出"为什么选择这个而不是其他方案",按 Kano 模型分类(是魅力品质还是当然品质;Witell et al., 2013)评估。例如,在 Kano 调查中,多数人答"没有也可以"的功能无法形成差异化。
概述:自 Cooper & Kleinschmidt(1987)以来,具有独特优势的优秀产品一直是区分成功与失败的最强因素。软件因功能易复制而优越性易被模仿,硬件的物理设计和制造工艺诀窍能长期维持优越性。例如,Dyson 吸尘器以"吸力不减弱"这一点明确差异,通过5,127次试制的技术长期保持了优越性(Dyson, 2021)。
③ 产品市场契合度
定义:顾客离不开这个产品,持续使用,并向他人推荐的状态。Andreessen(2007)说,有了 PMF 后,你能看到顾客在"拉动"产品。例如,达到 PMF 后的产品即使没有销售也会有咨询增加,服务器扩容跟不上。
评价方法:通过提问"无法使用时会有什么感受"的 PMF 调查(Ellis & Brown, 2017)、按队列统计的留存曲线是否趋于平坦、NPS(Reichheld, 2003)、付费计划的转换率进行评价。对于硬件产品,可用预订单、退货率、评论进行替代,如果是联网设备则用稼働率替代。例如,对于联网健身设备,销售台数不如用户的月度使用次数和订阅退订率作为指标更重要。
概要:PMF 不是一次性的。Olsen(2015)用市场(客户和课题)与产品(价值主张、功能、UX)的五层金字塔来理解 PMF,指出市场变化时匹配度也会崩溃,而 Vohra(2018)通过强化"非常不满意"用户最看重的方面,然后解决"有些不满意"用户的痛点来改进指标。例如,随着智能手机的普及,许多为 PC 设计的服务都失去了原有的 PMF 匹配度。
B. 易用性:能否使用、是否能持续使用
易用性是有价值的产品真正被使用和持续使用的先决条件。Davis(1989)的技术接受模型表明,易用性与实用性并列是影响使用意图的两个关键因素。
④ 可用性
定义:特定用户能够有效、高效、满意地完成特定目标的程度(ISO 9241-11;ISO, 2018)。Nielsen(1994)的十条启发式原则(系统状态可见、系统与现实世界相符、错误预防、识别优于回忆等)成为设计评判的标准。例如,编辑页面中无法看清内容是否已保存,这违反了"系统状态可见"原则。
评价方法:通过小规模用户测试(Nielsen, 2000)中的任务完成率和完成时间、系统可用性量表(SUS;Brooke, 1996; Sauro & Lewis, 2016)、是否有多人在同一处迷茫来评价。例如,让 5 个人操作新的申请表单,如果 3 人都在同一处感到困惑,那么该处就存在设计问题。
概要:Krug(2014)强调用户无需思考是最重要的原则,Norman(2013)指出我们不应责怪用户操作错误,而应该责怪引发错误的设计。软件在发布后可以修改 UI,但硬件的物理界面(按钮、形状、重量)在出货后无法改变,所以原型阶段的测试权重更大。例如,Amazon 的"一键购买"通过最小化购买决策次数进行设计,而 Nest 的转盘操作感经过原型阶段多次迭代(Fadell, 2022)。
⑤ 持续使用与习惯养成
定义:首次使用时触达核心价值("啊哈时刻"),之后反复使用,成为用户习惯或工作的一部分。Fogg(2009)解释行为由动机、能力和触发三要素同时具备时才会发生,Eyal(2014)梳理出触发、行为、奖励、投资的循环构成了习惯养成。例如,Slack 判断当团队交换了 2,000 条消息时产品已经定着,并据此进行设计引导(First Round Review, 2015)。
评价方法:通过激活率(注册用户中触达核心价值的比例)、按队列统计的留存曲线、DAU/MAU(工作工具则为工作日使用率)、Google 的 HEART 框架(幸福度、参与度、留存、持续性、任务成功;Rodden et al., 2010)进行评价。对于非联网硬件产品,因为无法追踪使用频率,可用调查问卷或耗材重复购买频率替代。例如,咖啡机的持续使用可通过胶囊的复购率来衡量。
概要:习惯养成设计只有在与用户利益一致时才正当。Eyal(2014)本人也表示,对于无法改善用户生活的产品,不应该使用习惯养成技巧。例如,通过提高通知频率来提升短期使用率的设计,会增加长期的退订。
⑥ 无障碍性与国际化
定义:视觉、听觉、运动、认知能力存在限制的用户,以及使用不同语言、文化和法律体系的用户,能够同样使用产品的状态。W3C(2023)的 WCAG 2.2 通过可感知、可操作、可理解、鲁棒性四项原则制定了达成标准。例如,仅用颜色来表示图表状态的设计,色觉障碍用户无法区分。
评价方法:通过 WCAG 的符合等级、支持技术(屏幕阅读器等)的可操作性、支持的语言、货币、日期格式和时区范围进行评价。例如,用英语设计的屏幕翻译为德语时,文字长度会增加约 1.3 倍,可能从按钮中超出。
概要:WebAIM(2024)的调查显示,排名前 100 万的网站中 95.9% 存在 WCAG 违规,这是需要有意识地设计才能满足的条件。软件可以通过设置切换语言和显示,但硬件的电源电压、插头形状、无线频段和各国认证(CE、FCC 等)因地区而异,需要在设计阶段确定适配范围。例如,同时在日本和美国销售的设备需要分别获得国家无线模块认证。
⑦ 美感与情感
定义:不仅仅满足功能,还能让人使用时感到舒适、想拥有它的特性。Norman(2004)将设计对情感的作用分为三层:基于视觉外观的"本能层"、基于使用体验的"行为层"、与意义和自我形象相关的"反思层",狩野等人(1984)的狩野模型中的魅力品质也属于这个要素。例如,Apple 产品的包装设计,本身就是在本能层对拆箱体验的精心设计。
评价方法:通过 NPS(Reichheld, 2003)、狩野问卷中的魅力品质判定、设计评审中的一致性(用语、颜色、空白、动画)进行评价。例如,不同页面混用"保存""登记""确定"等不同用语,就缺乏一致性。
概要:Rams 的设计法则(Vitsœ, n.d.)指出好的设计在细节上一致、尽可能简约,Jobs 认为应该从客户体验出发再回溯到技术,而非从技术开始(Jobs, 1997)。美感也提升了对易用性的感知(Kurosu & Kashimura, 1995; Tractinsky et al., 2000)。硬件的魅力取决于材质、重量、手感、声音等物理质感,软件则取决于响应速度、动画、措辞的语气。例如,高级汽车关门的声音是经过精心设计的魅力要素,应用程序画面切换的流畅性是其对应物。
C. 技术质量:能否构建、能否持续运行
技术质量不仅决定能否构建产品一次,还决定能否持续适应不断变化的需求,以及能否在客户手中持续运行。ISO/IEC 25010(ISO/IEC, 2023)的品质特性和 DORA 的实证研究(Forsgren et al., 2018)是这一条件的基础。
⑧ 架构与可维护性
定义:当需要变更时,影响范围有限、能够安全改动的结构。Parnas(1972)提倡"信息隐蔽",将易于改变的设计决策隐藏在模块内部,Conway(1968)指出系统结构反映了组织的沟通结构。例如,如果费用计算逻辑分散在界面、API、批处理三个地方,每次修改价格都要改三处。
评价方法:通过变更影响范围(模块边界、依赖方向、重复代码)、变更交付周期、测试覆盖度、技术债规模和偿还比例进行评价。硬件则通过部件互换性、模块化、维修便利性来衡量(Ulrich et al., 2020)。例如,Framework 笔记本电脑将部件可交换的模块化结构本身作为产品价值。
概要:Cunningham(1992)把仓促编写的代码比作"债务",不偿还的话利息(变更成本增加)会膨胀,Besker 等人(2019)的调查显示开发者平均 23% 的工作时间用于处理技术债。Fowler(2018)的重构是在不改变功能的情况下改善结构的方法,应该定期留出时间进行。例如,没有测试的代码每次变更都要手动验证,这相当于持续支付利息。
⑨ 可靠性、性能与可扩展性
定义:客户需要时能够可用、响应足够快、即使负载增加也能持续运行的特性。Google 的 SRE(Beyer et al., 2016)将稳定性目标明确为"服务等级目标(SLO)",超出目标的部分可作为"错误预算"用于开发新功能。例如,将月稳定率设为 99.9%,则月允许停机约 43 分钟,超过这个时间就应该优先稳定性而非新功能。
评价方法:通过 SLO 达成率、响应时间分布(如 95 百分位数值)、对负载的响应变化、故障恢复时间进行评价。硬件通过故障率(MTBF)、耐久性测试、保修期内故障成本来衡量(Garvin, 1987)。例如,汽车中只有软件缺陷能通过 OTA 升级修复,部件缺陷则需要召回。
概要:Nygard(2018)整理了超时、断路器、隔舱等设计模式,将故障局限在一定范围。故障是必然会发生的,设计时要考虑这一点,发生后通过不追责的事后分析来学习(Beyer et al., 2016)。例如,当外部支付 API 延迟时,应该只暂停支付功能而不是让整个界面卡住。
⑩ 安全性与隐私
定义:客户数据和资产得到保护,隐私在设计阶段就已考虑的状态。Cavoukian(2009)的"隐私设计"原则指出应该通过初始设置进行保护而非事后补救,OWASP(2021)的 Top 10 整理了访问控制缺陷、加密失败、注入等典型漏洞。例如,在 URL 中包含用户 ID 的设计是访问控制缺陷的典型。
评估方法:通过威胁建模识别的威胁是否采取了应对措施、漏洞扫描和渗透测试发现的漏洞严重程度及数量、依赖库的已知漏洞、个人数据的保留期限和删除程序是否存在来评估。例如,如果高严重度的漏洞未得到解决,即使满足其他条件,也无法发货。
概述:NIST(2022)的《安全软件开发框架》是将这些活动纳入开发流程的标准。软件可以通过修复版本的分发来修复漏洞,但硬件如果没有固件更新手段,就无法在销售后进行修复。欧盟《网络韧性法》(European Parliament and Council, 2024b)要求具有数字元素的产品提供销售后的安全更新。例如,没有安全更新手段的物联网设备的销售受到越来越多的限制。
⑪ 开发·运营流程
定义:小规模、频繁地安全地交付给客户,并从结果中学习的机制在运转的状态。Forsgren et al.(2018)证实了部署频率、变更的交付周期、变更失败率、恢复时间这4个指标与组织绩效的相关性。例如,高绩效的组织每天部署多次,失败率低,恢复时间在1小时以内。
评估方法:通过DORA的4个指标、CI/CD的自动化率、发布回顾的实施来评估。在硬件中,通过技术验证(EVT)、设计验证(DVT)、量产验证(PVT)各阶段的通过情况,以及各阶段的继续或中止决策(Cooper, 1990的阶段门控)来评估。例如,在模具下单后改变外壳形状会导致数个月的延期和数千万日元的额外费用(Fadell, 2022)。
概述:Brooks(1995)指出,为延期的项目增加人手会导致进一步延期,Singer(2019)的《Shape Up》展示了如何将工作范围削减到6周的固定周期内。Ries(2011)的"构建·测量·学习"循环,以及Amazon的"从后向前工作"方法(先写新闻稿和FAQ再开发)(Bryar & Carr, 2021)是最小化学习时间和无谓开发的原则。DORA(2025)报告称,AI的使用提高了吞吐量,但同时也增加了不稳定性,其效果在拥有小批量交付和严格版本管理等基础的组织中被放大。例如,即使AI加快了代码生成速度,如果代码审查和测试跟不上,变更失败率也会上升。
D. 商业可行性:作为事业是否能够成立
商业可行性决定了对客户来说是好的产品,对制造者来说是否能够持续。这是Cagan(2017)所述4个风险中的最后一个,法律法规和伦理在这里被视为事业存续的条件。
⑫ 单位经济学
定义:每个客户(每家公司、每台设备)的收益超过获取并持续为该客户服务的费用的状态。Skok(2013)将SaaS中的客户生命周期价值(LTV)与客户获取成本(CAC)的比率、CAC的回收期作为核心指标。例如,月收费1万日元、毛利率80%、平均续存期30个月的客户的LTV为24万日元,只要CAC充分低于这个数字,就能成立。
评估方法:通过LTV/CAC、CAC回收期、毛利率、流失率、净收益维持率(NRR)来评估。在硬件中,通过包括物料清单(BOM)原成本、制造费、物流费、库存、退货、保修费用在内的毛利率来评估。例如,如果NRR为110%,即使没有新客户,来自现有客户的收益也会每年增长10%。
概述:软件的边际成本接近零,云计算费用是主要变动成本,但硬件涉及物理成本,毛利率通常较低。AI产品每次使用都会产生推理费用,因此需要与⑳一起考虑。例如,在硬件中,销售价格的设定通常是BOM原成本的数倍,其中包含保修和退货费用。
⑬ 法律法规·安全·伦理
定义:产品符合适用法律法规,不对使用者和第三方造成伤害,在社会上被接受的状态。欧盟《AI法》(European Parliament and Council, 2024a)根据风险程度对AI系统施加义务,修订后的《产品责任指令》(European Parliament and Council, 2024c)将责任对象扩展到软件和AI。例如,用于招聘和信贷的AI被分类为高风险,需要进行文件记录、人工监管和精度保证。
评估方法:通过适用法规(个人信息、消费者保护、行业法规、产品安全、出口管制)清单的完整性、风险评估结果、外部审计或认证获取情况来评估。NIST(2023)的《AI风险管理框架》是AI风险自我检查的框架。例如,在进入新市场前,需要确认该国的个人信息保护法和数据跨境转移的限制。
概述:硬件产品安全(电气产品、无线电、化学物质)认证是出货的前提,软件以个人信息和网络安全法规为中心,但随着《网络韧性法》和《产品责任指令》的修订,软件也开始承担产品责任。伦理的范围比法律法规更广,Mathur et al.(2019)所示的黑暗模式虽然合法但欺骗用户的设计会损害信任。例如,从2024年起,欧盟将软件缺陷造成的损害也纳入产品责任对象。
⑭ 防御力
定义:当良好的产品被模仿时,有理由保留客户的状态。防御力(Moat)分为五类:成本结构、客户锁定、网络效应、无形资产、市场结构。例如,深度融入客户业务流程的产品具有高切换成本,即使功能被模仿也不容易被取消。
评估方法:通过切换成本的规模、每个客户的累积数据量、是否存在网络效应(用户增加时价值是否增加)、竞争对手发布同等功能后流失率的变化来评估。例如,竞争对手发布同等功能后流失率没有变化,说明防御力来自功能以外的地方。
概述:软件的主要防御力是数据和网络效应,硬件的主要防御力是制造技术诀窍、专利、流通网络、补充产品(消耗品、配件)。防御力不是一开始就存在的,而是在达到产品市场匹配后有意积累起来的。例如,相机镜头卡口因为兼容镜头资产成为补充产品锁定。
⑮ 与战略的一致性
定义:每项功能和产品都与产品愿景、战略以及公司目标相一致的状态。Cagan & Jones(2020)提倡不是执行功能需求的"功能团队",而是对成果负责并自行决定解决方案的"产品团队"。例如,仅被赋予销售目标的团队会采取降价策略,而被赋予"提高客户续存率"这一成果目标的团队会转向产品改进。
评估方法:通过产品愿景和战略是否被文档化、路线图上的每项是否明示战略上要验证的假设、按季度成果目标(OKR)的实现情况来评估。例如,为路线图的每项写上"该项要验证的假设",无法写的项则删除。
概述:Jobs指出决定不做什么就是专注,Bezos(2017)将对客户的执着和对流程目的化的警觉作为"第一天"的条件。Horowitz(2014)将优秀的产品经理称为"产品的CEO",定义为对结果负责的角色。例如,即使功能需求很多,如果会削弱产品的核心价值就要拒绝,这就是战略。
E. 硬件特有的条件
⑯ 可制造性·供应·物理品质
定义:能按设计规格、以目标成本、稳定品质进行量产,能稳定采购零部件的状态。Boothroyd et al.(2011)的"制造和装配设计(DFMA)"是在设计阶段进行零部件数量削减和装配简化的方法,Taguchi(1986)提出了对制造偏差具有鲁棒性的"稳健设计"。例如,仅将螺钉种类从3种减少到1种,就能减少装配时间和错误。
评估方法:通过试制各阶段(EVT、DVT、PVT)的良率和直通率、耐久·环保试验(温度、湿度、跌落、振动)结果、各国安全·电波认证(CE、FCC、UL等)的取得、量产初期的不良率和退货率、单一供应商零部件的比例来评估。例如,如果PVT的良率达不到目标,需要延迟量产。
概述:零部件采购来源、交期、单一供应商风险、库存量在设计同时就被决定了(Ulrich et al., 2020)。Fadell(2022)指出硬件第一代学习、第二代改进、第三代完成,建议初代不要追求完美。对应软件的该要素是构建和部署的可重现性、云供应商依赖、运行环境多样性(OS、浏览器、设备)的应对。例如,依赖特定芯片的设计会因供应中断而导致整体停产,这对应依赖单一云服务商的设计。
F. AI产品特有的条件
以AI为核心的产品具有输出是概率性的、包含错误、随使用而变化的特性,这是传统软件所没有的。除了前面的要素外,还需要以下4个要素。
⑰ 精度与评估
定义:AI的输出在实际使用场景中达到所需的准确度,且能用可重现的方法进行测量的状态。Stanford HAI(2025)的《AI指数》指出公开基准测试多数已达饱和,与实际课题的偏差在扩大。例如,通用问答正确率高的模型在特定业务文档阅读中可能错误很多。
评估方法:通过用实数据制作的评估数据集(反映预期输入分布)的精度、召回率、按错误类型的统计、与人工评估的一致率、按版本的回归测试来评估(Husain, 2024; Zheng et al., 2023)。例如,将过去的实际案件100件作为评估集,每次变更模型或提示词都用同一集合进行比较。
概要:正如Karpathy(2017)所说的"Software 2.0",AI产品的质量由数据和评估决定,而非代码。对于集成AI的硬件(机器人、车辆、医疗设备),错误可能导致物理伤害,因此需要额外的容错设计(失效保险)和实环境验证。例如,在自动驾驶中,除了模拟行驶里程外,实际驾驶中的干预次数也成为评估指标。
⑱ 对AI的信任与人类参与
定义:用户既不过度信任AI,也不过度怀疑,而是适当依赖AI的状态。Amershi等人(2019)提出了人类与AI交互的18项指南,包括明示AI的能力及其程度、有效纠正错误等。例如,显示AI的置信度,当置信度低时提示人类确认的设计就属于这一类。
评估方法:通过用户对AI正确和错误结果的接受率(校准程度)、人工修正率、修正所需时间,以及是否符合Google的People + AI Guidebook(PAIR, 2019)等设计指南来评估。例如,如果用户发现AI错误的比例很低,说明存在过度信任。
概要:Bansal等人(2021)表明,即使AI判断错误,添加解释后用户也更容易采纳;Buçinca等人(2021)表明,促进用户思考的"认知强制"能减少过度信任。Dell'Acqua等人(2023)展示了"锯齿状边界"——AI在擅长的任务上质量提升,但在不擅长的任务上准确率下降——这意味着在何处进行人类干预的设计决定了成果。例如,设计不仅要有直接批准AI建议的按钮,还要有在确认依据后才批准的流程,以减少错误遗漏。
⑲ 数据学习循环
定义:从使用中获得的数据能反馈到产品改进的机制。DORA(2025)将健全的数据生态系统和内部数据访问列为影响AI效果的能力。例如,用户纠正AI输出的历史成为下一个评估数据和改进的素材的设计。
评估方法:通过纠正数据的收集率、从收集到改进的周期、改进后的精度变化、以及数据质量和偏差审计来评估。例如,逐月汇总纠正历史,检查相同类型的错误是否减少。
概要:学习循环也是⑭防御性中因累积数据而产生锁定的源头。集成在硬件中的AI若缺少回收现场数据的通信和分发更新的机制(OTA),学习循环就无法闭合。例如,安装在工厂的检查设备需要在设计阶段就规划收集误检记录的路径。
⑳ 成本与响应速度
定义:AI推理的费用和响应时间与价格和使用体验相匹配。与传统软件不同,AI产品每次使用都产生推理费用,直接影响单位经济学。例如,每次处理费用数十元的功能若无限制提供,使用量增加反而会造成亏损。
评估方法:通过每次使用的推理费用及其占销售收入的比例、响应时间分布、通过模型轻量化或缓存减少费用的效果来评估。响应时间的可接受范围以Nielsen(1993)的三个时限(0.1秒、1秒、10秒)为参考。例如,根据处理类型分别使用小型和大型模型,测量成本与精度的平衡点。
概要:AI改变了制作方的速度,但效果并不一致。Peng等人(2023)的实验显示AI补完用户完成任务快55.8%,而METR(2025)的随机对照试验表明,经验丰富的开发者在熟悉的代码库上使用AI工具时,平均工作时间反而延长19%,且开发者自己认为速度加快了。例如,AI的效果应通过交付周期和变更失败率来衡量,而非凭主观感受。
产品开发的流程
利益相关者
以下将参与产品开发的职能分为7个系统,并按系统整理概况和主要利益相关者的职责(承担的条件和要素、决策权、应确认的指标)。
产品系统
概要:产品经理(对做什么和成果负责)、产品负责人(Scrum中的待办项目清单负责人)、项目经理、Scrum Master(推进和消除障碍)。主要涉及A(价值)、D(商业性)、⑪(开发运营流程)。例如,在小型组织中,产品经理兼任产品负责人和进度管理。
产品经理:是A(价值)和D(商业性)的责任人,负责顾客问题、价值主张、PMF、单位经济学、战略对齐。Horowitz(2014)称优秀产品经理为"产品的首席执行官",定义为不寻找借口、对结果负责的人。确认的指标包括PMF调查、留存率、LTV/CAC、OKR达成。例如,新功能提案必须附带验证假设和预期指标变化。
设计系统
概要:UX/UI设计师(屏幕和操作设计)、UX研究员(用户调查)、技术文档编写员(措辞、帮助、文档)。主要涉及B(易用性)和⑱(信任校准)。例如,如何显示AI的置信度是设计师和数据机器学习工程师的联合设计。
设计师:是B(易用性)的责任人,负责可用性、继续使用的导航、可访问性、吸引力和一致性。确认的指标包括任务完成率、SUS、WCAG符合、设计系统遵循。例如,发布前进行5人可用性测试,将结果在Trio中共享。
软件工程系统
概要:后端、前端、移动、基础设施/SRE、安全、数据机器学习、质量保证(QA)/测试工程师。主要涉及C(技术质量)和F(AI产品特定条件)。例如,SLO由后端和SRE共同定义,QA独立确认实现情况。
后端工程师:负责⑧(架构与可维护性)、⑨(可靠性性能)、⑩(安全性),对数据模型和API设计、技术债务管理、SLO达成负责。确认的指标包括变更交付周期、变更失败率、测试覆盖率、漏洞数量。例如,在设计评审中确认变更的影响范围是否限于一个模块。
前端工程师:负责④(可用性)和⑥(可访问性)的技术实现,⑨中体感性能(显示速度、响应性),设计系统实现。确认的指标包括显示速度(Core Web Vitals等)、可访问性自动检查、UI缺陷率。例如,主要页面的显示速度每次发布都自动测量,确保在目标时间内。
基础设施/SRE工程师:负责⑨(可靠性性能可扩展性)、⑩(安全性)、⑪(开发运营流程),对SLO和错误预算运维、CI/CD和内部平台建设、故障应对和事后总结负责(Beyer等人, 2016)。DORA(2025)将高质量的内部平台列为放大AI效果的能力之一。确认的指标包括SLO达成率、恢复时间、部署频率、云成本。例如,用尽错误预算后,有权停止新功能开发转向稳定性工作。
数据机器学习工程师:负责F(AI产品特定条件),对评估数据集整备、精度计测、学习循环设计、推理费用管理负责。确认的指标包括评估集精度、人工修正率、每次使用推理费用。例如,模型或指示文的变更必须有评估集对比结果才能发布。
质量保证(QA):独立确认所有条件的达成水平是否满足,为各阶段决策提供依据。确认的指标包括测试通过率、重大缺陷数量、回归测试结果。例如,在第4阶段结束时提供各要素达成水平的证据。
硬件工程系统
概要:结构设计、电气电子设计、固件嵌入式软件、制造生产技术、采购供应链、认证法规对应。主要涉及E(硬件特定条件)和⑨(可靠性)、⑬(法规安全)。例如,无线模块各国认证由电气设计和认证人员从设计阶段开始规划。
硬件工程师(结构电气制造):负责⑯(制造性供应物理品质),对DFM/DFA、部件采购、各试制阶段验证、认证取得负责。确认的指标包括良率、BOM成本、故障率、认证取得情况。例如,DVT结束时冻结量产形状和物料清单的决策。
商业系统
概要:销售、客户成功支持、市场营销、法务合规、财务。主要涉及A(价值)、⑫(单位经济学)、⑬(法规安全伦理)。例如,解约原因每月从客户成功反馈给产品经理。
销售客户成功:是将顾客问题和不满反馈给产品的路径,是A(价值)和⑫(单位经济学)的信息源。确认的指标包括解约原因、上线周期、按类别的问询件数。例如,每月向Trio报告解约客户的原因。
外部利益相关者
概要:客户(购买决策者和现场用户分别处理)、设计伙伴(初期协助评估的客户)、合作伙伴供应商、监管机构认证机构。主要是A(价值)的信息源,也是⑬和⑯的约束条件。例如,在B2B中,购买决策者重视⑫和⑬,而现场用户重视④和⑤,因此需要同时听取两方意见。
客户(设计合作伙伴):是问题信息的来源和解决方案的验证者。对于初期客户,应明确其作为"设计合作伙伴"的角色,定期参与访谈和原型评估(Blank, 2013)。例如,与初期的5家公司建立每月一次的评估会,从原型阶段收集意见。
管理层
概述:高管·创始人、董事·投资者。主要参与⑮(与战略的一致性)、⑫(单位经济学)、⑭(防御力)和资源配置。例如,管理者每季度设定成果目标,具体解决方案由三人小组决定(Cagan & Jones, 2020)。
管理者·创始人:负责产品愿景和战略、成果目标设定和资源配置,具体解决方案的决策委托给三人小组(Cagan & Jones, 2020)。要验证的指标包括OKR达成情况、PMF、单位经济学和法规风险。例如,每季度设定成果目标,不指示具体功能。
开发过程
这20个要素不是一次性满足的,而是在反复发现和验证的过程中逐步满足。以下将开发流程分为6个阶段,列举各阶段要验证的要素,及其对应的责任方、验证方法、达成水准等时间顺序。
第一阶段:发现客户问题
这一阶段对应Blank(2013)的客户开发和Torres(2021)的持续发现,在开始开发前验证问题的存在和严重程度。
① 问题的严重程度和客户细分
责任方:产品经理和客户(设计合作伙伴)、销售和客户成功团队。
验证方法:通过客户访谈(Fitzpatrick, 2013)了解过往行为,以每周至少1次的频率持续进行(Torres, 2021),并将问题的发生频率、所需时间和支付金额量化。
达成水准:目标细分市场的访谈数量达20次以上。自发讲述相同问题的客户占比60%以上。问题发生频率每周至少1次。理解当前替代方案(人工、现有工具)的支付额或工作时间的客户占比80%以上。
⑮ 与战略的一致性
责任方:产品经理和管理者。
验证方法:与战略文件和成果目标(OKR)对标(Cagan & Jones, 2020)。
达成水准:该项工作验证的战略假设用一句话描述。贡献所在季度的成果目标至少明确1个,目标指标的预期变化量(例:提升续费率5个百分点)以数值形式记录。
⑬ 法规·安全·伦理
责任方:产品经理和管理者(硬件产品中由认证和法规合规担当)。
验证方法:适用法规的整理和风险评估(NIST, 2023)。
达成水准:适用法规(个人信息、消费者保护、行业法规、产品安全、AI监管)的整理表已完成,所有法规的责任人已分配、无未分配项。按照EU AI法(European Parliament and Council, 2024a)等风险分类,高风险判定已完成。风险评估中判定为高风险的项目100%具有对策方案说明。
⑭ 防御力
责任方:产品经理和管理者。
验证方法:转换成本估算和竞争对手分析。
达成水准:定义了被模仿时保留客户的原因(转换成本、数据积累、网络效应、补充产品)至少1个,并设定了衡量其强度的先行指标(例:每个客户的数据积累量、已集成的系统数量)至少1个。针对主要竞争对手3家以上制定了功能对等性和价格对比表。
第二阶段:产品构想
在开发前用原型验证Cagan(2017)提出的4类风险的阶段。硬件产品中,在制模前与模型和并行试制(Dow et al., 2010)一起进行验证。
② 价值主张和相对优势
责任方:产品经理和设计师。
验证方法:与替代方案的对比表、Kano问卷(Witell et al., 2013)、使用原型的访谈。由于产品优势在成功因素中影响最大(Cooper & Kleinschmidt, 1987),用数值展示改善幅度。
达成水准:见过原型的客户中,能用自己的话说出"为什么选择这个而不用其他方案"的占比70%以上。Kano问卷中核心功能被分类为吸引性品质或必需品质。与替代方案相比的改善幅度在关键指标上明确(例:工作时间缩短50%以上)。
④ 易用性
责任方:设计师和产品经理。
验证方法:对约5名用户进行易用性测试(Nielsen, 2000),同时改进原型,进行多轮迭代。
达成水准:主要任务完成率80%以上(Sauro & Lewis, 2016报告的平均值为78%)。同一位置2人及以上卡顿的问题修正至零。主要任务耗时短于当前替代方案。
⑫ 单位经济学
责任方:产品经理和管理者。
验证方法:价格接受度访谈和按队列假设进行的收入与成本试算。
达成水准:按设想价格和成本计算,LTV/CAC不低于3,CAC回收周期12个月以内(Skok, 2013)。价格接受度访谈中,答"太贵"的占比低于30%。硬件产品中,包括BOM成本、制造费、物流费的毛利率达成目标(例:40%以上)。
⑯ 可制造性·供应
责任方:硬件工程师(机械·电气·制造)和采购担当。
验证方法:DFMA审查(Boothroyd et al., 2011)和零件采购交期确认。
达成水准:零件数量和组装时间的目标值已设定,并提出了从初始方案至少削减20%零件数的方案。所有单一供应商零件已明确,100%制定了替代品或库存方针。主要零件的采购交期在生产计划余量(例:4周)内。
⑰ 精度和评估
责任方:数据·机器学习工程师和产品经理。
验证方法:从过去实际案例创建评估集,并确认人工评估的评估者间一致率。如采用自动评估,需确认与人工评估的一致率(Zheng et al., 2023)。
达成水准:反映实际数据分布的评估集按主要误差类型各不少于30件。人工评估的评估者间一致率80%以上。求取的精度水准(例:重大误差率1%以下)已文档化,未达成时的对应措施已明确。
第三阶段:产品设计
在开发前通过设计确保可变性、可靠性、安全性和可访问性的阶段。问题发现越提前,开发周期和品质改善效果越好(Thomke & Fujimoto, 2000)。
⑧ 架构和可维护性
责任方:后端工程师。
验证方法:设计审查(模块边界、依赖方向、重复)(Parnas, 1972)。
达成水准:假设的变更场景(约5个)中,影响范围局限于单个模块的占比80%以上。模块间无循环依赖。技术债偿还占开发时间的10~20%的计划已制定(Besker et al., 2019报告技术债造成的损失约占开发时间的23%)。
⑨ 可靠性·性能·可扩展性
责任方:后端工程师、基础设施·SRE工程师、硬件工程师。
验证方法:SLO文档化、以故障为前提的设计审查(Nygard, 2018)、负载测试计划。
达成水准:主要功能各有SLO文档(例:可用性99.9%、响应时间95百分位1秒以内)和错误预算(可用性99.9%约为月43分钟)(Beyer et al., 2016)。硬件产品中,目标年故障率(例:1%以下)和耐久·环境试验条件(温度、湿度、跌落、振动)及试验数量已确定。
⑩ 安全性和隐私
责任方:后端工程师和基础设施·SRE工程师(如有专职安全负责人则为该负责人)。
验证方法:基于威胁建模和OWASP Top 10的设计审查(OWASP, 2021; Cavoukian, 2009)。
达成水准:威胁建模中识别的高风险威胁,对策已反映在设计中的占比100%。个人数据项目各已定义保留期和删除流程的占比100%。OWASP Top 10各项目都有设计层面的对应措施说明。
⑥ 可访问性和国际化
责任方:设计师和前端工程师(硬件产品中由认证和法规合规担当)。
验证方法:设计可访问性检查和地域要求整理(W3C, 2023)。
达成水准:设计阶段已满足WCAG 2.2 AA的所有符合标准(例:文字对比度4.5:1以上)(W3C, 2023)。各目标地域的语言、货币、日期格式、电源、无线认证要求表已完成。
⑱ 对AI的信任和人类参与
责任方:数据·机器学习工程师和设计师。
验证方法:根据 Amershi et al.(2019)的指南和 PAIR(2019)指针进行适配性确认。
达成水平:AI 输出中设有置信度或依据显示设计,符合 Amershi et al.(2019)18项指南中相关项目的适配率达到100%。明确了需要人工确认的处理,并设定了确认和修正所需时间的目标(例如:每件30秒以内)。
⑳ 成本与响应速度
利益相关者:数据・机器学习工程师和基础设施・SRE 工程师。
验证方法:按处理类型估算费用和响应时间,设计模型的区分使用。
达成水平:按处理类型估算每次使用的推理费用,推理费用占销售收入的比率控制在目标范围内(例如:低于20%)。根据 Nielsen(1993)的三个时间限界(0.1秒、1秒、10秒)为各处理类型定义响应时间目标(例如:交互型处理在10秒以内,超过该时间的处理显示进度)。
Phase 4:产品实现与验证
小步快走、各阶段验证的阶段。在硬件方面,由于工程验证阶段(EVT)、设计验证阶段(DVT)、量产验证阶段(PVT)各阶段都涉及模具和零部件订单的确定,因此如同 Cooper(1990)的阶段门控方法,在各阶段做出继续或中止的决策(Fadell, 2022)。
⑪ 开发・运营流程
利益相关者:基础设施・SRE 工程师和全体工程师。
验证方法:持续测量部署频率、变更前置时间、变更失败率、恢复时间四项指标(Forsgren et al., 2018; DORA, 2025)。
达成水平:DORA(2024)顶级组水平,即部署频率按需进行(每天多次)、变更前置时间少于1天、变更失败率5%以下、失败部署恢复时间少于1小时。AI 使用后变更失败率未恶化(DORA, 2025)。
④ 可用性
利益相关者:前端工程师和设计师。
验证方法:实现后的可用性测试(Nielsen, 2000)与 SUS 测量(Sauro & Lewis, 2016)、Core Web Vitals 自动测量集成至 CI(Walton, 2020)。
达成水平:主要任务完成率90%以上。SUS 达到68以上(平均值。Sauro & Lewis, 2016),最好80以上。Core Web Vitals 中 LCP 2.5秒以内、INP 200毫秒以内、CLS 0.1以下(Walton, 2020)。
⑥ 无障碍设计与国际化
利益相关者:前端工程师和设计师(硬件方面为认证・规制对应负责人)。
验证方法:无障碍自动检测(WCAG 合规检测工具)集成至 CI,以及使用辅助技术(屏幕阅读器、仅键盘操作)进行操作确认,确认各目标地区的显示(语言、货币、日期格式)。硬件方面在试制中确认目标地区的电源规格和无线认证要求。
达成水平:自动检测中 WCAG 2.2 AA 违规项为零(W3C, 2023)。使用屏幕阅读器和仅键盘操作时,主要任务完成率100%。Phase 3 中制定的各地区要求表的项目在实现中的确认率达100%。
⑨ 可靠性・性能
利益相关者:后端工程师、基础设施・SRE 工程师、硬件工程师。
验证方法:负载测试和故障注入测试(依赖服务停止)(Nygard, 2018)。硬件方面进行耐久・环境测试(温度、湿度、跌落、振动)和加速寿命测试。
达成水平:在预期峰值的2倍负载下,响应时间95百分位数值在 SLO 范围内,错误率低于0.1%。依赖服务停止时能自动降级・恢复。硬件方面耐久・环境测试合格率100%,加速寿命测试的预期故障率低于目标(例如:年故障率低于1%)。
⑩ 安全性
利益相关者:后端工程师和基础设施・SRE 工程师。
验证方法:漏洞诊断、渗透测试、依赖库自动检测(NIST, 2022)。
达成水平:漏洞诊断和渗透测试中"高"及以上严重程度的未处理漏洞为零。依赖库已知漏洞的未处理件数为零("中"级及以下设定应对期限)。CI 中安全检测的执行率100%。
⑯ 可制造性・供应
利益相关者:硬件工程师和制造・采购负责人。
验证方法:EVT・DVT・PVT 各阶段试制评估和一次合格率(首次合格的比例)的测量。
达成水平:EVT 中主要功能的动作在规格的100%得到确认。DVT 中量产形状和物料清单冻结,之后设计变更趋于零。PVT 中量产线一次合格率达到目标(例如:95%以上),组装时间在目标时间内,认证(安全、电磁兼容性、无线)完成取得。
⑰ 精度与评估
利益相关者:数据・机器学习工程师和 QA。
验证方法:每次发布时对评估集执行自动评估,并定期与人工评估进行对照(Zheng et al., 2023)。
达成水平:评估集上的精度达到目标以上,模型或提示词变更前后主要指标下降在1个百分点以内。自动评估与人工评估的一致率80%以上(Zheng et al., 2023 报告的水平)。每次发布的评估执行率100%。
⑲ 数据学习循环
利益相关者:数据・机器学习工程师。
验证方法:修正数据的收集率测量。
达成水平:主要输出类型中,为每种类型实现记录用户修正的机制的比例达100%。修正数据收集率(发生修正的件数中被记录的比例)90%以上。收集的数据被添加到评估集的周期在1个月以内。
Phase 5:产品运营与计测
发布后衡量是否实际产生价值的阶段。计测框架采用 AARRR(McClure, 2007)和 HEART(Rodden et al., 2010),通过 A/B 测试验证施策效果(Kohavi et al., 2020)。各增长阶段的关键指标(OMTM)参见另文"Startup・新业务各阶段应实现的 OMTM 和 KPI"。
③ 产品市场契合度
利益相关者:产品经理。
验证方法:PMF 调查、队列分析、NPS(Reichheld, 2003)。硬件产品用返品率和评价、连接类设备用稼働率替代。
达成水平:选择"如果不能使用会非常遗憾"的用户比例达40%以上(Ellis & Brown, 2017)。队列留存率曲线在3~6个月趋于平稳。NPS 为正值(但由于 NPS 单独的预测力有限,应与留存率结合使用。Keiningham et al., 2007)。硬件产品返品率在目标范围内(例如:低于3%),评价平均分(5分制)4分以上。
⑤ 持续使用与习惯化
利益相关者:产品经理和设计师。
验证方法:激活率、留存曲线、HEART 的5项指标测量。
达成水平:激活率(从注册到体验主要价值的到达率)达目标(例如:40%以上)。月度留存率与前期队列相同或改善。HEART 的5项指标中,任务成功率和重访率达到目标(Rodden et al., 2010)。
⑨ 可靠性・性能
利益相关者:基础设施・SRE 工程师。
验证方法:SLO 监控和故障事后分析(Beyer et al., 2016)。
达成水平:月度 SLO 达成率达目标以上(例如:可用性99.9%),错误预算消耗低于100%。重大故障事后分析执行率100%,再发防止措施期限内完成率90%以上。
⑫ 单位经济学
利益相关者:产品经理和管理层、销售・客户成功。
验证方法:按队列汇总收入和费用。
达成水平:实际 LTV/CAC 达3以上,CAC 回收期在12个月以内,净收入维持率100%以上(Skok, 2013)。硬件产品包括保修和返品费用的毛利率达目标(例如:40%以上)。
⑲ 数据学习循环
利益相关者:数据・机器学习工程师。
验证方法:修正历史汇总、改善前后的精度比较、数据偏差审计。
达成水平:修正数据收集率90%以上。同类错误发生率月度下降(例如:季度降低30%)。改善前后精度比较每次记录,数据偏差审计每季度1次以上进行。
⑳ 成本与响应速度
利益相关者:基础设施・SRE 工程师和数据・机器学习工程师。
验证方法:费用和响应时间持续计测,模型区分使用效果的测量。
达成水平:推理费用占销售收入的比率在目标范围内(例如:低于20%)。响应时间95百分位数值在各处理类型目标范围内。通过模型区分使用实现的费用节省幅度得到计测。
第6阶段:回顾与改进
将测量结果反馈到下一个计划的阶段。软件按周或季度为单位循环,硬件按产品代次为单位循环(Fadell, 2022)。
⑪ 开发·运营流程
利益相关者:基础设施·SRE 工程师和全体工程师。
验证方法:发布回顾和 4 项指标的定期测量。
达成水准:4 项指标的季度推移保持平稳或改善(趋向 DORA, 2024 的高水平组)。回顾中确定的改进措施实施率达 80% 以上。
⑧ 架构与可维护性
利益相关者:后端工程师。
验证方法:技术债务清单和变更交付周期推移(Besker et al., 2019)。
达成水准:技术债务清单至少每季度更新一次。用于偿还的开发时间实际占 10~20%(计划达成率 80% 以上)。变更的交付周期没有比前一季度恶化。
⑭ 防御力
利益相关者:产品经理和经营者。
验证方法:竞争对手动向追踪和流失率比较。
达成水准:竞争对手推出同等功能后的季度内,流失率上升不超过 1 个百分点。防御力的领先指标(累积数据量、已集成系统数量)比前一季度增加。
⑮ 战略一致性
利益相关者:产品经理和经营者。
验证方法:OKR 回顾(如 Camuffo et al., 2020 的科学方法一样,对照假设与结果)。
达成水准:季度成果目标的达成率达到目标(例:70% 以上;由于目标设定为有挑战性,不要求 100%)。未达成的假设的否定或修订记录率达 100%。
⑬ 法规·安全·伦理
利益相关者:产品经理和经营者。
验证方法:法规清单的定期更新和外部审计。
达成水准:法规清单的更新至少每年一次,且在向新市场或新用途扩展前 100% 完成。外部审计发现事项的期限内整改率达 100%。
⑯ 可制造性·供应
利益相关者:硬件工程师和产品经理。
验证方法:量产初期不良率和退货率分析(Fadell, 2022)。
达成水准:量产启动后 3 个月内的不良率和退货率在目标范围内。不良和退货的前 3 大原因已反映在第二代设计变更中。
③ 产品市场匹配度
利益相关者:产品经理。
验证方法:PMF 调查和队列分析的定期实施(Olsen, 2015)。
达成水准:至少每季度进行一次 PMF 调查,"非常失望"的占比保持在 40% 以上。保留率与去年同期相比没有恶化。
最新研究与实务专家的动向
最新研究的动向
产品优势位居第一:Cooper & Kleinschmidt(1987)分析了约 200 个新产品,表明具有独特优势的优秀产品最能强烈区分成功与失败。Henard & Szymanski(2001)对 60 项研究进行元分析,报告产品优势、市场潜力、客户需求满足、开发前的计划质量、开发资源投入等因素与成功一致相关。Evanschitzky et al.(2012)的最新元分析也确认了产品优势和市场导向的效果。例如,销售能力或广告可以补充优秀产品的效果,但不能替代。
功能越多越好是个误区:Thompson et al.(2005)通过实验表明,消费者在购买前倾向于选择功能多的产品,但使用后多功能产品的满意度和复购意向反而下降,即所谓"功能疲劳"。例如,在对比表中因功能数量领先而赢得比较的产品,发布后却被评价为"难以使用"的现象可以用这项研究解释。
魅力性品质随时间推移变为理所当然:Witell et al.(2013)总结了 Kano 模型 30 年的研究,指出魅力性品质随时间推移转变为一元性品质、理所当然品质的"品质时间演变"被重复确认。例如,智能手机的摄像头从魅力性品质转变为理所当然品质,现在像素质量是作为一元性品质竞争的。
美观性提高了对易用性的感知:Kurosu & Kashimura(1995)在 ATM 屏幕上发现,美观度评价与易用性评价强烈相关。Tractinsky et al.(2000)进行了重复试验,确认即使实际易用性相同,美观的屏幕也会被感知为易用。例如,两个功能相同的申请表单,排版整洁的那个会被评价为"容易理解",用户的耐心也会增加。
用户参与与系统成功相关联:Bano & Zowghi(2015)系统审查了 87 项涉及用户参与和系统开发成功关系的研究,报告大多数研究中都确认了正相关。例如,从需求定义阶段就有用户参与的项目,在验收测试中的返工会更少。
解释技术接受的因素:Venkatesh et al.(2003)的 UTAUT 整合了 Davis(1989)的技术接受模型,报告绩效期望、努力期望、社会影响、便利条件这 4 个因素解释了使用意图和使用行为差异的约 70%。例如,在业务系统导入时,仅有易用性还不够,上司和同事的使用这一社会影响,以及支持体系这一便利条件也会影响系统的定着。
软件开发的实证:Forsgren et al.(2018)通过多年调查表明,部署频率、交付周期、变更失败率、恢复时间这 4 项指标与组织业绩相关。DORA(2024)报告了 AI 使用增加与吞吐量下降 1.5% 和稳定性下降 7.2% 相关的结果。DORA(2025)报告吞吐量的改善有所转折,但不稳定性持续增加。例如,AI 导入的研究提示是先要建立小批量和版本控制这样的基础,然后再推进。
敏捷的效果:Serrador & Pinto(2015)分析了 1,002 个项目,表明敏捷采纳度越高,项目在效率和相关人员满意度两方面的成功度越高。另一方面,Shepherd & Gruber(2021)梳理了精益创业各要素中已被证实的部分和未验证的部分,主张应该针对具体实践的效果提问,而不是按方法名称。例如,仅采用冲刺仪式但不增加与客户接触的团队,无法获得研究所显示的效果。
技术债务的成本:Besker et al.(2019)报告开发者平均花 23% 的工作时间在处理技术债务上。例如,5 人团队的计算结果是,常有 1 人以上的工时被技术债务利息消耗。
心理安全性与团队成果:Edmondson(1999)表明,即使报告失败也不会被惩罚的"心理安全性"能提高团队学习行为和成果。Google 的内部研究(Rozovsky, 2015)分析了 180 个团队,报告心理安全性是最强预测团队效能的因素。例如,SRE 原则中在事故事后分析中不指责个人(Beyer et al., 2016)与这项研究相符。
生产力不能用单一指标衡量:Forsgren et al.(2021)的 SPACE 框架将开发者生产力分为满意度、成果、活动量、沟通、效率 5 个维度来看待,指出用提交数这样单一活动指标衡量的危险性。例如,即使 AI 增加了代码行数,如果代码审查等待时间增加了,生产力也没有提高。
科学方法的效果:Camuffo et al.(2020)的随机对照试验和 Camuffo et al.(2024)的大规模重复试验表明,明确假设并进行验证的训练能带来及早撤出无前景业务和提高收益。例如,同样是精益创业,有的团队写下假设并进行验证,有的团队只是反复试作,两者成果不同。
提前问题解决和并行试作:Thomke & Fujimoto(2000)从丰田的开发数据中表明,将问题发现和解决提前到开发早期能改善开发周期和质量。Dow et al.(2010)通过实验表明,多案并行试作比逐个改进单个案方案能带来更好的设计和更多样的探索。例如,硬件外壳应该在制造模具前同时试作 3 个案例并进行比较,而不是对 1 个案例进行 5 次改进。
在线实验的现实:Kohavi et al.(2020)从 Microsoft 和 Bing 进行的大量 A/B 测试经验中报告,旨在改进的施措中实际改善主要指标的不到三分之一,并整理了可信实验的设计方法。例如,即使是"这个变更肯定会更好"的案例,也有超过一半的可能无效或恶化,因此需要有先测量再扩展的规律。
人与 AI 的协作:Bansal et al.(2021)表明 AI 的解释可能强化用户的过度信任,Buçinca et al.(2021)表明促进思考的干预能减少过度信任。例如,AI 产品的 UI 仅增加解释还不够安全,需要设计来引导用户确认。
生成 AI 与生产力:Brynjolfsson et al.(2025)报告称,生成 AI 的协助在客户支持现场平均提高处理件数14%,对经验不足的员工提高了34%,而对资深员工基本没有影响。Peng et al.(2023)发现使用 AI 补全的程序员在编程任务中快55.8%完成,Dell'Acqua et al.(2023)在咨询顾问实验中报告了"锯齿形边界"现象——在 AI 擅长的任务中,质量提升40%,而在不擅长的任务中,正确率下降19个百分点。METR(2025)报告资深开发者在自己熟悉的代码库中使用 AI 时,工作时间增加了19%。例如,AI 的效果因工作类型和使用者的熟练度而异,可能产生正面或负面影响,因此需要在自身业务中进行测量。
AI 的评估方法:Zheng et al.(2023)表明,使用强大的语言模型作为评估者的方法与人类评估者约80%一致,与人类之间的一致率相当。Stanford HAI(2025)指出,许多公开基准已经饱和,与实际问题的偏差日益扩大。例如,在自有评估集上进行自动评估作为回归测试,在每次发布时运行,并定期与人工评估进行对比核对,这正是这两项研究的启示。
暗黑模式与可访问性的现状:Mathur et al.(2019)自动分析了约11,000个购物网站,报告称约11%包含欺骗用户的"暗黑模式"。WebAIM(2024)报告称排名前100万的网站中,95.9%的首页存在自动检测到的 WCAG 违规。例如,为提高留存率的设计应通过公开的分类清单确认是否属于暗黑模式,而可访问性则需要将自动检查集成到 CI 流程中,这是最低标准。
NPS 的局限性:Keiningham et al.(2007)验证了 NPS(净推荐值)在预测企业增长方面优于其他客户满意度指标的主张,但未能确认其优越性。例如,NPS 研究的启示是不要将其作为单独的增长预测指标使用,而应与留存率和流失原因相结合使用。
最新实务家的动向
关于价值:Y Combinator 的座右铭"制造人们想要的东西"(Graham, 2013)、贝佐斯(2017)的"痴迷于顾客"、乔布斯(1997)的"从顾客体验开始,反推到技术"都将 A(价值)置于最高位置。例如,亚马逊在会议中为顾客留一个空座位的做法,强制以顾客的视角来看待问题(Bryar & Carr, 2021)。
顾客的声音还是远景?:Blank(2013)和 Torres(2021)强调从顾客那里学习的重要性,而乔布斯认为,在事物呈现给人们之前,人往往不知道自己想要什么(Jobs, 1998)。两者的分工是:问题来自于向顾客学习,解决方案由制造者构想并验证。例如,顾客要求"更快的马",但"我想更快地移动"这个需求是正确的,而解决方案(汽车)则由制造者来构想。
关于易用性和吸引力:Krug(2014)的"别让我想"、Rams(Vitsœ, n.d.)的"尽可能少的设计"、Google(n.d.)的"专注于用户,其他一切自然而然就来了"都是 B(易用性)的原则。例如,Google 搜索页面的空白是这一原则的物理体现。
增加功能还是做减法?:Kano 模型强调添加魅力属性的功能,而 Rams 和 Musk 则重视做减法。Musk 提出了一个顺序:质疑需求、删除零件和工序、简化、加快、自动化,并指出在删除之前不应该自动化(Everyday Astronaut, 2021)。两者并不矛盾,而是添加的功能仅限于魅力属性,已成为必需属性的功能应该被简化,这是一个时间轴的问题。例如,新功能建议应附带"代替删除什么"的说明,对未使用的功能应定期判断是否废除。
关于技术质量:Brooks(1995)的"给延期的项目增加人手反而会进一步延期"、Beyer et al.(2016)的错误预算、Fadell(2022)的"三代产品才完成"都将 C(技术质量)视为约束管理而非理想追求。例如,错误预算是通过数字来解决稳定性和新功能之间冲突的机制。
兼顾速度和质量的运营:Singer(2019)的 Shape Up 将工作控制在6周的固定周期内,Bryar & Carr(2021)的 Working Backwards 从新闻稿反推,Beyer et al.(2016)的 SRE 用错误预算平衡新功能和稳定性。Forsgren et al.(2018)的研究表明,速度和稳定性不是权衡关系,而是通过相同的投资(小批量、自动化)两者都能提升。例如,相比一次发布三个月的功能,每两周发布一次,观察反应会更快地发现错误方向。
尽早发布还是精心打磨后发布?:Hoffman & Yeh(2018)认为,如果第一版本不让你感到尴尬,说明发布得太晚了。Graham(2013)建议初期阶段做"不可扩展的事",如手工获取和支持顾客。而 Dyson(2021)经历了5,127次试制才上市,说明物理产品在发布前需要反复迭代。例如,软件应限量发布并尽早推出,硬件则应加快和增加试制的迭代次数,两者有所不同。
深入现场:丰田的"现地现物"(Liker, 2004)原则强调在现场确认事实而非依赖报告,Torres(2021)的持续探索要求每周进行数次固定的顾客访谈。Vohra(2018)公开了一种程序,将产品市场适配性调查的开放式回答分类,以确定改进优先级。例如,对初期顾客,应由创始人亲自进行部署工作,在这个过程中了解问题。
关于商业性和战略:Horowitz(2014)的"优秀产品经理应像产品的 CEO 一样对结果负责"、Cagan & Jones(2020)的"以产品团队而非功能团队为基础"、Bezos(2017)的"警惕流程目的化"都将 D(商业性)视为成果问题而非单个功能。例如,对留存率目标负责的团队会因留存率而非功能数量受到评估。
向产品运营模式的转变:Cagan(2024)将从顺序完成功能需求的"功能团队"向对成果负责的"产品团队"的转变体系化为"产品运营模式",并整理了经营者、产品领导者和团队各自应改变的行为。例如,将路线图从功能清单转变为按季度的成果目标和待验证假设的清单,这是第一步。
创始人的参与方式:Graham(2024)基于 Airbnb 的 Chesky 经验,针对强调权限委托的"经理模式",提出创始人直接参与细节的"创始人模式",在实务家中引发了讨论。Cagan & Jones(2020)的"将解决方案委托给团队"原则与此形成了紧张关系。例如,即使创始人参与产品细节,关键在于不破坏成果目标和验证规律的方式来参与。
AI 对开发的改变:Karpathy(2017)提出"Software 2.0"的概念,认为人编写的代码将被学习的模型所取代,开发者的工作将从编写代码转变为整理数据。DORA(2025)报告称 AI 会放大组织的优势和劣势。例如,即使 AI 加快了代码生成,如果代码审查和测试跟不上,变更失败率也会上升。
以 AI 产品评估为中心:Husain(2024)指出,AI 产品的成败取决于能否建立基于真实数据的评估机制,建议将评估视为等同于需求定义的工作。这与 Zheng et al.(2023)和 Stanford HAI(2025)的研究一致。例如,在不使用自有评估集进行对比的情况下,不发布模型或指示文本的变更。
硬件实务家的共同点:Fadell(2022)的"三代产品才完成"、Dyson(2021)的试制迭代、Musk 的减法工序(Everyday Astronaut, 2021)、丰田的现地现物(Liker, 2004)都在一点上达成一致:对于物理产品,试制的次数和速度以及零件和工序的削减决定了质量。例如,第一代设备中功能要精简,并从一开始就制定好在第二代中反映所学内容的计划。
习惯化和伦理的界线:Eyal(2014)提供了一个框架,通过"制造者自己是否使用"和"是否改善用户生活"这两个问题来判断习惯化设计是否正当。Google(PAIR, 2019)和 Microsoft(Amershi et al., 2019)公开了 AI 产品的设计指南。针对 Mathur et al.(2019)研究所示的暗黑模式的广泛存在,EU AI 法(European Parliament and Council, 2024a)等监管措施成为了设计约束。例如,提高留存率的措施应以能否向用户解释为标准进行判断。
结语
本文将优秀产品的条件分解为6个条件和20个要素,整理了开发各阶段中谁确认什么内容至何种水准。达成水准的数值是参考值,前提是应根据各公司的实际情况进行调整。希望本文能在构想新产品或审视现有产品时,作为一个全面的参考视角。
参考文献
Amershi, S., Weld, D., Vorvoreanu, M., Fourney, A., Nushi, B., Collisson, P., Suh, J., Iqbal, S., Bennett, P. N., Inkpen, K., Teevan, J., Kikin-Gil, R., & Horvitz, E. (2019). Guidelines for human-AI interaction. Proceedings of the 2019 CHI Conference on Human Factors in Computing Systems, Paper 3. 概要:Microsoft 的研究人员整理了 150 多条设计指南,将其汇总为 18 条指导方针,并通过用户研究验证了其有效性。包括明确说明 AI 的功能、提高纠正错误的效率等内容。
Andreessen, M. (2007). The only thing that matters. pmarchive. https://pmarchive.com/guide_to_startups_part4.html 概要:一篇论文,将产品与市场契合度定义为决定创业成败的唯一因素,并解释为"处于良好的市场中,并拥有能满足该市场需求的产品"。
Bano, M., & Zowghi, D. (2015). A systematic review on the relationship between user involvement and system success. Information and Software Technology, 58, 148–169. 概要:系统审视了 87 项关于用户参与与系统开发成功关系的研究,报告大多数研究中发现了正相关关系。
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, Article 81. 概要:实验表明,当为 AI 的判断添加解释时,即使 AI 出错,用户也更容易遵循其建议,从而人类与 AI 的协作效果并不一定提升。
Besker, T., Martini, A., & Bosch, J. (2019). Software developer productivity loss due to technical debt: A replication and extension study examining developers' development work. Journal of Systems and Software, 156, 41–61. 概要:根据 43 名开发者的工作记录数据,研究表明平均 23% 的工作时间用于处理技术债务。
Beyer, B., Jones, C., Petoff, J., & Murphy, N. R. (Eds.). (2016). Site reliability engineering: How Google runs production systems. O'Reilly Media. 概要:整理了 Google SRE 的实践经验。书中通过服务级别目标(SLO)和错误预算的概念,展示了如何用数值方式平衡可靠性与新功能开发。
Bezos, J. (2017). 2016 letter to shareholders. Amazon. 概要:股东信阐述了保持"第一天"的条件,包括对客户的执着、抵抗流程目的化、接纳外部趋势和迅速做出决策。
Blank, S. (2013). The four steps to the epiphany: Successful strategies for products that win (2nd ed.). K&S Ranch. 概要:提出了"客户开发"模型,即在产品开发过程中并行地发现和验证客户需求,成为精益创业的基础。
Boothroyd, G., Dewhurst, P., & Knight, W. A. (2011). Product design for manufacture and assembly (3rd ed.). CRC Press. 概要:系统化了 DFMA 方法论的教科书,该方法在设计阶段即通过减少部件数量和简化组装来优化产品。
Brooke, J. (1996). SUS: A "quick and dirty" usability scale. In P. W. Jordan, B. Thomas, B. A. Weerdmeester, & I. L. McClelland (Eds.), Usability evaluation in industry (pp. 189–194). Taylor & Francis. 概要:提出了系统可用性量表(SUS),通过 10 项问题以 0 至 100 分的方式评估可用性。
Brooks, F. P. (1995). The mythical man-month: Essays on software engineering (Anniversary ed.). Addison-Wesley. 概要:软件开发管理的经典著作,包含了"向延期的软件项目增加人员会导致进度进一步延期"的布鲁克斯定律。
Bryar, C., & Carr, B. (2021). Working backwards: Insights, stories, and secrets from inside Amazon. St. Martin's Press. 概要:Amazon 前高管阐述了从新闻稿和常见问题开始的工作逆向法、单线程领导者、客户空位等机制。
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889–942. 概要:实证研究表明,在客户支持现场,生成式 AI 的支持使处理件数平均增加了 14%,且对经验较少的员工效果最显著。
Buçinca, Z., Malaya, M. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), Article 188. 概要:实验表明,让用户在查看 AI 建议前先自行思考等"认知强制"措施可以减少对 AI 的过度依赖。
Cagan, M. (2017). Inspired: How to create tech products customers love (2nd ed.). Wiley. 概要:将优秀产品的条件整理为价值、易用性、可实现性和商业性四大风险,提出在开发前进行验证的产品发现方法。
Cagan, M. (2024). Transformed: Moving to the product operating model. Wiley. 概要:将从功能团队向承担成果责任的产品团队的转变系统化为"产品运营模型",并阐述了变革步骤。
Cagan, M., & Jones, C. (2020). Empowered: Ordinary people, extraordinary products. Wiley. 概要:对比了执行功能需求的"功能团队"与承担成果责任、自主决策的"产品团队",论述了实现后者所需的领导力。
Camuffo, A., Cordova, A., Gambardella, A., & Spina, C. (2020). A scientific approach to entrepreneurial decision making: Evidence from a randomized control trial. Management Science, 66(2), 564–586. 概要:对 116 家初创公司进行随机分组实验,表明学习了明确假设并进行验证的科学方法的创业者能更早放弃前景不良的业务,并获得更高收益。
Camuffo, A., Gambardella, A., Messinese, D., Novelli, E., Paolucci, E., & Spina, C. (2024). A scientific approach to entrepreneurial decision-making: Large-scale replication and extension. Strategic Management Journal, 45(6), 1209–1237. 概要:将 2020 年的实验扩展到 759 家公司进行重复验证,确认了科学方法的效果得以再现。
Cavoukian, A. (2009). Privacy by design: The 7 foundational principles. Information and Privacy Commissioner of Ontario. 概要:展示了 7 项设计原则,强调通过预防而非事后补救,在设计阶段即通过默认设置等方式将隐私保护融入其中。
Christensen, C. M., Hall, T., Dillon, K., & Duncan, D. S. (2016). Competing against luck: The story of innovation and customer choice. HarperBusiness. 概要:通过牛奶昔等事例阐述了"需求理论"(Jobs to be Done),即客户购买产品是为了完成特定的"工作"。
Conway, M. E. (1968). How do committees invent? Datamation, 14(4), 28–31. 概要:论文提出了"康威定律",指出系统的结构反映了设计该系统的组织的沟通结构。
Cooper, R. G. (1990). Stage-gate systems: A new tool for managing new products. Business Horizons, 33(3), 44–54. 概要:将新产品开发分为阶段(Stage)和关门(Gate),在每个关门处判断是继续还是中止的阶段门控法(Stage-Gate Method)。
Cooper, R. G., & Kleinschmidt, E. J. (1987). New products: What separates winners from losers? Journal of Product Innovation Management, 4(3), 169–184. 概要:通过分析约200个新产品,表明具有独特优势的优秀产品是区分成功和失败的最强因素。
Cunningham, W. (1992). The WyCash portfolio management system. OOPSLA '92 Addendum to the Proceedings, 29–30. 概要:首次用债务来比喻仓促编写的代码,若不偿还则利息会增加的"技术债"比喻的报告。
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. 概要:提出技术接受模型(TAM),用感知有用性和感知易用性来解释用户是否接受技术。
Dell'Acqua, F., McFowland, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2023). Navigating the jagged technological frontier: Field experimental evidence of the effects of AI on knowledge worker productivity and quality (Harvard Business School Working Paper 24-013). 概要:对758名顾问的实验表明,AI在擅长的任务中提高质量,但在不擅长的任务中正确率下降,形成"参差不齐的边界"。
DORA. (2024). Accelerate State of DevOps Report 2024. Google Cloud. 概要:对约39,000人的调查报告显示,AI使用增加与吞吐量下降1.5%和稳定性下降7.2%相关。
DORA. (2025). 2025 DORA Report: State of AI-assisted software development. Google Cloud. 概要:对约5,000人的调查显示,AI改善吞吐量但增加不稳定性,AI放大组织的优势与劣势,报告了影响效果的7种能力。
Dow, S. P., Glassco, A., Kass, J., Schwarz, M., Schwartz, D. L., & Klemmer, S. R. (2010). Parallel prototyping leads to better design results, more divergence, and increased self-efficacy. ACM Transactions on Computer-Human Interaction, 17(4), Article 18. 概要:实验表明,并行试制多个方案比顺次改进单一方案能产生更好的设计和更多样的探索。
Dyson, J. (2021). Invention: A life. Simon & Schuster. 概要:戴森创始人的自传,包括经历5,127次试制才完成旋风式吸尘器的过程。
Edmondson, A. (1999). Psychological safety and learning behavior in work teams. Administrative Science Quarterly, 44(2), 350–383. 概要:表明心理安全性(报告失败不会受罚)提高了团队的学习行为和成果。
Ellis, S., & Brown, M. (2017). Hacking growth: How today's fastest-growing companies drive breakout success. Crown Business. 概要:以"如果无法使用该产品会感到非常遗憾"的用户占40%以上作为产品市场契合度(PMF)的指标,解释了增长实验的推进方式。
European Parliament and Council. (2024a). Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union. 概要:按风险程度对AI系统分类,要求高风险应用进行文档记录、人工监督、确保精度和鲁棒性的欧盟规则。
European Parliament and Council. (2024b). Regulation (EU) 2024/2847 on horizontal cybersecurity requirements for products with digital elements (Cyber Resilience Act). Official Journal of the European Union. 概要:要求具有数字要素的产品在设计阶段确保安全性,并在销售后提供安全更新的欧盟规则。
European Parliament and Council. (2024c). Directive (EU) 2024/2853 on liability for defective products. Official Journal of the European Union. 概要:将产品责任范围扩大到软件和AI系统,简化数字产品缺陷造成损害的赔偿的欧盟修订指令。
Evanschitzky, H., Eisend, M., Calantone, R. J., & Jiang, Y. (2012). Success factors of product innovation: An updated meta-analysis. Journal of Product Innovation Management, 29(S1), 21–37. 概要:更新了Henard & Szymanski(2001)的元分析,确认产品优势和市场导向继续与新产品成功紧密相关。
Everyday Astronaut. (2021). Starbase tour with Elon Musk [Part 1] [Video]. YouTube. 概要:Musk在采访中解释了设计和制造的5个阶段步骤:质疑要求、删除、简化、加快、自动化。
Eyal, N. (2014). Hooked: How to build habit-forming products. Portfolio. 概要:展示了习惯通过触发、行动、奖励、投资4个阶段循环形成的模型,并涉及其伦理使用。
Fadell, T. (2022). Build: An unorthodox guide to making things worth making. Harper Business. 概要:iPod和Nest的制造者解释了硬件在3代后完成、试制和阶段验证(EVT·DVT·PVT)的推进方式、团队建设。
First Round Review. (2015). From 0 to $1B: Slack's founder shares their epic launch strategy. First Round Review. 概要:Slack创始人Butterfield分享了团队交换2,000条消息后用户会定着的标准以及初期启动的推进方式的文章。
Fitzpatrick, R. (2013). The mom test: How to talk to customers and learn if your business is a good idea when everyone is lying to you. CreateSpace. 概要:提出在客户访谈中应询问过去的具体行为而不是观点或未来承诺的原则的实务著作。
Fogg, B. J. (2009). A behavior model for persuasive design. Proceedings of the 4th International Conference on Persuasive Technology, Article 40. 概要:提出Fogg行为模型,即行为在动机、能力、触发三者同时具备时发生。
Forsgren, N., Humble, J., & Kim, G. (2018). Accelerate: The science of lean software and DevOps. IT Revolution. 概要:基于数年调查显示,部署频率、变更前置时间、变更失败率、恢复时间这4个指标与软件开发成果和组织业绩相关联。
Forsgren, N., Storey, M.-A., Maddila, C., Zimmermann, T., Houck, B., & Butler, J. (2021). The SPACE of developer productivity: There's more to it than you think. ACM Queue, 19(1), 20–48. 概要:提出SPACE框架,从满意度、成果、活动、沟通、效率5个方面理解开发者生产力。
Fowler, M. (2018). Refactoring: Improving the design of existing code (2nd ed.). Addison-Wesley. 概要:将重构(在不改变外部行为的前提下改进内部结构)的手法进行了分类编目的著作。
Garvin, D. A. (1987). Competing on the eight dimensions of quality. Harvard Business Review, 65(6), 101–109. 概要:将产品质量分为性能、附加功能、可靠性、一致性、耐久性、可维护性、美观性和感知质量8个维度,论述应该选择在哪个维度上竞争。
Google. (n.d.). Ten things we know to be true. https://about.google/philosophy/ 概要:Google 的10项理念,其中首要理念是"专注于用户,其他一切都会随之而来"。
Graham, P. (2013). Do things that don't scale. http://paulgraham.com/ds.html 概要:论述初期创业公司应该有意进行不可扩展的工作,例如手工获取和支持客户。
Graham, P. (2024). Founder mode. http://paulgraham.com/foundermode.html 概要:与强调授权的管理者模式相对,提出创始人直接参与细节的创始人模式的论文。
Henard, D. H., & Szymanski, D. M. (2001). Why some new products are more successful than others. Journal of Marketing Research, 38(3), 362–375. 概要:对60项实证研究的元分析表明,产品优越性、市场潜力、满足客户需求、开发前规划和开发资源投入与新产品成功有一致的关联。
Hoffman, R., & Yeh, C. (2018). Blitzscaling: The lightning-fast path to building massively valuable companies. Currency. 概要:阐述了快速扩张战略和尽早推出不完善产品的理念,包含"如果初版不令你感到羞愧,那说明你发布得太晚了"这一观点。
Horowitz, B. (2014). The hard thing about hard things: Building a business when there are no easy answers. HarperBusiness. 概要:收录了1996年的内部文件《好产品经理·坏产品经理》,将产品经理定位为产品的CEO。
Husain, H. (2024). Your AI product needs evals. https://hamel.dev/blog/posts/evals/ 概要:这篇实践文章论述了基于真实数据的评估机制对AI产品改进的必要性,并解释了评估系统的构建方法。
ISO. (2018). ISO 9241-11:2018 Ergonomics of human-system interaction — Part 11: Usability: Definitions and concepts. International Organization for Standardization. 概要:国际标准,定义易用性为特定用户能有效、高效且满足地实现特定目标的程度。
ISO. (2019). ISO 9241-210:2019 Ergonomics of human-system interaction — Part 210: Human-centred design for interactive systems. International Organization for Standardization. 概要:国际标准,规定以用户和上下文的理解、用户参与和迭代评估为原则的以人为中心的设计流程。
ISO/IEC. (2023). ISO/IEC 25010:2023 Systems and software engineering — Systems and software Quality Requirements and Evaluation (SQuaRE) — Product quality model. International Organization for Standardization. 概要:国际标准,用功能适配性、性能效率、兼容性、交互性、可靠性、安全性、可维护性、灵活性和可安全性9个特性来定义软件产品质量。
Jobs, S. (1997). Closing keynote Q&A at the 1997 Worldwide Developers Conference. Apple. 概要:在问答环节中表述了"必须从客户体验出发,然后回溯到技术"的观点。
Jobs, S. (1998). Steve Jobs: \"There's sanity returning\" [Interview]. BusinessWeek. 概要:访谈中表述了"在事物呈现给人们之前,人们往往不知道自己想要什么",阐述了不依赖客户调研的产品开发理念。
Karpathy, A. (2017). Software 2.0. Medium. 概要:提出"Software 2.0"的概念,指人编写的代码被学习模型的权重所取代,论述开发者的工作将转向数据准备。
Keiningham, T. L., Cooil, B., Andreassen, T. W., & Aksoy, L. (2007). A longitudinal examination of net promoter and firm revenue growth. Journal of Marketing, 71(3), 39–51. 概要:验证了NPS在预测增长方面优于其他客户指标的主张,报告表明无法确认这一优越性。
Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. 概要:阐述了大规模A/B测试的设计和陷阱,报告指出旨在改进的措施中仅有一部分实际有效。
Krug, S. (2014). Don't make me think, revisited: A common sense approach to web usability (3rd ed.). New Riders. 概要:网站和应用易用性的实用指南,以不让用户费思就是最重要的原则。
Kurosu, M., & Kashimura, K. (1995). Apparent usability vs. inherent usability: Experimental analysis on the determinants of the apparent usability. CHI '95 Conference Companion on Human Factors in Computing Systems, 292–293. 概要:在ATM屏幕的实验中表明,视觉美观度的评价与易用性的评价之间存在强相关。
Levitt, T. (1980). Marketing success through differentiation—of anything. Harvard Business Review, 58(1), 83–91. 概要:从核心产品、期望产品、延伸产品和潜在产品的层级来理解产品价值,论述差异化发生在延伸产品层面。
Liker, J. K. (2004). The Toyota way: 14 management principles from the world's greatest manufacturer. McGraw-Hill. 概要:阐述丰田的14条管理原则,包括现地现物(在现场验证事实)等内容。
Mathur, A., Acar, G., Friedman, M. J., Lucherini, E., Mayer, J., Chetty, M., & Narayanan, A. (2019). Dark patterns at scale: Findings from a crawl of 11K shopping websites. Proceedings of the ACM on Human-Computer Interaction, 3(CSCW), Article 81. 概要:对约11,000个购物网站的自动分析表明,约11%的网站包含欺骗用户的暗黑模式。
McClure, D. (2007). Startup metrics for pirates: AARRR! 500 Hats. 概要:提出用获取、激活、留存、推荐和收入5个阶段来整理创业公司指标的AARRR框架的演讲。
METR. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. Model Evaluation & Threat Research. 概要:对16名经验丰富的开源开发者进行的随机对照试验表明,使用AI工具时工作时间平均延长了19%,但开发者主观感受是速度加快了。
Moore, G. A. (1991). Crossing the chasm: Marketing and selling high-tech products to mainstream customers. HarperBusiness. 概要:论述跨越早期采用者与主流市场之间的鸿沟需要"完整产品"——即满足客户所有期望的产品。
Nielsen, J. (1993). Response times: The 3 important limits. Nielsen Norman Group. https://www.nngroup.com/articles/response-times-3-important-limits/ 概要:整理了响应时间感知的3个关键界限:0.1秒(感觉即时)、1秒(思路不中断)、10秒(能保持注意力的极限)。
Nielsen, J. (1994). Enhancing the explanatory power of usability heuristics. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 152–158. 概要:整理了用于易用性评估的10条启发式原则,包括系统状态可见性、错误防止等内容。
Nielsen, J. (2000). Why you only need to test with 5 users. Nielsen Norman Group. 概要:5名的用户可以发现大多数可用性问题,因此反复进行小规模测试更有效率。
NIST. (2022). Secure Software Development Framework (SSDF) version 1.1 (NIST SP 800-218). National Institute of Standards and Technology. 概要:一套将安全实践融入软件开发各个阶段的框架。
NIST. (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0). National Institute of Standards and Technology. 概要:通过治理、映射、度量、管理四项职能管理AI风险的可选框架。
Norman, D. A. (2004). Emotional design: Why we love (or hate) everyday things. Basic Books. 概要:将设计对情感的作用分为本能层、行为层和反思层三个层次进行论述。
Norman, D. A. (2013). The design of everyday things (Revised and expanded ed.). Basic Books. 概要:这部经典著作的修订扩展版介绍了亲和力、能指、反馈等使用方法一目了然的设计原则。
Nygard, M. T. (2018). Release it! Design and deploy production-ready software (2nd ed.). Pragmatic Bookshelf. 概要:系统阐述了超时、断路器、隔壁等设计模式,通过限制故障范围使生产环境保持运行。
Olsen, D. (2015). The lean product playbook: How to innovate with minimum viable products and rapid customer feedback. Wiley. 概要:用五层金字塔分析产品与市场匹配(PMF),包括市场(客户、问题)和产品(价值主张、功能、用户体验),解释了实现步骤。
OWASP. (2021). OWASP Top 10: 2021. Open Worldwide Application Security Project. 概要:汇总了网络应用最严重的十大安全风险,包括访问控制失效、密码学失败、注入等。
PAIR. (2019). People + AI guidebook. Google. 概要:Google为设计以人为中心的AI产品提供的指南,涵盖用户需求定义、数据收集、信任校准、错误处理等。
Parnas, D. L. (1972). On the criteria to be used in decomposing systems into modules. Communications of the ACM, 15(12), 1053–1058. 概要:提出将易变的设计决策隐藏在模块内部的"信息隐藏"作为模块分割的标准。
Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The impact of AI on developer productivity: Evidence from GitHub Copilot. arXiv. https://arxiv.org/abs/2302.06590 概要:通过编程任务的随机实验报告了使用AI补全的用户完成速度快55.8%。
Reichheld, F. F. (2003). The one number you need to grow. Harvard Business Review, 81(12), 46–54. 概要:提出用"向朋友或同事推荐该产品的可能性"这一个问题测量净推荐值(NPS),并展示了与增长的关联。
Ries, E. (2011). The lean startup: How today's entrepreneurs use continuous innovation to create radically successful businesses. Crown Business. 概要:倡导通过最小化可行产品(MVP)验证假设的"构建-度量-学习"循环。
Rodden, K., Hutchinson, H., & Fu, X. (2010). Measuring the user experience on a large scale: User-centered metrics for web applications. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 2395–2398. 概要:Google提出的HEART框架用五个指标测量用户体验:幸福感、参与度、留存、持续使用和任务成功。
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. 概要:指出影响创新普及速度的五个属性:相对优势、兼容性、复杂性、可试用性和可观察性。
Rozovsky, J. (2015). The five keys to a successful Google team. Google re:Work. 概要:介绍了Google对180个团队的分析,指出心理安全感是预测团队效能的最强因素的内部研究。
Sauro, J., & Lewis, J. R. (2016). Quantifying the user experience: Practical statistics for user research (2nd ed.). Morgan Kaufmann. 概要:汇总了用户研究的统计方法,包括系统可用性量表(SUS)平均得分为68分等内容。
Serrador, P., & Pinto, J. K. (2015). Does Agile work? A quantitative analysis of agile project success. International Journal of Project Management, 33(5), 1040–1051. 概要:对1,002个项目的分析表明,敏捷采纳度与项目效率和利益相关者满意度呈正相关。
Shepherd, D. A., & Gruber, M. (2021). The lean startup framework: Closing the academic–practitioner gap. Entrepreneurship Theory and Practice, 45(5), 967–998. 概要:综述将精益创业的各要素与现有研究相关联,梳理了已有实证的部分和未验证的部分。
Singer, R. (2019). Shape Up: Stop running in circles and ship work that matters. Basecamp. 概要:介绍Basecamp的开发方法,将工作范围控制在六周的固定周期内,由专门团队执行。
Skok, D. (2013). SaaS metrics 2.0: A guide to measuring and improving what matters. For Entrepreneurs. 概要:实践者指南,给出了SaaS指标的基准,如LTV/CAC不低于3、CAC回收期不超过12个月等。
Stanford HAI. (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence. 概要:年度报告总结了AI在技术、经济和政策方面的发展趋势,指出公开基准测试大多趋于饱和,与实际问题的差距在扩大。
Taguchi, G. (1986). Introduction to quality engineering: Designing quality into products and processes. Asian Productivity Organization. 概要:解释了稳健设计(使产品性能对制造波动不敏感)和品质工学(用损失函数定义品质)。
Thomke, S., & Fujimoto, T. (2000). The effect of "front-loading" problem-solving on product development performance. Journal of Product Innovation Management, 17(2), 128–142. 概要:以丰田为例证明,将问题发现和解决前置到开发早期能够改善开发周期和品质。
Thompson, D. V., Hamilton, R. W., & Rust, R. T. (2005). Feature fatigue: When product capabilities become too much of a good thing. Journal of Marketing Research, 42(4), 431–442. 概要:实验证明消费者购买前倾向选择功能丰富的产品,但使用后满意度会下降的"功能疲劳"现象。
Torres, T. (2021). Continuous discovery habits: Discover products that create customer value and business value. Product Talk. 概要:提倡产品小组每周与客户接触,用机会-解决方案树组织假设的持续发现习惯。
Tractinsky, N., Katz, A. S., & Ikar, D. (2000). What is beautiful is usable. Interacting with Computers, 13(2), 127–145. 概要:重复Kurosu & Kashimura(1995)的实验,确认即使实际易用性相同,美观的界面也会被感知为更易用。
Ulrich, K. T., Eppinger, S. D., & Yang, M. C. (2020). Product design and development (7th ed.). McGraw-Hill. 概要:以硬件为中心的产品开发流程的标准教科书,系统阐述了从概念开发到制造的全过程。
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425–478. 概要:提出了整合技术接受理论的 UTAUT 模型,报告显示性能期望、努力期望、社会影响和促进条件可解释使用意图分散的约70%。
Vitsœ. (n.d.). The power of good design: Dieter Rams's ideology, engrained within Vitsœ. https://www.vitsoe.com/gb/about/good-design 概要:Dieter Rams 「好设计的10原则」的官方解说。
Vohra, R. (2018). How Superhuman built an engine to find product market fit. First Round Review. 概要:公开了 Superhuman 将"非常失望"的比例从22%提升至58%的方法的文章。
W3C. (2023). Web Content Accessibility Guidelines (WCAG) 2.2. World Wide Web Consortium. 概要:在可感知、可操作、可理解、稳健的4项原则基础上,规定了网络内容可访问性的实现标准的建议。
Walton, P. (2020). Web Vitals. web.dev. https://web.dev/articles/vitals 概要:定义了 LCP、INP、CLS 作为衡量网络用户体验的核心指标,分别设定2.5秒、200毫秒、0.1以下为"良好"标准。
WebAIM. (2024). The WebAIM Million: The 2024 report on the accessibility of the top 1,000,000 home pages. https://webaim.org/projects/million/ 概要:对排名前100万网站的首页进行自动检测,报告显示95.9%的网站存在 WCAG 违规。
Witell, L., Löfgren, M., & Dahlgaard, J. J. (2013). Theory of attractive quality and the Kano methodology – the past, present, and future. Total Quality Management & Business Excellence, 24(11–12), 1241–1252. 概要:总结了30年关于 Kano 模型的研究,整理了魅力属性随时间转变为基本属性等研究成果。
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, 36. 概要:使用强大的语言模型作为评估者的方法与人类评估者的一致率约为80%,与人类之间的一致率相当。
狩野紀昭・瀬楽信彦・高橋文夫・辻新一(1984).魅力的品质和理所当然的品质.品质, 14(2),147–156.概要:提出了 Kano 模型,区分了理所当然的品质、一元化品质和魅力属性等的原始论文。
已读
接下来阅读 ↓