
Articles
왜 게임에 빠지는가: 최신 연구에 따른 인간의 행동 원리와 응용
Product
Career
일본어 원문으로부터의 자동 번역입니다
1. 서론
게임은 왜 멈출 수 없을까, 공부를 좋아하는 사람과 싫어하는 사람이 있는 이유는 무엇일까, 자신이 열중할 수 있는 것과 그렇지 않은 것의 차이는 무엇일까. 이러한 사람의 동기와 행동은 동기부여 이론의 틀로 설명할 수 있습니다. 즉, 사람의 행동은 외부에서 주어지는 보상(외재적 보상: 돈, 인정 등)과 활동의 내부에서 발생하는 보상(내재적 보상: 호기심, 사람과의 연결 등)에 의해 유발됩니다. 이러한 보상의 설계를 거의 모든 요소를 가장 순수한 형태로 구현하고 있는 것이 텔레비전이나 스마트폰의 게임이며, 이를 통해 사람들은 열중하게 됩니다(중에는 의존하는 사람도). 저도 드래곤 퀘스트나 젤다의 전설 같은 게임을 매우 좋아했습니다.
조직 구성이나 이벤트 등의 기획에서 보상 설계를 하는 것은 매우 중요하며, 유사한 방식으로 설계하는 것이 가능합니다.
기존 문헌을 바탕으로 한 본 내용의 새로움은 다음 두 가지입니다.
도메인 횡단 비교가 없다: 학문은 도메인별로 수직 분할되어 있고, 일반 서적도 "1도메인 1권"이 기본입니다. 같은 이론군 위에 서 있음에도 불구하고, 동일한 관점에서 게임·도박·약물·공부·스포츠·음악·일을 나란히 놓고 비교 정리한 것은 학문·일반 어느 쪽에서도 거의 찾아볼 수 없습니다
밝은 측면과 어두운 측면이 단절되어 있다: 엔게이지먼트 관련 저서(Eyal, 2014)는 "열중의 만드는 방법"만을, 중독 관련 저서(Alter, 2017)는 "위험성"만을 다룹니다. 둘이 같은 메커니즘의 양면이라는 것과 그 분기 조건까지를 하나의 틀로 다룬 정리는 소수입니다
본 고의 구성은 동기부여 이론의 정리, 그 응용으로서의 보상 설계 방법, 그리고 게임·도박·일 같은 사례에서 이러한 보상이 어떻게 설계되고 있는지 설명하는 형태입니다.
2. 동기부여 이론의 정리
동기부여의 주요 이론은 크게 3가지 계통으로 분류할 수 있습니다. 본 장에서는 각 계통 내에서 고전에서 최신 연구까지 시간 순서대로 나열하고, 모든 이론을 공통의 항목(연구 배경·연구 방법·발견과 함의·구체적 예)으로 정리합니다.
계통A 보상과 학습: 외부의 보상(외재적 보상)은 행동을 어떻게 바꾸나
계통B 내재적 동기: 보상이 없어도 사람은 왜 행동하나
계통C 가치와 쾌감의 느낌: 같은 보상도 느끼는 방식은 다르다
2.1 계통A: 보상과 학습: 외부의 보상(외재적 보상)은 행동을 어떻게 바꾸나
이 계통은 "행동의 관찰(1938) → 뇌의 메커니즘(1997) → 계산의 내용(2020~)"과 같은 현상의 해상도가 높아지는 흐름입니다.
작동 조건화(Skinner, 1938; Ferster & Skinner, 1957): 행동 직후에 보상(강화자)이 따라오면 그 행동은 증가한다
연구 배경: 마음속의 추측이 아닌, 관찰 가능한 "행동과 결과의 관계"를 과학으로 만들려던 행동주의의 중심 연구
연구 방법: 비둘기나 쥐를 레버가 달린 실험 장치(스키너 상자)에 넣고, 먹이의 주어지는 방식(스케줄)을 바꾸면서 행동의 빈도를 기록했습니다
발견과 함의: 보상은 "매번"보다 "가끔"일 때 행동이 오래 지속된다. 특히 몇 번째에 당첨되는지 알 수 없는 "변동 비율" 방식이 가장 강력하며, 보상이 멈춰도 행동을 멈출 수 없게 된다. 당시 설명은 "가끔만 당첨되기 때문에 계속하게 된다"였습니다. 왜 효과적인지는 이후 2개의 연구에서 밝혀집니다
구체적 예: 뽑기나 복권. 당첨되는 회차를 예측할 수 없기 때문에(그렇기 때문에) 계속 뽑게 됩니다
보상 예측 오차(Schultz et al., 1997): 도파민은 보상 자체가 아니라 "예측과의 차이"에 반응한다
연구 배경: 도파민은 "쾌감 물질"이라고 생각했습니다. 정말 그럴까 하는 검증
연구 방법: 원숭이의 도파민 신경 활동을 단일 단위로 기록하면서 신호와 보상(주스)의 타이밍을 조작했습니다
발견과 함의: 도파민은 예측보다 좋은 결과면 발화하고, 예측대로면 반응하지 않으며, 예측보다 나쁘면 활동이 감소합니다. 반응을 결정하는 것은 보상의 크기가 아니라 "예측과의 차이"였습니다. 즉, 같은 보상이 매번 같게 전달되면 결국 뇌는 완전히 예측하게 되고 차이는 0이 됩니다. 그러면 도파민은 보상이 전달되어도 더 이상 반응하지 않습니다. 즉, "완전히 예측 가능한 보상은 뇌에게 더 이상 보상이 아니 된다". 또한 이러한 "차이의 정도만큼 배운다"는 계산의 형태는 AI에 시행착오로 학습하게 하는 알고리즘(TD 학습: Temporal Difference Learning, 강화학습의 대표적인 학습 방법)과 거의 같은 식입니다. 뇌와 AI가 같은 계산으로 보상에서 배우고 있었던 것입니다
구체적 예: 매달 정해진 날에 정해진 금액이 전달되는 급여에는 마음이 동하지 않습니다. 처음 가본 가게의 "대박"은 기쁘지만, 매주 같은 점심은 아무 느낌도 없습니다
분포 강화학습(Dabney et al., 2020): 뇌는 보상의 평균이 아니라 "편차(확률분포)"까지 학습한다
연구 배경: AI 연구에서 "평균이 아니라 분포를 배운다"는 알고리즘이 성능을 높이고 있었습니다. 뇌도 같은 계산을 하고 있지 않을까 하는 역방향 가설
연구 방법: 그 알고리즘이 예측하는 발화 패턴을 쥐의 도파민 신경 기록 데이터와 대조했습니다
발견과 함의: 낙관적인 세포와 비관적인 세포가 병렬로 작동하여 일어날 수 있는 결과의 전체 상(분포)을 표현하고 있었습니다. 2025년에는 "언제 전달되는가"까지 포함한 지도를 갖는다는 것도 밝혀졌습니다(Sousa et al., 2025). 이를 통해 1938년의 "가끔 당첨되면 강하다"는 이유가 업데이트되었습니다. 뇌는 편차 자체를 정보로 처리하기 때문에, 변동하는 보상은 학습계에 계속 신호를 보냅니다. 한편, AI에서 먼저 발명된 메커니즘이 나중에 뇌에서 발견되었으며, AI와 뇌 연구는 같은 수식을 공유하기 시작했습니다(결론에서 다시 논의합니다)
구체적 예: 낚시를 하루 종일 할 수 있는 이유는 언제·어떤 크기의 물고기가 올지 모르기 때문입니다. 뇌는 그러한 "모름" 자체를 배우고 있습니다
2.2 계통B: 내재적 동기: 보상이 없어도 사람은 왜 행동하나
이 계통은 "현상의 발견(1975) → 이론화(1985~) → 역효과의 발견(1999) → 신경 기반의 규명(2009~)"과 내재적 동기에 대한 이해가 심리학의 관찰에서 뇌의 메커니즘으로 깊어지는 흐름입니다.
플로우(Csikszentmihalyi, 1975): 도전의 어려움과 자신의 스킬이 맞아떨어질 때, 사람은 시간을 잊고 몰두한다
연구 배경: 예술가나 등산가가 보상도 없이 수시간 활동에 몰두하는 현상에 대한 의문에서 출발했습니다
연구 방법: 면접 조사 외에도 하루에 여러 번 무작위로 호출하여 "지금 무엇을 하고 있고 어떻게 느끼는가"를 기록하게 하는 경험표집법으로 몰두가 일어나는 조건을 특정했습니다
발견과 함의: 몰두는 "도전과 스킬의 균형"이라는 좁은 띠 안에서만 성립합니다. 너무 어려우면 불안하고, 너무 쉬우면 지루합니다. 즉, 열중할 수 있는지는 활동의 측면만으로는 결정되지 않으며, 본인의 스킬과의 균형에 의해 결정됩니다
구체적 예: 요리나 뜨개질, 자료 만들기에서 "깨닫고 보니 2시간이 지났다"는 경험. 적절한 난이도일 때만 일어납니다
자기결정이론(SDT)(Deci & Ryan, 1985; Ryan & Deci, 2000): 내부에서 샘솟는 동기(내재적 동기)는 유능감·자율성·관계성의 3가지가 충족되면 높아진다
연구 배경: "보상이 많을수록 좋다"는 행동주의적 관점에 대한 의문. 사람은 보상이 없어도 놀이와 탐색을 계속합니다
연구 방법: 보상의 유무로 자유시간의 행동이 어떻게 변하는지 본 실험과 질문지 조사의 축적. 최근에는 대규모 메타 분석으로 검증되고 있습니다
발견과 함의: 내재적 동기를 지탱하는 것은 ①유능감(잘하고 있다는 실감), ②자율성(스스로 선택하고 있다는 감각), ③관계성(사람과 연결되어 있다는 감각)입니다. 외재적 보상(돈·평가)은 행동을 "시작하게" 하고, 내재적 동기가 행동을 "계속하게" 합니다. 대규모 메타 분석에서 일관되게 지지되고 있으며(Ryan et al., 2023), 고전 중에서 가장 견고하게 살아남은 이론 중 하나입니다
구체적 예: 의사가 권해서 시작한 조깅은 계속되지 않지만, 동료가 있고 상향을 느낄 수 있는 테니스는 계속됩니다
언더마이닝 효과(Deci, Koestner & Ryan, 1999): 재미있어서 하던 활동에 보상을 붙이면 내재적 동기가 오히려 떨어진다
연구 배경: SDT의 초기 연구에서 발견된 "보상을 더하면 역효과가 난다"는 역설적인 현상
연구 방법: 퍼즐을 푸는 실험에서 보상 있음·없음 그룹으로 나누고, 실험 종료 후 자유시간에 자발적으로 퍼즐을 계속 풀 수 있는지 관찰했습니다. 동형의 실험 128건을 메타 분석으로 통합했습니다
발견과 함의: 보상을 받은 그룹은 보상이 끝나면 자발적으로 계속하지 않습니다. 보상이 "관리"로 느껴질 때 일어나기 쉽고, "상향의 인정"으로 느껴질 때는 일어나기 어렵습니다. 보상 도입으로 자발적인 의욕에 대응하는 뇌활동이 떨어진다는 것도 확인되었습니다(Murayama et al., 2010)
구체적 예: 좋아서 그리던 그림이 의뢰 일이 되는 순간 즐겁지 않아집니다
호기심의 신경과학(Bromberg-Martin & Hikosaka, 2009; Monosov, 2024): 정보를 얻는 것 자체가 보상으로 처리되고 있다
연구 배경: 심리학에서는 "지식의 결핍(정보 격차)이 호기심을 낳는다"는 이론이 먼저 나왔습니다(Loewenstein, 1994). 그러나 그 뇌 내의 실체는 불명확했습니다(심리학과 신경과학의 가교 종설로서 Kidd & Hayden, 2015)
연구 방법: 원숭이에게 "받을 수 있는 보상의 양은 같지만, 결과를 먼저 알 수 있는지 여부만 다르다"는 선택지를 주고 도파민 신경의 활동을 기록했습니다
발견과 함의: 원숭이는 일관되게 "먼저 알 수 있는" 선택지를 선택했고, 그 선호를 도파민 신경이 부호화하고 있었습니다. 인간에서는 호기심이 높은 상태에서 기억 정착이 좋아진다는 것도 밝혀졌습니다(Gruber et al., 2014). "알면 재미있다 → 배운다 → 다음 의문이 생긴다"는 루프는 보상 없이 행동이 계속되는 드문 메커니즘이며, 후술할 "건전한 열중"의 기둥입니다
구체적 예: 계속이 궁금해서 밤을 새우고 다음 동영상·다음 장으로 진행해버립니다
2.3 계통C: 가치와 쾌감의 느낌 — 같은 보상도 느끼는 방식에는 버릇이 있다
이 계통은 "판단의 버릇 발견(1979) → 원하는 것과 좋아하는 것의 분리(2016) → 질린 것의 규명(1999~2018)"과 보상의 "객관적인 크기"와 "느끼는 방식"의 어긋남의 법칙이 하나씩 특정되는 흐름입니다.
손실회피(Kahneman & Tversky, 1979): 동일한 크기의 손실이라도, 잃는 고통이 얻는 기쁨보다 더 크게 느껴진다
연구 배경: "사람은 기댓값대로 합리적으로 선택한다"는 당시 경제학의 전제에 의문을 제기하며 출발했다
연구 방법: 이익이나 손실이 발생하는 "복권" 선택 문제를 다수의 사람에게 제시하고, 선택의 편향을 분석했다
발견과 함의: 사람의 판단은 "기준점으로부터의 증감"에 반응하며, 손실 측의 고통이 더 크다(전망이론). "쌓아 올린 것을 잃고 싶지 않으려는 심리"는 새로운 보상을 더하는 것보다 강하게 작용할 수 있다
구체적 예시: 걸음 수 앱의 연속 기록이 끊어질 것 같아서 밤에 산책을 나간다. 포인트 만료 알림에 재촉되어 물건을 구매한다
wanting / liking(Berridge & Robinson, 2016): "원함"과 "좋아함"은 뇌에서 별개의 회로가 담당한다
연구 배경: 중독의 당사자가 말하는 "즐겁지 않은데 멈출 수 없다"는 모순을 어떻게 설명할 것인가
연구 방법: 쥐의 뇌 특정 부위를 조작하여 도파민을 증감시키고, "원하는 행동"과 "맛있어 보이는 표정 반응"을 별도로 측정했다
발견과 함의: "원함(wanting)"은 주로 도파민계, "좋아함(liking)"은 주로 오피오이드계가 담당하는 별개의 과정이다. 일반적으로는 연동되지만 분리될 수 있으며, wanting만 남고 liking이 사라진 상태가 중독의 핵심이다
구체적 예시: 메일이나 채팅 알림을 열어도 별로 즐겁지 않은데도, 열지 않고는 못 배긴다
포만감(쾌락 적응과 지루함)(Frederick & Loewenstein, 1999; Westgate & Wilson, 2018): 동일한 보상이 계속되면 쾌감이 옅어진다
연구 배경: 복권 당첨자의 행복감이 시간이 지나면서 원래 수준으로 돌아간다는 관찰에서 출발했다
연구 방법: 생활 변화 전후의 행복감을 추적 조사하거나, 지루함이 발생하는 조건을 실험적으로 검토했다
발견과 함의: 쾌감의 기준점은 반복에 따라 상향되어 동일한 보상에는 아무것도 느껴지지 않는다(쾌락 적응). 대상의 패턴을 완전히 학습하여 새로운 정보가 나타나지 않는 것도 포만감의 원인이다(Koster, 2013). 최근에는 지루함을 "이 대상에서 배울 것은 끝났다. 주의를 다른 곳으로 향하라"는 기능적 신호로 보는 이론이 유력하다(Westgate & Wilson, 2018). 포만감은 고장이 아니라 학습 완료의 알림이다
구체적 예시: 아무리 좋아하던 곡도 매일 들으면 아무 감정을 느끼지 못한다. 승급의 기쁨도 몇 개월이 지나면 사라진다
3. 동기이론의 적용: 보상 설계
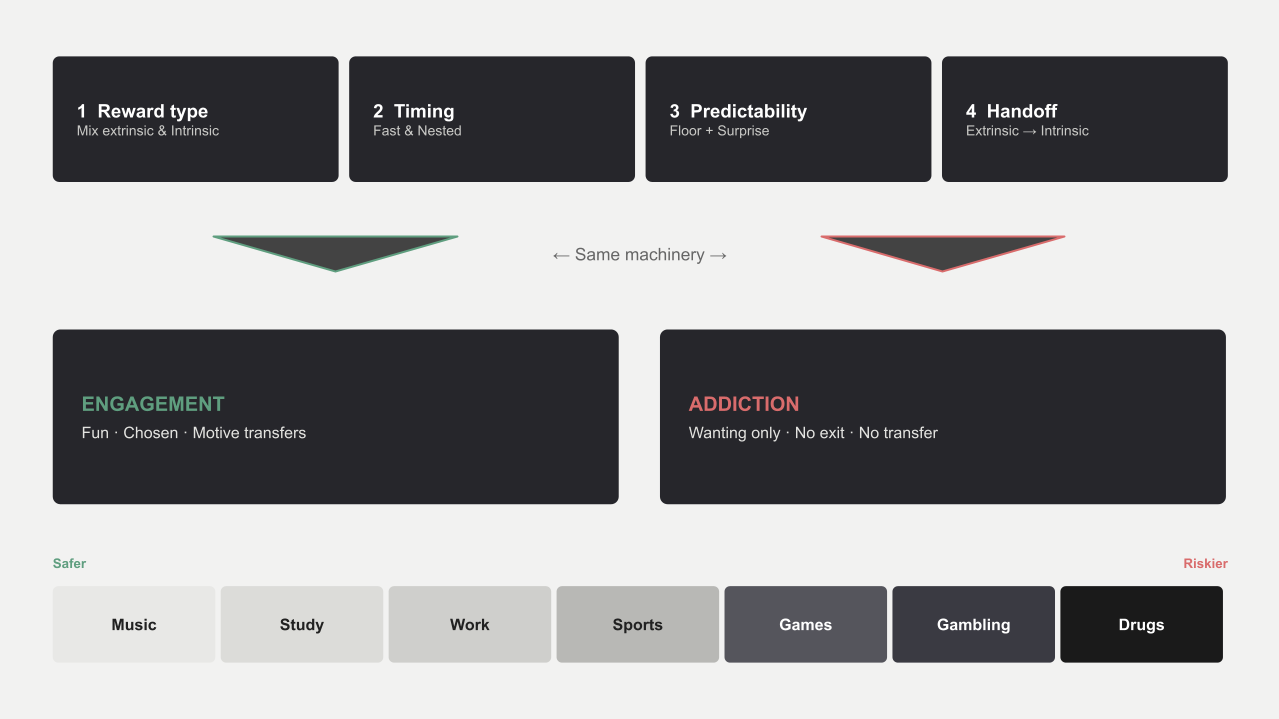
제2장의 이론을 실제 설계에 사용할 수 있는 형태로 번역합니다. 사람이 어떤 활동을 계속할지 말지는 결국 그 활동이 "보상을 어떻게 다루고 있는가"로 결정됩니다. 본 문서에서는 이를 다음 4가지 질문으로 분해합니다. 이 4가지 질문은 이후 전체(제3장의 설계 원칙, 제4장의 분기 정리, 제5장의 사례 분석)에서 공통의 척도로 사용됩니다.
① 보상의 종류: 돈이나 물건뿐 아니라, 칭찬도, 새로운 기회도, 할 수 있는 것이 늘어나는 것도 뇌에게는 보상입니다.
② 보상의 타이밍: 행동 후 결과가 돌아오는 속도가 빠를수록 강하게 작용합니다. 또한 오늘의 즐거움, 이번 주의 즐거움, 이번 달의 즐거움처럼 가까운 곳과 먼 곳에 다음 즐거움이 놓여 있는 것도 중요합니다.
③ 보상의 예측성: 매번 동일하면 뇌가 반응하지 않고, 완전히 운에만 맡기면 불안과 불신을 낳습니다. "확실히 받을 수 있는 토대" 위에 "가끔 일어나는 반가운 놀라움"이 얹혀 있으면 행동이 촉진됩니다.
④ 보상이 외발적에서 내발적으로 변화하는가: 동기 요인(외발적·내발적)의 문제입니다. 보상(외발적 보상)으로 시작된 행동이 최종적으로 "즐거워서", "잘하고 싶어서"라는 본인 내면의 동기(내발적 보상)로 이어지는지를 봅니다. 이어지지 않으면 보상(외발적 보상)을 계속 늘려야만 합니다.
제5장의 사례 분석에서는 이 4가지에 ⑤ 중독성의 높이를 추가합니다. 4가지 질문에 대한 답을 바탕으로 그 활동이 몰입과 중독 중 어느 쪽으로 기울기 쉬운지를 1.3의 3가지 조건(즐거움·갈아탈 곳·멈출 자유)으로 판정하고, 안전장치와 규제의 현황을 확인하는 마무리 항목입니다.
이하 각 절은 공통 항목(근거한 이론·원칙·구체적 예시·주의점)으로 정리됩니다.
3.1 ① 보상의 종류
근거한 이론: 계보B의 유능감·관계성·호기심, 계보C의 손실회피. 보상의 종류에 따라 효과가 나타나는 이론이 다르다
원칙
외발적 보상: 외부에서 주어지는 보상(외발적 보상)은 4가지 종류로 정리할 수 있다(Hallford & Hallford, 2001). 정석은 4가지를 혼합하는 것으로, 어느 한 쪽에 편중되면 오래가지 않는다
승인: 실질적 이득은 없지만 인정받는 보상(표창, 호칭, 칭찬). 유능감을 직접 충족시킨다. 비용이 거의 제로인데도 효과가 있다
유지: 잃으면 아프다고 느끼는 보상(지위, 처우, 쌓아 올린 기록). 손실회피에 작용한다
기회: 새로운 문이 열리는 보상(새로운 업무, 새로운 장소로의 초대). 호기심에 작용한다
능력: 할 수 있는 것이 늘어나는 보상(기술, 권한, 도구). 유능감의 실체로, 4가지 종류 중 가장 강력하다
내발적 보상: 활동의 내면에서 생기는 보상(내발적 보상)도 제2장의 이론에서 4가지 종류로 정리할 수 있다. 이것은 직접 줄 수 없고, 설계할 수 있는 것은 발생 조건뿐이다
유능감: 실력이 늘었다·할 수 있게 되었다는 실감
호기심: 알고 싶던 것을 알게 된다, 새로운 정보를 얻는 기쁨
관계성: 사람과 연결되어 있다, 누군가의 도움이 되는 실감
감각적 쾌감: 음향이나 감촉 등 그 자체로 기분 좋은 자극(liking)
구체적 예시: 승진이 기쁜 것은 직책(승인)뿐 아니라 할 수 있는 것이 늘어나기(능력) 때문이다. 직책만 있는 승진이 공허한 것은 능력의 실체가 없기 때문이다
설계의 포인트: 한 가지 종류를 많이 발급하면 효과가 없다. 특히 승인만 남발하면 가치 자체가 옅어진다. 제5장에서는 외발 4가지 + 내발 4가지, 총 8가지를 사용하여 사례를 비교한다
3.2 ② 보상의 타이밍
근거한 이론: 계보A의 보상 예측 오류. 예측 오류는 행동 직후에 발생하기 때문에, 그 자리에서 돌아오는 피드백이 뇌에 가장 높은 빈도로 신호를 보낸다
원칙: 보상을 복수의 시간대에 중첩시켜 놓고, 어느 시간 단위에서 봐도 "곧 무언가가 있을" 상태를 만든다. 가장 하단의 즉시 피드백이 가장 중요하며, 이것이 약하면 상위 설계는 모두 효율성이 떨어진다
구체적 예시: 운동 앱이면 1회 기록(그 자리) → 오늘의 달성(일) → 연속 기록(주) → 월간 실적(월). 업무면 일일 승인 → 주간 진행 상황 → 분기별 평가
설계의 포인트: 사람들이 떠나는 것은 계층이 빠진 곳이다. 연간 평가만 있는 직장은 일~주 계층이 통째로 빠져 있다
3.3 ③ 보상의 예측성
근거한 이론: 계보A의 변동 비율(행동이 가장 오래 지속됨)과 분포 학습(뇌는 편차 자체를 정보로 처리함), 계보C의 포만감(동일한 보상은 예측이 완성되어 효과가 없어짐)
원칙: 완전히 예측 가능한 보상은 효과가 없다. 다만 모든 것을 불확실하게 하면 불신과 불공정감이 생긴다. 정석은 2단계 구조다
기본 라인: 확실히 받을 수 있는 보상. 신뢰와 안심을 보장한다
스파이크: 가끔 일어나는, 예측할 수 없는 좋은 일. 학습계를 계속 움직인다
구체적 예시: 고정 급여라는 토대(확실)의 위에 돌발적인 좋은 소식이나 작은 깜짝 선물(변동)이 얹혀 있는 상태가 이상적이다. 하루에 수십 번이나 메일이나 SNS를 확인하는 것도 "언제 좋은 소식이 올지 모른다"는 변동 보상의 구조 때문이다
설계의 포인트: 토대 자체를 흔들면 안 된다. 급여를 변동시키면 동기부여 효과보다 공정성을 해치는 비용이 더 크다
3.4 ④ 보상이 외발적에서 내발적으로 변화하는가
근거한 이론: 계보B의 SDT(행동을 지속시키는 것은 내발적 동기), 과정정당화 효과(내발적 동기에 외발적 동기를 설정하면 무너짐), 호기심(보상 없이도 도는 드문 루프), 계보C의 포만감(외발적 보상만으로는 보상 인플레에 빠짐)
원칙: 외발적 보상으로 시작하게 하고, 계속하는 동안 유능감·호기심·관계성을 키우며, 내발적 동기에 주역을 넘긴다. 이 순서는 역순으로 할 수 없다
구체적 예시: 운동이면 처음엔 앱 기록이나 보상으로 습관을 들이고, 체조가 좋아지는 실감(내발적 동기)이 생기면 그쪽에 주역을 넘긴다
설계의 포인트: 이미 즐기고 있는 활동에 보상을 얹으면 과정정당화 효과의 조건이 갖춰진다(즐겁게 하던 활동이 즐겁지 않아져서 멈춤). 또한 내발적 보상이 발생하지 않는 구조는 외발적 보상을 계속 늘려야만 한다
4. 중독과 몰입의 차이 — 무엇이 분기를 결정하는가
제3장은 "사람을 계속하게 하는 설계"의 원칙이었습니다. 그러나 같은 원칙으로 몰입도, 중독도 만들 수 있습니다. 어떤 요소가 몰입과 중독 중 어느 쪽을 촉진하는지 정리합니다.
4.1 몰입과 중독의 상태 차이
요소는 공통이다: 변동 보상, 손실회피, wanting(제2장). 외부에서 본 행동도 같으며 장시간 몰입·높은 지속률로 나타난다. 따라서 엔게이지먼트 지표로는 구분할 수 없다
몰입은 중독의 연장이 아니다: 실증적으로도 "높은 열중(몰입)"과 "병적 사용(중독)"을 측정해서 구분하면, 상관성은 있지만 별개의 인자로 나뉜다(Charlton & Danforth, 2007). 중독은 몰입의 연장(진한 버전)이 아니라, 공통 부분을 가진 별개의 상태다
몰입과 중독의 상태:
몰입: "즐겨서, 스스로 선택해서, 계속하고 있다". wanting(원함)과 liking(좋아함)이 연동한다
중독: "즐겁지 않은데, 선택할 수 없으면서, 계속된다". wanting(원함)만 남고 liking(좋아함)이 없다
4.2 무엇이 몰입을 촉진하고, 무엇이 중독을 촉진하는가
제3장의 4가지 질문에 따라 촉진 요소를 대비할 수 있습니다.
① 보상의 종류
몰입을 촉진: 종류가 다양하다. 특히 내발 4가지(유능감·호기심·관계성·감각적 쾌감)가 풍부하다
중독을 촉진: 종류가 단일하고, 외발(금전 등)이거나 직접적인 쾌감에 집중한다
② 보상의 타이밍
몰입을 촉진: 즉시 피드백에 더해 일~년의 중첩이 있다
중독을 촉진: 즉시만 있고 중첩이 없다("다음 한 번"만 있음)
③ 보상의 예측성
몰입을 촉진: 확실한 토대 위에 정도 좋은 변동이 얹혀 있다
중독을 촉진: 토대 없이 변동만 있다. 아찰 놓침이나 통제 착각 등의 증폭 장치 포함
④ 보상이 외발적에서 내발적으로 변화하는가
몰입 촉진: 전환처(상달·지식·동료)가 마련되어 있음
의존 촉진: 전환처가 없음. 통제적인 외재적 동기만 계속됨
설계 측면의 요소에 더해, 본인·상황 측면의 요소도 있습니다. 같은 설계라도 스트레스나 고립이 강하면, 활동이 "쾌감을 얻는 수단"에서 "불쾌에서 벗어나는 수단"으로 바뀌어 의존 쪽으로 기울어집니다. 의존 연구에서는 보상을 추구하는 단계(충동)에서 고통을 제거하는 단계(강박)로의 이행으로 공식화되어 있습니다(Koob & Volkow, 2016).
4.3 몰입이 의존으로 변하는 신호
몰입이 깊어져서 의존이 되는 것이 아닙니다. 아무리 깊게 몰두하고 있어도, 즐거움과 선택의 자유가 남아 있는 한, 그것은 몰입입니다. 위험한 것은 깊이가 아니라, 몰입을 지탱하던 조건이 빠져나가는 것입니다. 행동은 같은데, 계속하는 이유만 바뀌어갈 때, 몰입은 의존으로 변합니다.
신호는 3가지이며, 다음의 1번만 해당되면 누구에게나 일어나는 "질림"의 범위이지만, 2번이 겹치면 주황등, 3번까지 갖춰지면 의존의 영역입니다.
1. 즐거움의 마모: "재미있으니까 한다"에서 "하지 않으면 불안해서 한다"로 바뀜
일어나는 현상: 반복에 따라 "좋아함(liking)"은 옅어지는데(쾌락 적응), "원함(wanting)"만 남는다. 행동의 목적이 쾌감을 얻는 것에서 불안함이나 죄책감 같은 불쾌감을 제거하는 것으로 바뀐다. 의존 연구에서는 이 "쾌의 추구 → 불쾌의 해소"로의 전환이 의존의 입구로 여겨집니다(Koob & Volkow, 2016).
구체 사례: 시작한 순간 이미 질렸는데, 일과를 처리하지 않으면 하루가 끝난 기분이 들지 않음
구분 방법: 끝난 직후에 만족감이 남아 있는지 떠올려 본다. "재미있었다"가 아니라 "처리했다"는 느낌뿐이라면, 마모가 시작되고 있는 것
2. 동기의 고착: 계속하는 이유가 "잃고 싶지 않다"는 것뿐이 됨
일어나는 현상: 원래라면 상달·호기심·동료(내재적 동기)로 옮겨가야 할 동기가, 연속 기록 유지나 손실 회복 같은 손실 회피에만 고정된다. 앞으로 나아가기 위한 것이 아니라 뒤로 물러나지 않기 위해 계속하는 상태
구체 사례: 놀고 싶어서가 아니라 스트릭을 끊기 싫어서 로그인한다. 진 것을 되찾기 위해서만 계속 거는 것
구분 방법: "지금 멈춰도 아무것도 잃지 않는다면, 그래도 계속하고 싶은가"라고 자문한다. 답이 아니오라면, 동기는 손실 회피만으로 돌아가고 있는 것
3. 생활의 침식: 멈출 자유가 실제로 사라짐
일어나는 현상: 수면·일·인간관계 등 다른 영역을 희생해도 행동이 계속되고, 자신이 정한 제한을 지키지 못하게 된다. 여기까지 오면, 이제 의지의 문제가 아니다. WHO나DSM-5가 의존의 진단에 사용하는 요건(조절 장애·생활 우선순위의 일탈·부정적 영향이 있어도 계속함)은, 정확히 이 단계를 가리킨다.
구체 사례: 내일 일찍 시작한다는 것을 알면서 "한 번만 더"가 멈추지 않는다. 사용 시간이나 금액을 정해도, 매번 초과한다.
구분 방법: 횟수·시간·금액의 상한을 직접 정하고, 1주일 지킬 수 있는지 시험해 본다. 지키지 못하면, 조절은 이미 사라지기 시작한 것
이 3가지가 5장의 각 사례에서 "의존성의 높이"를 판정하는 기준이 됩니다.
5. 사례 연구
여기부터는 사례 연구로서, 지금까지의 관점을 각 사례에서 정리합니다.
5.1 게임은 왜 몰입하게 되는가
요점: 8가지 유형의 보상·완벽한 중첩·이층의 변동이라는 "모두 포함된" 설계로, 내재적 동기로의 전환처도 마련되어 있다. 바로 이 때문에, 설계에 따라 몰입에도 의존에도 기울어질 수 있다.
보상 설계
① 보상의 종류
외재적 동기
승인: 칭호·업적·클리어 연출
유지: 회복 아이템이나 연속 기록
기회: 새 지역 해금
능력: 새로운 무기나 스킬
내재적 동기
유능감: 상달의 실감
호기심: 다음 전개·미탐험 지역의 탐색
관계성: 협력 플레이나 길드 동료
감각적인 쾌감: 조작감·게임 필(Swink, 2008)
② 보상의 타이밍
즉시: 히트의 반응·효과음·경험치
일: 데일리 보너스·일과 미션
주: 주간 미션·이벤트
월: 시즌·랭킹 업데이트
년: 대규모 업데이트·주년 이벤트
③ 보상의 예측성
베이스라인(고정): 플레이하면 확실히 모이는 경험치, 로그인 보상, 천장(일정 횟수에서 최고 레어도를 보장)
스파이크(변동): 뽑기 당첨, 레어 드롭
④ 보상이 외재적에서 내재적으로 변화하는가
변화한다: 데일리 보상으로 습관화시키고, 그 사이에 상달·탐색·동료의 즐거움으로 전환시킨다. "게임의 재미의 정체는 학습이다"라는 실무자의 통찰(Koster, 2013)은 전환처가 호기심임을 정확히 맞추고 있다.
의존성
의존성의 높이
중~고: 설계에 따라 몰입에도 의존에도 기울어질 수 있는 양의적 영역이며, 계속률이나 이용 시간으로는 둘을 구별할 수 없다.
의존에 대한 대책
벨기에의 도박법 위반 판정(2018년. Xiao, 2023)이나 WHO의 "게임 행동 장애" 수재(2019년, ICD-11) 등 규제는 형성 중이지만, 네덜란드에서는 제재금이 2022년 재판에서 취소되는 등 사법 판단은 엇갈리고 있습니다(Drummond & Sauer, 2018; Zagal et al., 2013).
몰입·의존이 높아지는 사이클
몰입 사이클: 도전한다 → 반응이 돌아온다(예측 오차) → 약간 상달한다(유능감) → 더 어려운 도전이나 새 지역이 해금된다(기회·호기심) → 더 도전한다. 상달할수록 다음 도전이 재미있어지는, 플로우의 자가 가동 루프.
의존 사이클: 데일리와 스트릭을 처리한다 → 적립이 늘어난다 → 잃고 싶지 않아진다(손실 회피) → 의무로서 로그인한다 → 즐거움이 닳아도, 적립을 지키기 위해 계속한다. 뽑기에서는 "꽝 → 다음엔 당첨될 거라고 생각(변동비율) → 쓴 돈을 되돌리고 싶어진다"가 겹친다.
5.2 도박은 왜 못 멈추는가
요점: 보상은 금전뿐·중첩 없음·토대 없이 변동만이라는 구조이며, 내재적 동기로의 전환처가 없다. 구조 자체가 의존 쪽으로 기울어 있다.
보상 설계
① 보상의 종류
외재적 동기
승인: −
유지: 상금·금전
기회: −
능력: −
내재적 동기
유능감: −
호기심: −
관계성: −
감각적인 쾌감: 승부의 흥분·거의 당첨된 듯한 희열(욕구 주도)
② 보상의 타이밍
즉시: 스핀이나 레이스의 결과가 그 자리에서 나온다.
일: −
주: −
월: −
년: −
③ 보상의 예측성
베이스라인(고정): −
스파이크(변동): 상금뿐. 변동비율이 가장 순수한 형태로 나타나며, 거의 당첨 효과("거의 맞다"는 꽝이 뇌에서는 승리에 가까운 반응을 일으킨다)로 증폭된다(Clark et al., 2009).
④ 보상이 외재적에서 내재적으로 변화하는가
변화하지 않는다: 아무리 계속해도 상달이 승률을 바꾸지 않으며, 전환처가 구조적으로 존재하지 않는다. 동기는 wanting(원함)의 한 줄로 집중하고, Liking(좋아함)은 수척해진다(같은 승리로도 흥분하지 않는 내성에 대해, 즐거움을 보충하는 상달이나 발견이 구조적으로 없기 때문).
의존성
의존성의 높이
고: 구조 자체가 의존 쪽으로 기울어져 있으며, DSM-5는 2013년 도박 장애를 약물 의존과 같은 범주에 수재했습니다(American Psychiatric Association, 2013).
의존에 대한 대책
입금 한도나 자기배제 프로그램이 주요 수단이지만, 변동비율이라는 핵심 구조가 남아 있기 때문에, 효과가 제한적이라는 평가가 계속되고 있습니다.
몰입·의존이 높아지는 사이클
몰입 사이클: −(성립하기 어렵다. 상달도 탐색도 없기 때문에, 초기 흥분이 옅어진 후에 즐거움을 갱신할 재료가 없다).
의존 사이클: 건다 → 가끔 당첨·거의 당첨으로 "아깝다"고 느낀다 → "다음엔"이 강해진다(변동비율 + 거의 당첨 효과) → 패배가 쌓인다 → 되돌리기 위해 배팅액이 올라간다(손실 회피 + 내성) → 더 진다. 당첨되어도 멈추지 않는 것은, 당첨이 "기쁨"이 아니라 "회수"가 되기 때문이다.
5.3 약물은 왜 의존하는가
요점: 보상 설계라는 질문 자체가 사라지고, 화학 물질이 뇌에 직접 작용한다. 전환처가 존재하지 않으며, 분기의 여지가 구조적으로 최소다.
보상 설계
① 보상의 종류
외재적 동기
승인: −
유지: −
기회: −
능력: −
내재적 동기
유능감: −
호기심: −
관계성: −
감각적인 쾌감: 약리적 쾌감(다만, 내성에 의해 감소해간다)
② 보상의 타이밍
즉시: 섭취하면 최빠르게, 확실하게, 자연스러운 보상보다 큰 도파민이 분비된다.
일~년: −
③ 보상의 예측성
베이스라인(고정): −
스파이크(변동): −(흔들림 자체가 불필요해진다. 약물은 신경에 직접 작용하기 때문에, 뇌에는 "예측을 항상 상회하는 보상"으로 전달되며, 체험의 질과 무관하게 행동의 가치가 계속 올라간다).
④ 보상이 외재적에서 내재적으로 변화하는가
변화하지 않는다: 건넬 곳이 존재하지 않으며, "좋아함"에는 내성이 붙고, "원함"만 증대한다(Berridge & Robinson, 2016). 진행되면, 브레이크 역할을 하는 전전두엽의 작동 자체가 손상된다(Koob & Volkow, 2016).
의존성
의존성의 높이
극도로 높음: 3가지 조건이 모두 최심부까지 기울어져, 분기의 여지가 구조적으로 거의 없는 "회로의 직접 점유".
의존에 대한 대책
치료와 공중보건이 중심이며, 현재의 의학은 의존을 의지의 약함이 아니라 뇌의 질환으로 취급합니다(Koob & Volkow, 2016).
몰입·의존이 높아지는 사이클
몰입 사이클: −
의존 사이클: 섭취한다 → 강한 쾌감 → 내성이 붙어, 같은 양으로는 듣지 않는다 → 량과 빈도가 늘어난다 → wanting이 감작되어, 끊기면 불쾌해진다 → 불쾌를 제거하기 위해 섭취한다(쾌의 추구에서 불쾌의 해소로) → 과도한 도파민에 대해 수용체가 줄어들고, 그 입력에 의존하던 전전두엽의 브레이크 자체가 약해진다 → 루프에서 빠져나오기 어려워진다.
5.4 공부를 좋아하는 사람과 싫어하는 사람은 뭐가 다른가
요점: 피드백이 느리고 외재적에 치우친 설계이지만, 본래는 최선의 내재적 보상(호기심)이 내장되어 있다. "알다 → 재미있다 → 다음 의문"의 자가 가동 루프가 시작되는지 아닌지가, 좋아함과 싫어함을 가른다.
보상 설계
① 보상의 종류
외재적 동기
승인: 성적·순위·칭찬받음
유지: −
기회: 진학·자격에 의한 선택지의 확대
능력: 학력·스킬의 습득
내재적 동기
유능감: "할 수 있게 되었다"는 실감
호기심: "알았다!"는 쾌감·다음 의문(Bromberg-Martin & Hikosaka, 2009; Monosov, 2024)
관계성: −(일제 수업에서는 약하다)
감각적인 쾌감: −
② 보상의 타이밍
즉시: −(그 자리에서의 반응이 거의 없다).
일: 숙제의 채점 정도
주: 소테스트
월: 정기고사·성적
년: 입시·진급
③ 보상의 예측성
베이스라인(고정): −(노력이 확실히 보상받는다는 보장이 없다).
스파이크(변동): −(설계된 변동은 없으며, "열심해도 오르지 않는 성적"이라는 무력감을 낳는 흔들림만 있다).
④ 보상이 외재적에서 내재적으로 변화하는가
변화할 수 있다——이것이 좋아하는 사람과 싫어하는 사람의 분기점이다: 「안다 → 즐겁다 → 다음 의문」의 자율 루프(Murayama, 2022)가 시작되면 기억도 정착하기 쉬워지고(Gruber et al., 2014) 성적은 부산물이 된다. 루프가 시작되지 않고 통제적인 외발(성적·꾸중·비교)만 계속되면 동기 저하의 조건이 갖춰진다(Deci, Koestner & Ryan, 1999)
의존성
의존성의 높이
낮음: 과제는 의존이 아니라 전환 실패가 「싫어함」으로 고착되는 것
의존 대책
−(필요한 것은 루프 시작 지원이다. 자율성을 지원하는 개입이 동기 부여와 성적 모두를 개선한다. Wang et al., 2024)
열정·의존이 높아지는 사이클
열정의 사이클: 의문을 가진다 → 알아본다 「알았다!」(정보의 쾌감) → 할 수 있는 것이 증가한다(유능감) → 모르는 것의 윤곽이 보인다 → 다음 의문이 떠오른다. 알수록 재미있어지는 자율 루프(Murayama, 2022)
의존의 사이클: −(의존은 일어나기 어렵다. 대신 「싫어함」이 고착되는 악순환이 있다: 모른 채로 진행된다 → 따라가지 못해 성적이 떨어진다 → 꾸중·비교라는 통제적 외발이 강해진다 → 공부와 불쾌함의 결합이 강해진다 → 더욱 손이 가지 않는다)
5.5 왜 사람들은 스포츠에 열광하는가
요점: 대본이 없는 변동과 소속·대리 보상이라는 내발이 주역. 자신은 상달하지 않는데도 평생 계속되는, 드물게 안전한 열광(다만 도박이 결합되면 급변한다)
보상 설계
① 보상의 종류
외발
승인: −
유지: −
기회: −
능력: −
내발
유능감: −(자신은 상달하지 않기 때문)
호기심: 전술·전개를 읽는 재미
관계성: 동료와의 관전, 팀에 대한 소속감. 인간은 소속 집단을 자기 자신의 일부로 취급하고(Tajfel & Turner, 1979) 이긴 다음 날은 「우리가 이겼다」, 지면 「그들이 졌다」고 말한다(BIRGing. Cialdini et al., 1976)
감각적 쾌감: 경기의 흥분·승리의 고양. 응원하는 팀의 성공이나 라이벌의 패배에 자신의 보상 시스템이 반응하는 대리 보상(Cikara et al., 2011)
② 보상의 타이밍
즉시: 한 번의 플레이마다의 환성과 흥분
일: 경기
주: 리그전의 절
월: 시즌의 순위 경쟁
년: 우승 경쟁·오랜 염원의 타이틀(수십 년 단위인 경우도 있다)
③ 보상의 예측성
베이스라인(고정): −(승리의 보장은 없다)
스파이크(변동): 대본이 없는 변동. 결과는 본질적으로 불확실하고, 명승부는 「가끔만 오는」 진정한 변동 비율
④ 보상은 외발적에서 내발적으로 변화하는가
대체로 처음부터 내발: 승패의 쾌감에서 지식과 동료의 즐거움으로 확산된다. 자신은 1밀리도 상달하지 않는데도 평생 계속되는 것은 이러한 확산 때문
의존성
의존성의 높이
낮음: 다만 스포츠 베팅이 결합되면 도박의 구조(5.2)가 연결되어 의존 쪽으로 급선회한다
의존 대책
베팅의 전 세계적 확대가 관전과 도박의 경계를 녹이고 있으며, 각국에서 규제 논의가 진행 중
열정·의존이 높아지는 사이클
열정의 사이클: 경기를 본다 → 극적인 순간(대본이 없는 변동)을 맞닥뜨린다 → 팀에 대한 애정과 전술의 지식이 깊어진다 → 문맥을 알수록 다음 경기가 재미있어진다 → 시즌의 서사를 계속 추적한다. 지식과 소속이 깊어질수록 같은 경기에서 받을 수 있는 보상이 증가한다
의존의 사이클: −(관전 단독으로는 성립하기 어렵다. 다만 베팅이 결합된 순간 도박의 사이클이 그대로 연결된다)
5.6 왜 사람들은 같은 음악을 계속 듣는가
요점: 외발 제로·liking 주도의 가장 안전한 도메인. 「알아도 예기의 쾌감이 작동한다」는 구조가 질리지 않고 계속 들을 수 있는 이유
보상 설계
① 보상의 종류
외발
승인: −
유지: −
기회: −
능력: −
내발
유능감: −
호기심: 다음 전개의 예기(Huron, 2006)
관계성: −
감각적 쾌감: 음 자체의 쾌감·소름 끼침(Salimpoor et al., 2011)
② 보상의 타이밍
즉시: 수 초마다의 긴장과 해결(모든 경우 중 가장 높은 밀도)
일: −
주: −
월: 신곡·앨범 발매
년: 라이브나 페스
③ 보상의 예측성
베이스라인(고정): 알고 있는 곡의 전개. 반복적 접촉 자체가 호감을 높인다(단순 접촉 효과. Zajonc, 1968)
스파이크(변동): 적절한 불확실성과 놀라움의 조합으로 쾌감이 최대가 된다(Cheung et al., 2019). 「알고 있다」는 것과 「예기가 작동한다」는 것은 별개이며, 쾌감의 피크 수 초 전부터 예기에 대응하는 뇌 부위에서 도파민이 방출된다(Salimpoor et al., 2011)——질림의 이론(2.3)에 대한 겉보기의 반례가 여기서 풀린다
④ 보상은 외발적에서 내발적으로 변화하는가
변화가 불필요: 처음부터 내발이므로 보상 인플레도 발생하지 않는다
의존성
의존성의 높이
극히 낮음: liking(좋아함)이 주도하고 wanting(원함)을 자극하지 않으며, 7가지 경우 중 가장 안전한 약물의 정반대
의존 대책
−(굳이 말하자면, 스트리밍의 자동 재생이 「다음 곡」이라는 변동 보상을 외부에 붙여 청취의 성질을 조금 바꾼다)
열정·의존이 높아지는 사이클
열정의 사이클: 듣는다 → 예기와 해결의 쾌감이 작동한다 → 반복할수록 호감이 증가한다(단순 접촉 효과) → 또 듣고 싶어진다. 동시에, 좋아하는 곡 → 비슷한 곡에 대한 호기심 → 새로운 발견 → 레퍼토리가 확대된다는 탐색의 루프도 돈다
의존의 사이클: −
5.7 일을 좋아하는 사람과 그렇지 않은 사람의 차이는 무엇인가
요점: 보상의 종류는 풍부하지만, 고정급은 예측 오차를 생기지 않게 하고, 피드백의 빠르기는 역할에 따라 결정된다. 급여에서 성장·재량·기여의 실감으로 전환할 수 있는가가 호불호를 가르는 기준
보상 설계
① 보상의 종류
외발
승인: 평가·표창·감사
유지: 급여·지위
기회: 새로운 과제·발탁
능력: 스킬·권한의 확대
내발
유능감: 할 수 있는 것이 증가하는 실감
호기심: 새로운 과제나 학습(역할에 따라 다름)
관계성: 고객이나 동료의 역할에 서는 손응(SDT의 3가지 욕구가 그대로 적용된다. Ryan & Deci, 2000)
감각적 쾌감: −
② 보상의 타이밍
즉시: 역할에 따라 다름(결과가 일 단위로 돌아오는 일도, 년 단위에서만 손응이 오는 일도 있다)
일: 매일의 승인·작은 완료
주: 주간 진척
월: 월간 성과 확인
년: 평가·상여금·승진(년차 평가만 있는 직장은 일~주의 층이 통째로 빠져 있다)
③ 보상의 예측성
베이스라인(고정): 고정급. 완전히 예측 가능하므로 예측 오차는 생기지 않지만, 토대로서는 이상적
스파이크(변동): 승인, 성장의 실감, 돌발적인 좋은 소식. 이것이 토대 위에 올라가는지 여부가 차이가 된다
④ 보상은 외발적에서 내발적으로 변화하는가
변화할 수 있다——여기가 좋아하는 사람과 그렇지 않은 사람의 분기점이다: 급여로 시작해서 성장·재량·기여의 실감으로 이어지는가. 전제로서 급여나 고용의 안정(위생 요인)이 충족되지 않으면 그 다음 이야기는 시작되지 않는다(Herzberg, 1959). 재량이 없고 통제적 관리와 평가만 있는 환경에서는 동기 저하의 조건이 갖춰진다
의존성
의존성의 높이
낮음: 주요 문제는 의존이 아니라 동기 고갈이며, 호불호의 상당 부분은 구조(피드백의 빠르기·재량·성장의 실감·관계의 질)의 함수
의존 대책
−(대응책은 고갈 대책이 주요 초점이다. 조직 측은 3.5에 따르고, 개인 측에는 직무를 스스로 재구성해서 자율성을 되찾는 직무 창작이 있다. Wrzesniewski & Dutton, 2001)
열정·의존이 높아지는 사이클
열정의 사이클: 맡겨진다 → 해내다(완료의 손응) → 성장의 실감과 주변의 신뢰가 증가한다(유능감·관계성) → 더 큰 재량과 과제가 온다(기회) → 더욱 도전한다. 신뢰와 재량이 늘어날수록 일이 재미있어지는 선순환
의존의 사이클: −(의존보다 「고갈」의 악순환이 전형적이다: 성과가 보이지 않는다 → 평가받지 못한다 → 의욕이 떨어진다 → 더욱 성과가 나오지 않는다. 대응책은 이 역회전을 위의 사이클의 순회전으로 되돌리는 것)
6. 맺음말
이렇게 정리하면, 자신이 열정을 쏟고 있는 것의 이유나, 재미없는데도 의존해서 쉽게 멈추지 못하는 것, 사회적으로 의존증이 문제가 되고 있는 배경을 알 수 있을 것 같습니다. 자신 스스로나 조직, 사회를 건전하게 유지·발전시키기 위해서도 적절히 보상을 설계할 필요가 있습니다.
참고 문헌
Alter, A. (2017). Irresistible: The Rise of Addictive Technology and the Business of Keeping Us Hooked. Penguin. 개요: 테크놀로지에 대한 행동 중독을 다룬 대표적인 일반 서적. 의존의 위험 쪽에 초점을 맞추고 있으며, 건전한 열정과의 분기 조건은 주제로 하지 않는다.
American Psychiatric Association (2013). Diagnostic and Statistical Manual of Mental Disorders (5th ed.). 개요: 도박 장애를 물질 관련 장애와 같은 카테고리에 처음 수재. 행동에 대한 의존이 약물 의존과 같은 틀로 다루어진 공식적 전환점.
Berridge, K. C., & Robinson, T. E. (2016). Liking, wanting, and the incentive-sensitization theory of addiction. American Psychologist, 71(8), 670–679. 개요: 「원함(wanting)」과 「좋아함(liking)」이 별개의 신경 과정임을 정리하고, wanting만 항진하는 인센티브 감작으로 의존을 설명하는 이론의 총설.
Bromberg-Martin, E. S., & Hikosaka, O. (2009). Midbrain dopamine neurons signal preference for advance information about upcoming rewards. Neuron, 63(1), 119–126. 개요: 원숭이가 보상량이 변하지 않는 조건에서도 「결과를 미리 알 수 있다」는 선택지를 선택하고, 그 선호를 도파민 신경이 부호화함을 보인 정보 자체가 보상임을 직접 증명한 연구.
Charlton, J. P., & Danforth, I. D. W. (2007). Distinguishing addiction and high engagement in the context of online game playing. Computers in Human Behavior, 23(3), 1531–1548. 개요: 온라인 게임의 플레이어에서 「높은 열중」과 「의존」을 측정해서 나누면 상관이 있지만 별개의 요인으로 나뉨을 보인 연구. 열정과 의존이 한 축의 농담이 아님을 실증적으로 뒷받침.
Cheung, V. K. M., Harrison, P. M. C., Meyer, L., Pearce, M. T., Haynes, J.-D., & Koelsch, S. (2019). Uncertainty and surprise jointly predict musical pleasure and amygdala, hippocampus, and auditory cortex activity. Current Biology, 29(23), 4084–4092. 개요: 팝 음악의 코드 진행을 통계적으로 분석하여 「적절한 불확실성과 놀라움」의 조합일 때 음악의 쾌감이 최대가 됨을 보여준 연구. 음악의 쾌감이 예측의 과학으로 설명 가능함을 실증했다.
Cialdini, R. B., Borden, R. J., Thorne, A., Walker, M. R., Freeman, S., & Sloan, L. R. (1976). Basking in Reflected Glory: Three (Football) Field Studies. Journal of Personality and Social Psychology, 34(3), 366–375. 개요: 응원팀이 이긴 다음날 로고가 있는 옷을 입는 학생이 증가하고 「we won/they lost」라는 표현의 사용 구분이 일어남을 보여준 고전. 집단의 영광을 자신의 보상으로 받아들이는 현상(BIRGing)의 원전.
Cikara, M., Botvinick, M. M., & Fiske, S. T. (2011). Us Versus Them: Social Identity Shapes Neural Responses to Intergroup Competition and Harm. Psychological Science, 22(3), 306–313. 개요: 열렬한 팬에서는 응원팀의 성공뿐만 아니라 라이벌의 실패에도 보상계(복측 선조체)가 반응함을 보여준 fMRI 연구. 경기 관전이라는 대리 경험이 보상으로 처리되는 증거.
Clark, L., Lawrence, A. J., Astley-Jones, F., & Gray, N. (2009). Gambling near-misses enhance motivation to gamble and recruit win-related brain circuitry. Neuron, 61(3), 481–490. 개요: 「거의 다 왔는데」라는 니어미스가 객관적으로는 외인데도 승리와 유사한 보상계의 반응을 일으키고 계속 진행하려는 의욕을 높임을 보여준 fMRI 연구.
Csikszentmihalyi, M. (1975). Beyond Boredom and Anxiety. Jossey-Bass. 개요: 도전과 기술의 균형에서 발생하는 몰입 상태 「플로우」의 개념을 처음 제시한 원전. 게임의 난이도 설계의 이론적 기둥.
Dabney, W., Kurth-Nelson, Z., Uchida, N., Starkweather, C. K., Hassabis, D., Munos, R., & Botvinick, M. (2020). A distributional code for value in dopamine-based reinforcement learning. Nature, 577, 671–675. 개요: DeepMind와 신경과학자의 공동 연구. 도파민 신경 집단이 보상의 기댓값이 아니라 확률분포 자체를 병렬로 부호화하고 있으며, AI에서 비롯된 분포 강화학습이 뇌에 구현되어 있음을 발견했다.
Deci, E. L., & Ryan, R. M. (1985). Intrinsic Motivation and Self-Determination in Human Behavior. Plenum. 개요: 자기결정이론(SDT)의 이론적 기반을 보여준 원전. 내재적 동기와 외재적 동기의 관계를 체계화했다.
Deci, E. L., Koestner, R., & Ryan, R. M. (1999). A meta-analytic review of experiments examining the effects of extrinsic rewards on intrinsic motivation. Psychological Bulletin, 125(6), 627–668. 개요: 외재적 보상이 내재적 동기를 저하시키는 언더마이닝 효과의 메타 분석. 효과가 「통제로 인식되는 보상」에서 강하게 나타나는 조건을 특정했다.
Deterding, S., Dixon, D., Khaled, R., & Nacke, L. (2011). From game design elements to gamefulness: defining \"gamification\". Proceedings of MindTrek. 개요: 「게이미피케이션 = 게임 디자인 요소의 비게임 맥락으로의 활용」이라는 표준적 정의를 제시한 논문.
Drummond, A., & Sauer, J. D. (2018). Video game loot boxes are psychologically akin to gambling. Nature Human Behaviour, 2, 530–532. 개요: 주요 타이틀의 루트박스를 도박의 심리적 정의에 비추어 분석하여 대부분이 도박과 동형의 구조를 가지고 있음을 보여준 논문.
Eyal, N. (2014). Hooked: How to Build Habit-Forming Products. Portfolio. 개요: 트리거→행동→변동 보상→투자의 4단계 모델로 프로덕트가 습관을 만드는 메커니즘을 정리한 정평 있는 저서. 프로덕트 설계라는 단일 도메인의 대표적 정리로, 분포 강화학습 이전의 지식에 기반한다.
Ferster, C. B., & Skinner, B. F. (1957). Schedules of Reinforcement. Appleton-Century-Crofts. 개요: 강화 스케줄(고정/변동 × 비율/간격)의 효과를 포괄적으로 실증한 원전. 변동 비율 스케줄의 소거 저항성의 강함을 보여주었다.
Frederick, S., & Loewenstein, G. (1999). Hedonic Adaptation. In D. Kahneman, E. Diener, & N. Schwarz (Eds.), Well-Being: The Foundations of Hedonic Psychology. Russell Sage Foundation. 개요: 쾌·불쾌에 대한 반응이 반복과 시간 경과에 따라 기준점 자체가 업데이트되어 희미해지는 「쾌락 적응」을 정리한 대표적 고찰. 같은 보상에 익숙해지는 현상의 심리학적 기초.
Gruber, M. J., Gelman, B. D., & Ranganath, C. (2014). States of curiosity modulate hippocampus-dependent learning via the dopaminergic circuit. Neuron, 84(2), 486–496. 개요: 호기심이 높아진 상태에서는 도파민계와 해마의 결합이 강해지고, 그때 우연히 제시된 정보의 기억까지 촉진됨을 보여준 실험 연구.
Hallford, N., & Hallford, J. (2001). Swords & Circuitry: A Designer's Guide to Computer Role-Playing Games. Prima Tech. 개요: 게임 내 보상을 Glory·Sustenance·Access·Facility의 4가지로 분류한 실무서. 보상 설계의 어휘로서 현재도 널리 참조된다.
Hamari, J., Koivisto, J., & Sarsa, H. (2014). Does Gamification Work? A Literature Review of Empirical Studies on Gamification. Proceedings of HICSS. 개요: 게이미피케이션의 실증 연구를 체계적으로 검토하여 효과가 맥락에 따라 달라지며 신규성 효과의 영향이 크다고 결론지은 대표적 리뷰.
Herzberg, F. (1959). The Motivation to Work. Wiley. 개요: 직무 만족의 요인을 위생 요인(불만을 방지)과 동기화 요인(만족을 생성)으로 양분한 고전. 위생 요인이 충족되지 않은 상태에서는 동기화 설계가 기능하지 않음을 보여준다.
Huron, D. (2006). Sweet Anticipation: Music and the Psychology of Expectation. MIT Press. 개요: 음악의 쾌감을 「예측과 그 배반·충족」의 심리학으로 체계화한 이론서. 곡을 알고 있어도 구절 단위의 예측 반응이 매번 작동함을 설명한다.
Kahneman, D., & Tversky, A. (1979). Prospect Theory: An Analysis of Decision under Risk. Econometrica, 47(2), 263–291. 개요: 준거점 의존성과 손실 회피를 중심으로 불확실성하에서의 의사결정을 기술한 프로스펙트 이론의 원전. 행동경제학의 출발점.
Kidd, C., & Hayden, B. Y. (2015). The psychology and neuroscience of curiosity. Neuron, 88(3), 449–460. 개요: 호기심 연구를 심리학과 신경과학 양쪽에서 검토하여 정보 탐색을 보상계의 틀로 통합적으로 다루는 시각을 보여준 종설.
Koob, G. F., & Volkow, N. D. (2016). Neurobiology of addiction: a neurocircuitry analysis. The Lancet Psychiatry, 3(8), 760–773. 개요: 중독을 「섭취의 쾌감 → 금단의 불쾌감 → 갈망」의 3단계와 각각에 대응하는 신경회로의 변화로 정리한, 중독의 신경생물학적 표준 종설.
Koster, R. (2013). A Theory of Fun for Game Design (2nd ed.). O'Reilly. 개요: 「게임의 재미의 정체는 학습이다」라고 논한 실무가의 이론서. 게임의 쾌감을 패턴 습득의 쾌감으로 설명하여 호기심 연구와 맞아떨어진다.
Langer, E. J. (1975). The Illusion of Control. Journal of Personality and Social Psychology, 32(2), 311–328. 개요: 복권 번호를 직접 선택하는 등의 무의미한 참여가 "결과를 제어할 수 있다"는 착각을 일으킴을 보여준 고전. 도박의 심리적 증폭 장치의 원천.
Loewenstein, G. (1994). The Psychology of Curiosity: A Review and Reinterpretation. Psychological Bulletin, 116(1), 75–98. 개요: 호기심을 "지식의 부족=정보 격차"에 대한 반응으로 공식화한 리뷰. 이후 신경과학적 호기심 연구의 개념적 토대가 되었다.
McGonigal, J. (2011). Reality Is Broken: Why Games Make Us Better and How They Can Change the World. Penguin. 개요: 게임이 제공하는 자발적 도전의 가치를 논한 베스트셀러. 게임을 인간의 동기부여 관찰 장치로 보는 관점을 널리 퍼뜨렸다.
Monosov, I. E. (2024). Curiosity: primate neural circuits for novelty and information seeking. Nature Reviews Neuroscience, 25, 195–208. 개요: 영장류의 신기함 탐색·정보 탐색의 신경 회로를 정리한 최신 종설. 호기심을 지탱하는 회로가 보상계와 부분적으로 겹치면서도 독자적 구조를 가짐을 보여준다.
Murayama, K. (2022). A reward-learning framework of knowledge acquisition: An integrated account of curiosity, interest, and intrinsic–extrinsic rewards. Psychological Review, 129(1), 175–198. 개요: 지식 획득 자체를 보상으로 하는 학습 루프로서 호기심·흥미를 통합적으로 모델화한 이론 논문. "공부가 좋다"가 자체적으로 작동하는 메커니즘의 이론적 정리.
Murayama, K., Matsumoto, M., Izuma, K., & Matsumoto, K. (2010). Neural basis of the undermining effect of monetary reward on intrinsic motivation. PNAS, 107(49), 20911–20916. 개요: 금전 보상 도입이 내재적 동기부여에 대응하는 선조체·전전두엽 피질의 활동을 저하시킴을 보여주어, 언더마이닝 효과의 신경 기반을 처음 시각화한 연구.
Newzoo (2025). Global Games Market Report 2025. 개요: 세계 게임 시장의 표준적 시장 조사 보고서. 2025년 플레이어 인구를 약 35억 8천만 명(세계 인구의 61.5%), 시장 규모를 188억 8천만 달러로 추정.
Pink, D. H. (2009). Drive: The Surprising Truth About What Motivates Us. Riverhead. 개요: SDT를 토대로 자율성·숙달·목적을 조직의 동기부여 설계의 3대 기둥으로 제시한 실무서.
Ryan, R. M., & Deci, E. L. (2000). Self-Determination Theory and the Facilitation of Intrinsic Motivation, Social Development, and Well-Being. American Psychologist, 55(1), 68–78. 개요: 유능감·자율성·관계성이라는 3가지 기본 심리 욕구를 축으로 SDT를 정리한, 가장 많이 인용되는 전망 논문.
Ryan, R. M., Duineveld, J. J., Di Domenico, S. I., et al. (2023). We know this much is (meta-analytically) true: A meta-review of meta-analyses on self-determination theory. Psychological Bulletin, 149(11-12). 개요: SDT 관련 메타 분석을 종합한 메타 리뷰. 기본 심리 욕구의 충족이 동기부여와 웰빙을 예측한다는 핵심 가설의 견고함을 확인했다.
Salimpoor, V. N., Benovoy, M., Larcher, K., Dagher, A., & Zatorre, R. J. (2011). Anatomically distinct dopamine release during anticipation and experience of peak emotion to music. Nature Neuroscience, 14(2), 257–262. 개요: 음악의 "닭살" 체험 시 도파민이 방출되며, 쾌감의 최고조와 그 몇 초 전의 예기 시점에서 서로 다른 뇌 부위가 작동함을 보여준 연구. 잘 알려진 곡에서도 "예기의 쾌감"이 발생함의 신경 기반.
Schell, J. (2019). The Art of Game Design: A Book of Lenses (3rd ed.). CRC Press. 개요: 게임 설계를 100개 이상의 "렌즈"로 체계화한 대표적 교과서. 동기부여 이론과 게임 설계 실무의 연결을 광범위하게 다룬다.
Schultz, W., Dayan, P., & Montague, P. R. (1997). A Neural Substrate of Prediction and Reward. Science, 275(5306), 1593–1599. 개요: 도파민 신경이 보상 자체가 아니라 "예측과의 차이(보상 예측 오류)"를 인코딩함을 보여주어, AI의 TD 학습과의 수학적 대응을 확립한 기념비적 논문.
Skinner, B. F. (1938). The Behavior of Organisms. Appleton-Century. 개요: 작동 조건화의 이론적 기초를 세운 원전. 행동의 빈도가 결과(강화)에 의해 변화하는 과정을 체계화했다.
Sousa, M., Bujalski, P., Cruz, B. F., et al. & Paton, J. J. (2025). A multidimensional distributional map of future reward in dopamine neurons. Nature, 642. 개요: 도파민 신경이 보상의 "양"과 "시기"를 포함한 다차원 확률 분포 지도를 보유함을 보여주어, 분포 강화 학습의 이미지를 시간축으로 확장한 최신 연구.
Swink, S. (2008). Game Feel: A Game Designer's Guide to Virtual Sensation. CRC Press. 개요: 조작에 대한 즉각적 피드백이 만드는 "손맛"을 체계화한 실무서. 1초 미만의 시간 척도에서 보상의 최소 단위를 다룬다.
Tajfel, H., & Turner, J. C. (1979). An Integrative Theory of Intergroup Conflict. In W. G. Austin & S. Worchel (Eds.), The Social Psychology of Intergroup Relations. Brooks/Cole. 개요: 사람들이 소속 집단을 자신의 일부로 취급하며, 내집단 편애가 발생한다는 사회적 정체성 이론의 원전. 스포츠 관전의 "우리"의식의 이론적 기반.
Wang, Y., Wang, H., et al. (2024). A systematic review and meta-analysis of self-determination-theory-based interventions in the education context. (SDT 공식 사이트 게재판) 개요: 교육 맥락에서의 SDT 기반 중재의 메타 분석. 자율성 지원형 중재가 학습 동기와 학업 성취 모두를 개선함을 보여주었다.
Westgate, E. C., & Wilson, T. D. (2018). Boring thoughts and bored minds: The MAC model of boredom and cognitive engagement. Psychological Review, 125(5), 689–713. 개요: 지루함을 주의의 맞춤(난이도의 적합성)과 의미 부족을 알리는 기능적 신호로 공식화한 이론. 싫증을 인지 자원의 재배치 신호로 보는 현대적 관점을 제시한다.
World Health Organization (2019). Gaming disorder. In International Classification of Diseases, 11th Revision (ICD-11). 개요: 게이밍 장애를 "통제의 상실·우선순위 역전·부정적 결과에도 불구한 지속"을 요건으로 질병 분류에 수록. 게임과 중독 논의의 공식적 기준점.
Wrzesniewski, A., & Dutton, J. E. (2001). Crafting a Job: Revisioning Employees as Active Crafters of Their Work. Academy of Management Review, 26(2), 179–201. 개요: 직원들이 직무의 범위·인간관계·의미 부여를 스스로 재구성하는 "직무 크래프팅"을 개념화한 논문. 주어진 일에 자율성을 되찾는 경로를 보여주었다.
Xiao, L. Y. (2023). Breaking Ban: Belgium's Ineffective Gambling Law Regulation of Video Game Loot Boxes. Collabra: Psychology, 9(1). 개요: 벨기에의 루트박스 금지가 실제로는 충분히 집행되지 않음을 실증적으로 보여주어, 규제의 실효성 문제를 제기한 연구.
Zagal, J. P., Björk, S., & Lewis, C. (2013). Dark Patterns in the Design of Games. Proceedings of FDG. 개요: 플레이어의 이익에 반하는 설계를 "게임의 다크 패턴"으로 유형화한 논문. 설계 윤리 논의의 출발점.
Zajonc, R. B. (1968). Attitudinal Effects of Mere Exposure. Journal of Personality and Social Psychology, 9(2, Pt.2), 1–27. 개요: 반복적인 접촉만으로도 대상에 대한 호의가 증가하는 "단순 접촉 효과"의 원전. 같은 음악을 들을수록 더 좋아하게 되는 현상의 고전적 기초.
읽음
다음 읽을 글 ↓